最小二乘详解:从误差平方到线性与非线性拟合
最小二乘是数据拟合中最常见的一类方法。它看起来只是"把误差平方后加起来,再找一个最小值",背后却连接着几何投影、线性代数、概率统计和数值优化。
本文只围绕一个问题展开:怎样用一个模型尽可能贴近一组观测数据?
你将看到:
- "最小二乘"到底在最小化什么;
- 为什么误差要平方,平方和又有什么几何意义;
- 最小二乘法如何从目标函数推导出方程;
- 线性最小二乘和非线性最小二乘到底按什么标准区分;
- 为什么有些模型看起来弯曲,却仍然可以用线性最小二乘求解;
- 实际使用时,矩阵形式、正规方程、QR 分解、初值和残差分别意味着什么。
一、先从"拟合"开始理解
假设我们测量了一些数据:
| 温度 x | 反应时间 y |
|---|---|
| 1 | 2.1 |
| 2 | 3.9 |
| 3 | 6.2 |
| 4 | 7.8 |
我们希望找一条直线
y=ax+b y = ax+b y=ax+b
让它尽量经过这些点。
现实数据通常带有测量误差,因此很难找到一条直线同时穿过所有点。于是,对于第 iii 个观测点,模型给出的预测值是
y^i=axi+b \hat y_i=ax_i+b y^i=axi+b
观测值与预测值之间的差叫作残差:
ri=yi−y^i=yi−(axi+b) r_i=y_i-\hat y_i=y_i-(ax_i+b) ri=yi−y^i=yi−(axi+b)
每个点都有一个残差。拟合的任务,就是选择合适的 aaa 和 bbb,让所有残差整体尽可能小。
这里的"整体尽可能小"需要被写成一个明确的数学目标。最小二乘选择的目标是:
J(a,b)=∑i=1nri2=∑i=1nyi−(axi+b)2 J(a,b)=\sum_{i=1}^{n}r_i^2 =\sum_{i=1}^{n}\lefty_i-(ax_i+b)\\right^2 J(a,b)=i=1∑nri2=i=1∑nyi−(axi+b)2
然后寻找使 J(a,b)J(a,b)J(a,b) 最小的参数:
(a^,b^)=argmina,bJ(a,b) (\hat a,\hat b)=\arg\min_{a,b}J(a,b) (a^,b^)=arga,bminJ(a,b)
这就是最小二乘的核心。它不是直接让每个误差都为零,而是让误差平方和达到最小。
二、什么是"最小二乘"
"最小二乘"这个名字可以拆成两部分:
- 二乘:把误差的二次方作为代价;
- 最小:寻找让这些二次误差之和最小的参数。
一般地,给定观测值 yiy_iyi、模型预测值 y^i=f(xi;θ)\hat y_i=f(x_i;\theta)y^i=f(xi;θ) 和参数 θ\thetaθ,定义残差
ri(θ)=yi−f(xi;θ) r_i(\theta)=y_i-f(x_i;\theta) ri(θ)=yi−f(xi;θ)
最小二乘问题写作
θ^=argminθ∑i=1nri(θ)2 \hat\theta=\arg\min_\theta\sum_{i=1}^{n}r_i(\theta)^2 θ^=argθmini=1∑nri(θ)2
向量形式更简洁。令
r(θ)=r1(θ)r2(θ)⋮rn(θ) \mathbf r(\theta)= \begin{bmatrix} r_1(\theta)\\r_2(\theta)\\\vdots\\r_n(\theta) \end{bmatrix} r(θ)= r1(θ)r2(θ)⋮rn(θ)
则目标函数为
J(θ)=r(θ)Tr(θ)=∥r(θ)∥22 J(\theta)=\mathbf r(\theta)^T\mathbf r(\theta)=\|\mathbf r(\theta)\|_2^2 J(θ)=r(θ)Tr(θ)=∥r(θ)∥22
所以最小二乘也可以理解为:让残差向量的欧几里得长度最短。
1. 为什么不直接把误差相加
如果使用
r1+r2+⋯+rn r_1+r_2+\cdots+r_n r1+r2+⋯+rn
正误差和负误差会互相抵消。例如两个残差分别是 333 和 −3-3−3,它们的和为 000,但模型显然并没有完美拟合这两个点。
绝对值和
∣r1∣+∣r2∣+⋯+∣rn∣ |r_1|+|r_2|+\cdots+|r_n| ∣r1∣+∣r2∣+⋯+∣rn∣
可以避免抵消,但绝对值在 000 处不可导,优化时处理起来不够平滑。
平方和
r12+r22+⋯+rn2 r_1^2+r_2^2+\cdots+r_n^2 r12+r22+⋯+rn2
既不会发生正负抵消,又处处可导。更重要的是,平方和在数学上有非常清晰的几何和统计解释。
2. 为什么大误差会受到更重的惩罚
残差为 111 时,平方贡献是 111;残差为 333 时,平方贡献是 999。因此,一个较大的误差会显著影响总目标。
这既是优点,也是局限:当数据中存在异常值时,异常点可能强烈拉动拟合结果。最小二乘适合误差大致符合连续、对称分布的场景;如果异常值很多,通常需要考虑加权最小二乘或鲁棒损失。
三、最小二乘的几何意义:寻找一个投影
先看线性模型的矩阵形式。设有 nnn 个观测点,模型为
yi=θ0+θ1xi y_i=\theta_0+\theta_1x_i yi=θ0+θ1xi
把所有观测写在一起:
y=Aθ+ε \mathbf y=\mathbf A\boldsymbol\theta+\boldsymbol\varepsilon y=Aθ+ε
其中
y=y1y2⋮yn,A=1x11x2⋮⋮1xn,θ=θ0θ1 \mathbf y= \begin{bmatrix}y_1\\y_2\\\vdots\\y_n\end{bmatrix},\quad \mathbf A= \begin{bmatrix} 1&x_1\\1&x_2\\\vdots&\vdots\\1&x_n \end{bmatrix},\quad \boldsymbol\theta= \begin{bmatrix}\theta_0\\\theta_1\end{bmatrix} y= y1y2⋮yn ,A= 11⋮1x1x2⋮xn ,θ=θ0θ1
矩阵 A\mathbf AA 的列空间记作 Col(A)\operatorname{Col}(\mathbf A)Col(A)。所有形如 Aθ\mathbf A\boldsymbol\thetaAθ 的向量,都位于这个列空间中。也就是说,模型能够产生的预测向量只能落在这个子空间里。
观测向量 y\mathbf yy 往往不在这个子空间中。最小二乘要找的是列空间中离 y\mathbf yy 最近的那个预测向量:
记这个最近点为 Aθ^\mathbf A\hat{\boldsymbol\theta}Aθ^,残差为
r=y−Aθ^ \mathbf r=\mathbf y-\mathbf A\hat{\boldsymbol\theta} r=y−Aθ^
在欧几里得几何中,点到一个平面的最近距离沿着垂线。因此,最小二乘解具有一个重要性质:
ATr=0 \mathbf A^T\mathbf r=0 ATr=0
残差与 A\mathbf AA 的每一列都正交。对于直线拟合,这意味着残差与"常数方向"和"自变量方向"都正交。
这个结论将会自然导出正规方程。
四、从目标函数推导最小二乘法
以线性模型为例:
y=Aθ+ε \mathbf y=\mathbf A\boldsymbol\theta+\boldsymbol\varepsilon y=Aθ+ε
目标函数为
J(θ)=∥y−Aθ∥22 J(\boldsymbol\theta)=\|\mathbf y-\mathbf A\boldsymbol\theta\|_2^2 J(θ)=∥y−Aθ∥22
利用转置展开:
J(θ)=(y−Aθ)T(y−Aθ) J(\boldsymbol\theta)= (\mathbf y-\mathbf A\boldsymbol\theta)^T (\mathbf y-\mathbf A\boldsymbol\theta) J(θ)=(y−Aθ)T(y−Aθ)
展开得到
J(θ)=yTy−2θTATy+θTATAθ J(\boldsymbol\theta)= \mathbf y^T\mathbf y -2\boldsymbol\theta^T\mathbf A^T\mathbf y +\boldsymbol\theta^T\mathbf A^T\mathbf A\boldsymbol\theta J(θ)=yTy−2θTATy+θTATAθ
对参数求梯度:
∇J(θ)=−2ATy+2ATAθ \nabla J(\boldsymbol\theta)= -2\mathbf A^T\mathbf y+2\mathbf A^T\mathbf A\boldsymbol\theta ∇J(θ)=−2ATy+2ATAθ
在最小值处梯度为零:
ATAθ^=ATy \mathbf A^T\mathbf A\hat{\boldsymbol\theta}=\mathbf A^T\mathbf y ATAθ^=ATy
这组方程叫作正规方程。
如果 ATA\mathbf A^T\mathbf AATA 可逆,可以写成
θ^=(ATA)−1ATy \hat{\boldsymbol\theta}=(\mathbf A^T\mathbf A)^{-1}\mathbf A^T\mathbf y θ^=(ATA)−1ATy
这个公式很有名,但实际计算中通常不建议直接求逆。原因是求逆会增加数值误差,尤其当特征之间高度相关时,ATA\mathbf A^T\mathbf AATA 的条件数会变差。工程实现一般优先使用 QR 分解或奇异值分解。
1. 直线拟合的显式结果
对于
yi=axi+b y_i=ax_i+b yi=axi+b
最小二乘目标为
J(a,b)=∑i=1n(yi−axi−b)2 J(a,b)=\sum_{i=1}^{n}(y_i-ax_i-b)^2 J(a,b)=i=1∑n(yi−axi−b)2
分别对 aaa 和 bbb 求导,可得到两条方程:
{a∑xi2+b∑xi=∑xiyia∑xi+bn=∑yi \begin{cases} a\sum x_i^2+b\sum x_i=\sum x_iy_i\\ a\sum x_i+b n=\sum y_i \end{cases} {a∑xi2+b∑xi=∑xiyia∑xi+bn=∑yi
解出后,也可以写成更直观的形式:
a^=∑i(xi−xˉ)(yi−yˉ)∑i(xi−xˉ)2,b^=yˉ−a^xˉ \hat a=\frac{\sum_i(x_i-\bar x)(y_i-\bar y)}{\sum_i(x_i-\bar x)^2}, \qquad \hat b=\bar y-\hat a\bar x a^=∑i(xi−xˉ)2∑i(xi−xˉ)(yi−yˉ),b^=yˉ−a^xˉ
这里的 xˉ\bar xxˉ 和 yˉ\bar yyˉ 是样本均值。斜率由 xxx 与 yyy 的共同变化程度决定,截距则保证拟合直线经过点 (xˉ,yˉ)(\bar x,\bar y)(xˉ,yˉ)。
五、最小二乘法是什么
"最小二乘"通常指一种目标函数或准则;"最小二乘法"指使用这个准则求参数的方法。
完整流程可以写成:
- 选择模型 y^=f(x;θ)\hat y=f(x;\theta)y^=f(x;θ);
- 计算每个样本的残差 ri=yi−f(xi;θ)r_i=y_i-f(x_i;\theta)ri=yi−f(xi;θ);
- 构造平方和 J(θ)=∑iri2J(\theta)=\sum_i r_i^2J(θ)=∑iri2;
- 求使 J(θ)J(\theta)J(θ) 最小的参数 θ^\hat\thetaθ^;
- 用残差、参数和泛化表现检查拟合是否可信。
因此,最小二乘法不是某一个固定公式。直线拟合、平面拟合、多项式拟合、曲线参数估计,都可能使用最小二乘准则;只要它们最小化的是残差平方和,就属于最小二乘问题。
六、什么是线性最小二乘
线性最小二乘的关键不在于图像是不是一条直线,而在于:模型对待估参数是否是线性的。
1. 参数线性才是判断标准
下面的模型对参数 β0,β1,β2\beta_0,\beta_1,\beta_2β0,β1,β2 是线性的:
y=β0+β1x+β2x2 y=\beta_0+\beta_1x+\beta_2x^2 y=β0+β1x+β2x2
虽然曲线是抛物线,但参数只以一次幂出现。写成矩阵形式:
y=1x1x121x2x22⋮⋮⋮1xnxn2β0β1β2 \mathbf y= \begin{bmatrix}1&x_1&x_1^2\\1&x_2&x_2^2\\\vdots&\vdots&\vdots\\1&x_n&x_n^2\end{bmatrix} \begin{bmatrix}\beta_0\\\beta_1\\\beta_2\end{bmatrix} y= 11⋮1x1x2⋮xnx12x22⋮xn2 β0β1β2
设计矩阵中的列可以是任意已知函数:1,x,x2,sinx,logx1,x,x^2,\sin x,\log x1,x,x2,sinx,logx,只要参数以线性组合的方式出现,就仍然是线性最小二乘。
例如
y=β0+β1sinx+β2log(x+1) y=\beta_0+\beta_1\sin x+\beta_2\log(x+1) y=β0+β1sinx+β2log(x+1)
仍然可以直接构造设计矩阵求解。
2. 线性最小二乘的统一形式
写成
y=Aβ+ε \mathbf y=\mathbf A\boldsymbol\beta+\boldsymbol\varepsilon y=Aβ+ε
其中 A\mathbf AA 已知,未知量只有参数向量 β\boldsymbol\betaβ。目标函数为
minβ∥y−Aβ∥22 \min_{\boldsymbol\beta}\|\mathbf y-\mathbf A\boldsymbol\beta\|_2^2 βmin∥y−Aβ∥22
这是一个凸二次优化问题。只要设计矩阵列满秩,目标函数就有唯一最小解;不满秩时,可能有多个参数解,但它们产生的预测值可能相同。
3. 线性最小二乘的例子
多项式拟合
y=β0+β1x+β2x2+⋯+βdxd y=\beta_0+\beta_1x+\beta_2x^2+\cdots+\beta_dx^d y=β0+β1x+β2x2+⋯+βdxd
多元线性回归
y=β0+β1x1+β2x2+⋯+βpxp y=\beta_0+\beta_1x_1+\beta_2x_2+\cdots+\beta_px_p y=β0+β1x1+β2x2+⋯+βpxp
指数模型的线性化
模型
y=aebx y=ae^{bx} y=aebx
对正值取对数:
lny=lna+bx \ln y=\ln a+bx lny=lna+bx
令 c=lnac=\ln ac=lna,就变成了关于 c,bc,bc,b 的线性模型。需要注意,取对数改变了误差结构:原始 yyy 空间中的最小二乘和 lny\ln ylny 空间中的最小二乘并不等价。因此,线性化是建模选择,不是简单的计算技巧。
七、什么是非线性最小二乘
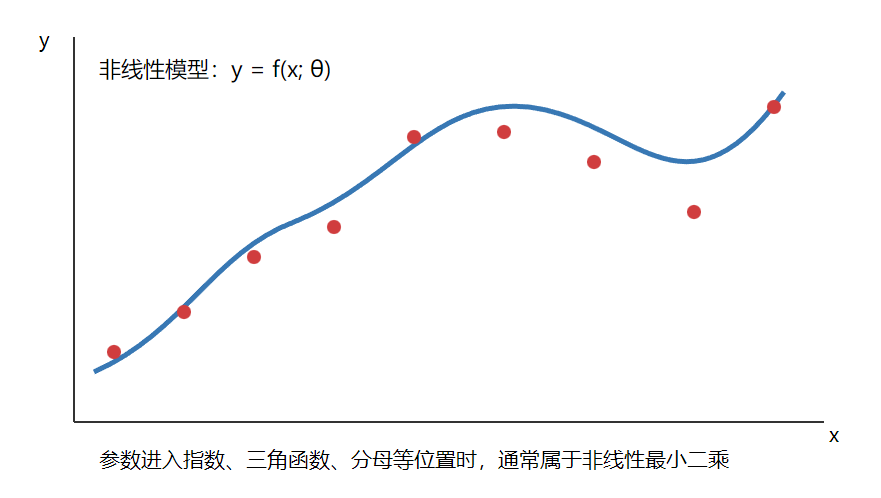
非线性最小二乘仍然最小化残差平方和,但模型对参数不是线性的:
θ^=argminθ∑i=1nyi−f(xi;θ)2 \hat\theta=\arg\min_\theta\sum_{i=1}^{n} \lefty_i-f(x_i;\\theta)\\right^2 θ^=argθmini=1∑nyi−f(xi;θ)2
例如:
y=aexp(−bx)+c y=a\exp(-bx)+c y=aexp(−bx)+c
其中参数 a,b,ca,b,ca,b,c 参与了乘法、指数和加法关系。再如:
y=asin(bx+c) y=a\sin(bx+c) y=asin(bx+c)
参数 bbb 和 ccc 位于三角函数内部,也属于非线性参数化。
1. 非线性并不等于曲线
这是最容易混淆的地方。
y=β0+β1x+β2x2 y=\beta_0+\beta_1x+\beta_2x^2 y=β0+β1x+β2x2
图像是曲线,但对参数是线性的,属于线性最小二乘。
y=aebx y=a e^{bx} y=aebx
图像也是曲线,而且参数 bbb 出现在指数中,属于非线性最小二乘。
判断标准是"参数如何进入模型",不是"拟合出来的图像是否弯曲"。
2. 非线性最小二乘为什么更难
线性最小二乘可以通过一次矩阵运算得到解;非线性最小二乘通常没有简单的闭式解,需要迭代求解。
给定当前参数 θk\theta_kθk,算法会计算残差和残差对参数的变化关系,产生一个新的参数 θk+1\theta_{k+1}θk+1,不断降低目标函数:
θ0→θ1→θ2→⋯ \theta_0\rightarrow\theta_1\rightarrow\theta_2\rightarrow\cdots θ0→θ1→θ2→⋯
常见方法包括高斯---牛顿法、Levenberg---Marquardt 方法和信赖域方法。它们都利用了局部近似,但具体的步长控制和稳定性处理不同。
3. 雅可比矩阵的作用
令残差向量为
r(θ)=y1−f(x1;θ)⋮yn−f(xn;θ) \mathbf r(\theta)= \begin{bmatrix} y_1-f(x_1;\theta)\\ \vdots\\ y_n-f(x_n;\theta) \end{bmatrix} r(θ)= y1−f(x1;θ)⋮yn−f(xn;θ)
残差对参数的偏导数组成雅可比矩阵:
J(θ)=∂r∂θ \mathbf J(\theta)=\frac{\partial\mathbf r}{\partial\theta} J(θ)=∂θ∂r
在当前点附近,用一阶泰勒展开近似:
r(θ+Δθ)≈r(θ)+J(θ)Δθ \mathbf r(\theta+\Delta\theta) \approx \mathbf r(\theta)+\mathbf J(\theta)\Delta\theta r(θ+Δθ)≈r(θ)+J(θ)Δθ
于是,非线性问题在局部被近似成一个线性最小二乘问题:
minΔθ∥r(θ)+J(θ)Δθ∥22 \min_{\Delta\theta} \|\mathbf r(\theta)+\mathbf J(\theta)\Delta\theta\|_2^2 Δθmin∥r(θ)+J(θ)Δθ∥22
求出增量后更新参数。这就是许多非线性最小二乘算法的基本思想。
八、线性最小二乘和非线性最小二乘的对比
| 对比项 | 线性最小二乘 | 非线性最小二乘 |
|---|---|---|
| 参数进入模型的方式 | 参数是已知基函数的线性组合系数 | 参数出现在指数、三角函数、乘积、分母等非线性位置 |
| 是否一定需要迭代 | 通常不需要 | 通常需要 |
| 是否有闭式解 | 常见情况下可通过正规方程表示 | 一般没有简单闭式解 |
| 对初值的敏感性 | 通常不敏感 | 可能非常敏感 |
| 局部最小值问题 | 凸问题时较少 | 可能存在多个局部最小值 |
| 计算重点 | 设计矩阵的秩、条件数、数值分解 | 初值、雅可比、步长、收敛和参数约束 |
两者共享同一个目标:最小化残差平方和。区别在于模型对参数的结构不同。
九、残差、误差和拟合优度
1. 残差与真实误差
真实误差通常指观测值与真实规律之间的差异,但真实规律一般未知。拟合后能够直接计算的是残差:
ri=yi−y^i r_i=y_i-\hat y_i ri=yi−y^i
残差是误差的可观测替代物,但它不等于真实误差。
2. 残差平方和
SSE=∑iri2 \mathrm{SSE}=\sum_i r_i^2 SSE=i∑ri2
它是最小二乘直接优化的量,数值越小表示训练数据上的平方误差越小。但不同数据集、不同量纲之间不能只凭 SSE 数值直接比较。
3. 均方误差和均方根误差
MSE=1n∑iri2 \mathrm{MSE}=\frac{1}{n}\sum_i r_i^2 MSE=n1i∑ri2
RMSE=1n∑iri2 \mathrm{RMSE}=\sqrt{\frac{1}{n}\sum_i r_i^2} RMSE=n1i∑ri2
RMSE 与 yyy 具有相同单位,因此通常更容易解释。
4. R2R^2R2 不是最小二乘本身
在线性回归中常见决定系数:
R2=1−∑i(yi−y^i)2∑i(yi−yˉ)2 R^2=1-\frac{\sum_i(y_i-\hat y_i)^2}{\sum_i(y_i-\bar y)^2} R2=1−∑i(yi−yˉ)2∑i(yi−y^i)2
R2R^2R2 用来描述模型相对于"只用均值预测"的改进程度,但它不是最小二乘目标,也不能单独证明模型正确。高 R2R^2R2 可能来自过拟合、数据范围过窄或变量之间的偶然关系。
十、最小二乘背后的概率解释
假设观测模型为
yi=f(xi;θ)+εi y_i=f(x_i;\theta)+\varepsilon_i yi=f(xi;θ)+εi
并且误差独立同分布,满足
εi∼N(0,σ2) \varepsilon_i\sim\mathcal N(0,\sigma^2) εi∼N(0,σ2)
那么所有观测出现的似然为
p(y∣θ)∝exp(−12σ2∑iyi−f(xi;θ)2) p(\mathbf y\mid\theta) \propto \exp\left(-\frac{1}{2\sigma^2} \sum_iy_i-f(x_i;\\theta)^2\right) p(y∣θ)∝exp(−2σ21i∑yi−f(xi;θ)2)
最大化似然,等价于最小化残差平方和。因此,最小二乘不仅是一种几何距离准则,也对应于"观测噪声近似为高斯噪声"时的最大似然估计。
如果不同观测的噪声方差不同,统一平方和就不再合适。设第 iii 个观测的标准差是 σi\sigma_iσi,可以使用加权最小二乘:
minθ∑iri(θ)2σi2 \min_\theta\sum_i\frac{r_i(\theta)^2}{\sigma_i^2} θmini∑σi2ri(θ)2
噪声越大的观测权重越低,测量越可靠的观测权重越高。
十一、最小二乘的几个常见陷阱
1. 把"线性模型"误解成"直线模型"
多项式、傅里叶基函数和样条基函数都可能属于线性最小二乘。判断依据是参数是否线性出现。
2. 直接用正规方程求逆
理论公式中的 (ATA)−1(A^TA)^{-1}(ATA)−1 便于推导,但程序中直接求逆通常不是最佳选择。更稳妥的做法是调用线性代数库的 QR 或 SVD 求解器。
3. 忽略特征尺度
如果一个特征在 10−410^{-4}10−4 量级,另一个在 10610^6106 量级,矩阵可能出现严重的尺度差异。中心化、标准化或重新参数化往往能改善数值稳定性。
4. 非线性拟合只给一个随意初值
非线性算法从初值开始探索。初值很差时,可能收敛到不合适的局部解,或者直接不收敛。可以利用物理知识、可视化、粗网格搜索或多组初值来提高成功率。
5. 只看目标函数,不看残差结构
残差应当在没有明显规律的情况下随机分布。如果残差随 xxx 呈弯曲趋势,说明模型可能缺少非线性项;如果残差呈扇形,可能存在异方差;如果连续观测的残差成段同号,可能存在时间相关性。
6. 盲目加入高次项
高次多项式可以降低训练误差,却可能在区间边缘剧烈振荡。模型复杂度、数据量、外推范围和验证集表现都需要一起考虑。
十二、用一个统一视角回顾全文
无论模型长什么样,都可以从下面四个对象开始:
- 观测数据:yiy_iyi;
- 模型预测:f(xi;θ)f(x_i;\theta)f(xi;θ);
- 残差:ri(θ)=yi−f(xi;θ)r_i(\theta)=y_i-f(x_i;\theta)ri(θ)=yi−f(xi;θ);
- 目标函数:J(θ)=∑iri(θ)2J(\theta)=\sum_i r_i(\theta)^2J(θ)=∑iri(θ)2。
如果模型对参数是线性的,可以把问题写成 Aθ≈yA\theta\approx yAθ≈y,使用线性代数方法求解,这就是线性最小二乘。
如果参数以非线性方式进入 fff,就需要通过局部线性化和迭代优化求解,这就是非线性最小二乘。
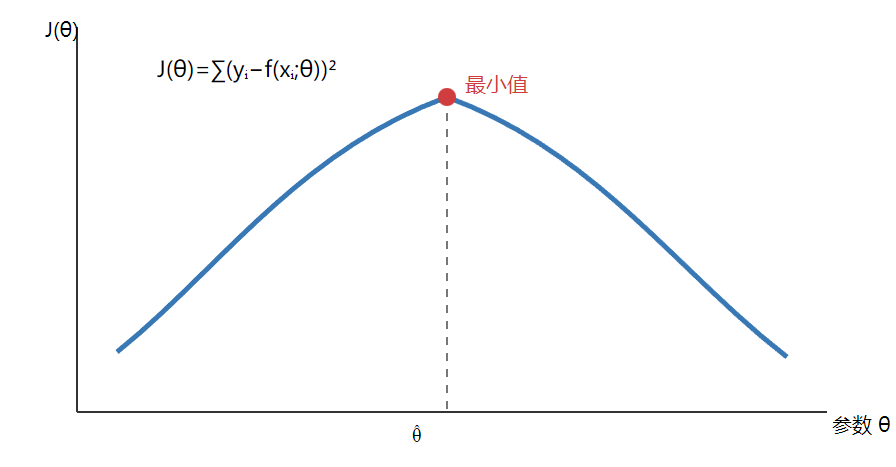
最小二乘真正解决的事情很朴素:在模型无法完全解释数据时,按照平方距离定义"整体最接近",再寻找对应的参数。它的深度来自这条简单规则与几何投影、矩阵方程、概率模型和数值优化之间的联系。
十三、结语
理解最小二乘时,建议牢牢记住三层含义:
- 在数据层面,它是在累计每个样本的平方残差;
- 在几何层面,它是在寻找观测向量到模型空间的最近投影;
- 在计算层面,它是在求一个参数,使目标函数达到最小。
线性最小二乘和非线性最小二乘的分界点,是参数化形式,不是曲线是否弯曲。掌握这一点之后,遇到新的拟合模型时,只需检查参数如何进入模型,再决定使用矩阵求解还是迭代优化。
参考阅读方向
- 线性代数中的正交投影、列空间和奇异值分解;
- 数值优化中的高斯---牛顿法与 Levenberg---Marquardt 方法;
- 概率统计中的高斯噪声、最大似然估计和加权最小二乘;
- 回归分析中的残差诊断、正则化和模型验证。