摘要:Flink 里所有算子(map/filter/window/UDF)最终都执行在一个"函数类"上。这篇文章把函数类体系拆开讲透:四大家族的继承关系、RichFunction 生命周期与 RuntimeContext 的底层机制、ProcessFunction 状态+定时器+侧输出三大能力、窗口函数的增量/全量执行模型,以及六个真实踩坑案例。看完你能直接回答"为什么 lambda 一碰状态就失灵""WindowFunction 为什么被废弃""定时器为什么会爆炸"这类面试与线上问题。
关键词:Flink 函数类、RichFunction、ProcessFunction、KeyedProcessFunction、定时器、侧输出、窗口函数、AggregateFunction、Table UDF、状态访问、生命周期
一、先从一个"升级需求"说起
很多 Flink 项目都是从 lambda 起步的:
java
DataStream<String> result = source.map(x -> x.toUpperCase());一切正常,直到某天需求变了:要给 map 里的逻辑配一个连接池、要统计处理条数、要按 key 记住上次的值 。然后你发现 lambda 全做不了------没有地方做一次性初始化,拿不到运行时上下文,更别提状态。你只能把匿名函数改成具名类,再升级成 RichMapFunction。
这不是语法问题,是函数类的体系分层问题。Flink 把"处理逻辑"封装成一套可序列化、可分发、带生命周期的函数类体系,lambda 只是最上层普通函数的语法糖。之前的基础系列我们讲了 Source / Transformation / Sink 三类 API 怎么用,这篇往下沉一层,看算子背后真正执行的那个"函数类"。
二、函数类全景:一个 Function 接口,四大家族
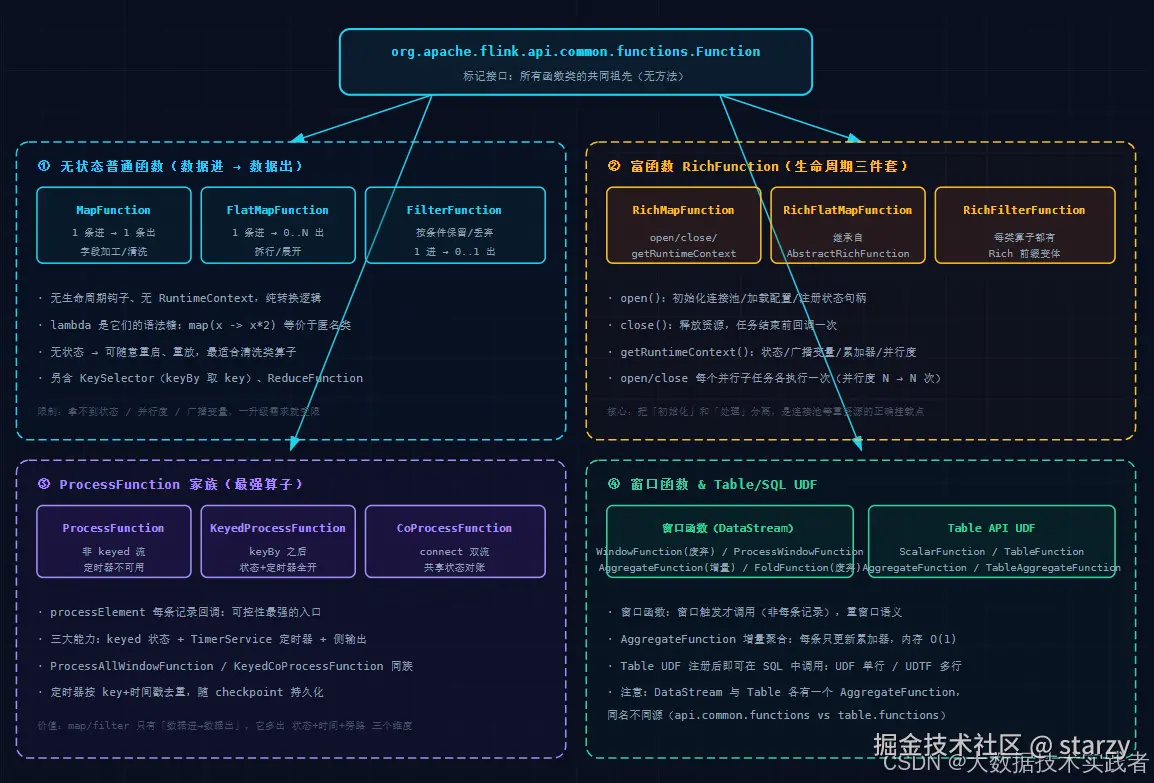
体系的全貌如上图。所有函数类的共同祖先是 org.apache.flink.api.common.functions.Function------注意它只是一个空的标记接口 (历史上曾有过 map(T) 方法,后来废弃了,现在不定义任何方法),真正的契约由每个子接口自己声明。
四大家族的划分依据,其实是"控制力逐级递增":
| 家族 | 代表 | 生命周期钩子 | 状态访问 | 定时器/侧输出 |
|---|---|---|---|---|
| 普通函数 | MapFunction / FlatMapFunction / FilterFunction | 无 | 无 | 无 |
| 富函数 | RichMapFunction 等(继承 AbstractRichFunction) | open / close | getRuntimeContext | 无 |
| ProcessFunction | KeyedProcessFunction / CoProcessFunction | open / close | 完整 keyed state | 全开 |
| 窗口函数 & UDF | ProcessWindowFunction / AggregateFunction / ScalarFunction | 视情况 | 视情况 | 窗口触发语义 / SQL 注册 |
判断标准一句话:控制力越强,代码越重。 能用普通函数解决的,别一上来就 ProcessFunction;反过来,需要状态和定时器时也别硬用 lambda 加局部变量凑------那是线上事故的温床。
三、RichFunction:生命周期三件套的底层机制
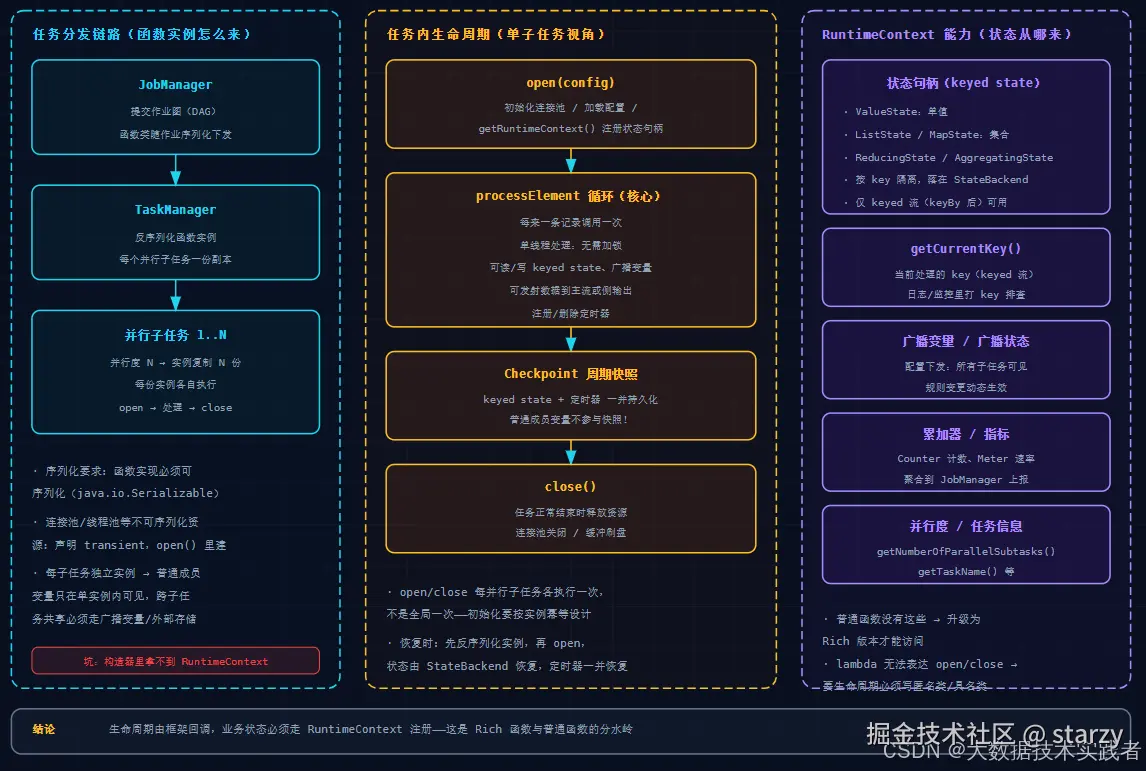
先纠正一个常见误解:函数类不是"每个算子一个实例"那么简单。完整的链路是:
- 作业提交时,JobManager 把算子链(含函数类)序列化下发;
- TaskManager 反序列化后,每个并行子任务各自复制一份函数实例(并行度 N,就有 N 份副本);
- 每份副本独立走一遍
构造 → open() → processElement 循环 → close()。
所以 open() 在每个并行子任务上都会执行一次,不是全局一次。这也是为什么 open 里的初始化必须按"单实例"设计------比如初始化连接池,每个子任务建一个自己的连接池,这是正常的,也是 Flink 分布式语义的一部分。
getRuntimeContext() 是富函数与普通函数的分水岭:状态句柄(ValueState / ListState / MapState / ReducingState / AggregatingState)、广播变量、累加器、并行度信息,全从这里拿。还有一个容易被忽略的时序细节:open() 被调用时,状态已经从 StateBackend 恢复完毕------也就是说你在 open 里拿到的状态句柄直接可用,不需要等第一条数据。
看一个真实的连接池场景,对比 lambda 和 RichMapFunction:
java
// ❌ 错误:lambda 里没法做一次性初始化,只能每条数据临时建连接
DataStream<Order> bad = source.map(o -> {
    Jedis jedis = new Jedis("redis-1", 6379);   // 每条数据 new 一个连接 → 连接数爆炸,必挂
    Order order = parse(o, jedis);
    jedis.close();
    return order;
});

// ✅ 正确:open() 初始化一次,map() 里复用
DataStream<Order> good = source.map(new RichMapFunction<String, Order>() {

    private transient JedisPool pool;   // 连接池不可序列化 → 必须 transient

    @Override
    public void open(Configuration parameters) throws Exception {
        // 只在算子初始化时执行一次(每个并行子任务各一次)
        // 此时状态已恢复、RuntimeContext 已可用
        pool = new JedisPool(new JedisPoolConfig(), "redis-1", 6379);
    }

    @Override
    public Order map(String value) throws Exception {
        // 单子任务内单线程串行调用,成员变量无需加锁
        return parse(value, pool.getResource());
    }

    @Override
    public void close() throws Exception {
        if (pool != null) {
            pool.close();              // 任务结束时释放
        }
    }
});
这个例子里藏着三个坑,逐个说:
- 连接池必须声明
transient。函数实例要跨 JobManager/TaskManager 序列化分发,JedisPool不可序列化,不标 transient 会在提交时直接抛NotSerializableException。所有重量级资源(连接、线程池、HTTP client)都走这个模式:transient + open 里建 + close 里关。 - 业务状态别写普通成员变量 。checkpoint 只认 StateBackend 里的状态,普通成员变量既不参与快照、重启后也全部丢失。要在重启/恢复后还在的数据,一律走
getRuntimeContext().getState(...)。 - 构造器里拿不到 RuntimeContext,会 NPE。初始化逻辑必须放在 open() 里,这是框架的回调时机,不是你可以提前的地方。
四、ProcessFunction:Flink 表达力最强的函数类
如果说 RichFunction 是"加了生命周期的函数",ProcessFunction 就是"拥有完整执行上下文"的函数------它在普通函数"数据进→数据出"的模型上,多出状态、时间、旁路三个维度。
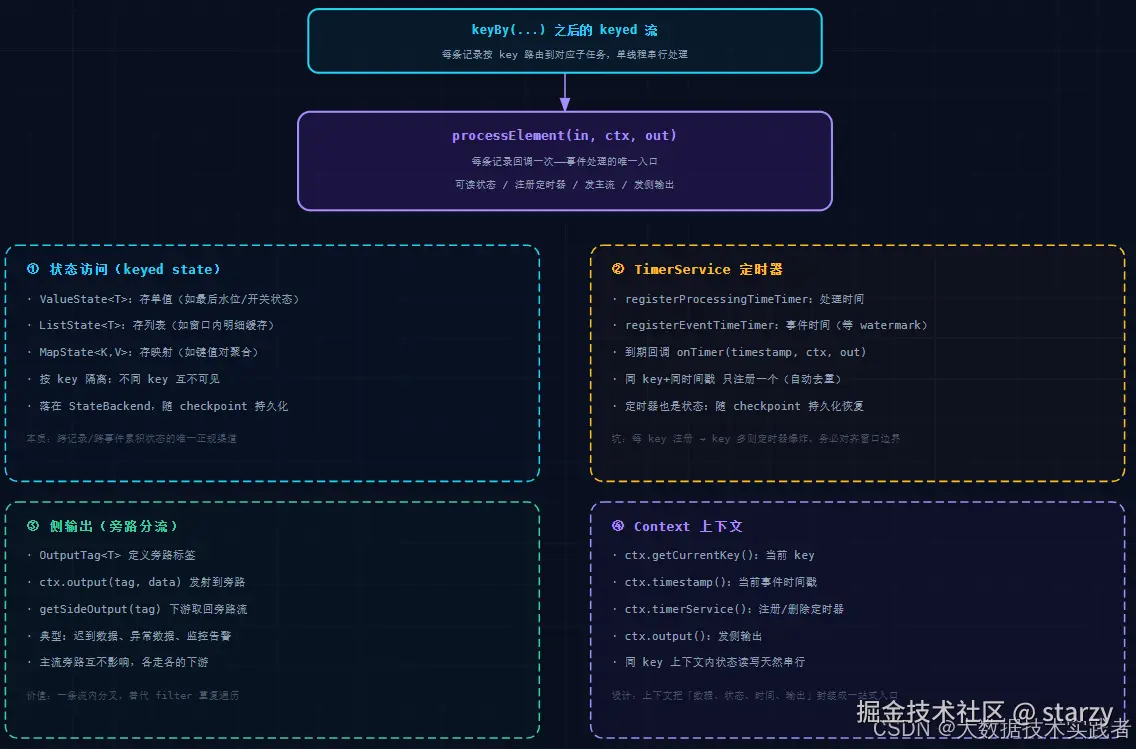
以 KeyedProcessFunction 为例(keyBy 之后才能用),四个能力象限:
- 状态访问:ValueState / ListState / MapState,按 key 隔离,落 StateBackend,随 checkpoint 持久化;
- TimerService 定时器 :
registerEventTimeTimer(事件时间,等 watermark 越过触发)和registerProcessingTimeTimer(处理时间,按系统时钟触发),到期回调onTimer;同一 key 的同一时间戳只注册一个定时器,且定时器本身也是状态------checkpoint 会连同定时器一起持久化,作业恢复后定时器原样恢复,不会丢; - 侧输出 :
OutputTag+ctx.output(),把迟到数据、异常数据、监控告警旁路出去,与主流互不干扰; - Context:当前 key、当前事件时间戳、timerService、output,一站式封装。
4.1 实战:订单 30 分钟未支付检测(事件时间定时器 + 状态 + 侧输出)
这是 ProcessFunction 的经典考题,也是线上真实需求。核心设计:用事件时间而不是处理时间------处理时间定时器在 Flink 重启或数据乱序时会误报;事件时间定时器等 watermark 越过时间点才触发,语义与业务时间对齐。
java
public class TimeoutCheck extends KeyedProcessFunction<Long, OrderEvent, OrderEvent> {

    private ValueState<Long> createTs;   // 记住订单创建时间

    @Override
    public void open(Configuration parameters) {
        // TTL:40 分钟,防止已支付/超时订单的状态无限残留
        StateTtlConfig ttl = StateTtlConfig.newBuilder(Time.minutes(40))
                .setUpdateType(StateTtlConfig.UpdateType.OnCreateAndWrite)
                .setStateVisibility(StateTtlConfig.StateVisibility.NeverReturnExpired)
                .build();
        ValueStateDescriptor<Long> desc =
                new ValueStateDescriptor<>("create-ts", Long.class);
        desc.enableTimeToLive(ttl);
        createTs = getRuntimeContext().getState(desc);
    }

    @Override
    public void processElement(OrderEvent e, Context ctx, Collector<OrderEvent> out)
            throws Exception {
        if (e.type == EventType.CREATE) {
            createTs.update(e.ts);
            // 注册"创建时间 + 30 分钟"的定时器;同 key 同时间戳只注册一次
            ctx.timerService().registerEventTimeTimer(e.ts + 30 * 60 * 1000L);
        } else if (e.type == EventType.PAY) {
            Long ts = createTs.value();
            if (ts != null) {
                // 已支付:删掉定时器,避免多余回调
                ctx.timerService().deleteEventTimeTimer(ts + 30 * 60 * 1000L);
                createTs.clear();
            }
            out.collect(e);   // 正常支付订单进主流
        }
    }

    @Override
    public void onTimer(long timestamp, OnTimerContext ctx, Collector<OrderEvent> out)
            throws Exception {
        // 定时器到期 = watermark 已越过时间点,且期间没收到支付事件
        Long ts = createTs.value();
        if (ts != null) {
            // 走到这里说明订单确实没支付(支付了会删定时器、清状态)
            ctx.output(timeoutTag, buildTimeout(ctx.getCurrentKey(), ts));
            createTs.clear();
        }
    }
}
两个容易忽略的细节:
ValueStateDescriptor一定要带 TTL 。订单场景 key 是 orderId,量级可控;但凡是"按 key 存明细"的状态,不配 TTL 就是状态无限膨胀------RocksDB 下直接反映为磁盘占用和 GC 压力。OnCreateAndWrite意思是创建和每次写入都刷新过期时间,适合"最后一次事件时间 + N 分钟"这类语义。- 删定时器必须跟注册配对 。
deleteEventTimeTimer的时间戳要和注册时完全一致,否则删不掉,onTimer 里只能靠createTs.value() == null兜底。这也是为什么状态判空 + 定时器删除要成对写。
4.2 双流对账:CoProcessFunction
connect 双流(订单流 + 支付流)对账是 CoProcessFunction 的典型场景------两条流共享同一个 keyed state,互相匹配:
java
orderStream.connect(payStream)
        .keyBy(Order::getOrderId, Pay::getOrderId)
        .process(new CoProcessFunction<Order, Pay, MatchResult>() {

            private ValueState<Order> pending;

            @Override
            public void open(Configuration parameters) {
                pending = getRuntimeContext()
                        .getState(new ValueStateDescriptor<>("pending-order", Order.class));
            }

            @Override
            public void processElement1(Order o, Context ctx, Collector<MatchResult> out) {
                pending.update(o);   // 订单先到:记住它,注册 10 分钟兜底定时器
                ctx.timerService().registerEventTimeTimer(o.ts + 10 * 60 * 1000L);
            }

            @Override
            public void processElement2(Pay p, Context ctx, Collector<MatchResult> out) {
                Order o = pending.value();
                if (o != null) {
                    // 匹配成功:清状态、删定时器
                    pending.clear();
                    ctx.timerService().deleteEventTimeTimer(o.ts + 10 * 60 * 1000L);
                    out.collect(new MatchResult(o, p, MatchStatus.MATCHED));
                } else {
                    // 先支付后下单(或支付流超前)------异常旁路
                    out.collect(new MatchResult(null, p, MatchStatus.UNMATCHED_PAY));
                }
            }

            @Override
            public void onTimer(long ts, OnTimerContext ctx, Collector<MatchResult> out) {
                Order o = pending.value();
                if (o != null) {   // 10 分钟还没匹配上 → 订单异常
                    pending.clear();
                    out.collect(new MatchResult(o, null, MatchStatus.TIMEOUT));
                }
            }
        });
这里的坑是数据到达顺序 :同一订单的两条事件可能跨分区乱序到达(Kafka 多分区、重试重放),所以"先到先存、后到匹配"的逻辑必须靠状态而不是靠时序假设。这也是 CoProcessFunction 相对 join 的优势------连接窗口外的事件也有处可去(侧输出或异常旁路),而不是被静默丢弃。
4.3 定时器爆炸:ProcessFunction 最隐蔽的坑
定时器"同 key 同时间戳去重"听起来安全,但去重是按 key 粒度的。如果你的逻辑是"每 key 每 1 秒注册一个定时器",百万 key 就是百万定时器,而且每个定时器都要参与 checkpoint 序列化------恢复时全量反序列化,直接卡爆。
两个工程修复手段:
java
// 修复 1:事件时间对齐------只注册到下一个窗口边界(如分钟边界)
long aligned = (ts / 60_000L + 1) * 60_000L;
ctx.timerService().registerEventTimeTimer(aligned);

// 修复 2:单调推进------每个 key 只保留"最晚"的一个定时器
Long last = lastTimer.value();          // lastTimer: ValueState<Long>
if (last == null || ts > last) {
    ctx.timerService().registerEventTimeTimer(ts);
    lastTimer.update(ts);
}
对齐注册的收益是数量级级别的:1 秒粒度改成分钟边界,定时器数量直接降 60 倍。代价是触发时间有最多 1 秒的滞后------对大多数告警/统计场景完全可接受。
五、窗口函数族:从 WindowFunction 到增量聚合
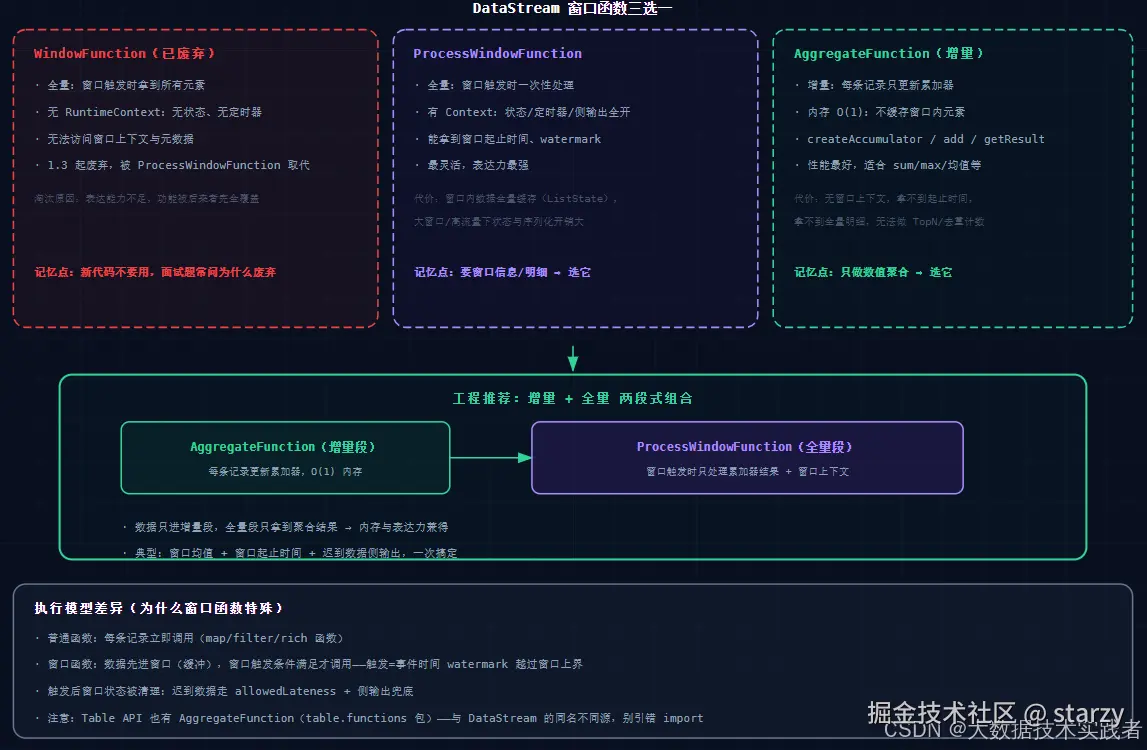
窗口函数和前面所有函数类有一个执行模型上的根本差异 :普通函数是"每条记录立即调用",窗口函数是"数据先进窗口缓冲,窗口触发时才调用"。触发条件 = 事件时间 watermark 越过窗口上界(或处理时间到点)。
三选一怎么选,先记住淘汰项:WindowFunction 已废弃(1.3 起) ------它全量处理却没有 RuntimeContext,拿不到状态、拿不到窗口上下文,能力被 ProcessWindowFunction 完全覆盖。面试官问"为什么废弃 WindowFunction",答"表达力不足、无状态访问、被 ProcessWindowFunction 取代"就到位了。
剩下两个是性能和表达力的权衡:
- AggregateFunction(增量):每条记录只更新累加器,内存 O(1),性能最好。代价:没有窗口上下文,拿不到起止时间,拿不到明细,做不了 TopN、去重计数这类需要全量信息的聚合。
- ProcessWindowFunction(全量) :窗口触发时一次性拿到窗口内所有元素,Context 里状态/定时器/侧输出全开,还能读
ctx.window().getStart()/getEnd()。代价:窗口内数据全量缓存(底层是 ListState),大窗口 + 高流量 = 状态压力。
工程上的正解是两段式组合------增量段省内存,全量段补表达:
java
stream.keyBy(Order::getProductId)
        .window(TumblingEventTimeWindows.of(Time.minutes(5)))
        .aggregate(
                // ── 增量段:每条记录只做一次累加,O(1) 内存 ──
                new AggregateFunction<Order, DoubleAccumulator, Double>() {
                    @Override
                    public DoubleAccumulator createAccumulator() {
                        return new DoubleAccumulator();
                    }
                    @Override
                    public DoubleAccumulator add(Order o, DoubleAccumulator acc) {
                        acc.add(o.amount);
                        return acc;
                    }
                    @Override
                    public Double getResult(DoubleAccumulator acc) {
                        return acc.get();
                    }
                    @Override
                    public DoubleAccumulator merge(DoubleAccumulator a, DoubleAccumulator b) {
                        a.add(b.get());   // 多并行度窗口合并时被调用
                        return a;
                    }
                },
                // ── 全量段:窗口触发时只拿到聚合结果 + 完整窗口上下文 ──
                new ProcessWindowFunction<Double, WindowStat, String, TimeWindow>() {
                    @Override
                    public void process(String key, Context ctx,
                                        Iterable<Double> agg, Collector<WindowStat> out) {
                        out.collect(new WindowStat(
                                key,
                                agg.iterator().next(),        // 增量段产出的唯一结果
                                ctx.window().getStart(),
                                ctx.window().getEnd()));
                    }
});两个实战提醒:merge() 一定要实现 ------多并行度下窗口状态合并会调用它,不实现或实现错,窗口聚合结果会算错(很多人只写 createAccumulator/add/getResult 就上线);DoubleAccumulator 用 Flink 自带的 org.apache.flink.api.common.accumulators 下的即可,不要自己维护可变 double 再踩序列化坑。
另外注意一个同名陷阱:DataStream 的 AggregateFunction 在 org.apache.flink.api.common.functions 包,Table API 的 AggregateFunction 在 org.apache.flink.table.functions 包------同名不同源,IDE 自动补全引错包,编译期大概率不报错,运行期行为完全对不上。
六、Table API/SQL 函数类:UDF 三件套
Table/SQL 层的函数类体系是另一条线:ScalarFunction(一行进一行出)、TableFunction(一行进多行出,配合 LATERAL TABLE)、AggregateFunction(多行进一行出,分组聚合)。
java
// ── 1. ScalarFunction:手机号脱敏,SQL 里当普通函数用 ──
public class MaskPhone extends ScalarFunction {
    public String eval(String phone) {
        if (phone == null || phone.length() < 7) return phone;
        return phone.substring(0, 3) + "****" + phone.substring(7);
    }
}
tableEnv.createTemporarySystemFunction("mask_phone", new MaskPhone());
// SQL: SELECT mask_phone(phone) FROM orders;

// ── 2. TableFunction:标签串展开成多行 ──
public class ExplodeTags extends TableFunction<String> {
    public void eval(String tags) {
        for (String t : tags.split(",")) {
            collect(t.trim());   // 每 collect 一次 = 输出一行
        }
    }
}
tableEnv.createTemporarySystemFunction("explode_tags", new ExplodeTags());
// SQL: SELECT t FROM orders, LATERAL TABLE(explode_tags(tags)) AS t;

// ── 3. AggregateFunction:加权平均(UDAF) ──
public class WeightedAvg extends AggregateFunction<Double, WeightedAvg.Acc> {

    public static class Acc {   // 累加器:必须可序列化的普通 POJO
        public double sum;
        public long cnt;
    }

    @Override
    public Acc createAccumulator() {
        return new Acc();
    }

    // 每行数据调用一次
    public void accumulate(Acc acc, Double value, Long weight) {
        acc.sum += value * weight;
        acc.cnt += weight;
    }

    @Override
    public Double getValue(Acc acc) {
        return acc.cnt == 0 ? 0.0 : acc.sum / acc.cnt;
    }

    // 回撤:数据被撤回流(去重、维表更新)时逆操作,实时数仓必写
    public void retract(Acc acc, Double value, Long weight) {
        acc.sum -= value * weight;
        acc.cnt -= weight;
    }
}
tableEnv.createTemporarySystemFunction("weighted_avg", new WeightedAvg());
// SQL: SELECT weighted_avg(amount, cnt) FROM orders GROUP BY product_id;
三个容易踩的:
- Table UDF 的 open 入参是
org.apache.flink.table.functions.FunctionContext,不是 DataStream 的RuntimeContext。两者能力不同(Table 的提供 getMetricGroup、getJobParameter),写代码前先确认 import。 - UDAF 必须写
accumulate,但生产环境建议连retract一起写。实时数仓的聚合经常会因为上游回撤(如去重、维表延迟更新)触发 retract,不实现会导致聚合结果只增不减。SQL 客户端里报 "AggregateFunction does not implement retract" 就是缺它。 - TableFunction 的
eval方法名固定,但参数可以重载。多写几个重载 eval 比在方法里做类型判断干净。
七、函数类避坑清单(浓缩版)
把前面散落的坑集中成一张检查单,写函数类之前过一遍:
- 序列化 :函数类必须可序列化。lambda 捕获外部非序列化变量(比如外部的连接)会在提交时炸;重量级资源一律
transient+ open 里初始化。 - lambda 的类型擦除 :
map(x -> ...)在泛型推断失败时要.returns(TypeInformation)显式声明输出类型,尤其是flatMap和 map 到复杂 POJO 时;匿名类则没这个问题。 - 状态只认 StateBackend :业务状态写普通成员变量 = checkpoint 无视它 + 重启丢光。要跨检查点存活,必须
getRuntimeContext().getState(...)。 - open 每子任务一次:初始化要按"单实例幂等"设计;构造器里拿 RuntimeContext 会 NPE。
- 定时器要数量级管理:同 key 同时间戳自动去重,但跨 key 不防爆;事件时间对齐 + 单调推进是标准解法;定时器随 checkpoint 持久化,恢复时全量反序列化------定时器太多会拖垮恢复。
- OutputTag 必须匿名类 :
new OutputTag<String>("late") {}------不带花括号的new OutputTag<>("late")在泛型擦除后拿不到类型信息,侧输出反序列化会报错。 - 窗口聚合别漏 merge/retract :增量窗口函数不实现
merge(),多并行度聚合算错;Table UDAF 不实现retract(),回撤场景结果失真。 - 同名不同源的类 :DataStream 的
AggregateFunction(api.common.functions)与 Table 的(table.functions)不要引错;ProcessFunction与ProcessWindowFunction是两个不同的类,前者处理每条记录、后者窗口触发调用。
八、总结:我的选型判断
函数类体系的本质,是 Flink 把"处理逻辑"按控制力 分层:普通函数 → 富函数 → ProcessFunction,越往下你能干预执行细节越多,代价是样板代码和心智负担越大。我的个人建议是从最小表达力开始,被需求逼着再升级:
- 纯转换/过滤 → lambda 或普通函数(还能享受算子链优化);
- 要初始化连接/配置、要计数器 → RichMapFunction / RichFlatMapFunction;
- 要 keyed state、要定时器、要侧输出、要双流对账 → KeyedProcessFunction / CoProcessFunction(没有商量余地,这是唯一解);
- 窗口统计 → 默认 AggregateFunction 增量;要窗口上下文/明细 → 增量 + ProcessWindowFunction 组合;永远不要写新的 WindowFunction;
- SQL 场景 → ScalarFunction / TableFunction / AggregateFunction 三件套,UDAF 记得写 retract。
函数类选对了,Flink 作业的稳定性、恢复速度、资源占用差一个数量级。下一篇计划深入时间语义与 Watermark 机制------定时器触发、迟到数据处理、allowedLateness 的完整原理都建立在这上面,欢迎继续关注。
(本文架构图均提供 Mermaid 可编辑源文件,位于 diagrams/ 目录,可用 mermaid.live 打开二次编辑。) 有商量余地,这是唯一解);
- 窗口统计 → 默认 AggregateFunction 增量;要窗口上下文/明细 → 增量 + ProcessWindowFunction 组合;永远不要写新的 WindowFunction;
- SQL 场景 → ScalarFunction / TableFunction / AggregateFunction 三件套,UDAF 记得写 retract。
函数类选对了,Flink 作业的稳定性、恢复速度、资源占用差一个数量级。下一篇计划深入时间语义与 Watermark 机制------定时器触发、迟到数据处理、allowedLateness 的完整原理都建立在这上面,欢迎继续关注。