上一节我们研究了sgd with momentum算法,在其基础上非常自然的就能过度到下一个优化算法NAG,全名叫Nestetrov accelerated gradient.它是对前者非常自然的过度。前面我们看到sgd with momentum算法的核心
思想就是,我们把前面前进的过程积累成一个惯性,如果当前我们落入到一个坑底(局部最优解),那么利用惯性就能冲出当前的坑底,也就是它有助于我们逃脱局部最优点,从而有机会找到全局最优点。
NAG算法在momentum的基础上就做了一点改进。如果说momentun算法是利用惯性无脑向前冲,NAG就是睁开眼往前看,如果前面是一个向上的陡坡,那么它就会及时踩刹车。我们可以感受到,由于我们没有上帝视觉,因此我们
无法得知当前处于的低点是不是全局最低点,momemtun虽然能帮我冲出当前最低点,但如果此刻的最低点已经是全局最低,那么继续往前冲不就错过了全局最优点吗。所以NAG就能避免这一点,如果它发现前面向上的陡坡足够高,
它就能及时降低速度,从而留在当前低点。这时你可能就会问了,如果全局最低点在当前低点的后面,那么NAG冲不出当前低点,不就错过了全局最低吗,确实是这样,在解决这个问题之前我们先看看NAG算法的具体逻辑。
在前面momemtun算法中,我们会积累前面的惯性,然后在当前点我们会利用以前的惯性结合现在的速度前进。如果现在是下坡,那么惯性会帮助我们加快速度往下冲,如果是上坡,惯性会帮助我们向上冲,有可能让我们冲出
当前最低点,于是有机会逃出当前局部最低点,转换为代码如下:
py
g = grad_f(x)              # 1. 在当前位置计算梯度
v = beta * v + lr * g      # 2. 累积速度
x = x - v                  # 3. 用速度更新
NAG算法就在上面的基础上做了一点点改进,它的思想是在当前点决定是否利用惯性加速前进前,先预先看一步,如果看到前面多走一步就遇到往上的陡坡,那就在当前点适当减速,具体做法如下:
py
g = grad_f(x - beta * v)   # 1. 在"预判位置"计算梯度 ← 唯一改动!
v = beta * v + lr * g      # 2. 累积速度
x = x - v # 3. 用速度更新在上面代码中,x-betav表示"向前多走一步",grad_f(x-beta v)用于计算多走一步后所在位置的梯度,如果计算的梯度是向下的(g>0),说明前面遇到一个向上的陡坡,如果向前一步是个向上的陡坡(g<0),那么它的梯度g就是一个正值,
说明"向右走"就是上坡方向,注意到v对应的是向下方向产生的能力积累,也就是惯性。如果前一步的梯度g<0,说明前面是上坡,那么lrg就是负数,由此算出的v=beta v+lr*g的数值就会减少,也就是继续向前冲的惯性降低,那么
x=x-v就使得当前点向前冲的距离变小,这就产生了前面是"墙壁",我们现在就有刹车的作用。
如果g>0,说明向前一步所在的位置是继续向下的坡度,于是g<0,v=betav+lr g 就会使得向下的惯性得到一个"能量补充",也就是betav使得向下的惯性衰减,但是lr g又补充了向下的惯性,于是v的数值衰减的小,如果g足够大,v甚至会增加,
那么x=x-v就表示我们向下冲的距离增大,也就是如果前一步还处于下坡位置,那么我们就加大向下冲的力量。
回到前面的问题,NAG的算法思想是,如果前面是上坡,那么我们要在当前点降低向前冲的力量,使得在当前点往前冲的距离变小。问题是如果全局最优点需要冲出当前最低点才能达到,那么NAG算法不就阻止我们前往最优点吗。事实上NAG算法
的作用并不是前往全局最优点,而是在抵达最优点时,减少在最优点的左右震荡。是想momemtun算法是不顾前面情况一味蒙着眼睛向前冲,那么当我们位于最优点的左边时,我们就会一下子冲到最优点的右边。位于最优点右边,
那么就会一下子冲到最优点左边,于是我们一直在最优点的左右两边晃动,一直无法停留在最低点。但是NAG算法由于预判到前面如果是上坡,那么我就在当前点立刻降低前进的速度,于是就更加容易防止一下子冲过最低点,然后在
最低点停留下来,我们看下面代码示例就能更容易明白:
py
import numpy as np
import matplotlib.pyplot as plt

# ---------- 简单二次函数 ----------
def f(x):
    return 0.5 * x**2

def grad_f(x):
    return x

# ---------- 三种优化器 ----------
def sgd(start, lr=0.9, epochs=20):
    x = start
    path = [x]
    for _ in range(epochs):
        x = x - lr * grad_f(x)
        path.append(x)
    return np.array(path)

def momentum(start, lr=0.9, beta=0.9, epochs=20):
    x = start
    v = 0.0
    path = [x]
    for _ in range(epochs):
        g = grad_f(x)
        v = beta * v + lr * g
        x = x - v
        path.append(x)
    return np.array(path)

def nag(start, lr=0.9, beta=0.9, epochs=20):
    x = start
    v = 0.0
    path = [x]
    for _ in range(epochs):
        pos_ahead = x - beta * v      # 预判位置
        g = grad_f(pos_ahead)          # 在预判位置算梯度
        v = beta * v + lr * g
        x = x - v
        path.append(x)
    return np.array(path)

# ---------- 运行 ----------
start = 5.0
epochs = 20

path_sgd = sgd(start, lr=0.9, epochs=epochs)
path_mom = momentum(start, lr=0.9, beta=0.9, epochs=epochs)
path_nag = nag(start, lr=0.9, beta=0.9, epochs=epochs)

# 打印每步的 x 值
print("Step |    SGD    |  Momentum |    NAG")
print("-" * 45)
for i in range(epochs + 1):
    print(f"{i:4d} | {path_sgd[i]:+9.4f} | {path_mom[i]:+9.4f} | {path_nag[i]:+9.4f}")

print("\n最终位置:")
print(f"SGD:       x={path_sgd[-1]:+.6f}, f={f(path_sgd[-1]):.6f}")
print(f"Momentum:  x={path_mom[-1]:+.6f}, f={f(path_mom[-1]):.6f}")
print(f"NAG:       x={path_nag[-1]:+.6f}, f={f(path_nag[-1]):.6f}")
print("全局最小: x=0, f=0")

# ---------- 绘制损失曲线 ----------
plt.figure(figsize=(12, 5))

plt.subplot(1, 2, 1)
plt.plot([f(x) for x in path_sgd], 'r.-', label='SGD')
plt.plot([f(x) for x in path_mom], 'g.-', label='Momentum')
plt.plot([f(x) for x in path_nag], 'b.-', label='NAG')
plt.xlabel('Iteration')
plt.ylabel('Loss f(x)')
plt.title('损失下降曲线')
plt.legend()
plt.grid(True)

plt.subplot(1, 2, 2)
plt.plot(path_sgd, 'r.-', label='SGD')
plt.plot(path_mom, 'g.-', label='Momentum')
plt.plot(path_nag, 'b.-', label='NAG')
plt.axhline(0, color='k', linestyle='--', alpha=0.3)
plt.xlabel('Iteration')
plt.ylabel('x 值')
plt.title('参数轨迹')
plt.legend()
plt.grid(True)

plt.tight_layout()
plt.show()
上面代码运行后结果如下:
py
Step |    SGD    |  Momentum |    NAG
---------------------------------------------
   0 |   +5.0000 |   +5.0000 |   +5.0000
   1 |   +0.5000 |   +0.5000 |   +0.5000
   2 |   +0.0500 |   -4.0000 |   -0.3550
   3 |   +0.0050 |   -4.4500 |   -0.1125
   4 |   +0.0005 |   -0.8500 |   +0.0106
   5 |   +0.0000 |   +3.1550 |   +0.0121
   6 |   +0.0000 |   +3.9200 |   +0.0014
   7 |   +0.0000 |   +1.0805 |   -0.0008
   8 |   +0.0000 |   -2.4475 |   -0.0003
   9 |   +0.0000 |   -3.4200 |   +0.0000
  10 |   +0.0000 |   -1.2172 |   +0.0000
  11 |   +0.0000 |   +1.8608 |   +0.0000
  12 |   +0.0000 |   +2.9562 |   -0.0000
  13 |   +0.0000 |   +1.2816 |   -0.0000
  14 |   +0.0000 |   -1.3791 |   +0.0000
  15 |   +0.0000 |   -2.5325 |   +0.0000
  16 |   +0.0000 |   -1.2913 |   +0.0000
  17 |   +0.0000 |   +0.9879 |   -0.0000
  18 |   +0.0000 |   +2.1501 |   -0.0000
  19 |   +0.0000 |   +1.2610 |   +0.0000
  20 |   +0.0000 |   -0.6741 |   +0.0000

最终位置:
SGD:       x=+0.000000, f=0.000000
Momentum:  x=-0.674106, f=0.227210
NAG:       x=+0.000000, f=0.000000
全局最小: x=0, f=0
绘制的图像如下:
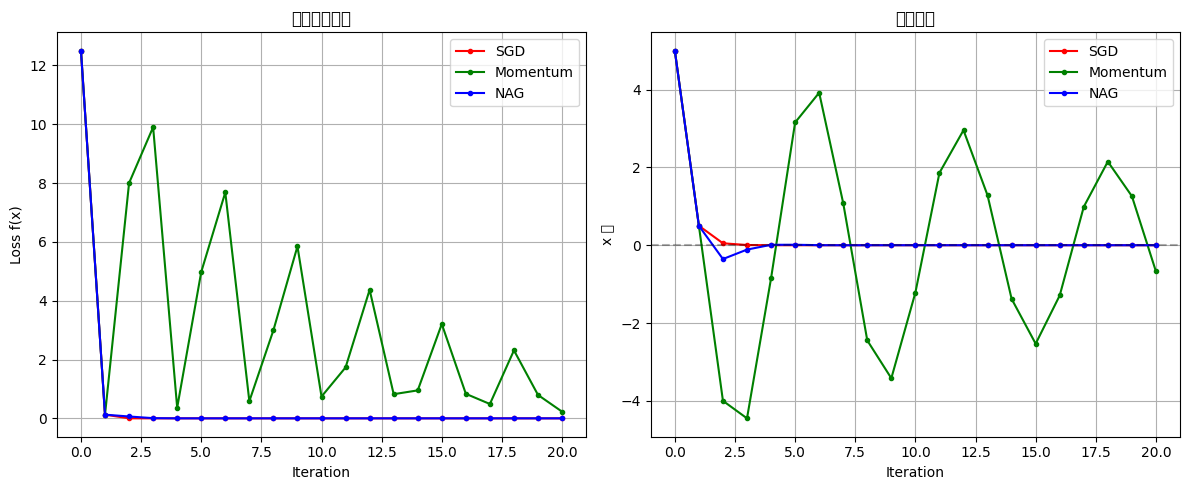
从运行结果看sgd的效果更好,基于sgd改进的两个算法momentu和nag反而要差一些,原因在于不同算法在不同目标函数面前产生的效果不一样,有些在特定函数效果好,在另一些函数,其他算法会更好。但从图像看NAG算法
对应的紫色线条其抖动是最小的,也就是它走的更平稳,绿色对应的momemtun算法抖动非常厉害,抖动厉害的算法有点是容易冲出当前最低点,缺点就是在最低点处容易左右震荡而难以收敛。