本文概览:本文讲解编辑距离的核心思路:dpij 表示 word1 前 i 个字符转成 word2 前 j 个字符的最少操作数;两个字符相等就跳过(不花操作),不相等就在删除、插入、替换三种手段里选最省的;方法一是二维 DP,方法二只保留上一行把空间降到 O(m)
一、题目
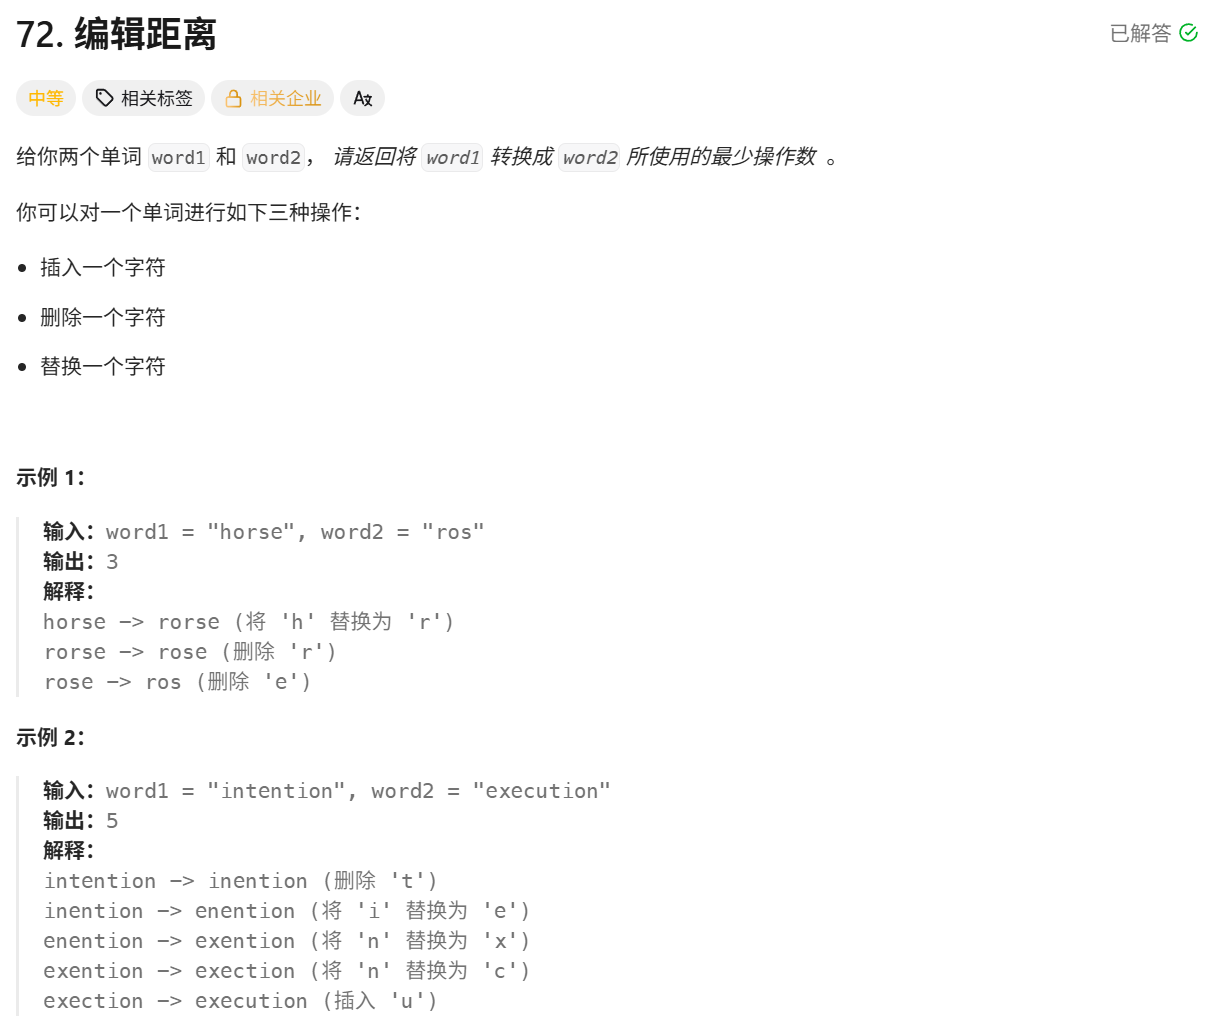
二、题目分析
1. 题目要求
给你两个单词 word1 和 word2,返回将 word1 转换成 word2 所使用的最少操作数。
你可以对一个单词进行以下三种操作:
- 插入一个字符
- 删除一个字符
- 替换一个字符
示例 1 :word1 = "horse", word2 = "ros" → 3
horse → rorse(替换 h→r)→rorse → rose(删除 r)→rose → ros(删除 e)
示例 2 :word1 = "intention", word2 = "execution" → 5
2. 怎么想这题?
先看看暴力能不能做。每一步都有三种操作可选,走一步分三岔、走两步分九岔......操作数一多,分支就是 3^k 级别地爆开,枚举不完。这条路直接堵死。
换个角度,想想"操作"这件事到底在干什么。插入、删除、替换,一次只动一个字符,而且动完之后,两个字符串就各自"往前推进了一格"。也就是说,整个过程就是两个字符串一个字一个字地往前对,对到哪儿、花了多少步,是可以被"记住"的。
这和上一篇《最长公共子序列》是同一个姿势:两个串各自都有进度。设 word1 看到第 i 个字符、word2 看到第 j 个字符,把状态定成
dp[i][j] = word1 的前 i 个字符 转成 word2 的前 j 个字符 需要的最少操作数要求的就是 dp[n][m](两个整串)。接下来只需要想清楚:(i, j) 这个局面,怎么由更小的局面推出来。
先看最简单的情况:这两个位置的字符正好相等。
比如 word1 的第 i 个字符和 word2 的第 j 个字符都是 a。那这个 a 根本不用动------不用插入、不用删除、不用替换,它俩天然就对上了。既然不动,就等于这两个字符可以一起"消掉",问题直接退化成"前 i-1 个转成前 j-1 个",操作数一次都不花。
再看不一样的。 这时必须动手,而手里正好有三张牌:删除、插入、替换。每种牌打出去之后,"剩下的问题"是不同的小局面------有的变成前 i-1 对前 j,有的变成前 i 对前 j-1,有的变成前 i-1 对前 j-1。搞清楚每张牌对应哪个小局面、再取最省的那张,这题就通了。
3. 需要解决哪几个问题?
问题一 :两个字符不相等时,删除、插入、替换这三种操作,各自把问题变成了哪个更小的局面?为什么?
问题二 :初值怎么填?word1 或 word2 为空串的时候是多少步?
问题三(进阶):二维表能不能压成一维数组?
三、方法一:二维 DP,O(n × m) 空间
1. 思路概览
java
public int minDistance(String word1, String word2) {
    int n = word1.length(), m = word2.length();
    int[][] dp = new int[n + 1][m + 1];
    // 初值:word2 为空,word1 前 i 个只能全删,i 步
    for (int i = 0; i <= n; i++) {
        dp[i][0] = i;
    }
    // 初值:word1 为空,只能靠插入凑出 word2 前 j 个,j 步
    for (int j = 0; j <= m; j++) {
        dp[0][j] = j;
    }
    for (int i = 1; i <= n; i++) {
        for (int j = 1; j <= m; j++) {
            if (word1.charAt(i - 1) == word2.charAt(j - 1)) {
                dp[i][j] = dp[i - 1][j - 1];              // 相等,跳过,不花操作
            } else {
                dp[i][j] = 1 + Math.min(Math.min(dp[i - 1][j],    // 删除
                                                 dp[i][j - 1]),   // 插入
                                                 dp[i - 1][j - 1]); // 替换
            }
        }
    }
    return dp[n][m];
}
思路简要说明:
- 状态定义 :
dp[i][j]= word1 前i个字符转成 word2 前j个字符的最少操作数 - 转移 :字符相等 →
dp[i-1][j-1];不等 →1 + min(删除, 插入, 替换) - 初值 :
dp[i][0] = i(全删)、dp[0][j] = j(全插) - 时间复杂度 O(n × m),空间 O(n × m)
2. 思路详解
第一步:解决状态定义
dp[i][j] 处理的是两个前缀 :word1 的前 i 个字符、word2 的前 j 个字符。之所以用前缀而不是整串,是因为每做一次操作,问题都在往"更短的前缀"上退,一路退到空串为止。答案 dp[n][m] 就是把前缀推到头。
第二步:解决转移方程
情况一:两个字符相等(word1[i-1] == word2[j-1])。
这两个字符天然对得上,三种操作都用不着。既然什么都不用做,就相当于把它们一并从两边拿掉,问题退化成"前 i-1 个转前 j-1 个":
dp[i][j] = dp[i-1][j-1]注意这里不加 1------因为这一步没花任何操作。
情况二:两个字符不相等。
这时必须动手,三种手段挨个看它把问题变成了什么。
① 删除:删掉 word1 的第 i 个字符。
既然它和 word2 的第 j 个对不上,干脆把它抹掉,让它从此不再参与比较。删掉之后,word1 剩下的就是前 i-1 个,而 word2 那边一个都没少,仍然要凑出前 j 个。所以问题变成"前 i-1 个转前 j 个":
删除的代价 = dp[i-1][j] + 1(那个 +1 就是这一次删除操作本身。)
② 插入:在 word1 的第 i 个字符后面,插入一个和 word2 第 j 个字符相同的字符。
这个稍微绕一点,举个例子。word1 = "ab"、word2 = "abc":word1 的 b 对着 word2 的 c,对不上。这时候最优解是在 b 后面插入一个 c ------插入的这个 c 正好顶替 word2 的第 3 个字符,于是 word1 这边"凑齐了前 3 个",而 word2 的那一位也就被消化掉了,剩下要管的只是"前 2 个转前 2 个"。
所以一次插入,等于用掉 word2 的第 j 个字符 ,问题变成"前 i 个转前 j-1 个":
插入的代价 = dp[i][j-1] + 1③ 替换:把 word1 的第 i 个字符改成 word2 的第 j 个字符。
这个最直白。改完之后这两个字符就相等了------也就回到"情况一":这一对字符可以一起消掉。所以问题变成"前 i-1 个转前 j-1 个":
替换的代价 = dp[i-1][j-1] + 1三种手段取最省:
dp[i][j] = 1 + min(dp[i-1][j], dp[i][j-1], dp[i-1][j-1])
          (删)        (插)      (替)
三种手段能覆盖所有走法------面对一对对不上的字符,无非就是"不要 word1 的这个"(删)、"不要 word2 的那个"(插)、"原地把它改成对方"(替)。所以取三者最小就不会漏最优解。
第三步:解决初值------空串怎么办?
边界就是"其中一边为空"的情形,没法再靠转移方程推,得单独定:
dp[i][0] = i:word2 是空串,word1 前i个字符要变成空,只能一个一个全删掉 →i步。dp[0][j] = j:word1 是空串,要凑出 word2 的前j个字符,只能一个一个全插入 →j步。
这两个初值也顺带回答了"dp[0][0] = 0":两个都是空串,不用动。
第四步:完整执行过程
以示例 1,word1 = "horse"、word2 = "ros"(答案是 3)为例:
          word2
      ""  r    o    s
""     0   1    2    3      ← 初值:word1 空,全插入
h      1   1    2    3      ← h!=r:min(删1, 插1, 替0)+1 = 1
o      2   2    1    2      ← o==o:等于 dp[1][1] = 1
r      3   2    2    2      ← r==r:等于 dp[2][1] = 2
s      4   3    3    2      ← s==s:等于 dp[3][2] = 2
e      5   4    4    3      ← e!=s:min(删2, 插4, 替3)+1 = 3
挑几个格子看:
dp[1][1]:'h' != 'r' → 1 + min(dp[0][1]=1, dp[1][0]=1, dp[0][0]=0) = 1
dp[2][2]:'o' == 'o' → dp[1][1] = 1
dp[3][2]:'r' != 'o' → 1 + min(dp[2][2]=1, dp[3][1]=2, dp[2][1]=2) = 2
dp[4][3]:'s' == 's' → dp[3][2] = 2
dp[5][3]:'e' != 's' → 1 + min(dp[4][3]=2, dp[5][2]=4, dp[4][2]=3) = 3
最后 dp[5][3] = 3 ✓。注意 dp[4][3] = 2 那一格,说明 "hors" → "ros" 只要 2 步(把 h 换成 r、删掉 r);再拿 e 这一格看,末尾的 e 和 s 对不上,删掉它 1 步就够,所以最终 3 步。
3. 复杂度分析
时间复杂度 O(n × m):两层循环,每格常数次比较。
空间复杂度 O(n × m):完整二维表。
四、二维表里其实只用到"上一行"
看转移方程,dp[i][j] 用到的还是那三个老邻居。把表按行列摆好,i 是行、j 是列:
               列 j-1              列 j
行 i-1    dp[i-1][j-1]        dp[i-1][j]
行 i dp[i][j-1] dp[i][j] ← 当前要算的dp[i-1][j]:同一列、上一行 → 正上方dp[i][j-1]:同一行、上一列 → 正左方dp[i-1][j-1]:上一行、上一列 → 左上方(对角线)
也就是说,算第 i 行只用到上一行整行和当前行左边一格,第 i-2 行及更早的都用不上了。和上一篇一样,可以把两行挤进同一个一维数组。滚动时有两个 地方要留神:对角线 dp[i-1][j-1] 会被覆盖(要用 prev 提前存住),还有第一列 dp[i][0] 每行都在变(得单独更新)。
五、方法二:一维滚动数组,O(m) 空间
1. 思路概览
java
public int minDistance(String word1, String word2) {
    int n = word1.length(), m = word2.length();
    int[] dp = new int[m + 1];
    // 初值:等价于二维表的第一行(word1 为空,全插入)
    for (int j = 0; j <= m; j++) {
        dp[j] = j;
    }
    for (int i = 1; i <= n; i++) {
        int prev = dp[0];   // 对角线 dp[i-1][j-1],逐列往后挪
        dp[0] = i;          // 第一列 dp[i][0] = i(word2 为空,全删)
        for (int j = 1; j <= m; j++) {
            int temp = dp[j];   // 先存下旧值 dp[i-1][j],下一列当对角线用
            if (word1.charAt(i - 1) == word2.charAt(j - 1)) {
                dp[j] = prev;
            } else {
                dp[j] = 1 + Math.min(Math.min(dp[j], dp[j - 1]), prev);
            }
            prev = temp;
        }
    }
    return dp[m];
}
思路简要说明:
- 状态定义 :
dp[j]表示当前行第j列的值,随i逐行滚动 - 初值 :
dp[j] = j,正是二维表第一行 - 每行开头 :
dp[0] = i,补上第一列的边界 - 对角线 :用
prev提前存住,否则会被覆盖 - 时间复杂度 O(n × m),空间 O(m)
2. 思路详解
第一步:初始化为什么是 dp[j] = j?
一维的 dp 对应"当前行"。外层 i 从 1 开始,进循环之前,dp 得先装好二维表的第一行------也就是"word1 为空,凑 word2 前 j 个要插 j 次",正好是 dp[j] = j。
第二步:为什么每行开头要写 dp[0] = i?
看二维表的第一列:dp[i][0] 表示"word1 前 i 个转成空串",答案是 i(全删)。它是逐行变化的:第 1 行是 1、第 2 行是 2......
而 dp[0] 在滚动数组里从头到尾不进内层循环(j 从 1 开始),如果不管它,它就永远停在初值 0 上。所以每进一行,得手动把它更新成当前行的值:
java
dp[0] = i;这一步是这题比《最长公共子序列》多出来的地方------那题的 dp[0] 恒为 0,不需要管;这题的第一列是 1、2、3......必须自己维护。
第三步:prev 为什么还在?
内层循环里,dp[j] 要在被覆盖前先读出它代表的东西:
dp[j](还没覆盖时)是上一行同列 的dp[i-1][j]→ 就是"正上方";dp[j-1](本列之前已更新)是本行前一列 的dp[i][j-1]→ 就是"正左方";- 而对角线
dp[i-1][j-1]在算dp[j-1]时就已经被顶掉了,所以要用prev提前留住它。
prev 的接力过程就是:上一列循环里存下的 temp(也就是 dp[i-1][j-1]),在本列开头赋给 prev 用掉;然后本列自己的旧值 dp[j] 又存进 temp,留给下一列当对角线。这一句 int temp = dp[j]; ... prev = temp; 和《最长公共子序列》里那段完全一样。
注意 prev 的初值 是 dp[0],也就是 dp[i-1][0] = i-1------它正好是第 1 列的对角线,衔接上了。
第四步:完整执行过程
仍是 word1 = "horse"、word2 = "ros"(m=3)。初始 dp = [0, 1, 2, 3]:
i=1 ('h'):prev = dp[0] = 0,dp[0] = 1
  j=1: temp=1;h!=r → dp[1] = 1 + min(dp[1]=1, dp[0]=1, prev=0) = 1;prev=1 → [1,1,2,3]
  j=2: temp=2;h!=o → dp[2] = 1 + min(dp[2]=2, dp[1]=1, prev=1) = 2;prev=2 → [1,1,2,3]
  j=3: temp=3;h!=s → dp[3] = 1 + min(dp[3]=3, dp[2]=2, prev=2) = 3;prev=3 → [1,1,2,3]

i=2 ('o'):prev = dp[0] = 1,dp[0] = 2
  j=1: temp=1;o!=r → dp[1] = 1 + min(dp[1]=1, dp[0]=2, prev=1) = 2;prev=1 → [2,2,2,3]
  j=2: temp=2;o==o → dp[2] = prev = 1;prev=2                     → [2,2,1,3]
  j=3: temp=3;o!=s → dp[3] = 1 + min(dp[3]=3, dp[2]=1, prev=2) = 2;prev=3 → [2,2,1,2]

i=3 ('r'):prev = dp[0] = 2,dp[0] = 3
  j=1: temp=2;r==r → dp[1] = prev = 2;prev=2                     → [3,2,1,2]
  j=2: temp=1;r!=o → dp[2] = 1 + min(dp[2]=1, dp[1]=2, prev=2) = 2;prev=1 → [3,2,2,2]
  j=3: temp=2;r!=s → dp[3] = 1 + min(dp[3]=2, dp[2]=2, prev=1) = 2;prev=2 → [3,2,2,2]

i=4 ('s'):prev = dp[0] = 3,dp[0] = 4
  j=1: temp=2;s!=r → dp[1] = 1 + min(dp[1]=2, dp[0]=4, prev=3) = 3;prev=2 → [4,3,2,2]
  j=2: temp=2;s!=o → dp[2] = 1 + min(dp[2]=2, dp[1]=3, prev=2) = 3;prev=2 → [4,3,3,2]
  j=3: temp=2;s==s → dp[3] = prev = 2;prev=2                     → [4,3,3,2]

i=5 ('e'):prev = dp[0] = 4,dp[0] = 5
  j=1: temp=3;e!=r → dp[1] = 1 + min(dp[1]=3, dp[0]=5, prev=4) = 4;prev=3 → [5,4,3,2]
  j=2: temp=3;e!=o → dp[2] = 1 + min(dp[2]=3, dp[1]=4, prev=3) = 4;prev=3 → [5,4,4,2]
  j=3: temp=2;e!=s → dp[3] = 1 + min(dp[3]=2, dp[2]=4, prev=3) = 3;prev=2 → [5,4,4,3]

返回 dp[3] = 3 ✓
每一轮结束时的 dp,正好等于二维表里对应的那一行:
方法一逐行结果:          dp 滚动结果:
[0, 1, 2, 3](第一行)→   [0, 1, 2, 3]
[1, 1, 2, 3](h 行)  →   [1, 1, 2, 3]
[2, 2, 1, 2](o 行)  →   [2, 2, 1, 2]
[3, 2, 2, 2](r 行)  →   [3, 2, 2, 2]
[4, 3, 3, 2](s 行)  →   [4, 3, 3, 2]
[5, 4, 4, 3](e 行)  →   [5, 4, 4, 3]
看 i=2 的 j=2(o == o):用的是 prev = 1,也就是对角线的旧值,得 1;要是错读成已经被覆盖的 dp[1],就会算错。
3. 复杂度分析
时间复杂度 O(n × m):循环规模不变。
空间复杂度 O(m):只留一行,从 O(n × m) 降到 O(m)。
六、总结
| 维度 | 方法一 二维 DP | 方法二 一维滚动 |
|---|---|---|
| 状态 | dp[i][j] 两个前缀 |
dp[j] 只保留当前行 |
| 相等时 | dp[i-1][j-1](不花操作) |
取 prev |
| 不等时 | 1 + min(上方, 左方, 对角线) |
1 + min(dp[j], dp[j-1], prev) |
| 每行要做两件事 | ------ | dp[0] = i,prev = 旧 dp[0] |
| 空间 | O(n × m) | O(m) |
这道题的转移方程不用背,它就是从"一次操作到底改了什么"推出来的:
- 字符相等 → 天然对上,不用动,直接把这一对消掉,
dp[i-1][j-1],不加 1。 - 字符不等 → 三种手段各对应一个更小的局面:
- 删除 word1 的第
i个 → 它不再参与 → 前i-1对前j,即dp[i-1][j]; - 插入一个字符顶替 word2 的第
j个 → 用掉了这一位 → 前i对前j-1,即dp[i][j-1]; - 替换 word1 的第
i个成对方 → 变成"相等",一起消掉 → 前i-1对前j-1,即dp[i-1][j-1]。
- 删除 word1 的第
三种手段穷尽了所有走法,取最小就是最优。把这套 dp[i][j] 填成二维表后,发现只用得到上一行,再用 prev 把对角线救下来,就压成了一维------比上一篇多做的一件事情是:第一列 dp[i][0] 每行都在变,得自己用 dp[0] = i 维护。