论文原标题:HuMoCon: Concept Discovery for Human Motion Understanding
这是一篇发表在 2025年 计算机视觉顶会 CVPR 的正式论文,属于多模态大语言模型(MLLM)应用于人体运动理解的前沿工作。
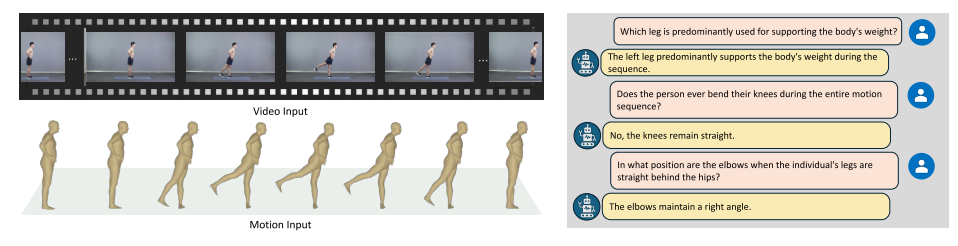
一、问题背景:
1. 单一模态有硬伤
人体行为理解可以用两种数据:
-
视频:上下文丰富,能看环境、物体交互,但包含大量无关信息。例如模型可能学到"跑步大多在体育场",于是把体育场里的其他活动也误判成跑步。
-
运动/骨架:轻量、隐私友好、精确描述身体关节运动,但缺少环境上下文。例如"打高尔夫"和"扫地"的骨架可能相似,只看骨架很难区分。
所以,视频和运动是互补的:视频提供"在什么场景",运动提供"身体具体怎么动"。
2. 现有多模态方法的问题
以 MotionLLM 为代表的方法虽然同时用视频和运动,但它只是隐式对齐 ------在 LLM 微调阶段用配对数据让模型自己学,没有在编码器预训练阶段显式对齐视频和运动特征。这导致特征语义不够强、跨模态一致性不足。
3. 掩码自编码器的通病
很多方法用 掩码自编码器(MAE) 预训练编码器 :遮住一部分输入,让模型重建 。这能学到低频整体 结构,但会丢失高频信息 ,导致重建结果 时间上"过平滑",动作细节 (速度、突变、节奏)被抹掉,不利于理解细微运动。
所以,论文提出HuMoCon,其核心主张 :用一个"人类运动概念发现 "框架,显式对齐视频和运动特征 ,并通过"速度重建"保留高频动态信息 ,让编码器学到既语义丰富又细节敏感的表示 ,最终提升 LLM 对视频/运动的理解与推理能力。
二、主要贡献:
-
提出 HuMoCon 框架 :一个用于人类运动概念发现和视频-运动理解的 LLM 系统。
-
显式特征对齐策略 :在编码器预训练阶段 ,就用配对的视频-运动数据显式对齐两种模态 。视频负责上下文理解 ,运动 负责细粒度 交互建模。
-
速度重建机制 :在掩码自编码器中加入"速度重建 ",重建光流/运动差分,保留高频信息,缓解时间过平滑。
三、创新点:
整体框架流程:用视频和运动数据预训练编码器 :通过 VQ-VAE 把特征量化成"运动概念 ",并用掩码重建、速度重建、判别信息、可操作信息和显式对齐 四类目标训练编码器 ;然后训练投影层 把编码特征映射到 LLM 空间 ;最后冻结编码器和投影层 ,用 LoRA 指令微调 LLM ,使其能根据视频或运动输入回答问题。
创新点1:显式跨模态特征对齐
-
从 Motion-X 中取按帧对齐的视频-运动对。
-
用两个投影层 Pu 和 Pm 分别把视频离散特征和运动离散特征映射到共享对齐空间。
-
用对齐损失 Lalign让同一时刻的视频帧特征和运动帧特征相似,同时与其他运动帧不相似。
-
这样编码器学到的特征天然跨模态一致,而不是等到 LLM 微调才"临时抱佛脚"。
创新点2:速度重建保留高频信息
-
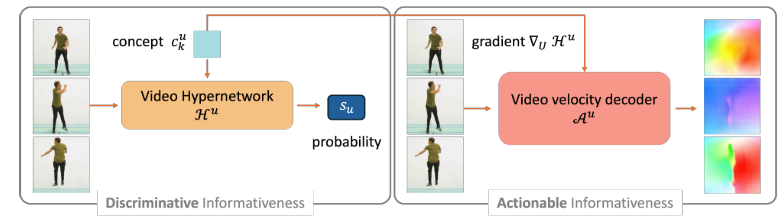
普通掩码重建只重建"状态"(姿势、画面),容易过平滑。
-
HuMoCon 还重建"速度":
-
视频:重建 光流 O。
-
视频编码:
-
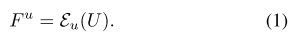
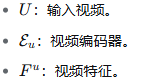
通俗例子:把一段篮球视频输入视频编码器,得到一串高维特征向量。
-
运动:重建 运动差分 δM。
-
为了更好重建速度,引入两个目标:
-
判别信息(Discriminative Informativeness):用超网络根据码本概念生成分类器,判断某个状态是否属于某个概念,提高特征区分度。
-
可操作信息(Actionable Informativeness):利用判别器的梯度作为输入,预测速度。梯度变化反映状态变化,从而捕捉动态。
-
创新点3:VQ-VAE 码本作为"运动概念"
-
把连续视频/运动特征量化到离散码本 Cu、Cm。
-
码本中的每个码字可视为一个"运动概念",例如"抬手""屈膝""转身"。
-
掩码重建和速度重建共同优化这些概念,使其既包含整体结构,又保留高频细节。
量化到码本:
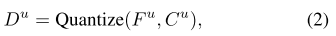
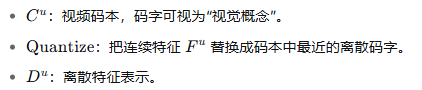
通俗例子:把"连续的视频特征"翻译成"离散概念编号",比如第 21 号概念代表"抬手",第 47 号代表"屈膝"。
创新点4:两阶段 LLM 适配
-
模态翻译阶段:冻结编码器和 LLM,只训练投影层,把编码特征映射到 LLM 能理解的空间。
-
多模态指令微调阶段:冻结编码器和投影层,用 LoRA 微调 LLM,让模型根据视频/运动输入回答问题。
掩码:
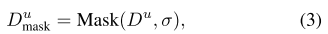
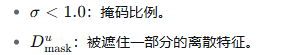
通俗例子:把一段动作中 70% 的帧遮住,只留下 30% 让模型猜。
解码重建:
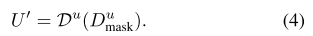
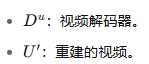
- 通俗例子:模型根据残缺概念猜出完整视频。
总损失:
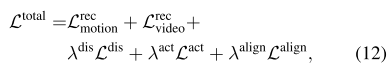
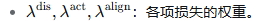
通俗例子:总目标 = 视频重建 + 运动重建 + 判别概念 + 重建速度 + 跨模态对齐,五项一起优化,让编码器学到既完整又细粒度、且视频-运动一致的表示。
四、比较基准与数据集:
比较基准
-
BABEL-QA:2s-AGCN-M/R、MotionCLIP-M/R、MotionLLM,以及 HuMoCon(生成式)。
-
ActivityNet-QA:FrozenBiLM、VideoChat、LLaMA-Adapter、Video-LLaMA、Video-ChatGPT、Video-LLaVA、VideoChat2、MotionLLM。
-
消融:去掉掩码重建、去掉速度重建、去掉对齐损失,分别比较。
数据集
-
预训练:
-
Motion-X:81K 运动序列,36K 视频-运动配对。
-
HumanML3D:10K 注释数据用于模态翻译。
-
VATEX:20K 注释视频用于视频翻译器训练。
-
-
指令微调:
-
200K 运动/视频 Q&A 对。
-
VideoChatGPT:100K Q&A。
-
BABEL-QA:2K Q&A。
-
-
评估:
-
ActivityNet-QA:视频问答。
-
BABEL-QA:运动问答。
-
总结:
这篇论文证明了 "编码器特征质量 > 模型规模" ------不需要改变 LLM 架构,只需要在编码器预训练阶段做两件事:①显式对齐视频和运动特征 (让两种模态在编码阶段就共享语义空间,而非等到 LLM 微调时才隐式对齐),②速度重建 (重建光流和运动增量,保留被掩码自编码器丢失的高频细节,避免时序过度平滑),就能让运动-视频理解在 BABEL-QA 上从 MotionLLM 的 0.436 飙升到 0.711,提升近 60%。这是一种 "编码器先行、对齐与高频并重" 的低成本策略,为未来多模态人体运动理解提供了坚实的起点。在 BABEL-QA 上大幅超越 MotionLLM,在 ActivityNet-QA 上也取得领先,证明了"显式跨模态对齐 + 高频速度重建"是提升人体运动理解的有效路径。