最近接连跑通了两个 LLM 应用的小 Demo:先是一个 RAG 私有文档问答,然后是一个 ReAct 模式的旅行助手 Agent。最大的收获不是代码本身,而是终于搞明白了一件天天被提但一直模模糊糊的事------RAG 和 Agent 到底差在哪。
第一站:RAG------让模型"知道"我的文档
第一个 Demo 很经典:让 LLM 回答它训练数据里不可能有的问题------我自己的笔记。
流程两条管线:
ini
# 建索引:markdown 文档 → 切成 500 字的块 → 算 embedding → 存进 Chroma
chunks = chunk_text(text, size=500, overlap=50)
embeddings = embedder.encode(chunks)
collection.add(ids=..., documents=chunks, embeddings=embeddings)
ini
# 查询:问题 → 向量检索 top3 → 拼进 prompt → 调一次 LLM 生成回答
def answer(question: str) -> str:
    chunks = retrieve(question)          # 检索最相似的 3 块
    prompt = PROMPT_TEMPLATE.format(context=..., question=question)
    response = CLIENT.chat.completions.create(...)
    return response.choices[0].message.content
跑通之后回头看,RAG 的特点非常明显:
- 流程是代码写死的:检索 → 拼 prompt → 生成,永远这三步,一步不会多
- LLM 只被调用一次,它自始至终不知道"检索"这件事的存在
- LLM 的角色是拿着参考资料的答题者------你喂它三段资料,它负责好好回答,答不出就说"文档里没说"
一句话:RAG 解决的是"知道"的问题------把模型不知道的私有知识,现场塞给它。
第二站:Agent------让模型"做事"
第二个 Demo 是一个旅行助手,任务一句话:查北京今天的天气,然后根据天气推荐景点。
注意这是个两步任务,而且第二步依赖第一步的结果。如果是普通程序,我们得自己写"先查天气、再搜景点"的调度逻辑。但 Agent 的做法是:只给模型工具,让模型自己决定怎么串。
工具就是两个普通 Python 函数,没有任何特殊之处:
python
def get_weather(city: str) -> str:
data = requests.get(f"https://wttr.in/{city}?format=j1", timeout=10).json()
cur = data["current_condition"][0]
return f"{city}当前天气:{cur['weatherDesc'][0]['value']},气温{cur['temp_C']}摄氏度"
def get_attraction(city: str, weather: str) -> str:
result = tavily.search(query=f"{city} 适合{weather}天气的旅游景点推荐", max_results=3)
return "根据搜索,为您找到以下信息:" + ";".join(r["title"] for r in result["results"])然后在 System Prompt 里告诉模型有哪些工具、按什么格式说话(Thought / Action / Observation 协议),核心循环长这样:
css
for i in range(1, MAX_LOOPS + 1):
# ① 问模型下一步干嘛
reply = llm.chat.completions.create(model=MODEL, messages=messages).choices[0].message.content
# ② 模型说"信息够了" → 结束
if "Final Answer" in reply:
return reply.split("Final Answer:")[-1]
# ③ 抠出工具名和参数,真正执行
tool_name, args = parse_action(reply)
observation = TOOLS[tool_name](**args)
# ④ 关键:把工具结果拼成 Observation 喂回对话,进入下一轮
messages.append({"role": "assistant", "content": reply})
messages.append({"role": "user", "content": f"Observation: {observation}"})实际跑起来的输出(真实运行结果节选):
vbnet
--- 循环 1 ---
Thought: 用户需要先查询北京今天的天气......第一步先调用天气查询工具。
Action: get_weather(city="北京")
Observation: 北京当前天气:Sunny,气温27摄氏度
--- 循环 2 ---
Thought: 北京今天是晴天,气温27摄氏度,适合户外活动。接下来根据这个天气条件调用景点推荐工具。
Action: get_attraction(city="北京", weather="Sunny")
Observation: 根据搜索,为您找到以下信息:北京在sunny天气下最值得去的旅游景点推荐及理由;......
--- 循环 3 ---
Thought: 工具返回了景点推荐结果......
Final Answer: 北京今天天气晴朗,气温约27°C,非常适合户外游玩......执行结果: 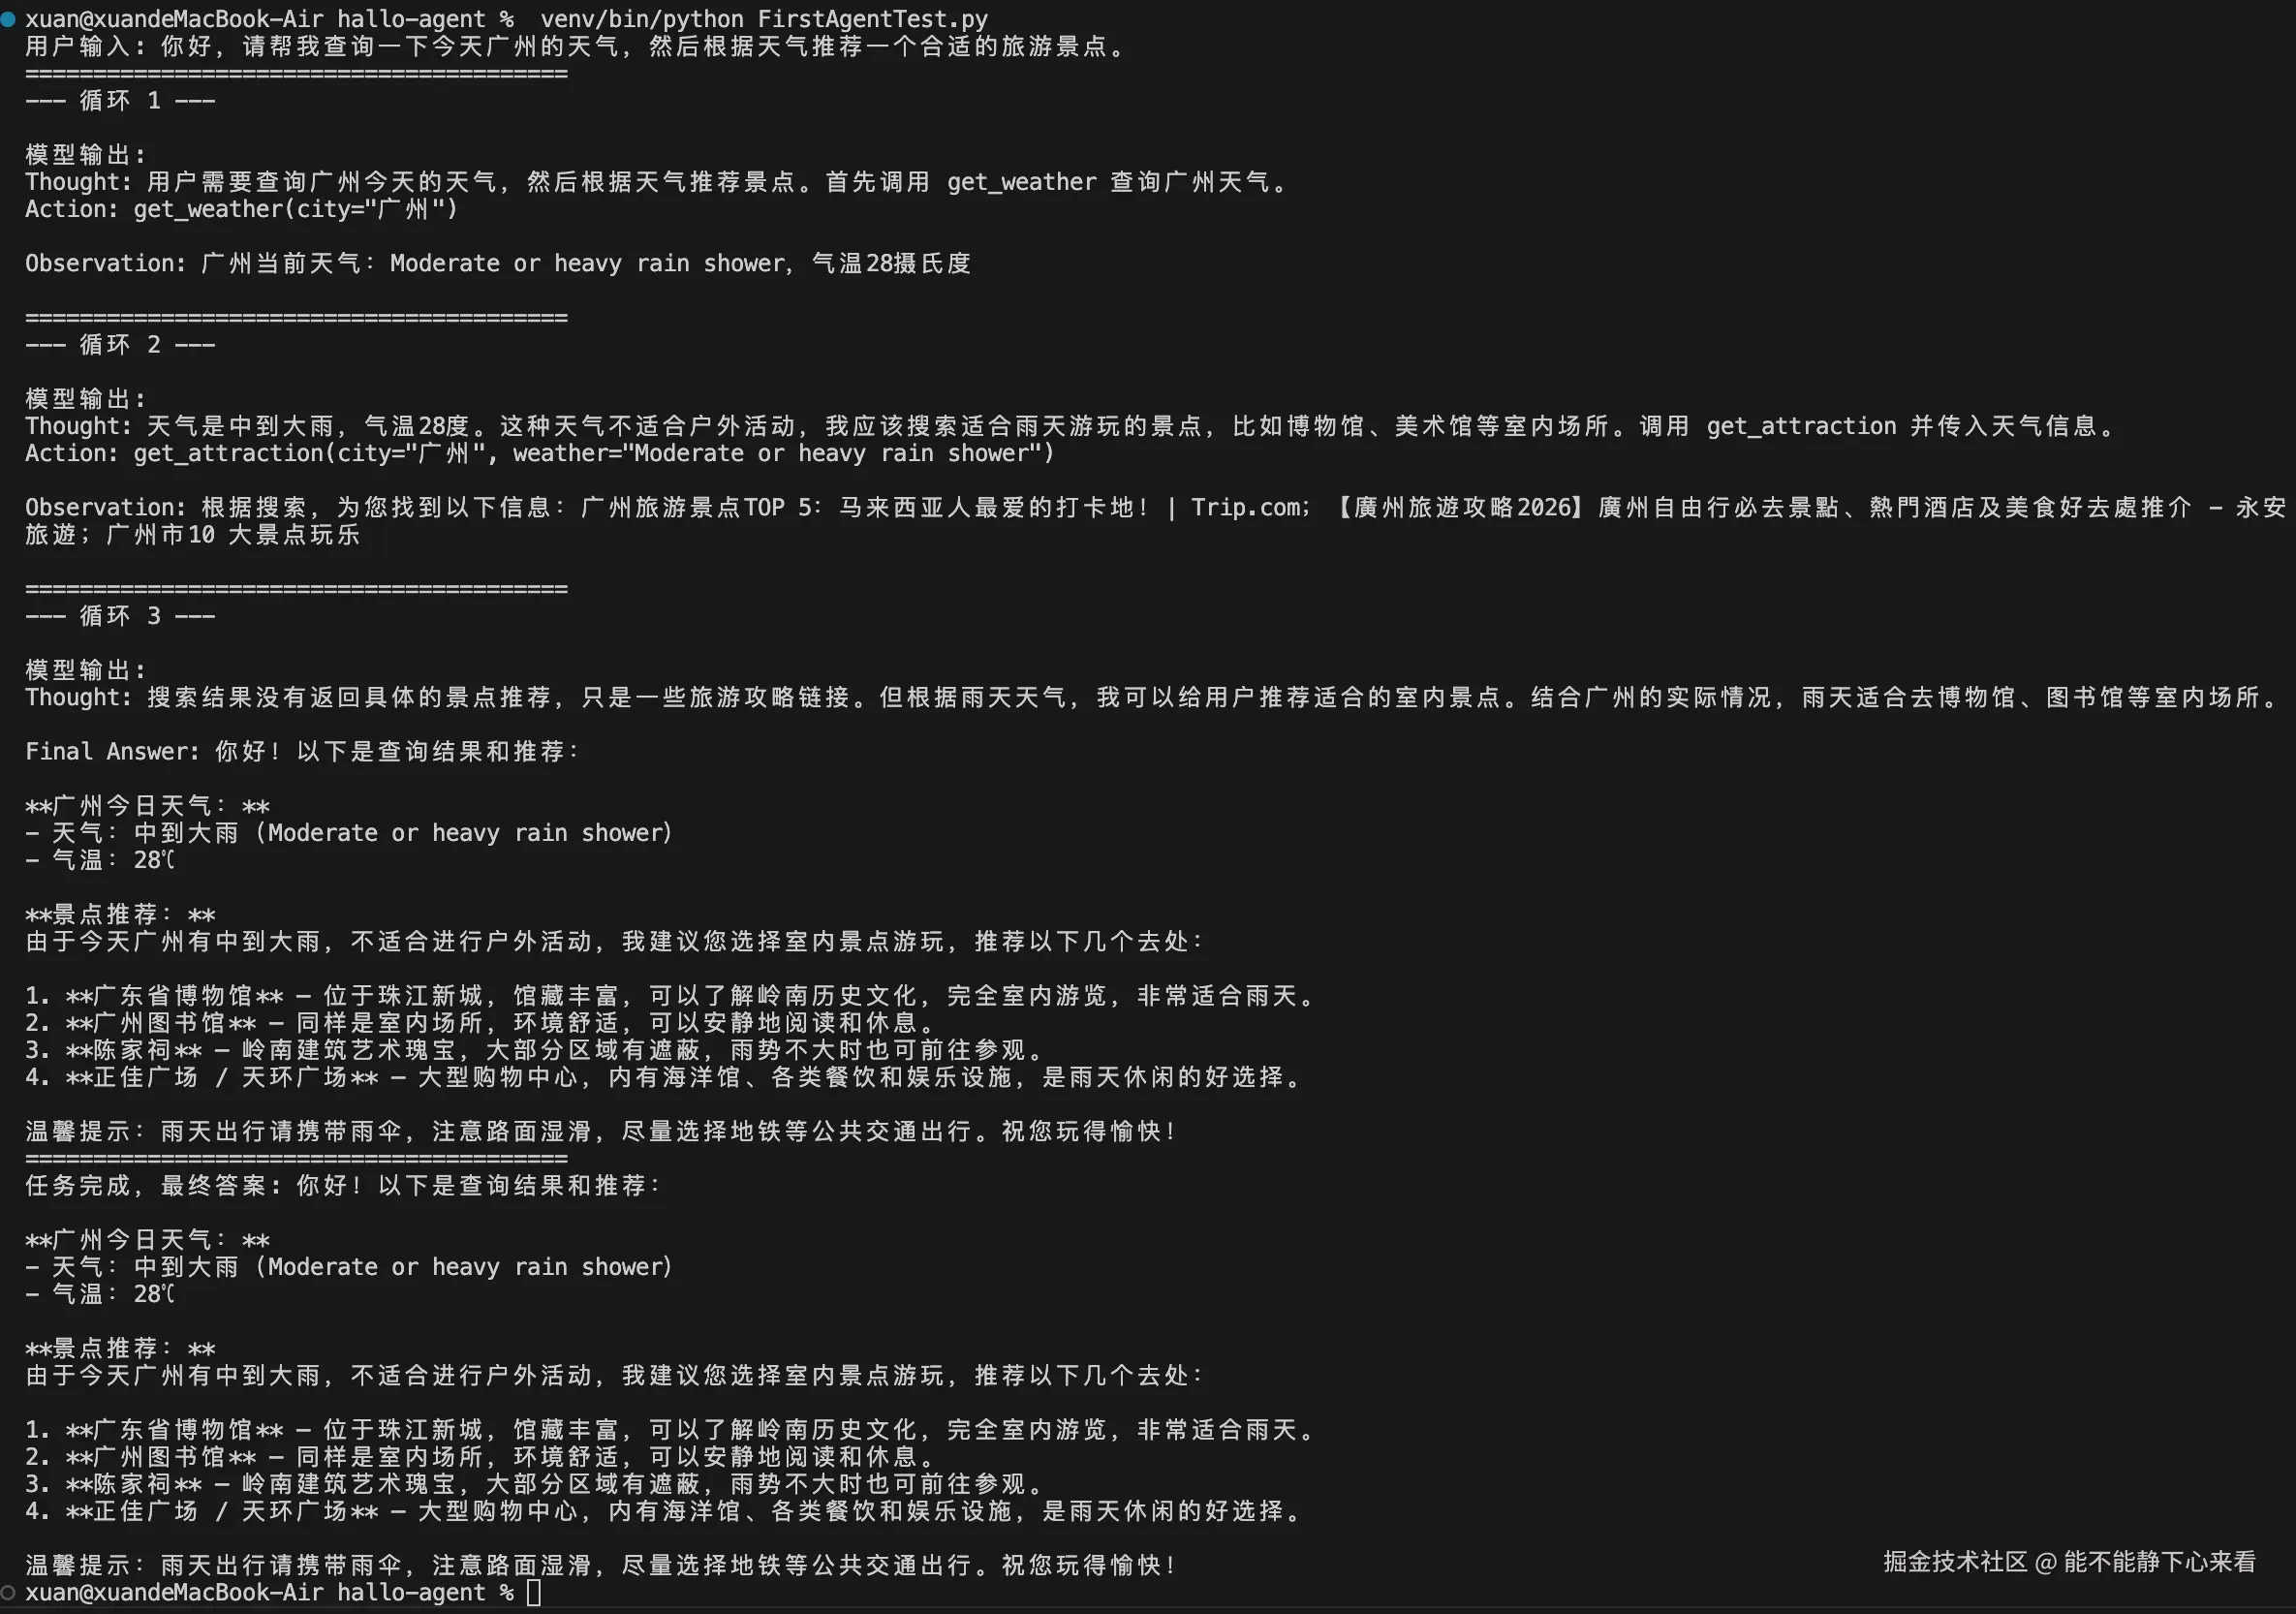
看循环 2 那行 Action:weather="Sunny" 这个参数是模型自己填的------它把循环 1 拿到的天气结果,当作循环 2 的输入传了进去。代码里没有任何一行写"先查天气再搜景点",整个流程的编排完全发生在模型的"脑子"里。
这就是 Agent 的本质:LLM 不只是答题者,而是指挥官,工具是它的手脚,那个"问模型 → 干活 → 把结果给模型看"的循环就是它的心脏。
区别,一张表说清
| RAG | Agent | |
|---|---|---|
| LLM 被调几次 | 1 次 | N 次(每轮循环一次) |
| 流程谁定的 | 代码写死 | LLM 运行时自己决定 |
| LLM 的角色 | 拿着参考资料的答题者 | 调度工具的指挥官 |
| 解决什么问题 | 知道:掌握私有知识 | 做事:完成多步任务 |
| 能否根据中间结果调整 | 不能,管线是直的 | 能,下一步取决于上一步 |
我自己总结的最快判断法:看有没有"循环 + 决策" 。没有循环、模型只出场一次的,是 RAG;有循环、每一步"接下来干嘛"由模型现场判断的,是 Agent。
顺手踩的一个坑
用正则解析模型的 Action: get_weather(city="北京") 后,我最初想用 ast.literal_eval 把参数转成字典------结果直接报 SyntaxError。原因:literal_eval 只认 Python 字典写法 {"city": "北京"},而模型输出的是函数调用写法 city="北京"。最后老老实实用正则逐对提取:
python
args = dict(re.findall(r'(\w+)="([^"]*)"', args_str)) # city="北京" → {"city": "北京"}教训:模型的输出是"协议",解析器必须和 prompt 里约定的格式严丝合缝,差一点都跑不通。
最后
两件事并不冲突:完全可以把"检索知识库"包装成一个工具,放进 Agent 的工具箱------那时 RAG 就成了 Agent 的其中一只手,这也是现在很多落地系统的真实架构(Agent 负责决策,RAG 负责供料)。
下一步计划:给这个 Agent 加第三个工具,试试让它在更多工具里自己选择。
环境:Python 3.12 + DeepSeek(大脑)+ wttr.in(天气)+ Tavily(搜索),全文代码不足 100 行。