机器人模型(WM / WAM / VLA)综合分析与对比:从「看」到「想」再到「做」
0x00 概要
本文覆盖 2026 年集中出现的九个机器人基础模型项目。它们共同回答同一个问题:机器人该以什么为单位、什么表征、什么结构,把"看见的世界"变成"该做的动作"?
| 项目 | 一句话定位 | 关键论文 / 仓库 |
|---|---|---|
| π0.7 | LLM + World Model + VLA 三层协同的通用机器人基础模型,工程与涌现的标杆 | arXiv:2604.15483(Physical Intelligence) |
| τ₀-VLA | 分层式基础模型:高层子任务级测试时计算(TTC)+ 低层通用 VLA | 2026.07(AgiBot / SII Research) |
| τ₀-WM | 统一视频-动作世界模型:一个骨干同时当 Policy(VAM)与 Simulator(ACVS) | arXiv:2606.01027 / github.com/sii-research/tau-0-wm |
| WALL-WM | 把 WAM 的学习单位从"固定 chunk"重定义为"语义事件",事件级联合去噪 | arXiv:2606.01955(X Square Robot) |
| MemoryWAM | 混合记忆(短窗+锚点+gist)打破 WAM 的记忆-效率权衡,15:1 压缩长程上下文 | 2026(Wan2.2 系,RMBench 83.0%) |
| EventVLA | 稀疏视觉证据记忆:只记"关键帧"而不是全部历史,前瞻式调度关键帧 | arXiv:2606.20092 / github.com/InternRobotics/EventVLA |
| LaWAM | 两阶段知识蒸馏:把"看未来"的能力压缩进 32 维潜动作,推理时零视频开销 | 2026(LIBERO 98.6% / 187ms / 2.3B) |
| Being-H0.7 | 隐空间世界-动作模型:双分支隐对齐,训练时用未来、推理时零未来帧开销 | arXiv:2605.00078(北大 BeingBeyond) |
| TurboVLA | 釜底抽薪:把 LLM 从执行回路里拿掉,V+L→A 直通范式,0.2B 跑 32Hz |
arXiv:2607.27205 / github.com/H-EmbodVis/TurboVLA |
把这九个项目放在一起,可以看到一个比较清晰的脉络:这是一条"世界模型该放在哪、该不该存在"的光谱。
- 一端是 π0.7 :独立 14B 世界模型(BAGEL)在推理时主动生成"子目标图片",把世界模型当作条件生成器。
- 中段是 τ₀-WM / WALL-WM / MemoryWAM :世界模型与动作策略共享同一骨干,训练时联合预测视频+动作,推理时要么继续用视频分支做评估(τ₀-WM)、要么事件级去噪(WALL-WM)、要么只用它维护记忆缓存(MemoryWAM)。
- 再往下是 τ₀-VLA :世界模型被降级为评估器------只在高层"不确定"的关键决策点被调用,预测候选子任务的后果供打分。
- 更进一步是 EventVLA / LaWAM / Being-H0.7 :不再生成未来视频,改用稀疏关键帧记忆 、把未来信息蒸馏进潜动作 (LaWAM)、或在隐空间做双分支对齐(Being-H0.7),推理时完全回到"轻量 VLA"。
- 最远的一端是 TurboVLA :干脆没有世界模型 ,
DINOv3+BERT+交叉注意力+ACT解码器,0.2B 参数跑出 32Hz 实时。
要点:τ₀-VLA 是光谱的转折点------世界模型从"台前"退到"幕后验证";LaWAM 与 Being-H0.7 把它藏进参数(潜动作蒸馏 / 隐查询对齐);TurboVLA 直接宣告它不存在。
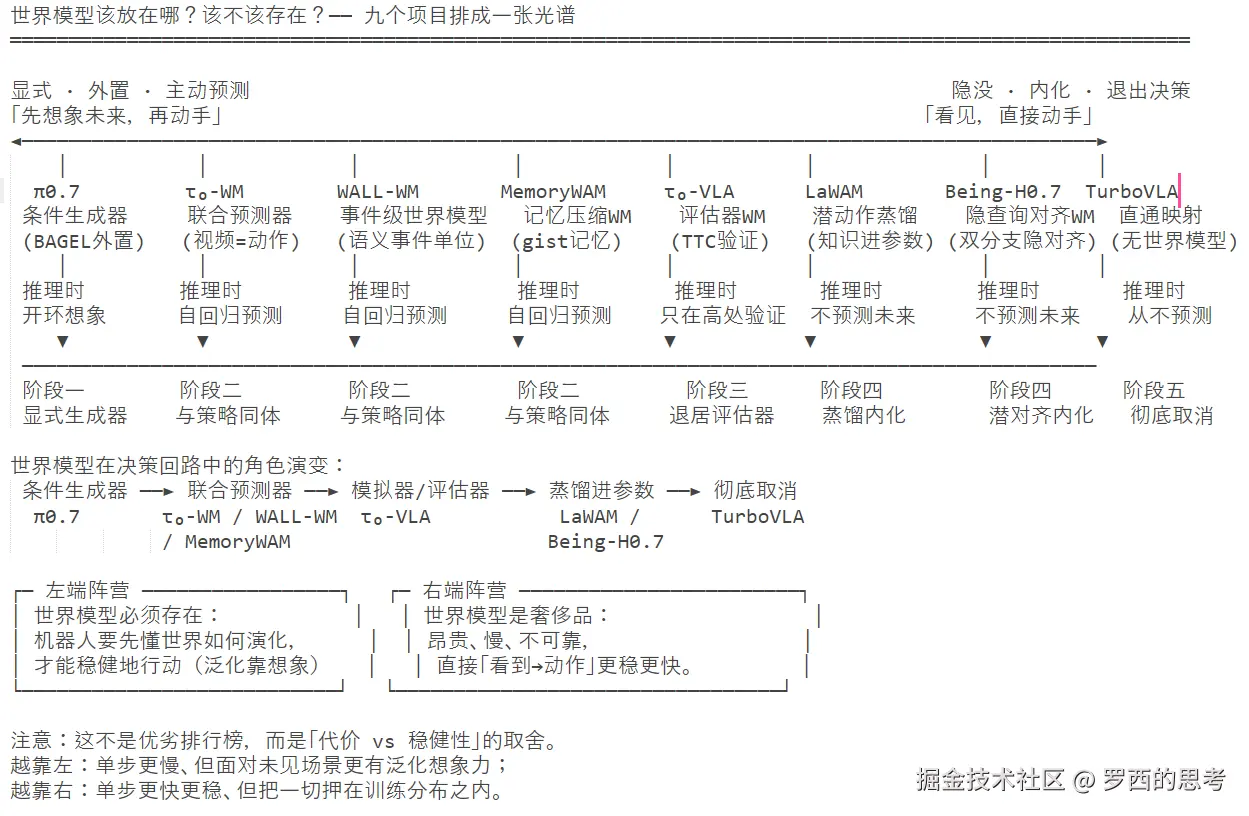
WM-VLA-光谱
这八条路线并非互斥,而是**"预测未来"与"实时控制"这两个需求在同一个架构里的此消彼长**。
注:本文成文较早。
0x01 面对的难点与核心冲突
1.1 核心冲突的一句话版本
我们把九个模型各自面对的难题压缩成一句话:机器人的"大脑"必须同时做到三件事------看懂世界(感知)、想象后果(世界建模)、输出动作(控制),但这三项能力对架构的要求互相打架:感知要快、想象要准、控制要稳,而且每一步决策都必须被压在毫秒级、毫焦级、低显存的计算预算内。
把这句话展开,九个模型分别撞上了它的不同侧面:
- π0.7 撞上的是"通用性与可操控性 的兼得":既要跨本体、跨任务零样本泛化,又要让人类能精确指定"想要什么"(子任务文本 + 子目标图片 + 控制模式),最后还要承担 14B 世界模型与 5B VLA 之间的推理延迟错配(BAGEL 每 4 秒才更新一次子目标,VLA 却要 20-50Hz 推理)。
- τ₀-VLA 撞上的是"所有决策都被一视同仁地对待":简单动作(往前走)和复杂抉择(该拿哪个工具)都消耗同样的前向传播,长程任务中"执行不了"与"不知道该做什么"被混为一谈。
- τ₀-WM 撞上的是"数据来源不兼容 + 模型角色冲突":真实机器人数据有精确动作但贵,人类视频有丰富动态但无动作标签,UMI 数据有大量交互但动作弱;而 Policy 要"快速响应",World Model 要"精确预测",传统做法把两者拆成两个模型导致预测能力服务不了决策。
- WALL-WM 撞上的是"学习单位的时钟错配":语言是语义事件、视觉是连续场景、动作是接触级控制,三者时间尺度不同,用固定长度 chunk 切分强制模型去拟合"窗口内的统计相关"而非"任务语义",并在分布外泛化时崩溃。
- MemoryWAM 撞上的是"记忆的容量-效率权衡":滑动窗口(FastWAM/Cosmos Policy)省算力但丢了长程上下文,全历史 KV cache(LingBot-VA/DreamZero)保住了一切却让延迟和显存随序列长度线性增长,1,600 帧时已无法实时控制。
- EventVLA 撞上的是"历史信息要不要全记":稠密视频历史既贵又冗余,但全丢掉又会在非马尔可夫任务中"失忆"------它需要的是"只记得有用的那几帧"。
- LaWAM 撞上的是"推理时未来不可见":世界模型要预测未来,可策略决策的那一刻根本没有未来帧可用------这个矛盾让"训练时用未来"与"推理时不用未来"成为两条必须打通的轨道。
- Being-H0.7 撞上的是"未来信息的表征形态 ":既要像世界模型那样"理解未来",又不想付出像素渲染的推理成本------它主张未来的价值不在像素,而在隐空间中与当前状态的结构差异;但要准确捕捉这种差异,必须先解决隐空间对齐的"表征坍塌"与"对齐信号过弱"两个工程难题。
- TurboVLA 撞上的是"语义能力与实时执行被强行绑定 ":LLM 中心的
V→L→A让每次控制都要跑一遍十几亿参数模型,延迟(~100ms)、显存(~十几 GB)对实时/边缘机器人不可承受,而执行级指令又根本用不上 LLM 的开放生成能力。
1.2 深挖:难点的四个层次
我们把上述矛盾归纳为四个递进的层次,构成本文的分析骨架:
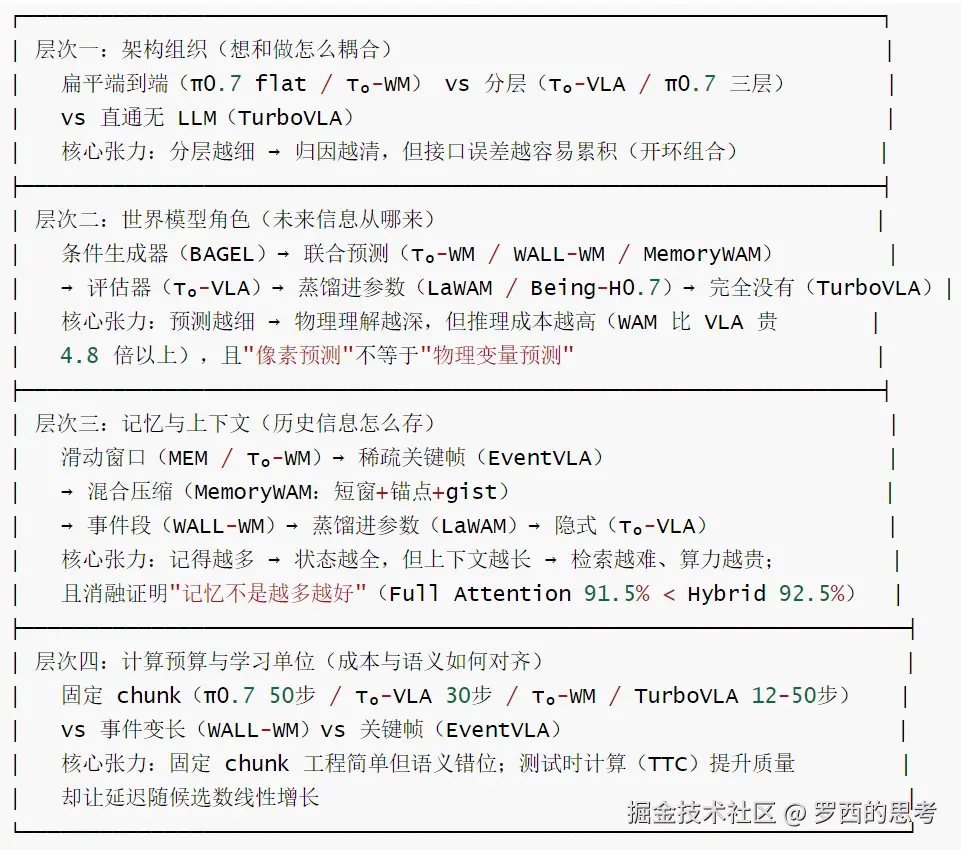
WM-VLA-四个递进的层次
核心冲突的完整表述:我们想让机器人模型在真实物理世界里可靠地长程操作,但
- (1) "看/想/做"三种能力对架构的要求互相冲突;
- (2) 世界模型的"预测未来"能力与"实时控制"成本难以兼得,且像素预测 ≠ 物理理解;
- (3) 历史记忆的多与少、稠与稀、显与隐存在根本权衡;
- (4) 学习单位(chunk/事件/关键帧)与计算预算(固定/自适应)必须在语义对齐和工程成本之间做选择。
四个问题互相纠缠,单独修任何一个都会撞上另外三个。
π0.7 flat :指去掉 70B 规划器和 14B BAGEL 之后的"5B 核心 VLA" (Gemma3+SigLIP+Action Expert)。它单独看是纯粹的扁平条件端:"观测+指令 → 动作块",中间没有任何层次拆解。完整 π0.7 是三层,但最底层这个单模型是扁平的,"π0.7 flat"说的是剥掉上层后的那个执行模型。
0x02 这些模型如何解决这些难点
2.1 解法总览:一张映射表
我们把"难点 → 解法"的因果链画出来:
| 难点层次 | 典型问题 | 解决策略 | 代表项目 |
|---|---|---|---|
| 架构组织 | 想与做耦合、失败难归因 | 分层解耦:慢脑(规划/评估)与快脑(执行)分离 | π0.7(LLM→BAGEL→VLA)、τ₀-VLA(高层+低层) |
| 架构组织 | 全部决策一视同仁 | 测试时计算(TTC)+ 动态路由:只在关键点"多想想" | τ₀-VLA(子任务级束搜索)、τ₀-WM(RCS+LAR 两级) |
| 架构组织 | 语义能力绑定实时执行 | 执行路径重设计:移除 LLM 作为表示桥梁 | TurboVLA(V+L→A) |
| 世界模型 | 未来预测与实时控制冲突 | 共享骨干统一:Policy 与 Simulator 同一个模型 | τ₀-WM(VAM+ACVS 共享 5.5B 骨干) |
| 世界模型 | 像素预测 ≠ 物理理解 | 把世界模型当评估器/蒸馏器,而非唯一真理来源 | τ₀-VLA(评估)、LaWAM(蒸馏)、EventVLA(不预测未来) |
| 世界模型 | 推理时未来不可见 | 潜动作蒸馏:训练时从未来帧学,推理时只用当前观测 | LaWAM(32 维潜动作 + 知识绝缘) |
| 世界模型 | 未来信息缺像素渲染也要进决策 | 隐空间双分支对齐:训练时对齐先/后验隐状态,推理时只走先验分支 | Being-H0.7(隐查询 + 潜对齐 + 抗坍塌正则) |
| 记忆上下文 | 历史信息全记太贵、不记会失忆 | 分层/稀疏记忆:重要帧高保真,其余压缩 | MemoryWAM(短窗+锚点+gist 15:1)、EventVLA(关键帧) |
| 记忆上下文 | 滑动窗口丢长程、全历史太贵 | 可检索压缩 + 训练-推理一致掩码 | MemoryWAM |
| 记忆上下文 | 长程任务方向感丢失 | 外部记忆/隐式执行记忆 | τ₀-VLA(执行记忆)、π0.7(MEM) |
| 学习单位 | 固定 chunk 语义错位 | 事件级学习单位 + 变长执行 | WALL-WM(Event Mode / Unified Mode) |
| 学习单位 | 关键帧怎么选 | 前瞻式关键帧调度 + 软标签课程学习 | EventVLA(KEM + 1D-NMS + 冷却期) |
| 计算预算 | 跨本体动作空间不兼容 | 统一动作空间 + mask | τ₀-VLA(40D + ComponentSpec + mask) |
| 计算预算 | 推理延迟/显存难下降 | 极简架构 + 轻量解码 | TurboVLA(0.2B/0.9GB/31.2ms)、LaWAM(蒸馏后 187ms) |
| 计算预算 | 扩散/流匹配去噪太慢 | 蒸馏 + 量化 + 编译 | WALL-WM(DMD 50→4 步 + FP8)、τ₀-WM(KV cache + torch.compile) |
2.2 四条贯穿性的解题主线
上面 15 条映射背后,其实是四条更抽象的主线。
主线一:分层与解耦(Hierarchy & Decoupling)------把"想"和"做"切开,并按"值不值得想"分配算力。
π0.7 和 τ₀-VLA 是两个典型代表,但分层的哲学相反。我们看 τ₀-VLA 的分层结构:
css
慢脑(决策层,秒级,可调用额外算力):
  维护执行记忆 → 生成子任务 proposal → 置信度评估
  → 低置信度时启动 TTC:Proposal 采样 → World Model 预测后果
  → Value Model 打分 → Beam Search 剪枝 → Reflective Model 定夺
        │
        ▼
快脑(执行层,~30Hz,固定计算):
  接收高层选定的子任务 → Qwen3.5 VLM 编码 → Flow Matching 出 30 步动作块
τ₀-VLA 的分层关键是计算预算自适应 :简单决策一次前向就出结果,复杂决策才触发 TTC。而 π0.7 的分层更像"工具分工":70B LLM 拆子任务、14B BAGEL 画子目标、5B VLA 出动作,三层各自迭代、各自替换。两者共同的代价是开环组合------接口处误差逐级累积,失败时难以归因到具体某层。
主线二:世界模型角色的再定位------从"预言者"到"评估者"再到"蒸馏对象"。
这是九个模型之间最锋利的一条分水岭。我们用一个坐标轴展开:
scss
世界模型角色光谱(左→右:推理时开销从大到小)

[条件生成器]      [联合预测器]        [评估器]        [蒸馏进参数]     [不存在]
π0.7(BAGEL 14B)  τ₀-WM(共享骨干)    τ₀-VLA(TTC内)   LaWAM(潜动作)   TurboVLA
生成子目标图片     WALL-WM(双塔)      预测后果供打分    推理时零视频    纯V+L→A
                 MemoryWAM(缓存)                    Being-H0.7     开销
                                                    (隐查询对齐)
    ▲                                                    ▲
  每步都想要未来                                    只要"现在",未来靠参数
  质量高、成本极高                                   成本极低、能力受限
关键洞察在 τ₀-VLA 的宣言里:"世界模型不是拿来当条件,是拿来评测 "。π0.7 要求 BAGEL 生成的子目标图精确到能指导动作;τ₀-VLA 只要求世界模型预测出"足够区分好/坏结果的粗略未来",因此可以用更轻量、更慢但更便宜的世界模型,且只在关键决策点触发。LaWAM 则把这条路走到极致------它不预测像素未来,而是让 VLM 策略学会从当前观测预测一个"潜动作",再冻结的潜世界模型把它解码成潜子目标。未来信息被压缩进了模型参数而非推理过程。
主线三:记忆的分层、稀疏与压缩------"记什么"与"怎么忘"一样重要。
MemoryWAM 从认知心理学的"三重记忆结构"出发,给出了最系统的设计:
ini
MemoryWAM 混合记忆
    ├── 短期记忆(Short-term): 最近 N_recent=4 帧,完整 120 token/帧
    │     → 提供精细闭环控制的高保真局部上下文
    ├── 事件边界记忆(Anchor): 任务起始 N_init=2 帧,完整 token
    │     → 保留"任务基态"(初始场景布局,一旦遮挡/移出视野就无法恢复)
    └── 摘要记忆(Gist): 中间帧各压缩为 M=8 个 gist token(15:1)
          → 历史帧 KV cache 被驱逐,只留 gist 的 KV,动作 DiT 靠注意力检索
EventVLA 走的是另一条路------只记关键帧 。它用一个前瞻式调度器(基于 VLM 联合隐状态)预测"未来哪几帧会成为关键证据",用升余弦软标签 + 教师-学生课程学习训练模型学会"什么时候该记一笔"。而 WALL-WM 用"事件段"做记忆的天然边界,LaWAM 则彻底不记------把历史信息蒸馏进参数。四者共同回答的是:记忆不是上下文越长越好,而是"该记的记得住、不该记的不拖累" ------MemoryWAM 的消融实验(Full Attention 91.5% < Hybrid Memory 92.5%)直接反驳了"记忆越多越好"的直觉。
主线四:学习单位与计算预算------用"语义的时间刻度"替代"时钟的时间刻度"。
WALL-WM 把这条主线讲得最彻底。传统方法把任务切成固定长度 chunk(如 32 步),但语言描述的是语义事件、视觉是连续流、动作是接触级控制------三者天然不同步。WALL-WM 的做法是把原子学习单位从"固定 chunk"替换为"语义事件" (抓取、放置、拉抽屉),事件在语言中可命名、在视频中可观察、在动作中可执行,是三种模态的自然交点。配合变长执行(Event Mode),持续时间跟随任务而非时钟。
与此同时,测试时计算(TTC)这条线在 τ₀-VLA 和 τ₀-WM 中成熟: "简单问题快速响应,复杂问题深入思考" ------τ₀-WM 用 RCS(轻量重去噪一致性筛选)+ LAR(重量 ACVS 修正)两级策略,τ₀-VLA 用子任务级束搜索,把 Test-Time Scaling 从 NLP 移植到具身决策。
一句话总结解法 :九个模型用四种武器(分层解耦、世界模型角色再定位、记忆分层稀疏化、学习单位事件化)打同一场仗------在"预测未来的深度"与"实时控制的成本"之间,找到每个应用场景最经济的平衡点。
0x03 九个模型的详细对比
3.1 一张表看懂九个模型
| 维度 | π0.7 | τ₀-VLA | τ₀-WM | WALL-WM | MemoryWAM | EventVLA | LaWAM | Being-H0.7 | TurboVLA |
|---|---|---|---|---|---|---|---|---|---|
| 机构 | Physical Intelligence | AgiBot | AGIBOT Finch | X Square Robot | Wan2.2 系 | InternRobotics | - | 北大 BeingBeyond | 华科+华为 |
| 时间 | 2026.04 | 2026.07 | 2026.05 | 2026.06 | 2026 | 2026 | 2026 | 2026.04 | 2026.07 |
| 总参数 | ~5B(+14B+70B) | ~3B | ~5.5B | ~14B | ~6B | ~4B(Qwen3-VL) | 2.3B | ~3B(MoT 稀疏,FLOPs≈1.2B) | 0.2B |
| 架构 | 三层(LLM→WM→VLA) | 分层(高层+低层) | 扁平共享骨干 | 双塔(Video+Action) | MoT 双 DiT | 单 VLA + 记忆 | 单 VLA + 蒸馏 | MoT 双专家 + 双分支隐对齐 | V+L→A 直通 |
| 世界模型角色 | 条件生成器(BAGEL) | 评估器(TTC) | 联合预测(VAM/ACVS) | 联合预测(事件级) | 记忆缓存(推理不生成) | 无(关键帧记忆) | 蒸馏对象(LaWM) | 隐对齐(潜未来表征) | 无 |
| 记忆机制 | MEM 滑动窗口 | 隐式执行记忆 | 滑动窗口 | 事件段 | 短窗+锚点+gist | 稀疏关键帧 | 蒸馏进参数 | 16 隐查询工作槽 | 无 |
| 学习单位 | 50 步 chunk | 30 步 chunk | 固定 chunk | 语义事件(变长) | 16 步 chunk | 关键帧 | chunk | 20 步 chunk | 12/50 步 chunk |
| 动作生成 | Flow Matching | Flow Matching | Flow Matching | Flow Matching | Flow Matching | Diffusion(4步) | 潜动作蒸馏 | Flow Matching | L1 回归+tanh |
| TTC/推理自适应 | 无 | 子任务级束搜索 | RCS+LAR 两级 | 无 | 无 | 无 | 无 | 无(UAC 异步分块) | 无 |
| 跨本体 | 零样本(UR5e) | 统一 40D+mask | 双臂 16D | 单平台验证 | 双臂 | 双臂 | LIBERO | PND/Unitree G1/Franka | 双臂 RoboTwin |
| 训练数据 | 大规模混合+失败数据 | 40,115h 异构 | 27,300h 混合 | UMI 自采+四层标注 | RMBench+真实 | RoboTwin-MeM | LIBERO | ~20万h人视频+~1.5万h机器人 | 基准自带 no_noops |
| 标杆成绩 | 跨本体/涌现/失败恢复 | 闭环 27.5→45.0% | 无 TTC 0.43→0.60 | Event 64.84 | RMBench 83.0% | +40% 相对 | LIBERO 98.6% | LIBERO 99.2% / RoboCasa 62.1% | LIBERO 97.7% |
| 推理延迟 | ~94ms(π0.5 基线) | ~30Hz | ~220ms(基线) | ~120ms(A100) | O(N/15) | - | 187ms | 3-4ms/步 | 31.2ms/0.9GB |
| 开源 | ✗ | ✓ Apache 2.0 | VAM 部分 | ✗(仓库是 Wall-OSS) | - | ✓ | - | - | ✓ Apache 2.0 |
3.2 按"世界模型角色"分阵营
这是八者之间最干净的一条分界线:
vbnet
阵营 A:推理时要"看到未来"(视频/图片生成在热路径上)
  ├─ π0.7:BAGEL 生成子目标图片(条件生成器,独立 14B,异步 4s 级)
  ├─ τ₀-WM:VAM 联合预测未来视频+动作,ACVS 预测后果(共享骨干)
  └─ WALL-WM:Event Mode 联合去噪变长事件视频+动作(双塔)

阵营 B:推理时"只维护未来表征,不生成未来画面"
  └─ MemoryWAM:视频 DiT 只前向更新 KV 缓存,不做视频生成(Fast-WAM 范式)

阵营 C:推理时"世界模型作评估,不作生成"
  └─ τ₀-VLA:World Model 只在 TTC 时预测候选后果,Value Model 打分

阵营 D:推理时"彻底不用未来",未来靠参数或记忆
  ├─ EventVLA:稀疏关键帧记忆(不预测未来)
  ├─ LaWAM:32 维潜动作蒸馏(未来信息在参数里)
  ├─ Being-H0.7:16 隐查询双分支对齐(训练时看未来,推理时只走先验分支)
└─ TurboVLA:完全没有世界模型这条分界线背后是一个清晰的权衡:世界模型越"在场",物理理解越深、泛化越强,但推理成本越高 。业界实证("Do World Action Models Generalize Better than VLAs?")确认 WAM 鲁棒性确实强于 VLA,但推理开销高 4.8 倍以上;Fast-WAM 的消融进一步指出:WAM 的主要收益来自"训练时的视频预测目标塑造的世界表征",而非"推理时显式的未来生成" ------这直接为阵营 B/D 的低成本路线提供了理论依据。
3.3 按"决策者是否 LLM"分视角
- LLM 中心派:π0.7(Gemma3 + 70B 规划器 + BAGEL)、τ₀-VLA(Qwen3.5 高层+低层)、WALL-WM(Qwen2.5-VL 做事件推理 + T5 条件)、τ₀-WM(T5/UMT5-XXL)。它们继承 LLM 的开放语义与推理能力,代价是每次控制都要过至少一个十亿级模型。
- 轻 LLM 桥接派:EventVLA(Qwen3-VL 做关键帧标注与理解)、LaWAM(VLM 策略蒸馏)、Being-H0.7(InternVL3.5+MoT 处理文本/视觉)。用 LLM 的语义能力但不把 LLM 放在动作热路径上。
- 去 LLM 派:TurboVLA(冻结 BERT 提供执行级语义,DINOv3 提供视觉)。它正面论证"执行级控制不需要开放式语言生成",代价是放弃开放词表与高层推理。
一条此消彼长的规律:LLM 越强,世界模型越可以"简单";LLM 越弱/越被拿掉,要么世界模型承担更多物理理解(WAM 系),要么能力上限被压缩(TurboVLA 只做执行级) 。
0x04 当前业界的实现方案总结
站在 2026 年年中回看,业界对"机器人基础模型怎么建"已经沉淀出七条可辨识的实现路线,九个模型分别是其中若干条的典型代表:
路线一:三层/分层协同(Hierarchical Composition)------已成工程事实标准。 π0.7(LLM→BAGEL→VLA)与 τ₀-VLA(高层规划→低层执行)分别示范了"工具分工式"和"思考预算式"两种分层。差异只在:高层是否训练(π0.7 的 70B 规划器需微调,τ₀-VLA 的 Proposal/Value/Reflective 都训练)、世界模型放哪(条件 vs 评估)、接口是文本还是图片。
路线二:世界动作模型(WAM)------从 VLA 的一次重大范式偏移。 τ₀-WM / WALL-WM / MemoryWAM 代表"联合预测视频+动作"的 WAM 系。它们共享一个信念:显式建模"世界如何因动作演化"能得到比 VLA 更强的物理表征。Fast-WAM、Cosmos Policy、DreamZero、GigaWorld Policy 是这个阵营的平行成员。当前最大的争议是"训练时预测 vs 推理时预测"的收益归属,以及像素预测是否通向物理理解。
路线三:事件级学习(Event-Centric Learning)------学习单位的重新定义。 WALL-WM 是代表,τ₀-WM 也提到了事件级对齐。它把固定 chunk 换成语义事件,让语言-视觉-动作在自然的时间边界上对齐,变长执行。代价是四层人工标注和昂贵的 UMI 采集,自监督事件发现仍标注为未来工作。
路线四:记忆的分层与压缩(Hierarchical & Compressed Memory)。 从 π0.7 的 MEM 滑动窗口,到 EventVLA 的稀疏关键帧,到 MemoryWAM 的短窗+锚点+gist,再到 WALL-WM 的事件段。记忆设计的趋势是从"全记/全不记"走向"按信息重要性分级存储 + 可检索" ------这与 DeepSeek NSA 的粗-细粒度分层检索在思想上同构。
路线五:测试时计算(Test-Time Computation)------把"思考预算"引入具身决策。 τ₀-VLA 的子任务级束搜索与 τ₀-WM 的 RCS+LAR 是代表。它们把 NLP 界的 Test-Time Scaling(o1 的慢思考)移植到机器人:简单决策一次前向,关键决策才调用世界模型+价值模型做多步搜索。核心挑战是价值模型的泛化、候选规模带来的延迟,以及"评估预算"是否与收益匹配。
路线六:去 LLM 的执行路径重设计(Execution-Pathway Redesign)。 TurboVLA 是代表,与 SmolVLA/Evo-1/DreamVLA 等"compact VLA"形成呼应。它论证了执行级控制用"小编码器+交叉注意力+连续动作解码"就够,把 LLM 从热路径上拿掉,换来 31.2ms/0.9GB 的量级优势。代价是开放语义与组合泛化被放弃。
路线七:知识蒸馏进参数(Distillation into Parameters)------把"未来"折叠进权重。 LaWAM 是代表(潜动作蒸馏 + 知识绝缘),Being-H0.7 的 latent-query 世界建模是同路线的平行工作。它们解决"推理时未来不可见"矛盾的方法是把未来信息压缩进潜表征,推理时回到 VLA 效率。风险是信息瓶颈与失去视频先验。
业界实现方案的七条路线可以用一句话收束:从"单体模型包打天下"走向"分层系统 + 世界模型角色化 + 记忆分级 + 思考预算 + 效率工程"的组合拳------每条路线都在回答同一个问题:未来信息该以什么形式、多大代价地进入决策。
"
0x05 未来趋势判断
基于平行论文的互相印证,以及多篇对 VLA/WAM 范式的批评,我们给出六条趋势判断,并按确信度排序:
趋势一(高确信):世界模型的训练目标从"像素预测"走向"物理变量预测"。 "Robots Need More Than VLAs & World Models" 的核心论点正在被越来越多人接受:视频预测优化的是像素级重建,而非接触、力、物体位姿等物理变量。MemoryWAM 论文也自认"视频 DiT 缺乏语义理解与推理能力"。未来世界模型会引入物理预测头(6-DoF 位姿、接触事件、任务进度),而不是把 Flow Matching 只压在像素上。
趋势二(高确信):记忆管理从"工程妥协"走向"端到端可学习 + 自适应"。 MemoryWAM 的 gist token 与 EventVLA 的关键帧调度器已经把"记什么"变成可学习对象。下一步是自适应:MemoryWAM 的"固定前 2 帧锚点"会进化为基于场景变化检测的动态锚点(WALL-WM 事件边界的最直接结合);gist 数量会按帧信息量动态分配;甚至借鉴 MOBA 思路把记忆路由到不同注意力头。
趋势三(高确信):分层系统的"开环组合"问题被正面解决。 π0.7 的三层独立训练、τ₀-VLA 的高层/低层分离,共同的软肋是接口处误差累积、失败无法归因。改进方向:① 在接口加反馈回路(VLA 置信度低时触发上层重规划);② BAGEL+VLA 式的端到端联合微调;③ 把显式世界模型内化为 VLA 表征空间的隐式约束(LaWAM 已示范一半)。
趋势四(中高确信):测试时计算的"预算匹配"评估成为刚需。 τ₀-VLA 的 TTC、τ₀-WM 的 RCS/LAR 都在消耗推理时额外算力,但必须证明增益来自"思考本身"而非"多试了几次"。业界会建立"在相同推理预算下对比"的评估协议,正如 NLP 界对 harness 优化的"预算混杂"批评一样,这会持续收紧该领域的可信度标准。
趋势五(中确信):事件级学习单位与"自监督事件发现"走向结合。 WALL-WM 证明事件级训练有效,但四层人工标注是复现壁垒。未来会出现基于动作速度变化、接触力突变、视觉场景变化的自监督事件边界检测(MemoryWAM 的自适应锚点也是同一需求),把事件发现从"标注管道"变成"模型能力"。
趋势六(中低确信):低成本高效路线与 WAM 路线的融合。 TurboVLA 证明"去 LLM 直通式"在 LIBERO/RoboTwin 这类执行级任务上可以以极小代价达到顶尖成绩;LaWAM/Being-H0.7 证明"蒸馏进潜空间"可以保留世界模型收益而不付出推理成本;WALL-WM 的 DMD 蒸馏 + FP8 证明 WAM 也可以跑 10Hz。 "训练时世界模型 + 推理时 VLA 效率"这个组合(Fast-WAM 结论的直接推论)正在成为收敛点。
两股反向力量值得注意:
- 保守派(LIBERO 基准批评)提醒我们 97% 级的 LIBERO 分数大量是"记忆化/捷径",跨论文比较要留足误差带;
- 激进派(物理接地、系统 2 慢思考)提醒我们,如果只追求 benchmark 数字,整个 WAM/VLA 领域的"物理理解"短板会被掩盖。
0x06 双视角解读:难点、解决方案与未来趋势
本节对前三节最核心的三个命题,分别用"十二岁孩子"和"专业人士"两种语言各讲一遍。
6.1 难点:为什么"机器人大脑"这么难做?
给孩子讲:
想象你教一个机器人做"找杯子游戏"。你把硬币藏在三个杯子下面,然后快速交换杯子位置。机器人必须记住硬币最开始在哪个杯子下面,才能跟着杯子找到它。
普通的机器人只有"两三秒的记忆",一旦你开始换杯子,它就忘了硬币在哪------像你打开太多网页导致电脑卡死一样。这是第一个难题:记得住过去 vs 反应要快,两者打架。
再想想机器人要回答的三个问题:"我看到了什么?"、"如果我这样动,会发生什么?"、"我现在该怎么动?"。第二个问题最难------它要"在脑子里先演一遍"才知道后果,但"在脑子里演一遍"特别慢、特别贵。有的机器人干脆不演了(快但笨),有的机器人每次都要演(聪明但慢得没法用)。这是第二个难题:想要聪明地预测 vs 想要飞快地行动。
最后,教它的方式也有讲究。有的老师按"每 1 秒钟切一段"来教它动作,但"打开冰箱"这件事可能要 3 秒------它只看到了手伸向门,还没看到门打开,根本学不会"打开冰箱"是啥意思。这是第三个难题:事情本身有长有短,但教课的时间格子是固定的。
给专业人士讲:
这是一个三重结构性矛盾:① 架构张力 ------感知(快、稠密、被动)与规划/世界建模(慢、稀疏、主动)与控制(毫秒级、高维、连续)对架构形态的要求互相冲突,任何"一步到动作"的扁平模型都会顾此失彼;② 信息/成本张力 ------世界模型的"预测深度"与推理时"计算-延迟-显存预算"严格负相关,而像素级预测并不等价于物理变量预测("Robots Need More Than...");③ 时间尺度张力------语言是语义事件、视觉是连续场景、动作是接触级控制,三种模态时间尺度不同,固定 chunk 学习单位强制模型做"窗口内统计相关"的短视拟合,正是 WALL-WM 指出的分布外泛化崩溃根源。此外还有记忆的容量-效率权衡(MemoryWAM 的核心命题)与"训练时未来可见、推理时未来不可见"的矛盾(LaWAM 的核心命题)。
6.2 解决方案:分层、世界模型角色化、记忆分级为什么有效
给孩子讲:
我们把难题拆成四招,就像给机器人配一个"聪明但慢"的指挥官和"反应快但不动脑"的士兵:
- 第一招,分工:让"指挥官"负责看全局、决定下一步,让"士兵"负责把手脚动起来。指挥官想得慢没关系,士兵动得快就行。这样万一做错了,能分清是"指挥官想错了"还是"士兵做歪了"。
- 第二招,该想才想 :遇到简单的事(往前走),指挥官直接说"走"就行;遇到拿不准的事(该放豆瓣酱还是甜面酱),指挥官才停下来"在脑子里演一遍",看看每个选择的结果,挑最好的。不是每件事都要想很久。
- 第三招,记笔记而不是背课文:机器人不把看到的一切都记下来(那样会卡死),它只记"重要的事":任务刚开始时的样子、最近几秒发生的事,中间一大段用几句话概括成摘要。就像你做读书笔记,不用抄整本书。
- 第四招,按事情切而不是按时间切:教"打开冰箱"就教"从手碰到门到门完全打开"这一段完整过程,而不是硬切成 1 秒一段。这样它学的是"事情本身"而不是"时间格子"。
给专业人士讲:
四招的学名分别是 分层解耦、测试时计算/角色再定位、记忆分级压缩、事件级学习单位:
- 分层解耦 解决"想/做耦合与失败归因"问题。τ₀-VLA 的高层/低层、π0.7 的 LLM→BAGEL→VLA 都让"规划"与"执行"在不同时间尺度上运行;其代价是开环组合------接口误差累积。解耦的收益是每个模块可独立迭代、独立替换 (π0.7 换一个 70B LLM 就换了一整个规划层),代价是信用分配困难(失败时是规划错、想象错还是执行错)。
- 世界模型角色再定位 解决"预测深度 vs 推理成本"矛盾。从条件生成器(BAGEL,每步异步生成子目标图)→ 评估器(τ₀-VLA,只在 TTC 触发时预测后果)→ 蒸馏进参数(LaWAM,推理时零视频开销),本质是把"世界模型的知识"从"推理时计算"逐步迁移到"训练时参数" 。τ₀-VLA 的洞察是:评估用世界模型不需要精确到像素,只要求"足够区分好/坏结果",因此可以用更轻、更慢但更便宜的世界模型。
- 记忆分级压缩解决"容量-效率权衡"。MemoryWAM 的三组件(短窗高保真 + 锚点保基态 + gist 15:1 压缩)在 O(N/15) 成本下保留了帧级可检索性;其消融(Full Attention 91.5% < Hybrid 92.5%)证明"压缩和筛选历史本身就是一种表征学习"。EventVLA 的关键帧调度、WALL-WM 的事件段、LaWAM 的参数化记忆是同一问题的不同解。
- 事件级学习单位解决"时间尺度错配"。WALL-WM 把原子单位从固定 chunk 换成语义事件,让语言-视觉-动作在自然边界对齐,变长执行让持续时间跟随任务而非时钟。这条线的核心困难是事件边界的人工标注,自监督发现是明确的未来方向。
6.3 未来趋势:往哪里走
给孩子讲:
以后机器人会变成什么样?我猜有四个方向:
- "指挥官"越来越聪明,但只在关键时候才思考------就像考试时先跳过简单题,把时间留给难题。
- 机器人学会"感觉自己的身体" :现在最聪明的机器人也不知道"我的手在哪、碰到东西是什么感觉"。这是最大的宝藏,比记住更多事还重要。
- 教机器人从"按时间学"变成"按事情学" ,而且它会自己找到"一件事的边界在哪里",不用人一个个标注。
- 又快又聪明的机器人出现:以前聪明的很慢、快的不聪明,以后会有人做到"训练时拼命学物理规律,用的时候不拖泥带水"------就像你平时认真学习,考试时又快又准。
给专业人士讲:
趋势可以压缩为三个结构性的转向:① 世界模型目标的迁移 ------从像素重建(Flow Matching on pixels)到物理变量预测(接触事件、6-DoF 位姿、任务进度),"Robots Need More Than VLAs & World Models" 为这一转向提供了理论纲领,MemoryWAM/π0.7 的自我批评提供了动机;② 推理时计算的预算匹配评估 ------τ₀-VLA/τ₀-WM 的 TTC 必须证明增益来自"思考"而非"多试几次",预算匹配协议会收紧该领域的可信度;③ 低成本路线的收敛 ------Fast-WAM 的结论(收益来自训练时视频目标而非推理时生成)+ LaWAM/Being-H0.7 的潜空间蒸馏 + TurboVLA 的去 LLM 直通,三者共同指向"训练时世界模型,推理时 VLA 效率"这个范式。
最值得盯的三个拐点:其一 ,当世界模型能从像素预测进化为物理变量预测(并与控制闭环),WAM 对 VLA 的"4.8 倍推理成本"批评将失效,WAM 系的地位将被彻底确认;其二 ,当"自监督事件发现 + 分层记忆"被验证(WALL-WM 事件 × MemoryWAM 记忆 × EventVLA 调度),长程任务将不再依赖人工标注的窗口/边界;其三,当去 LLM 直通式在真实世界的接触密集任务上证明可靠性(而不只是 LIBERO 数字),TurboVLA 路线的"执行级 VLA"会成为工业落地的主力,而 LLM 系则退居"高层规划"。
0x07 总结
九个项目讲了九个不同的故事,但指向同一个判断:机器人模型的下一场增量,不在"要不要世界模型",而在"世界模型的知识以什么形式、多大代价地进入决策"。
π0.7 证明了三层协同的工程巅峰------LLM 规划、BAGEL 想象、VLA 执行,同时暴露了开环组合与延迟错配的软肋;τ₀-VLA 用分层 + 测试时计算示范了"该想才想"的思考预算,却被价值模型泛化与误差级联束缚;τ₀-WM 用一个共享骨干统一了 Policy 与 Simulator,把评价从训练时推到了推理时;WALL-WM 把学习单位重定义为语义事件,证明"按事情切"比"按时间切"更能泛化;MemoryWAM 用混合记忆打破记忆-效率权衡,并给出"记忆不是越多越好"的实证;EventVLA 用稀疏关键帧证明"选择性地记"比"全部记"更高效;LaWAM 把未来信息蒸馏进 32 维潜动作,在 187ms 里拿到 LIBERO 98.6%;TurboVLA 釜底抽薪,用 0.2B 证明执行级控制根本不需要 LLM 居中。
它们各自的缺点,恰恰就是彼此的去处:π0.7 缺反馈回路与物理接地,τ₀-VLA 缺联合训练与轻量世界模型,τ₀-WM 缺开源完整性与理论保证,WALL-WM 缺自监督事件发现与灵巧操作,MemoryWAM 缺自适应锚点与语义融合,EventVLA 缺闭环容错,LaWAM 缺视频先验与信息容量,TurboVLA 缺开放语义与多峰动作头。把这些短板补起来的方向------物理变量预测、自适应记忆、事件自监督发现、预算匹配的 TTC、训练时世界模型推理时 VLA 效率------就是下一代机器人基础模型的完整施工图。
站在更高的维度看,这条光谱的演化轨迹清晰可见:世界模型正在从"推理时昂贵的显式生成"走向"训练时廉价地折叠进参数/记忆/潜空间",而学习单位正在从"固定时钟"走向"语义事件"。 当这两条线交汇------模型在训练时学透了物理规律,推理时只带着一小撮关键记忆轻装上阵------机器人才能真正做到"平时认真学习,考试时又快又准"。
第二部分 九个项目逐一拆解
说明:本部分每个项目按统一框架展开------基础架构 → 架构图 → 数据流 → 核心组件 → 历史发展脉络 → 优点 → 缺点 → 改进方向。为避免与原始文档重复过长,本部分在保留关键工程细节的同时做了归纳整合;深度代码级解读请回到各自原始文档。
"
2.1 π0.7:可操控的通用机器人基础模型
2.1.1 基础架构与基本功能
π0.7(Physical Intelligence)是 π0 之后的迭代,约 5B 参数,核心目标是通用性与可操控性的兼得。它采用"LLM 规划 + 世界模型想象 + VLA 执行"的三层协同:70B 高级语言策略(Gemini 2.0 Pro 蒸馏/GPT-4o)把长程任务分解为子任务序列;14B BAGEL 世界模型(Mixture-of-Transformers)根据当前画面+子任务生成"子目标图片";5B 核心 VLA(Gemma3-4B + SigLIP 400M + Action Expert 860M)用 Flow Matching 生成动作块。其标志性能力包括跨本体零样本泛化(UR5e 零样本叠衬衫)、组合任务泛化(从烤箱/洗碗机泛化到空气炸锅)、以及数据驱动的涌现行为(避障、故障恢复、隐式记忆)。
2.1.2 架构图
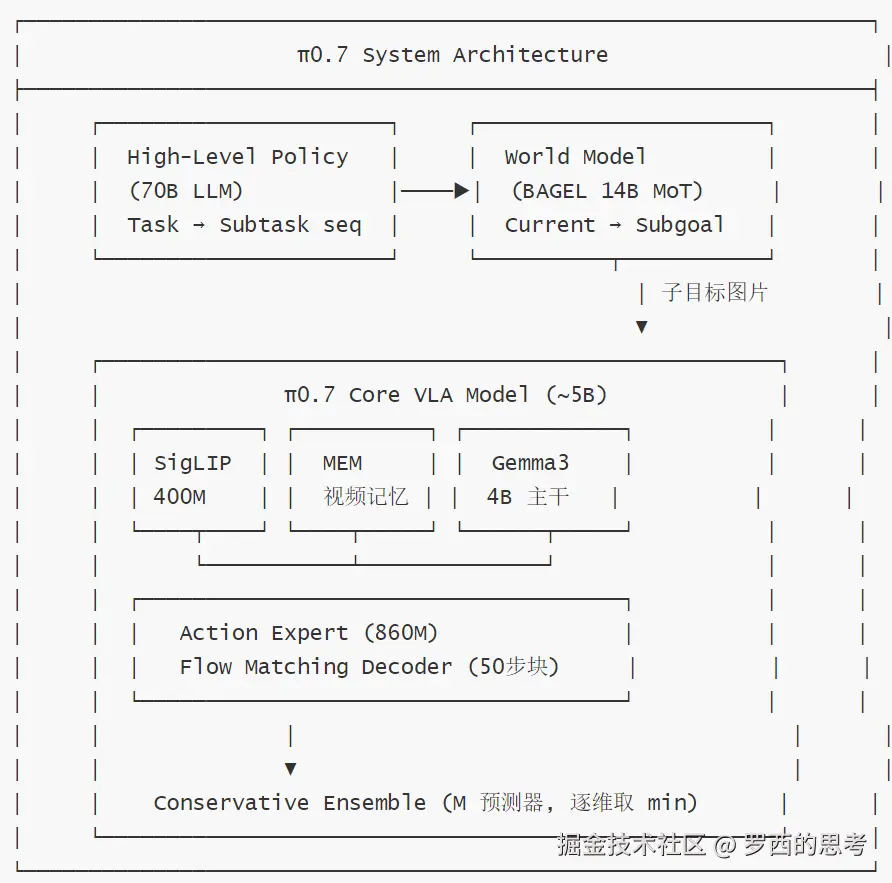
WM-VLA-PI0.7
2.1.3 数据流(以"叠衬衫"为例)
java
"帮我叠好那件蓝衬衫"
  → 70B LLM 分解: "把衬衫平铺在桌面上" → "折叠左袖" → ...
  → BAGEL: 当前桌面图 + "把衬衫平铺" → 子目标图片
  → π0.7 Core 编码: 高分辨率局部图 + 低分辨率全局图 + MEM视频历史
      + 子任务文本 + BAGEL子目标图 + 本体感知 + 控制模式元数据
  → Action Expert (Flow Matching): M 个预测器 → 逐维取 min → 50步动作
  → 执行前 25 步 → 新观测 → 滑动窗口 → 循环
  → 子任务完成 → 通知高层 → 下一子任务
2.1.4 优点
- 通用性极强:跨本体零样本、组合任务泛化、指令跟随新环境,均达到 SOTA。
- 可操控性完整:子任务文本 + 子目标图片 + 控制模式 + 元数据(speed/quality/mistake),人类可以在每一层干预。
- 数据哲学先进:"拥抱失败数据"被证明显著提升泛化与失败恢复,挑战了"垃圾进垃圾出"的传统观点。
- 工程务实:模块化(三层独立训练/替换)、规模化(70B+14B 低频调用,5B 高频推理)。
- 涌现能力实证:行为涌现、故障恢复、解析记忆,暗示隐式心智模型与因果推理能力。
2.1.5 缺点
- 开环组合:三层独立训练,接口处无联合优化,误差逐级放大,失败无法归因到具体层。
- 世界模型单点故障:BAGEL 生成不合理子目标时,VLA 会忠实执行错误规划。
- 延迟错配:BAGEL 每 4 秒更新一次子目标,VLA 却 20-50Hz 推理,VLA 大部分时间用"过期"子目标运行。
- 物理推理缺失:无显式物理模型,无法计算载荷/接触,极端物理参数下失败。
- 缺长时程记忆:MEM 是滑动窗口,10 分钟级任务无法维持早期步骤的精确记忆。
2.1.6 改进方向
- 接口加反馈回路:VLA 置信度低(Ensemble 分歧大)时触发 BAGEL 重生成/LLM 重规划。
- BAGEL 与 VLA 联合微调,把"生成子目标"与"执行子目标"变成端到端可微流程。
- 引入物理预测头(物体 6-DoF 位姿、接触点、任务进度),替换/补充像素级子目标。
- 把显式 14B BAGEL 内化为 VLA 表征空间的隐式约束,消除推理延迟错配。
2.2 τ₀-VLA:分层式机器人基础模型
2.2.1 基础架构与基本功能
τ₀-VLA(AgiBot / SII Research)是一个分层式基础模型 ,约 3B 参数,核心洞察是"长任务中'执行不了'和'不知道该做什么'是两回事"。高层策略负责"跟踪进度 + 决定下一步做什么",必要时启动世界模型引导的测试时计算(TTC) ;低层策略是通用型 VLA,接受 40,115 小时异构真实世界数据训练(23.4K 内部 + 16.7K 公开,覆盖 AGIBOT G1/G2、ARX AC One、Franka 等)。五大精华特性:WM-guided TTC、子任务级束搜索、统一 40D 动作空间、Qwen3.5 + MoT 动作专家、高频闭环 + 深度思考动态路由。
2.2.2 架构图
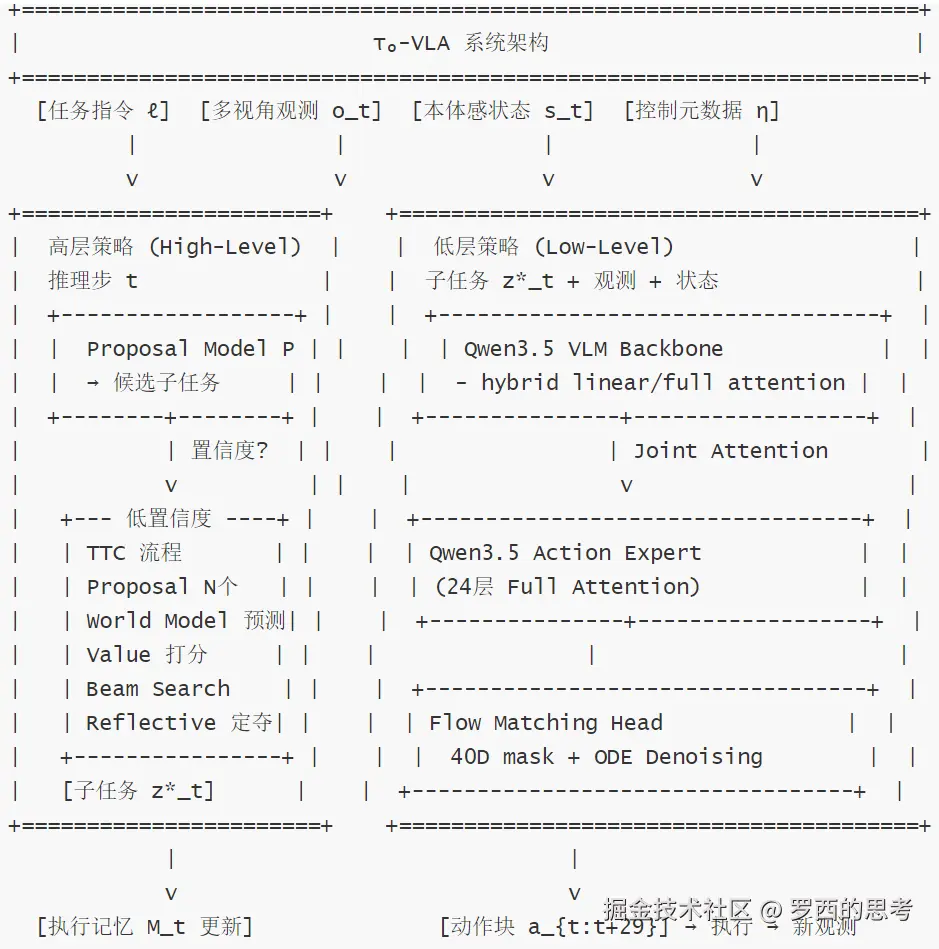
WM-VLA--τ₀-VLA
2.2.3 数据流(以"做麻婆豆腐"为例)
ini
高层: t=0 观测厨房 → Proposal "准备食材" → 置信度高 → 直接输出
      t=4 "加入豆瓣酱" → 置信度低 → TTC!
        Proposal: {豆瓣酱, 老干妈, 甜面酱}
        World Model: 各预测汤色结果 → Value Model: 打分
        Beam Search: 保留 Top-B 递归扩展 → Reflective: "加入豆瓣酱"
      → 输出子任务
低层: 收到 "加入豆瓣酱" → Qwen3.5 编码多视角图+指令 → 40D 动作块(30步)
      → 执行 ~1s → 新观测 → 高层继续推理
2.2.4 优点
- 计算预算自适应:简单决策一次前向,复杂决策才触发 TTC------"该想才想"。
- 跨本体泛化实用:40D 统一空间 + mask,一个模型控制多种机器人。
- 世界模型作为评估器:对世界模型精度要求低,可用更轻量模型,且非热路径调用。
- 数据规模与质量:40,115 小时 + 严格的质量控制流水线(污染过滤、LLM-as-a-Judge)。
- 工程严谨:异步双系统服务、右填充、CUDA Graph、torch.compile,部署考虑周全。
2.2.5 缺点
- TTC 流程复杂:四模型(Proposal/World/Value/Reflective)协同 pipeline 部署调试难。
- Value Model 训练瓶颈:需构建 (指令,候选,预测图)→分数 三元组数据集,构建本身是挑战。
- 误差级联:高层选错子任务直接传导到低层;闭环 27.5→45.0% 仍有半数场景失败。
- 粗粒度世界模型丢过程信息:终端图像预测看不出"倒多了还是倒少了"。
- 异步延迟耦合:高层约 1s 刷新,控制环读缓存,复杂任务的高层决策延迟会拖慢命令刷新。
2.2.6 改进方向
- Value Model + Error Recovery:实际结果与世界模型预测差距过大时触发 replanning。
- 显式成功/失败标记进执行记忆,而非纯隐式状态。
- 复用 τ₀-WM 的 re-denoising consistency 做轻量预筛选,再调用完整世界模型。
- 高层与低层端到端联合微调,改善接口协同。
2.3 τ₀-WM:统一视频-动作世界模型
2.3.1 基础架构与基本功能
τ₀-WM(上海创智学院 & AGIBOT Finch,2026.05,arXiv 2606.01027)用单个 5.5B 视频扩散骨干同时承载 Policy 与 Simulator。VAM(Video Action Model)回答"该怎么做",ACVS(Action-Conditioned Video Simulator)回答"如果这么做会怎样"。训练数据 27,300 小时(17,800h 机器人 + 6,500h UMI + 3,000h 人类视频),用模态掩码统一训练;推理时用 TTC(RCS 轻量筛选 + LAR 重量修正)形成"提议→评价→修正"闭环。
2.3.2 架构图
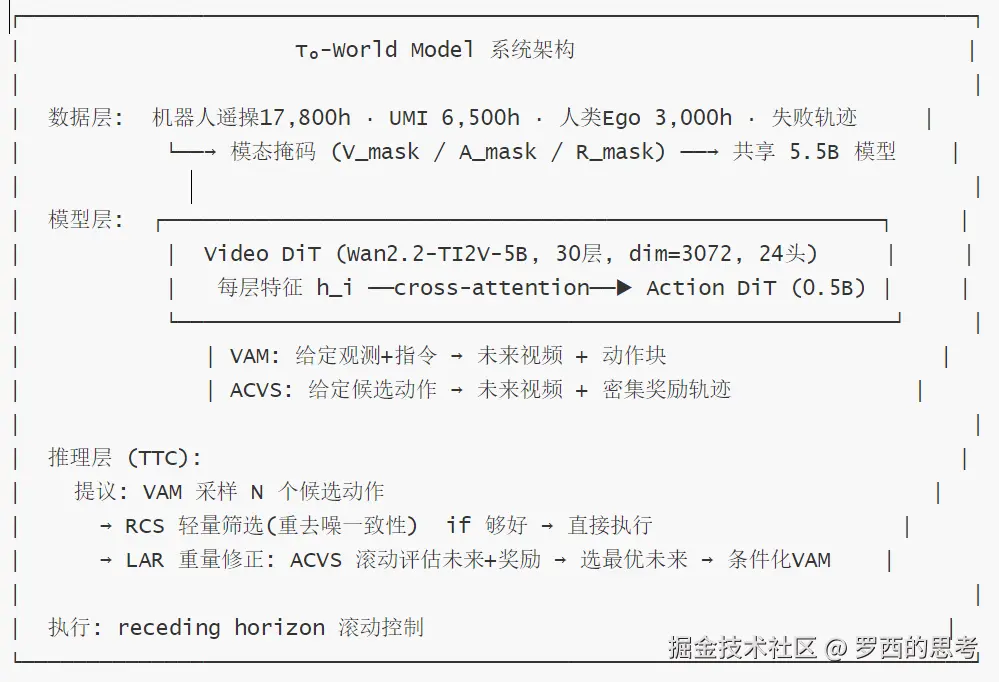
WM-VLA--τ₀-WM
2.3.3 数据流(训练)
scss
机器人(动作:精确, 视频:有, 奖励:无)
UMI(动作:弱, 视频:有, 奖励:无)  ──→ 模态掩码 ──→ 统一 World Model
人类Ego(动作:无, 视频:有, 奖励:无)               V_mask/A_mask/R_mask
失败轨迹(动作:无, 视频:有, 奖励:有)              (失败数据只训 ACVS 奖励头)
  → Flow Matching 联合损失: L_V(视频) + λ_a·L_A(动作) [ACVS 加 L_R(奖励)]
  → 视频 shift=5.0 / 动作 shift=1.0 独立时间步
2.3.4 优点
- 架构级统一:VAM 与 ACVS 共享骨干,保证 Policy 与 Simulator 对动作空间理解一致。
- 数据效率高:模态掩码让机器人/UMI/人类视频/失败数据互补。
- 推理时自适应:RCS 轻/LAR 重的两级策略,大部分情况 ~225ms 直接过。
- 失败数据用对地方:失败轨迹训评价模型而非 Policy,越训越准。
2.3.5 缺点
- TTC 延迟代价:LAR 触发时需 N 次 ACVS rollout + 二次 VAM,延迟升至秒级。
- Simulator 未开源:ACVS 权重与 TTC 代码未发布,核心贡献不可复现。
- RCS 理论薄弱:启发式度量,无理论保证与真实成功率的单调关系。
- 评估规模小:仅 4 个操作任务,高精度任务(Faucet 40%)仍是开放问题。
2.3.6 改进方向
- 自动子任务分解(LLM/LMM)消除人工标注瓶颈。
- RCS 的理论分析或更好的替代度量。
- 加入触觉/力传感器提升接触密集任务。
- Simulator-in-the-loop 训练:用 ACVS 评估信号在线优化 VAM。
- 渐进式 TTC(从二值门限到置信度融合)。
2.4 WALL-WM:事件级世界动作模型
2.4.1 基础架构与基本功能
WALL-WM(X Square Robot,2026.06,arXiv 2606.01955)的核心贡献是重新定义 WAM 的优化基底:把原子学习单位从"固定长度 chunk"替换为"语义事件"。双塔架构(Video DiT 继承 Wan 并冻结 + Action DiT 随机初始化),层级单向耦合(action 每层 cross-attend video 特征,不反向修改 video 塔)。两种推理模式:Event Mode(变长执行)+ Unified Mode(固定 chunk + Staircase Decoding 潜在推理)。配套 UMI 采集、四层层次化标注、聚类平衡采样,DMD 蒸馏 + FP8 量化实现 10Hz 实时闭环。
2.4.2 架构图
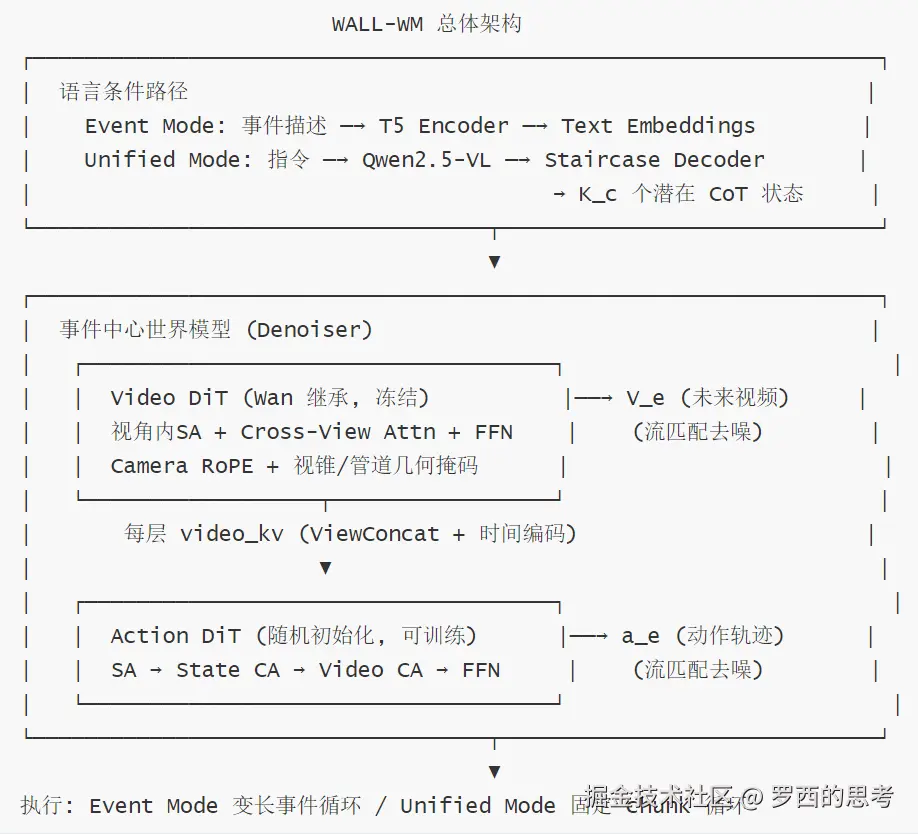
WM-VLA-WALL-WM
2.4.3 数据流(训练与推理)
yaml
训练 (5阶段):
  ① Video Pretraining: 冻结Wan, 训 Cross-View Attn + Camera RoPE + 几何掩码
  ② Action Pretraining: 冻结Video塔, 训 Action塔 + 层级耦合 (联合去噪 L_V+L_A)
  ③ VLM Text-Conditioner: 训 Qwen2.5-VL 桥接 → 事件描述嵌入
  ④ Staircase Distillation: AR Teacher(Qwen3.5-9B) → K_c 并行潜状态 (MoT)
  ⑤ Next-Chunk Adaptation (可选): 迁到观测中心窗口
  ── 非对称时间步: Video 固定 t*=0.5 算1次, Action 在 N_d=4 个水平算4次
  ── 损失: L_total = L_V + λ_A·L_A   (流匹配 velocity target)

推理:
  Event Mode: VLM "下一个事件?" → "用右手抓取蓝色杯子" → T5 → WALL-WM 变长去噪
  Unified Mode: Staircase K_c 潜状态 → 固定 chunk 动作去噪 (DMD 4步)
2.4.4 优点
- 事件对齐的泛化收益:Event Mode 在推理/泛化任务上优势最明显(操作多样化 64.84 vs baseline 60.84;推理操作 53.00 vs 42.25)。
- 先验保护:冻结 Video 塔 + 零初始化投影器,互联网规模视频先验被完整保留。
- 变长执行:持续时间跟随任务而非时钟,不用猜测 chunk 长度。
- 两种模式统一骨干:Event Mode 开放世界,Unified Mode 固定接口。
- 工程极致:DMD 50→4 步 + FP8 per-block + Muon,A100 上 120ms/10Hz。
2.4.5 缺点
- 灵巧操作弱:事件模式在接触级精度任务上的优势很小(32.00 vs 31.25)。
- 事件标注成本高:四层人工标注,自监督事件发现仅列为未来工作。
- 无公开数据集/代码:内部评分体系,论文架构与 Wall-OSS 开源实现并不一致(后者是单塔 Qwen2.5-VL VLA)。
- 实时性边界:120ms 对慢速拾取可接受,高速操作不足。
- 安全性:预测最终抓取状态而无中间检查,环境变化时可能不安全运动。
2.4.6 改进方向
- 自监督事件发现(动作速度/接触突变/场景变化)替代人工标注。
- 事件预测闭环:WALL-WM 执行结果反馈到 VLM 修正下一事件预测。
- 跨实体迁移验证(当前仅 AgileX 单平台)。
- 多模态触觉融合提升灵巧操作。
- 推理时安全验证 + 不确定性量化。
2.5 MemoryWAM:高效持久记忆的世界动作模型
2.5.1 基础架构与基本功能
MemoryWAM 的目标是打破 WAM 的记忆-效率权衡 。它基于 Wan2.2-TI2V-5B 预训练视频 DiT,采用 Mixture-of-Transformers(MoT)架构:视频 DiT(Φ_v,5B)负责物理动态编码,动作 DiT(Φ_a,1B,从 Φ_v 插值初始化)负责动作生成,中间用混合记忆缓存连接------短期记忆(最近 4 帧完整 token)+ 事件边界记忆(起始 2 帧锚点)+ 摘要记忆(中间帧各 8 个 gist token,15:1 压缩)。复杂度从 O(N) 降到 O(N/15)。
2.5.2 架构图
scss
当前帧 (384×320)
    │ 因果VAE编码 (Wan2.2 3D causal, 120 tokens/帧)
    ▼
clean latent z_t
    │
    ▼
视频 DiT (Φ_v, 5B, Wan2.2初始化)   ← 推理时只前向, 不做视频生成!
    ▼
更新混合 KV 缓存 C^v_≤t
    ├── 短期记忆: 最近4帧, 完整120tok/帧    → 精细闭环控制
    ├── 锚点记忆: 起始2帧, 完整120tok/帧    → 任务初始化语义
    └── 摘要记忆: 中间帧→各8个gist tok     → 驱逐原始KV, 保留压缩摘要
    │
    ▼
定制注意力掩码 (统一访问三个缓存分区)
    │ 最近/锚点帧: 后续token直接注意完整token
    │ 中间帧: 后续token只能注意gist token
    ▼
动作 DiT (Φ_a, 1B) → denoising (h=16步) → 动作块
2.5.3 数据流
bash
观测 → VAE编码 → clean latent → 视频DiT前向 → 更新混合KV缓存
  → 动作DiT(注意混合缓存) → 16步动作块 → 执行 → 新观测 → 循环
训练: 视频帧预测(Flow Matching, 视频shift=5.0/动作shift=1.0)
      + 训练-推理一致性visibility mask (训练时不能"作弊"看到会被驱逐的帧)
2.5.4 优点
- 精准解决记忆-效率权衡:1,600 帧轨迹上延迟和显存显著低于 RNN/TTT/Full Attention。
- 性能实证:RMBench 83.0%,远超 π0.5(10.4%)和 FastWAM(5.9%),超过全历史 LingBot-VA(78.2%);真实世界 Shell Game 18/20。
- 方法论启发:"压缩和筛选历史本身就是表征学习"------Full Attention 91.5% < Hybrid 92.5% 有力反驳"记忆越多越好"。
- gist 关键性被证明:去掉 gist 使 Press Button 从 87% 骤降至 5%。
- 工程务实:保留完整视频 DiT,只在记忆管理上做优化,集成成本低。
2.5.5 缺点
- 锚点选择过于简化:只保留任务起始 2 帧,多阶段任务可能有多个重要事件边界。
- gist 信息丢失是硬性的:15:1 压缩没有信息损失的直接评估,精装配任务 8 个 token 是否够未验证。
- 长程性能未被充分验证:RMBench 轨迹长度未明确报告,缺乏 10 分钟级任务验证。
- 固定 4 帧短窗:快变/慢变场景不能自适应。
- 语义理解受限:论文自认视频 DiT 缺乏语义理解与推理能力。
2.5.6 改进方向
- 自适应事件边界检测(WALL-WM 事件概念 + VLM/变化检测触发),多阶段任务每个阶段有自己的锚点。
- 动态 gist token 分配(关键帧多、平凡帧少),甚至按事件段共享 gist 降冗余。
- 与语义理解模型融合(VLM + 混合记忆),让 gist 不仅压缩视觉也包含语义摘要。
- MOBA 式注意力头路由:不同头集群专注短窗/锚点/gist 记忆,自适应分配注意力预算。
2.6 EventVLA:稀疏视觉证据记忆
2.6.1 基础架构与基本功能
EventVLA(InternRobotics,arXiv 2606.20092)的核心是稀疏视觉证据记忆 :不给模型塞入稠密视频历史,而是让模型只记住"关键帧"(视觉证据)。架构 = 基础视觉锚点(初始帧永久保留)+ 短时滑动窗口 + 关键帧证据记忆(KEM)动态缓冲区。它用前瞻式关键帧调度器(基于 VLM 联合隐状态)预测"未来哪几帧会成为关键证据",配合 1D-NMS 去重 + 冷却期防止重复采样。在 17 个仿真 + 4 个真实任务上平均成功率相对提升 40%。
2.6.2 架构图
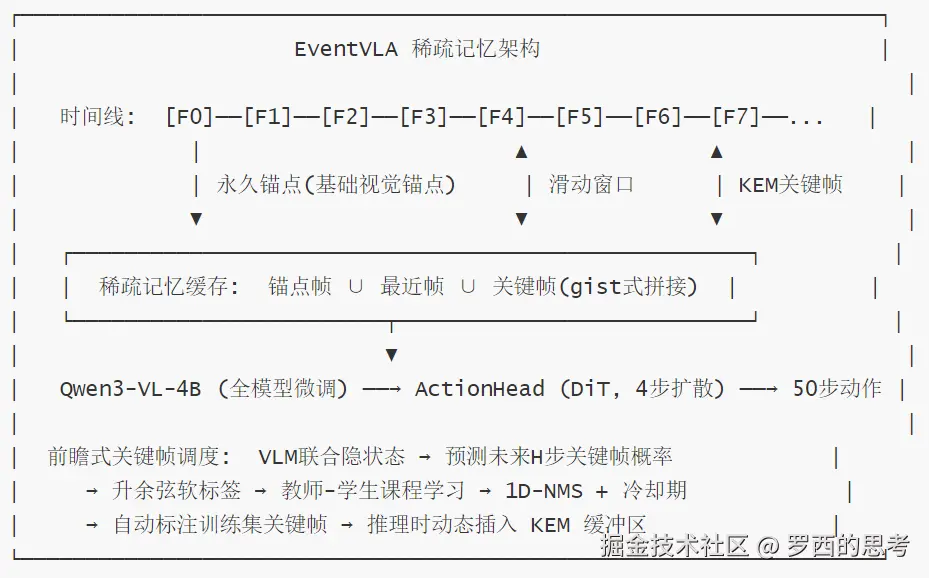
WM-VLA-EventVLA
2.6.3 数据流
makefile
训练: 轨迹帧 → Qwen3-VL 自动标注关键帧(升余弦软标签)
      → 教师-学生课程学习(逐步教会模型"什么时刻该记")
      → _augment_batch_images_with_keyframe_images 拼接记忆图像进 batch
      → 全模型微调 Qwen3-VL-4B (8万步 / 8 GPU)
推理: 观测 → 锚点帧永久缓存 + 最近帧滑动窗口
      → 调度器预测关键帧概率 → 超过阈值的帧进 KEM 缓冲区
      → 记忆图像拼接 → VLM 编码 → ActionHead DiT(4步扩散, t=[999,750,500,250])
      → 50 步动作 (一次 forward, 无 re-stage 容错)
2.6.4 优点
- 记忆效率高:只存关键帧而非全部历史,视觉 token 数大幅减少。
- 前瞻式调度:不是被动"记最近",而是主动"记未来会用到的",与人类做笔记策略同构。
- 训练-推理一致的调度学习:软标签 + 课程学习让"何时该记"成为可学习能力。
- 诊断基准完备:RoboTwin-MeM 参数化记忆需求,能量化"记多深才够"。
- 结果显著:17 sim + 4 real 任务平均成功率相对提升 40%。
2.6.5 缺点
- 无显式容错:生成式策略一次 forward 出 50 步动作,无 re-stage/重试机制。
- 关键帧质量依赖调度器:调度器预测不准时,关键证据可能被漏记。
- 课程学习复杂度:教师-学生训练需要精心设计,迁移到新域可能不稳定。
- 对比基准少:未与 MemoryWAM 式压缩记忆直接同台对比。
2.6.6 改进方向
- 与分层记忆结合(锚点 + 关键帧 + gist 三合一),兼顾语义基态与细节。
- 加入闭环重试/恢复,弥补"一次 forward 50 步"的无容错短板。
- 关键帧调度与 MemoryWAM 的动态锚点融合,覆盖多阶段任务。
- 将关键帧记忆作为"可检索接口"供高层规划器使用。
2.7 LaWAM:潜动作世界模型
2.7.1 基础架构与基本功能
LaWAM(Latent World Action Models)的核心命题是解决"推理时未来不可见 "的矛盾。它用两阶段知识蒸馏:Stage 1 训练潜动作模型(LAM,Teacher)------逆动力学编码器 q_ϕ(z|u, u_T) 从(当前帧, 未来帧)推断 32 维潜动作 z,解码器保留为潜世界模型 LaWM;Stage 2 训练 VLA 策略(Student)p_θ(ẑ|o, l) 从当前观测预测潜动作 ẑ,通过潜动作蒸馏逼近教师,再用冻结的 LaWM 把 ẑ 解码成潜子目标 û_T 条件化动作生成。核心技巧是知识绝缘(KI) ------阻止动作梯度破坏 LaWM。结果:LIBERO 98.6%、187ms、2.3B 参数。
2.7.2 架构图
r
Stage 1 (训练 Teacher/LAM):
  (当前帧 u, 未来帧 u_T) → 逆动力学编码器 q_ϕ(z|u,u_T) → 32维潜动作 z
        │  解码器保留为潜世界模型 LaWM:  z + 当前帧 → 潜子目标 û_T
        ▼
Stage 2 (训练 Student/VLA):
  当前观测 o + 语言指令 l → VLA 策略 p_θ(ẑ|o,l) → 预测潜动作 ẑ
        │ ① 潜动作蒸馏: 让 ẑ 逼近教师的 z (KL/MSE)
        │ ② 冻结 LaWM: ẑ 解码 → 潜子目标 û_T → 条件化动作生成
        │ ③ 知识绝缘(KI): 动作梯度不回传, 保护 LaWM 世界知识
        ▼
  输出动作
推理: 只用当前观测 → VLA → 潜动作 → 冻结 LaWM 解码潜子目标 → 动作
      (零视频生成开销, 未来信息全在参数里)
2.7.3 数据流
arduino
教师数据: (o_t, o_{t+T}) → q_ϕ → z (32维潜动作) → LaWM 解码 û_T
学生训练: o_t + l → p_θ → ẑ
  loss = 潜动作蒸馏损失(ẑ vs z) + 潜子目标条件动作损失(用冻结LaWM)
  KI: 动作梯度不穿过 LaWM (只更新 VLA 参数)
推理: o_t + l → p_θ → ẑ → LaWM(frozen) → û_T → 动作生成器 → 动作
2.7.4 优点
- 推理效率极高:未来信息压缩进 32 维潜动作,推理时零视频生成开销,187ms。
- 参数规模小:2.3B 即可在 LIBERO 达到 98.6%。
- 解决"未来不可见"矛盾:训练时用未来(教师),推理时不用未来(学生蒸馏)。
- 知识绝缘保护世界知识:动作梯度不破坏 LaWM,训练稳定。
- 理论优雅:潜动作是"未来状态变化的可执行摘要",比像素未来更接近控制语义。
2.7.5 缺点
- 信息瓶颈:32 维潜动作可能丢失精细空间信息(精装配类任务存疑)。
- 数据需求:双分支训练需要足够多的 (当前,未来) 对,Being-H0.7 用了 20 万小时人类视频。
- 失去视频先验:不继承 Wan 等视频生成先验,世界知识全靠训练数据学。
- LIBERO 单一基准:98.6% 需要放在 LIBERO 饱和争议语境下理解。
2.7.6 改进方向
- 潜动作维度自适应(关键任务高维、平凡任务低维)。
- 与 MemoryWAM 混合记忆结合:潜动作 + 关键帧高保真并存。
- 继承视频先验:用 Wan2.2 等初始化 LaWM 解码器。
- 在真实世界与 RoboTwin 等更难的基准上验证。
2.8 Being-H0.7:隐空间世界-动作模型
2.8.1 基础架构与基本功能
Being-H0.7(北京大学 BeingBeyond,2026.04,arXiv 2605.00078)属于"潜空间世界建模 "路线,核心命题是:未来的价值不在像素,而在隐空间中与当前状态的结构差异 。它用 16 个可学习的隐查询(latent queries)作为"工作记忆槽",通过双分支隐对齐------训练时让"只看当前观测的先验分支"与"看到了未来帧的后验分支"在 Transformer 的隐状态空间逐层对齐,推理时丢弃后验分支、零未来帧开销------把"理解未来"折叠进隐表示而非显式生成。
架构采用 MoT(Mixture of Transformers) 稀疏专家:Understanding Expert(InternVL3.5,~2.5B)处理文本与视觉,Action Expert(Qwen3,~0.5B)处理动作与隐查询,总参 3B、稀疏激活 FLOPs≈1.2B。预训练数据 ~20 万小时自我中心人类视频 + ~1.5 万小时机器人操作数据(UniHand 2.0 统一序列格式)。成绩:LIBERO 99.2%、RoboCasa(few-shot) 62.1%、GR1 49.2%、CALVIN 4.67/5,并在 PND Adam-U / Unitree G1 / Franka FR3 三个真实平台 12 个任务上全能力套件第一;配合 UAC 异步分块实现 3-4ms/步延迟。
2.8.2 架构图
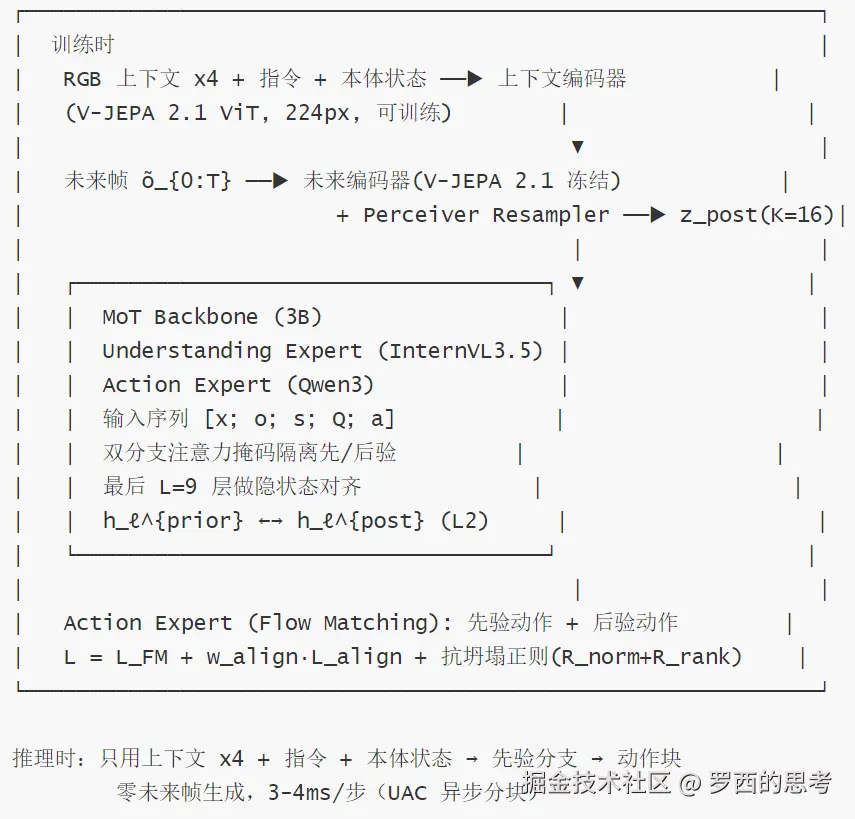
WM-VLA-Being-H0.7
2.8.3 数据流
css
训练 (双分支单序列打包):
  (o_{-4:0}, x, s) → 上下文编码器 → c
  õ_{0:T} → 未来编码器(冻结) + Perceiver → z_post (K=16)
  先验序列: [x; o; s; Q(可学习16槽); a_{0:T}]
  后验序列: [x; o; s; z_post; a_{0:T}]
  → 打包进同一 MoT 序列,双分支注意力掩码隔离 (preQ↛posE)
  → 每层: 共享上下文自注意力 + FFN
  → 最后 L=9 层记录 h_prior / h_post → L2 对齐
  → Action Expert Flow Matching: v_prior, v_post 分别预测速度场
  → L = L_FM(prior+post) + w_align·L_align + R_norm + R_rank

推理: o_{-4:0}+x+s → 上下文编码器 → MoT 先验分支 → Flow Matching 动作块
      (后验分支、未来帧、对齐损失全部丢弃)
2.8.4 优点
- 推理效率极高:训练时看未来、推理时零未来帧开销,3-4ms/步,适用于接滚球、抓传送带包裹等高频控制。
- 轻量跨本体:3B 参数 + 稀疏激活,PND Adam-U(31DoF)/ Unitree G1(26DoF)/ Franka FR3(13DoF)统一接口直接迁移。
- 保留未来理解收益:LIBERO 99.2% / RoboCasa 62.1%,真实世界 12 任务五能力套件全第一------证明"潜未来对齐"能拿回部分 WAM 的世界理解。
- 训练效率设计:双分支单序列打包(非两次前向)+ 冻结未来编码器 + 后处理去正则化。
- 人类视频利用充分:~20 万小时自我中心视频在 UniHand 2.0 下与机器人数据混训。
2.8.5 缺点
- 隐空间不可审计:推理过程是 16×d 个浮点数,无法像像素 WAM 那样"回放模型想象中的未来"来定位错误。
- 对齐损失与动作目标潜在冲突:L_align 要隐状态 L2 相近,L_FM 要动作更好,二者可能互斥;w_align=10⁻³ 太小可能让对齐效果偏弱。
- 信息瓶颈:K=16 固定容量,长程复杂任务可能装不下;压缩损失不可逆(像 RLT 的 RL Token 一样,丢了就回不来)。
- 小增量争议:对比 Being-H0.5 在多数仿真基准提升 <3%(LIBERO 99.2 vs 98.9),RoboTwin Hard 上甚至不如 2× 参数的 Fast-WAM(89.6 vs 91.9)。
- "纯动态预测"局限:真实任务多为反应式预测(球来了→接球),数十秒级长程因果推演(先倒水→再搅拌→再煮沸)未充分论证。
- 数据贡献未解耦:未消融"去掉人类视频",无法判断收益来自隐对齐还是更大的训练数据。
2.8.6 改进方向
- 动态隐查询数量:按任务复杂度自适应 K,甚至加"隐查询路由"。
- 对齐目标升级:L2 → 对比损失(SimCLR)/ InfoNCE,允许非线性对应。
- 层级化隐推理:底层编码"运动方向"、高层编码"亚目标进度"。
- 链式隐推理:推理时让隐查询多步迭代更新(Latent CoT),而非单次传播。
- 与 RL 结合:隐表示作为状态喂给 RLT 式在线精调。
- 显式动作-动态解耦:隐查询拆成"状态槽"与"动作槽",分别管世界演化与动作生成。
- 与 WALL-WM 事件学习、MemoryWAM 记忆结构交叉:隐查询可作为事件/记忆的天然锚点。
2.9 TurboVLA:去 LLM 的直通式 VLA
2.9.1 基础架构与基本功能
TurboVLA(华中科技大学 + 华为,2026.07,arXiv 2607.27205)挑战"一切以 LLM 为中心"的主流范式,把 V→L→A(视觉投影进 LLM 空间再由 LLM 解码动作)改写为 V+L→A(视觉与语言各自编码、轻量双向交互、直接预测连续动作块)。架构:DINOv3(视觉,可解冻)+ BERT(文本,冻结)+ 6 层双向交叉注意力(GroundingDINO 的 BiAttentionBlock 初始化)+ ACT 式 Transformer 解码器。在消费级 RTX 4090 上实现"0.2B 参数、0.9 GB 显存、31.2 ms 延迟、32 Hz 实时、LIBERO 平均 97.7% 成功率"。
2.9.2 架构图
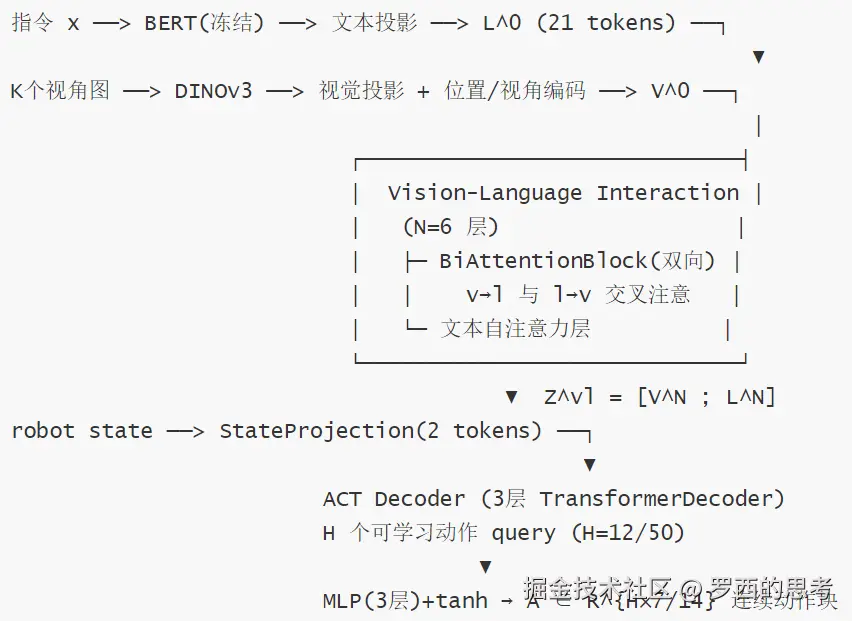
WM-VLA-TurboVLA
2.9.3 数据流
scss
训练 (纯行为克隆 + 掩码L1):
  samples{dinov3:[B,2,3,256,256]} → DINOv3 → 视觉投影 → V^0
  instructions → BERT(在线,冻结) → 文本投影 → L^0 + 子句级掩码
  states → 归一化
  → 6层双向交互 → Z^vl → ACT Decoder → pred[B,12,7]
  → masked_l1_loss(pred, gt, mask) → backward (LR 5e-5, 80k步, 4×4090)
  (无辅助语言建模目标, 无扩散/flow)

推理 (LIBERO open-loop 12步):
  policy.predict_env_action_chunk(主图, 腕图, 指令, obs)
  → 前向一次 → 12步动作块 → 反归一化 → 执行
2.9.4 优点
- 性能-效率同时占优:LIBERO 97.7% + 31.2ms + 0.9GB + 0.2B,全面优于同级/更高级方法。
- 范式级创新:正面论证"执行级控制不需要 LLM 居中",不是工程压缩而是架构选择。
- 借力打力:GroundingDINO 权重初始化 + no_noops 数据复用 + VLA-Adapter 协议。
- 跨基准与真机:LIBERO(单臂)/RoboTwin(双臂)/AgileX Piper(真机)三处跑通,架构可缩放。
- 工程完整:DDP/DeepSpeed 双后端、msgpack 部署、自适应动作集成、严格的 checkpoint 兼容校验。
2.9.5 缺点
- 开放词表与高层推理被放弃:无推理、无长时规划,对非执行级指令退化。
- LIBERO 分数需打折理解:基准本身有记忆化争议(LIBERO-PRO/Plus 系统批评),协议/数据自定义,跨论文可比性弱。
- 动作回归头偏简单:L1 + tanh 对多峰动作无能为力,LIBERO 上纯 open-loop 重放。
- 训练成本被低估:全量解冻 DINOv3 + 4×4090 + 80k 步,"推理便宜"不等于"训练便宜"。
- 消融不完整:未做随机初始化交互层、未隔离"交互模块 vs 解码器"的独立贡献。
2.9.6 改进方向
- 分层系统(论文自述 future work):LLM 做高层规划,TurboVLA 做低层执行。
- 更强的动作头:diffusion/flow 或 GMM,兼顾多峰与平滑。
- 鲁棒性训练:LIBERO-Plus/X 式扰动增强,缓解视觉 shift 脆弱。
- 低成本训练:视觉 backbone 用 LoRA 或先冻结后蒸馏。
- 更公平评估:报 LIBERO-PRO/Plus/X 分数、per-task 置信区间、训练成本。
TransFormer-封面
本文使用 markdown.com.cn 排版