人类98分,AI全零分,一段雪花视频戳穿了大模型的底牌
先看一个实验。
一段视频,平均7.1秒,大约333帧。
每一帧都是雪花,纯噪声。暂停在任何一帧,什么都看不见。
按下播放键,内容自己浮出来了。可能藏着几个字母,可能是一个物体的轮廓。动起来才有,停下来就没了。
灵异故事谈不上,这是CVPR 2026的一篇论文,KAUST和MBZUAI的研究者做的,基准叫SpookyBench,专收这种雪花视频,一共451段。
实验是公开的,论文在这 arxiv.org/abs/2505.24... ,项目主页 timeblindness.github.io/ ,代码和数据 github.com/TimeBlindne... ,感兴趣可以自己跑一遍。
人类来考,6名标注者,平均准确率98%。
视频大模型来考,25个以上,参数从20亿到780亿,开源闭源全到齐,GPT-4o,Gemini 2.5 Pro,Qwen全家,InternVL全家。
0%。
一个漏网的都没有。开了思维链,还是0%。
你的第一反应,因该是题目太刁钻。
真相反着来, 这题对人类简单到离谱,扫一眼就能过。
可全世界的模型,齐刷刷零分。
这事背后,藏着最近行业里吵得最凶的一个问题。
多模态大模型已经能识别视频、描述视频了,为什么还是看不懂时间?
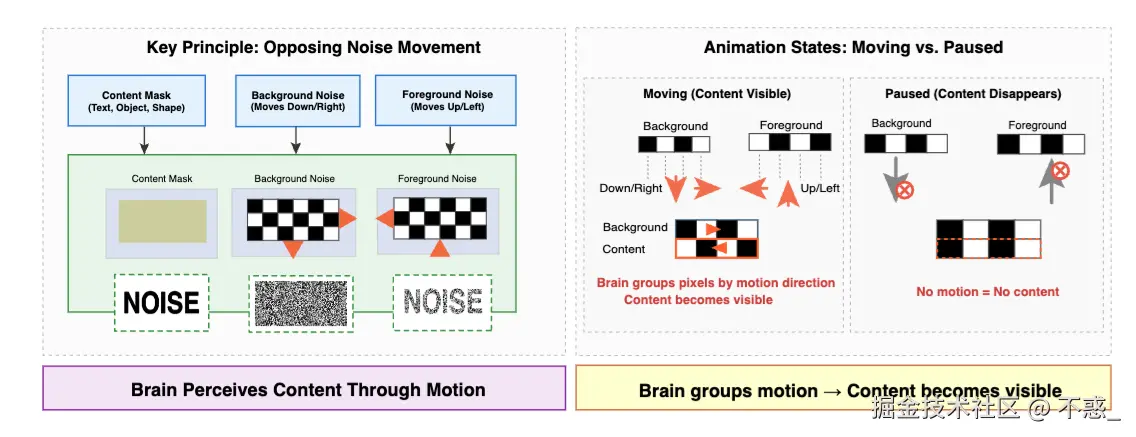
图来自SpookyBench项目页,动的噪声里藏着内容,大脑按运动方向给像素分组,内容就浮出来了
它在看幻灯片,你在看电影
想知道模型为什么瞎,得先看它是怎么看视频的。
主流方案大同小异。视频进来,先抽帧,几分钟的片子常常只留8到32帧。每帧单独过一遍图像编码器,压成一串视觉token,排好队,交给语言模型。
打个比方。
你在看电影,它在看幻灯片。
你看到一条流动的河,它拿到的是河的四张照片。
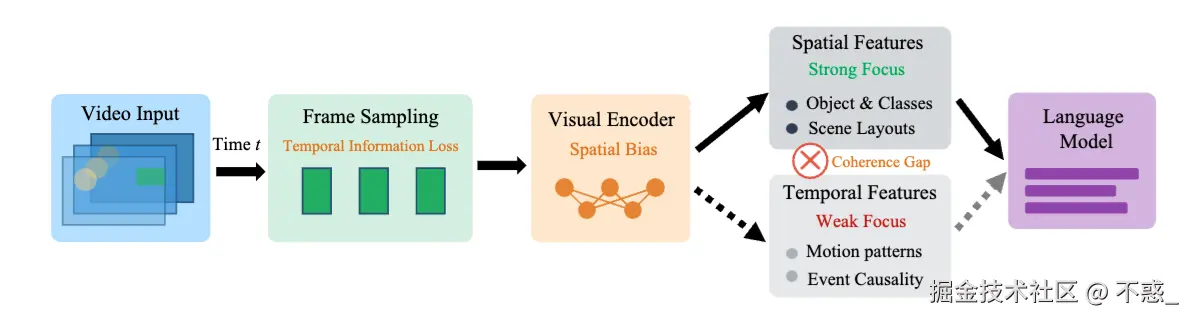
这张图把病根画得明明白白, 帧采样这一步,先把连续的时间剁碎了。视觉编码器又天生偏心,物体,布局,纹理这些空间特征它门儿清,运动,因果,先后顺序这些时间特征,基本处于失明状态。论文管中间那道裂口叫Coherence Gap,一致性缺口。
CVPR 2026另一篇论文WeaveTime给这个病起了正式名字,Time-Agnosticism,时间不可知症。他们的说法很形象,模型把视频当成一个无序的证据袋,帧的先后顺序,对它来说很多时候无所谓。
听着难以置信?有人做过验证。
TVBench团队干过一件特别损的事,把测试视频的帧顺序随机打乱,再喂给GPT-4o和Gemini 1.5 Pro。结果在老牌基准MVBench上,分数几乎不怎么掉。
翻译一下。之前很多所谓的视频理解高分,考的多半是静态识别加文本常识,时间压根没进考场。
更损的还有。TempCloze论文里提到一个2020年的老发现,纯文本语言模型不看视频,光靠选项的措辞和语言先验,就能比随机基线高出25个点以上。
考卷漏成筛子了。考了半天,时序感知根本没被考过。
加帧没用,思考也没用
直觉马上给出解法,那就多喂几帧,采样翻倍,看得多自然就懂了。
真有人试了。
CP-Bench的设计很朴素,镜头平移扫过一排外观一模一样的方块,每一帧只能看到局部,必须跨帧累积证据才能数对总数。
Qwen3-VL, InternVL3, 还有GPT-5, Gemini-3-Pro, 全挂。研究者把采样帧率拉高,成绩纹丝不动。
9月1日的新论文又补了一刀。TempCloze测下来,帧密度加上去,信息反而被稀释,模型严重依赖开头结尾的锚点,中间塞的帧越多,干扰越大。
那开思考模式呢,让它一步步推理?
TempCloze的结论是,测试时扩展能带来一些增益,但各维度之间的相对差距不变。ICLR 2026的MMR-V基准也发现,长视频多帧证据推理这件事,思维链和测试时扩展的收益很有限,最强的Gemini 2.5 Pro也只考了64.3%。更早的TemporalVQA给GPT-4o测时序先后判断,一致性准确率43.8%,人类是90.3%。
绕了一大圈,结论开始变得刺眼。
你以为它看得太少,其实它压根不知道怎么看时间。
病根挖出来了,在架构里
SpookyBench的作者没有停在现象上,他们做了三组实验,一组比一组狠。
第一组,教。拿400段雪花视频去微调InternVL2.5-8B和Qwen2-VL-7B,跑满30个epoch,硬灌。
还是零分。
第二组,连背都不给背。换VJEPA-2和DINOv3上,任务简单到判断画面里有没有内容。损失函数直接停在随机水平,过拟合都做不到。
死记硬背都失败,说明这些信息对模型来说压根不存在。
第三组,是全场最狠的一刀。
研究者用最老派的光流算法Farneback,把运动边界算出来,直接画在噪声帧上,相当于把时间信息提前翻译成空间线条,再喂给模型。
Qwen2-VL-7B,零分变51.5分。
GPT-4o,零分变59.1分。
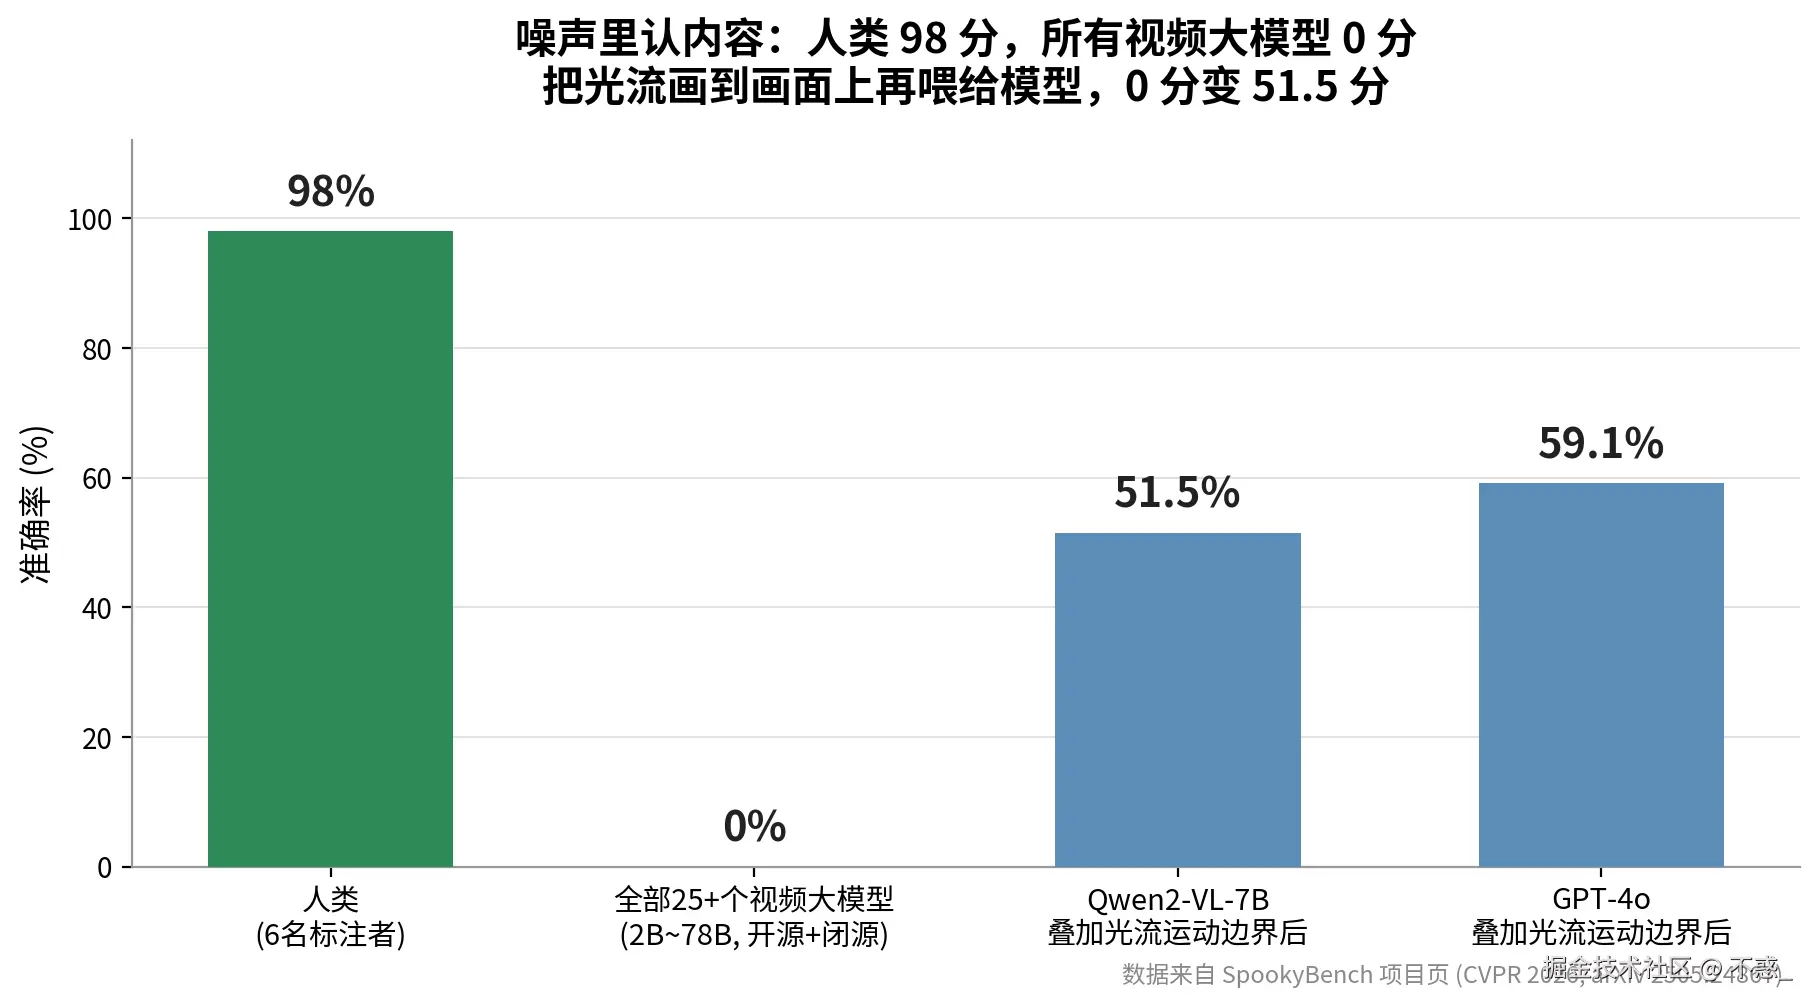
信息一直都在,一直算得出来,只是从来没能走到语言模型那里。
论文的诊断写得很直接,今天的视频大模型缺少帧间差分和时间整合机制,属于架构级的缺失,跟数据量无关,跟提示词写得好不好也无关。
人类这边靠的是几亿年进化攒下的硬件。心理学管它叫格式塔的共同命运原则,一起动的像素,大脑自动绑成一个东西。
自然界早就在用时间当信道。萤火虫靠闪光序列求偶,摩尔斯电码靠长短信号传信,脑电的病理特征也藏在时间模式里。
模型的流水线上,没有这条通路。
顺便说一句,动态场景那类雪花视频,就算叠了光流,模型也只做到3.5%封顶。
9月的新考卷,成绩依然惨烈
有人会讲,噪声视频太极端了,日常视频上模型总行吧。
咱们在把镜头拉回9月1日那篇TempCloze,港大, 新加坡国立, 北大三个团队联合做的。
玩法像个完形填空,给你看视频的开头和结尾,四个候选片段,选出真正夹在中间的那一段。
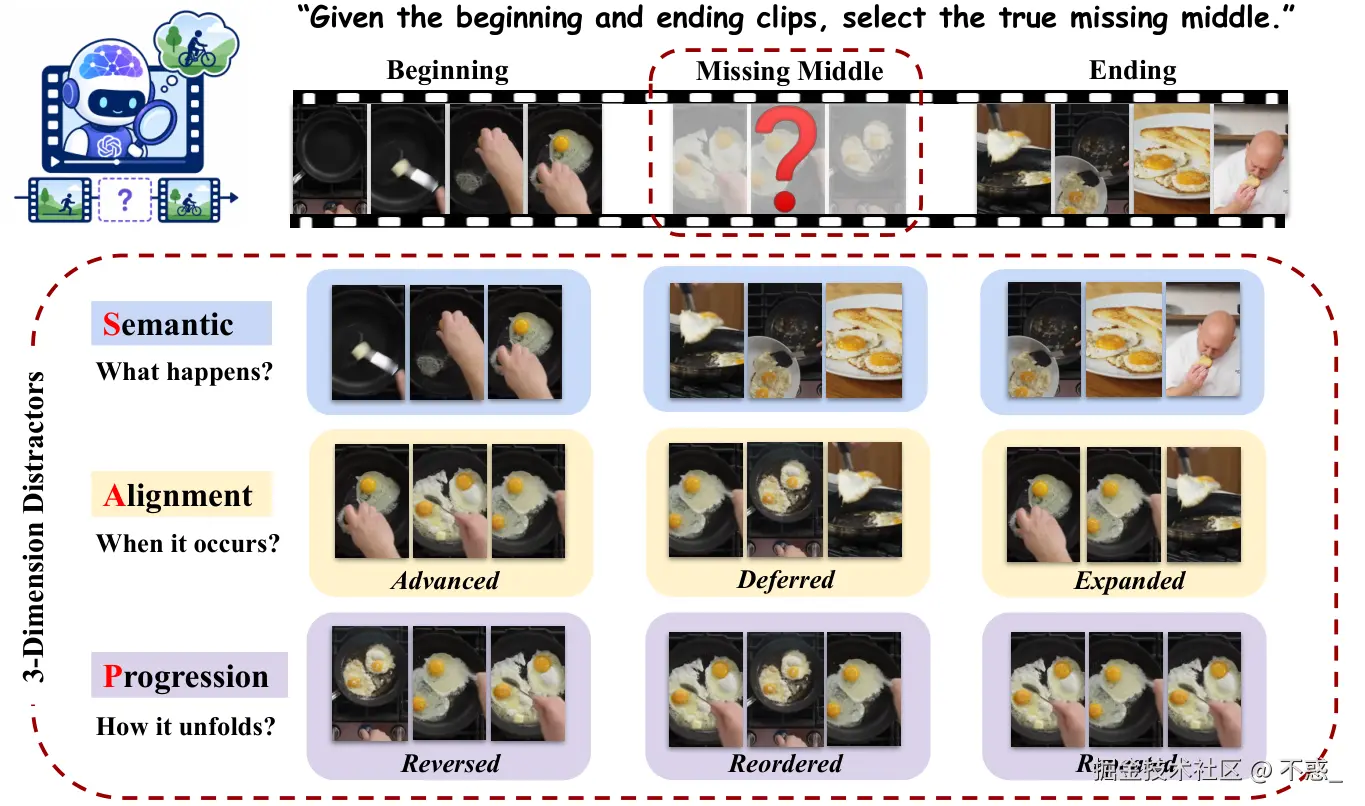
坏就坏在干扰项的构造。所有候选都来自同一段视频,同样的场景,同样的物体,光看长相根本分辩不出来,必须真懂时间才行。
考三个维度。语义,发生了什么。对齐,什么时候发生。演进,怎么展开。
31个模型参战,10个闭源,21个开源。
结果出奇地整齐。
语义大家都会,演进也还凑合,一到时序对齐,集体塌方。
GPT-5.4,语义68分,时序对齐37分。
Claude4.6-Sonnet,对齐28.8分。
Qwen3VL-32B,对齐10.9分。四选一的题,闭眼乱选都有25分,它比瞎选还低。
闭源模型平均,语义70.73,对齐48.13,差了22个点。
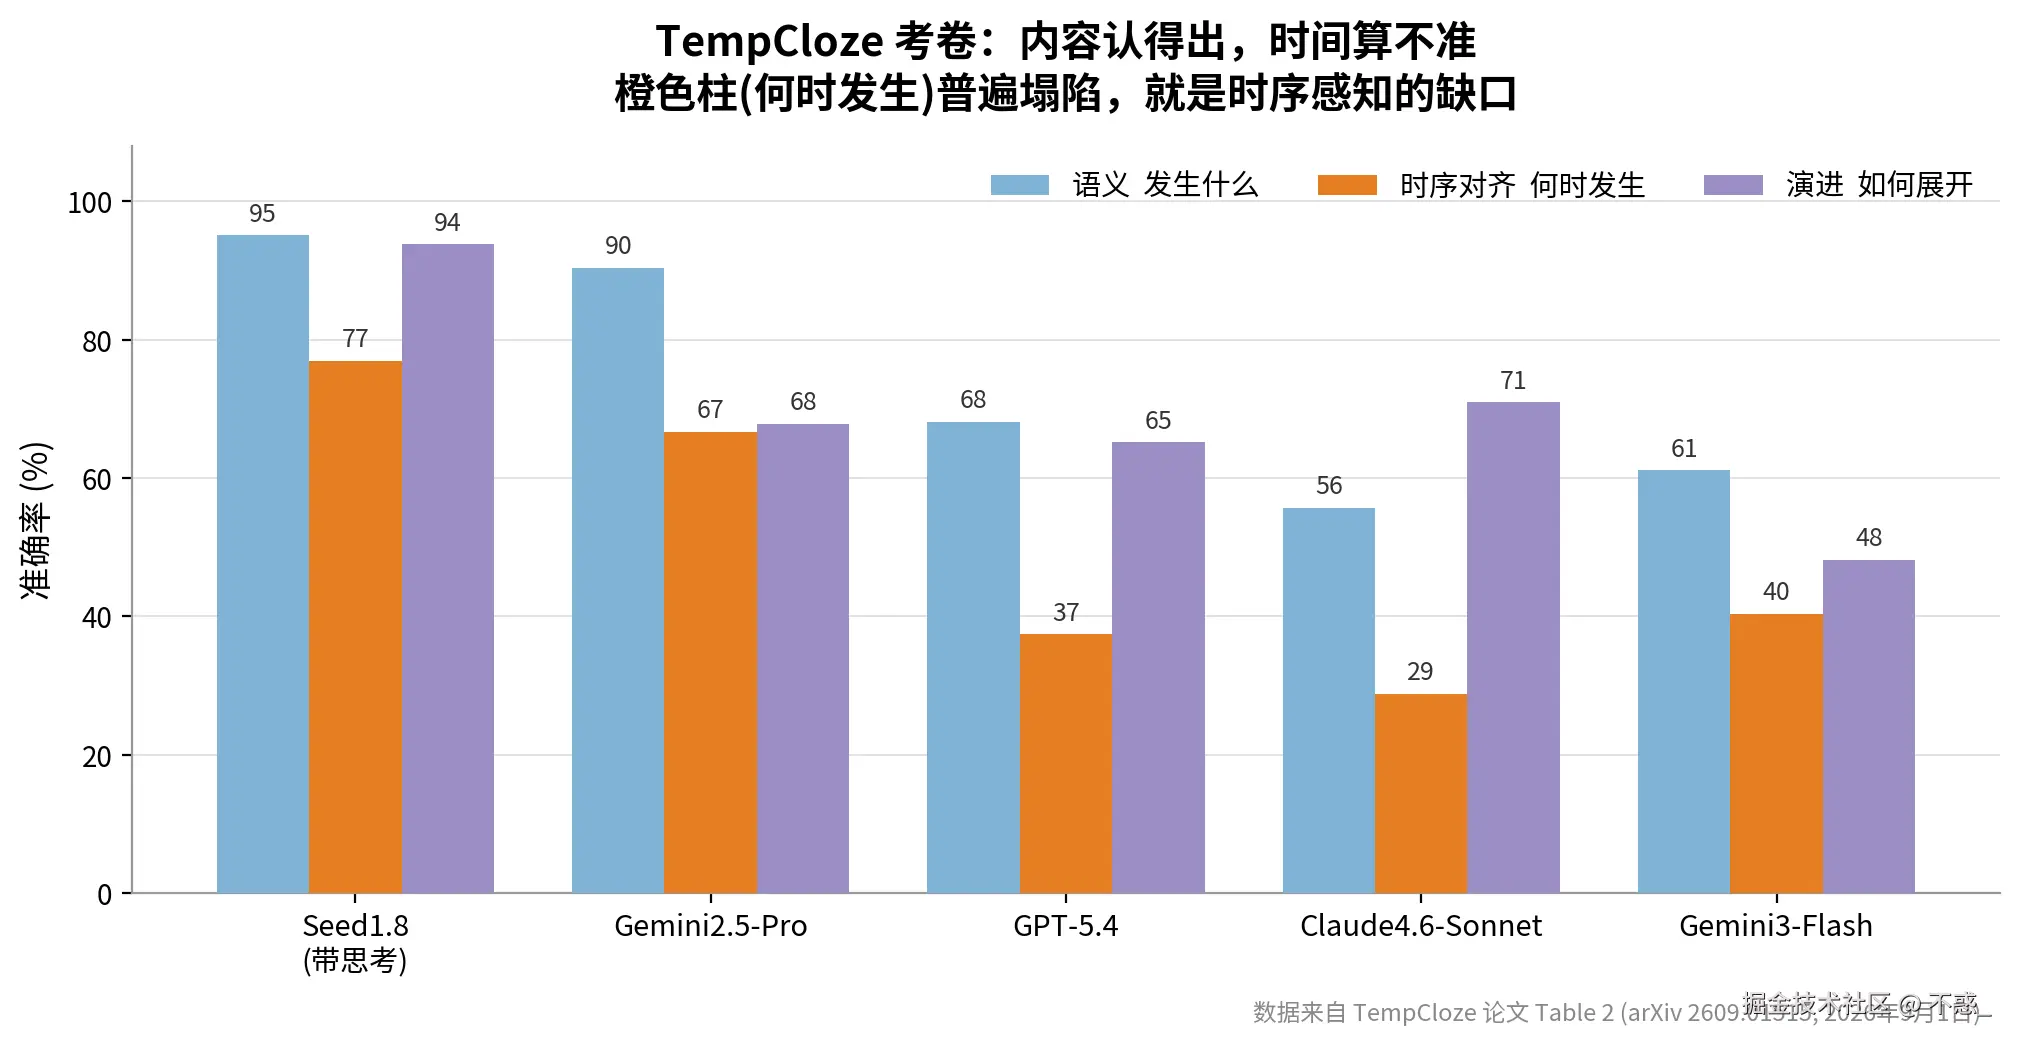
认得出发生了什么,算不准什么时候发生。
这,就是2026年秋天视频大模型的真实水位。
产业界坐不住了
学界在挖病根,公司们的动作更密,光9月第一周就好几发。
Google DeepMind在9月1日上线了Agentic Video Understanding。让Gemini Flash用思考,行动,观察的循环去啃长视频,自己决定去搜字幕,抓哪段帧,听哪段音频。官方自报长视频任务最多省88%的token,准确率最高提7个点,成本最多砍66%。
这招翻译成人话,承认模型一眼看不全,那就让它像人一样来回看,反复看,用工程手段绕过去。
另一拨人押在换底上。
9月2日,开源视频世界模型SolarWM放出,143万条视频片段打底,一次训了4个5B到33B的模型。最反直觉的地方在于,只用5秒的片段训练,生成却能连到分钟级甚至小时级。
9月1日,李飞飞的World Labs发了Atlas,全模态世界模型, 文本图像视频3D一起进,能出1分钟1440p的视频,主打空间和3D一致性。
世界模型这条线的信仰很朴素,如果模型能预测下一秒,它就必须懂运动和因果。Meta的VJEPA-2也是这个路数,在潜空间里学预测,主打给机器人用。
但9月7日,一盆冷水当头浇下。
有新论文发现JEPA类世界模型自己也有病,作者管它叫物理表征懒惰。编码器没有坍缩,看起来学得像模像样,但关键的物理属性,它直接无视。解法是训练时加一个傅里叶辅助头。
新药,也有新的副作用。
顺带一提,GitHub上有个叫Awesome-Video-Hallucination的仓库,9月刚更新,收录了37个视频幻觉基准和50种缓解方法。一条赛道挤了这么多人,侧面说明病得有多重。
这台车,敢让它开吗
说回大家最关心的,这对自动驾驶和机器人意味着什么。
知乎有限理性FM最新一期,请的就是王乃岩,图森未来中国原CTO,前小米汽车L3技术负责人,聊的正是这事。他这个月刚官宣离职,转身创业做具身智能去了。
他的判断很硬。只用自动驾驶数据训出来的模型,一定解决不了自动驾驶。
道理跟时序感知直接挂钩。
开车这件事,每一秒都在赌先后顺序。变道车是先打灯还是先切进来,行人是回头看了一眼还是马上要起步,加塞的车到底让不让。这些判断错一个,就是事故。
一个分不清先来后到的模型,你敢让它握方向盘吗.
9月8日,日本的TIER IV开源了端到端参考模型METEOR,纯视觉,单一神经网络,不要高精地图,分割,检测,轨迹一把梭,用日本全国跑出来的驾驶数据训的。
端到端的浪潮还在加速。
可端到端的前提,恰恰是模型看得懂时间。有自动驾驶方向的论文专门指出,语言模型的离散输出和驾驶需要的连续动作空间存在错位,光靠行为克隆还容易收敛到次优策略。
机器人那边同理。抓杯子,倒水,插钥匙,全是时序加因果的精细活。
看不懂时间的端到端,约等于蒙着眼踩油门。
最后
回到开头那段雪花视频。
人类视觉系统考出98分,是几亿年进化攒下的家底。大模型用两三年把静态视觉刷到超人水平,却在时间这扇门前,结结实实吃了闭门羹。
现在桌上摆着两条路。
一条路相信规模化, 数据够多, 模型够大,时间感自然会涌现,就像当年推理能力长出来那样。
另一条路说要动刀,时间得有自己的通路,得进表征,进训练目标,甚至要等一套新架构。
SpookyBench那批研究者明摆着赌后者。零分名单里,2B到78B参数的模型齐齐整整,规模在这道题上已经先输一阵。
我个人的倾向也偏后者。但历史反复教过我们,别急着给任何架构判死刑,也别急着宣布scaling出局。
留个问题给你。
如果时间感知最后真要靠新架构才能解决,那今天砸进视频大模型的训练算力,有多少是在给一栋地基有问题的楼刷墙?
评论区聊聊你的判断。
最后送你一句话。
现在的视频大模型,会看画面,不会看片。记得住发生了什么,记不住先后。
边界说明
老规矩,把丑话说在前面。
文中的数字全部来自公开论文和项目页,链接贴在下面。SpookyBench是合成噪声的极端场景,日常视频问答里模型当然有分数,谁也没真考零分,别拿去当标题党素材。
时序感知偏科这个结论,是TempCloze,TVBench,CP-Bench,TemporalVQA,Vinoground等一串团队各自独立验证出来的方向性结论。其中不少还是没经过同行评议的预印本,数字会随版本更新,方向短期内不会变。
DeepMind的省token数据是官方自报,暂无第三方复现。