摘要:本文从 Goroutine 与 Channel 这两个 Go 并发核心原语讲起,带你由浅入深掌握无缓冲/缓冲 Channel、WaitGroup 协作、select 多路复用,并落地 Worker Pool、信号量限流、扇出/扇入等高并发实战模式,最后梳理死锁、goroutine 泄漏与 Delve 调试等高频踩坑点,配 4 段可直接运行的代码。
导语
很多刚接触 Go 的同学都会问:为什么 Go 能在一台普通机器上轻松撑起十万级并发,而 Java 线程池动辄就要小心翼翼地调参?答案其实落在两个看起来极其简单的原语上------Goroutine 和 Channel。
本文不堆概念,直接上代码。我们从一次最小的并发开始,一路打到生产可用的高并发模式,并捋清那些年踩过的死锁、泄漏坑。文中的关键设计参考了 Go 官方文档(Effective Go 与官方并发之旅),可以放心对照。
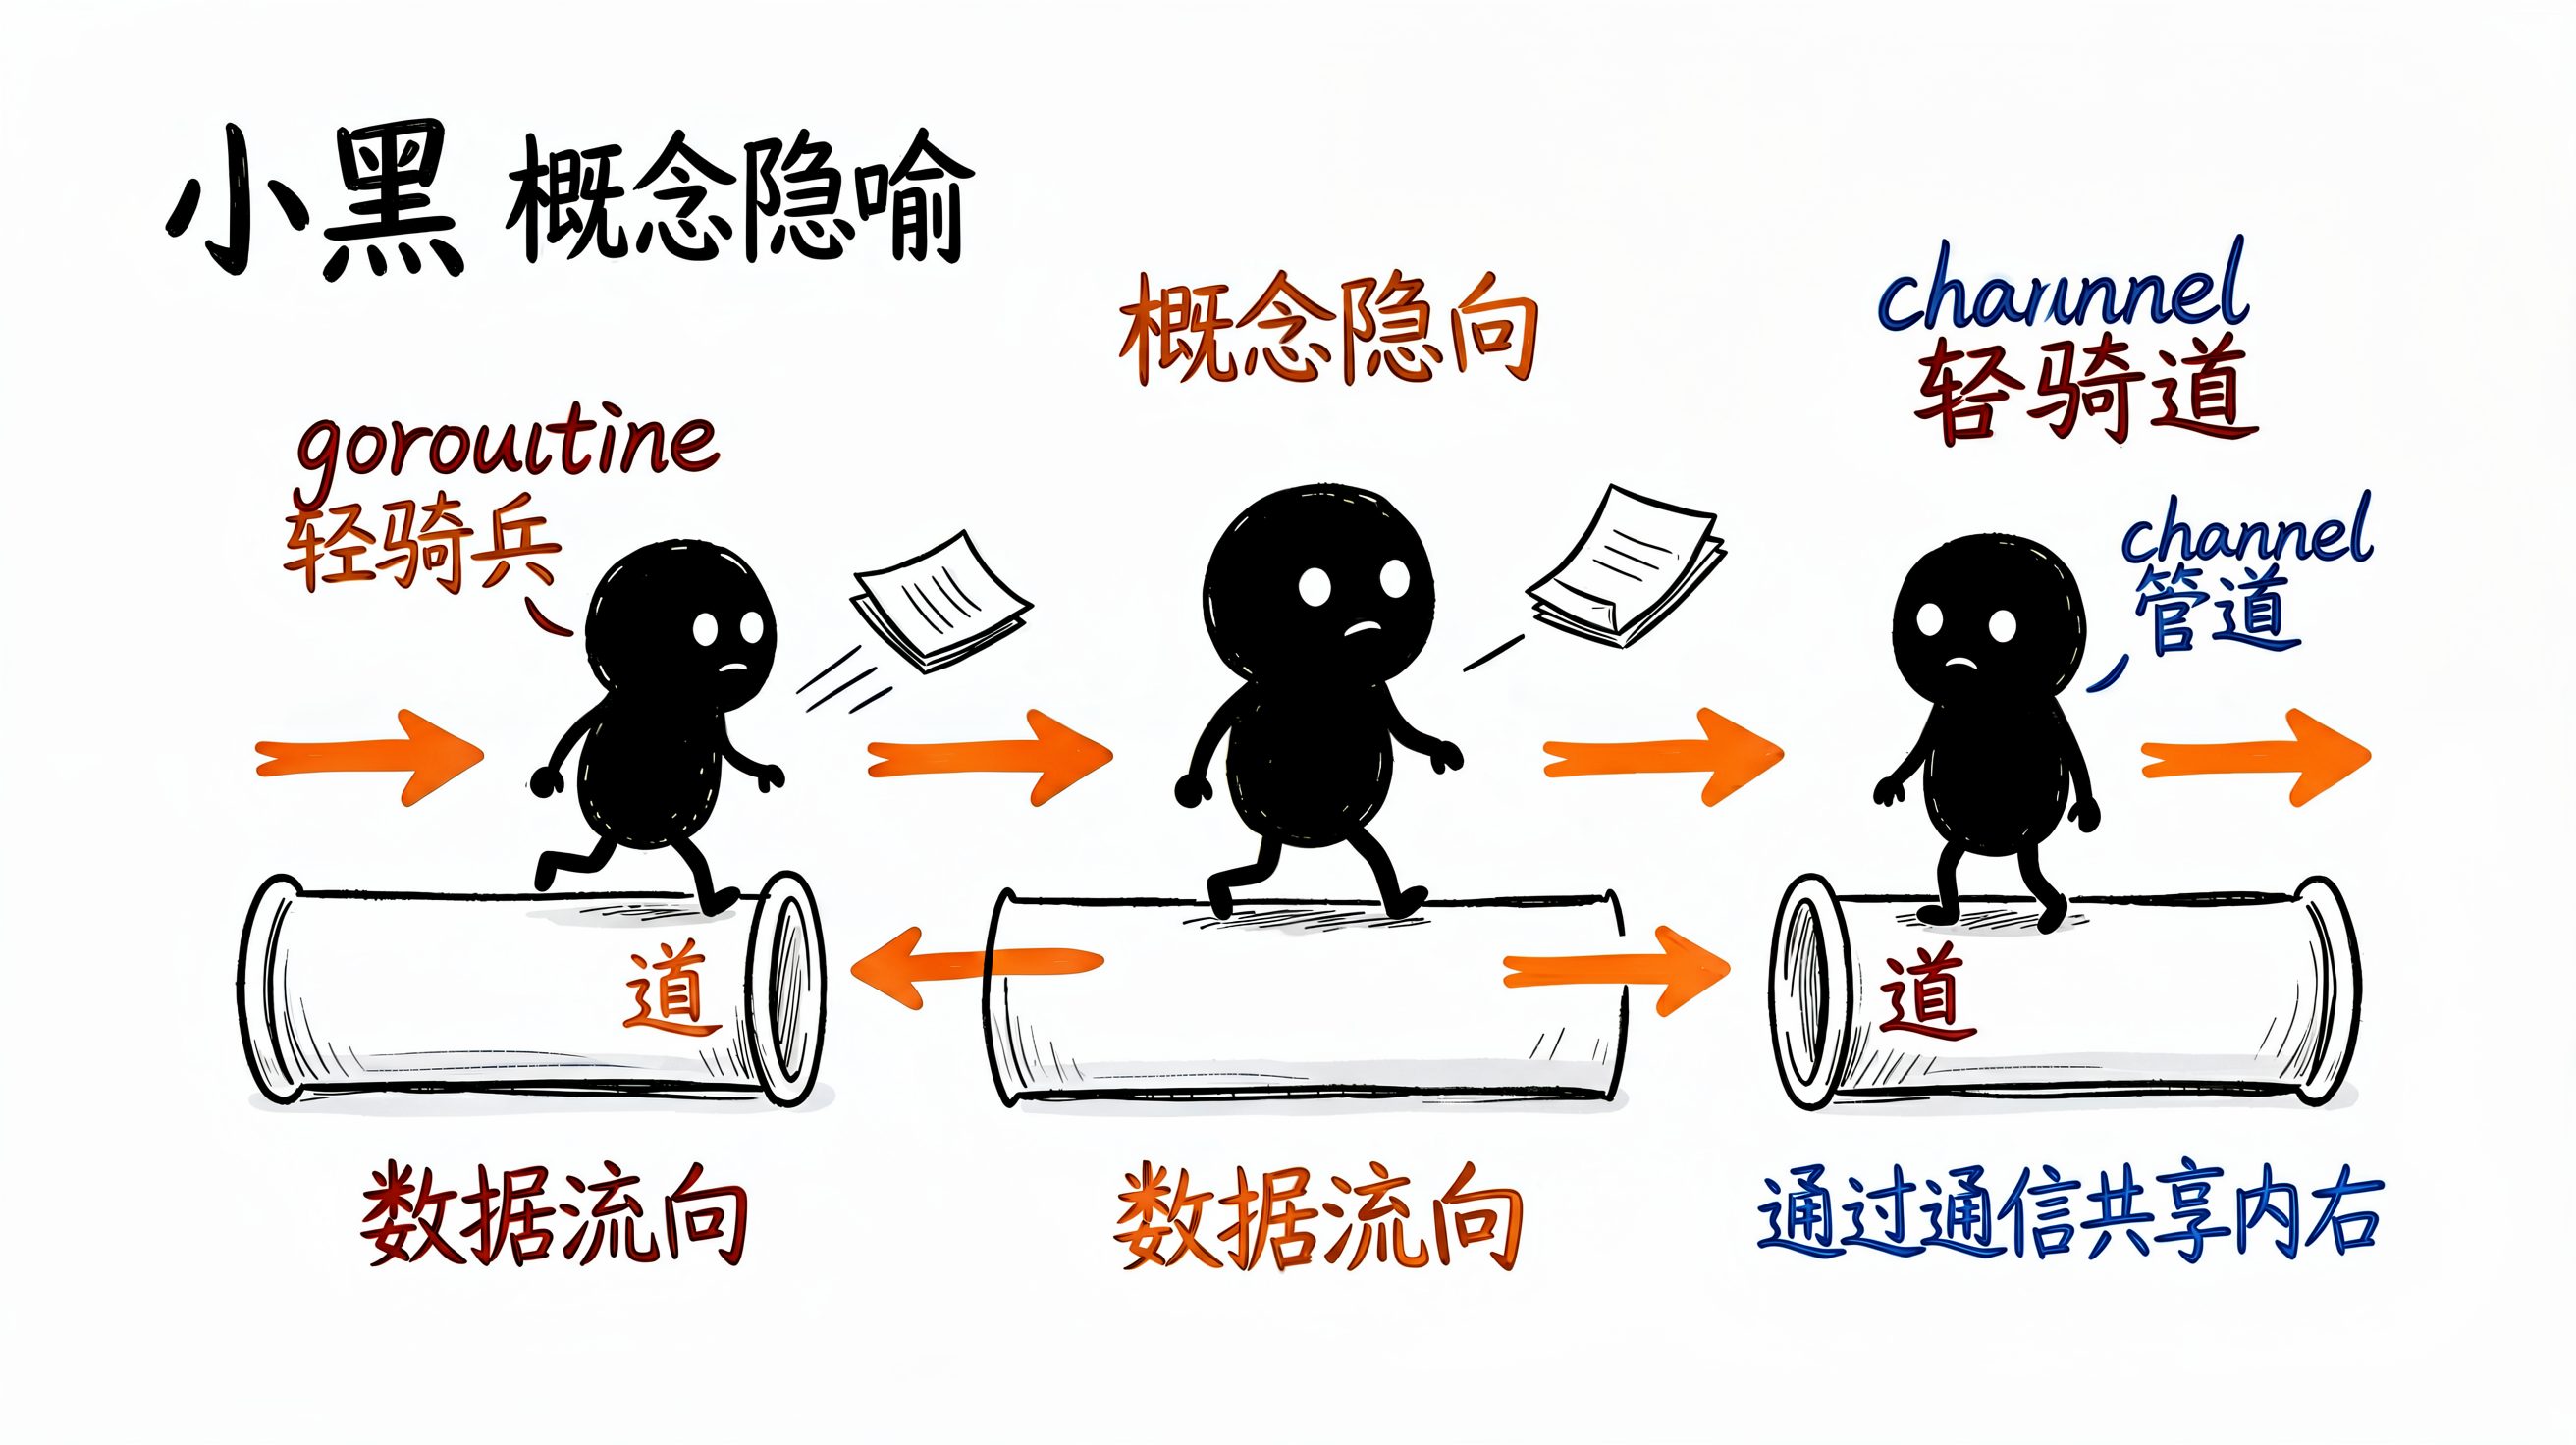
一、并发基石:Goroutine 是什么、怎么启动
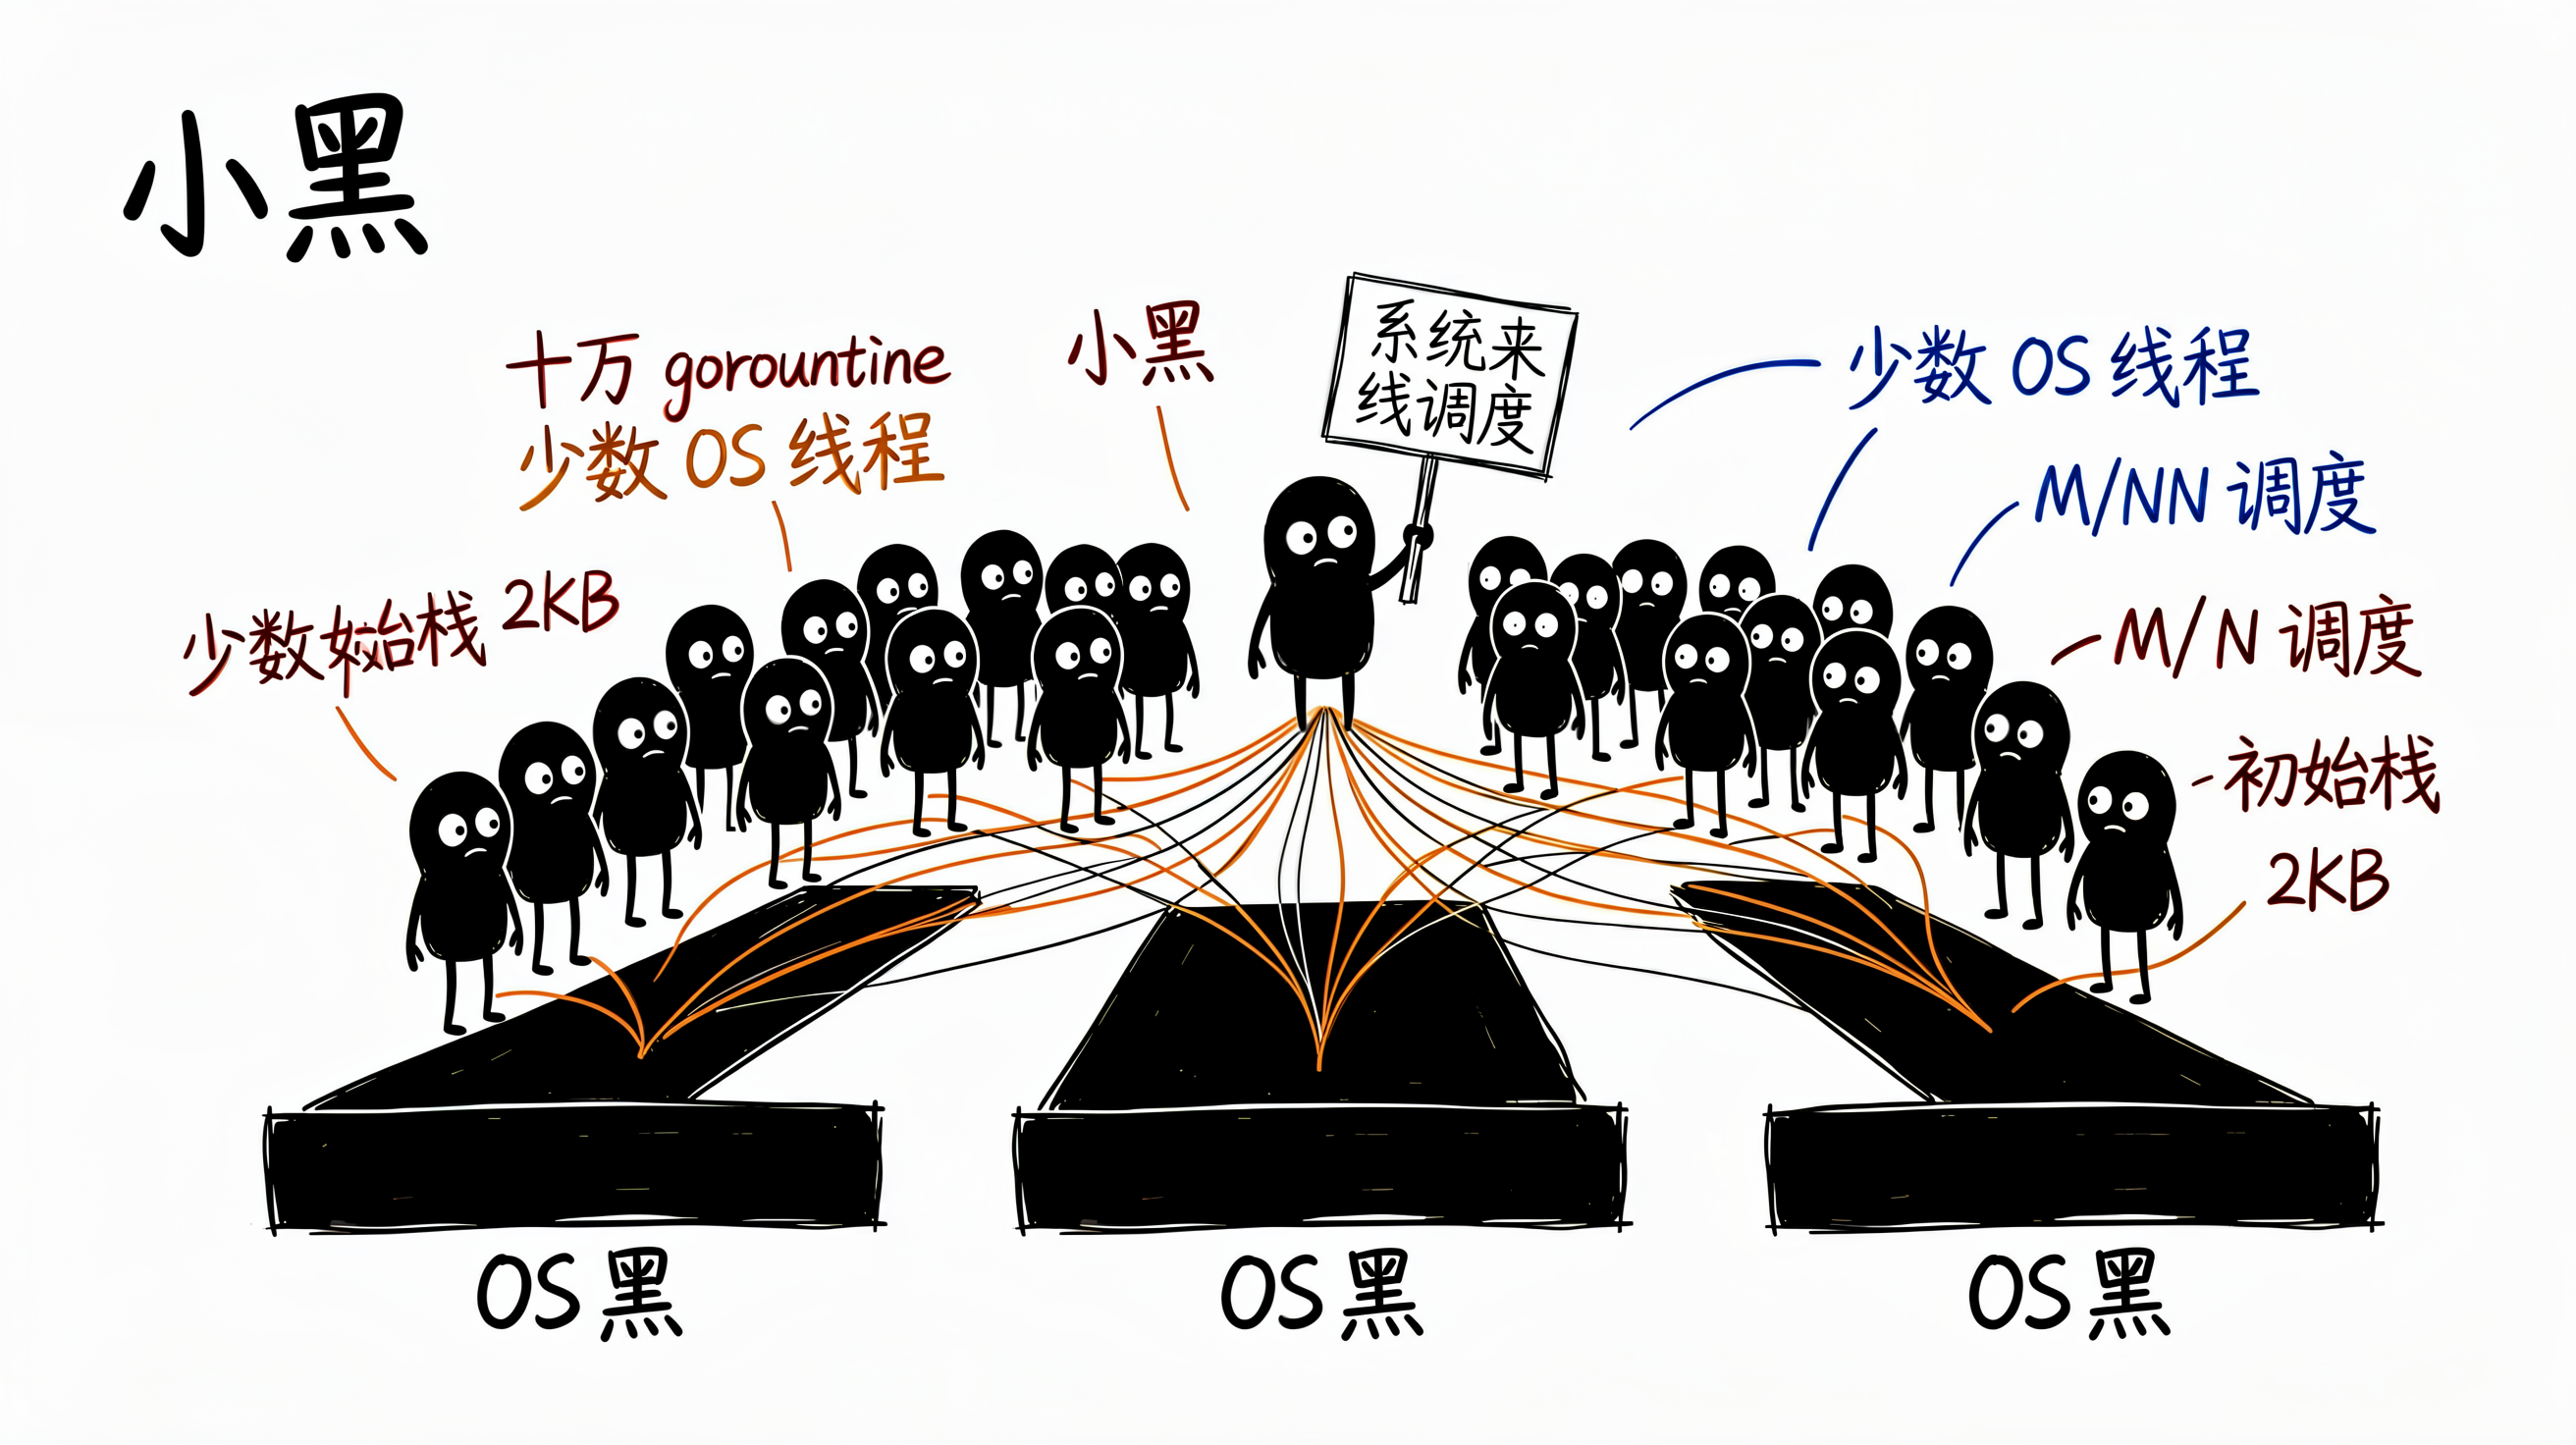
Goroutine 是 Go 运行时(runtime)管理的轻量级线程,也叫协程。它和操作系统线程最大的区别在于:Go runtime 把成千上万个 goroutine 多路复用到少量的 OS 线程上(即 M:N 调度模型),因此创建一个 goroutine 的成本极低------初始栈只有 2KB,并且能按需动态扩容,而一个 OS 线程默认就要占用几 MB。
Go 的设计哲学源自 CSP 模型 (Communicating Sequential Processes,通信顺序进程):"通过通信来共享内存,而不是通过共享内存来通信"。Channel 就是 goroutine 之间传递数据的"管道"。
启动一个 goroutine 只需要一个 go 关键字。下面是最朴素的例子:主 goroutine 启动一个工作 goroutine,再用一个无缓冲 channel 作为"完成信号"来等待它结束。
go
package main

import "fmt"

func main() {
	done := make(chan struct{}) // 无缓冲 channel,用作完成信号

	go func() {
		// 模拟一段并发工作
		fmt.Println("goroutine: 正在工作...")
		done <- struct{}{} // 工作完成,发送完成信号
	}()

	<-done // 主 goroutine 阻塞等待,直到收到信号
	fmt.Println("main: 收到完成信号,退出")
}
done 是一个无缓冲 channel:它的发送和接收必须同时就绪 ,否则发送方会阻塞,直到有接收方出现。上面的 <-done 就是主 goroutine 的"同步点",保证工作 goroutine 真正跑完才退出。
二、Channel:类型、缓冲/非缓冲、关闭与 range
Channel 是一种有类型的管道,只能在相同类型之间传递数据。用 make 创建时是否带容量,决定了它是非缓冲还是缓冲:
- 非缓冲 channel :
make(chan T),发送和接收必须配对,互为阻塞点(同步)。 - 缓冲 channel :
make(chan T, n),缓冲区未满时发送不阻塞,未空时接收不阻塞,能在生产者/消费者之间解耦。
关闭与遍历是日常最高频的操作:通常由发送方调用 close(ch) ;接收方可以用 val, ok := <-ch 判断通道是否已关闭(ok 为 false 表示已关闭);用 for v := range ch 则会在通道关闭后自动退出循环。重复关闭或向已关闭的通道发送都会触发 panic,所以"谁发送谁关闭"是铁律。
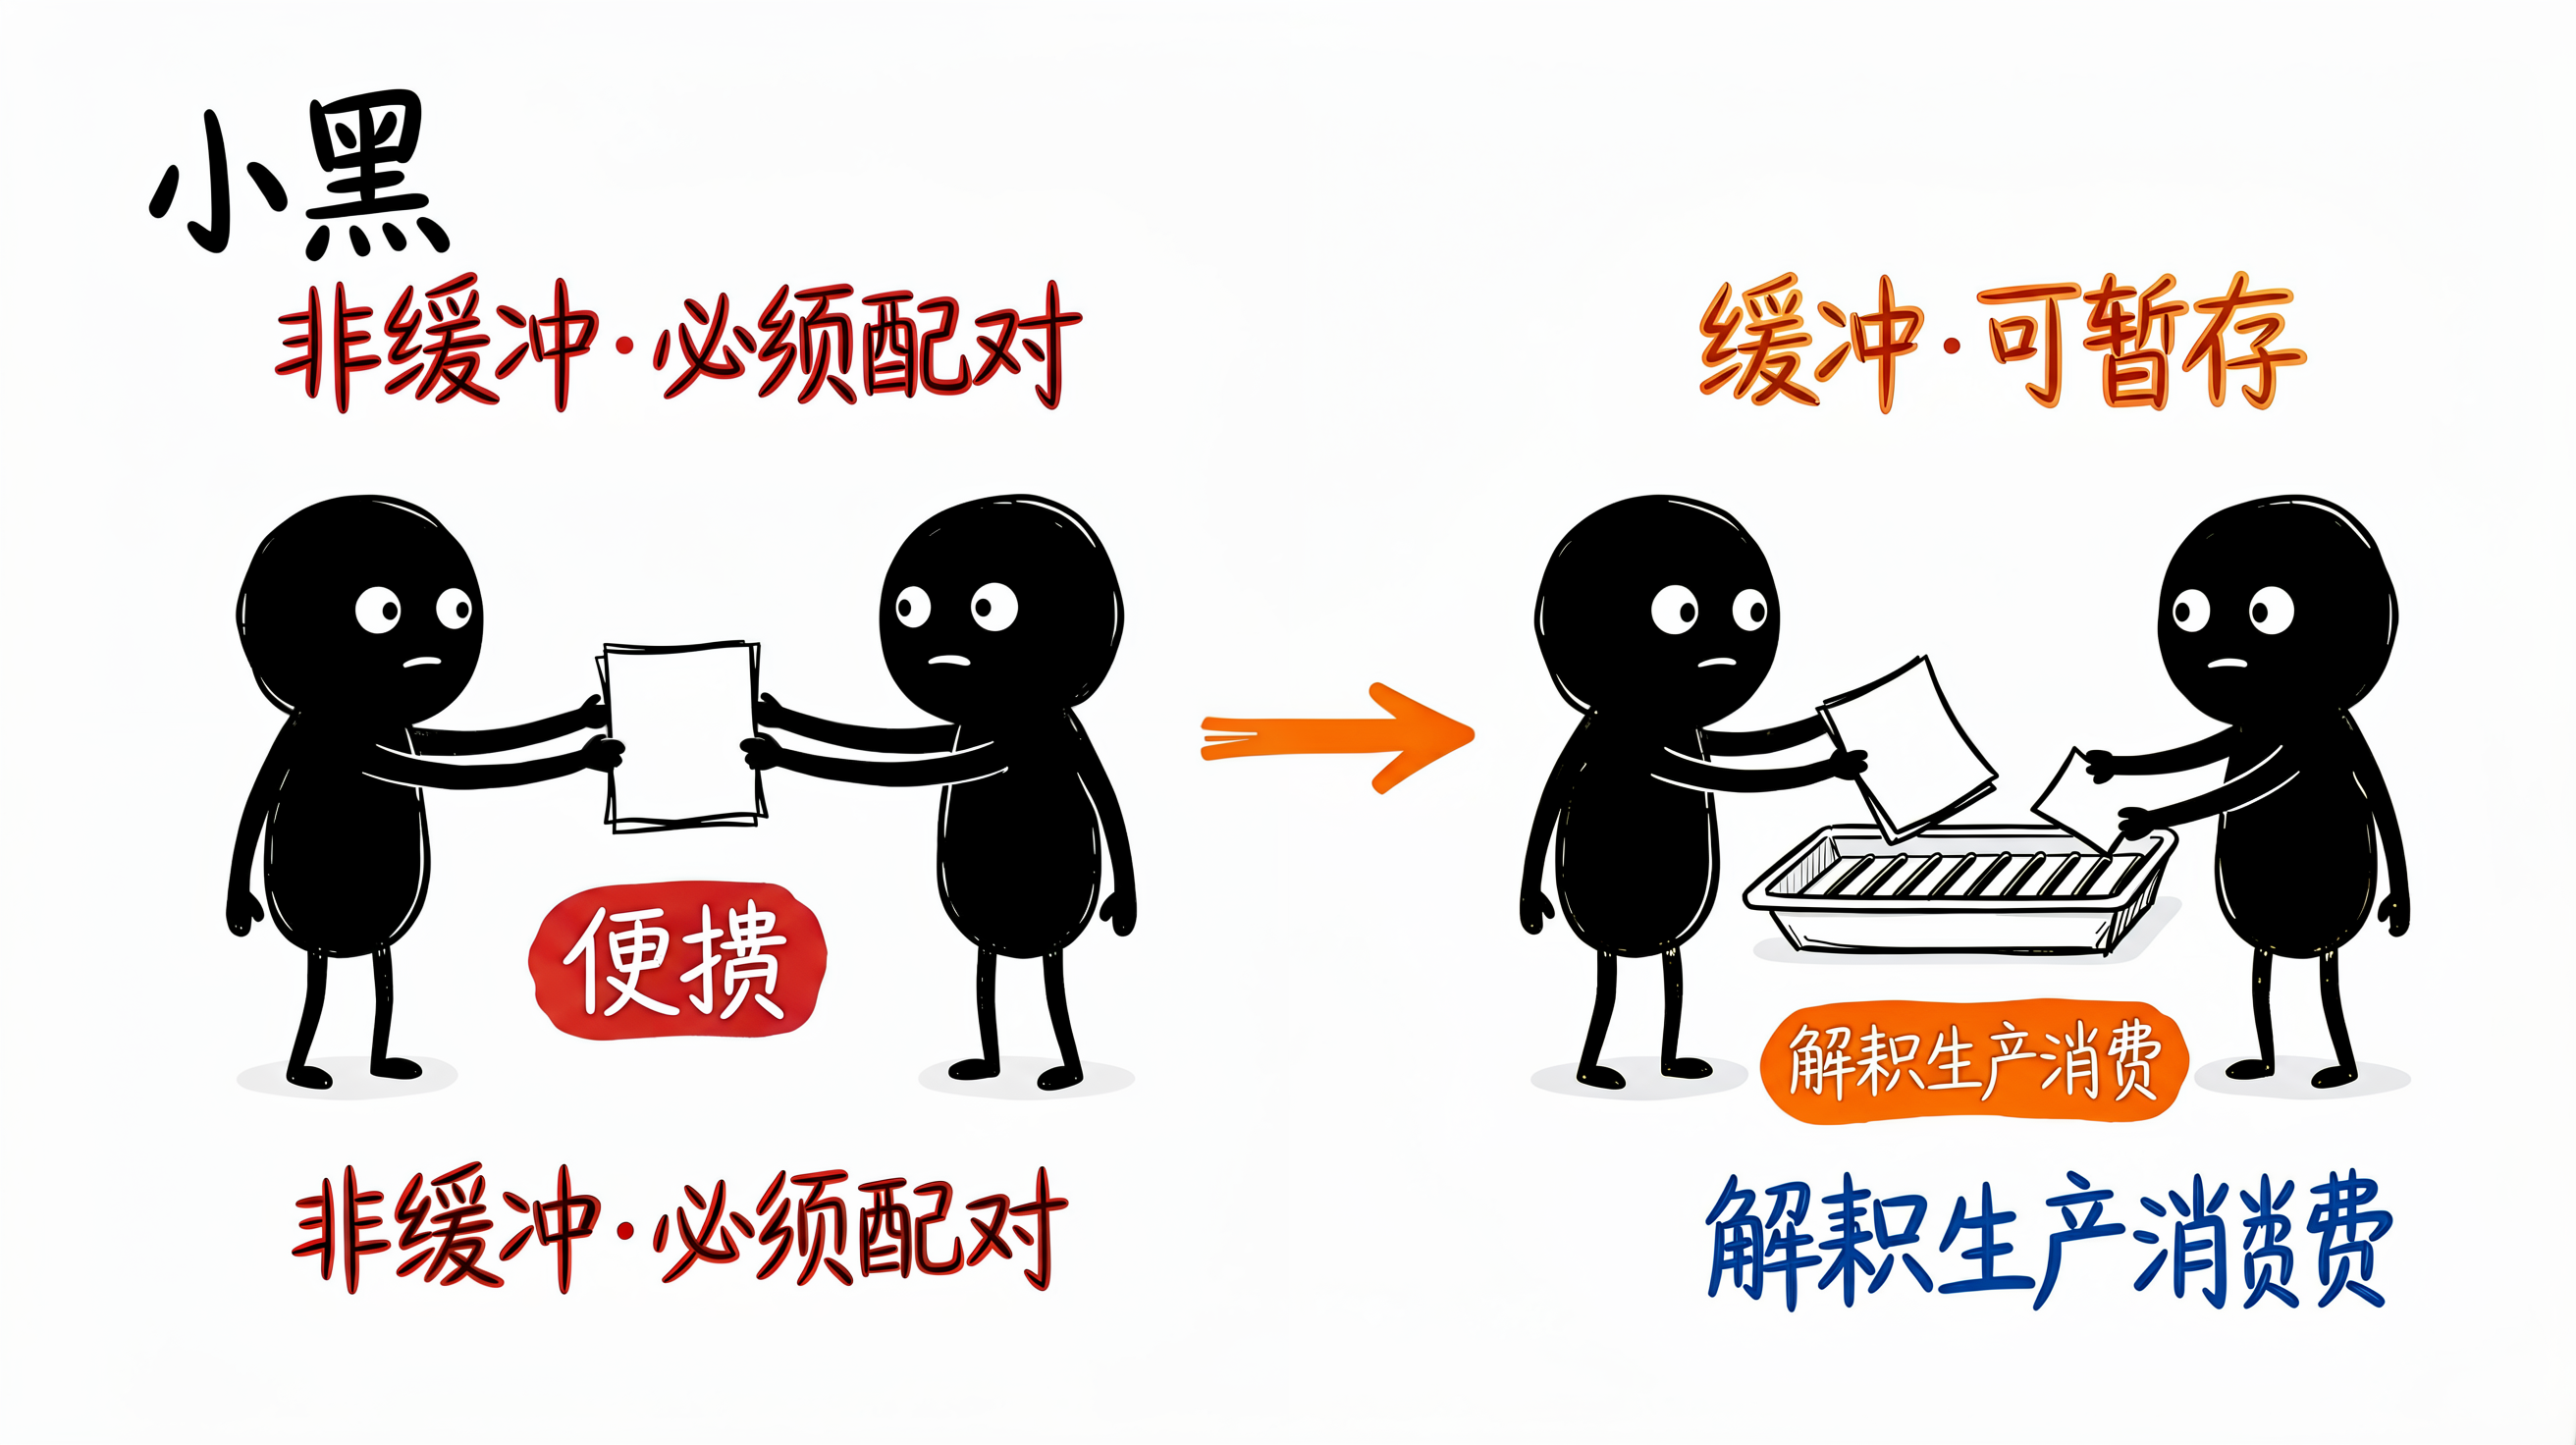
下面用缓冲 channel 实现一个**信号量(Semaphore)**来限制最大并发数------这是高并发限流的基础手段。
go
package main

import (
	"fmt"
	"sync"
	"time"
)

func main() {
	const maxConcurrency = 3
	sem := make(chan struct{}, maxConcurrency) // 容量为 3 的缓冲 channel,充当信号量
	var wg sync.WaitGroup

	for i := 1; i <= 9; i++ {
		wg.Add(1)
		sem <- struct{}{} // 获取信号量,缓冲区满则阻塞
		go func(id int) {
			defer wg.Done()
			defer func() { <-sem }() // 释放信号量
			fmt.Printf("worker %d 开始处理\n", id)
			time.Sleep(100 * time.Millisecond)
			fmt.Printf("worker %d 处理完成\n", id)
		}(i)
	}

	wg.Wait()
	fmt.Println("全部任务处理完毕")
}
无论循环发起 9 个任务,同一时刻真正在运行的 goroutine 永远不会超过 3 个。这种"令牌桶"式限流,在调用下游 API、访问数据库等场景里几乎是标配。Channel 的更多语义细节可参考 Go 官方并发教程。
三、协作与同步:WaitGroup 与 select 多路复用
当并发任务变多,光靠一个 done 信号就不够了,于是有了 WaitGroup (等待组):它像一个计数器,Add(n) 增加待等待数,Done() 减一,Wait() 阻塞到计数归零,用来等待一组 goroutine 全部完成。
而 select 则提供了类似网络编程里 select/poll 的多路复用 能力:它能同时监听多个 channel 的发送或接收,谁先就绪就走哪个分支,配合 time.After 还能轻松实现超时控制------这是编写健壮网络服务的利器。
下面的例子演示:给一个可能很慢的查询加上 1 秒超时,超时即放弃等待,不让主流程被拖死。
go
package main

import (
	"fmt"
	"time"
)

func query() <-chan string {
	ch := make(chan string)
	go func() {
		time.Sleep(2 * time.Second) // 模拟慢调用
		ch <- "result"
	}()
	return ch
}

func main() {
	select {
	case res := <-query():
		fmt.Println("得到结果:", res)
	case <-time.After(1 * time.Second): // 超时控制
		fmt.Println("请求超时,放弃等待")
	}
}
再来看 WaitGroup 的扇出(fan-out) 模式:一个生产者把任务投进 channel,多个 worker goroutine 同时消费,从而把串行任务并行化。
go
package main

import (
	"fmt"
	"sync"
)

func worker(id int, tasks <-chan int, wg *sync.WaitGroup) {
	defer wg.Done()
	for t := range tasks {
		fmt.Printf("worker %d 处理任务 %d\n", id, t)
	}
}

func main() {
	tasks := make(chan int, 10)
	var wg sync.WaitGroup

	// 扇出:启动多个 worker 并发消费
	for i := 1; i <= 3; i++ {
		wg.Add(1)
		go worker(i, tasks, &wg)
	}

	// 生产任务
	for j := 1; j <= 6; j++ {
		tasks <- j
	}
	close(tasks) // 关闭 channel,worker 的 range 会自然退出

	wg.Wait()
	fmt.Println("扇出模式:所有 worker 已退出")
}
注意 tasks 是 <-chan int(只读 channel),这是 Go 的类型系统帮我们约束 worker 只能接收、不能发送的好写法;生产端 close(tasks) 后,三个 worker 的 range 会优雅退出。
四、高并发实战模式:Worker Pool、信号量限流、扇出/扇入
把前面零散的技巧组合起来,就得到生产里最常见的几种模式。
Worker Pool(工作者池) :用固定数量的 worker 消费一个任务队列,避免无节制地 go func() 把内存和调度打爆。它本质上是"扇出 + 限流"的组合,第二章的信号量例子就是它的一种变体。
text
        ┌─────────┐
 任务 ──▶│ 任务队列 │ (buffered channel)
        └────┬────┘
     ┌──────┼──────┐
     ▼      ▼      ▼
   worker1 worker2 worker3   ← 固定数量的 goroutine
     └──────┼──────┘
            ▼
        结果汇总 (fan-in)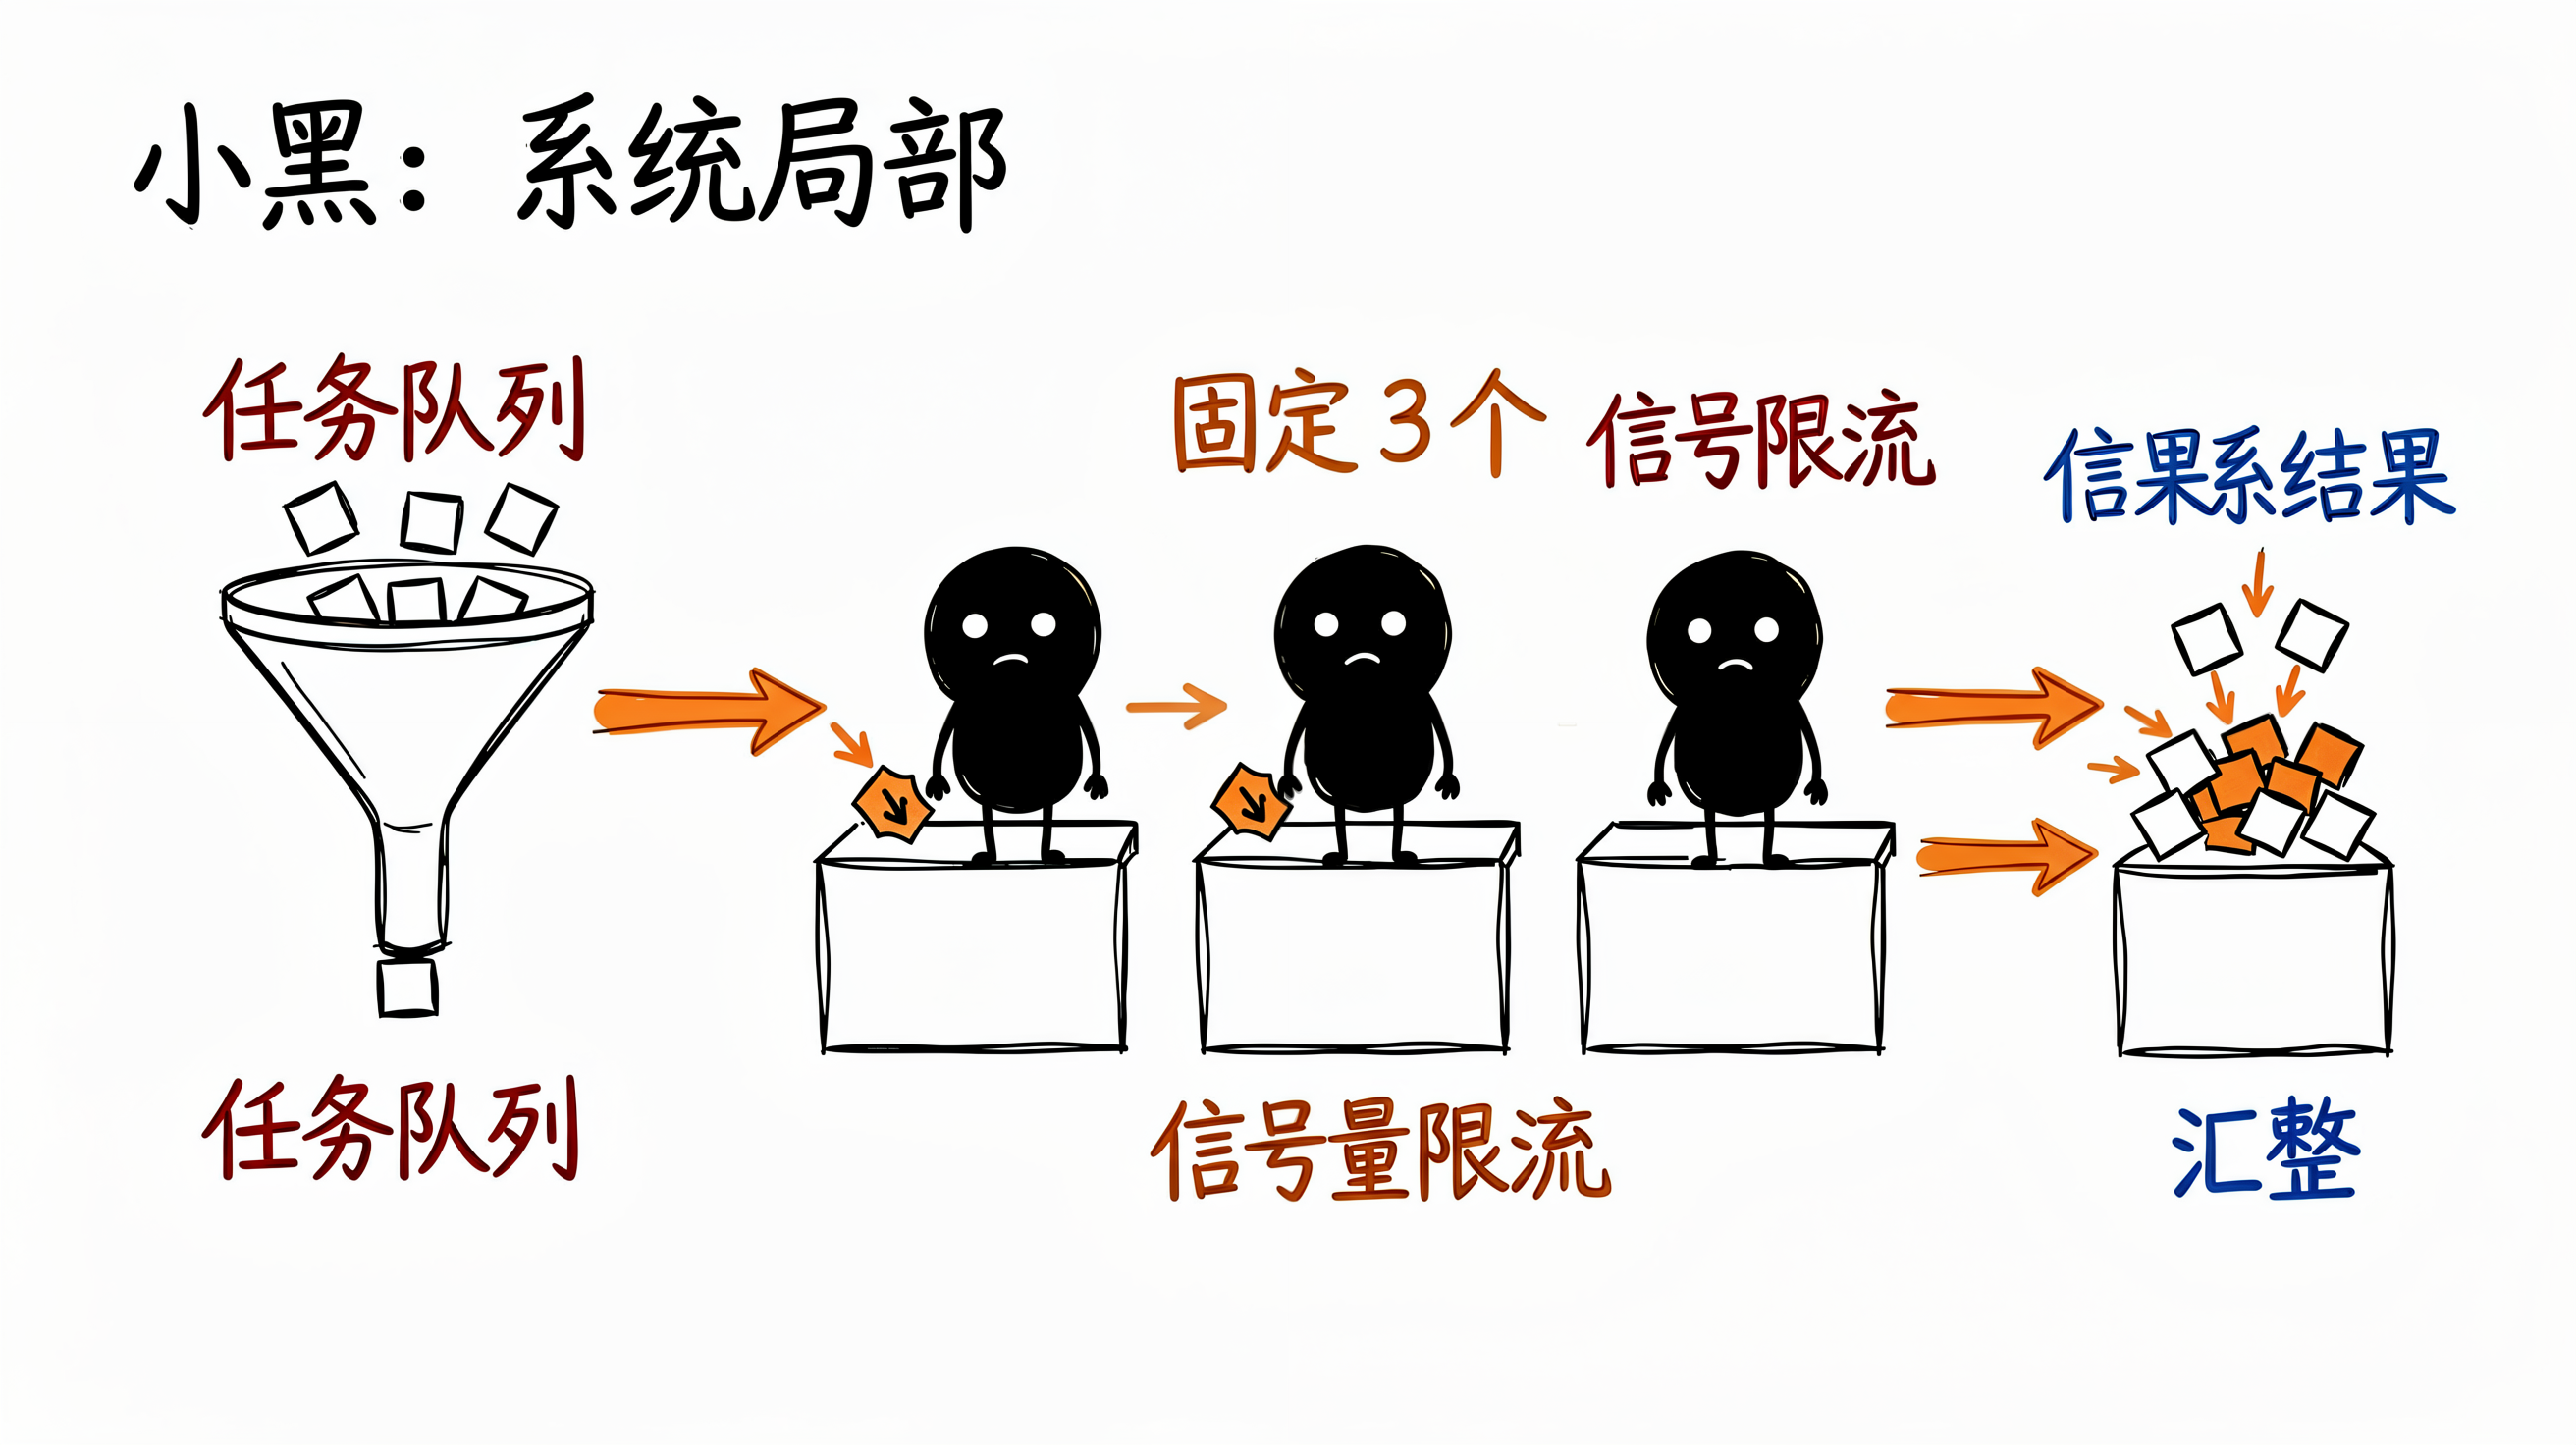
信号量限流:即第二章的令牌桶,控制对下游资源的并发压力。
扇出 / 扇入(fan-out / fan-in) :扇出是"一个 channel 被多个 goroutine 消费"(第三章已演示);扇入则是"多个 goroutine 的结果汇流到一个 channel"。两者结合就能搭出一条流水线(pipeline):上游生产 → 中游加工 → 下游聚合,每一级用缓冲 channel 衔接,平滑速度差、提升吞吐。
下面这段 fanIn 把多个同类型 channel 合并成一个流,是扇入最经典的实现:每个源 channel 各起一个 goroutine 往 out 里转发,全部源关闭后统一 close(out)。
go
package main

import (
	"fmt"
	"sync"
)

// fanIn 把多个同类型 channel 的结果汇流到一个 channel
func fanIn(channels ...<-chan int) <-chan int {
	out := make(chan int)
	var wg sync.WaitGroup
	wg.Add(len(channels))

	for _, ch := range channels {
		go func(c <-chan int) {
			defer wg.Done()
			for v := range c {
				out <- v
			}
		}(ch)
	}

	// 等所有源 channel 关闭后,再关闭 out,避免向已关闭 channel 发送
	go func() {
		wg.Wait()
		close(out)
	}()
	return out
}

func main() {
	// 两个独立生产者,各自向自己的 channel 投数据
	src1 := make(chan int, 3)
	src2 := make(chan int, 3)
	src1 <- 1
	src2 <- 2
	src1 <- 3
	src2 <- 4
	close(src1)
	close(src2)

	// 扇入:合并为一个流后统一消费
	for v := range fanIn(src1, src2) {
		fmt.Println("fan-in 收到:", v)
	}
}
实战中请记住一条经验:worker 数量要收敛。盲目开几万个 goroutine 去打同一个数据库,只会把下游打挂、把自己拖垮。先用 Worker Pool 把并发度控制在合理范围,再用缓冲 channel 削峰。
五、避坑与性能优化:死锁、goroutine 泄漏、调试(Delve)
模式好用,但坑也不少。下面三个是面试和生产事故的高频来源。
死锁(Deadlock) :当所有 goroutine 都因等待彼此而卡住、谁也无法推进时,Go runtime 会直接 panic 报 fatal error: all goroutines are asleep - deadlock。典型场景:向一个无缓冲 channel 发送,却没有接收方。预防办法是明确通信双方的配对关系,必要时借 select 的 default 分支避免永久阻塞。
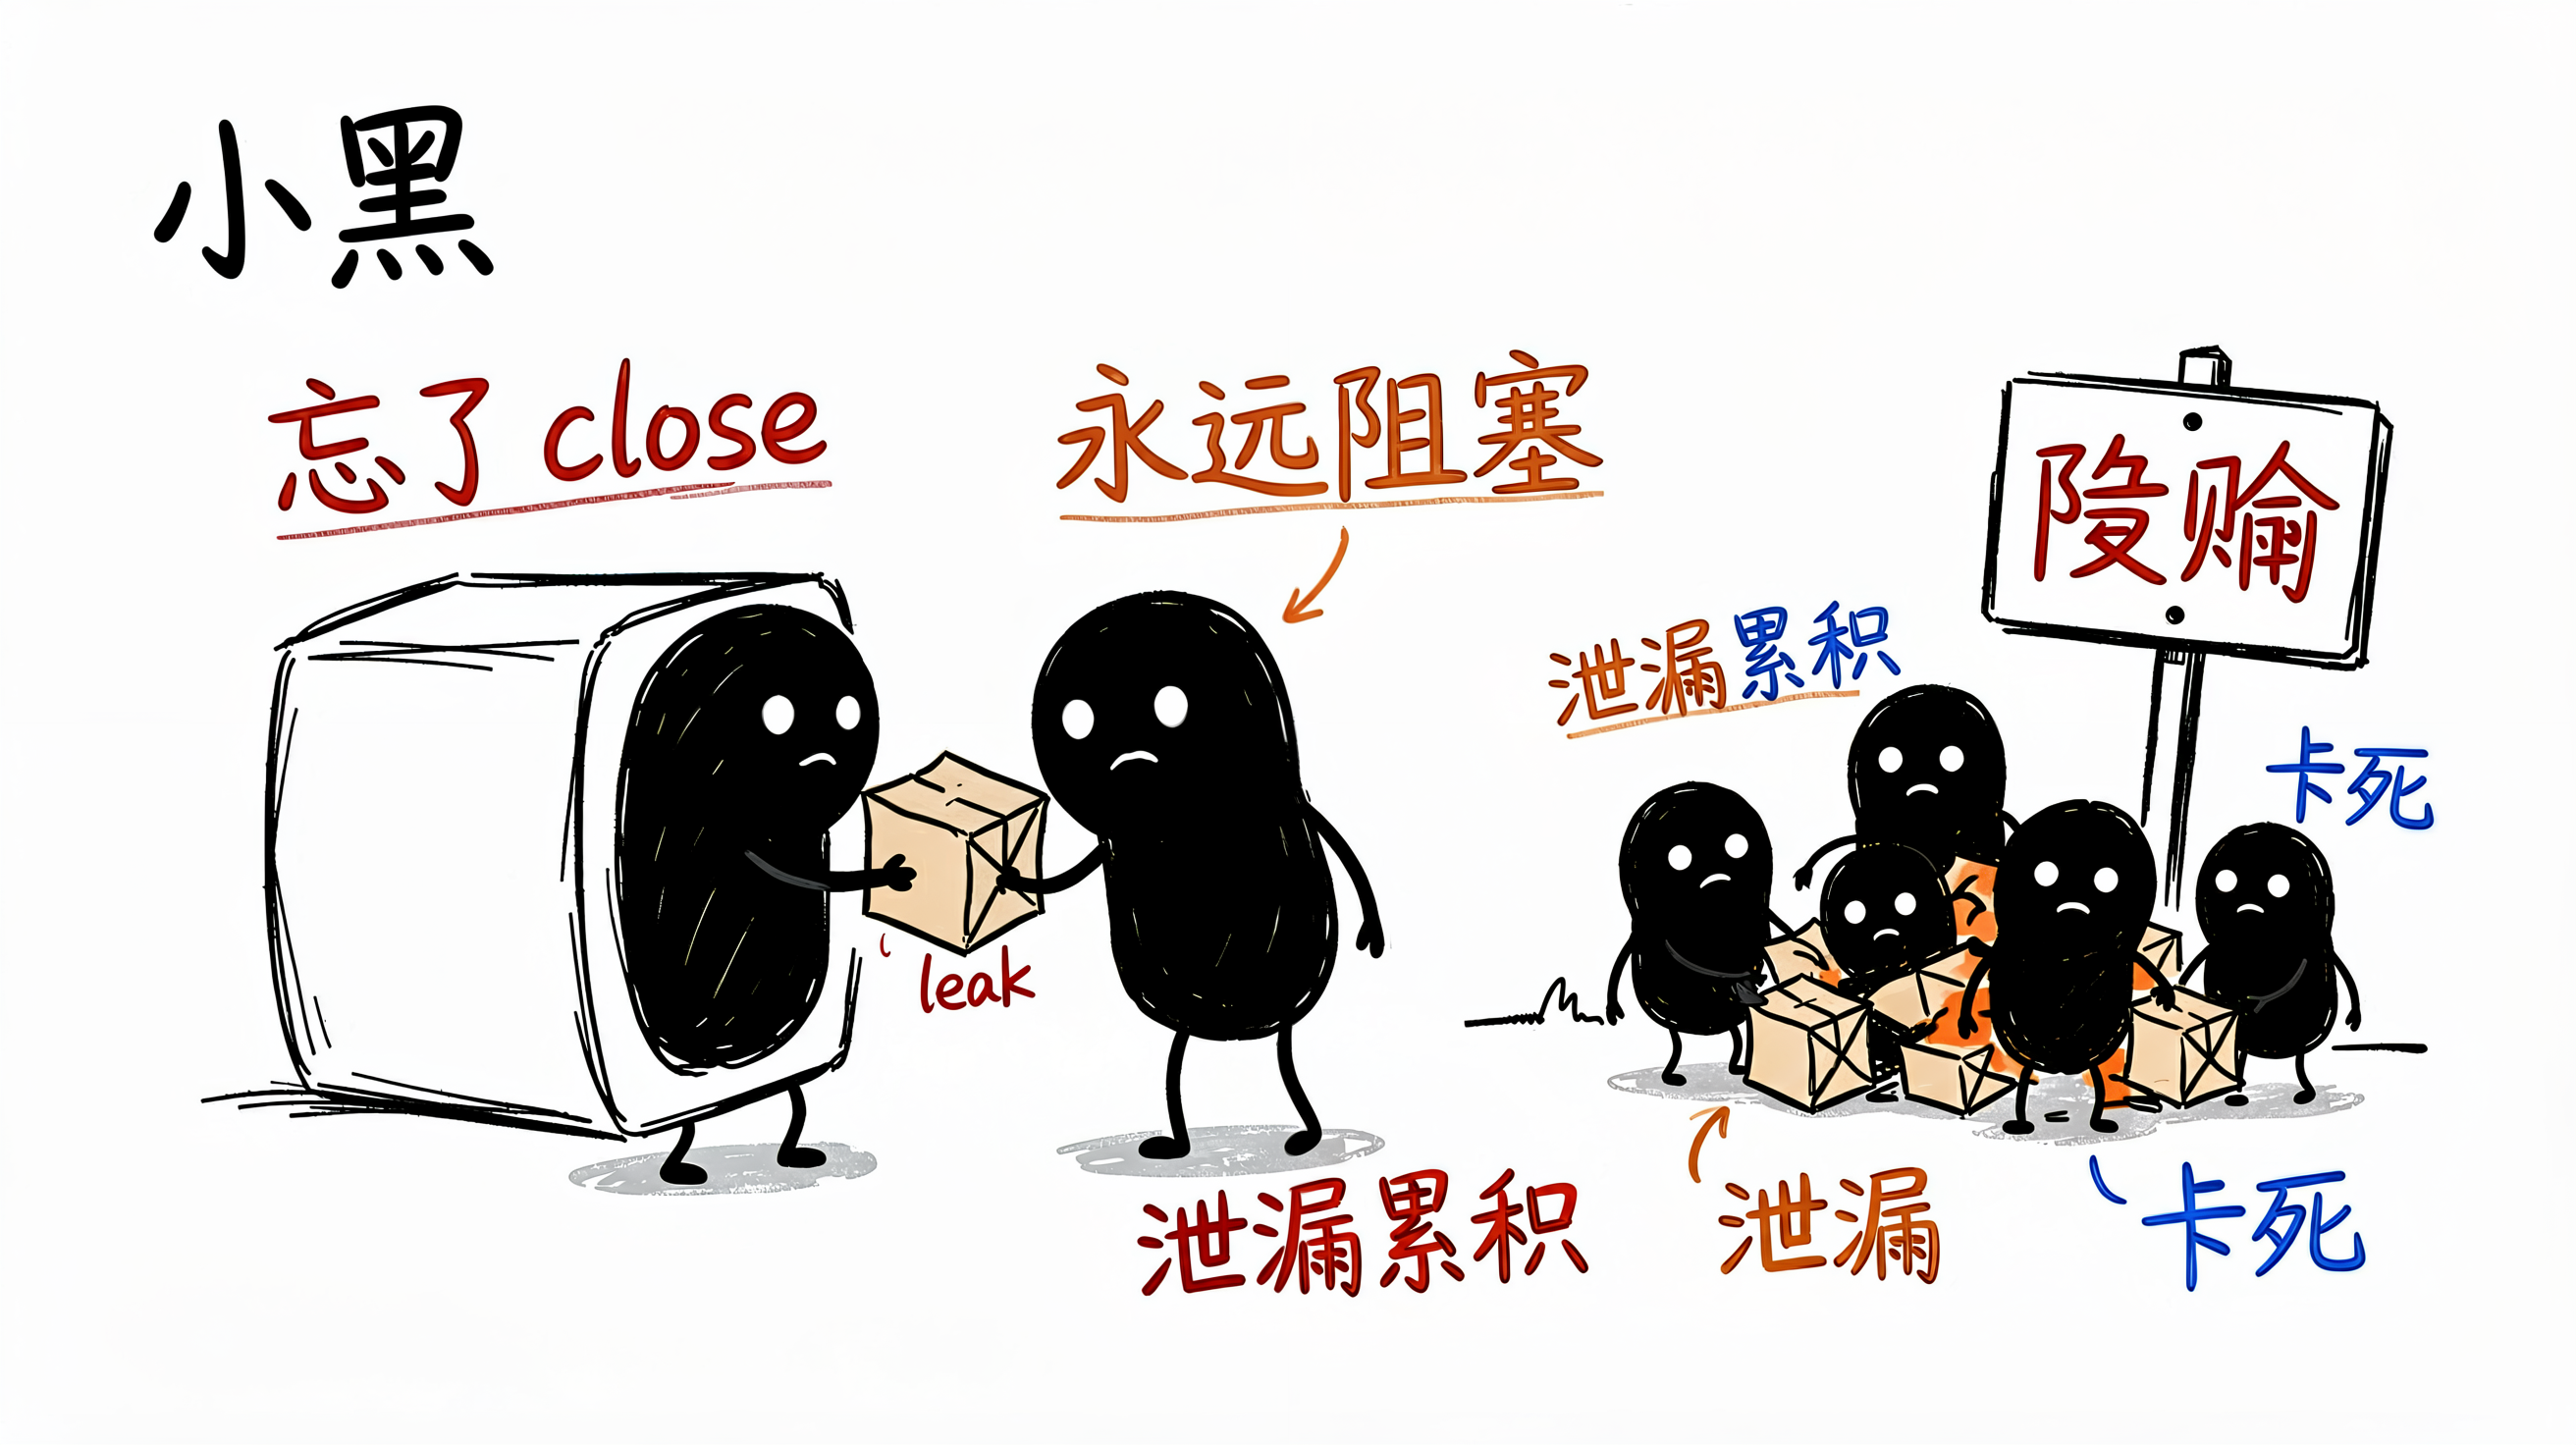
Goroutine 泄漏(Leak) :goroutine 阻塞在某个永远不会就绪的 channel 上,既不能退出也不被回收,数量累积最终拖垮进程。常见诱因是 channel 忘了关闭、或 select 永久等待。预防手段包括:发送方务必 close、用 context.Context 传递取消信号、给阻塞操作加超时。
数据竞争(Data Race) :多个 goroutine 同时读写同一变量且没有同步,结果不可预测。Go 提供了 -race 检测开关(go run -race main.go),能在开发期直接揪出竞争。优先用 channel 通信,实在要共享变量时再用 sync.Mutex 或 sync/atomic。
调试利器 Delve :Go 官方的调试器 dlv 可以 Attach 到进程、查看所有 goroutine 的栈。常用命令:dlv debug 进入调试;goroutines 列出全部 goroutine;goroutine <id> bt 看某个 goroutine 的调用栈,定位"卡死在哪一行"。配合 -race 报告,基本能覆盖绝大多数并发排查场景。
性能层面,几个低成本优化点:合理设置 GOMAXPROCS(默认等于 CPU 核数,一般无需改)、用 sync.Pool 复用临时对象降低 GC 压力、避免锁粒度过大、减少跨 goroutine 的共享写。更多内存模型细节可查阅 Go 官方 Memory Model 文档。
总结
Goroutine 是 Go 并发的"轻骑兵",Channel 是它们沟通的"管道",WaitGroup 与 select 负责把一群 goroutine 协同、编排好。把它们组合成 Worker Pool、信号量限流、扇出/扇入,你就能应对绝大多数高并发场景;而守住"不死锁、不泄漏、不竞态"三条底线,再配上 Delve 与 -race,就能把并发 Bug 挡在线上之前。
如果你还想进一步了解高并发下 goroutine 失控与数据竞争的实战排查,可以顺着这篇延伸阅读:Golang高并发编程:彻底解决Goroutine失控与数据竞争。如果本文对你有帮助,欢迎收藏,方便日后随时翻看。
参考资料
- Go 官方文档 Effective Go:https://go.dev/doc/effective_go
- Go 官方并发教程:https://go.dev/tour/concurrency/
- Go 官方 Memory Model:https://go.dev/ref/memory
© 2026 | 转载请注明出处