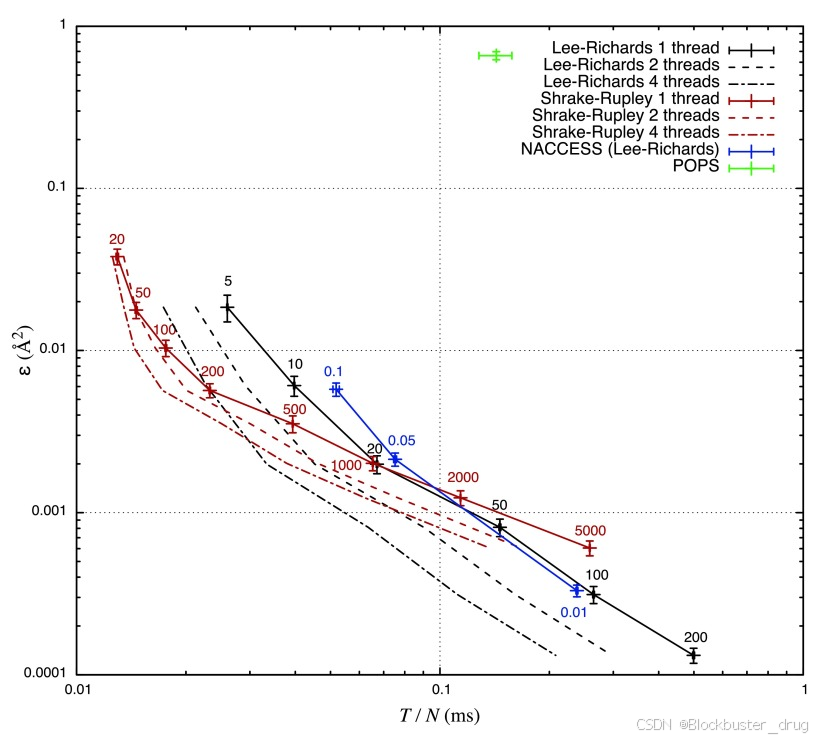
你算溶剂可及表面积(SASA)还在用要注册的闭源 NACCESS 吗?这篇给你 FreeSASA------MIT 协议开源 C 库,pip 一条命令装好,CLI + Python API 双接口,L&R 与 S&R 两种算法互差仅 0.1%,毫秒级出数。附三条安装路线、逐残基暴露排名 Python 示例(真实输出)、4 条实测踩坑、与 NACCESS/DSSP/PyMOL 等选型对比表,照抄代码 5 分钟接进你的脚本。
关键字:FreeSASA;SASA;溶剂可及表面积;NACCESS;Python API;结构生物学;pip 安装;残基暴露
相关教程与核心文献
| 资源 | 链接 | 与本文关系 |
|---|---|---|
| 官方文档站 | FreeSASA | 安装 + CLI 用法的权威来源 |
| GitHub 仓库 | GitHub - mittinatten/freesasa: C-library for calculating Solvent Accessible Surface Areas · GitHub | 源码、issue、release(205★,实测 2026-09) |
| C API 文档 (Doxygen) | FreeSASA: FreeSASA | 需要 C 集成时看 |
| 论文 | Mitternacht S. F1000Research 2016, 5:189, DOI 10.12688/f1000research.7931.1 | 算法与精度验证的原始出处(Crossref 已核) |
一、痛点:算个表面积,为什么没有一个顺手的小工具
做结构分析的人对 SASA(solvent accessible surface area,溶剂可及表面积)的需求非常日常:
- 判断某个残基到底埋在蛋白核心还是暴露在表面(突变设计前必看);
- 算配体结合前后被"埋起来"的界面面积(评估结合合理性);
- 比较 MD 轨迹里不同帧的紧凑程度(折叠/解折叠监控);
- 估算疏水效应------非极性表面暴露于水在能量上非常不利,疏水面积最小化是蛋白折叠的核心驱动力。
但看看现有选项:NACCESS 是最常用的命令行实现(L&R 算法的 Fortran 版),学术免费但闭源且要邮件申请 ;DSSP 主要算二级结构,SASA 只是顺带输出;PyMOL 的 get_area 藏在 GUI 里不好批量;MDAnalysis 倒是能算,但为一个表面积分析拉起整个框架太重。FreeSASA 填的就是这个空:一个只做一件事、开源、能轻松嵌进任何工具链的独立库。
二、SASA 是什么:滚球探针与两种经典算法
想象一个半径 1.4 Å 的小球(代表一个水分子),让它贴着蛋白表面滚一圈------球心划过的轨迹围成的面积,就是这个分子的 SASA。
精确计算这个曲面很贵,所以有两个经典近似,FreeSASA 都实现了:
| 算法 | 提出 | 思路 | FreeSASA 里的调法 |
|---|---|---|---|
| Lee & Richards (L&R) | 1971 | 沿 z 轴把分子切成一组薄片,用每片轮廓线近似表面 | 默认算法,slices 控制每原子切片数(默认 20) |
| Shrake & Rupley (S&R) | 1973 | 在每个原子球面上撒一组测试点,统计未被邻居遮挡的点 | algorithm='ShrakeRupley',n-points 控制点数(默认 100) |
论文(F1000Research 2016)用双原子体系解析解 + 两种算法互相对照 + 与 NACCESS 同参数对比三条路线验证了实现正确性:同分辨率同半径下 L&R 结果与 NACCESS 完全一致。半径默认用 Tsai 等的 ProtOr 参数集(覆盖 20 种标准氨基酸 + Sec/Pyl + 标准核苷酸),不在表内的元素回退到 Mantina 等的范德华半径,也允许用户给自定义配置文件。
性能上,论文报告单核速度与 NACCESS 相当甚至更快,且核心循环已并行化------我下面的实测也印证了"快"这一点。
三、安装:三条路线,pip 一条最快
路线 1:pip(推荐,Python 用户)
pip install freesasaPyPI 当前版本 2.2.1 (MIT 协议,27 个 release,实测 2026-09)。我实测在无编译器障碍的机器上 12 秒装完(自动拉源码编 C 扩展,纯标准 C 库无第三方依赖)。
路线 2:conda(推荐,管环境的人)
conda install -c conda-forge freesasaconda-forge 提供 Linux(amd64/arm64/ppc64le)预编译包,适合放进项目 environment.yml。
路线 3:源码(需要 CLI 或 C 集成)
# 下载 release 压缩包解压后
./configure
make
sudo make install
装好得到 freesasa 命令行二进制、freesasa.h 头文件和 libfreesasa 库。从 git 仓库直接拉的话先跑 autoreconf -i 生成 configure。macOS/Linux 还可以 brew install brewsci/bio/freesasa。
四、Python API 实战:30 行代码跑出残基暴露排名
拿一个 289 残基的蛋白(某 GPCR 跨膜结构域,2387 原子)做端到端演示------以下输出全部真实跑通(freesasa 2.2.1):
import freesasa

struct = freesasa.Structure("protein.pdb")
result = freesasa.calc(struct)                # 默认 L&R
print("Total SASA: %.2f A^2" % result.totalArea())
# Total SASA: 16627.92 A^2

# 极性/非极性分类面积
cls = freesasa.classifyResults(result, struct)
print(cls)   # {'Polar': 5101.1, 'Apolar': 11526.8}

# 换 S&R 算法对比一下
res2 = freesasa.calc(struct,
        freesasa.Parameters({'algorithm': 'ShrakeRupley', 'n-points': 100}))
print(res2.totalArea())   # 16645.44 ------ 与 L&R 只差 0.1%

# 逐残基面积:找最暴露 / 最埋的残基
ra = result.residueAreas()
for chain_id, residues in ra.items():
    items = sorted(((k, v.total) for k, v in residues.items()),
                   key=lambda x: -x[1])
    print(chain_id, "top exposed:", items[:3])
    print(chain_id, "top buried: ", items[-3:])
# R top exposed: [('170', 205.7), ('257', 184.5), ...]
# R top buried:  [('399', 0.0), ('403', 0.0), ...]
两个算法在真实蛋白上只差 0.1%,而 S&R(100 测试点)单次计算 0.009 秒------2387 原子的蛋白基本就是"秒出"。非极性面积占 69%(11,527/16,628 Ų),符合一个跨膜结构域大量疏水表面接触脂质的预期。
这个逐残基排名就是突变设计的第一步:area ≈ 0 的残基在核心,动它大概率影响折叠;area > 150 Ų 的在表面,是改造溶解度/免疫原性的候选位点。
五、CLI 实战:不想写代码也能用
官方示例用 RNA/蛋白复合物 3WBM(4 条蛋白链 + 2 条 RNA 链):
freesasa 3wbm.pdb输出自带参数回显 + 总量 + 分链明细:
## FreeSASA 2.1.0 ##
PARAMETERS
algorithm    : Lee & Richards
probe-radius : 1.400
threads      : 2
slices       : 20
INPUT
source  : 3wbm.pdb
chains  : ABCDXY
atoms   : 3714
RESULTS (A^2)
Total   :   25190.77
Apolar  :   11552.38
Polar   :   13638.39
CHAIN A :    3785.49
...
mmCIF 输入加 --cif 即可,输出完全一致。CLI 适合接 shell 流水线批量过 PDB 库;要逐残基/逐原子粒度或自定义分类,还是回 Python API。
六、踩坑记录(全部实测)
freesasa.__version__不存在 ------想确认版本别摸这个属性,用标准做法:from importlib.metadata import version; version('freesasa')→'2.2.1'。- Python API 没有
totalAreaByClass()------文档里极性/非极性分类在 Python 侧叫freesasa.classifyResults(result, struct),返回 dict。我第一次按 C API 的习惯找方法名直接 AttributeError。 residueAreas()的键是 PDB 里的真实 chain ID ------我拿的蛋白链 ID 是R,写死ra['A']直接 KeyError。先list(ra.keys())看一眼再取值。- 默认忽略 HETATM 和氢原子 ------要算配体/辅基/结晶水的 SASA,建 Structure 时显式打开(如
freesasa.Structure(pdb, options={'hetatm': True}));否则你算半天发现配体根本没进去。水分子、乙酰基/NH₂ 封端这三类 HETATM 有内置 ProtOr 半径,其余回退范德华半径。 - 许可证已变更 ------2016 年论文写的是 GPL-3,但当前 GitHub 仓库(2.x)已是 MIT(实测 2026-09)。商用集成不再有 copyleft 顾虑,以仓库 LICENSE 为准。
七、同类工具怎么选
| 工具 | 协议 | 接口 | 适合场景 |
|---|---|---|---|
| FreeSASA | MIT | CLI + C + Python | 批量/流水线、脚本集成、自定义半径------首选 |
| NACCESS | 闭源(学术免费需申请) | 仅 CLI | 审稿人点名要"经典口径"时 |
| DSSP | 开源 | 仅 CLI | 反正要算二级结构,顺带取 SASA |
PyMOL get_area |
开源 | GUI/Python | 交互式看单个结构 |
| MDAnalysis | GPL | Python | 已经在做 MD 轨迹分析,顺带算 |
cpptraj surf |
GPL | CLI | AMBER 轨迹流程内 |
一句话:单结构或 PDB 库批量 → FreeSASA;MD 轨迹内 → 用你已在用的分析框架。
结语
FreeSASA 是那种"装完就忘了它存在"的好工具:依赖只有标准 C 库、12 秒装好、两种经典算法结果互差 0.1%、单核毫秒级出数。它解决的不是什么高精尖问题,而是把"算个表面积"这件高频小事从"申请闭源软件 + 手工解析输出"变成"pip install + 三行 Python"。下次再做突变位点筛选或界面埋藏面积评估,先试它。
参考来源
- Mitternacht S. FreeSASA: An open source C library for solvent accessible surface area calculations. F1000Research 2016, 5:189. DOI: 10.12688/f1000research.7931.1
- FreeSASA 官方文档:FreeSASA
- GitHub 仓库(MIT, 205★):GitHub - mittinatten/freesasa: C-library for calculating Solvent Accessible Surface Areas · GitHub
- PyPI 页面(2.2.1):freesasa · PyPI
- Tsai J 等. J Mol Biol 1999(ProtOr 半径集);Mantina M 等. J Phys Chem A 2009(范德华半径)