当存储复制保不住逻辑,当DG/Binlog困于内核瓶颈,我们如何重新定义数据库极速恢复?
一、午夜凶铃:每个DBA最怕的那通电话
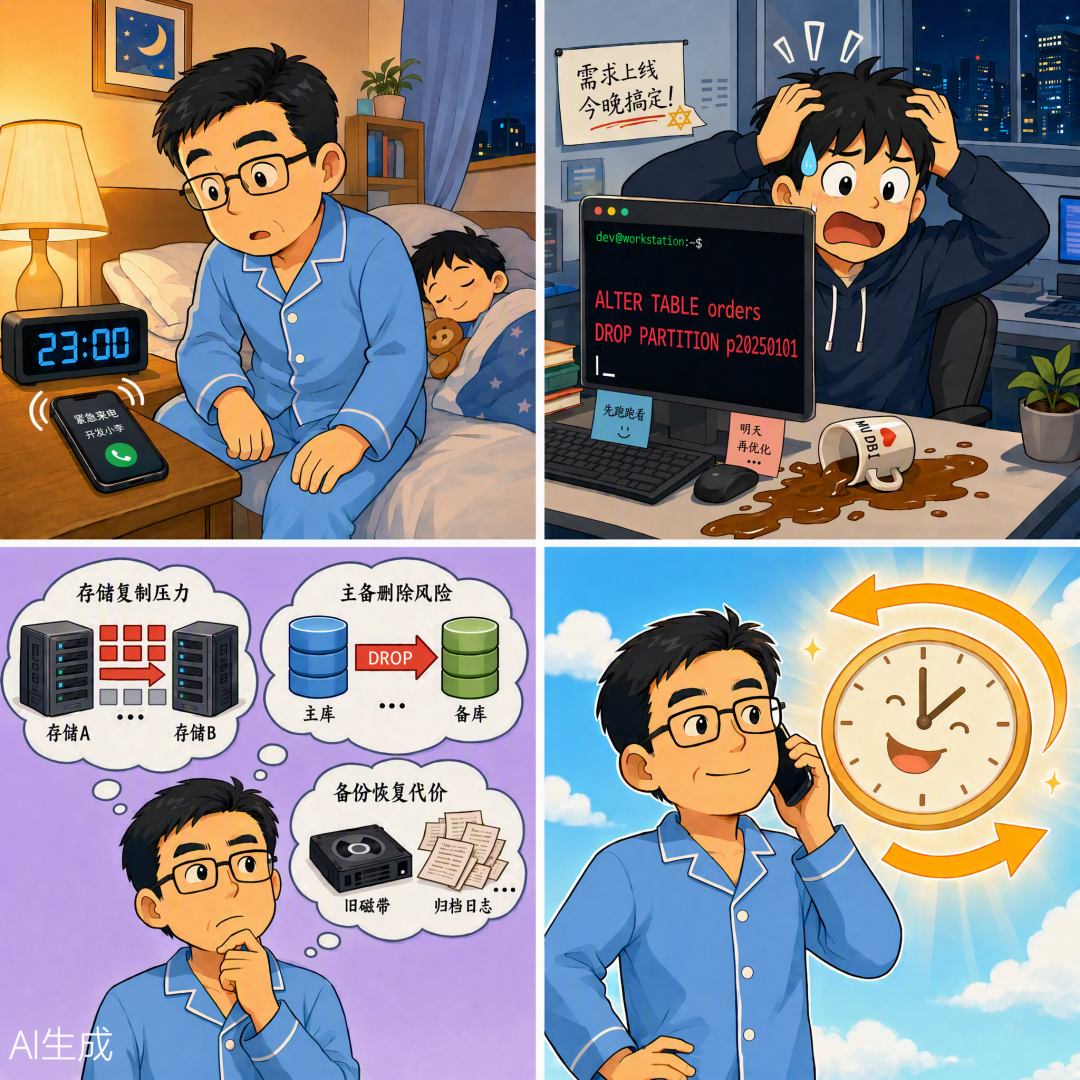
周五深夜23:00,你刚哄睡孩子,手机响了。
开发同事的声音在颤抖:"老大,我手滑把生产库orders表的p20250101分区给DROP了,本来是想清理备份库里的同名分区......等我反应过来已经过了十分钟,这期间业务还写进了大量新数据。"
你脑子里瞬间闪过三个画面:
-
存储层做了双活镜像------但镜像同步的是坏数据块,它"忠实"地复制了每一次操作;
-
Oracle ADG备库正在实时同步------它同样"忠实"地同步了那条DROP;
-
全量备份在24小时前,归档日志散落各处,恢复需要小时级起步。
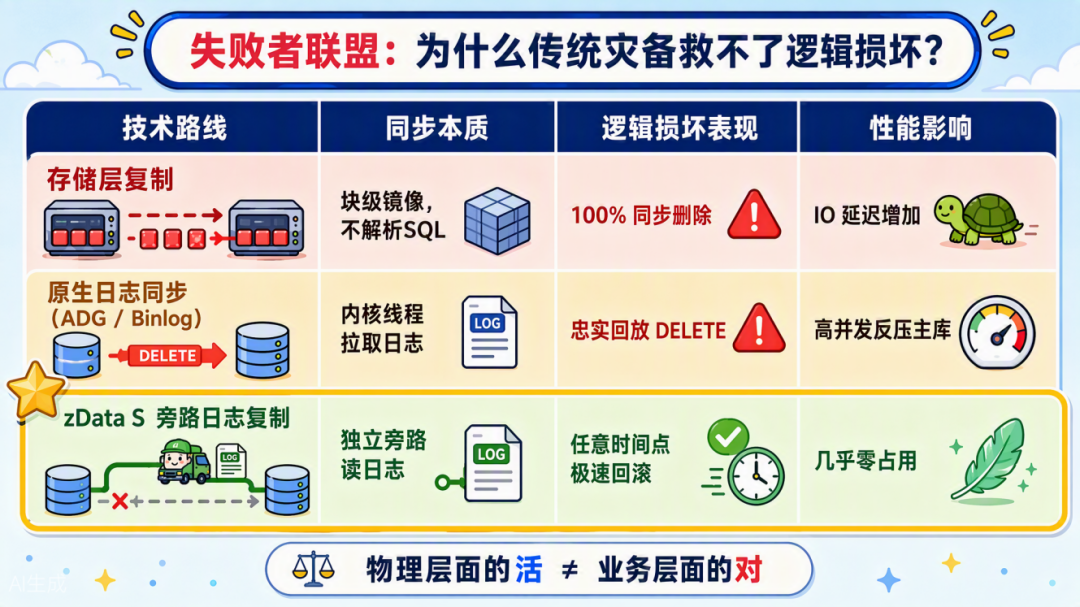
你面对的是一个残酷事实:物理层面的"活"不等于业务层面的"对"。 传统灾备在逻辑损坏面前,等于"同谋共犯"。
此时摆在DBA面前的路只有两条:要么从冷备磁带或全量备份中痛苦恢复数小时,业务停摆;要么......(你懂的)。
但今天,我们要聊的是第三条路------一条能让DBA从"救火队员"变成"时空旅行规划师"的路。
二、解剖"失败者联盟":为什么主流技术救不了逻辑损坏?
在展开zData S方案之前,我们有必要正视现状------DBA手中最常用的两类灾备手段,在面对逻辑损坏时,各自存在先天缺陷。
| 技术路线 | 典型代表 | 同步本质 | 逻辑损坏下的表现 | 对主库性能影响 |
|---|---|---|---|---|
| 存储层复制 | 存储双活、SAN Mirror、EMC SRDF | 块级Bit-to-Bit镜像,不解析任何SQL/事务语义。文件系统层面看到的是什么,就复制什么。 | 100%同步删除。回滚只能依赖存储快照(且需提前配置),回滚时业务中断,恢复时间取决于快照回滚速度。 | 消耗存储网络带宽,同步模式下IO延迟明显增加。 |
| 数据库原生日志同步 | Oracle ADG、MySQL Binlog复制、PostgreSQL物理流复制 | 内核线程拉取日志,依赖LGWR或Binlog Dump线程;严格绑定同版本、同架构。 | 事务被完整回放。Oracle Flashback Database依赖Flashback Logs,受db_flashback_retention_target约束;Flashback Query则受Undo保留时长与空间约束,大规模回查代价不菲。MySQL可通过binlog反向解析或第三方工具(binlog2sql、MariaDB mysqlbinlog --flashback等)实现类Flashback能力,但生态成熟度参差。 |
高并发、大事务场景下,日志生成速度可能超过Dump线程传输能力,造成主库性能抖动。 |
| zData S 旁路日志复制 | (本文主角) | 独立旁路读取日志文件,不依赖数据库任何工作线程,不调用DG Broker或Binlog Dump。 | 日志旁路至独立平台,可基于任意SCN/LSN进行极速回滚** ,平台内洁净副本秒级就绪,备用数据库5分钟以内拉起。** | 极低------独立I/O通道,数据库主机CPU/内存几乎零占用(仅涉及旁路文件读取I/O)。 |
核心差异一句话概括:原生同步是"生产线程分心做快递",zData S是"专业快递公司蹲在仓库门口独立取货"。前者可能拖累生产,后者与业务解耦。
然而,当我们庆幸于找到了"可回滚"的救命稻草时,一个更残酷的拷问浮出水面:回滚到指定时间点,到底需要多久? 是全量备份的恢复时长,还是SLA能忍受的分钟级?如果恢复动作本身演变为又一次"长时间停服",保护能力的价值将大打折扣。这个问题,我们留待以后深度拆解,本篇文章先聚焦于"能不能回"与"凭什么能回"。
三、深剖zData S"旁路日志"核心原理------给DBA的硬核技术餐
理解了"为什么需要",我们进入DBA最感兴趣的部分:它是怎么做到的?
3.1 架构三要素
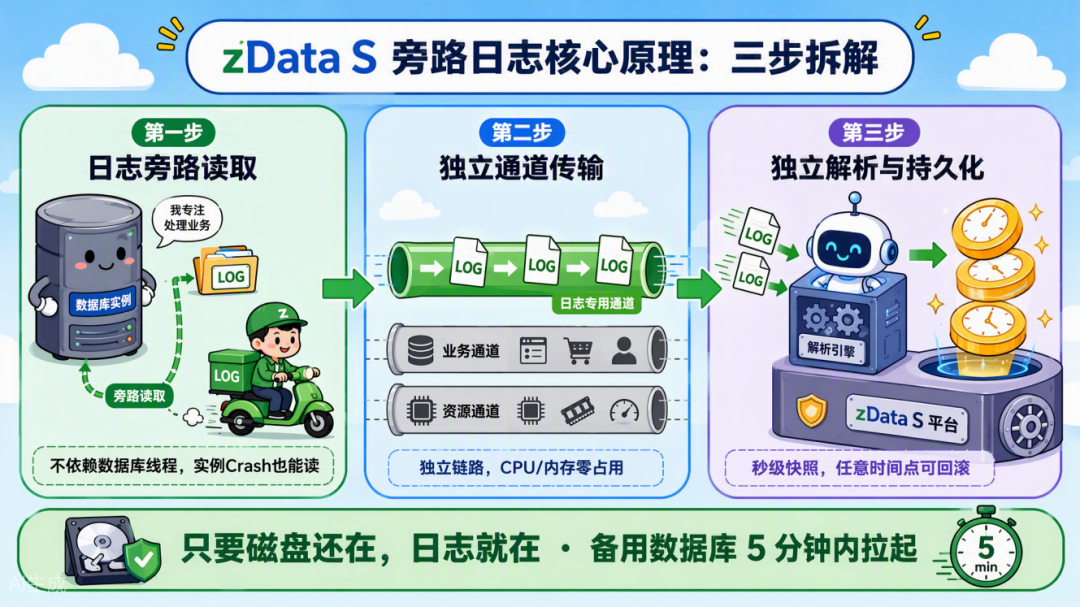
zData S持续保护平台的日志同步链路,可以拆解为三个清晰步骤:
第一步:日志旁路读取
zData S通过操作系统文件接口,直接读取已落盘的Online Redo Log、Archive Log或Binlog文件。该读取过程不依赖数据库内核API,不调用任何数据库后台进程(如LGWR、ARCH、Binlog Dump等),完全独立于数据库实例运行。
"旁路"二字背后,是三个实打实的工程门槛:
-
其一,Online Redo Log是循环复用的,zData S通过文件系统事件与文件元数据(大小、inode)监控实时识别log switch,确保日志被覆盖前完成采集;
-
其二,对ASM存储的Oracle环境,普通OS文件接口无法触达日志文件,zData S通过专用接口读取;
-
其三,采集节奏必须与日志写入速度赛跑,任何一环掉队都意味着保护窗口出现空洞。
关键价值:即使数据库实例Hang住、甚至CRASH崩溃,zData S依然可以读取存储中已持久化的日志数据。只要磁盘还在,日志就在。
第二步:独立通道传输
采集到的日志数据通过独立网络链路(可与管理网、业务网物理隔离)实时推送到zData S持续保护平台。传输过程中对数据进行轻量压缩和校验,确保网络带宽效率。
关键价值:全程不占用数据库服务器的CPU和内存资源,仅涉及旁路文件读取带来的少量磁盘I/O,对生产库的性能影响极低。这在核心交易系统中是压倒性的优势。
第三步:平台独立解析与持久化
zData S平台收到日志后,由自研日志解析引擎 独立完成事务重组,将Redo/Binlog中的物理变更重构为事务级操作序列 ,并以高效压缩格式持久化存储于平台内部;同时,平台以秒级快照将各时间点的数据库状态持续固化,使任意历史时刻都成为一个随时可拉起的恢复点。
关键价值:解析引擎独立于数据库内核,这意味着zData S具备数据库版本解耦能力------日志解析与数据库实例运行分离,为跨大版本兼容提供了架构基础。
3.2 "旁路"二字的真正含义
很多DBA会问:"ADG也是传日志,你这不也是传日志,区别在哪?"
区别在于"谁在传、怎么传"。
-
ADG/Binlog复制 :日志传输线程是数据库内核的一部分,它们与数据库的工作线程共享进程资源。在大事务、高并发或网络抖动场景下,日志生成速度一旦超过传输能力,Dump线程就可能成为瓶颈,进而反压主库,造成性能抖动。
-
zData S :采用完全独立的旁路采集通道,不挂载在任何数据库后台线程之下。它不关心数据库的当前负载,只关心文件系统上的日志文件是否新增了内容。两者完全解耦。
用一个通俗比喻:ADG像是让餐厅主厨一边炒菜一边抽空把做好的菜端到隔壁包间;zData S则是让一个独立的传菜员站在出菜口,菜一出来立刻端走。主厨只管炒菜,效率最高。
3.3 "准实时"而非"强同步"的设计智慧
有细心的同行会问:"既然是旁路读取已落盘的日志,那必然存在延迟,为什么不做成强同步?"
这是一个好问题,也是zData S刻意为之的产品哲学。
-
强同步(如存储同步复制、Oracle SYNC模式)必然拖累主库事务提交延迟,在网络抖动时尤其明显。这是用主库性能换RPO,许多生产系统承受不起。
-
zData S选择"准实时" :RPO典型值在10秒~2分钟 之间,具体受redo log切换频率、采集轮询间隔与网络条件影响;最坏情况下取决于单组redo log大小与归档完成时间。以此换来的是对主库几乎为零的性能影响。
在逻辑损坏场景下,RPO是秒级还是毫秒级其实没有意义------因为损坏瞬间发生后,你需要的不是"少丢几毫秒的数据",而是"能精准回到损坏前的那一刻"。 zData S保的是"精确回溯点"的能力,而非"同步速度"本身。 这个区分是DBA理解本产品价值的关键。
四、杀手锏------"任意时间点回滚"在DBA手中的实战体验
让我们回到开篇那个午夜事故。
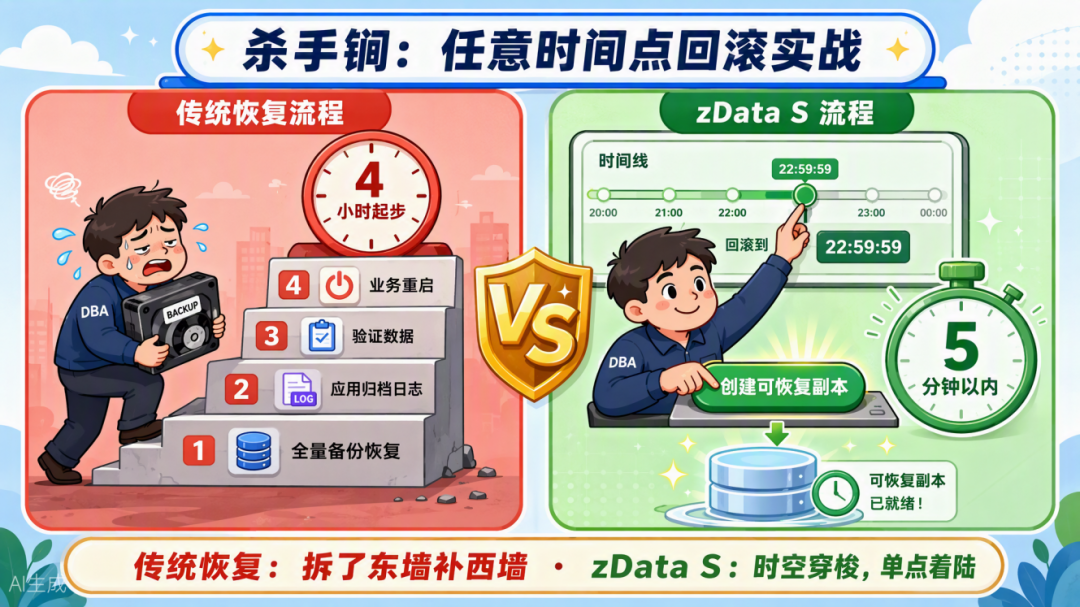
传统流程:
-
- 确认误操作时间点(23:00)。
-
- 从全量备份恢复(假设3小时)。
-
- 应用全量备份之后的归档日志到误操作前一秒(假设1小时)。
-
- 验证数据一致性。
-
- 业务恢复。
总耗时:4小时起步。 对于7×24小时在线的业务,这是灾难性的。
zData S流程:
-
- 登录zData S控制台,选择时间轴视图。
-
- 定位到误操作发生前1秒(例如22:59:59),点击"创建可恢复副本"。
-
- zData S平台在自身内部存储 上,基于已持续保护的日志,构建一份该时间点的洁净数据副本,秒级拉起。
-
- 业务连接到该副本,验证数据正确性后,自行切换流量或补录数据。
总耗时:5分钟以内拉起备用数据库------洁净副本秒级就绪,备用数据库5分钟以内完成拉起,业务验证切换后即可恢复运行,与传统全量恢复的"4小时起步"形成数量级差距。
对比Oracle Flashback:Flashback Database本质是基于Flashback Logs的块级时点还原,能力与保留窗口绑定,且要求数据库处于特定配置状态;Flashback Query/Table则依赖Undo,在大事务、长回溯场景下代价显著上升。zData S走另一条路:在旁路平台上预先备好数据副本,恢复时只需在副本基础上前滚少量增量日志至指定时间点------数据底座早已就位,需要"临时补的课"越少,恢复自然越快。
一句话总结:传统恢复是"拆了东墙补西墙",zData S是"时空穿梭,单点着陆"。
说到这里,请各位DBA同行设身处地再多想一步:如果这个"拉起"过程需要等待数据文件完全初始化、日志全部重做完毕,耗时数十分钟甚至数小时,业务方是否还会为你鼓掌?在真实生产事故中,业务方对"恢复"的容忍度,往往只以"分钟"甚至"秒"为单位计。 恢复速度,才是将技术能力兑换为业务安全感的最终汇率。
zData S如何实现真正的"极速"?它的底层调度机制与传统的"全量恢复+日志应用"有何天壤之别?这将是我们后续会讲到的硬核话题。
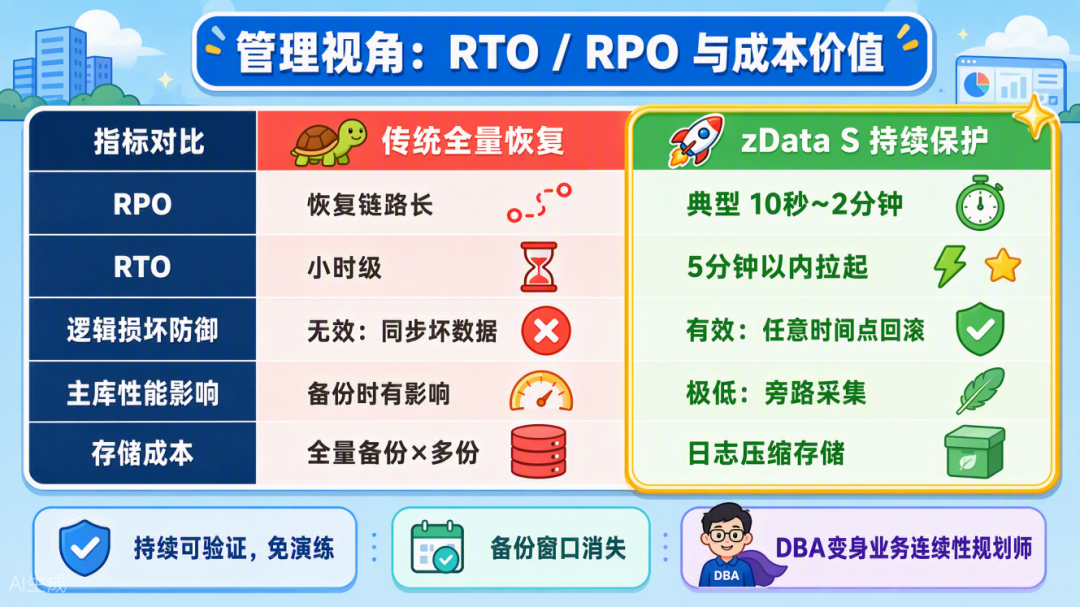
五、回归管理视角------RTO/RPO与成本价值
从技术管理层视角,几个关键数据值得关注:
| 指标 | 传统全量恢复 | zData S持续保护 |
|---|---|---|
| RPO | 取决于备份与归档策略;有完整归档时可接近事故点,但恢复链路长 | 典型10秒~2分钟(准实时,受日志切换频率与网络条件影响) |
| RTO | 小时级(TB级数据全量恢复+日志应用) | 5分钟以内拉起备用数据库(洁净副本秒级就绪) |
| 逻辑损坏防御 | 无效(同步坏数据) | 有效(任意时间点回滚) |
| 主库性能影响 | 无(备份时除外) | 极低(旁路采集通道,仅少量文件读取I/O) |
| 备份存储成本 | 全量备份×多份,占用大 | 日志压缩存储,远小于全量副本 |
对于IT管理层,zData S带来的不仅仅是技术指标改善,更是运维范式的转变:
-
不再需要频繁做全量恢复演练来验证备份有效性------因为持续保护的日志平台本身就是"持续可验证"的;
-
备份窗口彻底消失------日志是持续同步的,没有"备份时间窗口"的概念;
-
DBA团队从"救火队"转型为"业务连续性规划师"------这是组织能力的质变。
尾声:从"能恢复"到"恢复快"
本篇文章剖析了"旁路日志同步"如何为逻辑损坏画上句号。核心结论很清晰:
-
存储层复制不懂业务语义,逻辑损坏时是"同谋";
-
数据库原生同步受限于内核架构,性能有损且恢复路径长;
-
zData S通过独立旁路读取、独立通道传输、独立引擎解析,实现了对主库几乎零影响的持续保护,并赋予DBA"任意时间点回滚"的终极能力。
但故事的另一个主角------"时间"------尚未登场。能恢复不等于恢复快。当业务人员在电话那头嘶吼"还要多久"时,分钟级和小时级之间,隔着的是一家公司的生死线。
在后续的文章中,我们将回答"为什么极速恢复对于保障业务安全至关重要?"并深入探讨:当RPO趋近于零时,为什么RTO才是决定业务生死的"最后一根稻草"?zData S在面对TB级海量数据拉起时,如何通过独特的存储层快照与并行调度机制 ,将备用数据库拉起时间从"小时级"压缩至5分钟以内?
敬请期待。
注:zData S不替代数据库原生高可用方案(如ADG、MGR),而是与之互补,共同构建"物理高可用+逻辑安全"的双重防线。