一.Join连接算法的意义
1.为什么我们需要连接操作
因为我们通常不会把所有相关信息都塞进一张表,而是把不同类型的信息分开存储;当查询需要同时使用这些信息时,就必须把它们"连接"起来。
比如我们有一张学生表:
| 学号 | 姓名 | 专业 |
|---|---|---|
| 1 | 张三 | 计算机 |
| 2 | 李四 | 软件工程 |
| 3 | 王五 | 网络工程 |
还有一张成绩表:
| 学号 | 课程 | 成绩 |
|---|---|---|
| 1 | 数据库 | 90 |
| 2 | 数据库 | 85 |
| 3 | 数据库 | 78 |
当我们需要查询每个学生的姓名和数据库课程时,我们就需要把Student.学号和Score.学号对应起来,这就是join。
那为什么我们不把所有信息都放在一张大表里?这样看起来确实方便,但如果一个学生有很多门课怎么办,例如张三有:
数据库 90 操作系统 88 计算机网络 92 数据结构 95
此时这张表就会变成:
| 学号 | 姓名 | 专业 | 课程 | 成绩 |
|---|---|---|---|---|
| 1 | 张三 | 计算机 | 数据库 | 90 |
| 1 | 张三 | 计算机 | 操作系统 | 88 |
| 1 | 张三 | 计算机 | 计算机网络 | 92 |
| 1 | 张三 | 计算机 | 数据结构 | 95 |
这样以来姓名列和专业列就会出现大量重复数据"张三"和"计算机",而且如果张三的专业发生改变,就需要我们修改很多行,这就容易产生:数据冗余和数据不一致。
所以我们就需要把数据库的信息拆开,设计成
Student:学号,姓名,专业
Course:课程号,课程名称,学分
Score:学号,课程号,成绩
这样每种信息只保存一次。当我们需要查询一个人的成绩时,由于数据分散在多张表里,这时就需要把他们连接起来。
2.join的本质
Join 是根据两个关系之间的关联属性,把分散在不同表中的相关信息重新组合起来。
整体可理解为:数据分开存储→需要一起使用→通过关联字段连接→得到完整信息
3.低效查询倒逼技术优化
在专门的连表算法出现之前,数据库要把两张表关联起来,用的是最笨的办法:先把两张表的所有行两两配对,生成一张超级大的中间表,再从里面挑出符合关联条件的数据。
这个办法有个致命问题:两张表的数据量会直接相乘。比如一张表 1 万行、另一张表 10 万行,中间就会生出 10 亿条配对数据,这里面绝大多数都是没用的。这会让磁盘读写量、计算量都爆炸式增长,数据量一大就完全跑不动。
所以后来学术界和工业界才陆续研究出各种高效的连表算法,靠排序、哈希分桶、分块读取这些思路,大幅降低了多表关联的资源消耗。
4.连接算法
连接算法研究的问题:两个表的数据量很大时,数据库如何快速找到满足连接条件的记录对。
我们主要聚焦于基于相等条件的两表内连接算法,即基于相等条件的两表连接。这类算法的实现逻辑稍作调整,就可以支持外连接、半连接等其他类型的连接操作。
在连接中,通常会把较小的表作为左表(外表),这是数据库优化器在生成物理计划时会重点考虑的优化策略,以减少内层循环的次数。
二.核心逻辑与实现方法:主流Join算法原理详解
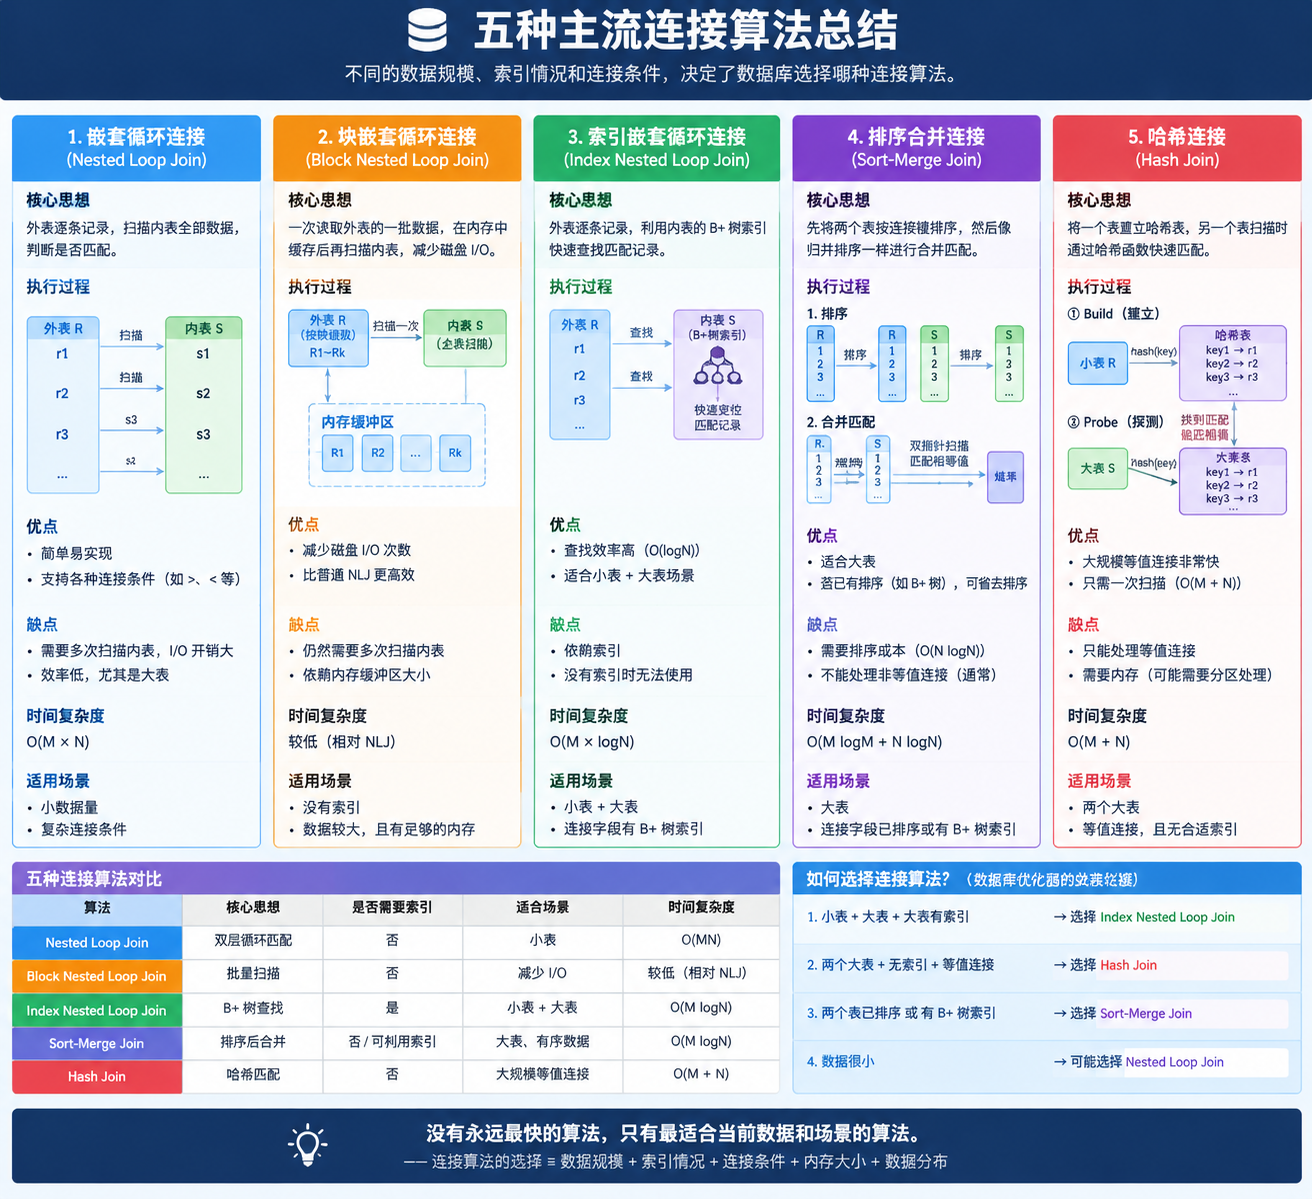
1.朴素嵌套循环连接
嵌套循环连接是最基础的连接算法,核心逻辑为双层遍历匹配,通过外层遍历一张表、内层遍历另一张表,可以理解为:拿左表的一条记录,去右表从头到尾找匹配项;找完以后,再拿左表下一条。
我们可以用C语言中的for循环类比:
c
for (Student中的每一条记录) {
    for (Score中的每一条记录) {
        if (Student.id == Score.sid) {
            输出连接结果;
        }
    }
}核心就是:外层循环遍历外表,内层循环扫描内表。
但朴素嵌套循环连接效率可能很低
假设学生表有1000条数据,成绩表有10000条数据。在最简单情况下要进行1000*10000=10000000次匹配判断,如果数据量更大效率就会很低很低。所以朴素嵌套循环连接的问题就是:如果外表和内表都很大,需要大量重复扫描内表,性能输在磁盘I/O
2.分块嵌套循环连接
朴素嵌套循环连接是一条一条的处理数据,但是数据库有内存池,所以一次性可以装很多页,于是就可以一块一块的处理。本质就是把朴素版「一行扫一遍内表」的笨办法,改成了「一块扫一遍内表」,靠大幅减少内表的扫描次数来省磁盘 IO。
- 优化内表扫描次数:嵌套循环里最大的开销就是反复扫内表。分块之后,内表的扫描次数从「外表的行数」变成了「外表的分块数」,块越大,扫描次数越少。
- 用内存换 IO:把外表的一批数据先缓存到内存里,扫内表的时候一次性和这批数据匹配,本质就是用少量内存空间,换大量的磁盘读取开销。
- 适配大外表场景:如果外表太大、整个装不进内存,就用分块的方式分批加载,既不爆内存,又比一行一行扫高效得多。
3.索引嵌套循环连接
核心思想:索引嵌套循环连接 = 嵌套循环连接 + 内表上的索引,用索引快速找到匹配记录,而不是每次扫描整个内表。
普通嵌套循环:外表记录→扫描内表
索引嵌套循环:外表记录→查一个目录 →直接找到内表记录
这个目录就是索引,这个索引通常用B+树实现,速度比普通嵌套循环快,时间复杂度为O(logn)。
4.排序合并连接
核心思想:先把两个表按照连接键排序,然后利用两个有序序列像拉拉链一样扫描匹配。
嵌套循环连接:
张三 → 扫描Score全部
李四 → 扫描Score全部
王五 → 扫描Score全部
如果两个表很大就会变得非常慢,那有没有办法让两个表按照id排好,然后直接匹配?这就是排序合并连接。
它主要分为两个阶段:
阶段1(排序) :基于连接键,通过外部分归并排序,分别对表R、表S进行全局排序;
阶段2(合并):为两张有序表分别设置游标,逐行比对游标所在元组的连接键,键相等则拼接输出,键不相等则移动较小值的游标,直至遍历完任意一张表。
5.哈希连接
核心思想:利用哈希函数把两个表中连接键相同的数据映射到同一个位置,然后快速匹配。
哈希连接分为两个阶段:
**Build建立阶段:**选取小表为构建表,通过哈希函数对连接键哈希,在内存中构建哈希表,存储元组或记录ID;
**Probe探测阶段:**遍历大表(探测表),对每条元组的连接键执行相同哈希运算,定位哈希表对应桶,比对真实键值完成匹配。
但如果表非常大不能全部放进内存,这时就需要分区哈希连接。核心:先分区再分别连接。
6.五种算法对比
| 算法 | 核心思想 | 是否需要索引 | 适合场景 | 复杂度 |
|---|---|---|---|---|
| Nested Loop | 双层循环匹配 | 否 | 小表 | O(MN) |
| Block Nested Loop | 批量扫描 | 否 | 减少I/O | 较低 |
| Index Nested Loop | B+树查找 | 是 | 小表+大表 | O(MlogN) |
| Sort-Merge Join | 排序后合并 | 否/可利用索引 | 大表、有序数据 | O(NlogN) |
| Hash Join | 哈希匹配 | 否 | 大规模等值连接 | O(M+N) |