一、为什么需要卷积神经网络?
在计算机中,图像本质上是一组按照顺序排列的数字。灰度图像中的像素值通常表示明暗程度,数值范围为 0~255;而更常见的 RGB 彩色图像由红、绿、蓝三个通道组成,因此可以把一张彩色图片理解成一个三维张量。
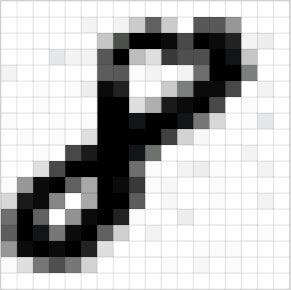
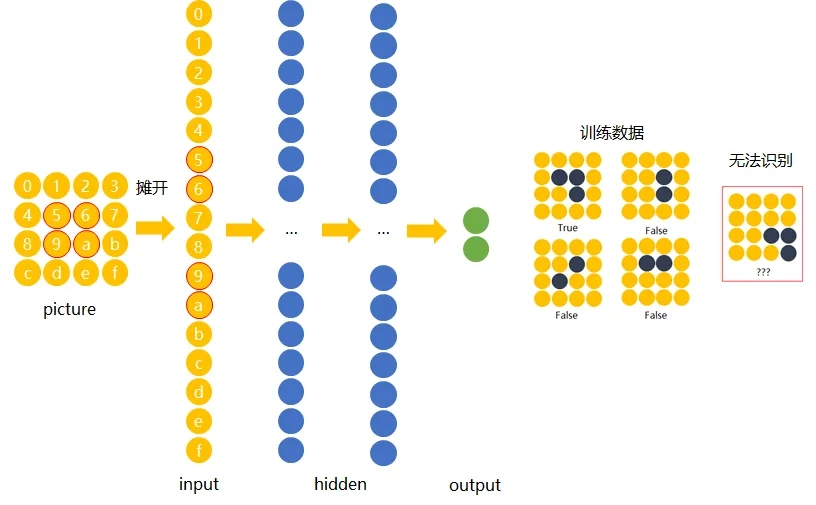
如果直接使用传统的全连接神经网络处理图像,图片尺寸变大以后,网络需要处理的参数数量会迅速增加,而且很难很好地处理同一个物体出现在不同位置、发生轻微变形等情况。
CNN 的一个重要目标,就是让网络能够从局部区域中自动提取有用特征,并尽可能具备一定的画面不变性。例如,一个物体出现在图片左侧还是右侧,模型都应该尽量识别成同一种物体。
二、CNN 的核心:卷积、池化和全连接
CNN 的基本结构主要包括卷积层、池化层和全连接层。
1. 卷积层
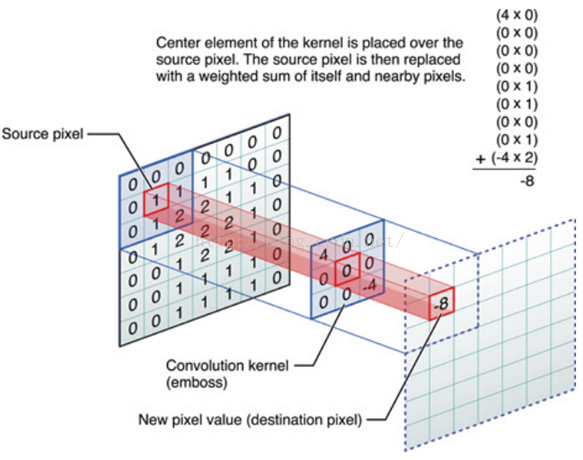
所谓卷积,就是让图像中的一个局部窗口与卷积核进行计算:对应位置的元素相乘,再把结果相加,从而得到新的特征值。卷积核可以看成一组需要学习的权重,也可以理解为一种滤波器。
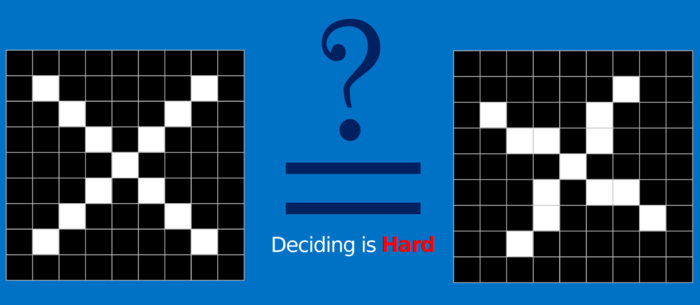
随着卷积核在图像上不断移动,就能够得到一张新的特征图(Feature Map)。不同的卷积核可以学习不同的特征,例如边缘、纹理以及更加复杂的形状。
卷积过程中有几个重要参数:
-
stride(步长):卷积核每次移动的距离。
-
padding(填充):在图像边缘补充一定数量的 0。
-
卷积核数量:决定输出特征图的深度。
2. 池化层
池化层主要用于下采样,也就是减小特征图的空间尺寸。这样可以降低参数数量和计算量,并在一定程度上控制过拟合。
常见的池化方式包括最大池化、平均池化、全局平均池化和全局最大池化。其中最大池化比较常见,它会在池化窗口中选择最大的值作为输出。
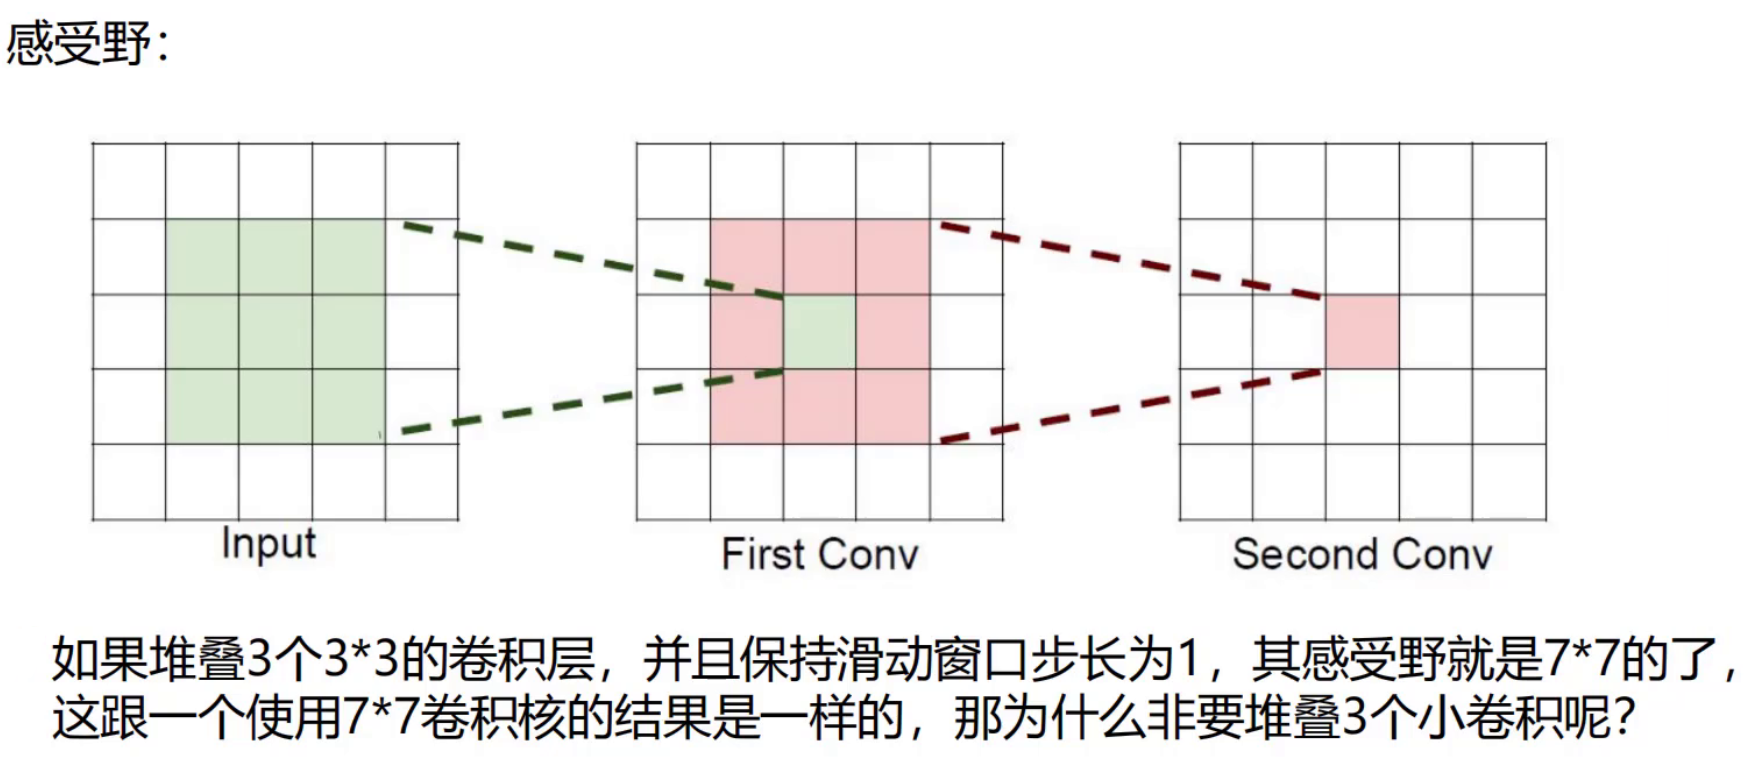
池化的核心思想可以简单理解为:保留比较重要的信息,同时压缩一些冗余信息。
3. 全连接层
当卷积层和池化层提取到足够多的特征之后,还需要根据这些特征完成分类。通常会先把最后得到的特征图进行 Flatten(展平),再送入全连接层,最终输出各类别的预测结果。
因此,一个典型的 CNN 流程可以概括为:
输入图像 → 卷积 → 激活 → 池化 → 卷积 → 激活 → 池化 → Flatten → 全连接 → 分类结果
三、用 MNIST 实现 CNN 图像识别
掌握基本原理后,PPT 使用 MNIST 数据集作为 CNN 的实践案例。MNIST 是经典的手写数字数据集,每张图片表示一个 0~9 的数字。
在 PyTorch 中,可以使用 datasets.MNIST 下载和读取数据,再通过 DataLoader 按 batch 组织数据。模型部分使用 nn.Conv2d、激活函数、nn.MaxPool2d、nn.Flatten 和 nn.Linear 等模块组成。
训练过程可以简单概括为:
-
准备训练集和测试集;
-
使用 DataLoader 按批次读取图片;
-
将图片输入 CNN;
-
计算预测结果与真实标签之间的损失;
-
反向传播并更新网络参数;
-
使用测试集检查模型效果。
通过这个过程,可以把前面学习的卷积、池化和全连接真正应用到图像分类任务中。
四、数据增强:让模型见过更多变化
在实际图像任务中,训练数据可能数量有限。如果模型只看到比较固定的图片形式,就可能出现泛化能力不足的问题。
数据增强(Data Augmentation)的目的,就是增加训练数据的多样性,从而提高模型的泛化能力。
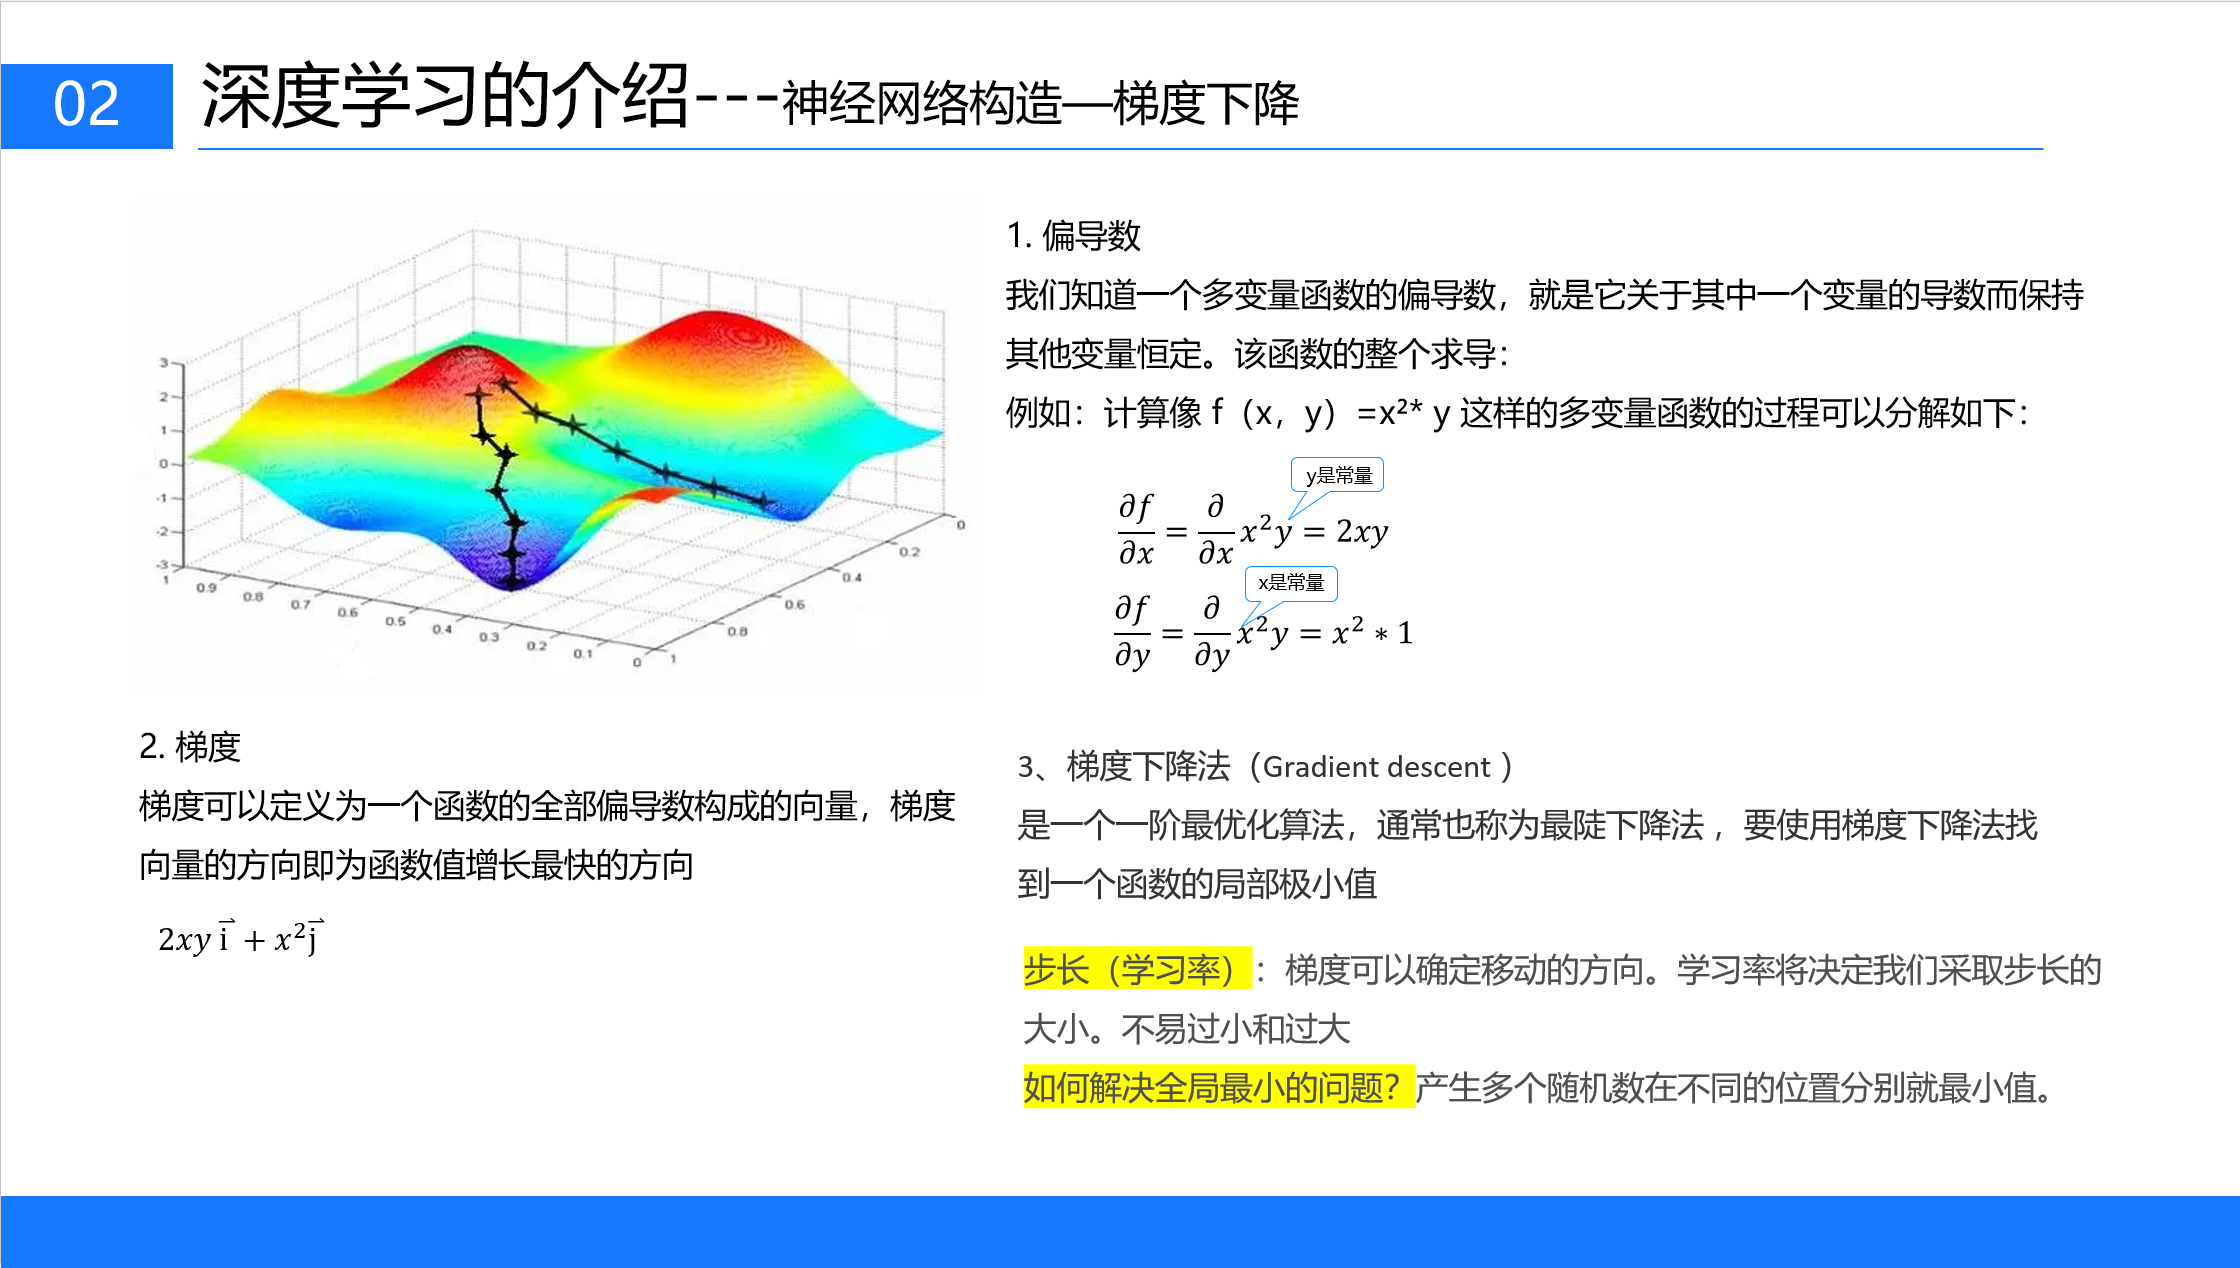
数据增强方式包括:
-
垂直翻转
-
随机旋转
-
随机裁剪
-
颜色变换
例如,同一张图片经过旋转、翻转或者颜色变化后,可以形成不同的训练样本。这样模型在训练过程中能够接触到更多变化,从而减少对某一种固定图片形式的依赖。
五、调整学习率:让训练过程更加稳定
学习率决定了神经网络每次更新参数时的幅度。常用学习率包括 0.1、0.01 和 0.001。
一般来说,希望训练初期的学习率相对较大,让网络快速收敛;到了训练后期,再逐渐降低学习率,使模型更加稳定地接近较优解。
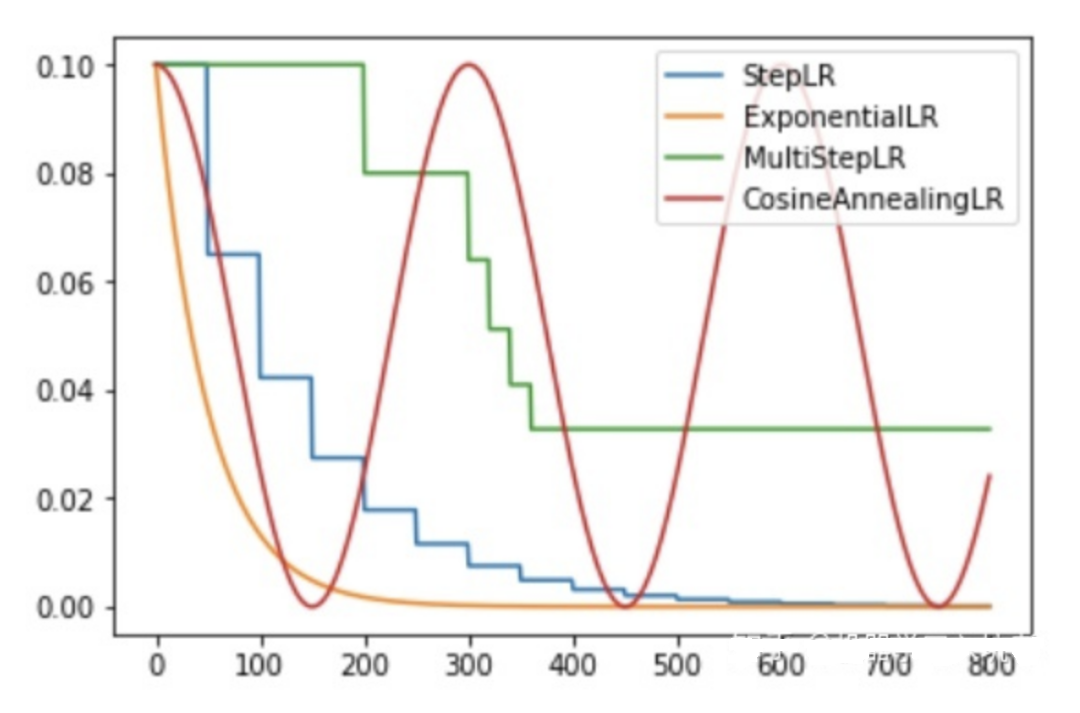
PyTorch 可以通过 torch.optim.lr_scheduler 实现学习率调整。以下介绍了三类方法:
-
有序调整:StepLR、MultiStepLR、ExponentialLR、CosineAnnealingLR 等;
-
自适应调整:ReduceLROnPlateau,根据 loss 或 accuracy 等指标变化调整学习率;
-
自定义调整:LambdaLR,通过自定义函数决定学习率变化。
其中 StepLR 的思路比较直观:每经过指定数量的 epoch,就按照一定比例降低学习率。
六、迁移学习与 ResNet
当数据集规模较小或者从头训练一个深度网络成本较高时,可以使用迁移学习。
迁移学习的基本思想是:先利用已经在大规模数据集上训练好的模型,再把它应用到新的任务中,通过冻结部分参数、增加新的分类层以及进一步微调等方式,使模型适应新的数据集。
PPT 中给出的迁移学习基本步骤是:
-
选择预训练模型和合适的层;
-
冻结预训练模型参数;
-
在新数据集上训练新增层;
-
解冻部分网络并进行微调;
-
在测试集上评估模型。
其中 ResNet 是非常典型的预训练网络。
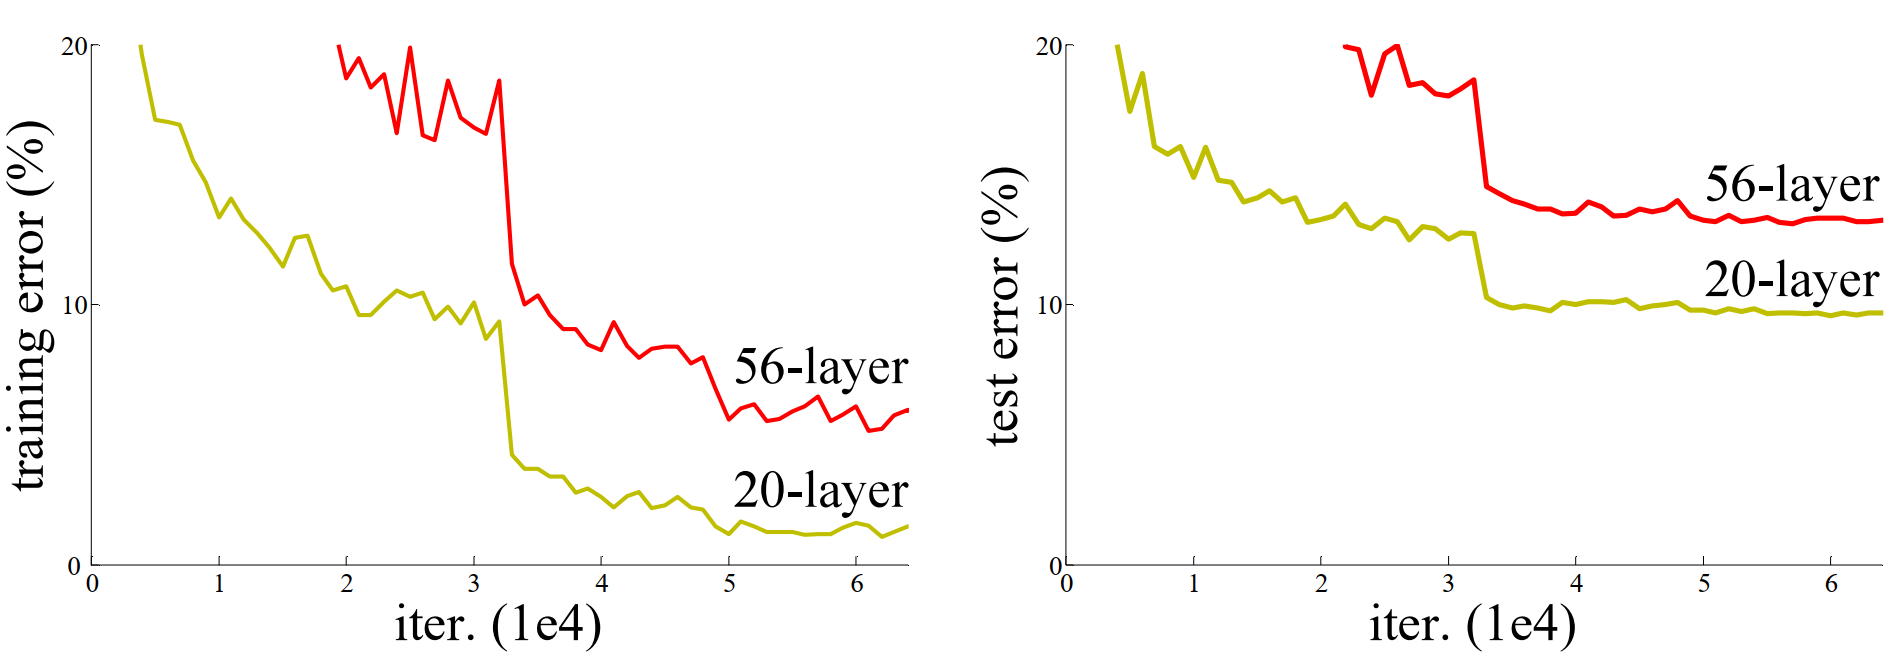
传统 CNN 随着网络越来越深,可能出现梯度消失、梯度爆炸以及网络退化等问题。ResNet 通过残差结构引入 shortcut(捷径)连接,让输入 X 可以跨过部分网络层,与变换后的 F(X) 进行相加。
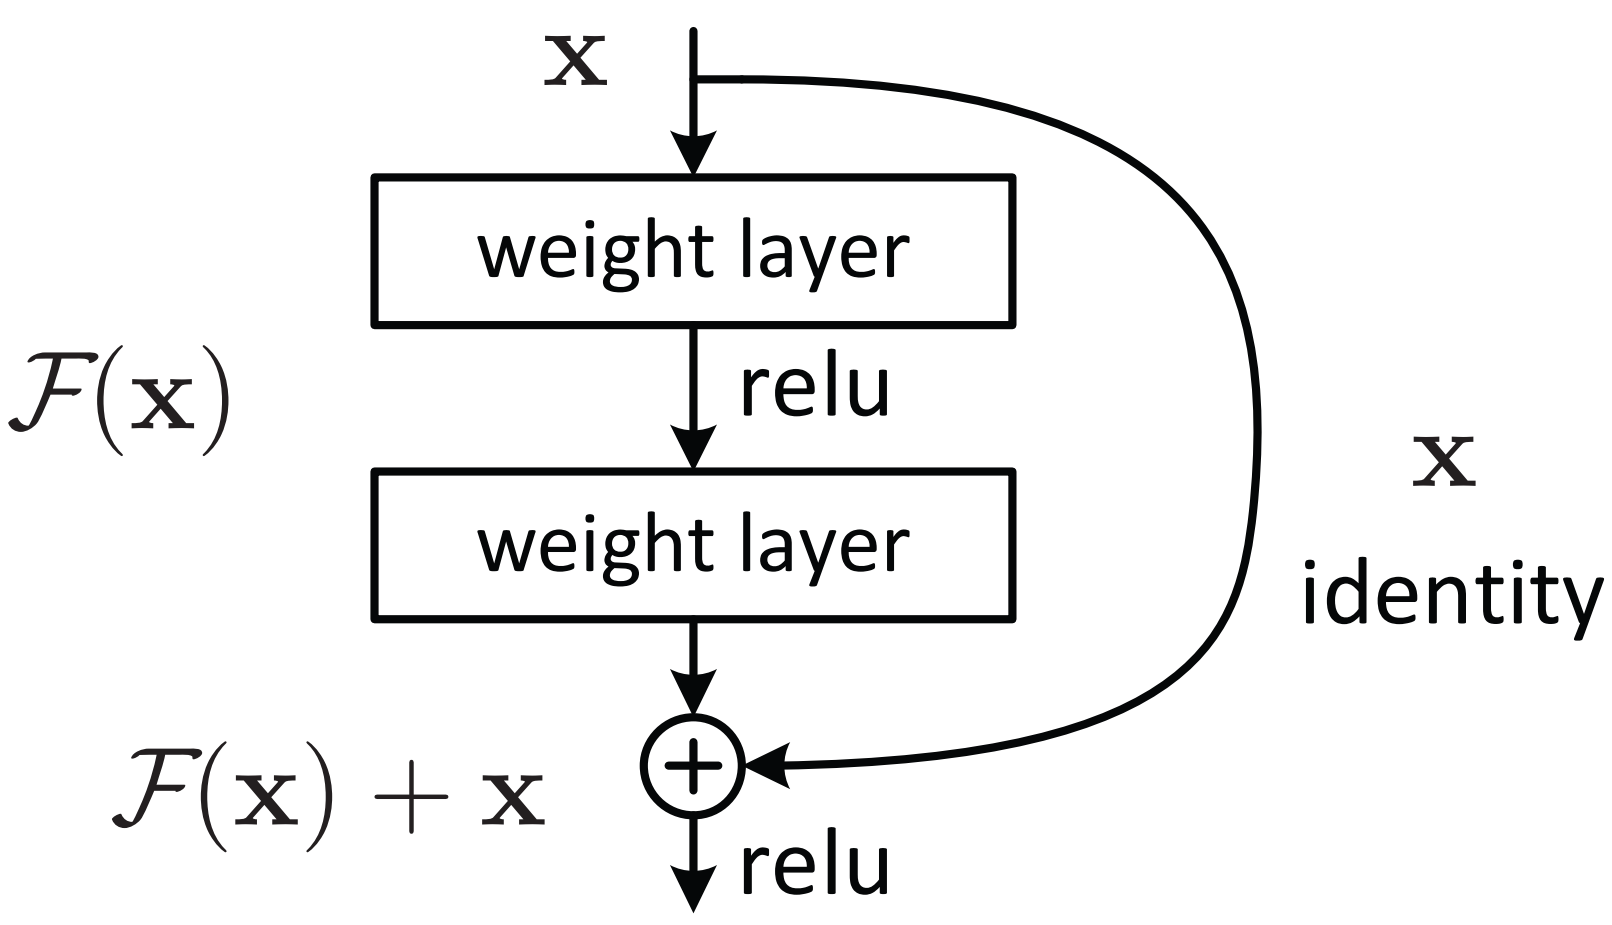
残差结构可以简单表示为:
输出 = F(X) + X
这里要求参与相加的特征矩阵形状一致。这样的结构可以帮助深层网络更容易进行训练。
七、总结
通过这一章的学习,可以把 CNN 的知识串成一条完整的路线:
图像数据 → 卷积提取特征 → 池化压缩信息 → 全连接完成分类 → 数据增强提高泛化能力 → 学习率调整改善训练 → 迁移学习复用已有模型 → ResNet 解决深层网络训练问题。
CNN 不只是几个网络层简单地堆叠,而是一套针对图像数据特点设计的特征提取和分类方法。卷积层负责发现局部特征,池化层负责压缩和保留重要信息,全连接层负责最终分类;当任务更加复杂时,又可以通过数据增强、学习率调整、迁移学习以及 ResNet 等方法进一步提升模型的训练效果。
这次学习也让我对 PyTorch 中的数据集、DataLoader、CNN 模型、训练过程以及预训练模型有了更加完整的认识,为后续进行实际的图像分类项目打下基础。