PyTorch 安装与验证
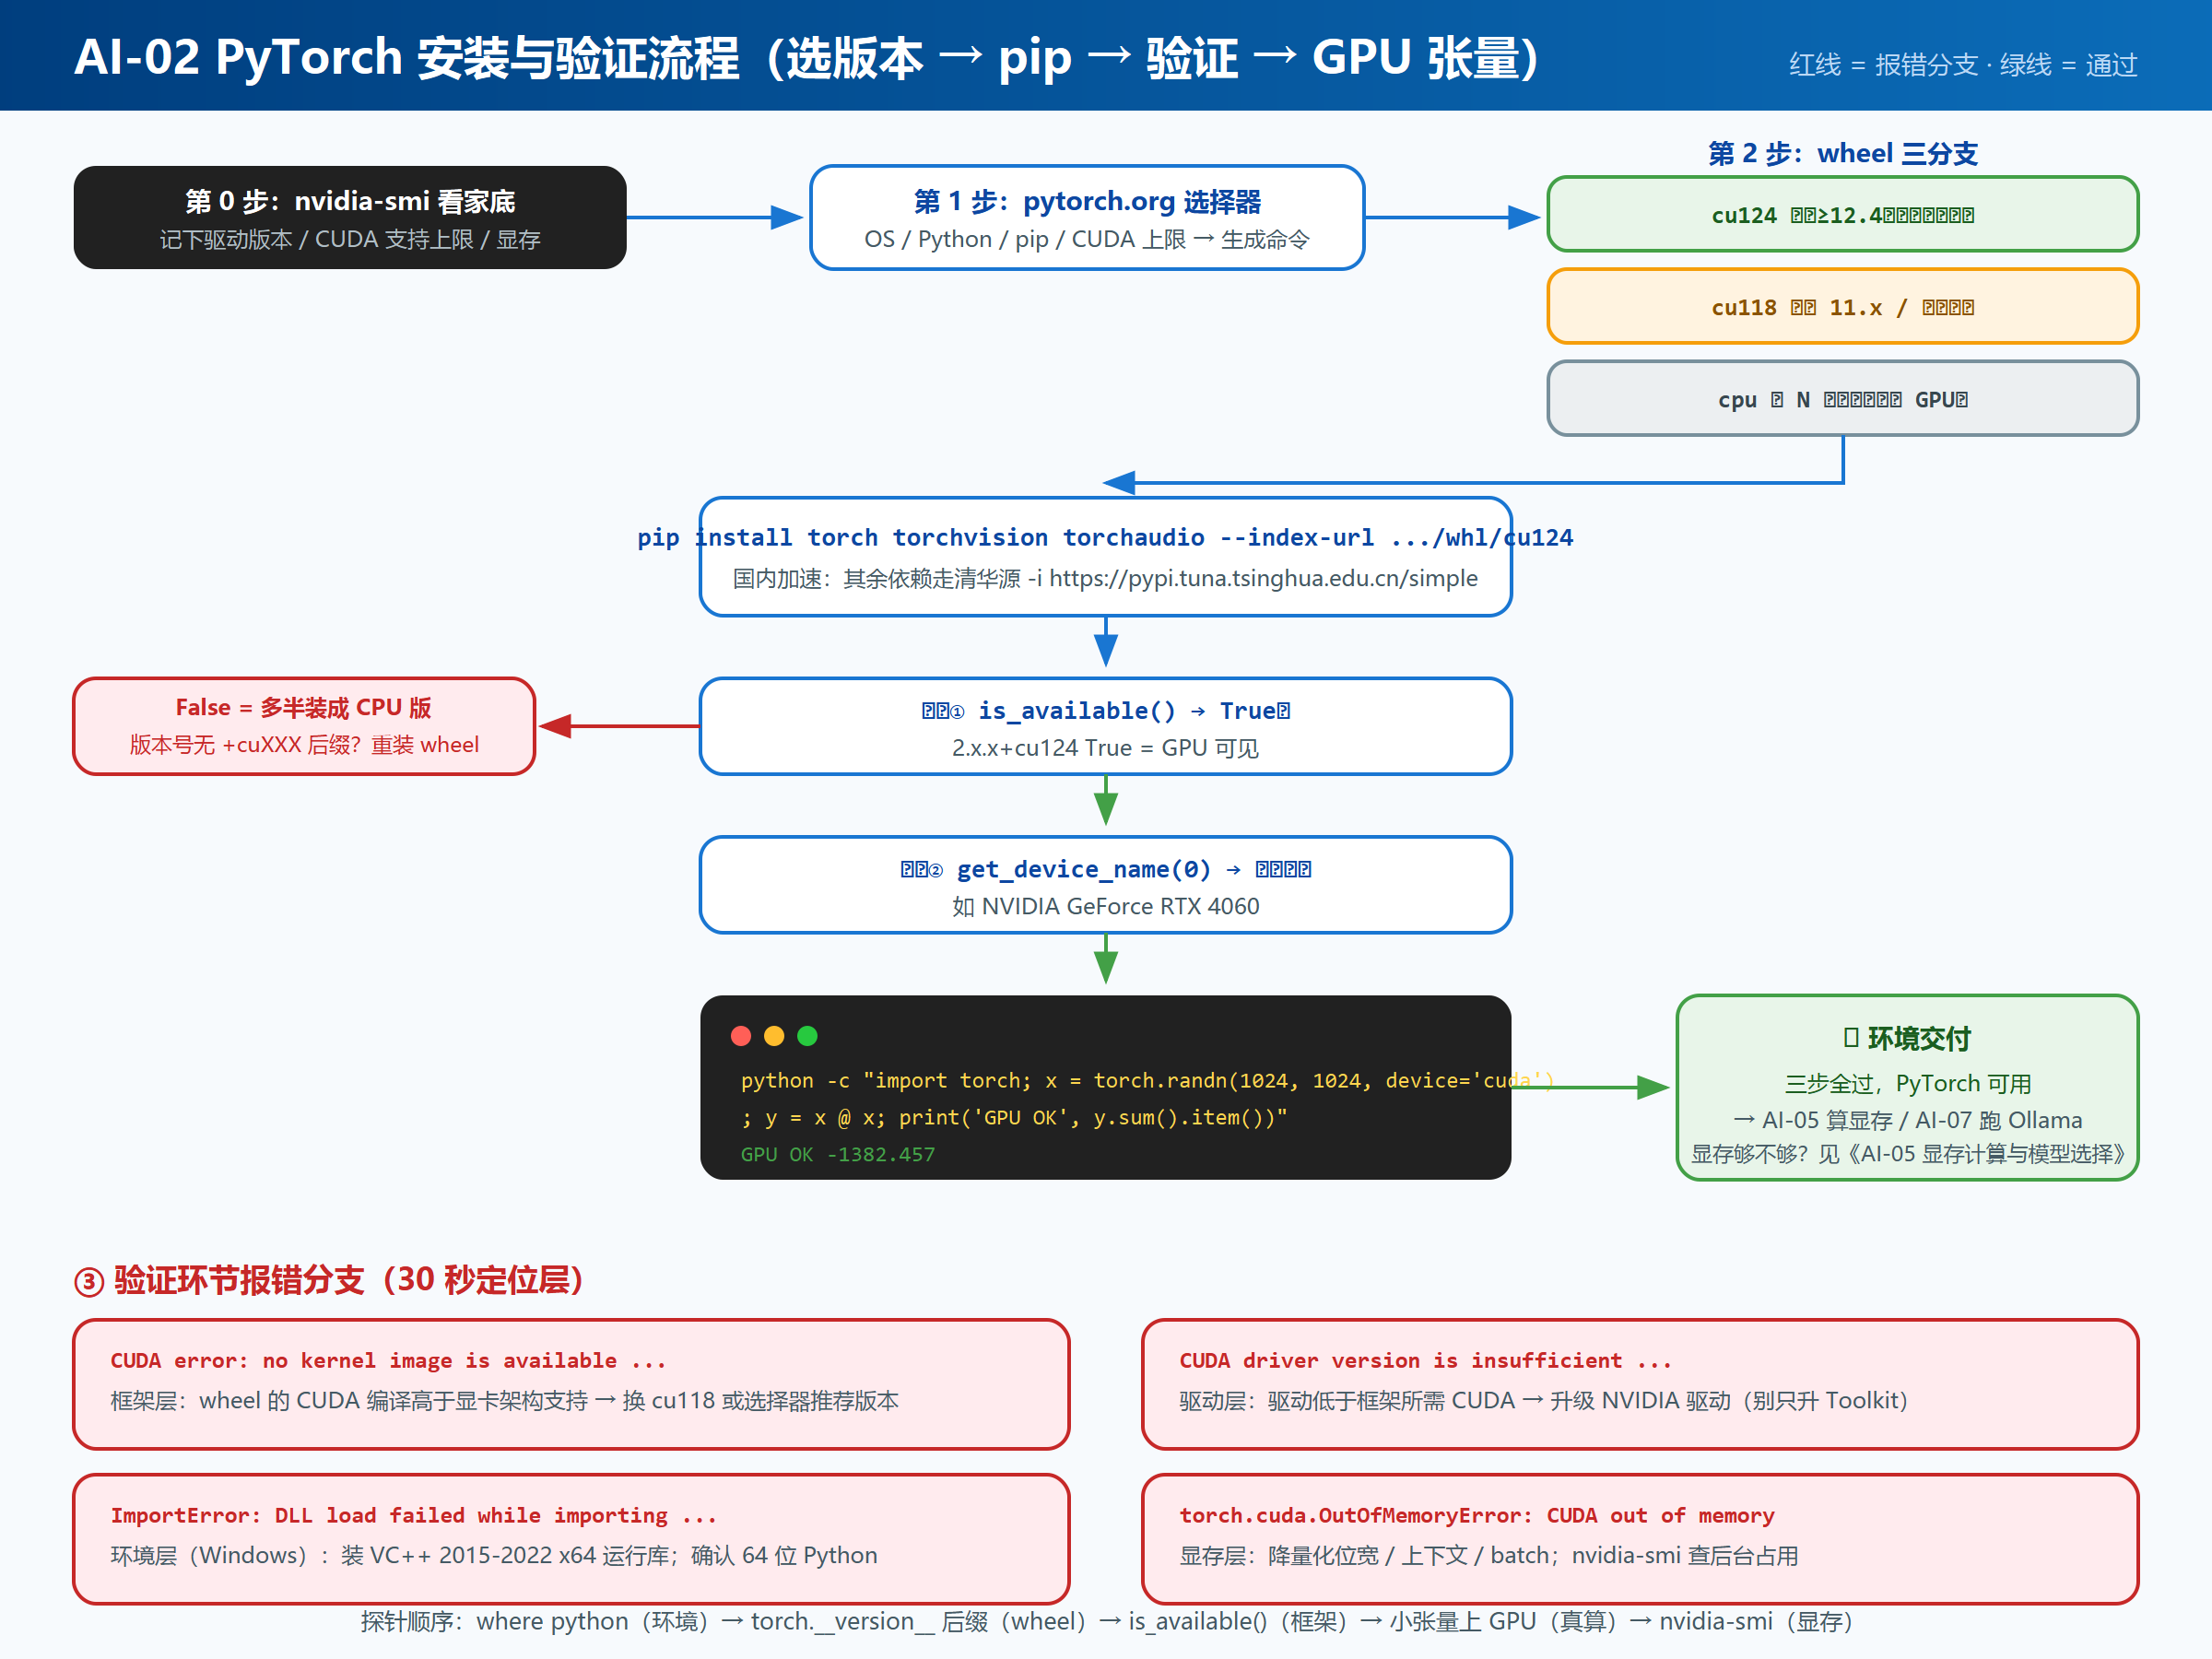
系列第 2 篇。上一篇 GPU 底座打完,本篇装本地 AI 的核心框架 PyTorch。重点解决四个问题:去 pytorch.org 选择器怎么选 pip 命令;cu124 / cu118 / cpu 三种 wheel 怎么选;国内怎么加速;装完用哪三步验证"真的上卡了"。读完你能装出一个
torch.cuda.is_available()返回True的环境,并避开 32 位 Python、CPU 版装成默认这两类最阴的坑。
一、为什么需要它
PyTorch 是本地 AI 的事实标准底座:跑大模型推理、微调、图像生成(Stable Diffusion 全家桶)、Whisper 语音识别,底层几乎都是它。本篇的"验证三步"会成为后面 28 篇的公共检查点------以后任何一篇报 GPU 相关的错,第一反应都是回到这三步查环境。
装 PyTorch 的坑不在命令本身(一条 pip 的事),而在选版本:pytorch.org 的选择器会按操作系统、语言、包管理器和 CUDA 版本四个条件生成一条完整命令,四个条件里任何一个选错,装出来的东西就和预期不一致。
第二层坑在 wheel 。同一份 PyTorch 会按不同 CUDA 版本编译出不同安装包:cu124 版带 CUDA 12.4 运行时,cu118 版带 11.8,cpu 版干脆不带。选错组合的典型症状是 torch.cuda.is_available() 返回 False,或者驱动太老时报 CUDA driver version is insufficient for CUDA runtime version。这两个报错的修法方向完全相反,本篇后面会拆开讲。
第二个高频坑是装成 CPU 版而不自知 :很多教程里的 pip install torch 默认拉的是 CPU 版(或按本机环境推了 cpu wheel),装完 import 成功、跑 CPU 推理也没报错,唯独 GPU 一点不上。所以本篇把"验证"写成和"安装"同等重要的部分,而且验证不止看 is_available(),还要真把一张量扔到 GPU 上算一遍。
第三个坑更隐蔽:教程里的命令本身可能过时。PyTorch 的版本组合几个月就迭代一轮,一年前文章里的命令,照着敲可能拉到已经下架的 cuXXX 变体,或者一个和现有驱动不搭的旧版本。这就是本篇第一步坚持"去官网选择器生成命令"、而不是直接甩一条让你复制的原因------命令本身不值钱,能随时生成最新正确命令才值钱。
前置条件:驱动已装好(nvidia-smi 能出表,记下了驱动版本和 CUDA 支持上限)。如果还没装,先回《AI-01 CUDA 与 N 卡驱动安装》。本篇全程在虚拟环境里操作,不碰全局环境------这条纪律比任何一条安装命令都重要,它决定了你以后会不会在"明明装过 torch 却找不到"这种问题上反复消耗时间。
二、环境要求
| 项目 | 要求 | 说明 |
|---|---|---|
| NVIDIA 驱动 | nvidia-smi 能出表(建议 550 系及以上) |
驱动约 550 支持 CUDA 12.4、555 支持 12.5、560 支持 12.6+,以官网兼容性表为准 |
| Python | 3.10 / 3.11 / 3.12(保守选 3.11),必须 64 位 | 32 位 Python 装不了 GPU 版 PyTorch,也装不上 VC 运行库 x64 |
| 虚拟环境 | venv 或 conda,一个项目一个环境 | 创建与激活命令详见《AI-03 Python 环境与虚拟环境》 |
| 磁盘 | 建议预留 5 GB 以上 | torch 本体重,加上依赖(CUDA 运行时捆绑在里面)不小 |
| 网络 | 能访问 PyPI 或清华镜像 | wheel 从 download.pytorch.org 官方源拉,国内可用清华源装其余依赖 |
| Windows 附加 | VC++ 2015-2022 Redistributable(x64) | 缺失时报 DLL load failed,见故障排查 |
Python 版本这里强调两点。其一,必须是 64 位:32 位 Python 拿到的只能是不带 GPU 支持的包,且 Windows 下 32 位环境装 VC 运行库 x64 也对不上。其二,3.11 是当前兼容性最稳的选择,3.13 的新生态还有兼容风险,不建议拿它当第一环境。
三、安装与部署
3.1 第一步:pytorch.org 选择器选 pip 命令
不要手抄任何教程里的安装命令------PyTorch 的 wheel 组合迭代快,唯一可靠的命令生成器是官网 Get Started 页面(pytorch.org)。进去后按四栏选:
- 操作系统:Windows 或 Linux(WSL2 里选 Linux,别选 Windows);
- 语言 :Python(本篇主线;选 Conda 的话命令是
conda install形式,同样以页面生成结果为准); - 包管理器:pip;
- CUDA 版本 :这里对照
nvidia-smi右上角的支持上限选(如 12.4 就选 12.4;上限只有 11.x 就选 11.8)。上限够新却选了偏旧的 wheel 也能跑,只是放弃了一部分新特性;上限不够却硬选新的,就是后面故障排查里那条 insufficient 报错。
页面生成的命令长这样(cu124 为例):
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu1243.2 cu124 / cu118 / cpu 三种 wheel 怎么选
选择原则一条:PyTorch 编译所用的 CUDA 版本 ≤ 驱动支持的 CUDA 版本(这是"上限原则",不是"必须相等")。
-
cu124(CUDA 12.4 运行时):nvidia-smi 支持上限 ≥ 12.4 时的默认选择,绝大多数 2023 年后的卡 + 新驱动都落在这个区间;
-
cu118 (CUDA 11.8 运行时):驱动上限只有 11.x(老驱动、老卡)时用它。老架构显卡(如 Maxwell、Pascal 这一代)对 cu118 的覆盖比更新版本更好,太新的 CUDA 编译在老架构上会直接报
CUDA error: no kernel image is available for execution on the device; -
cpu:没有 N 卡、或显存/驱动实在没戏时的兜底。cpu 版体积小、装得快,验证代码逻辑和跑小模型够用,但 GPU 相关功能全部缺失,命令:
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cpu
怎么选不纠结:先 nvidia-smi 看支持上限,再用 pytorch.org 选择器按上限选------选择器给出的就是"当前 PyTorch 版本下"与你的驱动最匹配的组合,以它为准。
3.3 国内加速方案
两个层面分开处理:
wheel 本身 从官方源 download.pytorch.org 拉,这个源国内直连通常可用但不快,慢就换时段。多说一句:torch 的 wheel 带捆绑的 CUDA 运行时,单个包就有好几 GB,别把它指到不熟的第三方镜像------体积大、校验麻烦,来路不明的源比"慢"更坑。
其余依赖一律走清华源,速度快一个量级:
pip install <pkg> -i https://pypi.tuna.tsinghua.edu.cn/simple阿里源可作备份:-i https://mirrors.aliyun.com/pypi/simple。
后续下载模型才是真正的大流量场景,届时用 hf-mirror 或 ModelScope:
set HF_ENDPOINT=https://hf-mirror.com(Linux 下用 export HF_ENDPOINT=https://hf-mirror.com),或 pip install modelscope 后走 ModelScope 下载,完整方案详见《AI-06 模型下载全攻略》。
3.4 执行安装
确认虚拟环境已激活(python -c "import sys; print(sys.executable)" 打印的路径指向你的 .venv/conda 环境),然后跑 3.1 生成的命令。安装过程会显示一个个 Collecting / Downloading,torch 本体加捆绑的 CUDA 运行时加起来好几 GB,耐心等。出现 Successfully installed torch-2.x.x+cu124 ... 即成功------注意看版本号里的 +cu124 后缀,这是它装成了 GPU 版的第一证据 。如果发现装出来的是 torch-2.x.x 或 +cpu 而没有 +cuXXX,说明安装命令没带对 --index-url,先卸载再重装,别在错误版本上继续搭后面的东西。
四、验证
三步,逐层确认,分别回答三个问题:框架看不看得到卡、认不认得出卡是什么、真算算得动吗。任何一步单过都不算数------is_available() 为 True 但小张量算不动,说明中间某层(驱动架构、wheel 组合)还有问题;只做到前两步就收工,是最常见的"假成功",往往到后面跑模型时才爆出来,排查时间翻几倍。
第一步,确认 GPU 可见(框架层探针):
python -c "import torch; print(torch.__version__, torch.cuda.is_available())"期望输出:2.x.x+cu124 True。返回 False 直接跳"六、故障排查"第一条。
第二步,看 PyTorch 自己认到几张卡、什么卡:
python -c "import torch; print(torch.cuda.device_count()); print(torch.cuda.get_device_name(0))"期望:张数 ≥ 1,设备名是你的显卡型号(如 NVIDIA GeForce RTX 4060)。
第三步,真把一张量扔到 GPU 上算------这步治"能 import、is_available 为 True、实际算不动"的隐性故障:
python -c "import torch; x = torch.randn(1024, 1024, device='cuda'); y = x @ x; print('GPU OK', y.sum().item())"期望:打印 GPU OK 加一个数字,且几秒内返回。报 no kernel image 是 wheel 与卡架构不匹配;报 OutOfMemoryError 才说明显存层有问题(1024×1024 的 float32 矩阵才 4 MB,这一步 OOM 基本是别的进程把显存占满了,nvidia-smi 查占用)。
三步全过,PyTorch 环境即交付。我个人的习惯是把第三步的小张量存成一个 check_gpu.py,以后每换一个环境先跑它,30 秒定位环境层问题。
五、进阶技巧
多版本共存怎么避免 :一个项目一个虚拟环境,环境名直接带用途(llama、diffusion)。同一台机器要跑不同 torch 版本时,venv 或 conda(conda create -n ai python=3.11 -y)天然隔离,互相不污染。千万别在一个全局环境里反复 pip install torch==2.0.1、torch==2.2.0 来回折腾------残留的 CUDA 库和 PATH 污染是 Windows 上 Error 126: Unknown error 的头号来源。
验证 torch 用的 CUDA 版本 :python -c "import torch; print(torch.version.cuda)",对照 nvidia-smi 的 CUDA 支持上限,前者必须 ≤ 后者。这条命令在排查"驱动够不够"时是框架层的第二探针。看到版本号是 +cu126 而 nvidia-smi 只给到 12.4,问题只是还没爆发,跑 GPU 操作时必现------升驱动或降 wheel 二选一,别拖。
装前先看上限再选 wheel:nvidia-smi 只支持到 11.8、而选择器里一堆 12.x,不代表卡不行,只是驱动老。先升驱动再看上限,然后做选择。升驱动是一次性动作,降到旧 wheel 跑旧运行时则是一笔长期债。
WSL2 用户 :WSL 里直接按 Linux 流程装,不需要在 WSL 内装 NVIDIA 驱动------Windows 侧驱动透传即可,装完 nvidia-smi 在 WSL 内也能跑,详见《AI-04 WSL2 部署 AI 开发环境》。
显存预算先算账:装完框架别急着拉大模型,先按"参数量 × 每参数字节数"估算你的卡装得下什么(7B fp16 约 14-15 GB,Q4 量化约 4-5 GB,再加 10-20% 开销),详见《AI-05 显存计算与模型选择》。
六、故障排查
分层定位:网络层 → 驱动层 → 框架层 → 显存层 → 应用层。装 PyTorch 的问题 90% 落在框架层和环境依赖层。
| 层 | 症状 / 报错原文 | 原因 | 解决 |
|---|---|---|---|
| 【框架】 | torch.cuda.is_available() 返回 False |
PyTorch 装了 CPU 版(默认坑),或驱动过老 | 先 python -c "import torch; print(torch.__version__)" 看版本号后缀:没有 +cuXXX 就是 CPU 版,重装对应 cuXXX wheel(带 --index-url 那条);后缀正常则升级驱动 |
| 【框架】 | CUDA error: no kernel image is available for execution on the device |
wheel 的 CUDA 编译高于显卡架构支持(新 CUDA + 老卡),或 wheel 与卡不匹配 | 换与显卡架构匹配的 PyTorch wheel:老卡优先试 cu118,以 pytorch.org 选择器为准 |
| 【驱动】 | CUDA driver version is insufficient for CUDA runtime version |
驱动低于框架所需 CUDA(如 cu126 wheel + 550 系驱动) | 升级 NVIDIA 驱动到支持对应 CUDA 的版本(约 550→12.4、555→12.5、560→12.6+);驱动不动就换更低 cuXXX 的 wheel |
| 【环境】 | Windows 下 ImportError: DLL load failed while importing ... |
VC 运行库缺失,或 32/64 位不匹配 | 安装 VC++ 2015-2022 Redistributable x64 ;python -c "import struct; print(struct.calcsize('P')*8)" 确认是 64 位 Python,32 位重装 64 位 |
| 【环境】 | ModuleNotFoundError: No module named 'torch' |
激活了错误环境 / 全局与 venv 装串了 | where python(Windows)/ which python(Linux)确认解释器路径,重新激活装过 torch 的那个环境 |
| 【环境】 | Error 126: Unknown error / 加载 .dll 失败(libcudart.so.12 not found 类) |
多版本 CUDA 混装、PATH 污染 | 清理环境变量;用 conda/venv 隔离重装;dumpbin/ldd 看缺的具体是哪个库 |
| 【网络】 | pip 拉 wheel 卡住 / 超时 | 直连官方源慢或抖动 | 换网络时段重试;其余依赖走清华源 -i https://pypi.tuna.tsinghua.edu.cn/simple;下载模型用 HF_ENDPOINT=https://hf-mirror.com 或 ModelScope |
| 【显存】 | torch.cuda.OutOfMemoryError: CUDA out of memory. Tried to allocate ... |
模型 / 上下文 / 批太大,或后台进程占满显存 | 降量化位宽、降 max-model-len / batch;nvidia-smi 查占用进程并清掉;模型能跑多大的预算见《AI-05 显存计算与模型选择》 |
| 【驱动】 | Linux 下 Could not load libcuda.so.1 |
用户态驱动未装好,或容器未透传 | 装/重装 NVIDIA 驱动;Docker 加 --gpus all |
30 秒探针顺序:where python(环境对不对)→ torch.__version__ 后缀(wheel 对不对)→ torch.cuda.is_available()(框架认不认卡)→ 小张量上 GPU(真算得动吗)→ nvidia-smi(显存谁占了)。从上往下,一步一个结论。
七、本篇自检清单
- 会用 pytorch.org 选择器生成 pip 命令,没手抄过时命令
- 能解释 cu124 / cu118 / cpu 三种 wheel 的适用场景(上限原则)
- 安装成功,
torch.__version__带+cuXXX后缀 - 验证三步全过:
is_available()为True、get_device_name(0)报出卡名、小张量上 GPU 返回GPU OK - 知道 32 位 Python / VC 运行库缺失各自对应的报错长什么样
- 多项目用虚拟环境隔离,全局环境不装 torch
参考
- PyTorch 官网 Get Started(安装命令生成器):https://pytorch.org/get-started/locally/
- PyTorch 官方文档(CUDA 支持说明):https://docs.pytorch.org/docs/stable/notes/cuda.html
- 清华 PyPI 镜像:https://pypi.tuna.tsinghua.edu.cn
- HuggingFace 国内镜像:https://hf-mirror.com