PPO代码实战:PyTorch实现
-
- 前言
- 一、环境介绍
-
- [1.1 CartPole-v1 环境](#1.1 CartPole-v1 环境)
- [1.2 依赖安装](#1.2 依赖安装)
- 二、PPO整体架构回顾
- 三、完整代码实现
-
- [3.1 第一步:定义Actor-Critic网络](#3.1 第一步:定义Actor-Critic网络)
- [3.2 第二步:定义PPO Agent](#3.2 第二步:定义PPO Agent)
- [3.3 第三步:训练主循环](#3.3 第三步:训练主循环)
- 四、Clip机制可视化
- 五、GAE与偏差方差权衡
- 六、训练结果与调参建议
-
- [6.1 预期训练效果](#6.1 预期训练效果)
- [6.2 常见问题与调参](#6.2 常见问题与调参)
- 总结
前言
前面两篇文章我们详细讲解了PPO算法的原理,从策略梯度到TRPO,再到PPO的Clip机制。光说不练假把式,本篇我们就用PyTorch从零实现一个完整的PPO算法,在经典的CartPole平衡杆环境上跑通训练流程。
这篇文章适合已经了解PPO基本原理,想动手写代码实践的同学。我们会实现一个最精简但完整可用的PPO,不依赖任何深度强化学习库,只用到PyTorch和Gymnasium。
一、环境介绍
1.1 CartPole-v1 环境
CartPole是强化学习入门最经典的环境之一:
- 状态空间:4维连续向量(小车位置、小车速度、杆子角度、杆子角速度)
- 动作空间:2个离散动作(小车向左推、向右推)
- 奖励:每坚持一步得1分,杆子倒了或小车出界就结束
- 目标:尽可能长时间保持杆子竖立,满分500分
这个环境简单但足够展示PPO的完整流程,非常适合入门实战。
1.2 依赖安装
bash
pip install torch gymnasium numpy matplotlib二、PPO整体架构回顾
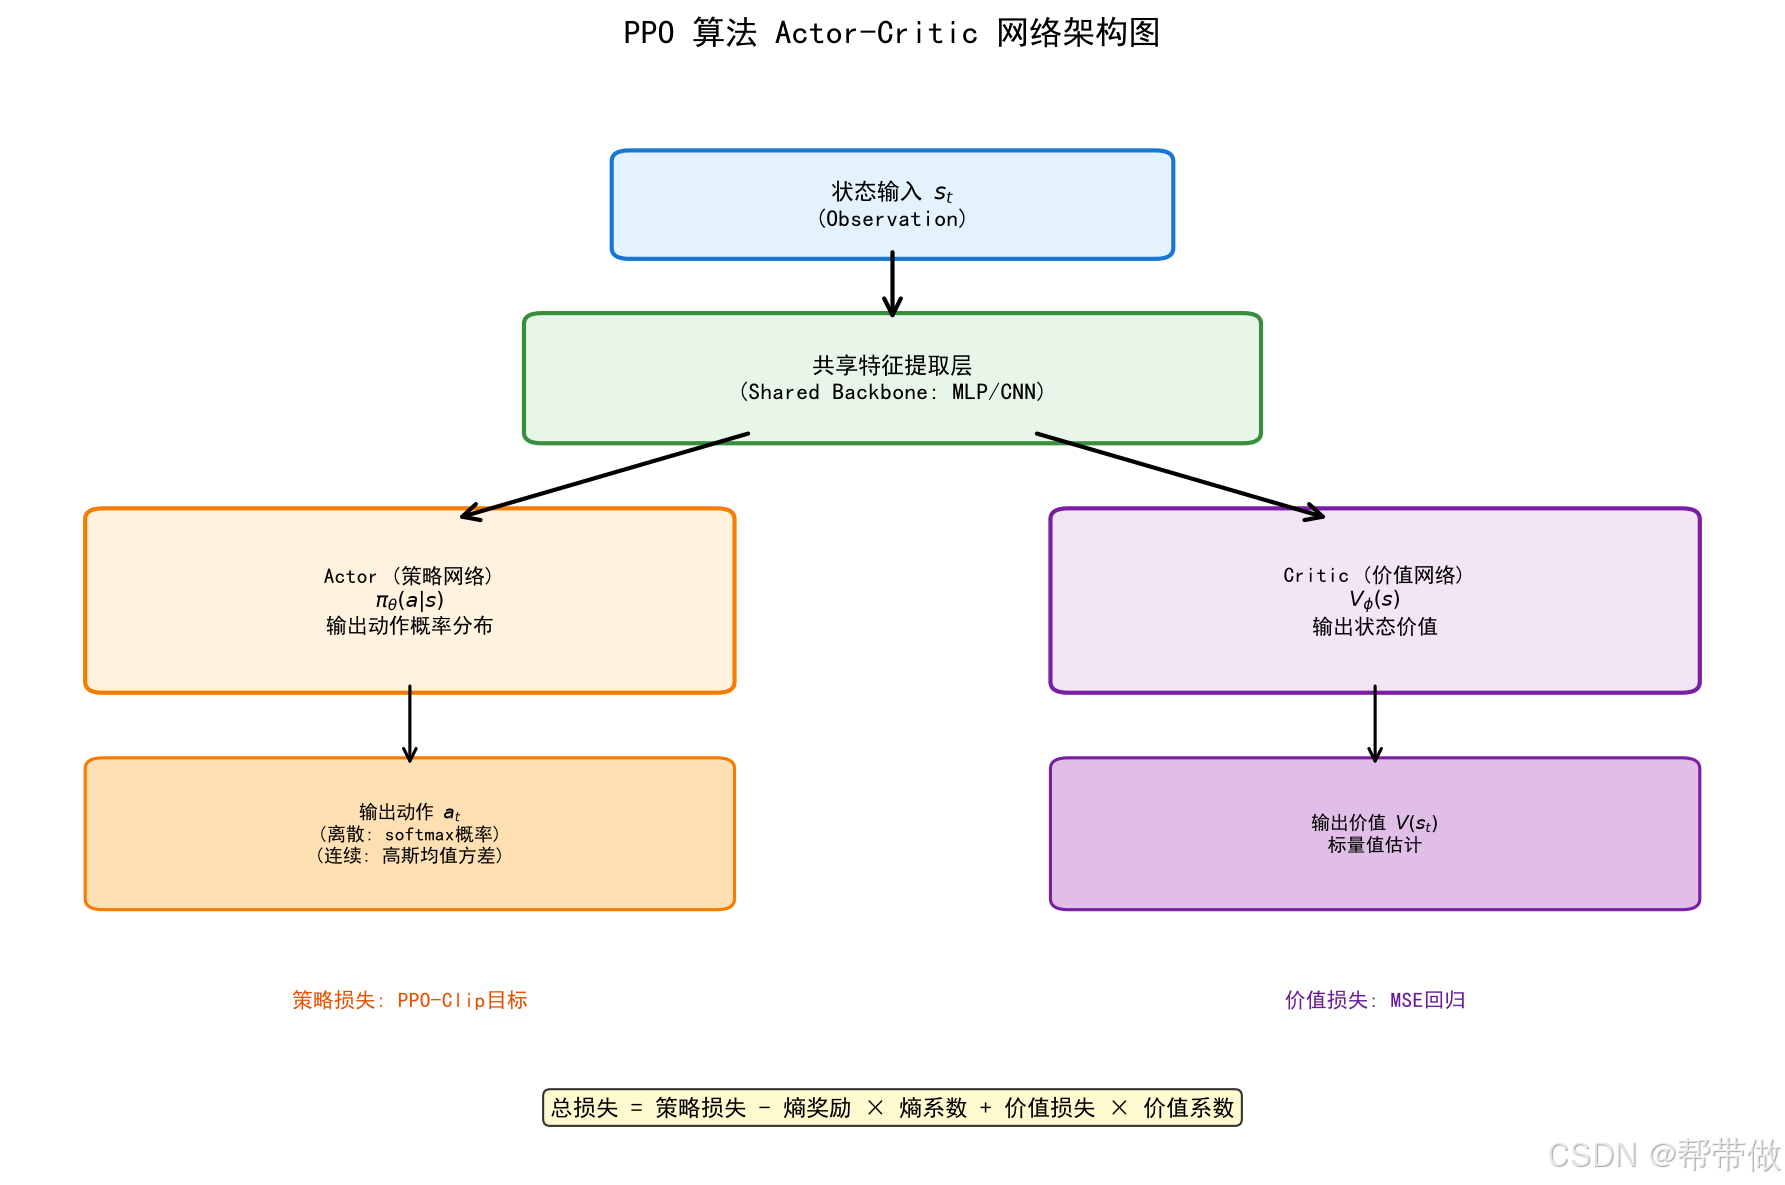
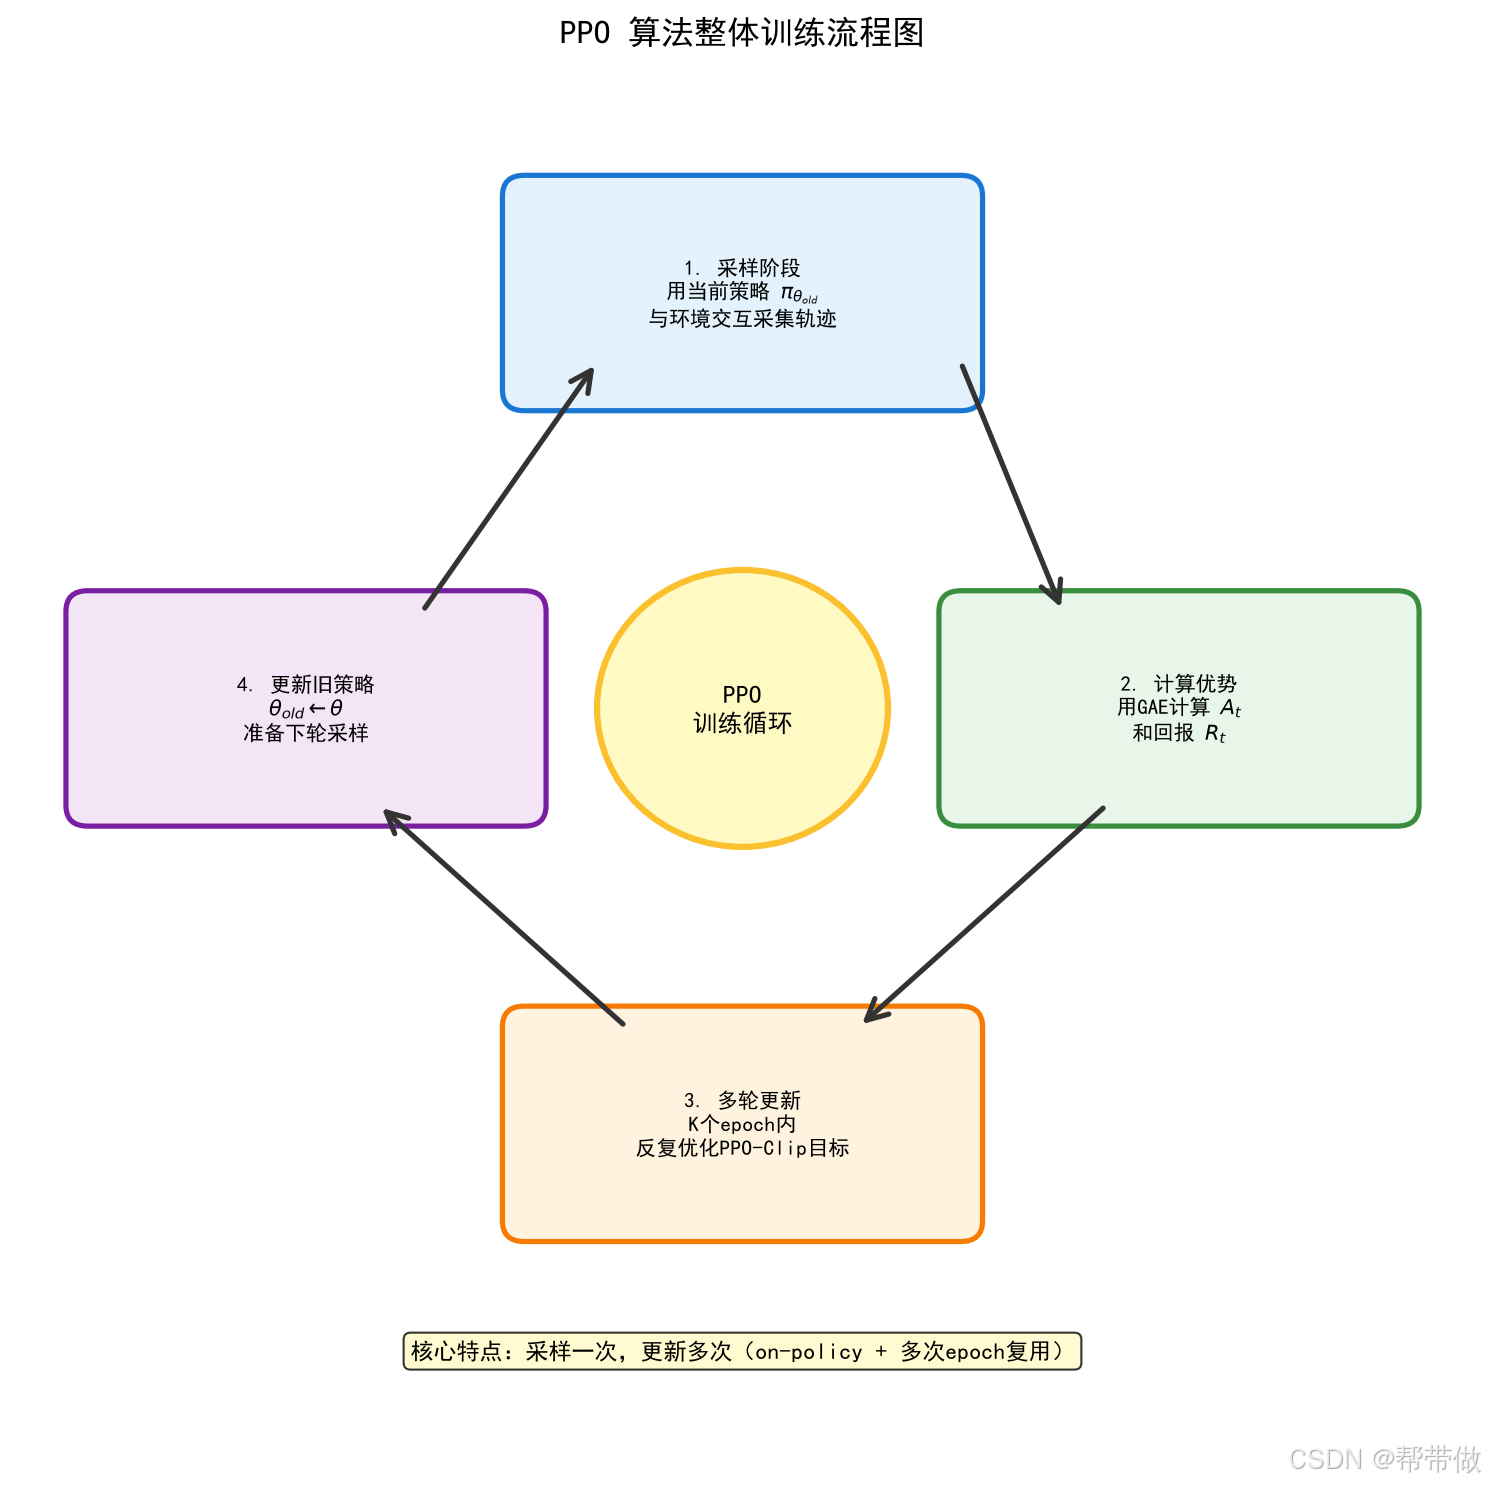
在写代码之前,我们先回顾一下PPO的Actor-Critic架构:
整个PPO训练流程是一个循环:采样 → 计算优势 → 多轮更新 → 更新旧策略 → 再采样。

三、完整代码实现
3.1 第一步:定义Actor-Critic网络
python
import torch
import torch.nn as nn
import torch.optim as optim
from torch.distributions import Categorical
import gymnasium as gym
import numpy as np
from collections import deque

class ActorCritic(nn.Module):
    def __init__(self, state_dim, action_dim, hidden_dim=128):
        super(ActorCritic, self).__init__()

        # Actor 策略网络:输出动作概率分布
        self.actor = nn.Sequential(
            nn.Linear(state_dim, hidden_dim),
            nn.ReLU(),
            nn.Linear(hidden_dim, hidden_dim),
            nn.ReLU(),
            nn.Linear(hidden_dim, action_dim),
            nn.Softmax(dim=-1)
        )

        # Critic 价值网络:输出状态价值 V(s)
        self.critic = nn.Sequential(
            nn.Linear(state_dim, hidden_dim),
            nn.ReLU(),
            nn.Linear(hidden_dim, hidden_dim),
            nn.ReLU(),
            nn.Linear(hidden_dim, 1)
        )

    def forward(self, state):
        # 前向传播,同时输出动作概率和状态价值
        action_probs = self.actor(state)
        state_value = self.critic(state)
        return action_probs, state_value

    def get_action(self, state):
        # 根据状态采样动作
        state = torch.FloatTensor(state).unsqueeze(0)
        action_probs, state_value = self.forward(state)

        dist = Categorical(action_probs)
        action = dist.sample()

        return action.item(), dist.log_prob(action), state_value.item()
代码讲解:
- Actor网络输出softmax概率,对应每个动作的选择概率
- Critic网络输出一个标量,即该状态的价值估计
get_action()用于与环境交互时采样动作,同时返回log_prob和价值,供后续训练使用
3.2 第二步:定义PPO Agent
python
class PPOAgent:
    def __init__(
        self,
        state_dim,
        action_dim,
        lr=3e-4,
        gamma=0.99,
        eps_clip=0.2,
        K_epochs=4,
        entropy_coef=0.01,
        value_coef=0.5,
    ):
        self.gamma = gamma
        self.eps_clip = eps_clip
        self.K_epochs = K_epochs
        self.entropy_coef = entropy_coef
        self.value_coef = value_coef

        # 当前网络和旧网络
        self.policy = ActorCritic(state_dim, action_dim)
        self.policy_old = ActorCritic(state_dim, action_dim)
        self.policy_old.load_state_dict(self.policy.state_dict())

        self.optimizer = optim.Adam(self.policy.parameters(), lr=lr)
        self.MseLoss = nn.MSELoss()

        # 存储轨迹数据
        self.states = []
        self.actions = []
        self.log_probs = []
        self.rewards = []
        self.dones = []

    def update(self):
        # 计算回报(蒙特卡洛回报)
        rewards = []
        discounted_reward = 0
        for reward, done in zip(reversed(self.rewards), reversed(self.dones)):
            if done:
                discounted_reward = 0
            discounted_reward = reward + self.gamma * discounted_reward
            rewards.insert(0, discounted_reward)

        # 归一化回报
        rewards = torch.FloatTensor(rewards)
        rewards = (rewards - rewards.mean()) / (rewards.std() + 1e-8)

        # 转换为tensor
        old_states = torch.FloatTensor(self.states)
        old_actions = torch.LongTensor(self.actions)
        old_log_probs = torch.FloatTensor(self.log_probs)

        # 多轮更新(PPO的核心!)
        for _ in range(self.K_epochs):
            # 前向计算
            action_probs, state_values = self.policy(old_states)
            dist = Categorical(action_probs)

            # 新的log prob
            new_log_probs = dist.log_prob(old_actions)
            state_values = state_values.squeeze()

            # 计算优势
            advantages = rewards - state_values.detach()

            # 概率比
            ratios = torch.exp(new_log_probs - old_log_probs.detach())

            # PPO Clip目标
            surr1 = ratios * advantages
            surr2 = torch.clamp(ratios, 1 - self.eps_clip, 1 + self.eps_clip) * advantages
            actor_loss = -torch.min(surr1, surr2).mean()

            # Critic损失
            critic_loss = self.MseLoss(state_values, rewards)

            # 熵奖励(鼓励探索)
            entropy = dist.entropy().mean()

            # 总损失
            total_loss = actor_loss + self.value_coef * critic_loss - self.entropy_coef * entropy

            # 反向传播
            self.optimizer.zero_grad()
            total_loss.backward()
            self.optimizer.step()

        # 更新旧网络
        self.policy_old.load_state_dict(self.policy.state_dict())

        # 清空轨迹
        self.clear_buffer()

    def clear_buffer(self):
        self.states = []
        self.actions = []
        self.log_probs = []
        self.rewards = []
        self.dones = []
核心代码讲解:
-
概率比计算 :
ratios = torch.exp(new_log_probs - old_log_probs),因为log概率相减再exp就是概率比 -
PPO-Clip核心:
pythonsurr1 = ratios * advantages surr2 = torch.clamp(ratios, 1 - eps_clip, 1 + eps_clip) * advantages actor_loss = -torch.min(surr1, surr2).mean()这就是我们上一篇讲的Clip机制的代码实现!
-
多轮更新 :
for _ in range(K_epochs),同一批数据重复训练K次,这是PPO样本效率高的关键。
3.3 第三步:训练主循环
python
def train():
    env = gym.make('CartPole-v1')
    state_dim = env.observation_space.shape[0]
    action_dim = env.action_space.n

    agent = PPOAgent(state_dim, action_dim)

    max_episodes = 500
    max_timesteps = 500
    update_timestep = 2000  # 每多少步更新一次

    timestep = 0
    reward_history = deque(maxlen=20)

    for episode in range(max_episodes):
        state, _ = env.reset()
        ep_reward = 0

        for t in range(max_timesteps):
            timestep += 1

            # 用旧策略采样动作
            action, log_prob, state_value = agent.policy_old.get_action(state)

            # 与环境交互
            next_state, reward, done, truncated, _ = env.step(action)
            done = done or truncated

            # 存入轨迹buffer
            agent.states.append(state)
            agent.actions.append(action)
            agent.log_probs.append(log_prob)
            agent.rewards.append(reward)
            agent.dones.append(done)

            state = next_state
            ep_reward += reward

            # 达到更新步数就更新
            if timestep % update_timestep == 0:
                agent.update()

            if done:
                break

        reward_history.append(ep_reward)
        avg_reward = np.mean(reward_history)

        if episode % 10 == 0:
            print(f"Episode {episode}, 奖励: {ep_reward:.1f}, 平均奖励(近20轮): {avg_reward:.1f}")

        # 提前结束:连续10轮平均奖励超过480就收敛了
        if avg_reward > 480 and len(reward_history) >= 10:
            print(f"训练完成!Episode {episode}, 平均奖励: {avg_reward:.1f}")
            break

    env.close()

if __name__ == "__main__":
    train()
四、Clip机制可视化
我们在上一篇原理篇中详细讲了PPO的Clip机制,下面这张图直观展示了裁剪的效果:
从图中可以看到:
- 当优势为正时,概率比超过 1 + ϵ 1+\epsilon 1+ϵ 后目标函数不再上升,梯度为0
- 当优势为负时,概率比低于 1 − ϵ 1-\epsilon 1−ϵ 后目标函数不再变化,梯度为0
- 这种机制自动限制了策略更新的幅度,保证训练稳定
五、GAE与偏差方差权衡
本教程为了简洁,使用的是蒙特卡洛回报作为优势估计的基础。在更复杂的任务中,通常会使用GAE(广义优势估计)来平衡偏差和方差:
- λ = 0 \lambda=0 λ=0 是单步TD估计,低偏差高方差
- λ = 1 \lambda=1 λ=1 是蒙特卡洛估计,高偏差低方差
- 常用值 λ = 0.95 \lambda=0.95 λ=0.95,在两者之间取得平衡
六、训练结果与调参建议
6.1 预期训练效果
在CartPole-v1环境上,PPO通常在100-200个episode左右就能收敛到接近满分(500分)。
6.2 常见问题与调参
训练不收敛?
- 检查学习率是不是太大(试试1e-4)
- 增大update_timestep,让每批数据更多
- 增大K_epochs到10
奖励波动大?
- 对优势做归一化(代码里已经做了回报归一化)
- 增大batch size
- 减小clip epsilon到0.1
探索不足,很快收敛到局部最优?
- 增大entropy_coef到0.02
- 检查网络容量是不是太小
总结
本篇我们用PyTorch从零实现了一个完整的PPO算法:
- Actor-Critic双网络架构:Actor输出动作概率,Critic输出状态价值
- PPO-Clip目标函数:通过裁剪概率比来限制策略更新幅度
- 多轮epoch复用数据:采样一次,训练K次,提升样本效率
- 熵奖励探索机制:鼓励策略保持多样性,避免过早收敛
这个精简版PPO虽然代码量不大,但包含了PPO算法的全部核心要素。理解了这份代码,再去看Stable Baselines3等成熟库的实现,就会轻松很多。
下一篇预告:PPO算法进阶(四):连续动作空间与MuJoCo机器人控制实战,我们将把PPO从离散动作空间扩展到连续动作空间,并在MuJoCo环境上进行训练。