ACM MM 2026|ConFusion:连续融合空间实现实例级细粒度可控融合
- 一句话总结
针对可控红外-可见光图像融合(Infrared and Visible Image Fusion,IVIF)中离散条件难以表达细微意图的问题,ConFusion 通过高斯条件空间调制 学习连续融合空间,兼顾融合质量、实例级控制与目标检测。
- 论文信息
-
题目: ConFusion: Continuous Fusion Space Learning for Fine-Grained Controllable Infrared and Visible Image Fusion|ConFusion:面向细粒度可控红外-可见光图像融合的连续融合空间学习
-
发表: ACM MM 2026
-
作者: Yurong Guo¹、Yufei He¹、Yonghao Li¹、Dongliang Chang²、Ke Zhang¹*、Zhanyu Ma²
-
单位: ¹华北电力大学;²北京邮电大学
-
代码:
-
下载:
- 论文摘要
目前的方法大多把指令映射为有限个离散条件,不能很好地表示出细微程度上的差别。ConFusion 通过使用连续调制变量 、Grounded SAM 掩模以及文本语义来实现不同的目标可以根据意图单独地进行调节,在三个融合的数据集以及下游检测上都得到了验证。
4、主要创新之处
创新一:连续的空间融合
用高斯分布对实例级别的调制变量进行连续抽样,并且在稠密融合空间里学习来适应微小的变化。
创新二:双分支解耦及语义对齐
利用自重建、交叉重建以及文本语义对齐的方法来把模态特有的特征和模态不変的特征区分开来。
创新三:实例级的空间调制和文本增强
Mask-Guided Specific Feature Modulator(MGSM )用于实例空间的调节,Text-Driven Invariant Feature Enhancer(TDIE)利用文本先验来改善跨模态的语义。
- 方法详解
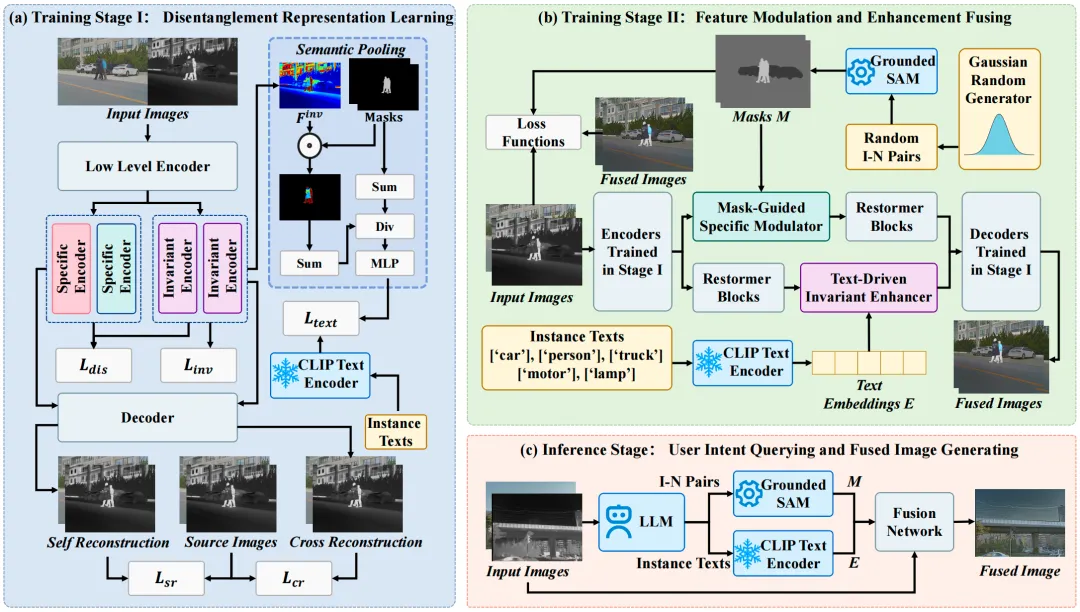
ConFusion 先学会特征解耦与重建,然后做实例调制和增强融合,在推理的时候用到多模态大语言模型来分析意图、Grounded SAM 产生掩模、对比语言-图像预训练给出文本语义。
5.1 问题的界定以及整个体系的大致结构
输入的是红外图像、可见光图像和推理阶段中用户的意图,输出的是融合图像,细粒度的控制是由连续采样产生的实例调制变量所驱动的。
为实例级别的可控融合函数,为从高斯分布中独立抽取出来的实例调制参数。
公式解释: 连续变量被映射为空间掩模之后再加入特征中去,以此来实现对融合结果的连续控制。
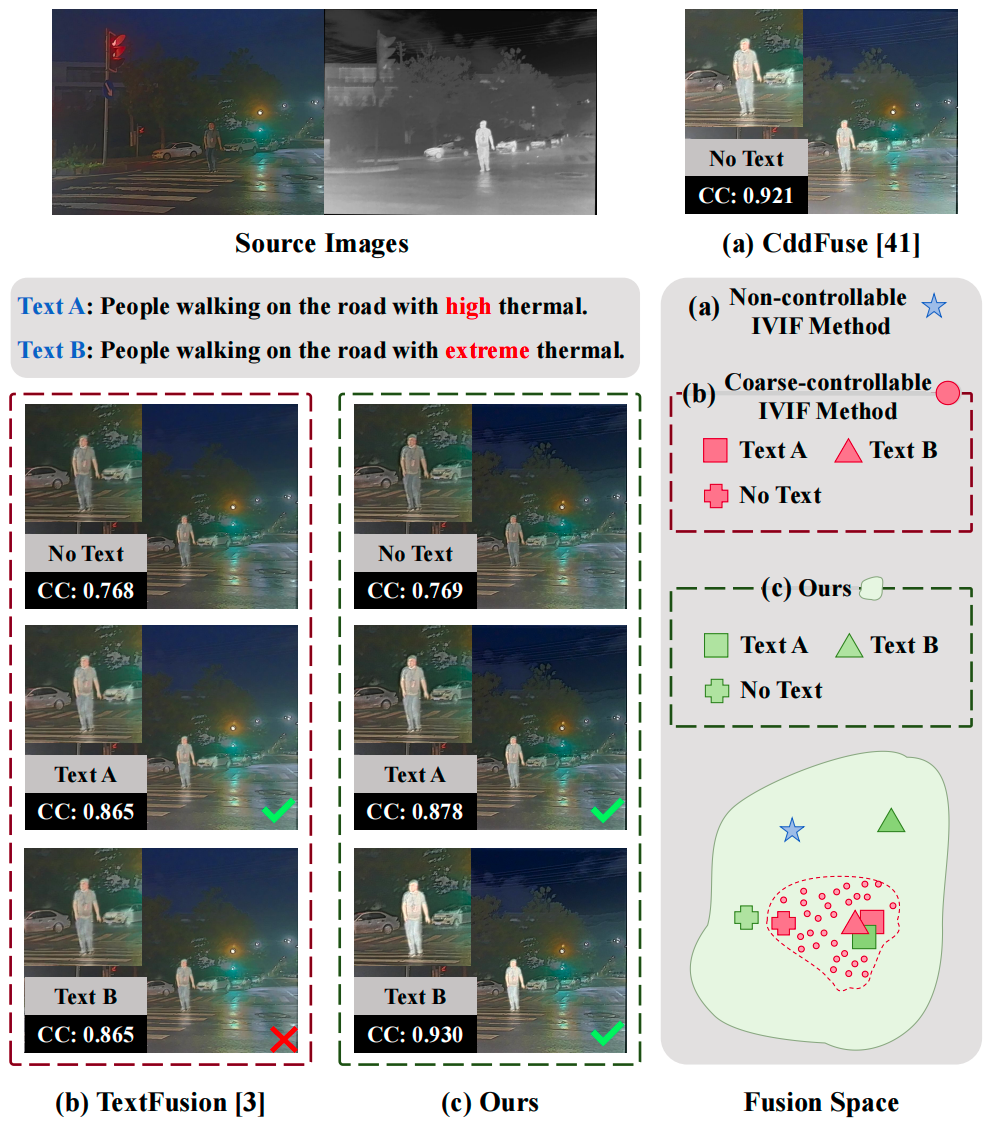
图1 不可控融合、粗粒度可控融合以及ConFusion三种方式的区别;其中ConFusion可以使得小的文字差别在融合的空间里产生不同的效果。
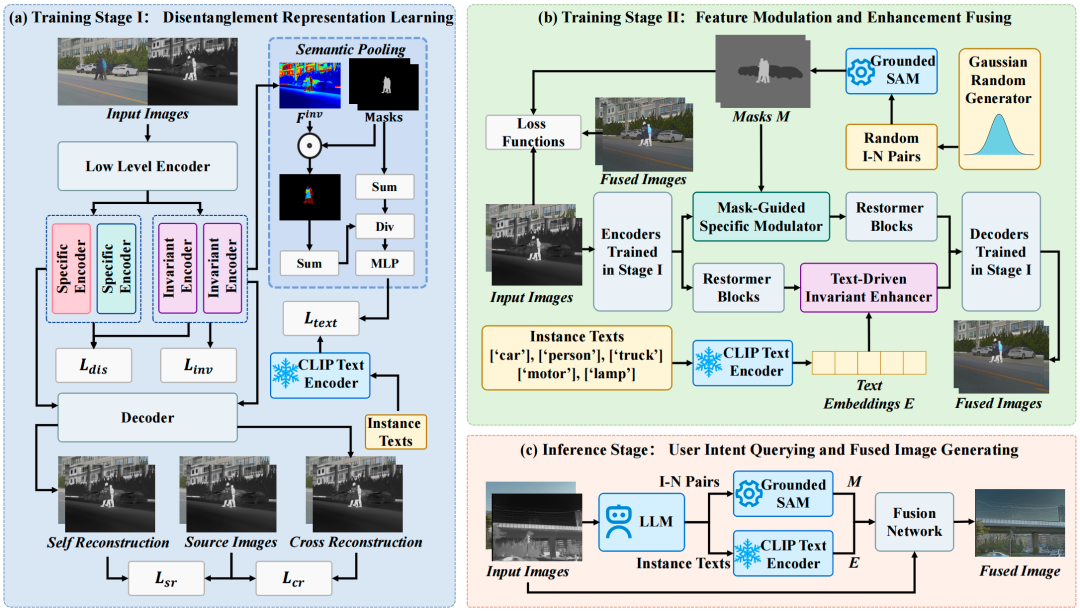
图2 ConFusion的整体结构分为三个部分,第一阶段为特征解耦和重构,第二阶段为调制增强融合,第三阶段根据用户的意图进行推断。
5.2 双分支特征解耦
从网络中抽取热辐射、纹理以及跨模态语义,并用解耦损失来抑制不变特征和特有的特征之间的关联。
和分别代表了模态的不变特征和特有的特征,是两者交集协方差近似的值,表示随机选取的空间点的数量,表示Frobenius范数。
公式解释: 降低两种特征的相关性,减小共同的意义和不同的表现形式之间的影响;CLIP 文本嵌入使不变的特征更加一致。
5.3 高斯条件下的实例级调制
对于每一个实例,它的调制强度,并且和该实例的掩模一起产生出空间调制掩模。
为第个样本的掩膜,为样本总数,以及分别代表背景掩膜和默认背景强度,为空间坐标。
公式解释: 将强度落实到具体的实例上;MGSM通过来调节红外特征,而用来调节可见光特征。
5.4 文本驱动的不变特征加强
TDIE 使融合之后的模态不变特征和实例文本做交叉注意。
展平后不变融合特征、和是文本嵌入投影、是通道维度、是注意力图、是增强结果。
公式解释: 注意力把相关的文字的意思加到视觉的位置上,提高跨模态的语言一致性的程度。
5.5 损失函数
训练使用的是两阶段的目标优化方法。
其中表示跨模态不变特征一致,和分别对应自重建和交叉重建,完成图文语义对齐,促使特征解耦;根据掩模强度约束实例区域,在背景区域保持两种模态的像素、边缘以及纹理,是权重。
公式解释: 第一阶段得到可以分割的表现形式,第二阶段学会"什么地方加强、加强多少"。
简单来说就是: ConFusion 先把"共享语义"与"模态差异"分开来处理,然后用连续强度、实例掩模以及文本语义把这些部分重新组装起来。
- 实验结果
6.1 实验条件
本实验采用、RoadScene以及TNO三种数据集进行实验,其中包含张图片,其中有张用于训练,张用于测试;RoadScene有张图片,TNO有张图片都用来做推理;两个阶段各训练了轮,裁剪尺寸为,批次大小为;第一阶段用Adam算法并设置学习率为,第二阶段对编码解码器使用的学习率,其他部分使用的学习率;损失函数和调制超参数设为、、、、;硬件方面使用NVIDIA RTX 4090和AMD EPYC 7453 28核CPU,软件平台为PyTorch 2.9.1。用峰值信噪比、均方误差、平均梯度、空间频率、相关系数以及这六种标准来衡量种方法的好坏。
6.2 定量的结果
在Table 1中的组"数据集-指标"的组合里,ConFusion获得了其中的组最优以及组次优。上PSNR、MSE、AG、SF、CC分别为、、、、,为次优;RoadScene上PSNR为,较次优 TDFusion 提高,但是SF和都是次优;TNO上除了之外其他五项都最优,其中AG为、SF为。意图是加强目标热点信息的同时也可能会降低整体可看见性纹理,所以在某些地方SF和并不是最好的。
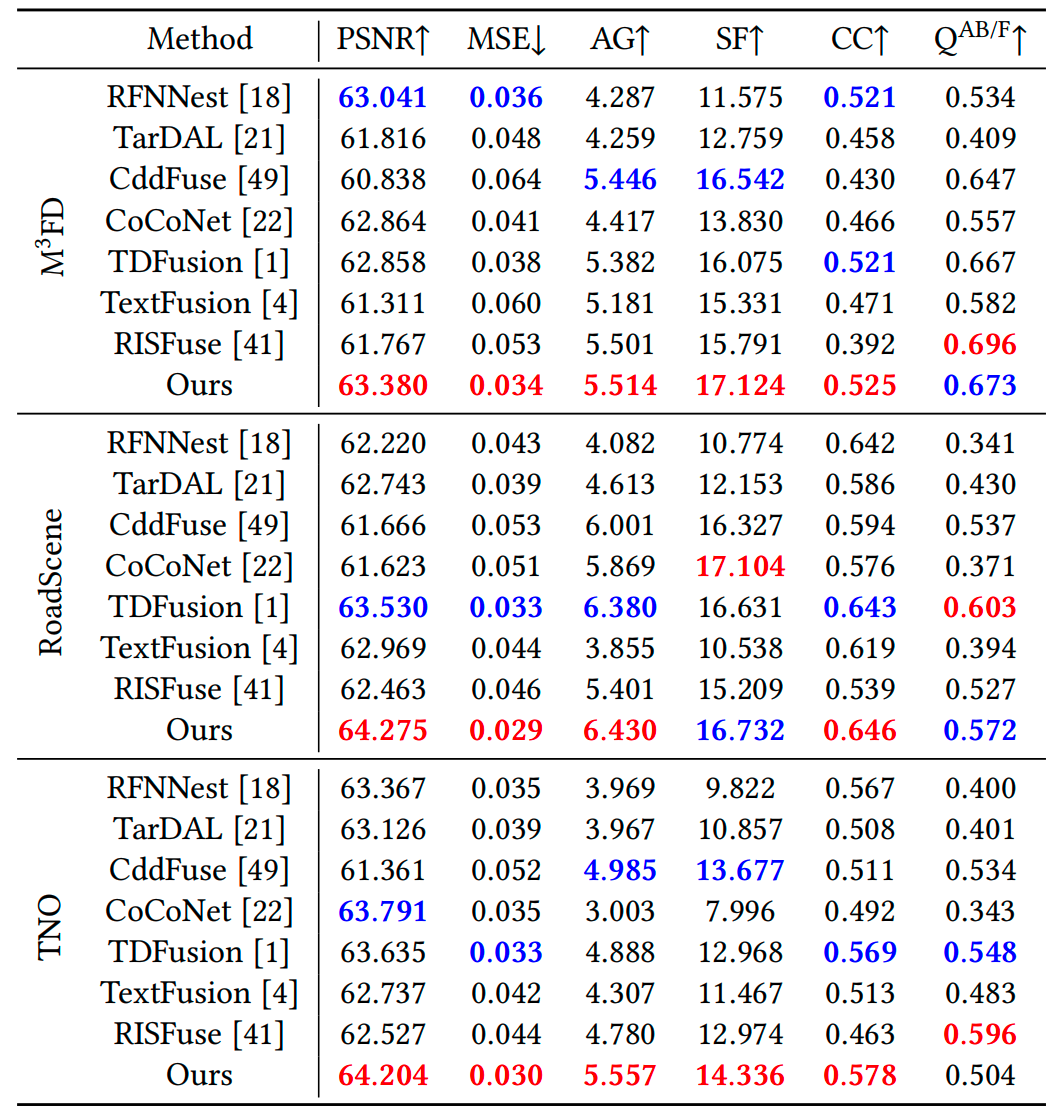
表1 ConFusion 和其他先进的方法在、RoadScene以及TNO上进行定量对比,其中红色代表最好的结果,蓝色为第二好的结果。
6.3 定量和精细化控制
图3可以比较清楚地保留砖纹、门窗边沿以及道路结构,并且能够突出人等热源的目标。图4进一步说明了TextFusion和RISFuse对于低、中、高、显著这样的相似命令做出的反应比较粗糙,而ConFusion可以单独控制一个或者多个实例。在行人区域对应的四级强度CC分别为、、和,符合文本意图的变化。
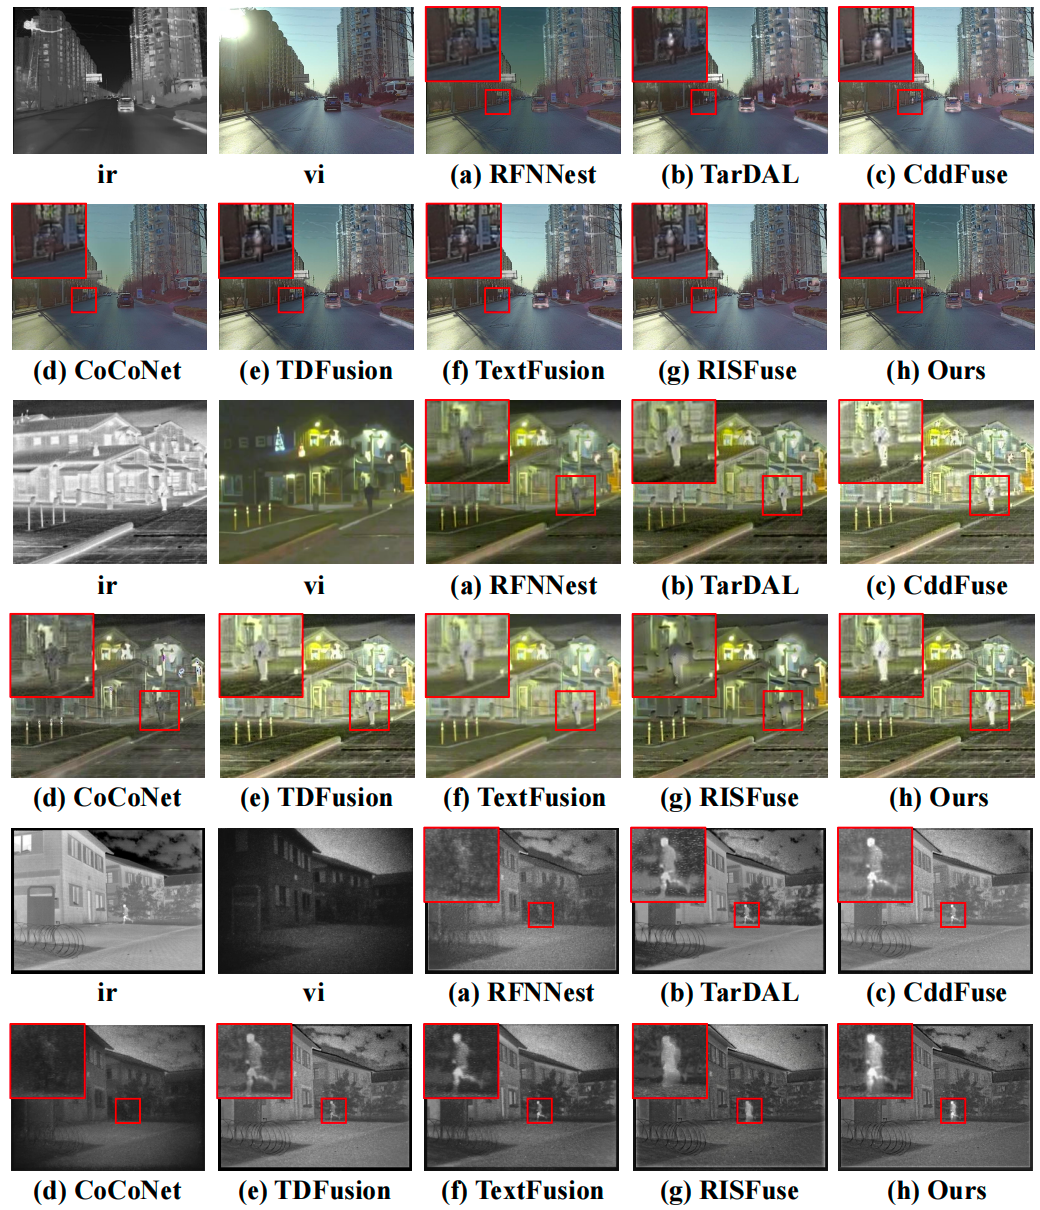
图3 为三种样品上用七种先进的方法做定性的比较。
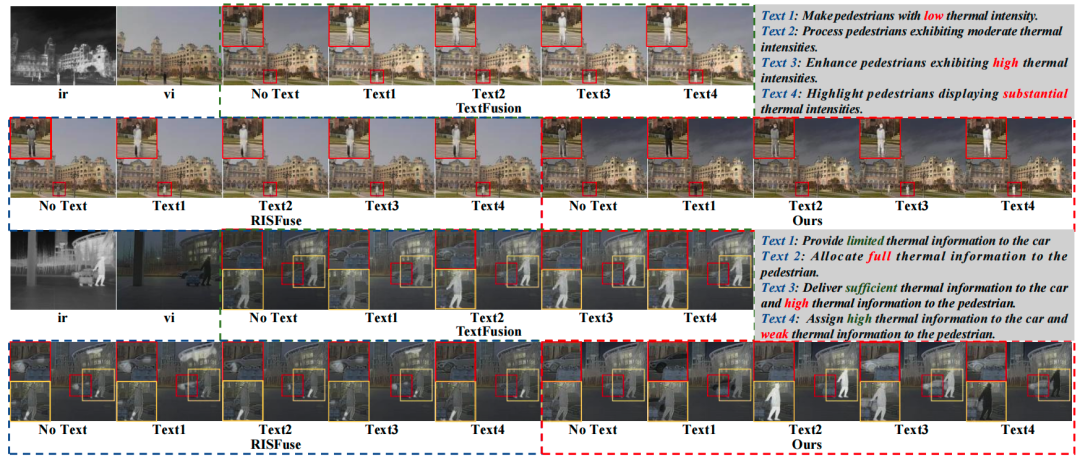
图4 为单实例和多实例情况下细粒度可控制的融合可视化。
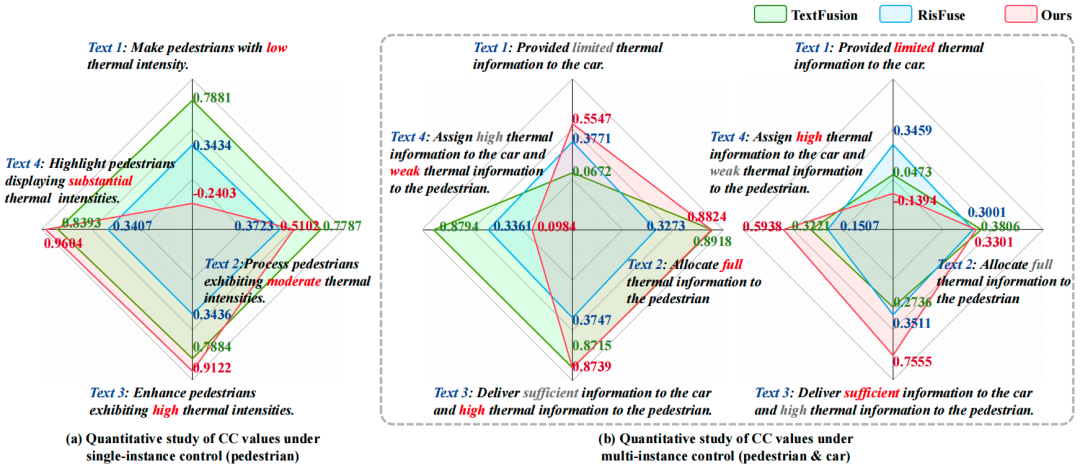
图5 对于不同的用户需求,在实例区域内融合后的热图和红外图的CC值定量研究。
下游的任务结果
将的张训练图移到测试集中,得到的训练-测试比例,并用YOLOv9进行轮训练。根据表格3的数据和颜色,ConFusion的Precision、Recall、mAP50以及mAP50:95分别为、、和,都是最好的;卡车和摩托车的AP50分别是和,都是最好的;汽车与路灯的AP50是和,次之。这表明细粒度实例控制可以提高融合图像的检测表征质量。
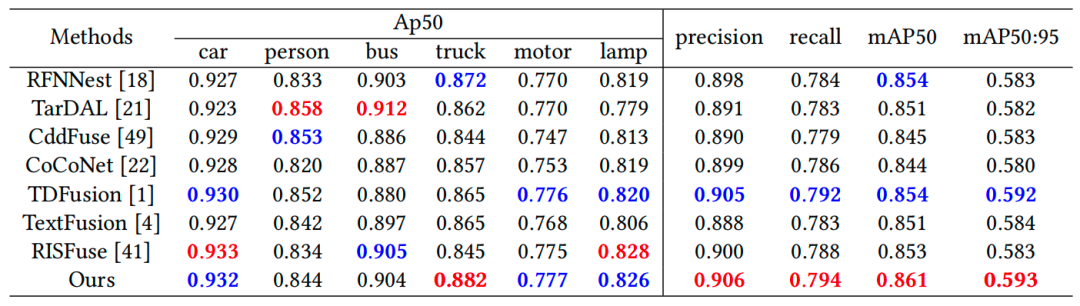
表3 为用不同的融合方式得到的结果,在上用YOLOv9做目标检测所得到的结果。
消融实验
完整的模型得到的PSNR为,MSE为,CC为,为。去掉语义对齐之后,PSNR降到;去掉MGSM之后,PSNR和CC分别降到和,虽然AG和SF升高了,但是语义区域没有控制好,可控性变差;去掉TDIE之后所有指标都降低了。分别移除、或者也会使整体性能降低,说明重建、解耦以及跨模态一致性缺一不可。
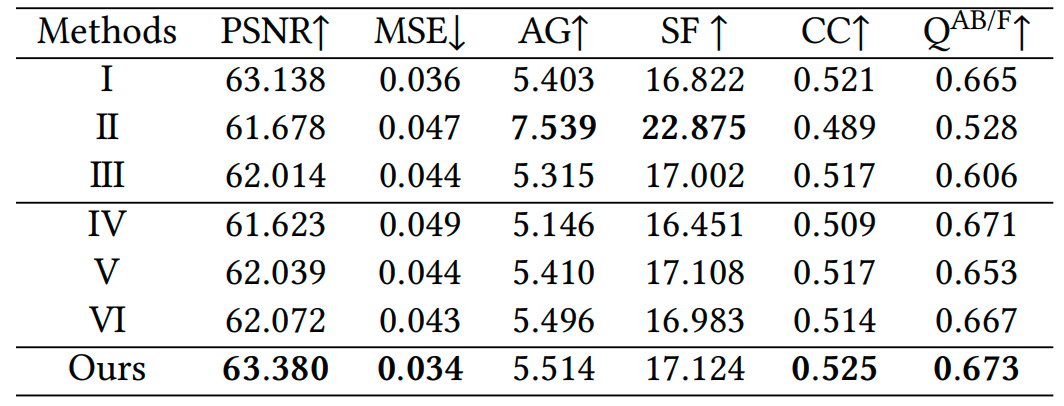
表2 M3FD的语义对齐、MGSM、TDIE 以及三个损失函数的消融情况。
- 结论和预测
总结
ConFusion 将可控融合由离散条件推广到实例级别的连续空间 ,并且证明了它的融合效果、控制能力以及检测价值;之后要降低大规模模型和分割模块的成本。
一句话概括:ConFusion 最重要的贡献就是使不同的实例中的红外和可见光的信息可以按照用户的意愿进行连续或者独立的调整。
往期推荐