Codex源码深度解读:从原理到企业落地,一篇文章搞懂AI编程Agent的天花板
2026年8月19日,OpenAI正式将驱动Codex App、CLI和IDE扩展的底层执行框架------Codex Agent Harness全面开源(Apache-2.0协议)。这意味着,曾经只存在于OpenAI内部的生产级AI Agent运行时,现在任何人都可以阅读源码、二次开发、甚至嵌入到自己的企业系统中。本文将从源码层面拆解Codex的设计哲学,结合实际代码教你如何在企业项目中落地使用。
文章目录
- Codex源码深度解读:从原理到企业落地,一篇文章搞懂AI编程Agent的天花板
-
- 痛点场景:你是不是也遇到过这些开发噩梦?
- 一、Codex到底是什么?
-
- [1.1 专业定义](#1.1 专业定义)
- [1.2 大白话解释](#1.2 大白话解释)
- [1.3 生活案例](#1.3 生活案例)
- 二、为什么要用Codex?痛点的解决方案
-
- [2.1 解决"读代码慢"的问题](#2.1 解决"读代码慢"的问题)
- [2.2 解决"重复劳动多"的问题](#2.2 解决"重复劳动多"的问题)
- [2.3 解决"质量参差不齐"的问题](#2.3 解决"质量参差不齐"的问题)
- [2.4 解决"调试耗时"的问题](#2.4 解决"调试耗时"的问题)
- [2.5 一句话总结](#2.5 一句话总结)
- 三、Codex是怎么演进过来的?
-
- [3.1 第一世:2021年,那个"懂代码的GPT"](#3.1 第一世:2021年,那个"懂代码的GPT")
- [3.2 沉寂期:2022-2024年,名字被雪藏](#3.2 沉寂期:2022-2024年,名字被雪藏)
- [3.3 第二世:2025年4月,Codex CLI开源](#3.3 第二世:2025年4月,Codex CLI开源)
- [3.4 2025年5月,云端Agent预览](#3.4 2025年5月,云端Agent预览)
- [3.5 2025年9月,GPT-5-Codex成为默认](#3.5 2025年9月,GPT-5-Codex成为默认)
- [3.6 2026年上半年,生态爆发](#3.6 2026年上半年,生态爆发)
- [3.7 2026年8月,Harness全面开源](#3.7 2026年8月,Harness全面开源)
- 四、Codex源码架构深度解读
-
- [4.1 整体目录结构](#4.1 整体目录结构)
- [4.2 核心概念:Thread、Session、Turn、Step](#4.2 核心概念:Thread、Session、Turn、Step)
- [4.3 Agent Loop核心源码解析](#4.3 Agent Loop核心源码解析)
- [4.4 上下文管理:ContextManager](#4.4 上下文管理:ContextManager)
- [4.5 工具调度:Tool Runtime](#4.5 工具调度:Tool Runtime)
- [4.6 沙箱安全:多平台隔离](#4.6 沙箱安全:多平台隔离)
- [4.7 持久化:Thread Store](#4.7 持久化:Thread Store)
- [4.8 三层集成接口](#4.8 三层集成接口)
- 五、Codex怎么用?常用场景教学
-
- [5.1 安装与配置](#5.1 安装与配置)
-
- [安装Codex CLI](#安装Codex CLI)
- [配置API Key](#配置API Key)
- 配置文件
- [5.2 场景一:交互式开发(最常用)](#5.2 场景一:交互式开发(最常用))
- [5.3 场景二:非交互式执行(codex exec)](#5.3 场景二:非交互式执行(codex exec))
- [5.4 场景三:AGENTS.md项目配置](#5.4 场景三:AGENTS.md项目配置)
- [5.5 场景四:Skills技能包](#5.5 场景四:Skills技能包)
- [5.6 场景五:MCP工具扩展](#5.6 场景五:MCP工具扩展)
-
- [配置MCP Server](#配置MCP Server)
- 六、企业项目中如何使用Codex?
- [七、竞品对比:Codex vs Claude Code vs Cursor vs GitHub Copilot](#七、竞品对比:Codex vs Claude Code vs Cursor vs GitHub Copilot)
- 八、面试官高频面试题
-
- [8.1 基础概念题](#8.1 基础概念题)
- [8.2 架构设计题](#8.2 架构设计题)
- [8.3 工程实践题](#8.3 工程实践题)
- [8.4 深度思考题](#8.4 深度思考题)
- 九、总结
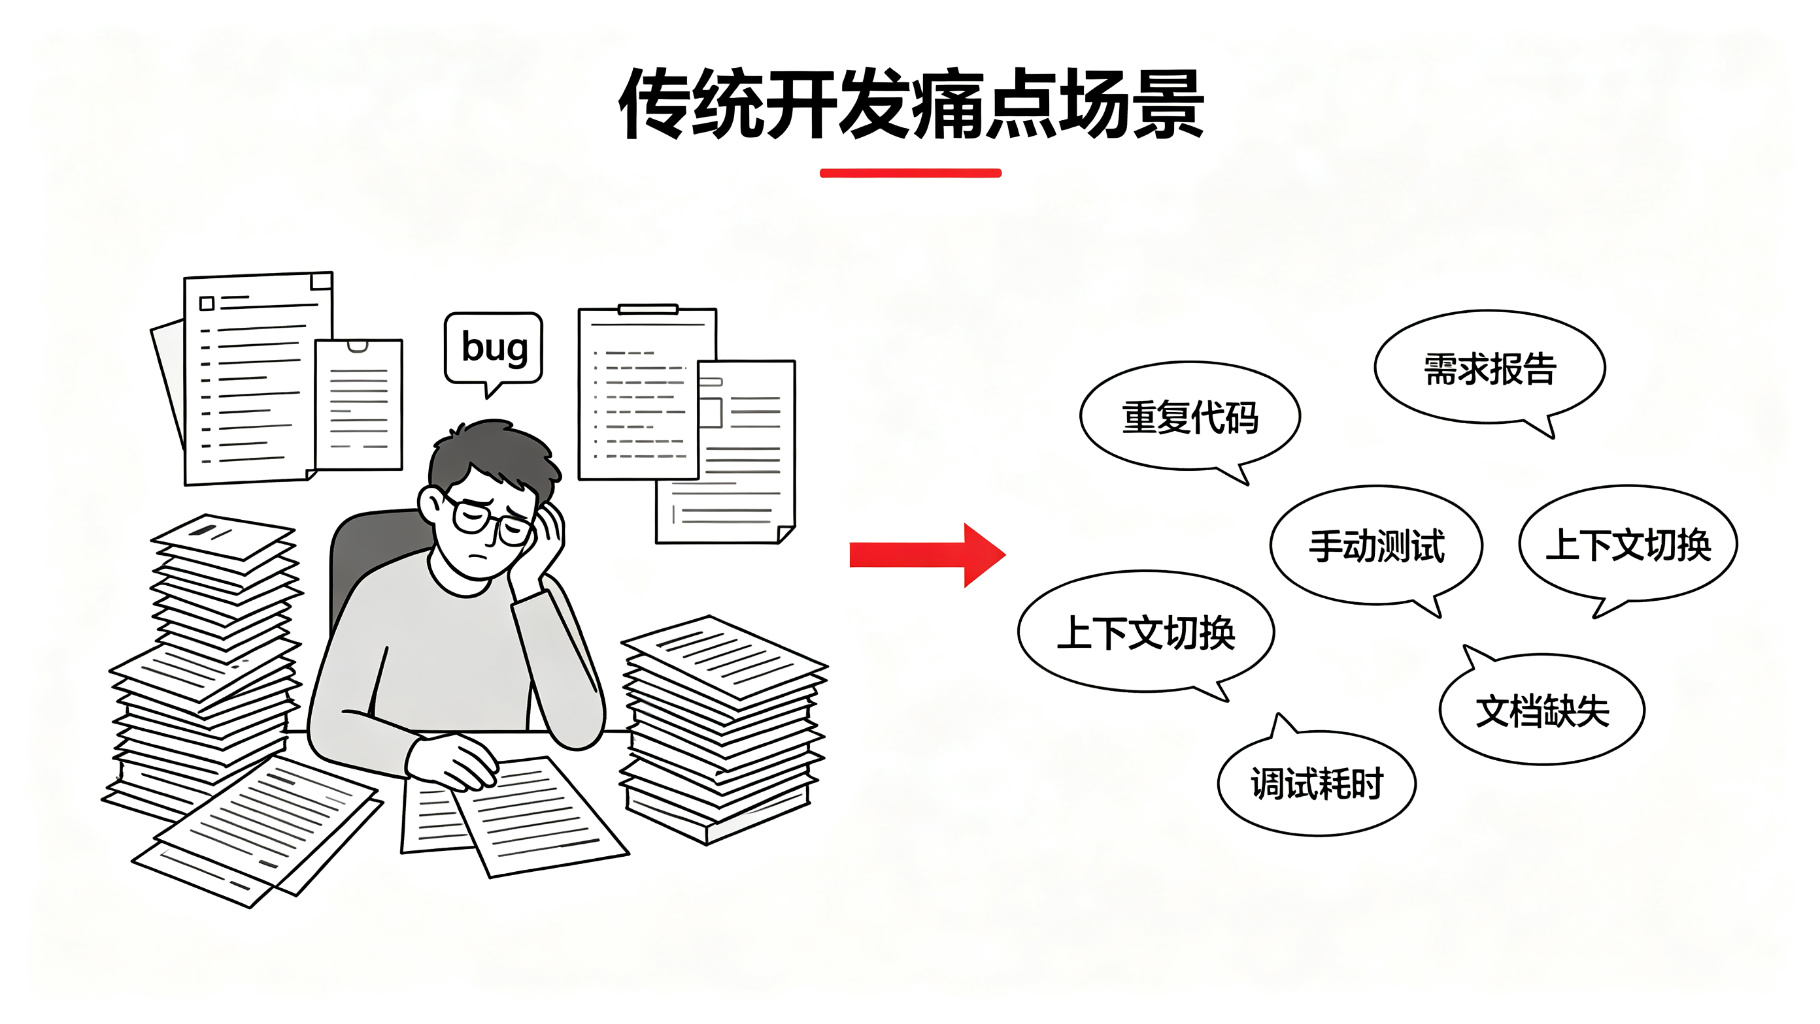
痛点场景:你是不是也遇到过这些开发噩梦?
先讲一个真实的故事。
我有个朋友在一家中型互联网公司做后端开发,上周跟我吐槽了他的一天:
- 早上9点,产品经理扔过来一个需求:"把用户中心的三个接口重构一下,顺便加个缓存层。"
- 他花了2小时读代码,搞清楚这三个接口分布在5个文件里,调用链长达8层。
- 开始写代码,改到一半发现公共方法被其他模块依赖,又得回去看调用方。
- 下午3点,终于写完了,跑测试,15个用例红了7个。
- 开始调试,发现是缓存key的命名规则和老代码不一致。
- 晚上8点,修完bug,写文档,写单测,提交PR。
- 第二天,code review被打回来,说命名不规范、缺少错误处理。
这不是个例。根据Stack Overflow 2025年开发者调查,开发者平均只有32%的时间在写新功能,其余时间都花在读代码、调试、修bug、写文档、跑测试上。
更扎心的是:
- 上下文切换成本高:一个需求可能涉及前端、后端、数据库、配置文件,来回切换文件和工具,注意力被切碎。
- 重复劳动多:写CRUD、写单测、写文档、改格式,这些机械性工作占据了大量时间。
- 知识断层严重:老员工走了,代码没人懂;新人上手,光熟悉项目就要一两周。
- 质量参差不齐:每个人写代码风格不一样,code review变成了"规范纠察队"。
- 调试耗时:一个诡异的bug,可能要追半天日志,加无数print。
那有没有一种工具,能像一个不知疲倦的初级工程师一样,帮你读代码、写代码、跑测试、修bug,而且7x24小时不喊累?
有,这就是Codex。
但Codex不是简单的"代码补全工具",它是一个完整的软件工程智能体运行时。要真正用好它,我们得从源码层面理解它到底是怎么工作的。
一、Codex到底是什么?
1.1 专业定义
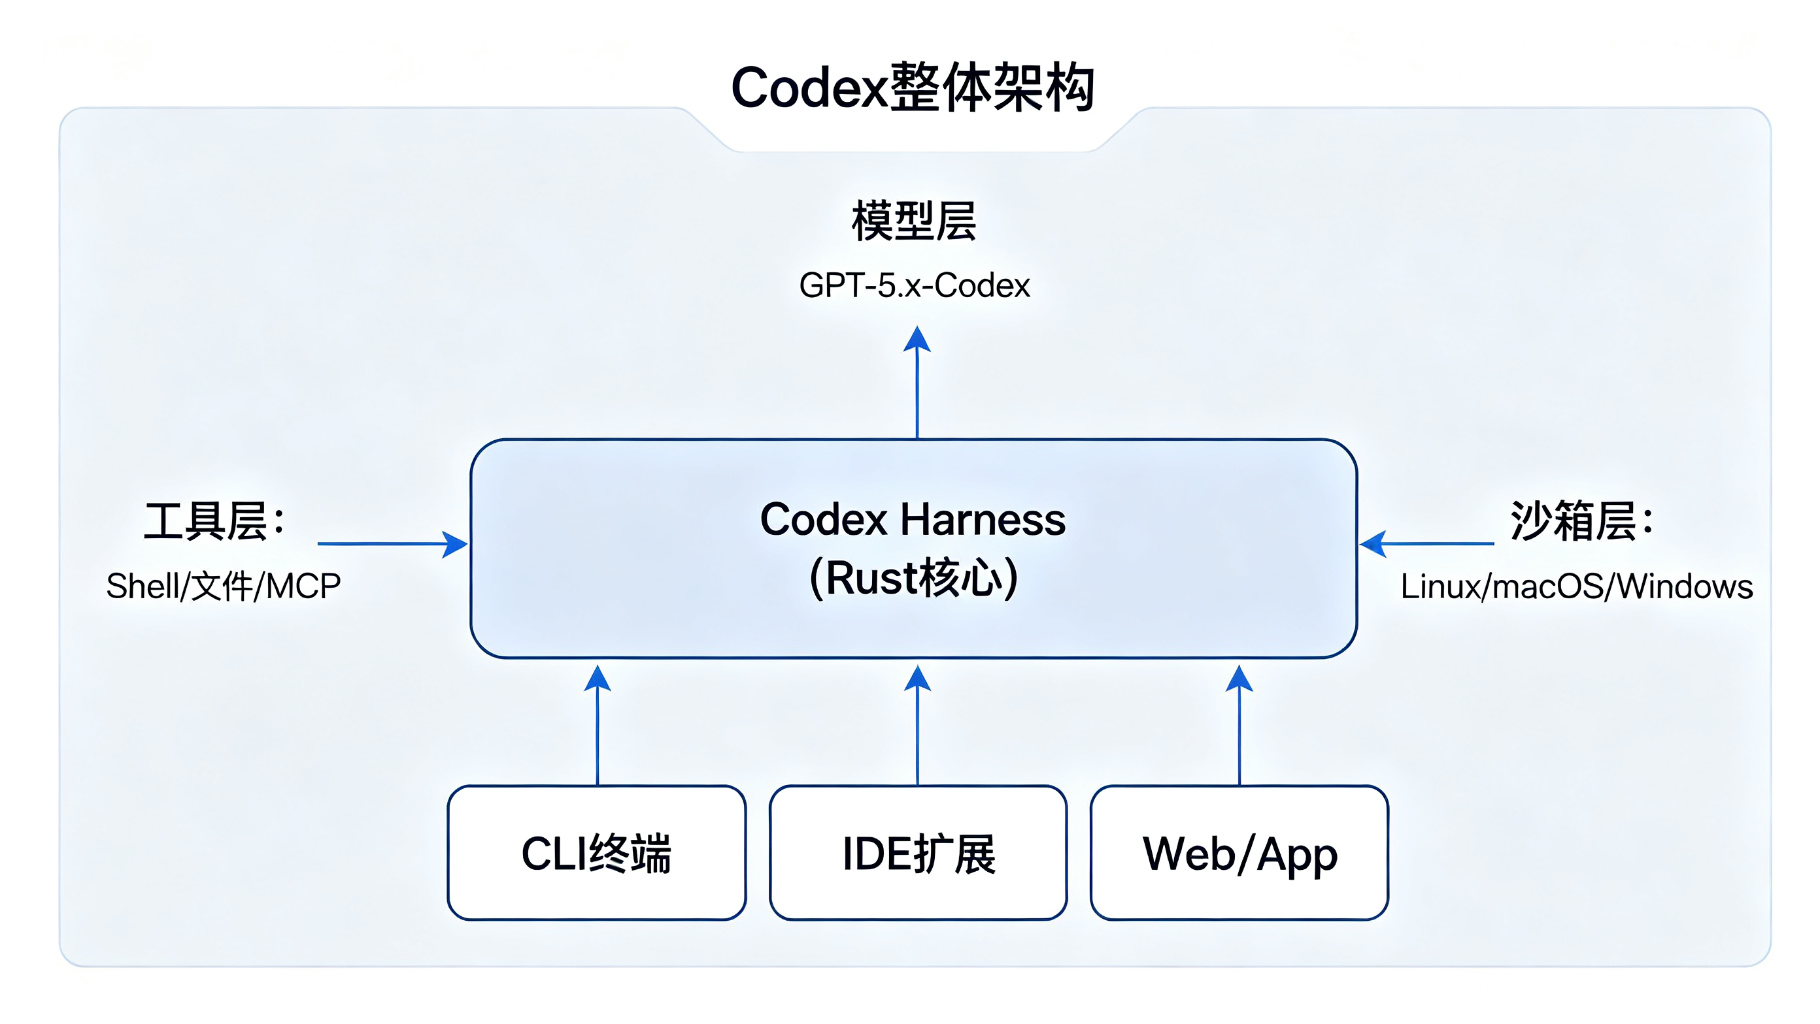
Codex是OpenAI推出的生产级开源Coding Agent运行时,用Rust实现了一套统一的Agent核心(Codex Core),通过App Server(JSON-RPC 2.0)对外暴露,让CLI、IDE扩展、Web等多个前端共享同一份Agent Loop、工具编排、沙箱隔离和记忆管线。
源码地址:https://github.com/openai/codex
截至2026年8月,仓库已累计超过10万Star,是目前最火的AI编程Agent开源项目。
1.2 大白话解释
说人话,Codex就像一家全国性银行的IT系统:
- 模型层(GPT-5.x-Codex) = 银行的"大脑",负责做决策,比如"这个需求该怎么实现"。
- Harness核心(Rust写的) = 银行的"核心业务系统",负责管账户、管交易、管流程,是真正干活的地方。
- CLI/IDE/Web = 银行的"柜台/APP/网银",是用户接触到的界面,不管你用哪个界面,背后都是同一套核心系统。
- 工具层(Shell/文件/MCP) = 银行的"业务窗口",比如取钱窗口、转账窗口,Agent通过这些工具来操作真实世界。
- 沙箱层 = 银行的"金库保险库",把操作限制在安全范围内,防止Agent搞破坏。
你可能会问:"这不就是个高级版的ChatGPT吗?"
区别大了。ChatGPT是"你问一句,它答一句",而Codex是"你给个任务,它自己规划、自己执行、自己验证、自己修正,直到完成"。
举个例子:
- 你跟ChatGPT说:"帮我写个用户登录接口。"它给你返回一段代码,你自己复制粘贴到项目里。
- 你跟Codex说:"帮我写个用户登录接口。"它会自己找到项目里的用户模块,看现有代码风格,创建文件,写代码,跑测试,测试不过自己修,最后给你一个可以直接合并的PR。
1.3 生活案例
想象你是一个餐厅老板。
- 传统开发 = 你自己买菜、切菜、炒菜、端菜、收银,一个人干所有活,累得半死还容易出错。
- 代码补全工具(如Copilot) = 雇了个切菜工,你说切什么他切什么,但不会自己炒菜。
- Codex = 雇了个厨师长,你说"今天做个红烧肉",他自己规划菜单、买菜、切菜、炒菜、尝咸淡、调整火候,最后端上桌,你只需要验收。
这就是Agent和补全工具的本质区别:补全工具是"工具",Agent是"员工"。
二、为什么要用Codex?痛点的解决方案
2.1 解决"读代码慢"的问题
Codex启动时会自动扫描项目结构,读取AGENTS.md配置文件,理解项目的技术栈、编码规范、目录结构。你问它任何问题,它都能快速定位到相关文件。
bash
# 你只需要在项目根目录放一个AGENTS.md
# Codex启动时会自动加载
cat AGENTS.md
markdown
# 项目规范
- 语言:Python 3.11+
- 框架:FastAPI
- 代码风格:PEP 8,使用black格式化
- 测试框架:pytest
- 数据库:PostgreSQL,使用SQLAlchemy ORM
- 禁止事项:不要修改migrations目录,不要直接写SQL
2.2 解决"重复劳动多"的问题
Codex可以通过codex exec命令实现自动化,比如自动写单测、自动修lint、自动更新文档。
bash
# 自动为src/auth目录下的所有文件写单元测试
codex exec --full-auto "为 src/auth/ 目录下的所有 Python 文件编写单元测试,使用 pytest,覆盖率达到80%以上"

# 自动修复lint错误
codex exec --full-auto "运行 flake8 检查,修复所有可以自动修复的问题"

# 自动更新CHANGELOG
codex exec --full-auto "根据最近的git commit记录,更新 CHANGELOG.md"
2.3 解决"质量参差不齐"的问题
Codex严格按照AGENTS.md中定义的规范写代码,不会因为"心情"而改变风格。而且它写完代码会自动跑测试,测试不过就自己修。
bash
# 让Codex在写完代码后自动跑测试
codex exec --full-auto "实现用户登录功能,完成后运行 pytest tests/test_auth.py 确保所有测试通过"
2.4 解决"调试耗时"的问题
你可以把报错信息直接扔给Codex,它会自己分析错误、定位代码、修复问题。
bash
# 把报错信息通过管道传给Codex
pytest tests/ 2>&1 | codex exec --full-auto "分析这些测试失败的原因,并修复代码中的bug"
2.5 一句话总结
Codex的价值不是"替你写代码",而是"替你干那些你不想干但又必须干的活",让你把精力集中在真正需要创造力的地方。
三、Codex是怎么演进过来的?
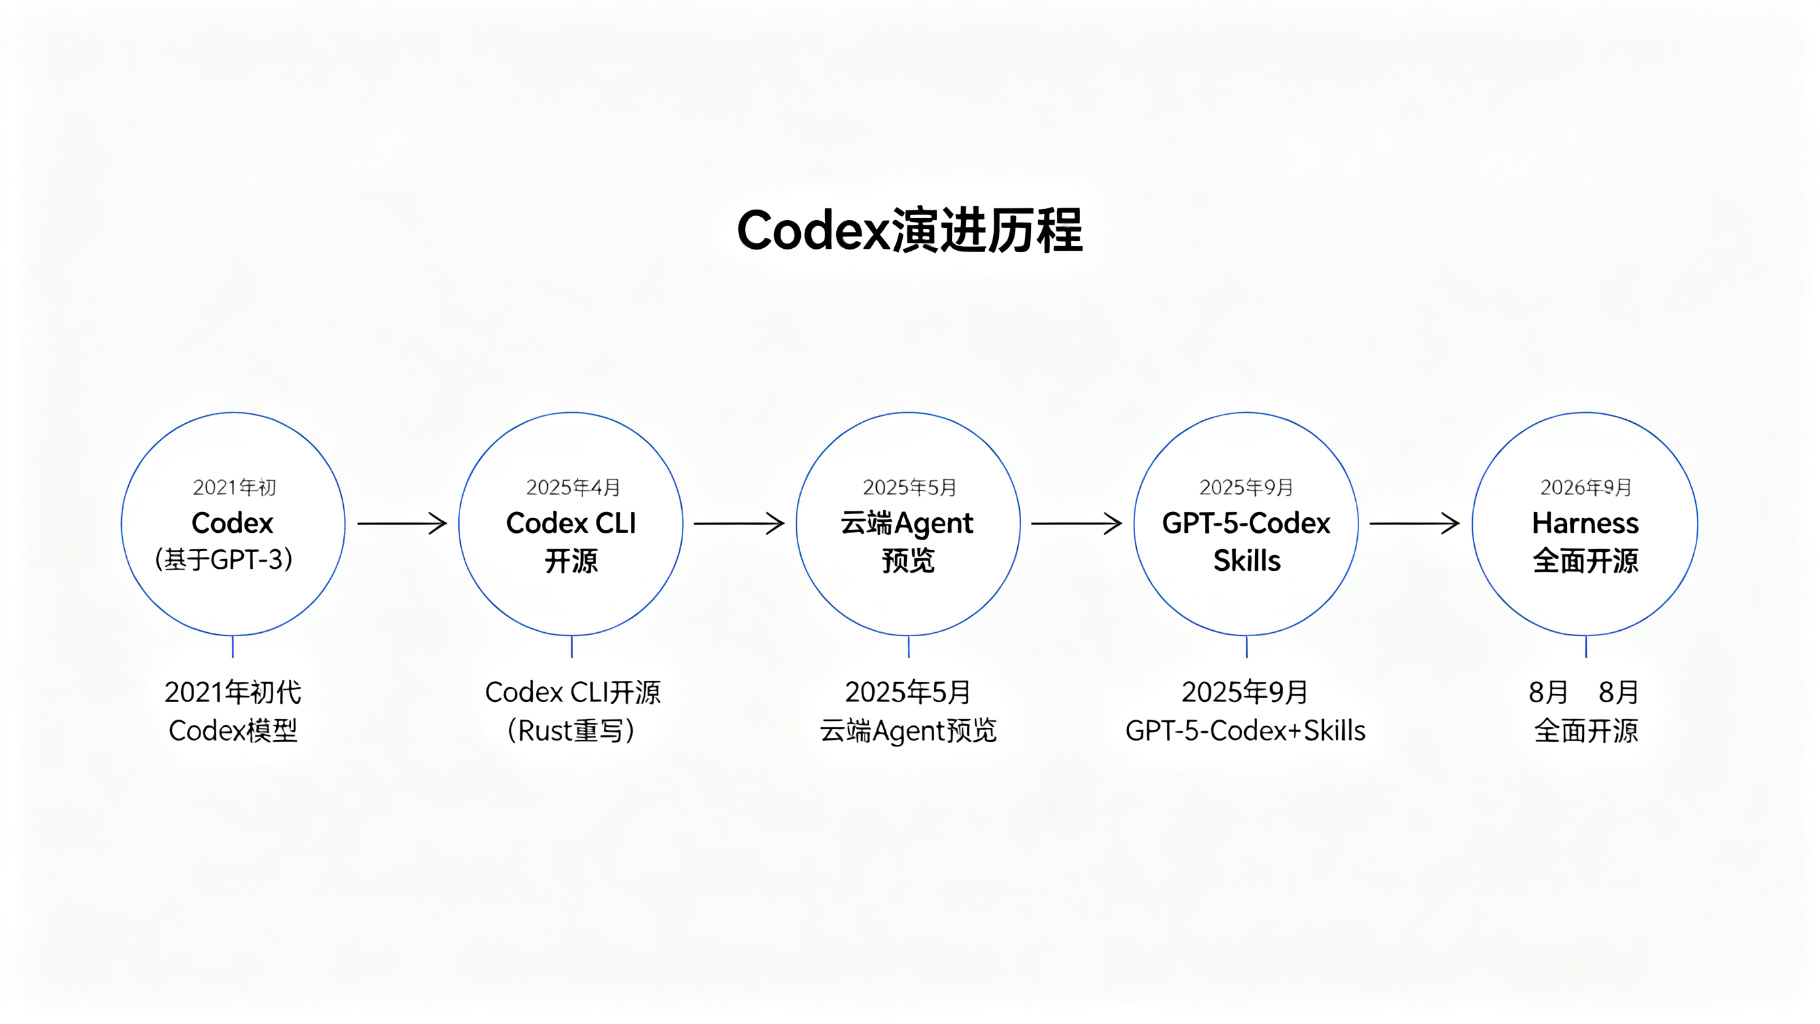
很多人以为Codex是2025年才出来的新产品,其实它已经有5年历史了。理解它的演进历程,能帮你更好地理解它的设计决策。
3.1 第一世:2021年,那个"懂代码的GPT"
2021年7月,OpenAI在arXiv挂出论文《Evaluating Large Language Models Trained on Code》,Codex正式进入视野。
- 架构:基于GPT-3的decoder-only Transformer
- 参数规模:120亿
- 训练数据:筛选GitHub 5400万个公开仓库,总计159GB高质量代码
- 能力:HumanEval基准测试达到28.8%的通过率
- 用途:给GitHub Copilot供血,做代码补全
这个时期的Codex,本质上就是一个"代码补全模型",你写一半,它帮你补另一半。
3.2 沉寂期:2022-2024年,名字被雪藏
2022年之后,OpenAI把重心放在了ChatGPT和GPT-4上,Codex这个名字逐渐淡出公众视野。但内部一直在积累Agent相关的技术。
3.3 第二世:2025年4月,Codex CLI开源
2025年4月,OpenAI突然发布Codex CLI,一个用Rust写的本地终端Agent。
- 核心变化:从"模型"变成了"Agent",不再只是补全代码,而是能执行完整任务
- 技术栈:Rust重写核心,零依赖安装
- 沙箱:原生支持macOS Seatbelt、Linux Landlock+seccomp、Windows Job Objects
- 开源协议:Apache-2.0
发布后npm周下载量很快冲到百万级,成为当时最火的AI编程工具。
3.4 2025年5月,云端Agent预览
OpenAI推出基于云沙箱的并行软件工程智能体,先给Pro/Enterprise用户,6月开放到Plus用户。
- 核心变化:从"本地运行"变成"云端运行",可以并行处理多个任务
- 能力:可以同时开多个子任务,每个子任务在独立的沙箱中运行
- 模型:codex-1和codex-mini
3.5 2025年9月,GPT-5-Codex成为默认
GPT-5-Codex模型成为云端默认,引入Skills和Automations功能。
- Skills:可复用的技能包,比如"写单测"、"代码审查"
- Automations:自动化工作流,可以定时执行任务
3.6 2026年上半年,生态爆发
- 桌面App发布
- Codex Security安全扫描功能
- 子代理(Subagents)功能
- GPT-5.3/5.4-Codex模型相继落地
- 与GitHub Copilot深度集成
3.7 2026年8月,Harness全面开源
这是里程碑式的事件。OpenAI把驱动所有Codex产品的底层执行框架------Codex Agent Harness全面开源。
开源的内容包括:
- Rust核心(codex-rs)
- App Server驱动层
- 完整的SDK集成接口(TypeScript和Python)
- 三层集成接口:codex exec、Codex SDK、App Server
这意味着,你现在可以把Codex的核心嵌入到自己的产品中,打造属于自己的AI编程Agent。
四、Codex源码架构深度解读
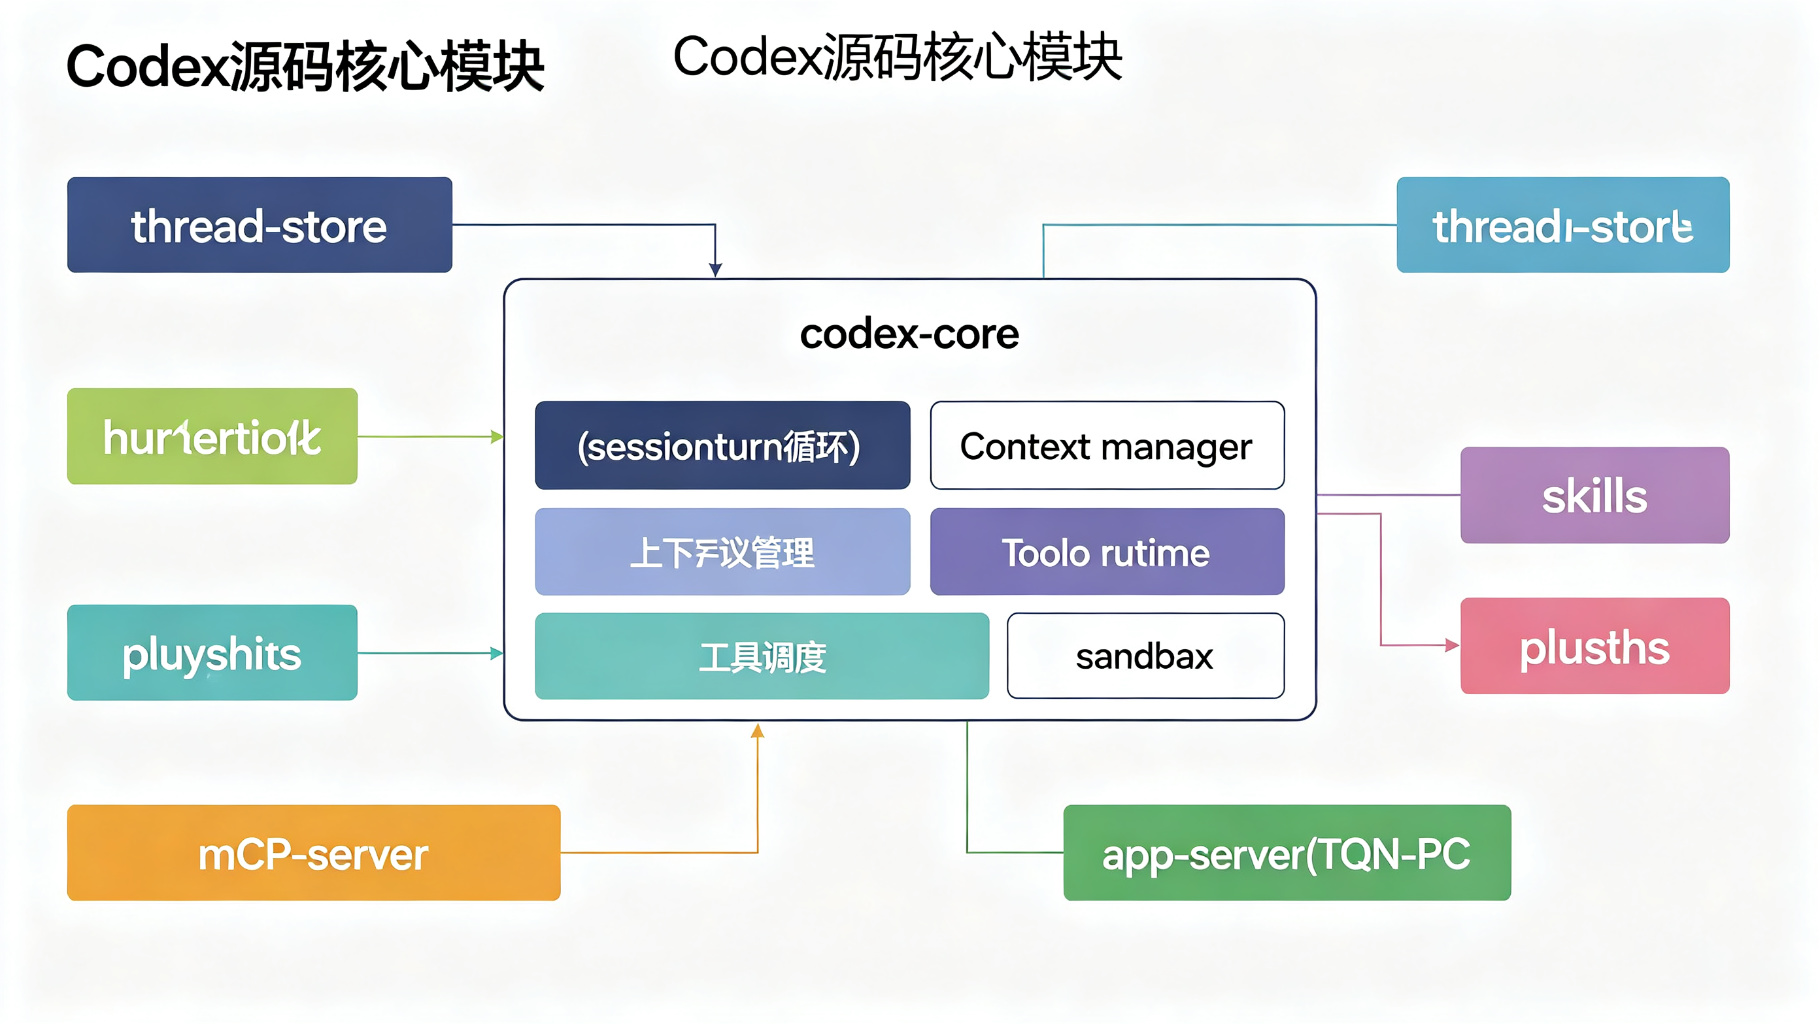
终于到了最硬核的部分。我们来拆开Codex的源码,看看它到底是怎么工作的。
4.1 整体目录结构
先看一下仓库的核心目录结构:
text
openai/codex/
├── codex-rs/                    # Rust核心,所有Agent逻辑都在这里
│   ├── core/                    # 核心引擎:Session、Turn、上下文、工具调度
│   ├── session/                 # 会话管理:turn循环、输入队列
│   ├── context_manager/         # 上下文管理:历史消息、压缩、注入
│   ├── tools/                   # 工具运行时:Shell、文件、MCP
│   ├── sandboxing/              # 跨平台沙箱抽象
│   ├── linux-sandbox/           # Linux Landlock / bubblewrap
│   ├── windows-sandbox-rs/      # Windows 受限token、ACL
│   ├── thread-store/            # 线程持久化抽象
│   ├── skills/                  # 技能发现、加载、渲染
│   ├── plugins/                 # 插件系统
│   ├── mcp-server/              # MCP协议服务端
│   ├── app-server/              # JSON-RPC 2.0 App Server
│   ├── tui/                     # 终端UI
│   └── exec/                    # 非交互执行入口
├── sdk/
│   ├── typescript/              # TypeScript SDK
│   └── python/                  # Python SDK
└── docs/                        # 文档
4.2 核心概念:Thread、Session、Turn、Step
要理解Codex的源码,首先要理解这四个核心概念:
| 概念 | 类比 | 说明 |
|---|---|---|
| Thread | 一次对话 | 用户和Agent的一次完整会话,包含所有历史消息 |
| Session | 一次运行 | Thread的一次运行实例,管理当前状态 |
| Turn | 一轮交互 | 用户发一条消息,Agent处理完返回,这是一个Turn |
| Step | 一次模型调用 | 一个Turn可能包含多次模型调用(思考->调工具->看结果->再思考) |
用餐厅的例子:
- Thread = 一桌客人从入座到离开的全过程
- Session = 这桌客人当前的用餐状态(点菜中/上菜中/用餐中)
- Turn = 客人叫一次服务员,服务员处理完回来
- Step = 服务员处理过程中的一个动作(去厨房下单/端菜/结账)
4.3 Agent Loop核心源码解析
Agent Loop是Codex的心脏,负责协调用户、模型和工具。核心逻辑在codex-rs/core/session/turn.rs的run_turn函数中。
我们来看简化版的核心逻辑:
rust
// codex-rs/core/session/turn.rs
pub async fn run_turn(
    &mut self,
    turn_context: &TurnContext,
    input: UserInput,
) -> Result<TurnOutput> {
    // 第1步:构建初始上下文
    let mut context = self.build_initial_context(turn_context, input)?;

    // 第2步:进入循环,直到模型给出最终回答或达到最大步数
    let mut step_count = 0;
    while step_count < turn_context.max_steps {
        step_count += 1;

        // 第3步:调用模型,获取响应
        let model_response = self.call_model(&context).await?;

        // 第4步:解析模型响应
        match model_response {
            ModelResponse::Text(text) => {
                // 模型给出了文本回答,这轮结束
                return Ok(TurnOutput::Final(text));
            }
            ModelResponse::ToolCall(tool_calls) => {
                // 模型要求调用工具
                for tool_call in tool_calls {
                    // 第5步:检查权限,是否需要用户审批
                    if self.needs_approval(&tool_call, turn_context)? {
                        return Ok(TurnOutput::NeedsApproval(tool_call));
                    }

                    // 第6步:在沙箱中执行工具
                    let result = self.execute_tool(&tool_call, turn_context).await?;

                    // 第7步:把工具结果加入上下文,继续循环
                    context.push_tool_result(tool_call, result);
                }
            }
        }
    }

    Err(TurnError::MaxStepsExceeded)
}这个循环的核心思想是:模型不是一次性给出答案,而是不断地"思考->行动->观察->再思考",直到完成任务。
这就是ReAct(Reasoning + Acting)模式的工程化实现。
4.4 上下文管理:ContextManager
上下文管理是Agent最关键的技术之一。模型的上下文窗口是有限的(比如200K tokens),但一个项目可能有几百万行代码。怎么在有限的上下文里塞下最有用的信息?
Codex的ContextManager做了这几件事:
rust
// codex-rs/core/context_manager/mod.rs
pub struct ContextManager {
    history: ConversationHistory,    // 对话历史
    system_prompt: SystemPrompt,     // 系统提示词
    tool_schemas: ToolSchemas,       // 工具定义
    compact_strategy: CompactStrategy, // 压缩策略
}

impl ContextManager {
    pub fn build_context(&self) -> Result<Context> {
        let mut context = Context::new();

        // 1. 系统提示词(永远保留)
        context.push(self.system_prompt.render());

        // 2. 工具定义(永远保留)
        context.push(self.tool_schemas.render());

        // 3. AGENTS.md内容(项目规范,永远保留)
        context.push(self.load_agents_md()?);

        // 4. 最近的对话历史(保留最近N轮)
        context.push(self.history.recent_turns(10));

        // 5. 更早的历史(压缩成摘要)
        if self.history.len() > 10 {
            let summary = self.compact_strategy.compress(
                self.history.older_turns(10)
            )?;
            context.push(summary);
        }

        // 6. 如果还超预算,继续压缩
        while context.token_count() > self.max_tokens {
            context.compact_one_layer()?;
        }

        Ok(context)
    }
}大白话解释:上下文管理就像你整理行李箱。系统提示词和工具定义是"身份证和护照",必须带;AGENTS.md是"旅行攻略",必须带;最近的对话是"刚买的纪念品",优先带;更早的历史是"旧衣服",压缩成摘要带;实在装不下,就扔最不重要的。
4.5 工具调度:Tool Runtime
工具是Agent与真实世界交互的桥梁。Codex内置了这些工具:
| 工具 | 功能 |
|---|---|
| shell | 执行Shell命令 |
| read_file | 读取文件 |
| write_file | 写入文件 |
| apply_patch | 应用补丁(修改文件) |
| grep | 搜索代码 |
| glob | 匹配文件 |
| mcp | 调用MCP协议的外部工具 |
工具执行的核心逻辑:
rust
// codex-rs/core/tools/runtime.rs
pub async fn execute_tool(
&self,
tool_call: &ToolCall,
turn_context: &TurnContext,
) -> Result<ToolResult> {
// 第1步:查找工具定义
let tool = self.registry.get(&tool_call.name)?;
// 第2步:验证参数
let params = tool.validate_params(&tool_call.arguments)?;
// 第3步:检查执行策略(是否允许、是否需要审批)
self.exec_policy.check(&tool_call.name, ¶ms)?;
// 第4步:在沙箱中执行
let result = match tool_call.name.as_str() {
"shell" => self.sandbox.exec_shell(¶ms.command).await?,
"read_file" => self.sandbox.read_file(¶ms.path).await?,
"write_file" => self.sandbox.write_file(¶ms.path, ¶ms.content).await?,
"apply_patch" => self.apply_patch(¶ms).await?,
_ => return Err(ToolError::UnknownTool(tool_call.name.clone())),
};
// 第5步:记录审计日志
self.audit_log.record(&tool_call, &result);
Ok(result)
}4.6 沙箱安全:多平台隔离
沙箱是Codex的安全底线。AI执行命令可能会搞破坏,所以必须限制它的权限。
Codex为三个平台都做了原生沙箱:
rust
// codex-rs/sandboxing/src/lib.rs
pub trait Sandbox {
    async fn exec_command(&self, cmd: &str) -> Result<CommandOutput>;
    async fn read_file(&self, path: &Path) -> Result<Vec<u8>>;
    async fn write_file(&self, path: &Path, content: &[u8]) -> Result<()>;
}

// Linux实现:使用Landlock + seccomp
// codex-rs/linux-sandbox/src/lib.rs
pub struct LinuxSandbox {
    landlock: Landlock,   // 文件系统访问控制
    seccomp: Seccomp,     // 系统调用过滤
    cgroup: Cgroup,       // 资源限制(CPU、内存)
}

// macOS实现:使用Seatbelt
// codex-rs/core/src/sandbox/macos.rs
pub struct MacOSSandbox {
    profile: SeatbeltProfile,  // 沙箱配置文件
}

// Windows实现:使用受限Token + Job Objects
// codex-rs/windows-sandbox-rs/src/lib.rs
pub struct WindowsSandbox {
    restricted_token: RestrictedToken,  // 受限访问令牌
    job_object: JobObject,              // 作业对象(资源限制)
}生活案例:沙箱就像给AI配了一个"儿童安全座椅"。它可以在座椅里活动(读写指定目录、执行允许的命令),但不能解开安全带乱跑(不能删除系统文件、不能访问网络、不能修改其他目录)。
4.7 持久化:Thread Store
Codex支持会话持久化,你可以中断一个任务,明天再继续。核心是ThreadStore:
rust
// codex-rs/thread-store/src/lib.rs
pub trait ThreadStore {
    async fn save_thread(&self, thread: &Thread) -> Result<()>;
    async fn load_thread(&self, id: &str) -> Result<Thread>;
    async fn list_threads(&self) -> Result<Vec<ThreadSummary>>;
    async fn delete_thread(&self, id: &str) -> Result<()>;
}

// 默认实现:本地文件系统,JSONL格式
pub struct FileThreadStore {
    base_dir: PathBuf,
}

// 每个Thread保存为一个目录
// thread-id/
//   ├── metadata.json    # 元信息(标题、创建时间、模型)
//   ├── events.jsonl     # 所有事件(消息、工具调用、结果)
//   └── rollout/         # rollout记录(用于调试和复现)
4.8 三层集成接口
Codex Harness开源后,提供了三层集成接口,满足不同场景的需求:
text
┌─────────────────────────────────────────────────────────┐
│  第三层:App Server(JSON-RPC 2.0)                      │
│  适合:IDE扩展、桌面App、Web应用                         │
│  特点:双向通信、实时事件流、审批请求、多客户端连接       │
├─────────────────────────────────────────────────────────┤
│  第二层:Codex SDK(TypeScript / Python)                │
│  适合:程序化编排、自定义工作流、嵌入到其他系统           │
│  特点:API调用、线程管理、流式输出、细粒度控制           │
├─────────────────────────────────────────────────────────┤
│  第一层:codex exec(命令行)                            │
│  适合:脚本、CI/CD、一次性任务                           │
│  特点:一行命令、标准输入输出、JSONL事件、最轻量         │
└─────────────────────────────────────────────────────────┘
五、Codex怎么用?常用场景教学
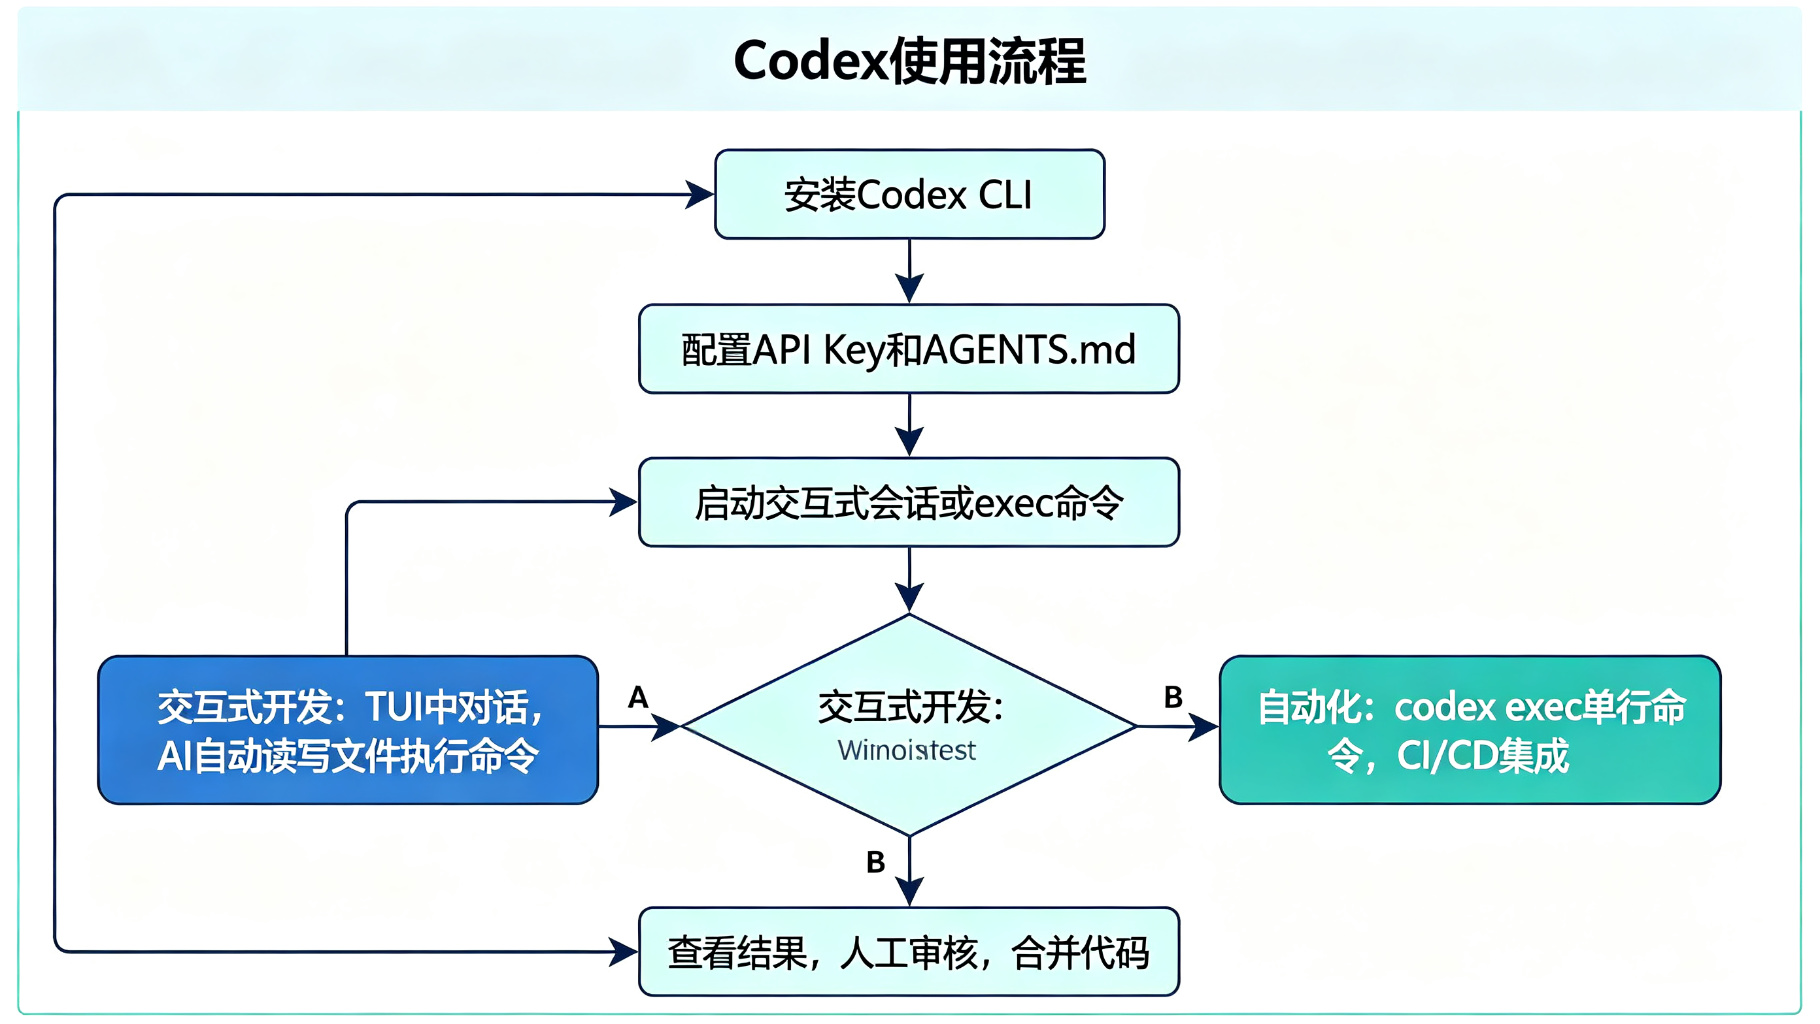
理论讲完了,现在来实操。这一部分会给你可以直接复制运行的代码。
5.1 安装与配置
安装Codex CLI
bash
# 方式1:npm安装(推荐)
npm install -g @openai/codex

# 方式2:Homebrew(macOS)
brew install openai/codex/codex

# 验证安装
codex --version
配置API Key
bash
# 方式1:交互式登录(会打开浏览器)
codex login

# 方式2:设置环境变量
export OPENAI_API_KEY="sk-your-api-key-here"

# 方式3:使用Azure OpenAI(企业常用)
export AZURE_OPENAI_API_KEY="your-azure-key"
export AZURE_OPENAI_ENDPOINT="https://your-resource.openai.azure.com"
codex --profile azure
配置文件
Codex的配置文件在~/.codex/config.toml:
toml
# ~/.codex/config.toml
model = "gpt-5.4-codex"
sandbox = "auto"  # auto, always, never

[approval]
# 哪些命令需要审批
require_approval = ["rm -rf", "git push", "npm publish"]
# 哪些命令自动允许
auto_approve = ["ls", "cat", "git status", "pytest"]

[profiles.azure]
model = "gpt-5.4-codex"
api_type = "azure"
azure_endpoint = "https://your-resource.openai.azure.com"
5.2 场景一:交互式开发(最常用)
在项目目录下启动交互式会话:
bash
cd your-project/
codex
启动后你会看到一个TUI界面,直接输入需求即可:
text
> 帮我实现一个用户注册接口,要求:
> 1. 接收用户名、邮箱、密码
> 2. 密码用bcrypt加密
> 3. 邮箱格式校验
> 4. 用户名不能重复
> 5. 写完后跑一下测试
Codex会自动:
- 查看项目结构和现有代码
- 创建或修改文件
- 安装依赖(如果需要)
- 运行测试
- 报告结果
你可以随时按Ctrl+C中断,或者输入/approve批准危险操作。
5.3 场景二:非交互式执行(codex exec)
codex exec是自动化的利器,适合脚本和CI/CD。
bash
# 基本用法:执行一个任务
codex exec "为 src/utils.py 编写单元测试"

# 完全自动模式(不需要人工审批)
codex exec --full-auto "修复所有flake8错误"

# 指定模型
codex exec --model gpt-5.4-mini "给这个函数加注释"

# 从标准输入读取内容
cat error.log | codex exec --full-auto "分析这个错误日志,找出根本原因"

# 输出JSON格式(方便脚本解析)
codex exec --json --full-auto "审查这个PR的代码质量,返回评分和建议"

# 指定输出schema(结构化输出)
codex exec --full-auto \
  --output-schema '{"type":"object","properties":{"summary":{"type":"string"},"risk_level":{"type":"string","enum":["low","medium","high"]}}}' \
  "分析这次代码变更的风险"
5.4 场景三:AGENTS.md项目配置
AGENTS.md是给AI看的"项目说明书",放在项目根目录,Codex启动时自动加载。
一个完整的模板:
markdown
# 项目说明

## 项目概述
这是一个基于FastAPI的用户管理系统,提供用户注册、登录、权限管理功能。

## 技术栈
- 语言:Python 3.11+
- Web框架:FastAPI
- ORM:SQLAlchemy 2.0
- 数据库:PostgreSQL 15
- 缓存:Redis
- 测试:pytest + pytest-asyncio
- 代码风格:black + isort + flake8

## 目录结构
src/
├── api/ # API路由
├── models/ # 数据模型
├── schemas/ # Pydantic schema
├── services/ # 业务逻辑
├── utils/ # 工具函数
└── config.py # 配置
tests/ # 测试
migrations/ # 数据库迁移
## 编码规范
- 所有函数必须有类型注解
- 所有公共函数必须有docstring
- 错误处理使用自定义异常,不要裸except
- 数据库操作必须使用异步
- 密码必须用bcrypt加密,不要明文存储

## 测试要求
- 新功能必须有对应的单元测试
- 测试覆盖率不低于80%
- 运行测试命令:pytest tests/ -v

## 禁止事项
- 不要修改migrations目录下的文件
- 不要在代码中硬编码密钥或密码
- 不要直接写SQL,必须用ORM
- 不要删除现有的测试用例

## 常用命令
- 启动开发服务器:uvicorn src.main:app --reload
- 运行测试:pytest tests/ -v
- 代码格式化:black src/ && isort src/
- 生成迁移:alembic revision --autogenerate -m "描述"
5.5 场景四:Skills技能包
Skills是可复用的技能包,可以理解为"给AI的专业培训手册"。
创建自定义Skill
bash
mkdir -p ~/.codex/skills/code-review
cat > ~/.codex/skills/code-review/SKILL.md << 'EOF'
---
name: code-review
description: 对代码进行专业审查,检查安全性、性能、可维护性
---

## 使用场景
当用户要求代码审查、code review、检查代码质量时使用。

## 审查清单
1. 安全性:SQL注入、XSS、敏感信息泄露
2. 性能:N+1查询、不必要的循环、内存泄漏
3. 可维护性:命名规范、注释、函数长度
4. 错误处理:异常捕获、错误提示、边界情况
5. 测试:是否有对应的测试用例

## 输出格式
- 总体评分(1-10分)
- 按严重程度分类的问题列表
- 每个问题的具体位置和修复建议
EOF
使用Skill
bash
# 显式调用
codex exec "$code-review 审查 src/auth.py"

# 隐式调用(Codex会自动匹配)
codex exec "帮我看看这段代码有没有问题"
5.6 场景五:MCP工具扩展
MCP(Model Context Protocol)是Anthropic提出的开放协议,Codex也支持。通过MCP,你可以给Agent接入外部工具。
配置MCP Server
json
// ~/.codex/mcp.json
{
  "mcpServers": {
    "github": {
      "command": "npx",
      "args": ["-y", "@modelcontextprotocol/server-github"],
      "env": {
        "GITHUB_PERSONAL_ACCESS_TOKEN": "ghp_your_token"
      }
    },
    "postgres": {
      "command": "npx",
      "args": ["-y", "@modelcontextprotocol/server-postgres"],
      "env": {
        "DATABASE_URL": "postgresql://user:pass@localhost:5432/mydb"
      }
    }
  }
}
配置后,Codex就可以直接操作GitHub和数据库了:
bash
codex exec "查看repo myorg/myproject的issue #123,分析问题并创建一个修复PR"六、企业项目中如何使用Codex?
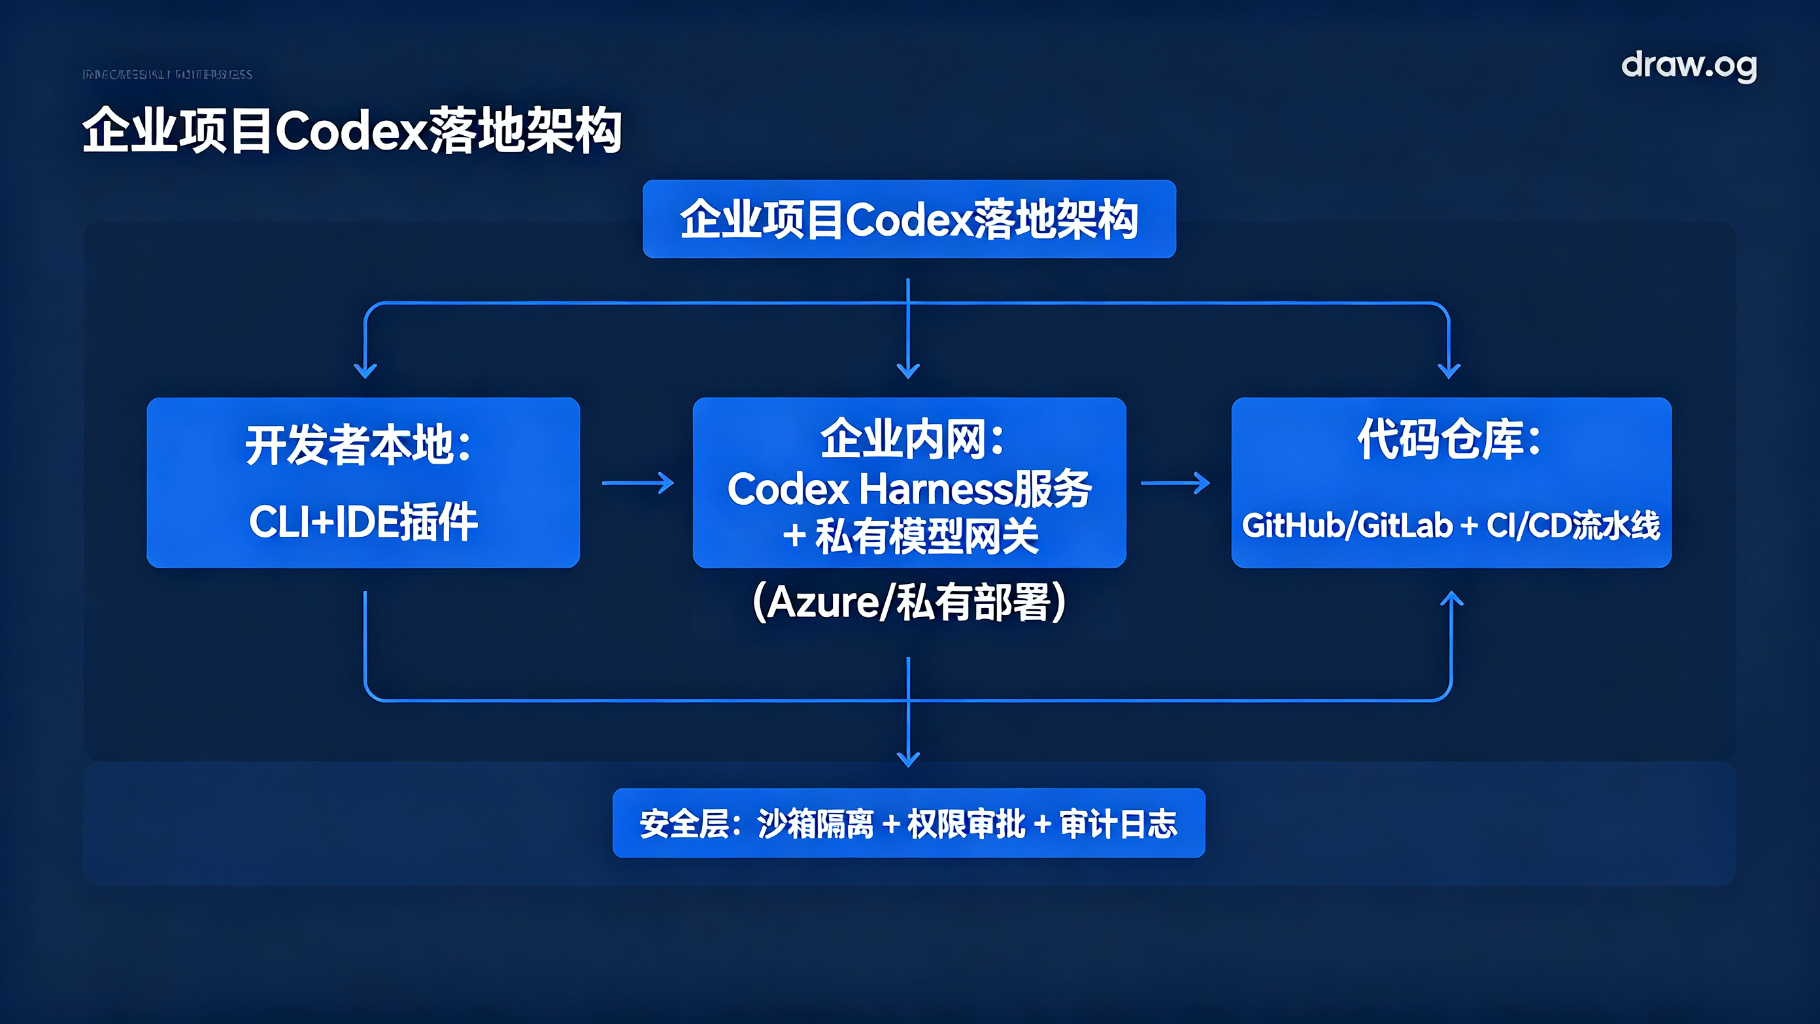
个人使用和企业使用是两回事。企业更关注安全、合规、权限、审计。这一部分讲企业级落地。
6.1 企业部署模式
企业通常有三种部署模式:
| 模式 | 说明 | 适合场景 |
|---|---|---|
| SaaS模式 | 直接用OpenAI的Codex Cloud | 中小企业、快速验证 |
| Azure模式 | 通过Azure OpenAI调用,数据在Azure | 有Azure订阅的企业、合规要求 |
| 自托管模式 | 自己部署Codex Harness + 私有模型 | 金融、政府等强合规场景 |
6.2 CI/CD集成(最实用的企业场景)
GitHub Actions集成
yaml
# .github/workflows/codex-review.yml
name: Codex Code Review

on:
  pull_request:
    branches: [main]

jobs:
  review:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
        with:
          fetch-depth: 0

      - name: Setup Node.js
        uses: actions/setup-node@v4
        with:
          node-version: '20'

      - name: Install Codex
        run: npm install -g @openai/codex

      - name: Run Codex Review
        env:
          OPENAI_API_KEY: ${{ secrets.OPENAI_API_KEY }}
        run: |
          # 获取PR的diff
          git diff origin/main...HEAD > pr.diff

          # 用Codex审查
          codex exec --full-auto --json \
            --output-schema '{"type":"object","properties":{"score":{"type":"number"},"issues":{"type":"array","items":{"type":"object","properties":{"severity":{"type":"string"},"file":{"type":"string"},"line":{"type":"number"},"description":{"type":"string"},"suggestion":{"type":"string"}}}}}}' \
            "你是一个资深代码审查员。请审查以下PR的diff,从安全性、性能、可维护性三个维度给出评分和具体问题。
            评分标准:9-10优秀,7-8良好,5-6一般,<5需要重大修改。
            Diff内容:
            $(cat pr.diff)" > review-result.json

      - name: Post Review Comment
        uses: actions/github-script@v7
        with:
          script: |
            const fs = require('fs');
            const result = JSON.parse(fs.readFileSync('review-result.json', 'utf8'));
            const issues = result.issues.map(i =>
              `- **[${i.severity}]** ${i.file}:${i.line} - ${i.description}\n  建议:${i.suggestion}`
            ).join('\n');
            github.rest.issues.createComment({
              owner: context.repo.owner,
              repo: context.repo.repo,
              issue_number: context.issue.number,
              body: `## Codex代码审查报告\n\n**综合评分:${result.score}/10**\n\n### 发现的问题\n${issues}`
            });
自动修复Lint问题
yaml
# .github/workflows/codex-fix.yml
name: Codex Auto Fix

on:
  schedule:
    - cron: '0 2 * * 1'  # 每周一凌晨2点
  workflow_dispatch:

jobs:
  fix:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4

      - name: Install Codex
        run: npm install -g @openai/codex

      - name: Run linter and fix
        env:
          OPENAI_API_KEY: ${{ secrets.OPENAI_API_KEY }}
        run: |
          # 运行flake8,把错误传给Codex修复
          flake8 src/ --output-file=lint-errors.txt || true
          codex exec --full-auto "根据以下flake8错误,修复src/目录下的代码问题。只修复报告的问题,不要做其他改动。错误信息:$(cat lint-errors.txt)"

      - name: Create Pull Request
        uses: peter-evans/create-pull-request@v6
        with:
          title: "chore: 自动修复lint错误"
          body: "由Codex自动生成的lint修复PR"
          branch: codex/auto-fix-lint
6.3 Python SDK集成(嵌入到自己的系统)
如果你想把Codex嵌入到自己的产品中,可以用官方Python SDK。
安装SDK
bash
pip install codex-sdk基本用法
python
# codex_integration.py
from codex import CodexClient
import asyncio

async def main():
    # 初始化客户端
    client = CodexClient(
        api_key="sk-your-api-key",
        model="gpt-5.4-codex",
    )

    # 创建一个线程(会话)
    thread = await client.threads.create(
        title="修复用户登录bug",
        instructions="你是一个Python后端专家,负责修复用户登录模块的bug。",
    )

    # 提交任务,流式获取事件
    task = await client.tasks.create(
        thread_id=thread.id,
        prompt="用户反馈登录时偶尔出现500错误,日志显示是数据库连接池耗尽。请分析原因并修复。",
        workspace_path="/path/to/project",
    )

    # 流式监听事件
    async for event in task.stream():
        if event.type == "message":
            print(f"[Agent] {event.content}")
        elif event.type == "tool_call":
            print(f"[Tool] {event.name}({event.arguments})")
        elif event.type == "tool_result":
            print(f"[Result] {event.result[:100]}...")
        elif event.type == "approval_request":
            # 需要人工审批
            print(f"需要审批: {event.tool_name}")
            # 可以选择批准或拒绝
            await event.approve()

    # 获取最终结果
    result = await task.result()
    print(f"任务完成: {result.summary}")
    print(f"修改的文件: {result.modified_files}")

asyncio.run(main())
批量处理任务
python
# batch_process.py
from codex import CodexClient
import asyncio

async def process_file(client: CodexClient, file_path: str):
    """为单个文件生成单元测试"""
    thread = await client.threads.create(title=f"测试 {file_path}")
    task = await client.tasks.create(
        thread_id=thread.id,
        prompt=f"为文件 {file_path} 编写单元测试,使用pytest,覆盖率达到80%以上。",
        workspace_path="/path/to/project",
    )
    result = await task.result()
    return file_path, result.summary

async def main():
    client = CodexClient(api_key="sk-your-api-key")

    # 需要处理的文件列表
    files = [
        "src/auth.py",
        "src/user.py",
        "src/order.py",
        "src/payment.py",
    ]

    # 并发处理(注意控制并发数,避免触发限流)
    semaphore = asyncio.Semaphore(3)  # 最多3个并发

    async def process_with_limit(file_path):
        async with semaphore:
            return await process_file(client, file_path)

    results = await asyncio.gather(*[process_with_limit(f) for f in files])

    for file_path, summary in results:
        print(f"{file_path}: {summary}")

asyncio.run(main())
6.4 企业安全配置
企业使用时,安全是第一位的。以下是关键的安全配置:
权限审批规则
python
# ~/.codex/rules/security.rules
# 危险操作:需要审批
prefix_rule("rm -rf /", decision="deny")
prefix_rule("git push --force", decision="deny")
prefix_rule("npm publish", decision="approve")
prefix_rule("docker run --privileged", decision="deny")

# 安全操作:自动允许
prefix_rule("ls", decision="allow")
prefix_rule("cat", decision="allow")
prefix_rule("git status", decision="allow")
prefix_rule("pytest", decision="allow")
prefix_rule("flake8", decision="allow")

# 写操作:需要审批
prefix_rule("git commit", decision="approve")
prefix_rule("git push", decision="approve")
沙箱策略
toml
# ~/.codex/config.toml
[sandbox]
# 只允许访问项目目录
allowed_directories = [
    "/path/to/project",
    "/tmp",
]

# 禁止访问的目录
denied_directories = [
    "/etc",
    "/root",
    "/home/user/.ssh",
]

# 禁止网络访问(可选)
network = "deny"

# 资源限制
max_memory_mb = 2048
max_cpu_cores = 2
max_execution_time_seconds = 300
审计日志
toml
# ~/.codex/config.toml
[audit]
enabled = true
log_file = "/var/log/codex/audit.log"
log_format = "json"

# 记录的内容
record = [
    "user_input",
    "tool_calls",
    "tool_results",
    "approval_decisions",
    "file_modifications",
]
审计日志示例:
json
{"timestamp":"2026-09-14T10:30:00Z","user":"zhangsan","action":"tool_call","tool":"shell","command":"pytest tests/","result":"success","duration_ms":1523}
{"timestamp":"2026-09-14T10:30:05Z","user":"zhangsan","action":"file_write","path":"src/auth.py","lines_added":45,"lines_removed":12}
6.5 企业落地最佳实践
- 从小范围试点开始:先在一个非核心项目中试用,积累经验后再推广。
- 制定AGENTS.md规范:统一项目配置,确保AI输出符合团队规范。
- 建立审批流程:危险操作必须人工审批,不能完全放权。
- 保留人工审核:AI生成的代码必须经过code review才能合并。
- 监控使用情况:统计使用量、成功率、节省时间,用数据说话。
- 定期培训:团队成员需要学习如何写好Prompt,如何与AI协作。
七、竞品对比:Codex vs Claude Code vs Cursor vs GitHub Copilot
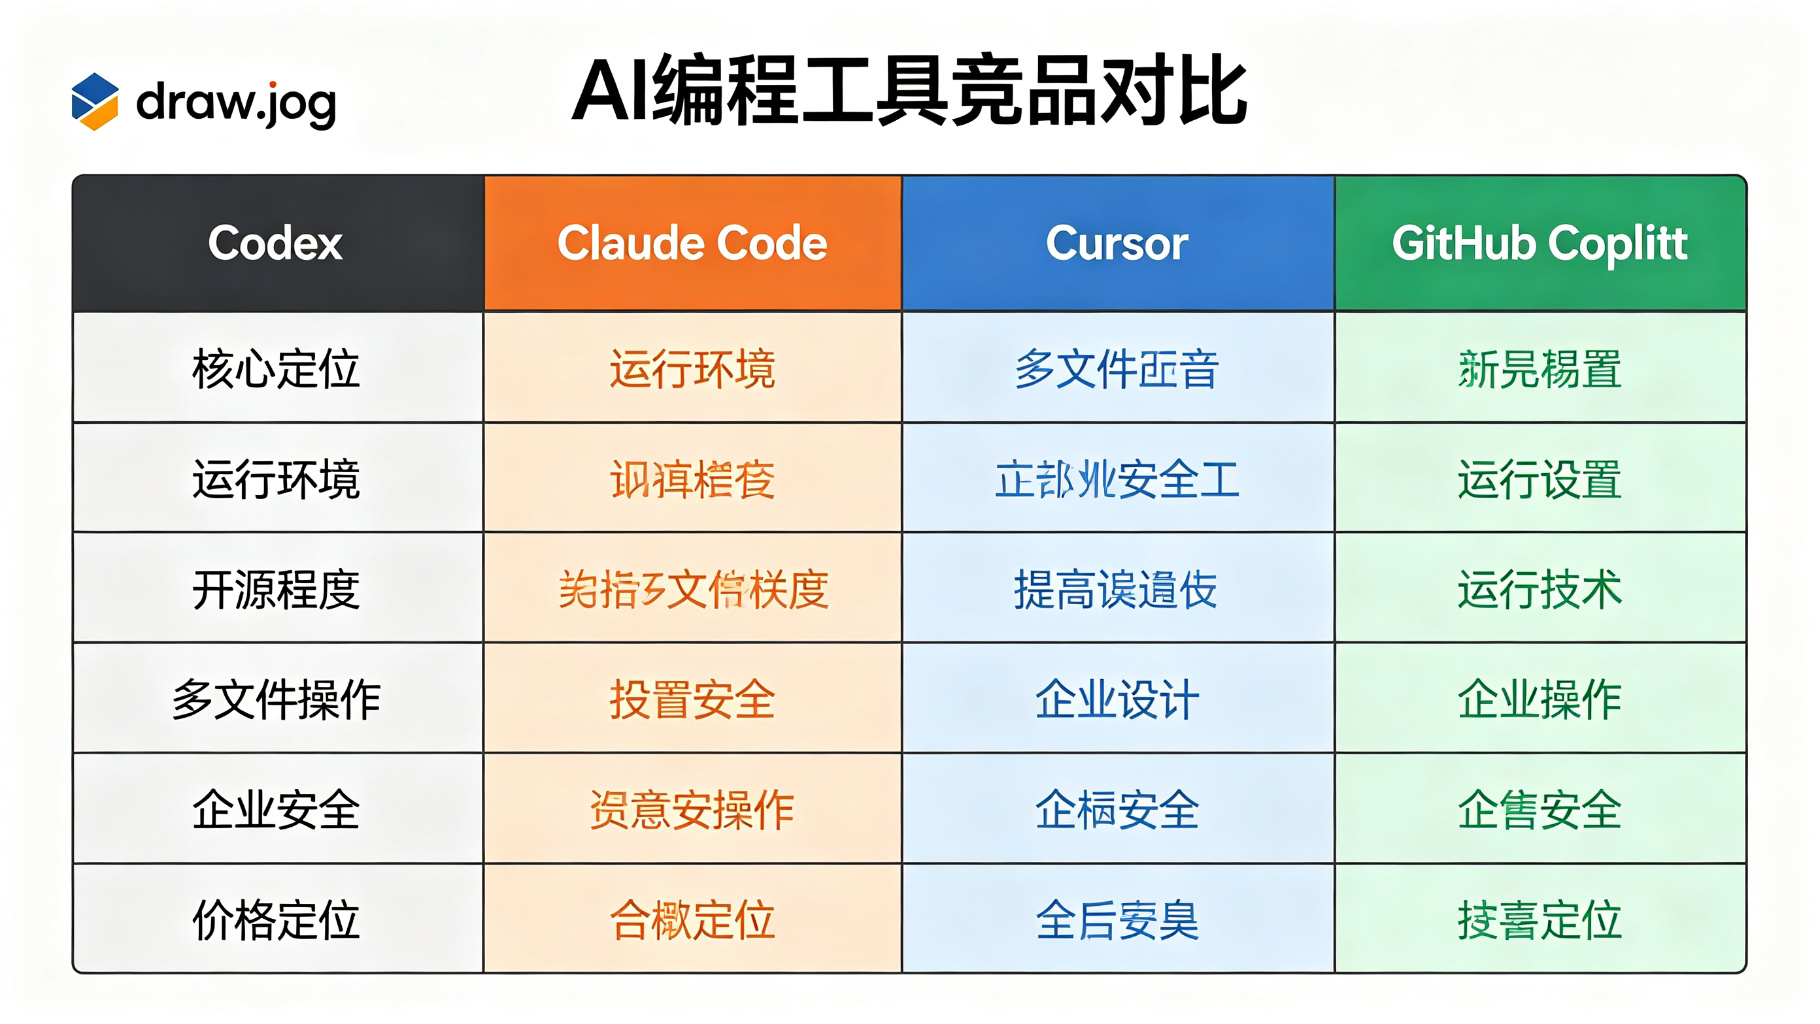
市面上AI编程工具很多,怎么选?我们来做一个全面的对比。
7.1 核心参数对比表
| 对比维度 | Codex | Claude Code | Cursor | GitHub Copilot |
|---|---|---|---|---|
| 出品方 | OpenAI | Anthropic | Cursor Inc. | GitHub/Microsoft |
| 核心定位 | 全栈软件工程Agent | 终端优先的编程Agent | AI-first IDE | 代码补全+轻量Agent |
| 运行环境 | 本地CLI + 云端沙箱 | 本地终端 | IDE内 | IDE内 |
| 开源程度 | Harness核心开源(Apache-2.0) | 闭源 | 闭源 | 闭源 |
| 支持模型 | 仅OpenAI模型 | 仅Claude模型 | Claude/GPT/Gemini多模型 | GPT/Claude多模型 |
| 多文件操作 | 强,自动规划 | 最强,全仓库理解 | 强,IDE集成 | 有限 |
| 上下文窗口 | 模型相关(最高200K+) | 200K + 自动压缩 | 模型相关 | 64K(Pro+) |
| 沙箱安全 | 原生多平台沙箱 | 本地执行,权限提示 | 本地执行 | 本地执行 |
| CI/CD集成 | 原生支持(codex exec) | 支持(CLI) | 不支持 | 有限支持 |
| 企业功能 | 完善中 | 成熟 | 成长中 | 最成熟 |
| MCP支持 | 支持 | 支持(首创) | 支持 | 支持 |
| 价格(个人) | $200/月(Pro) | $20/月(Max)或API计费 | $20/月 | $10/月(Pro) |
| 适合人群 | 需要自动化和企业集成的团队 | 终端重度用户、复杂重构 | 喜欢IDE交互的开发者 | 企业团队、GitHub重度用户 |
7.2 各工具优劣势分析
Codex
优势:
- 核心开源,可以二次开发和嵌入
- 原生支持CI/CD,自动化能力最强
- 三层集成接口,适配各种场景
- OpenAI生态原生集成(ChatGPT、API)
- 云端沙箱,可以并行处理大任务
劣势:
- 价格较高,个人版$200/月
- 只能用OpenAI模型,不能切换
- 企业功能还在完善中
- TUI界面学习成本较高
Claude Code
优势:
- Claude模型代码理解能力强,复杂重构表现好
- 终端优先,与Git/Shell集成紧密
- MCP协议的首创者,生态丰富
- 价格相对合理
劣势:
- 闭源,不能自定义核心逻辑
- 只能用Claude模型
- 没有云端沙箱,大任务受本地资源限制
- 企业合规功能不如Copilot成熟
Cursor
优势:
- IDE体验最好,交互流畅
- 支持多模型切换
- Tab补全+Agent+内联编辑一体化
- 上手门槛低
劣势:
- 闭源,定制能力弱
- Token消耗较大
- 不适合CI/CD自动化
- 重度依赖IDE,不适合服务器环境
GitHub Copilot
优势:
- 企业生态最成熟,合规方案完善
- 与GitHub深度集成(PR、Issue、Actions)
- 价格便宜,$10/月起
- 多编辑器支持(VS Code、JetBrains等)
- Microsoft企业渠道分发
劣势:
- Agent能力相对较弱,更偏补全
- 闭源,不能自定义
- 多文件操作能力有限
- 复杂任务需要人工引导较多
7.3 选型建议
- 如果你是个人开发者,预算有限:选GitHub Copilot,性价比最高。
- 如果你是终端重度用户,经常做复杂重构:选Claude Code。
- 如果你喜欢IDE内交互,想要一体化体验:选Cursor。
- 如果你需要CI/CD自动化、企业集成、或者想自己定制Agent:选Codex。
- 如果你的团队已经深度使用GitHub,重视企业合规:选GitHub Copilot。
很多团队的实际做法是:Copilot做日常补全 + Codex做自动化任务 + Claude Code做复杂重构,三者配合使用。
八、面试官高频面试题
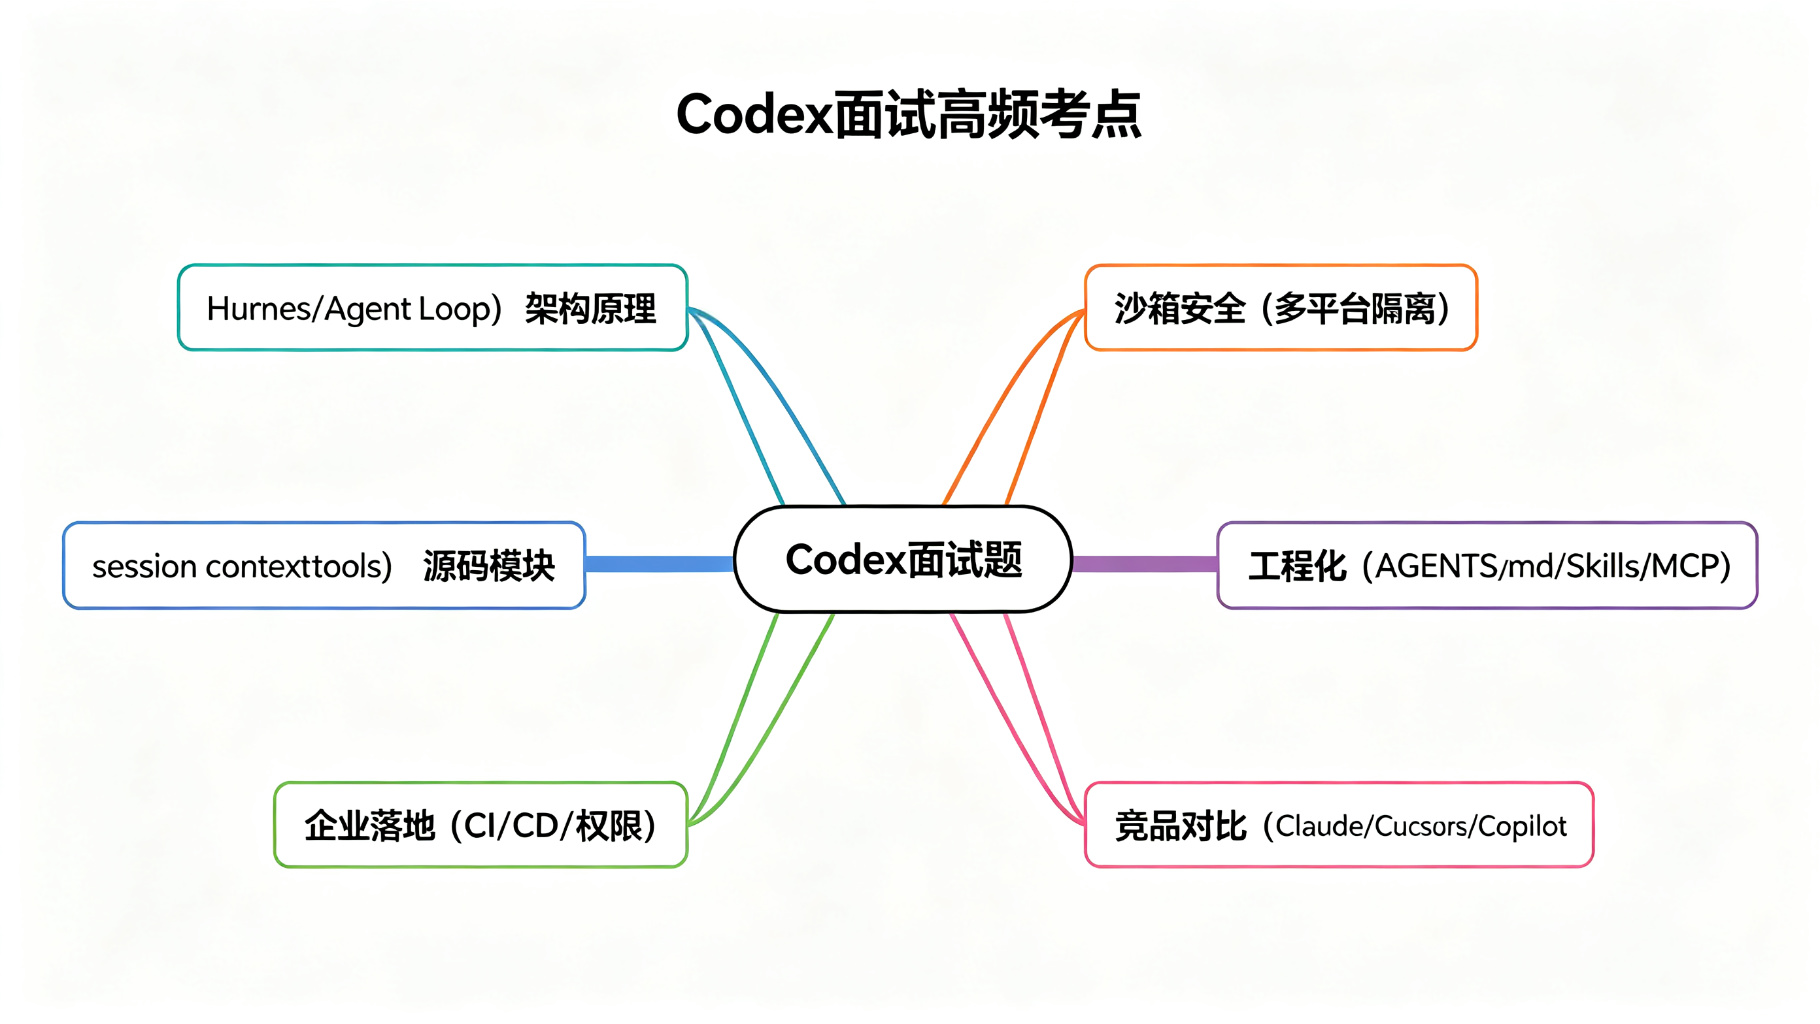
最近AI Agent岗位面试中,Codex相关的问题越来越多。以下是高频面试题和参考答案。
8.1 基础概念题
Q1:Codex和传统的代码补全工具有什么本质区别?
A:核心区别在于"工具"和"Agent"的区别:
- 代码补全工具(如早期Copilot)是被动的,你写它补,不理解全局上下文,不会执行操作。
- Codex是主动的Agent,你给一个任务,它自己规划、自己调用工具(读写文件、执行命令)、自己验证结果、自己修正错误,直到完成任务。
- 本质上是从" autocomplete "到" autonomous "的转变。
Q2:Codex的Agent Loop是怎么工作的?
A:Agent Loop采用ReAct模式,核心循环是:
- 构建上下文(系统提示词+历史+工具定义+项目规范)
- 调用模型,获取响应
- 如果是文本回答,结束本轮
- 如果是工具调用,检查权限,在沙箱中执行
- 把工具结果加入上下文,回到第2步
- 直到模型给出最终回答或达到最大步数
关键源码在codex-rs/core/session/turn.rs的run_turn函数。
8.2 架构设计题
Q3:Codex为什么用Rust重写核心,而不是继续用TypeScript?
A:主要有几个原因:
- 性能:Agent Loop是CPU密集型的,Rust的性能远高于TypeScript。
- 零依赖部署:Rust编译成单个二进制文件,不需要Node.js环境,安装简单。
- 沙箱原生绑定:Rust可以直接调用操作系统的沙箱API(Landlock、Seatbelt、Job Objects),TypeScript需要通过原生模块间接调用。
- 内存安全:Agent执行不可信的模型输出,Rust的内存安全特性可以减少漏洞。
- 并发模型:Rust的async/await和所有权系统适合高并发的工具执行场景。
Q4:Codex的上下文管理是怎么做的?上下文不够了怎么办?
A:Codex的ContextManager采用分层策略:
- 系统提示词和工具定义永远保留(这些是"宪法",不能丢)
- AGENTS.md项目规范永远保留
- 最近N轮对话完整保留
- 更早的对话压缩成摘要
- 如果还超预算,继续按层压缩,从最不重要的开始
- 最终保证在模型的上下文窗口内
压缩的方式通常是让模型自己总结历史,生成摘要。
Q5:Codex的沙箱是怎么实现的?为什么需要沙箱?
A:需要沙箱是因为AI执行的命令是模型生成的,不可信,可能会搞破坏(比如删文件、访问敏感数据)。
Codex为三个平台做了原生实现:
- Linux:Landlock(文件系统访问控制)+ seccomp(系统调用过滤)+ cgroup(资源限制)
- macOS:Seatbelt(沙箱配置文件)
- Windows:受限Token(降低权限)+ Job Objects(资源限制)
沙箱限制了Agent可以访问的目录、可以执行的系统调用、可以使用的资源,确保即使模型输出恶意命令,也不会造成严重后果。
8.3 工程实践题
Q6:AGENTS.md和README有什么区别?怎么写好AGENTS.md?
A:区别:
- README是给人看的,侧重项目介绍、使用方法。
- AGENTS.md是给AI看的,侧重编码规范、目录结构、禁止事项、常用命令。
写好AGENTS.md的要点:
- 明确技术栈和版本
- 说明目录结构,让AI知道去哪找代码
- 写清楚编码规范(命名、注释、错误处理)
- 列出禁止事项(不要改什么、不要做什么)
- 给出常用命令(测试、构建、格式化)
- 不要写废话,AI的上下文是有限的
Q7:在CI/CD中使用Codex需要注意什么?
A:几个关键点:
- API Key安全:存在Secrets中,不要硬编码
- 权限控制 :CI环境中用
--full-auto,但要限制能执行的命令 - 超时控制:设置最大执行时间,防止死循环
- 幂等性:确保任务可以重复执行而不产生副作用
- 结果验证:AI生成的代码必须跑测试,不能直接合并
- 限流处理:批量任务要控制并发数,避免触发API限流
- 审计日志:记录所有操作,便于追溯
Q8:怎么评估Codex的效果?有哪些指标?
A:可以从几个维度评估:
- 任务完成率:给定任务,有多少比例能独立完成
- 代码质量:生成代码的bug率、code review通过率
- 时间节省:相比人工,节省了多少时间
- 迭代次数:平均需要多少轮对话才能完成任务
- 测试覆盖率:生成代码的测试覆盖情况
- 用户满意度:开发者的主观评价
常用的基准测试有SWE-bench(软件工程任务)、HumanEval(单函数编程)等。
8.4 深度思考题
Q9:Codex的局限性是什么?未来可能怎么发展?
A:当前局限性:
- 上下文窗口有限:超大型项目还是无法全部加载
- 模型幻觉:有时会生成不存在的API或错误的逻辑
- 复杂推理能力不足:需要深度架构设计的任务还做不好
- 成本较高:大任务的Token消耗很大
- 安全性:即使有沙箱,prompt注入等攻击仍然存在
未来发展方向:
- 更长的上下文:模型上下文窗口不断扩大
- 多Agent协作:一个主Agent调度多个子Agent,分工合作
- 更强的工具使用:接入更多外部系统(数据库、API、云服务)
- 自我改进:Agent能从错误中学习,不断优化
- 更完善的企业功能:权限、审计、合规、私有化部署
Q10:如果让你自己设计一个Coding Agent,你会怎么设计?
A:参考Codex的架构,我会这样设计:
- 核心循环:ReAct模式,思考->行动->观察->再思考
- 上下文管理:分层保留+智能压缩,优先保留高价值信息
- 工具系统:可扩展的工具注册机制,支持MCP协议
- 沙箱隔离:多平台原生沙箱,确保安全
- 持久化:会话保存和恢复,支持中断后继续
- 权限系统:细粒度的工具执行权限和审批流程
- 多前端:核心与UI分离,CLI/IDE/Web共享同一核心
- 可观测性:完整的事件日志和调试工具,便于排查问题
- 插件系统:支持第三方扩展,不修改核心代码
- 企业级特性:审计、监控、团队协作、私有化部署
九、总结
通过这篇文章,我们从源码层面深度解读了Codex:
- 是什么:Codex是OpenAI开源的生产级Coding Agent运行时,用Rust实现,核心是Harness。
- 为什么用:解决读代码慢、重复劳动多、质量参差不齐、调试耗时等痛点。
- 演进历程:从2021年的代码补全模型,到2025年的CLI Agent,再到2026年Harness全面开源。
- 源码架构:Thread/Session/Turn/Step四层概念,Agent Loop核心循环,ContextManager上下文管理,Tool Runtime工具调度,多平台沙箱,Thread Store持久化。
- 怎么用:交互式开发、codex exec自动化、AGENTS.md配置、Skills技能包、MCP工具扩展。
- 企业落地:CI/CD集成、Python SDK嵌入、安全配置、审计日志。
- 竞品对比:Codex vs Claude Code vs Cursor vs GitHub Copilot,各有优劣,按需选择。
- 面试题:从基础概念到架构设计到工程实践,覆盖高频考点。
最后想说的是:AI不会取代程序员,但会用AI的程序员会取代不会用AI的程序员。
Codex这样的工具,本质上是把程序员从机械性劳动中解放出来,让我们能专注于真正需要创造力和判断力的工作。越早掌握这些工具,就越能在未来的竞争中占据优势。
现在就去安装Codex,在你的项目里试试吧。记住,最好的学习方式就是动手。
转载声明:本文为原创文章,如需转载,请联系作者获得授权,并注明出处。