给一段音频和它的文本转写,要标出每句话在音频里的起止时间戳 ------这类需求在 TTS 训练数据清洗、字幕生成、发音评测、视频配音时间对齐里都反复出现。开源生态里做这件事的工具不少,但跨语种、边界精度、覆盖率上的差距非常大。这一篇拿 3 语种 6 条真实音频 · 20 个 GT 句段 · 5 个开源 forced aligner 做了一轮横评:MMS_FA / WhisperX / whisper-timestamped / NeMo Forced Aligner / aeneas。
一、音频与语料
测试集 6 条 wav,涵盖中/英/日 三个语种,长度 8-25 秒,内容包括:中文自我介绍、拼音教学、英文讲课、英文冥想引导、日文平假名讲解、日文占星长段。共 20 句 ------ 每句都配了人工标的 start / end 时间戳作为对齐 gold(Audacity 波形拉边界 · ~50 ms 精度 · 语气词/停顿归属存在主观判断)。
统计:中文 7 句、英文 5 句、日文 8 句。原始音频 40 kHz stereo,进模型前统一 downsample 到 16 kHz mono(各系统 loader 里自动处理或脚本手动 resample+downmix)。
指标口径 :每句算 |Δstart| = |系统预测起点 − 人工 gold 起点|、|Δend| = |系统预测终点 − 人工 gold 终点|,按系统 × 语种聚合成中位数。越小越准。
规模 caveat:这只是行为差异的演示样本,不代表这几个系统在千小时级 benchmark 上的排名。生产落地前请按实际语料重测。硬件口径:桌面级 GPU(MMS_FA / WhisperX / whisper-timestamped / NeMo)· CPU(aeneas)· 5 个系统单条音频秒级出结果,性能不是这一轮的比较维度。
二、5 个系统介绍
先立个速查表,后面每节展开:
| 系统 | 底座 | 语种覆盖 | 需要什么 | 定位 |
|---|---|---|---|---|
| MMS_FA | Wav2Vec2 CTC + uroman | 1130 语 | 音频 + 文本(任意语种) | 通用 forced alignment |
| WhisperX | Whisper ASR + wav2vec2 词级对齐 | ~99 语 | 音频(可选文本) | ASR + 对齐一体 |
| whisper-timestamped | Whisper + cross-attention DTW | ~99 语 | 音频(转写自出) | 纯 Whisper 生态 |
| NeMo NFA | NeMo CTC | 官方 pretrained 仅英文/欧洲多语种 | 音频 + 文本 | 生产级 forced alignment |
| aeneas | DTW + eSpeak TTS | ~30 语(看 eSpeak 覆盖) | 音频 + 文本 | CPU 下限 baseline |
2.1 MMS_FA
- 仓库
github.com/pytorch/audio· torchaudio.pipelines.MMS_FA - 论文 Pratap et al., Scaling Speech Technology to 1,000+ Languages, arxiv:2305.13516(Meta AI · MMS 项目 · 2023)
- License CC-BY-NC 4.0(禁商用)
- 架构 Wav2Vec2 CTC · 词表 27 拉丁字符(
a-z + ')· blank token- - 多语种做法 :非拉丁语种(中文/日文/韩文/阿拉伯文......)先用 uroman 通用罗马化器转成拉丁字符再对齐。论文口径覆盖 1000+ 语言,torchaudio 的 MMS_FA bundle 标称 1130 语。
输入输出:
# 实跑(本地脚本片段,略去 batch/CUDA 细节)
import torch, torchaudio
import torchaudio.functional as F
from torchaudio.pipelines import MMS_FA as bundle
from uroman import uroman

model = bundle.get_model(with_star=True).to("cuda").eval()
DICT  = bundle.get_dict(star="*")

# 音频 → 16 kHz mono float32(原始 40 kHz stereo 要显式 resample + downmix)
waveform, sr = torchaudio.load("audio.wav")
if sr != bundle.sample_rate:
    waveform = torchaudio.functional.resample(waveform, sr, bundle.sample_rate)
if waveform.shape[0] > 1:
    waveform = waveform.mean(0, keepdim=True)

# 文本 → romanize → char-level token ids(保留 a-z + apostrophe,词表里有 )
import re
romanized = uroman("你看,它这个是从ü开始发音", language="zho").lower()
# → "nikan, tazhegeshiconguekaishifayin"
clean = re.sub(r"[^a-z']+", " ", romanized)
tokens = [DICT.get(c, DICT["*"]) for c in clean if c != " "]

# forward → forced align
with torch.inference_mode():
    emission, _ = model(waveform.to("cuda"))
aligned, scores = F.forced_align(emission, torch.tensor([tokens], device="cuda"), blank=0)
注意 :MMS_FA 不像常见 wav2vec2 ASR bundle 那样有 | word boundary token ------ 分句只能靠每句字符数在 token 序列上切。
2.2 WhisperX
- 仓库
github.com/m-bain/whisperX· BSD-4-Clause - 论文 Bain et al., WhisperX: Time-Accurate Speech Transcription of Long-Form Audio, arxiv:2303.00747 · Interspeech 2023
- 架构 Whisper 转写 + language-specific wav2vec2 CTC 词级对齐 + VAD 断句
- 定位:ASR + 对齐一体化,主要解决"Whisper 词级时间戳不准"的问题
输入输出:
# 实跑
import whisperx
audio = whisperx.load_audio("audio.wav")
model_a, meta_a = whisperx.load_align_model(language_code="zh", device="cuda")

# 把 GT 文本拼成一个大 seg,喂给 [0, duration],让 whisperx 在整段做词级对齐
segments = [{"text": full_text, "start": 0.0, "end": len(audio)/16000}]
result = whisperx.align(segments, model_a, meta_a, audio, "cuda",
                       return_char_alignments=True)
# result["segments"][0]["words"] 里每项含 start/end/score(word 字段名以安装版本为准)已知问题:在本文这套「把整段 GT 拼成一个大 seg 输入 + 按 unit 数回切」的用法下,英文长段有时会 backtrack 失败------5 句英文 seg 只出了 2 句时间戳。具体原因需结合 raw align log 与版本进一步确认,不作为通用性结论。
2.3 whisper-timestamped
- 仓库
github.com/linto-ai/whisper-timestamped· AGPL-3.0 - 引用 Louradour, whisper-timestamped, GitHub, 2023(无独立 arxiv 论文;底层用 Radford et al., Whisper, arxiv:2212.04356 + DTW)
- 架构 纯 Whisper 单模型 · 通过分析 cross-attention 权重的 DTW 从注意力里读出词级时间戳 · 不外挂 wav2vec2
输入输出:
# 实跑
import whisper_timestamped as whisper
model = whisper.load_model("medium", device="cuda")
audio = whisper.load_audio("audio.wav")
result = whisper.transcribe(model, audio, language="ja",
                            vad=False, condition_on_previous_text=False)
# result["segments"][i]["words"] = [{"text":..., "start":..., "end":..., "confidence":...}, ...]
关键差异 :它是 ASR-then-align,不是"给文本对时间戳"------ 音频里说什么它就转写什么,之后我们把 GT 句按 word/char 数从 ASR 结果里切段回来。转写和 GT 不一致的地方无法回填。
2.4 NeMo Forced Aligner (NFA)
- 仓库
github.com/NVIDIA/NeMo· tools/nemo_forced_aligner/ - 博客 NVIDIA NeMo Forced Alignment Blog(nvidia.github.io/NeMo/blogs/2023/2023-08-forced-alignment/)· Apache-2.0
- 架构 任意 NeMo CTC 模型 + Viterbi 强制解码 · 输出 CTM (token / word / segment 三级)
输入输出:
# 实跑
python NeMo/tools/nemo_forced_aligner/align.py \
  pretrained_name=stt_en_fastconformer_hybrid_large_pc \
  manifest_filepath=manifest.jsonl \
  output_dir=out/ \
  save_output_file_formats=[ctm]

# manifest.jsonl 每行:
# {"audio_filepath": "audio.wav", "text": "The grasp of ..."}
# out/ctm/segments/<uttid>.ctm 每行:  uttid A start dur text
硬伤 :本文使用的 NeMo 官方 pretrained CTC 配置(stt_en_fastconformer_hybrid_large_pc)只在英文跑通;中文、日文没有找到可直接调用的官方 CTC checkpoint,本文按 miss 处理。要用 NeMo 做非英语对齐,需要自训或找社区权重。
2.5 aeneas
- 仓库
github.com/readbeyond/aeneas· AGPL-3.0 - 原理 : 1. 用 eSpeak / eSpeak-ng 把参考文本合成成"假声"波形 2. 假声跟真实音频做 DTW(动态时间规整) 对齐 3. 从 DTW 路径反推每段文字的起止
输入输出:
# 实跑
python -m aeneas.tools.execute_task \
  audio.wav text.txt \
  "task_language=cmn|is_text_type=plain|os_task_file_format=json" \
  sync_map.json
# text.txt 每行一句 GT;sync_map.json 的 fragments[i] = {"begin", "end", "lines"}
注意 1 :aeneas 内置的 espeak TTS 不支持日文 ,日文要切到 espeak-ng backend;而且 aeneas 的 wrapper 语言映射表里没有 jpn → ja,需要 monkey-patch 一行才能跑起来。
注意 2 :aeneas 段与段之间没有 gap ------ DTW 路径连续,句间静音全部被塞进相邻段。表现出来就是 seg[i].end == seg[i+1].start。这在长停顿场景下会把 Δend 拉飞。
三、单条对齐结果 · 6 张时间轴图
每张图上方是波形 + 手工 gold 时间轴(浅蓝底),下方是 6 条 gantt 轨:manual (人工) · MMS_FA · WhisperX · whisper-ts · NeMo NFA · aeneas。手工 gold 边界用蓝色虚线延伸到 gantt 里做对齐参考。
3.1 中文 · 自我介绍
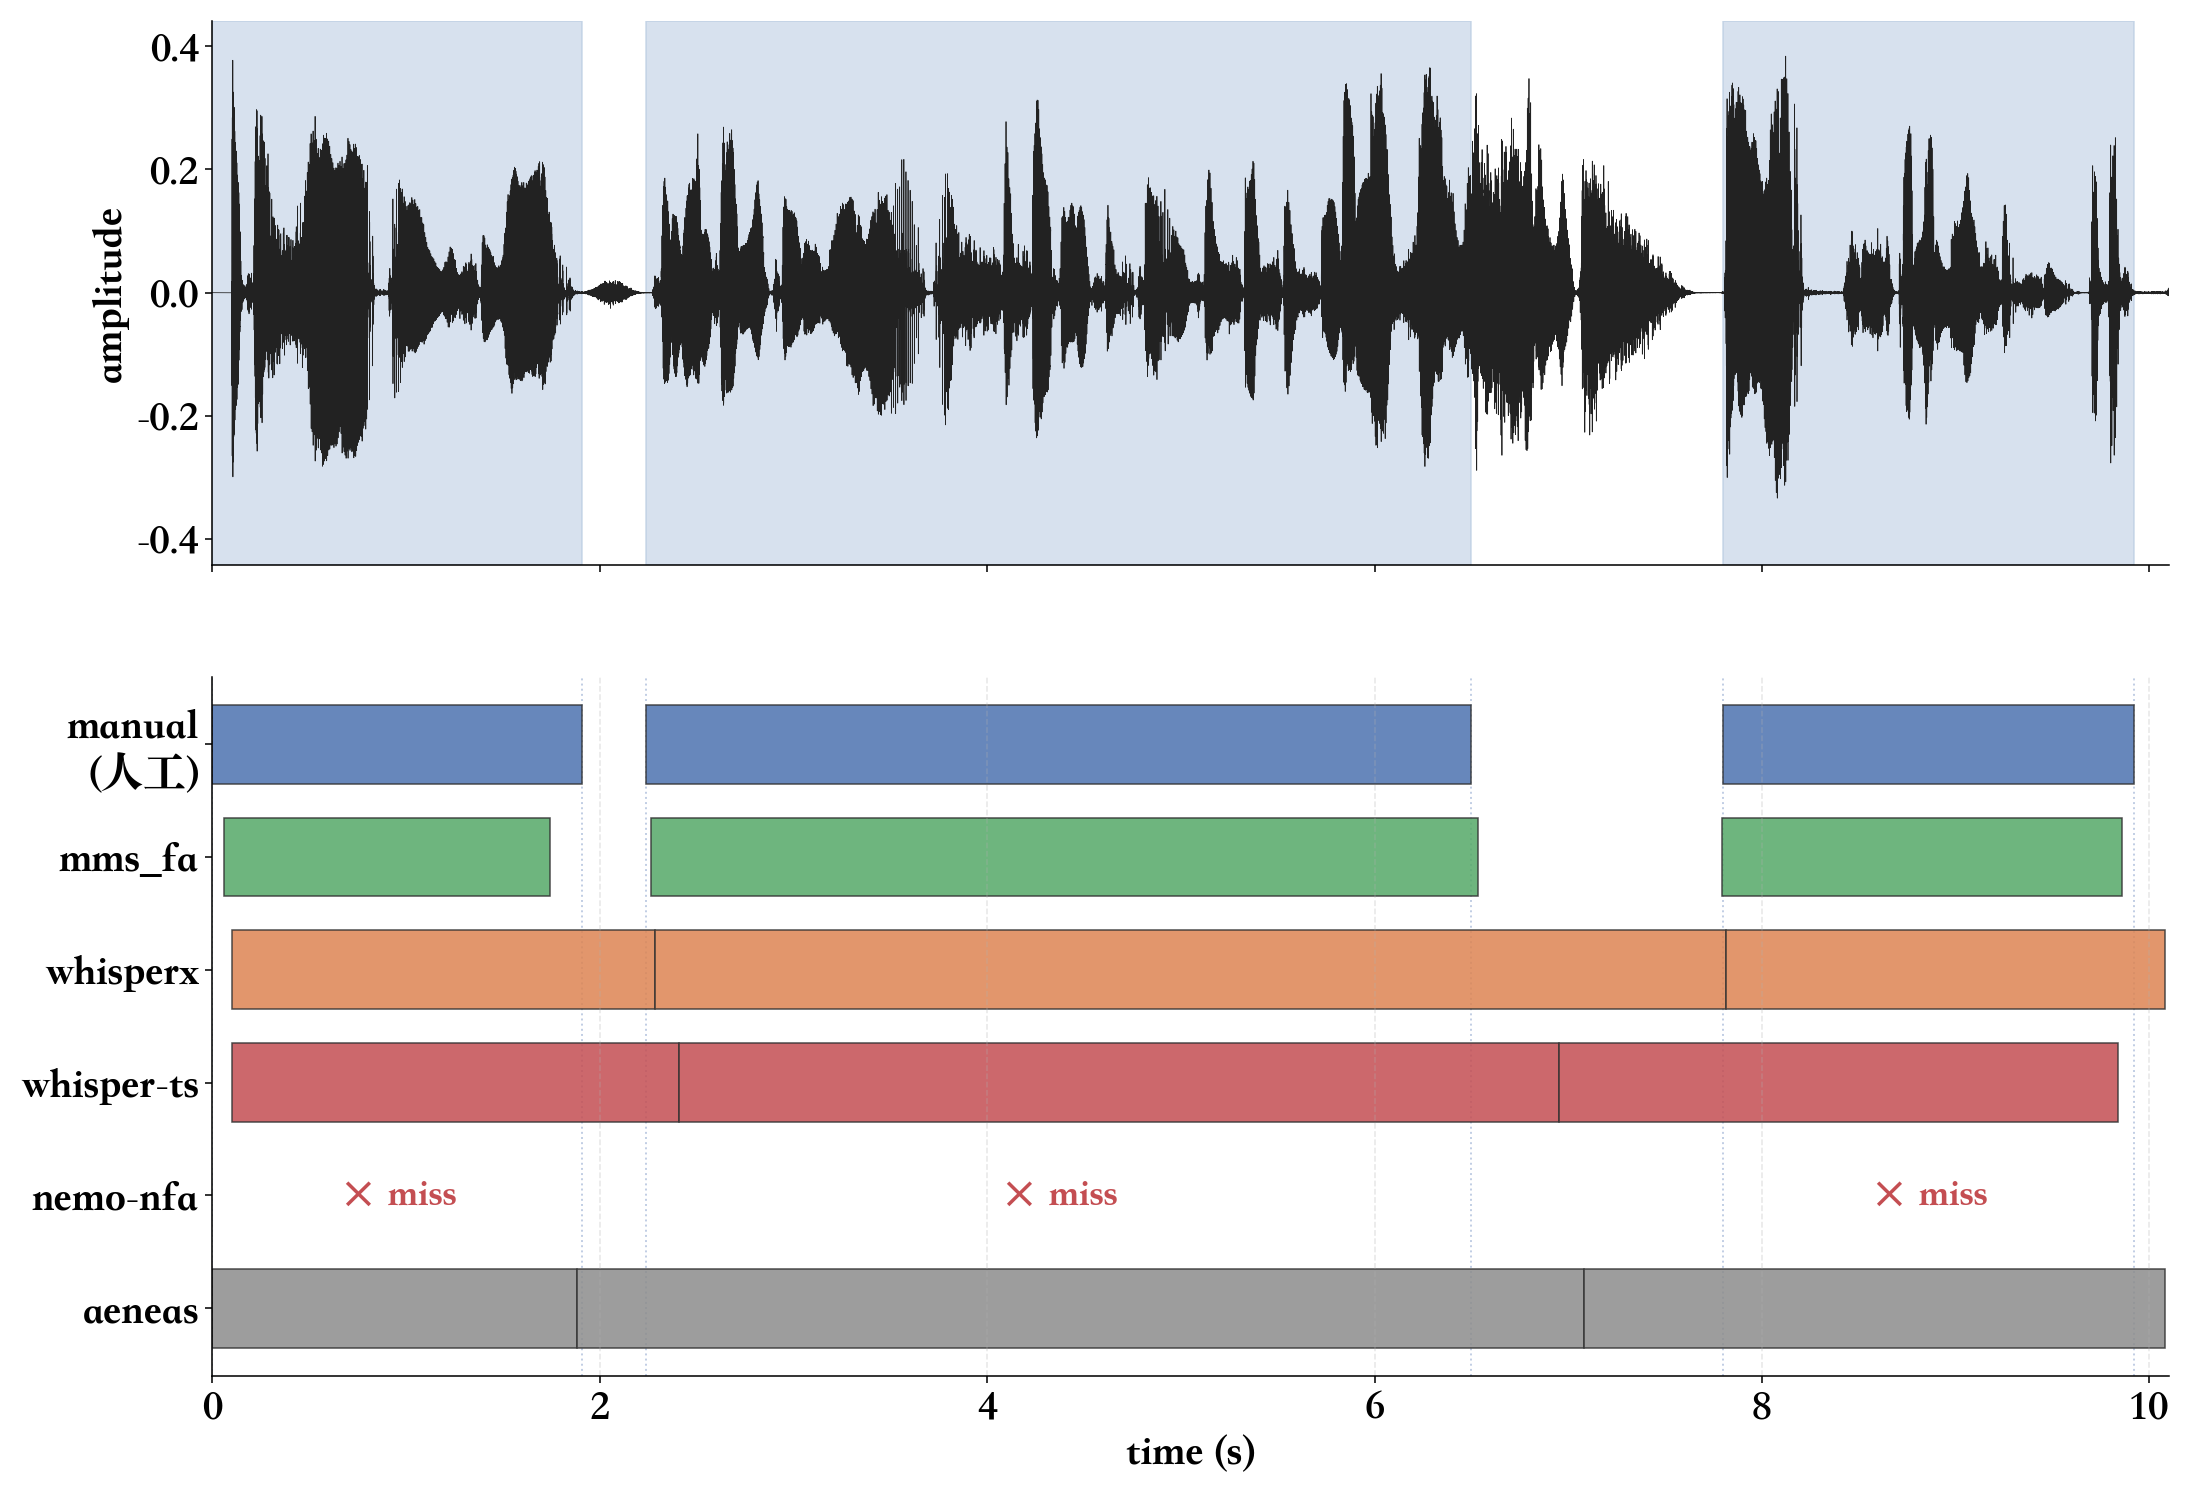
3 段清晰的中文口语,语速平缓。读图 :MMS_FA 3 段跟人工 gold 完美贴合;whisperx / whisper-ts / aeneas 段与段之间没有缝(句间的呼吸停顿全被塞进相邻段),Δend 因此偏大;NeMo 官方无中文 CTC,3 段全 miss。
3.2 中文 · 拼音教学
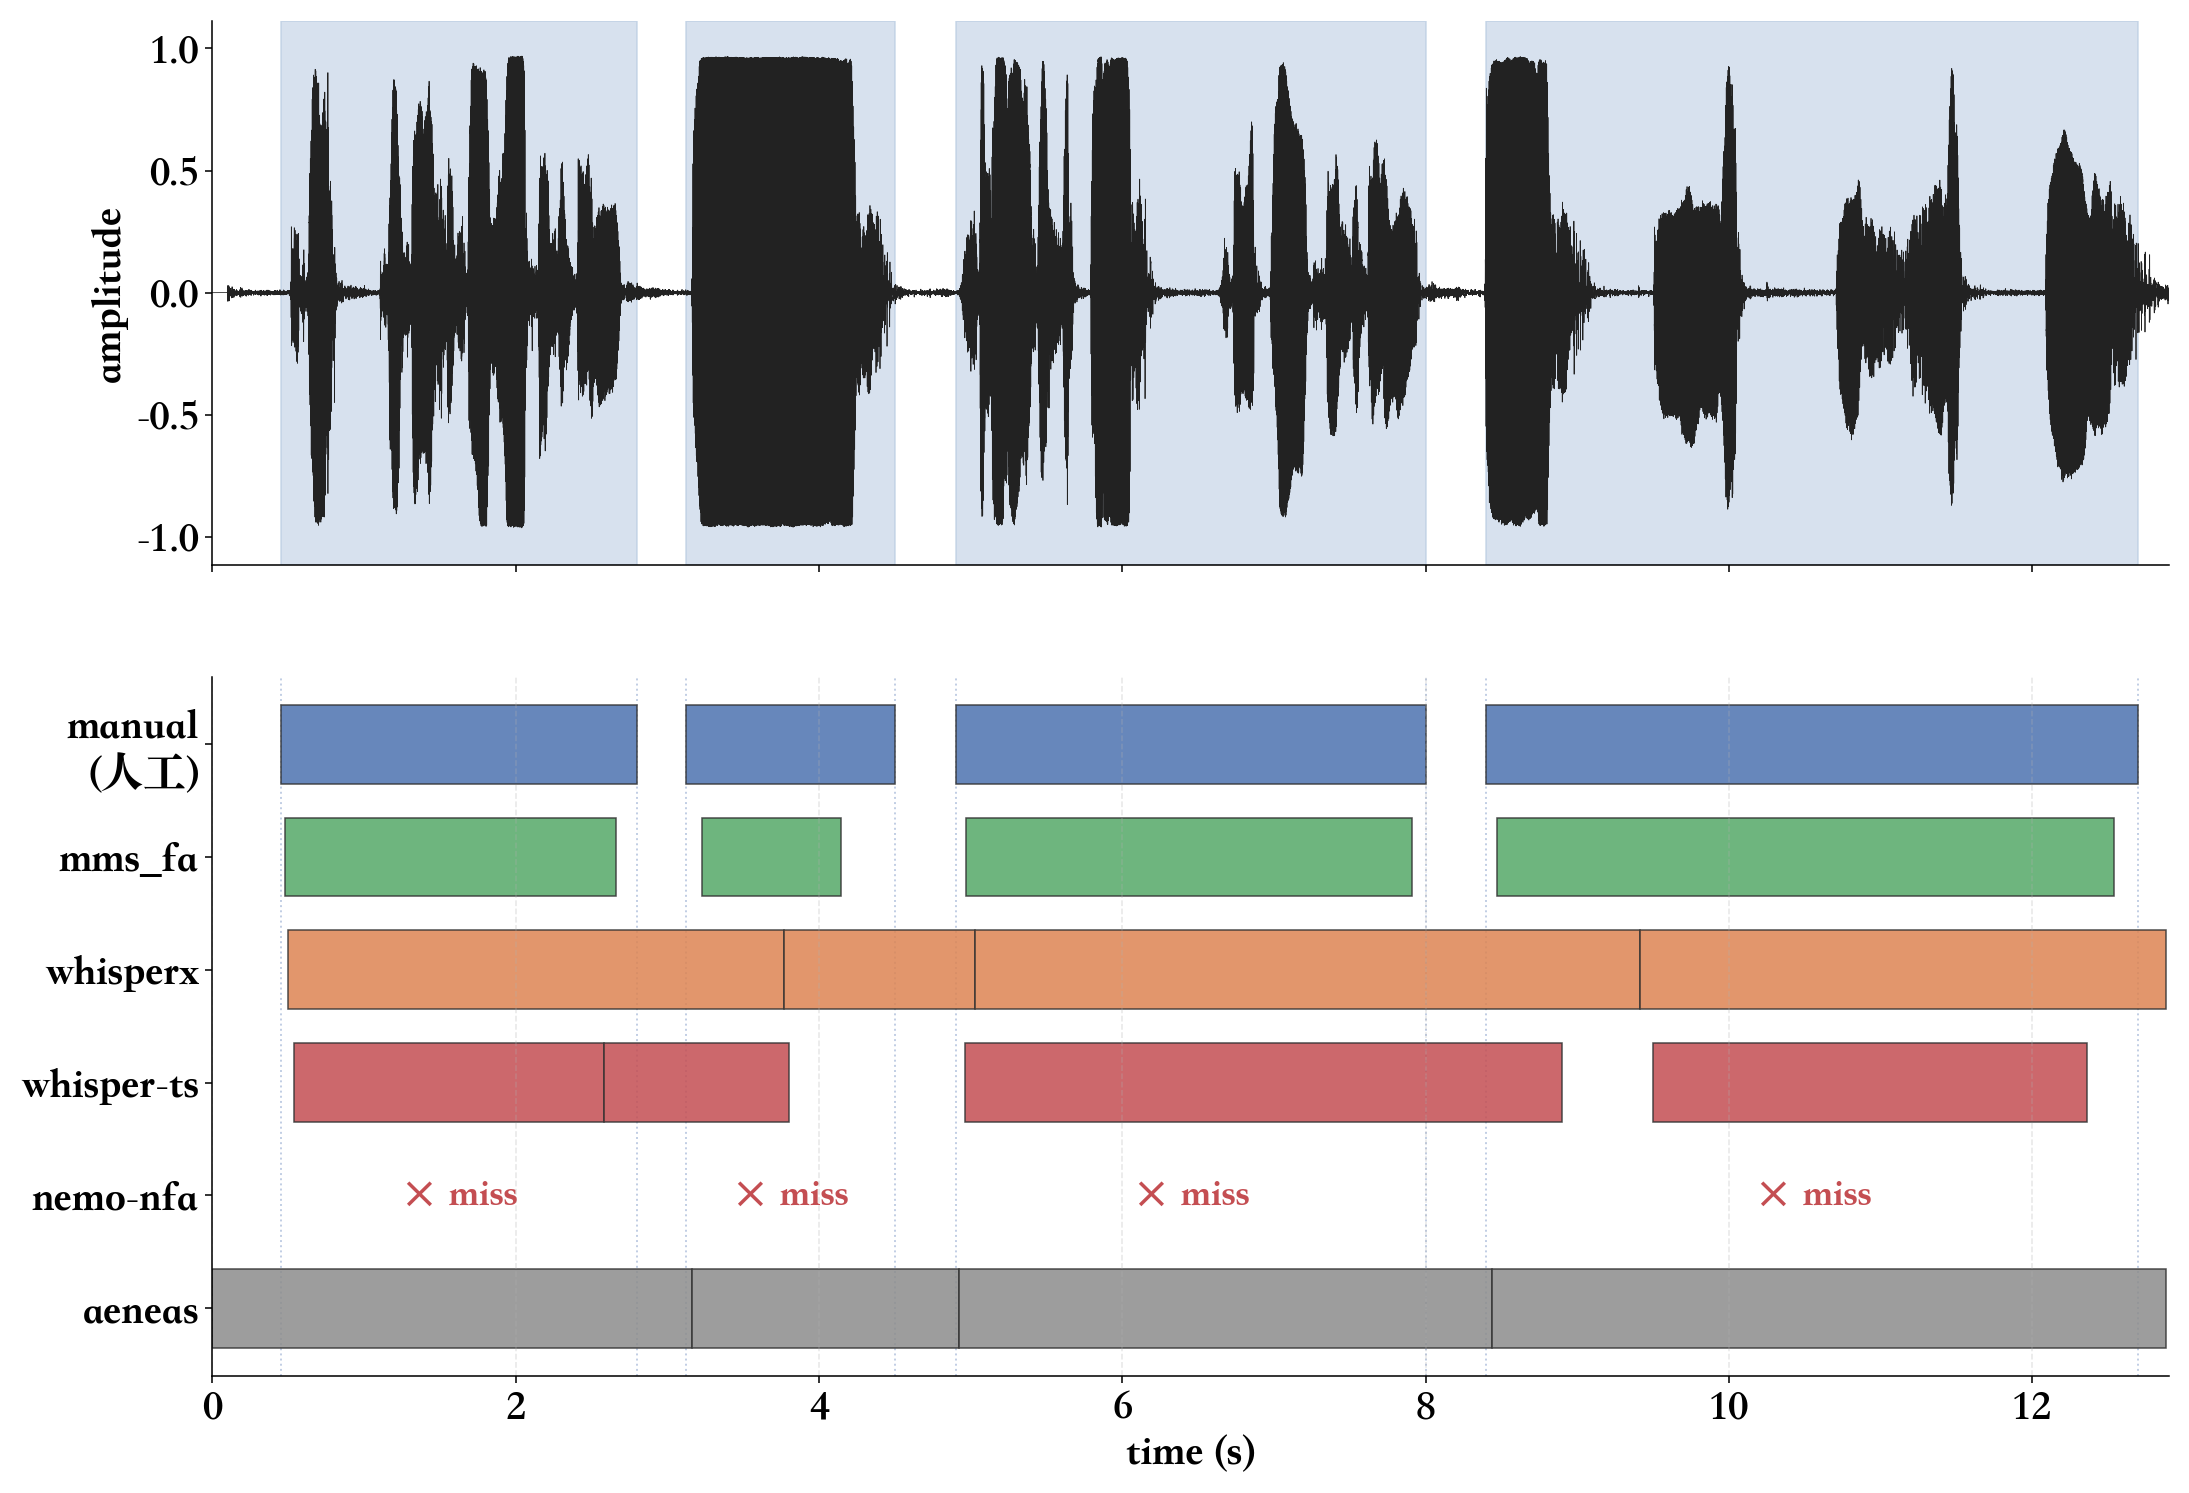
这条是给学习者示范 ü / ün / ǘn / ǚn / ǜn 声调的教学音频,第 4 段还录到削波(波形直接顶到 ±1.0)。这是 MMS_FA 通过 uroman 会踩坑的场景 :声调和 ü 信息在罗马化后被弱化------ǘn / ǚn / ǜn 全归化成 un,ün 变成 uen------模型看到三段 un 一段 uen,边界只能靠时长猜。即便如此 MMS_FA 4 段还是跟人工 gold 大致对上,误差在 0.03-0.35 s 一档;其他系统在第 2 段(ün。 人工 gold 只有 1.38 s)几乎都定位不准。
3.3 英文 · 讲课
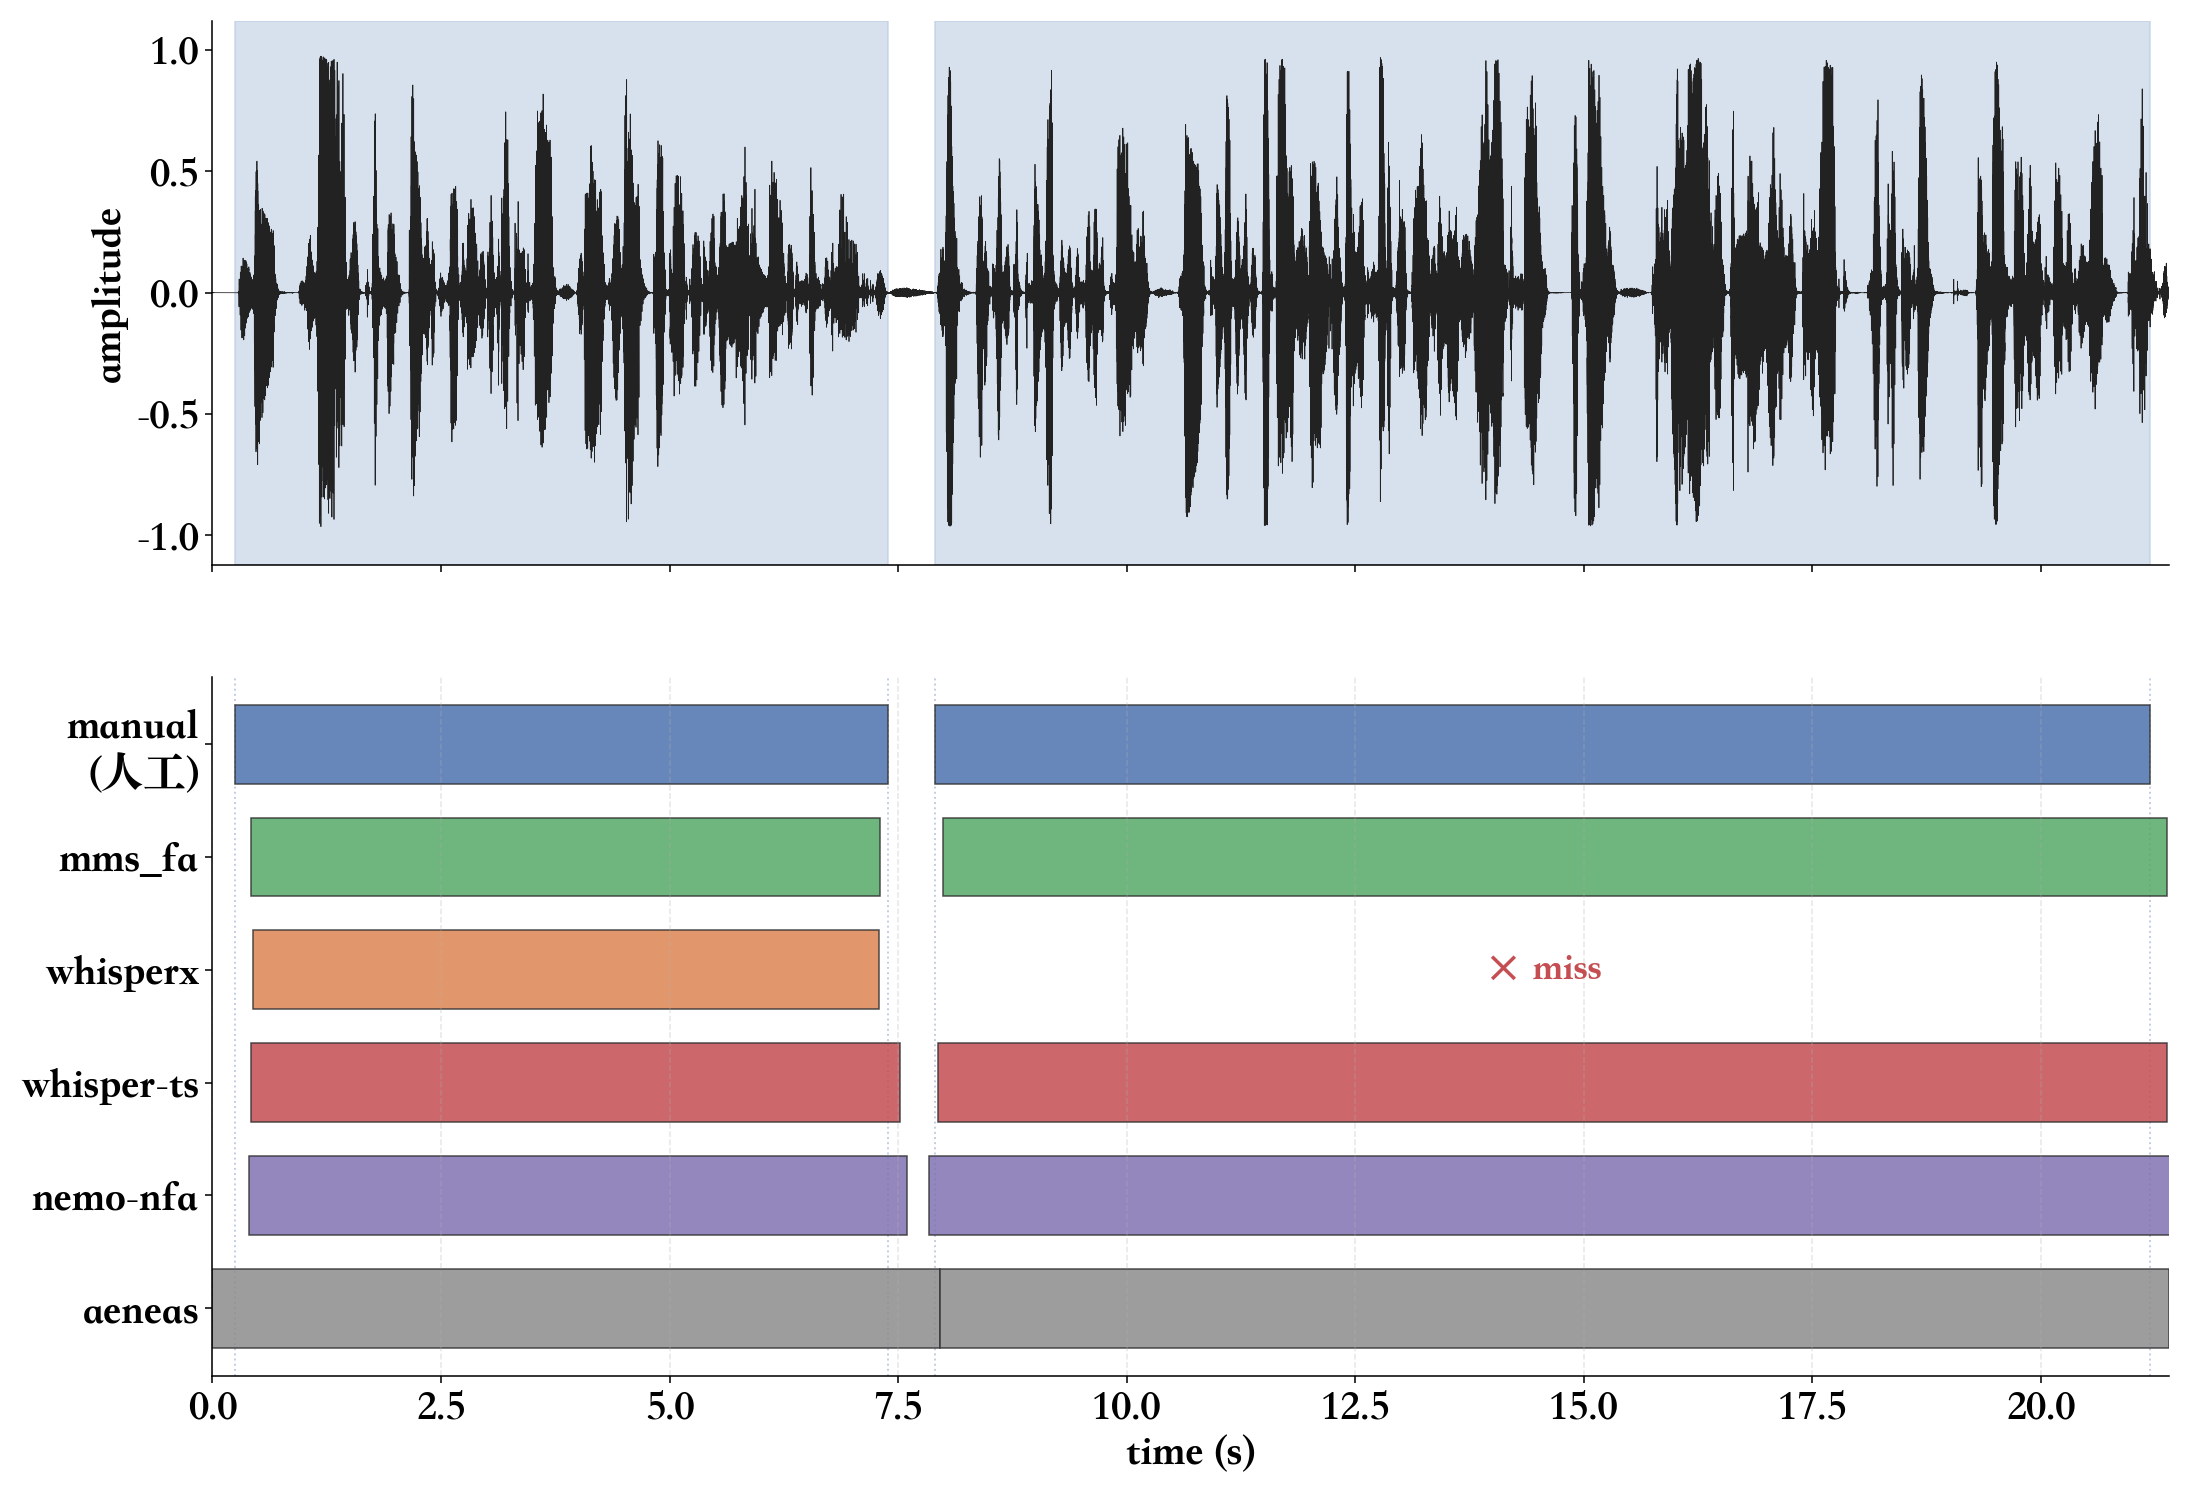
一段清晰的英文技术讲解,两句都很长(前句 7 s、后句 13 s)。读图 :MMS_FA / whisper-ts / NeMo NFA 在两句上全部对齐成功,边界误差都在 0.4 s 以内;WhisperX 第 2 句直接标 miss ------ 长句 backtrack 失败是 WhisperX 已知的问题,不是精度差、是它放弃了这一段。aeneas 段间无缝的老毛病继续存在,两段边界一致压到 8.0 s 前后。
3.4 英文 · 冥想引导
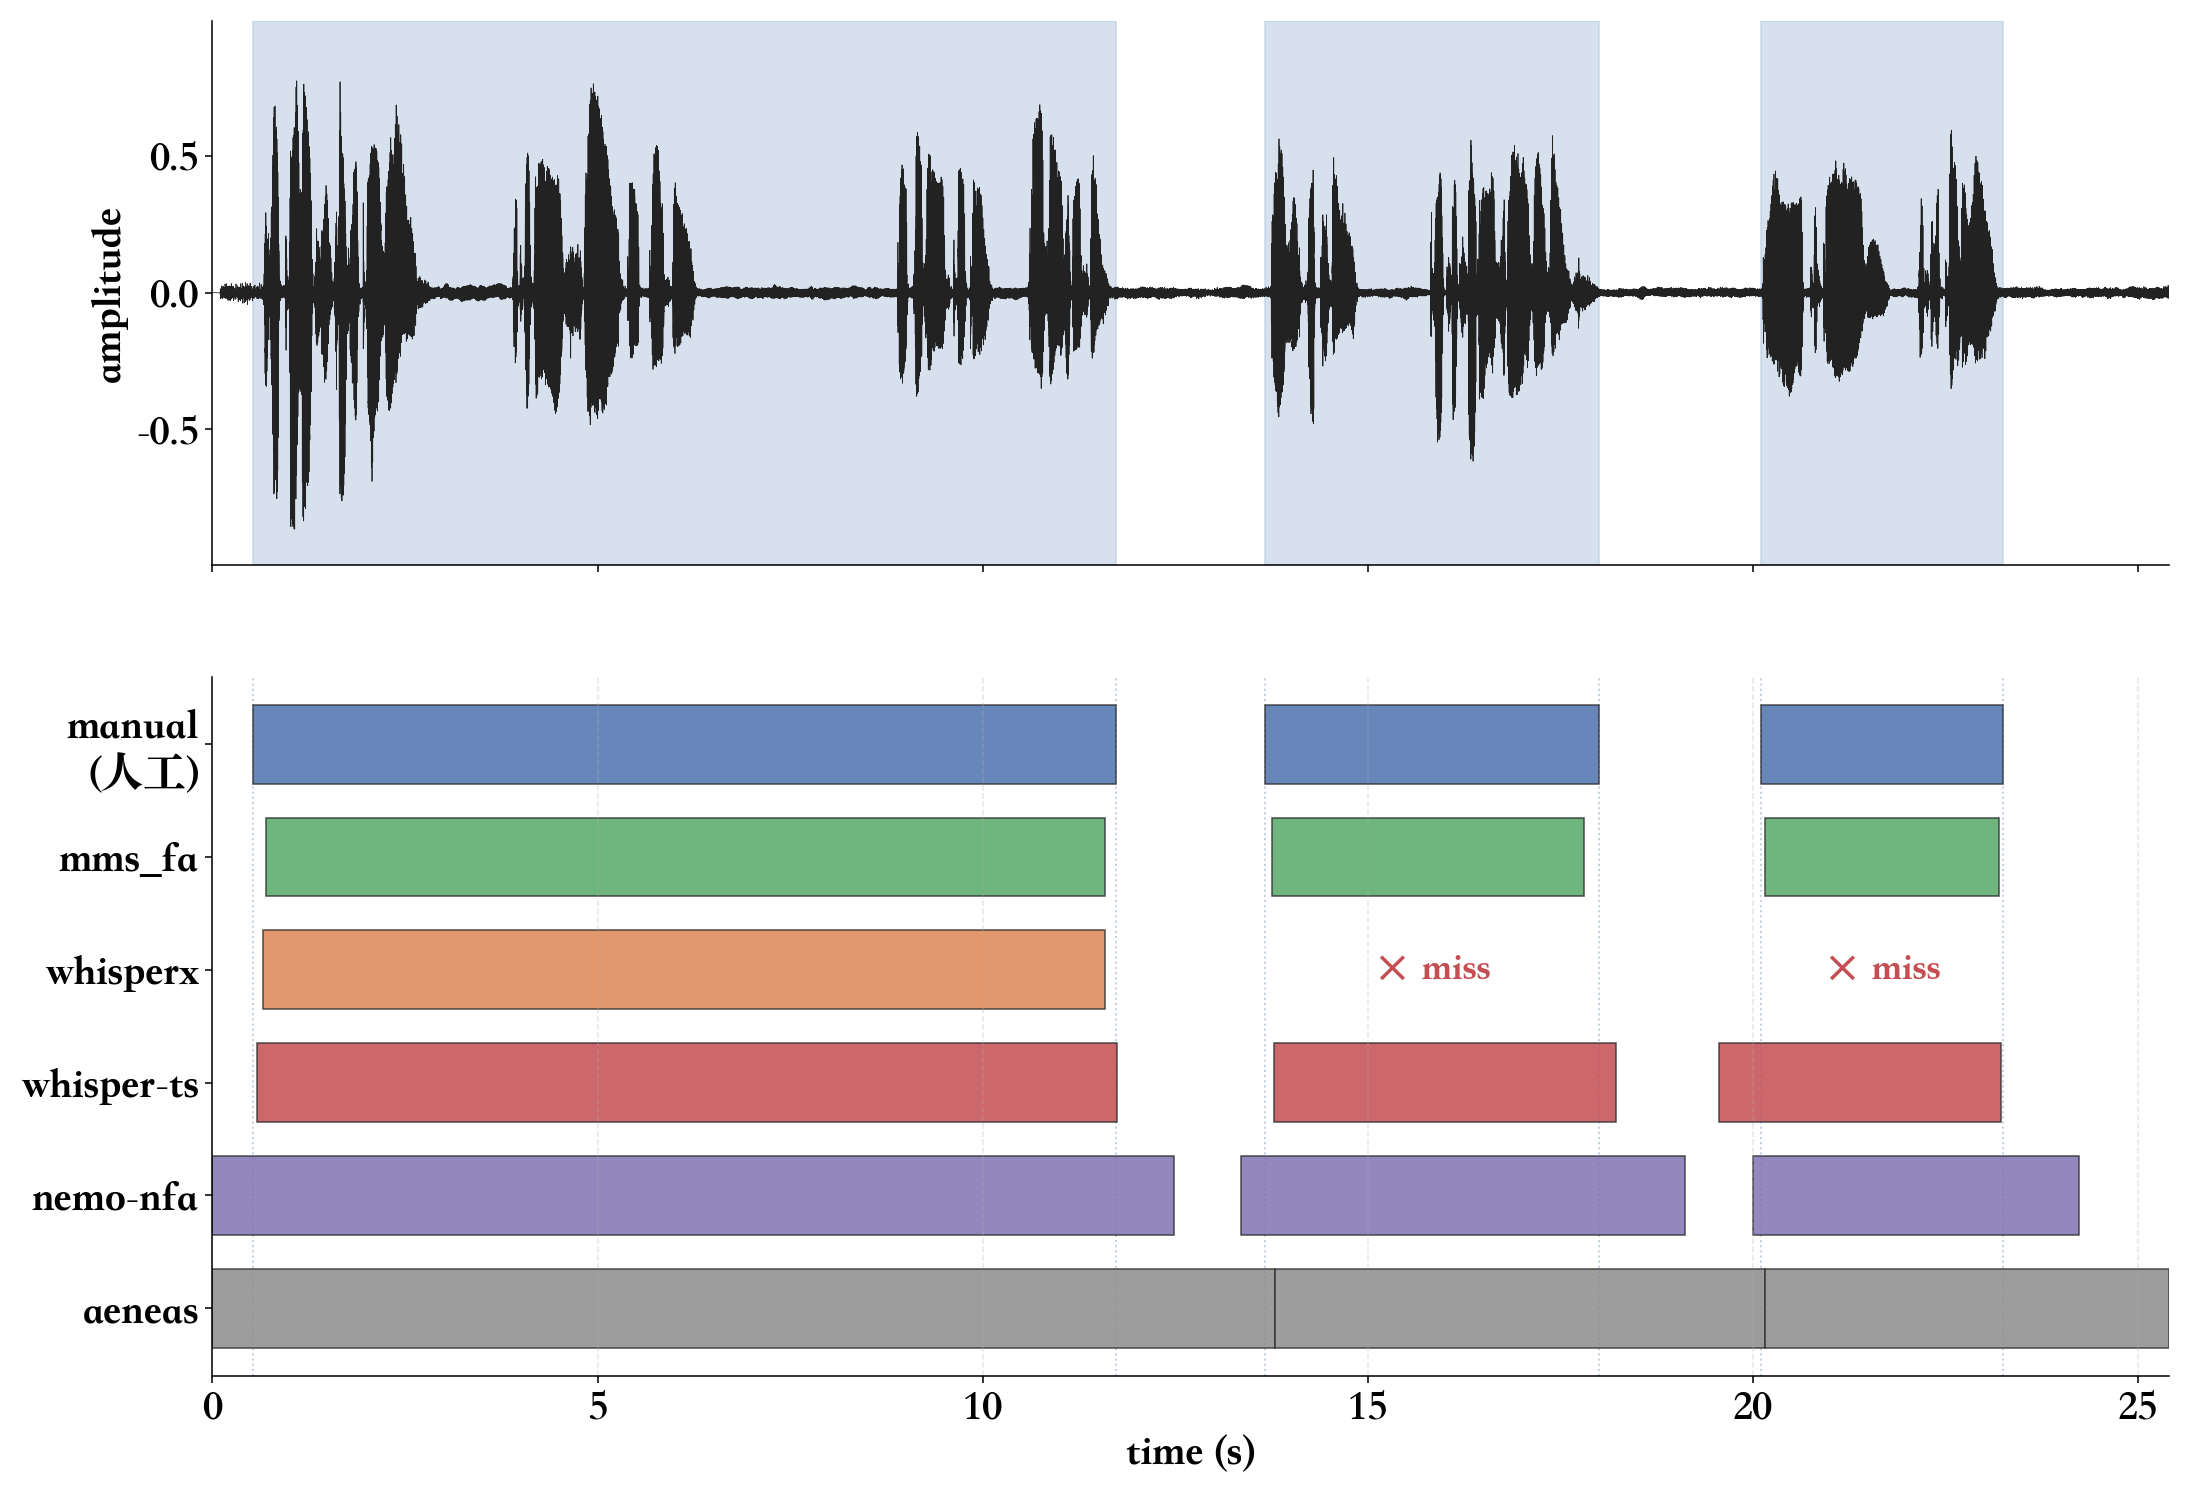
冥想引导词,语速极慢、句间停顿约 2 s(明显长于其他 case)。这条是长停顿场景的教科书案例 :人工 gold 把第 0 句 end 标到 11.73s(她实际念到 11.7 s 才停)------ MMS_FA / WhisperX / whisper-ts 分别约 11.59 / 11.59 / 11.74 s,NeMo 12.48s,都贴近这个人工边界。WhisperX 又在第 2、3 句 miss,aeneas 三段边界互相咬合(seg 0 end = seg 1 start)。
3.5 日文 · 平假名讲解
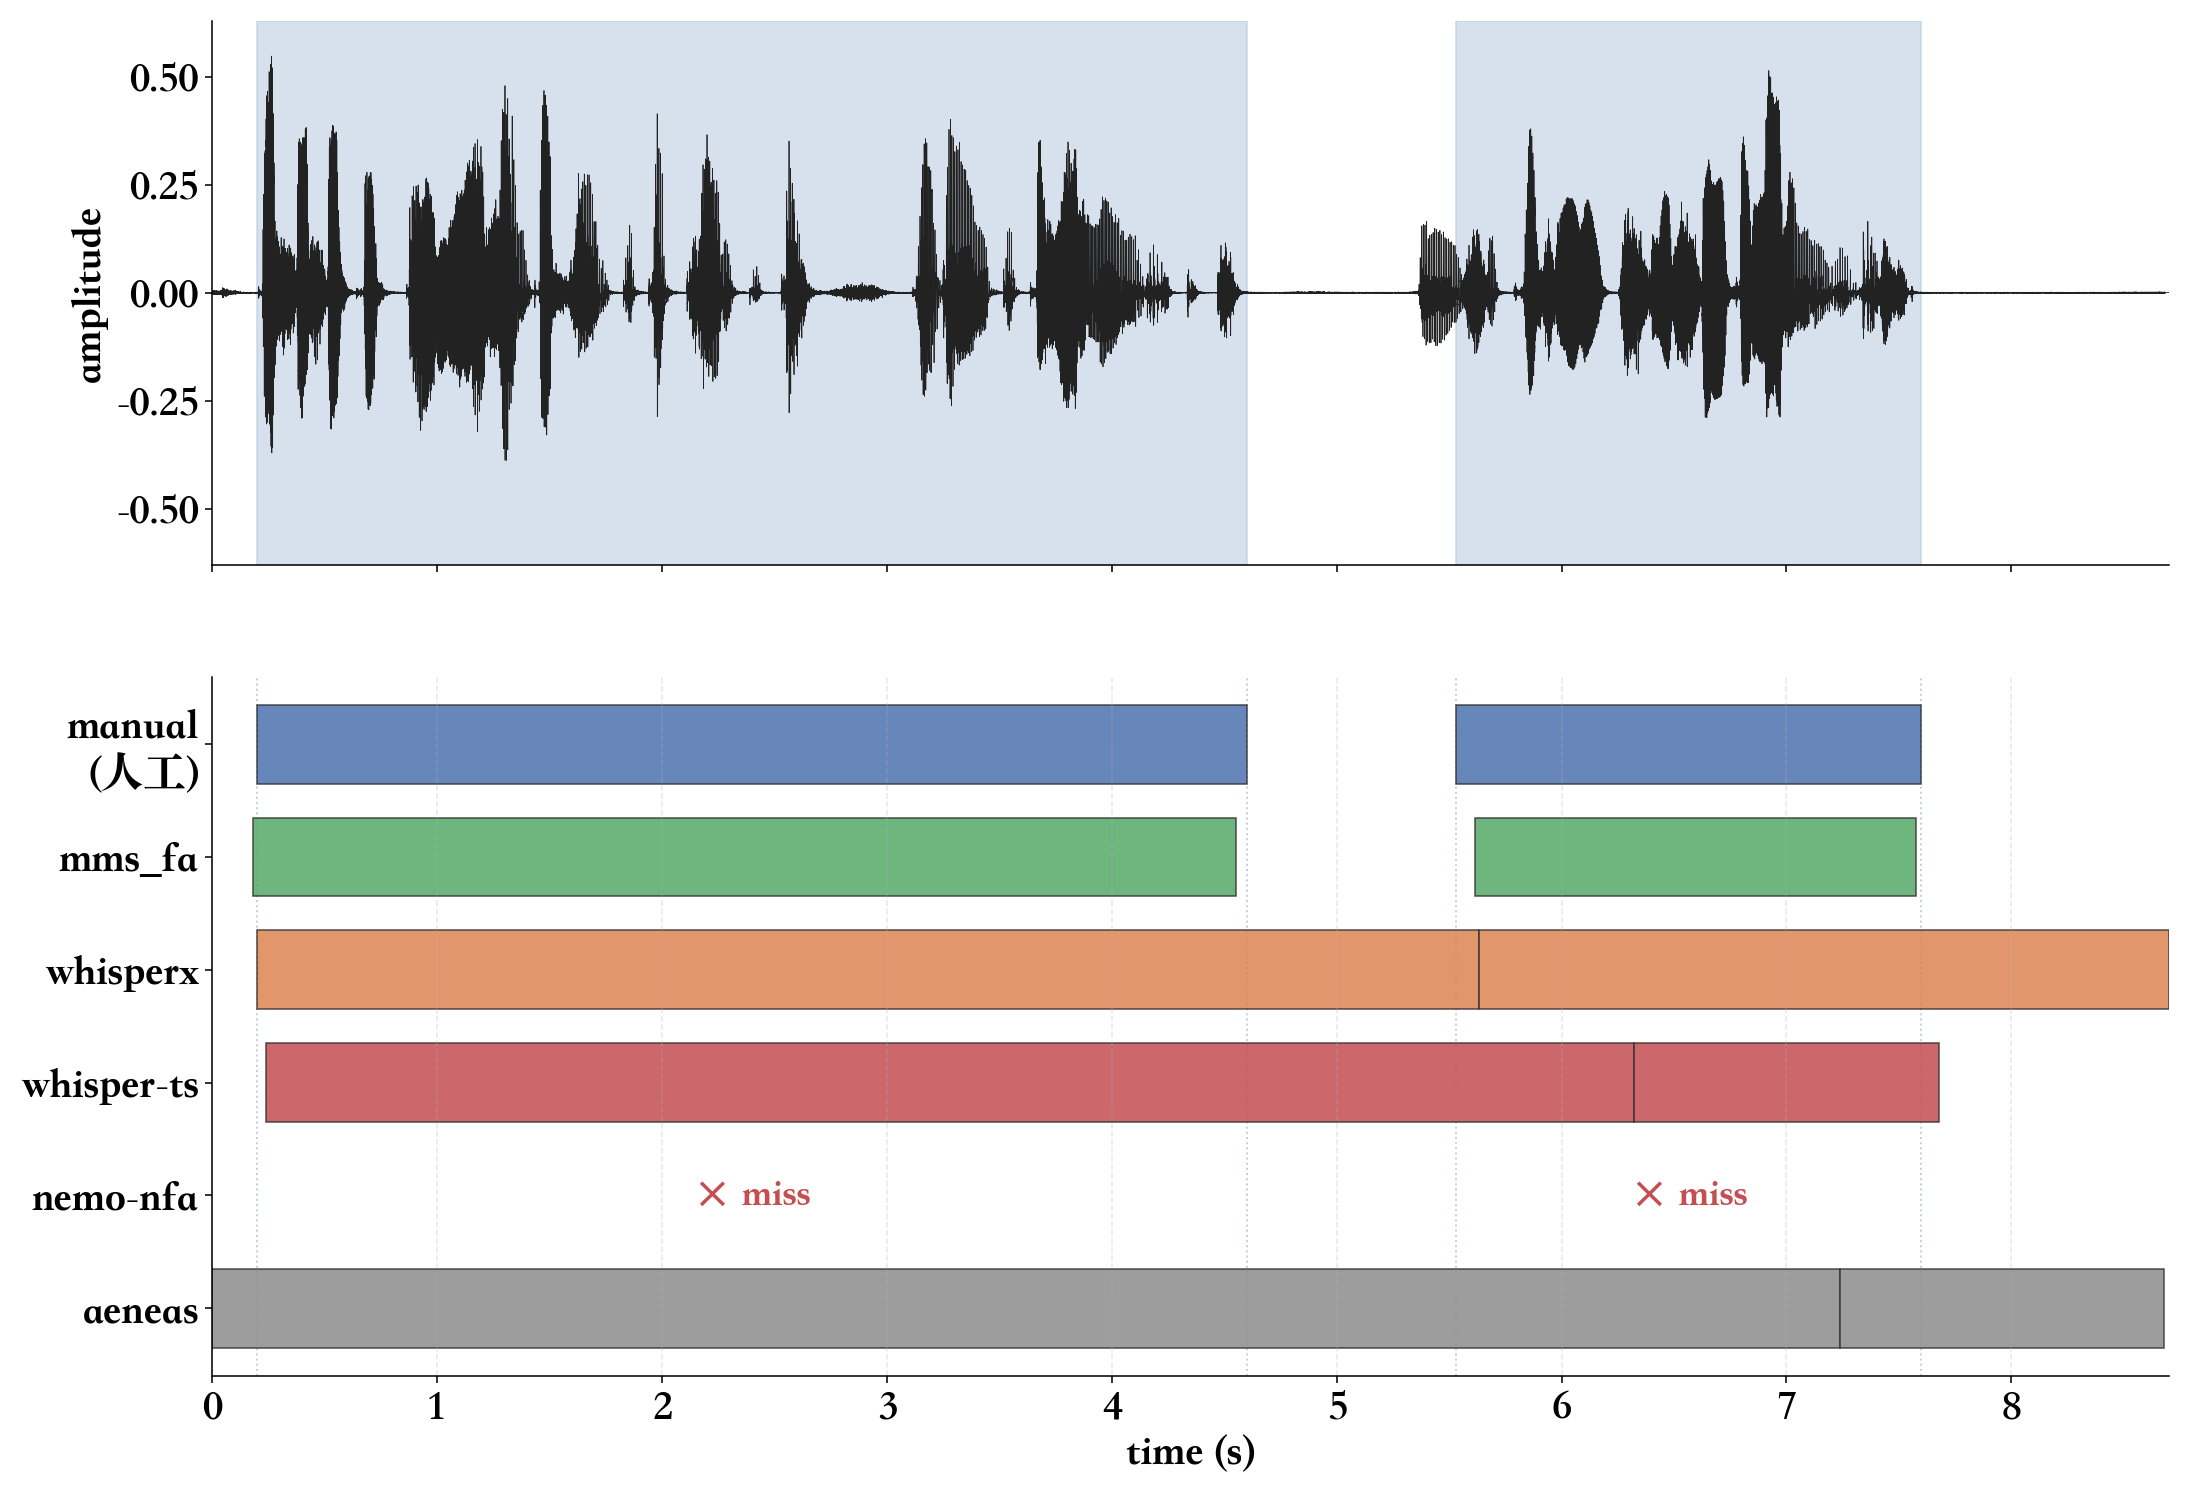
日文女声讲解,几乎全平假名(少量汉字)。读图:MMS_FA 两段边界都跟人工 gold 差 <0.3 s;whisperx / whisper-ts / aeneas 三家把第 1 句的 end 都拉到 5.6-7.2 s(人工 gold 4.6 s),说明 Whisper 系和 DTW 系对句间的短促停顿分辨不出。NeMo 日文无 CTC 依旧全 miss。
3.6 日文 · 占星长段
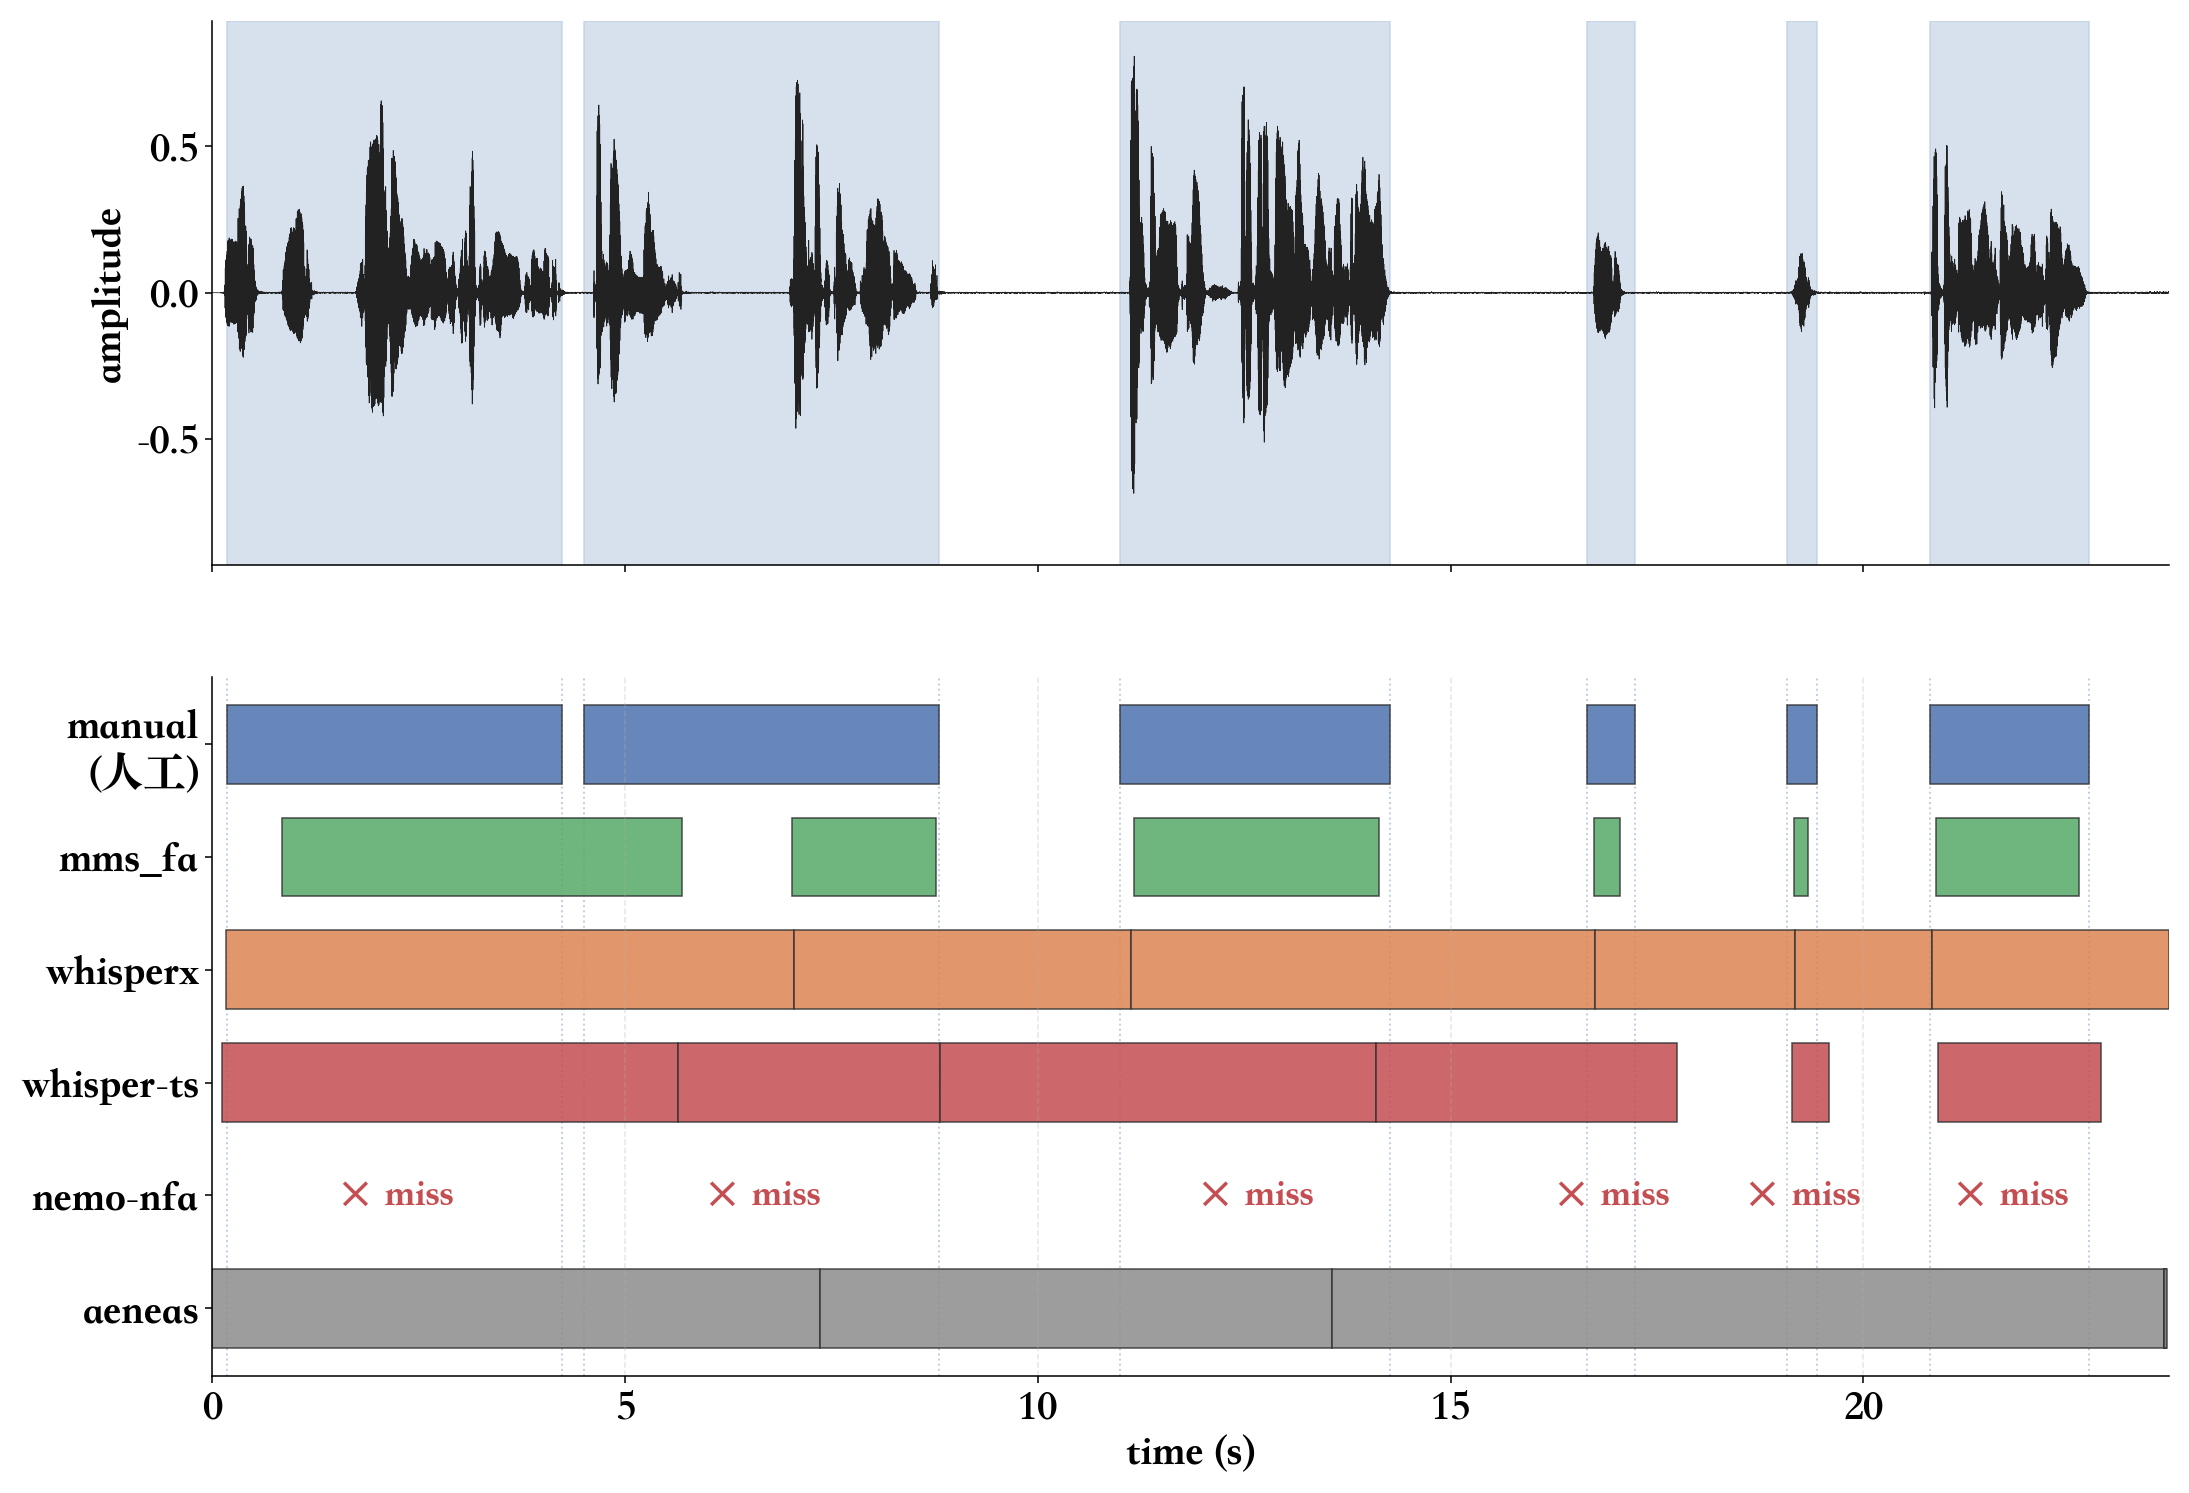
一段日文占星讲述,句数最多(6 句)、有大量汉字混排(昭和44年7月12日生まれ火星人マイナス、大殺界)。读图 :这也是本轮 MMS_FA 表现最弱的 case ------ uroman-python 对含日文汉字的文本默认走中文拼音查表 (把 昭和 转成 zhaohe、大殺界 转成 dashajie),模型在音频里找不到对应音节,第 2 句(大殺界は去年で終わった)起点飘到 7.03 s(人工 4.5 s)。WhisperX 6 段直接串联(一根条通到底);whisper-ts 第 2 句起点 5.64 s 反而最准(Whisper 原生懂日文);aeneas 段间无缝 + 日文 TTS 音色和真人差异大,DTW 匹配崩坏,第 3 段 end 冲到 23.64 s。NeMo 6 段全 miss。
四、总体指标
3 语种 20 seg,|Δstart| / |Δend| 中位(log y 轴):
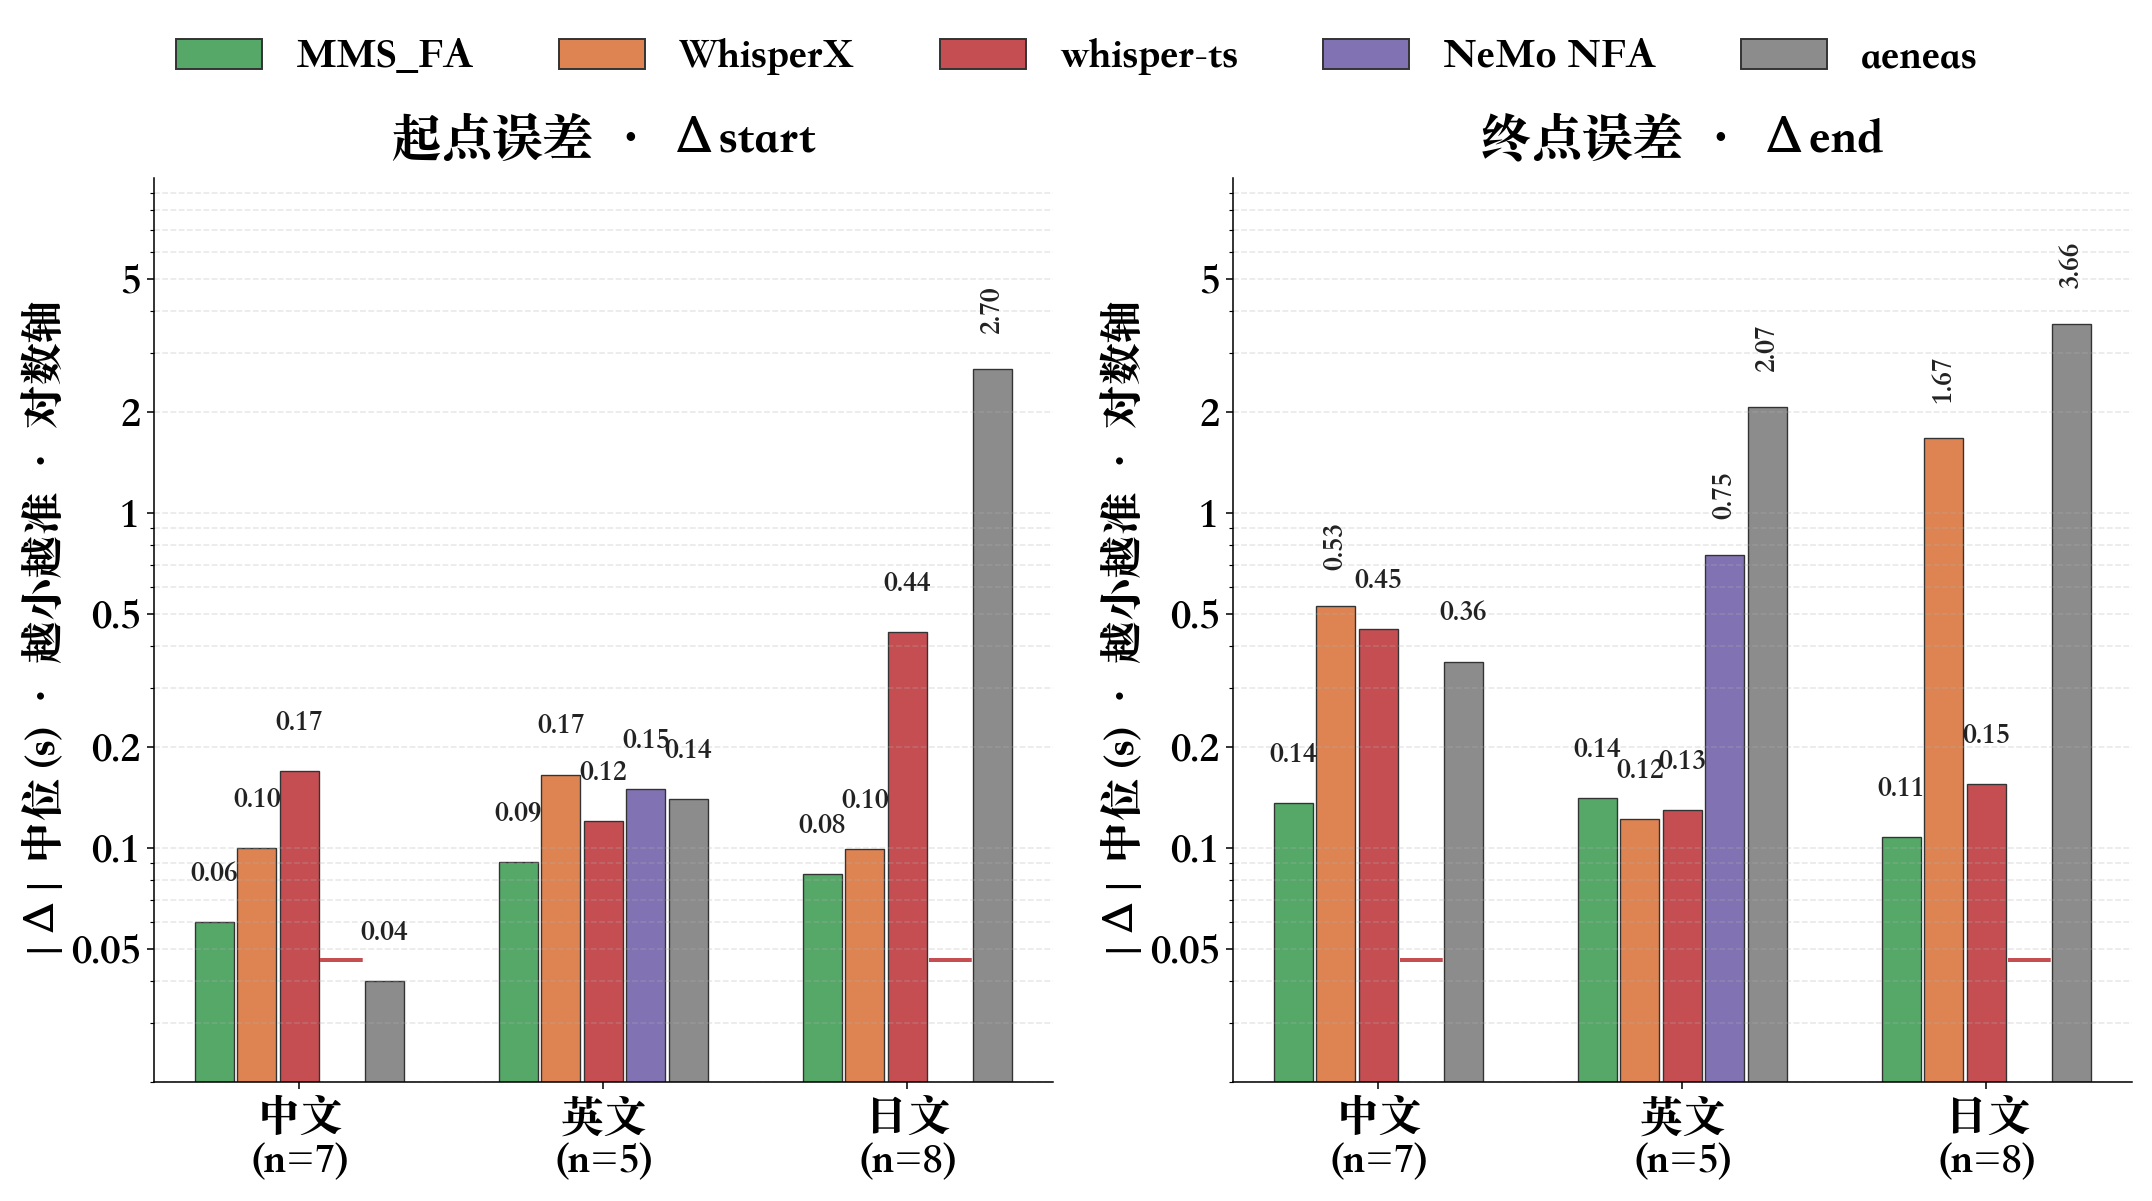
读图 :横轴按语种分组,柱子颜色对应 5 个系统。--- 表示该语种无有效对齐(NeMo 中日文)。
- 中文:MMS_FA 起点 0.06 s / 终点 0.14 s 最好;aeneas 起点 0.04 s 意外准,但终点 0.36 s 拉开。
- 英文:4 家 Δstart 都在 0.09-0.17 s 一档;Δend 上 MMS_FA / whisper-ts / WhisperX 三家分别 0.14 / 0.13 / 0.12 s 打平,NeMo 0.75 s、aeneas 2.07 s。
- 日文:MMS_FA 起点 0.08 s / 终点 0.11 s 中位最好;whisper-ts 起点 0.44 s、WhisperX 终点 1.67 s(虽然覆盖 8/8 但边界飘)、aeneas 起点 2.70 s / 终点 3.66 s 崩盘。
覆盖率 · n_ok / n_total:
| 系统 | 中文 (n=7) | 英文 (n=5) | 日文 (n=8) |
|---|---|---|---|
| MMS_FA | 7/7 | 5/5 | 8/8 |
| WhisperX | 7/7 | 2/5 | 8/8 |
| whisper-ts | 7/7 | 5/5 | 8/8 |
| NeMo NFA | 0/7 | 5/5 | 0/8 |
| aeneas | 7/7 | 5/5 | 8/8 |
MMS_FA / whisper-ts / aeneas 三家在本轮 20 seg 全部有输出 ;WhisperX 英文长句 miss 3 句;NeMo 中日文各 0(官方无 pretrained CTC)。注意:覆盖率高不等于精度好------WhisperX 日文覆盖 8/8,但 Δend 中位 1.67 s、p90 2.81 s,边界仍飘。
五、5 个系统的定位与选型
1. MMS_FA · 通用 forced aligner 里综合最稳的选择
20 seg 全覆盖 · 中英日 Δstart 中位都 <0.1 s · Δend 中位都 <0.15 s。代价 :非拉丁语种依赖 uroman 罗马化,遇到"声调符号被抹平"(拼音教学)和"汉字被按中文拼音处理"(日文汉字混排)时会漂移------日文长段 Δstart p90 到 2.53 s、Δend p90 1.45 s。License 是 CC-BY-NC,商用要另做许可。推荐场景:多语种 TTS 训练数据清洗 · 通用 forced align。
2. whisper-timestamped · 多语种第二选择,日文终点边界表现好
纯 Whisper 单模型的路线,不依赖第二个对齐器,也不需要文本 romanize。日文 Δend 中位 0.16 s(MMS_FA 0.11 s)基本打平;中英 Δstart 稍差一档但覆盖率同样 100%。局限 :日文 Δstart 中位 0.44 s、p90 2.55 s,起点在长段上仍飘;走 ASR-then-align 路线,Whisper 转写错的地方无法用 GT 文本"锚回来"。推荐场景:已经在跑 Whisper 转写栈 · 只做词级时间戳补齐。
3. WhisperX · 长句上会直接放弃
英文 5 句 miss 掉 3 句 ------ 在本文这套"整段 GT 拼成一个大 seg + 按 unit 回切"的用法下,长段英文的内部 wav2vec2 CTC 会 backtrack 失败、fallback 到"不给这个 seg 输出时间戳"。这不是对齐器精度问题 (对齐上的 2 句 Δend 中位 0.12 s,跟 MMS_FA 打平),是它跟本文包装方式的匹配问题------WhisperX 本来是 Whisper ASR 后处理器,Whisper 的 seg 边界能给到它,它就能对;上游没给或给错,它就放弃。推荐场景:Whisper 已经在跑,音频没长静音的短段词级补时间戳(前提:单独测过 backtrack 稳定性)。
4. NeMo NFA · 英文精度好,非英语要自训
英文 5 句全覆盖,Δstart 0.15 s、Δend 0.75 s(长停顿场景边界向后飘)。本文使用的官方 pretrained CTC 配置在中日文上没有可直接调用的 checkpoint,直接标 miss。要用 NeMo 做非英语对齐得自己训 CTC 模型 ------ 走的是"生产级但语种自定"的路线,跟 MMS_FA "多语种通用"的路线正好对着。推荐场景:只做英文 · 追求生产级稳定 · 有 NVIDIA 生产支持。
5. aeneas · 下限 baseline
20 seg 全覆盖(CPU 就能跑,零 GPU 依赖),中文起点检测 0.04 s 中位意外准,但段与段之间无缝 是 DTW 的结构性问题 ------ 句间静音塞给前段,Δend 中位 0.36 s (zh) / 2.07 s (en) / 3.66 s (ja) 一路被拉飞。日文 DTW 崩得最厉害,eSpeak 合成的日文假声和真人音色差异极大。推荐场景:CPU only · 已知只做 eSpeak 支持语种的短句 · 长段慎入。