目录
[01 🏭 工业物联网真正难的,不是"采集数据"](#01 🏭 工业物联网真正难的,不是“采集数据”)
[02 ⚡ 工业物联网为什么特别需要"实时计算"?](#02 ⚡ 工业物联网为什么特别需要“实时计算”?)
[03 🧠 DolphinDB到底是什么?](#03 🧠 DolphinDB到底是什么?)
[04 🏗️ DolphinDB的核心优势:存储和计算不再割裂](#04 🏗️ DolphinDB的核心优势:存储和计算不再割裂)
[05 📊 2000+函数背后,真正解决的是"怎么算"](#05 📊 2000+函数背后,真正解决的是“怎么算”)
[06 🚀 一个非常典型的案例:长江电力](#06 🚀 一个非常典型的案例:长江电力)
[07 🔥 工业AI真正难的地方,不是"大模型"](#07 🔥 工业AI真正难的地方,不是“大模型”)
[08 🤖 DolphinX:DolphinDB开始进入Agent时代](#08 🤖 DolphinX:DolphinDB开始进入Agent时代)
[09 🧩 MCP解决的是什么问题?](#09 🧩 MCP解决的是什么问题?)
[10 🧠 RAG、TextDB、VectorDB:让AI真正"认识企业"](#10 🧠 RAG、TextDB、VectorDB:让AI真正“认识企业”)
[11 🧬 FeatureDB:AI时代的数据"新角色"](#11 🧬 FeatureDB:AI时代的数据“新角色”)
[12 🏭 如果把DolphinDB放进一家制造企业,会是什么样?](#12 🏭 如果把DolphinDB放进一家制造企业,会是什么样?)
[13 🆚 DolphinDB真正适合什么场景?](#13 🆚 DolphinDB真正适合什么场景?)
[14 🧩 DolphinDB的未来,可能不只是"国产数据库"](#14 🧩 DolphinDB的未来,可能不只是“国产数据库”)
[15 🚀 这可能才是DolphinDB真正的"破局点"](#15 🚀 这可能才是DolphinDB真正的“破局点”)
[16 📝 写在最后](#16 📝 写在最后)
如果把工业物联网比作一家大型工厂,那么传感器就是遍布工厂各处的"神经末梢"。
温度、压力、振动、电流、转速、流量、位移......
设备每秒都在产生数据。
问题也恰恰出在这里。
工业企业真正缺的,从来不是数据,而是让这些数据"及时算起来"的能力。
一台设备异常了,数据已经采集到了,但分析系统还在排队;
一个轴承温度正在持续升高,数据库里已经有连续几个小时的记录,但工程师看到的还是昨天的报表;
某个水电站出现异常振动,需要把实时数据、历史趋势、设备参数、检修记录放在一起分析,结果发现数据分散在好几个系统里。
等数据真正分析出来,设备可能已经停机了。
这也是为什么这几年工业数字化建设开始出现一个非常明显的变化:
企业关注点正在从"我能不能把数据存下来",转向"我能不能让数据马上产生价值"。
在这个背景下,DolphinDB开始被越来越多地放到工业物联网、电力、能源、制造等场景的数据底座位置。
它的定位也并不只是一个传统意义上的"数据库"。
更准确地说,它正在往:
高性能时序数据库 + 实时计算引擎 + 分析平台 + AI Agent 基础设施
这个方向演进。
而这,可能才是DolphinDB值得关注的地方。
01 🏭 工业物联网真正难的,不是"采集数据"
很多企业做工业互联网,第一阶段往往非常顺利。
设备接入。
传感器部署。
PLC、SCADA、OPC、MQTT等系统逐渐上线。
然后问题来了。
数据越来越多。
一天几百GB、几个TB,甚至更高。
设备数量从几百台变成几千台、几万台。
测点从几万个变成几十万、几百万。
这时候,传统架构的问题就开始暴露出来。
典型架构大概是这样的:
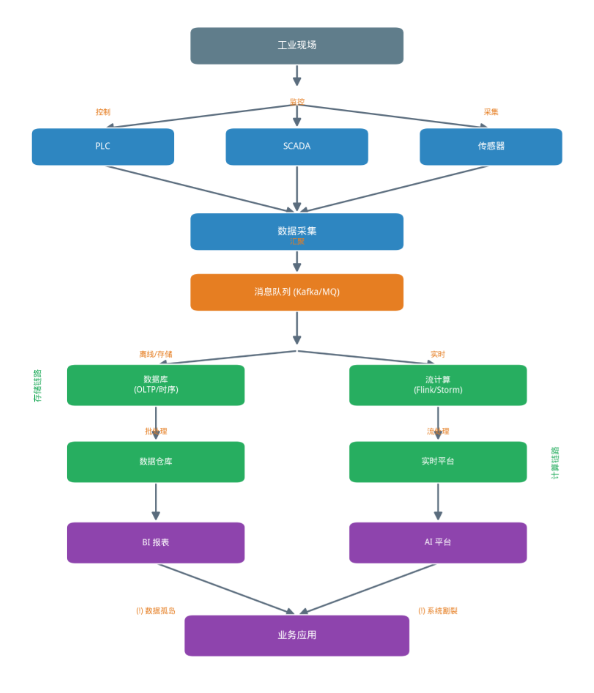
看起来没有什么问题。
但真正运行几年之后,很多企业会发现:
系统越来越多,数据越来越分散,计算链路越来越长。
尤其是复杂分析。
例如现在要回答一个问题:
"过去30分钟内,3号机组振动是否出现异常?如果异常,与过去30天同工况下的历史数据相比有什么区别?"
这个问题其实并不简单。
它需要:
-
查询实时数据;
-
查询历史数据;
-
找到对应设备;
-
按时间窗口计算;
-
过滤工况;
-
计算统计指标;
-
做异常检测;
-
最后把结果交给业务系统。
如果这些事情分别发生在不同系统里,就意味着:
数据要搬来搬去。
而数据一旦开始搬运,延迟、开发成本、系统复杂度也就跟着上来了。
02 ⚡ 工业物联网为什么特别需要"实时计算"?
这里需要先区分一个概念。
实时数据 ≠ 实时计算。
很多系统能够做到:
数据实时采集 → 数据实时写入数据库。
但企业真正想要的是:
数据实时采集 → 数据实时计算 → 实时判断 → 实时告警 → 实时决策。
这中间差别非常大。
比如一台水轮发电机组。
传感器每秒产生大量数据:
时间
温度
压力
振动
转速
功率
流量
油压
轴位移
水位
......
如果只是把这些数据存下来,那么数据库完成任务了。
但如果企业希望:
"一旦振动值连续异常超过阈值,并且温度趋势同步上升,就立即触发预警。"
这就不再只是数据库的问题。
而是一个典型的实时流计算问题。
DolphinDB本身提供高性能流数据处理能力,可以进行实时ETL、低延迟复杂计算、多源数据关联等处理,并支持流批一体与分布式计算。官方文档也明确将大型电厂百万测点实时监控列为物联网典型场景。
可以简单理解成:
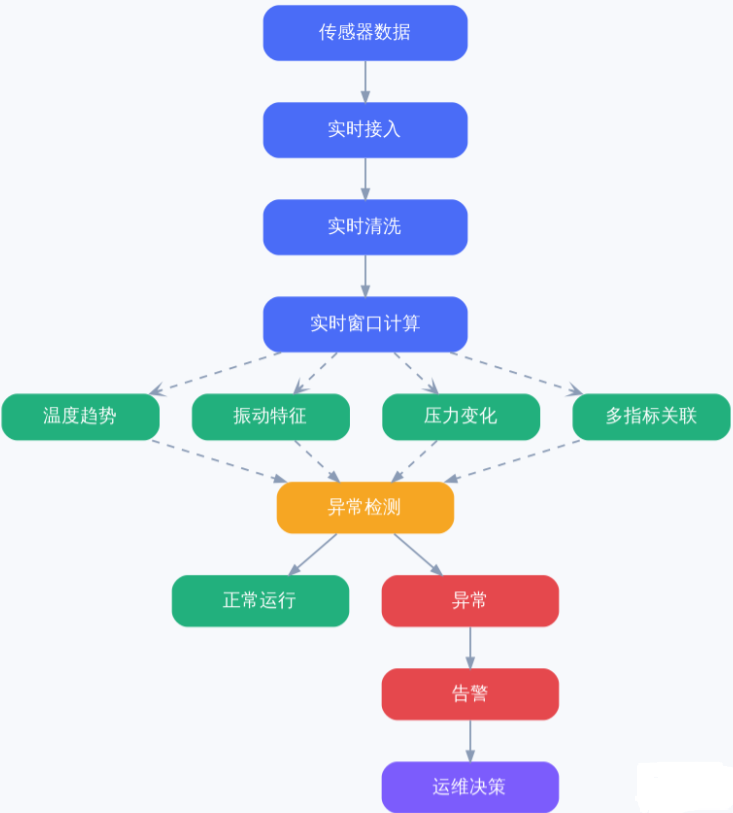
这就是工业物联网真正需要的实时计算闭环。
03 🧠 DolphinDB到底是什么?
如果只把DolphinDB理解成"国产时序数据库",其实有点低估它了。
官方目前对DolphinDB的定位,是:
基于高性能时序数据库、支持复杂分析与流式处理的实时计算平台。
它最初在金融领域积累了大量应用经验。
因为金融行业和工业物联网,其实有一个非常相似的地方:
数据都具有非常强的时间属性。
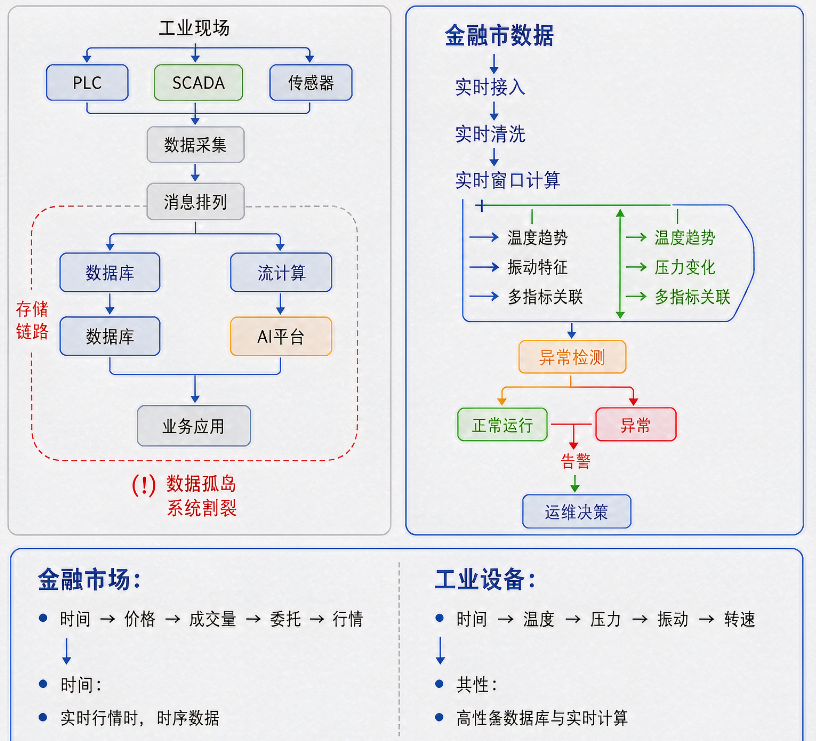
所以,处理海量时间序列数据的能力,也就自然能够迁移到工业场景。
而DolphinDB的思路并不是简单地:
"我做一个数据库,然后再外挂一个计算平台。"
而是尽可能把:
存储 + 计算 + 流处理 + 分析
融合到一起。
这也是它和很多传统数据库产品最大的区别之一。
04 🏗️ DolphinDB的核心优势:存储和计算不再割裂
传统架构经常是:
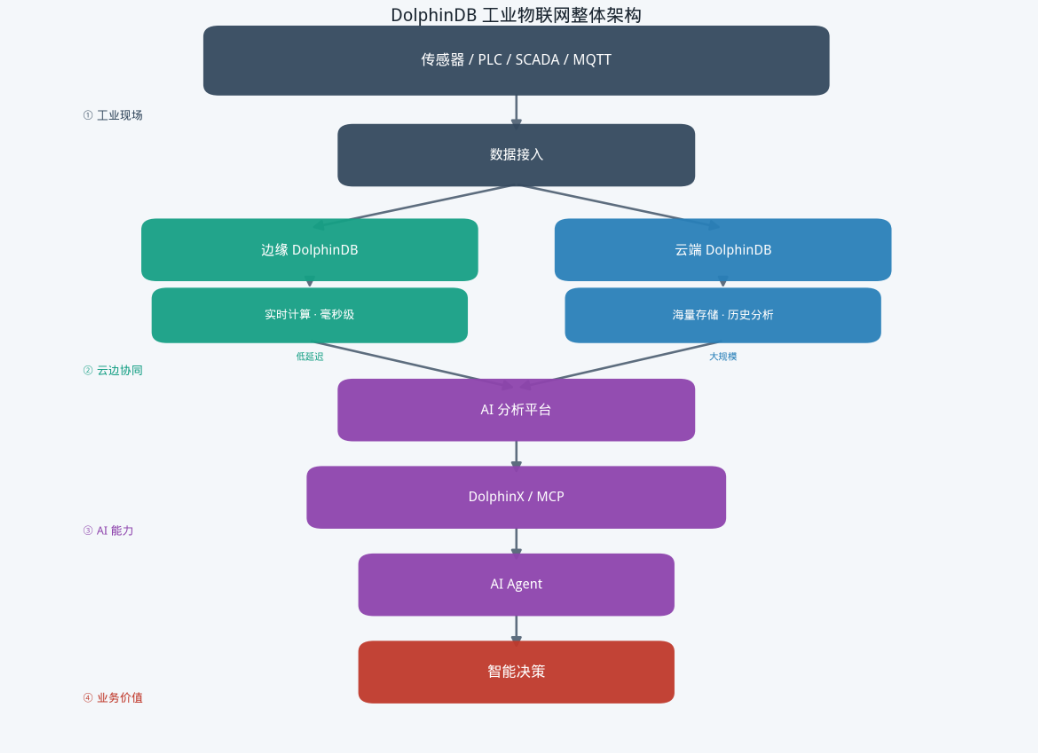
每增加一种能力,就可能增加一个系统。
而DolphinDB希望做的是:
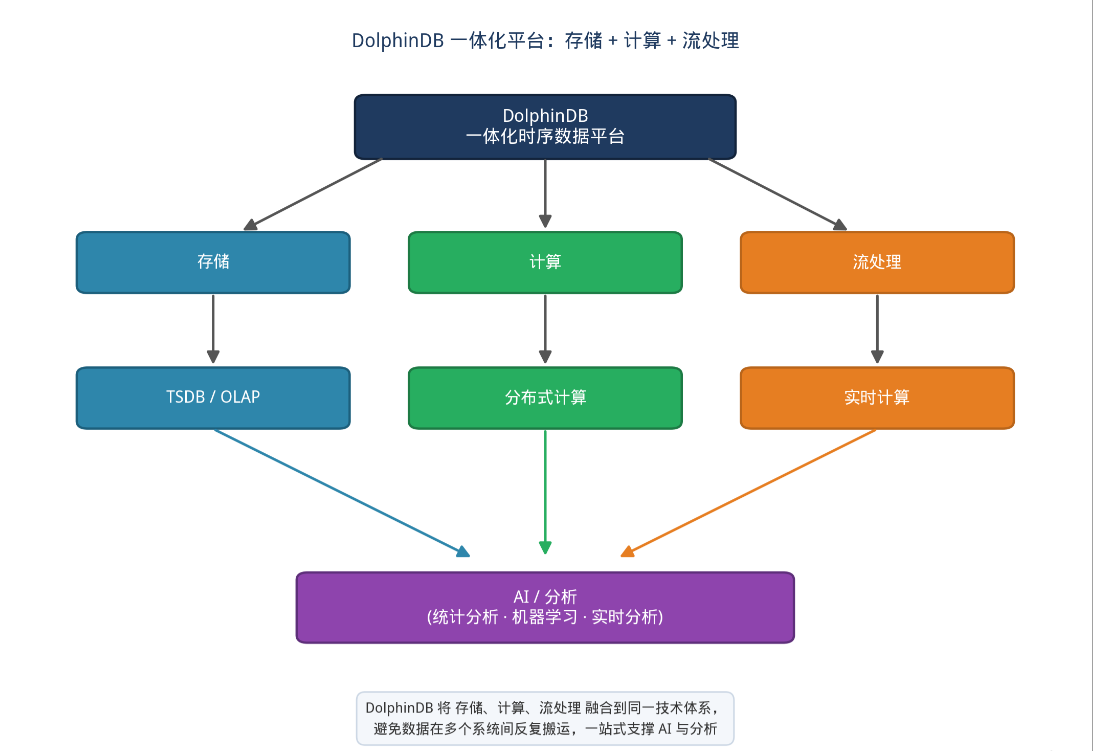
目前DolphinDB已经支持多种存储引擎,包括TSDB、OLAP、VectorDB、TextDB、PKEY、IOTDB等,其中IOTDB就是面向电网、汽车、工业制造等物联网场景的细粒度低延迟海量测点管理。
这意味着什么?
简单说:
不同类型的数据,不一定非得全部塞进同一种存储模型里。
工业企业的数据本来就是"混合型"的。
例如:
| 数据类型 | 典型数据 |
|---|---|
| 时序数据 | 温度、压力、振动 |
| 关系数据 | 设备、工厂、产线 |
| 文本数据 | 运维日志、故障记录 |
| 向量数据 | 文档、知识库Embedding |
| 实时流数据 | MQTT、Kafka实时消息 |
| 特征数据 | AI模型训练与推理特征 |
这也是DolphinDB向多模态数据平台发展的一个重要原因。
05 📊 2000+函数背后,真正解决的是"怎么算"
工业场景和普通业务系统还有一个明显区别。
普通业务经常问:
"今天卖了多少?"
工业系统经常问:
"这个设备过去7天的振动频谱有什么变化?"
再复杂一点:
"同一工况下,这台设备的振动特征和历史正常设备有什么差异?"
再往前一步:
"根据过去几个月的数据,能不能提前判断设备可能出现什么故障?"
这已经不是简单SQL查询了。
需要大量数学和统计计算。
DolphinDB官方资料显示,其内置函数体系覆盖大量数据分析、数学统计、信号处理和机器学习能力,并在工业水电场景中提到傅里叶变换、小波变换、LSTM、PDE等算法方法。
于是工业分析链路可以进一步变成:
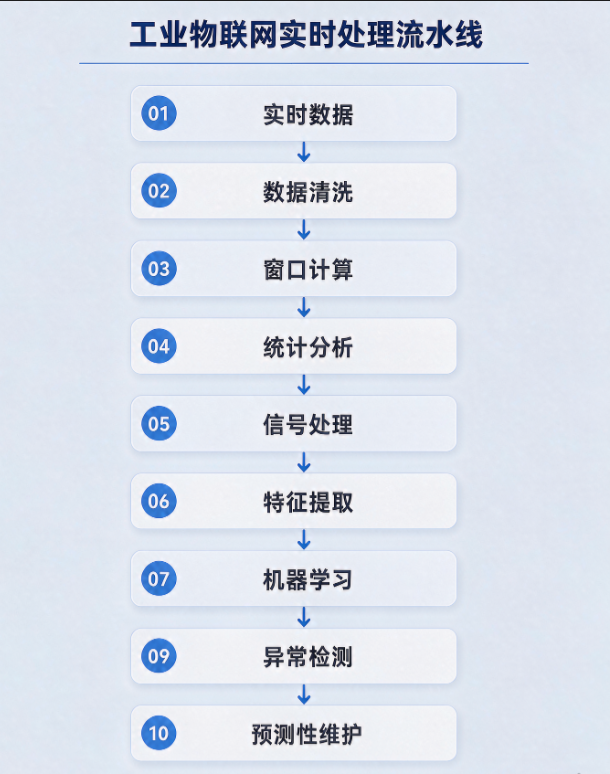
真正有价值的地方就在这里。
以前可能需要:
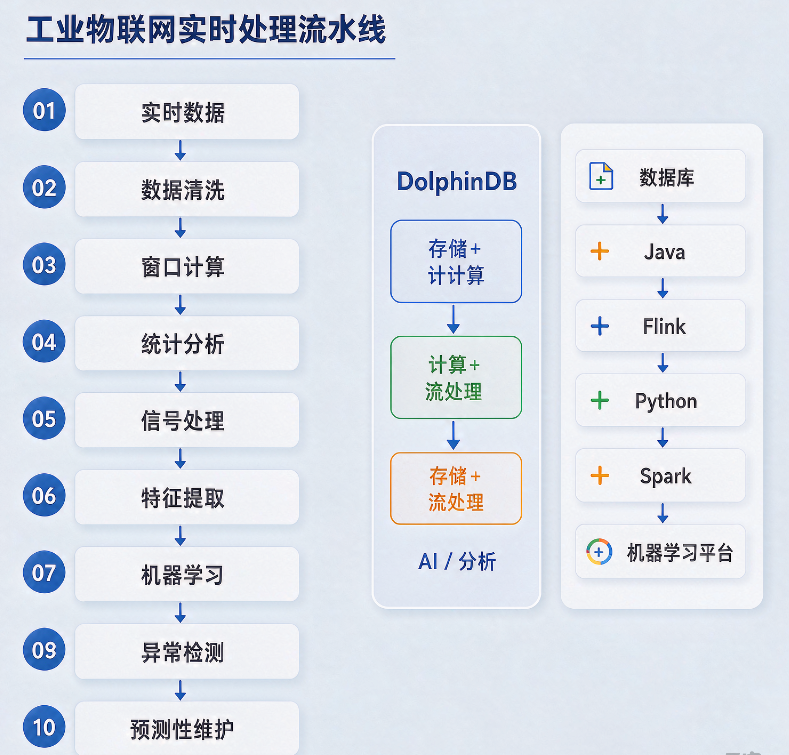
现在可以把大量计算逻辑向DolphinDB内部收拢。
这并不意味着其他技术都没有价值。
而是:
企业不再需要为了一个复杂分析场景,把所有数据不停地搬到不同系统之间。
06 🚀 一个非常典型的案例:长江电力
如果要理解DolphinDB为什么会进入工业物联网,长江电力是一个非常值得研究的案例。
长江电力拥有六座大型水电站,电站群分布跨度超过2000公里,设备和测点规模非常庞大。
这种场景有一个非常现实的问题:
数据不能只看"有没有",还要看"什么时候算出来"。
公开案例显示,长江电力原有架构中,边缘侧数据采集后定时上传云端,存储和流处理采用不同技术栈,协同延迟可能达到分钟级甚至几十分钟级;新的方案则在六大水电站边缘部署轻量级DolphinDB节点,在边缘侧进行实时计算,云端负责海量数据统一存储和历史分析。
整个架构可以理解为:
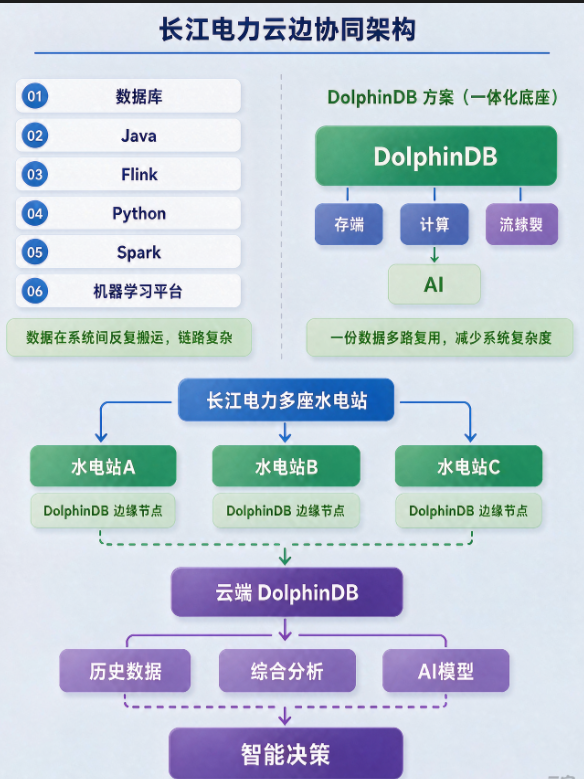
这套架构最值得关注的并不是"用了某个数据库"。
而是一个架构思想:
能在边缘算的,不一定全部上传云端再算。
设备异常判断,本地先处理。
高频数据特征,本地先提取。
需要跨站点、跨周期分析的数据,再进入云端。
这样才能真正实现:
边缘低延迟 + 云端大规模分析。
07 🔥 工业AI真正难的地方,不是"大模型"
到了2026年,几乎所有工业企业都在谈AI。
但真正把AI部署进生产环境后,企业很快会发现一个问题:
大模型本身并不是最大的难题。
真正难的是:
大模型怎么知道我的设备是什么?
怎么知道我的生产线发生过什么?
怎么读取过去三年的设备数据?
怎么理解企业内部的维修知识?
怎么调用数据分析工具?
怎么保证它没有越权?
怎么让它真正执行,而不是只会聊天?
这才是工业AI真正的"最后一公里"。
08 🤖 DolphinX:DolphinDB开始进入Agent时代
DolphinDB最近一个非常值得关注的变化,就是DolphinX。
从3.00.6版本开始,DolphinDB提供DolphinX Agent框架。
它允许用户通过自然语言与DolphinDB交互,可以进行数据库操作、脚本编写、脚本执行、结果解释和问题排查。
这意味着未来一个工程师面对数据库,可能不需要先写:
select ...
where ...
group by ...
而是直接问:
"查询3号机组过去24小时的振动数据。"
甚至:
"找出过去7天振动幅度异常的设备,并和历史正常状态进行对比。"
再进一步:
"根据过去30天的数据,帮我计算3号机组振动趋势,并生成异常分析脚本。"
Agent负责理解需求。
DolphinDB负责数据和计算。
这两者结合起来,才真正开始有点像工业AI。
09 🧩 MCP解决的是什么问题?
如果说DolphinX解决的是:
"怎么让AI理解和操作DolphinDB?"
那么MCP解决的是:
"怎么让AI调用更多工具?"
DolphinDB从3.00.4开始支持MCP Server,可以把自定义函数转换成MCP工具,让Agent调用DolphinDB的数据分析能力。
可以把它理解成:
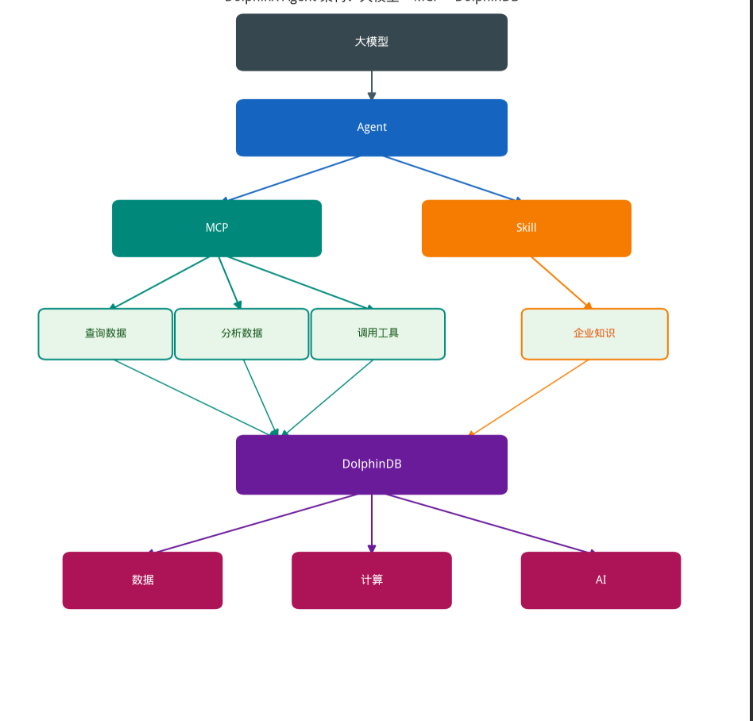
这时候,数据库就不再只是"存数据"。
而开始成为Agent可以调用的:
数据 + 计算 + 工具能力底座。
10 🧠 RAG、TextDB、VectorDB:让AI真正"认识企业"
工业企业还有大量数据不是数字。
比如:
设备维修手册
设备说明书
故障处理记录
检修报告
工程师经验
操作规程
事故复盘
生产日志
这些东西如果没有被AI利用,企业过去几十年积累的经验其实还是"躺在文档里"。
DolphinDB已经加入TextDB、VectorDB等能力。
TextDB主要解决文本检索问题,可以通过倒排索引对文本进行检索,并支持关键词、短语等检索方式;VectorDB则面向向量检索场景。
于是可以形成这样的企业知识链路:
例如工程师问:
"2号机组最近一次类似振动故障是什么原因?"
Agent可以进一步:
-
查询实时数据;
-
查询历史设备数据;
-
检索维修记录;
-
查询设备说明书;
-
找出相似案例;
-
进行数据分析;
-
最后给出判断依据。
这才是工业AI真正应该走的路线。
11 🧬 FeatureDB:AI时代的数据"新角色"
另一个值得关注的方向,是FeatureDB。
过去数据库主要保存:
原始数据。
但AI模型真正需要的往往是:
特征数据。
例如:
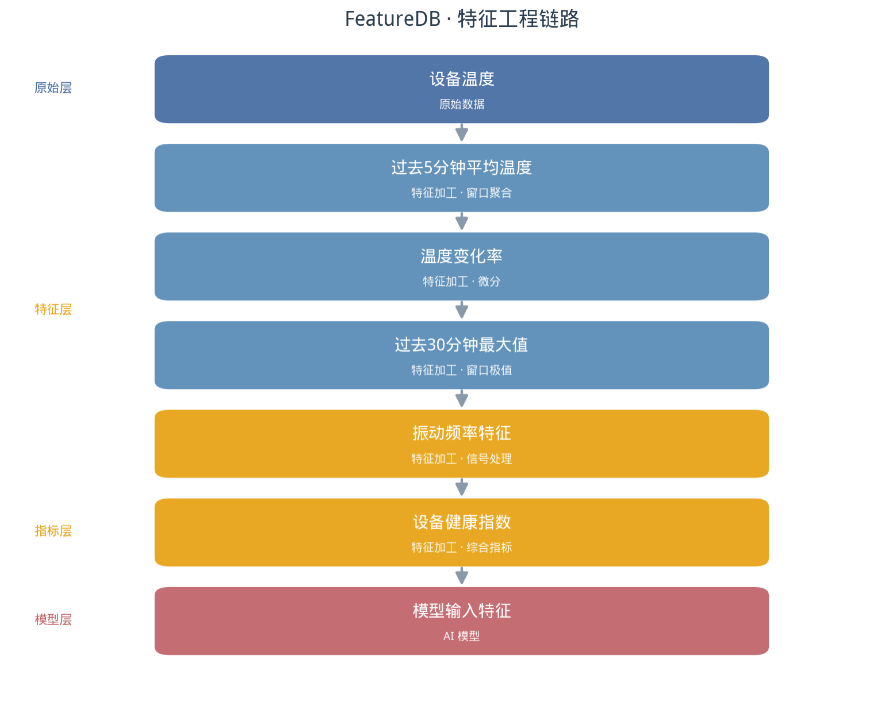
这些东西如果每次模型调用都重新计算,效率会受到影响。
DolphinDB 3.00.6引入FeatureDB,用于AI和机器学习场景下的低延迟特征存储,官方介绍其随机读取可达到微秒到几十微秒级,并支持面向机器学习的数据类型和宽表设计。
于是整个AI链路开始变成:
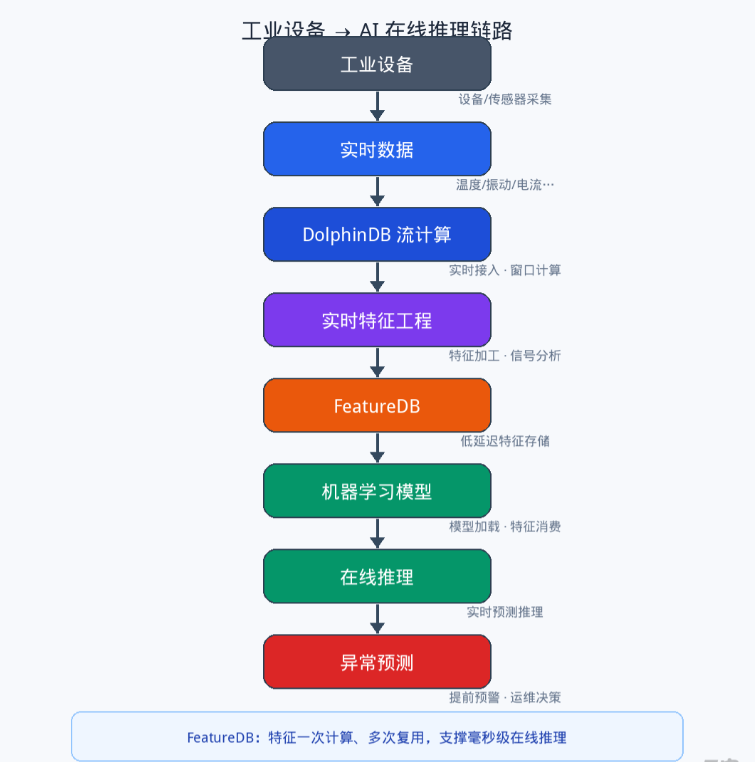
这比单纯"数据库+大模型"要更接近真正的工业智能化。
12 🏭 如果把DolphinDB放进一家制造企业,会是什么样?
假设现在有一家大型制造企业。
拥有:
-
20条生产线
-
数千台设备
-
数十万个数据测点
-
PLC/SCADA系统
-
MES系统
-
ERP系统
-
历史维修数据库
-
设备说明书
-
AI模型
那么可以设计成:
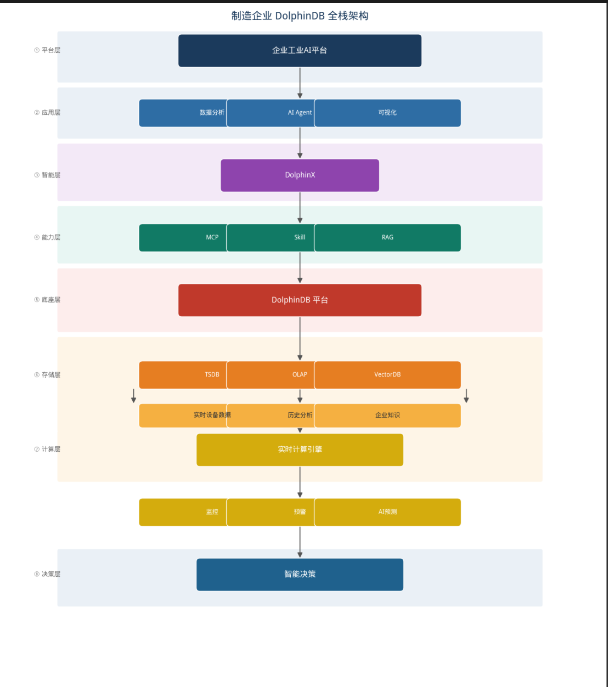
这样一来,数据库、计算、AI之间的距离就被明显缩短了。
13 🆚 DolphinDB真正适合什么场景?
如果让我简单总结,我认为它并不是为了取代所有数据库。
它最适合的,是下面这类场景:
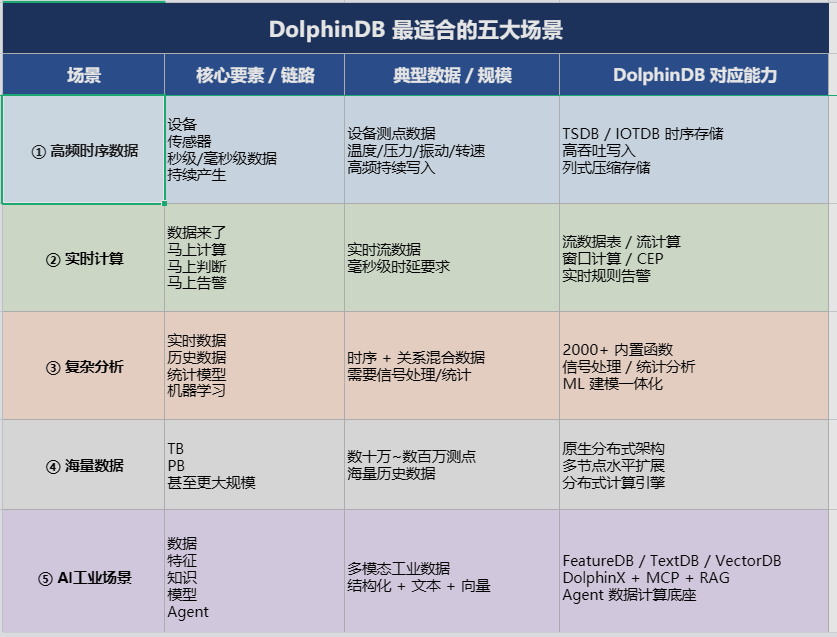
这些场景组合起来,才是DolphinDB真正的价值空间。
14 🧩 DolphinDB的未来,可能不只是"国产数据库"
如果把时间拉长来看,我认为DolphinDB真正值得关注的地方,并不是:
"它是不是又增加了一个数据库功能?"
而是它正在逐渐形成一条完整链路:
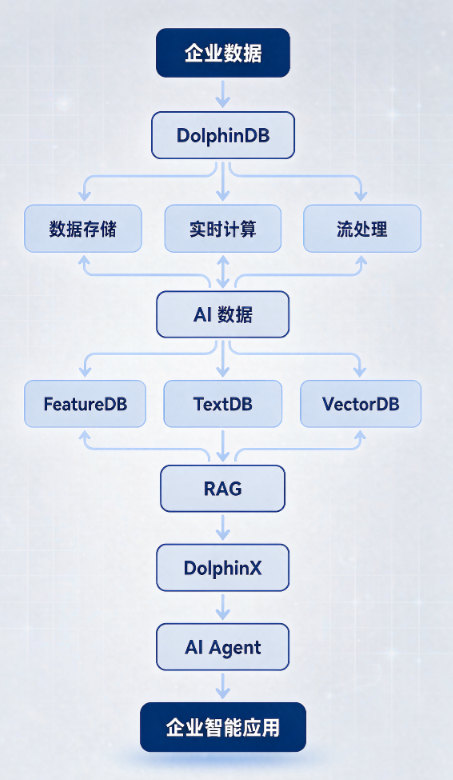
这条链路一旦真正打通,数据库的角色就会发生变化。
它不再只是:
"把数据放进去。"
而是:
让数据进入系统之后,马上能够被计算、分析、理解,并最终被AI调用。
15 🚀 这可能才是DolphinDB真正的"破局点"
回到文章最开始的问题:
工业物联网为什么需要DolphinDB?
答案其实已经很清楚了。
不是因为工业企业缺数据库。
而是因为工业数据正在发生三个变化。
第一,数据越来越实时
过去:
一天一张报表。
现在:
秒级甚至毫秒级数据。
第二,分析越来越复杂
过去:
查询一下历史数据。
现在:
实时数据 + 历史数据 + 算法 + 模型。
第三,AI开始进入生产系统
过去:
工程师分析数据。
现在:
Agent辅助工程师分析数据。
所以企业真正需要的底座正在变成:
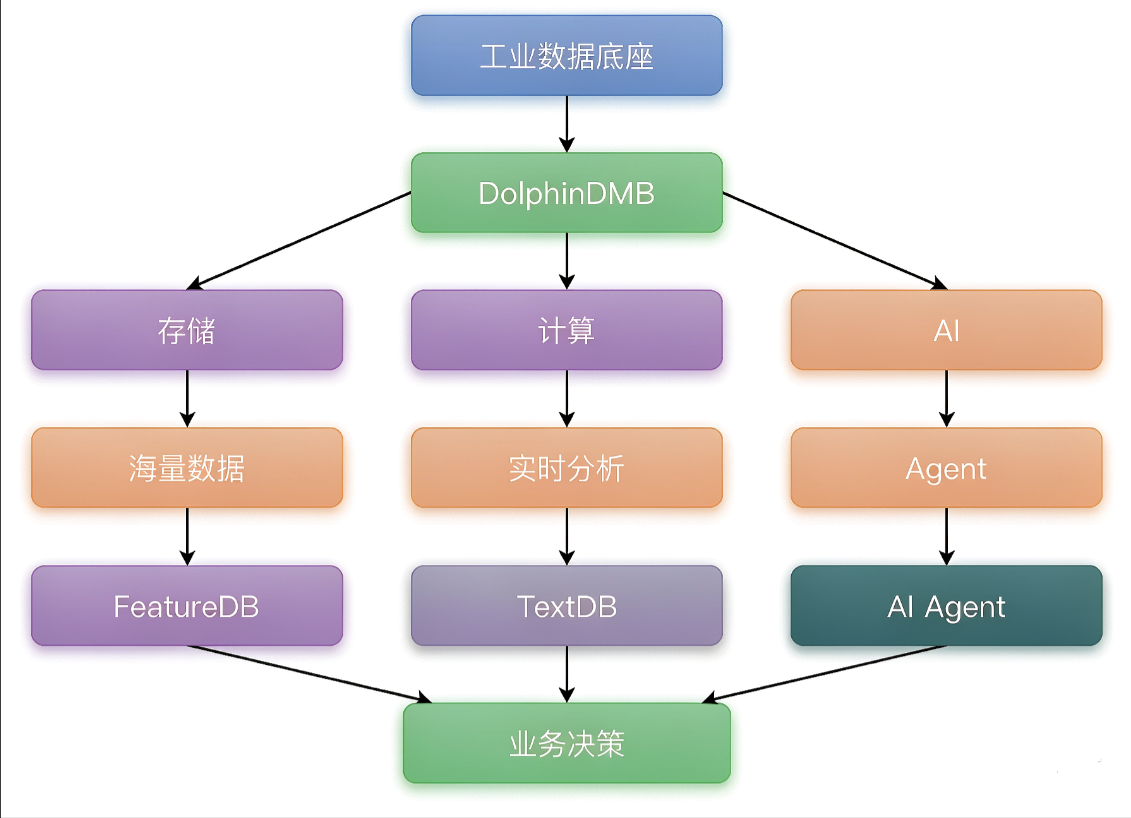
而DolphinDB正在努力把这三件事情放到同一个技术体系里面。
16 📝 写在最后
很多人第一次听到DolphinDB,可能会把它理解成:
"一个国产时序数据库。"
这个理解不能说错。
但如果只停留在这里,就很容易错过它现在正在发生的变化。
从高性能时序数据存储,到流式计算;
从复杂数据分析,到机器学习;
从TSDB,到TextDB、VectorDB、FeatureDB;
再到DolphinX、MCP、RAG和Agent。
DolphinDB正在尝试做的事情,其实已经越来越接近:
一个面向实时数据分析和AI应用的数据计算底座。
尤其是在工业物联网领域,这条路线非常值得观察。
因为工业现场真正缺的,从来不是"再建一个数据库"。
而是:
让设备产生的数据,能够更快地被看见、被计算、被理解,最后真正参与生产决策。
长江电力的实践已经说明,面对跨区域、大规模工业设备和海量测点数据,边缘实时计算与云端统一分析可以形成新的数据架构;而DolphinX、MCP、FeatureDB等新能力,则意味着这套底座正在进一步向AI时代延伸。
所以,如果未来工业互联网真正进入"AI原生"阶段,那么数据库可能也会发生一次角色变化:
过去,数据库负责保存企业的数据。
未来,数据底座需要进一步负责让数据产生计算、分析和智能。
而这,或许才是DolphinDB值得持续关注的原因。