Java
文章目录
基础篇
java的特点
- 平台无关性
- 面向对象
- 内存管理
Java的优点缺点
优点
- 跨平台
- 支持面向对象
- 拥有强大的生态系统
- 内存管理:自动垃圾回收机制
- 多线程支持
缺点
- 性能较低:使用JVM相较于cpp直接使用操作系统来说较慢,启动时间较长
- 语法繁琐
- 消耗内存:JVM本身就占用内存
- 开发效率较低
java为什么能跨平台
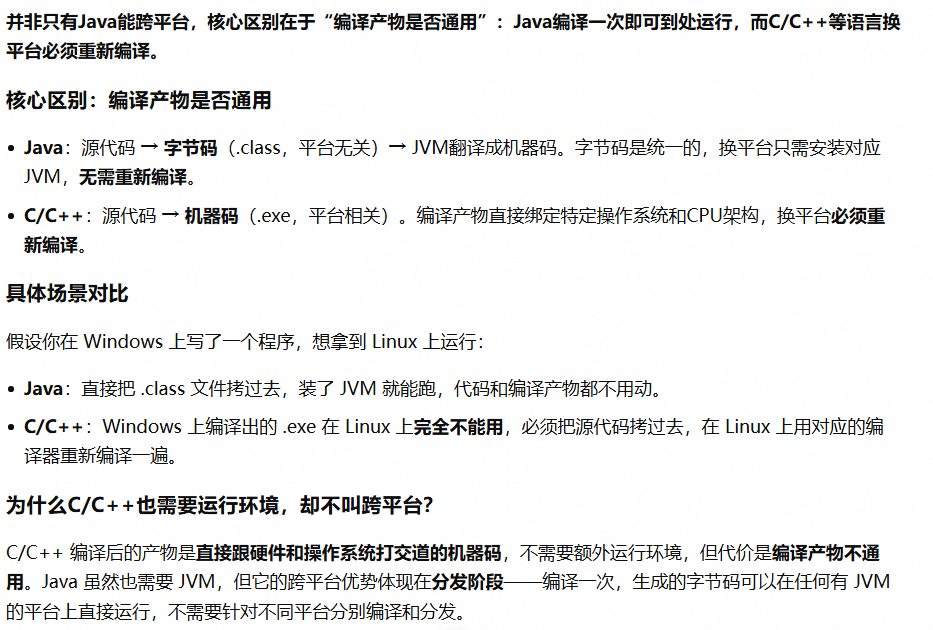
一次编译到处运行
Java 程序不是直接跑在操作系统上的,而是跑在 JVM(Java 虚拟机)上的
JVM
普通的翻译器(比如 C 编译器)是一次性翻译 ,翻译完就走了。而 JVM 是一直活着的,它在程序运行期间持续工作:
| 功能 | 说明 |
|---|---|
| 翻译字节码 | 把字节码翻译成机器码(JIT) |
| 内存管理 | 自动分配和回收内存(垃圾回收 GC) |
| 线程管理 | 管理 Java 线程的创建和调度 |
| 安全检查 | 数组越界检查、空指针检查等 |
| 类加载 | 动态加载 .class 文件 |
所以 JVM 不只是翻译器,它更像是一个**"虚拟的操作系统"**------它给 Java 程序提供了一个统一的运行环境,屏蔽了底层操作系统的差异
| Java | C++ | |
|---|---|---|
| 跨平台方式 | 编译一次,字节码到处跑 | 一套代码,每个平台分别编译 |
| 需要用户装什么 | JVM | 什么都不用装(直接是 .exe) |
| 开发者要做什么 | 不用管平台 | 需要处理平台差异(条件编译/跨平台库) |
| 运行性能 | 有 JVM 开销 | 直接跑机器码,性能最优 |
跨平台的是Java程序,不是JVM。JVM是用C/C++开发的,是编译后的机器码,不能跨平台,不同平台下需要安装不同版本的JVM
JDKJ&JRE&JVM
JDK是开发工具包,里面有编译器、调试工具这些,也包含了JRE。JRE是运行环境,包含了JVM和Java的核心类库。所以关系就是JDK大于JRE大于JVM
JVM是 java 虚拟机,主要工作是解释自己的指令集(即字节码)并映射到本地的CPU指令集和OS的系统调用。
JVM屏蔽了与操作系统平台相关的信息,使得Java程序只需要生成在Java虚拟机上运行的目标代码(字节码),就可在多种平台上不加修改的运行,这也是Java能够"一次编译,到处运行的"原因
为啥Java既有编译又有解释
| 编译型(C/C++) | 解释型(Python) | |
|---|---|---|
| 翻译时机 | 运行前,一次性全部翻译完 | 运行时,逐行翻译逐行执行 |
| 执行速度 | 快(直接跑机器码) | 慢(每次都要翻译) |
| 跨平台 | 差(编译产物绑定平台,换平台要重新编译) | 好(源代码通用,换平台装个解释器就行) |
| 调试 | 麻烦(编译完才能发现错误) | 方便(跑到哪行出错就停在哪行) |
| 代表语言 | C、C++、Go、Rust | Python、JavaScript、Ruby |
值传递和引用传递
对象在堆内存里只有一份,变量在栈内存里各自独立。 值传递复制的是变量(栈上的那份),但堆里的对象没有被复制
Java只有值传递
数据类型
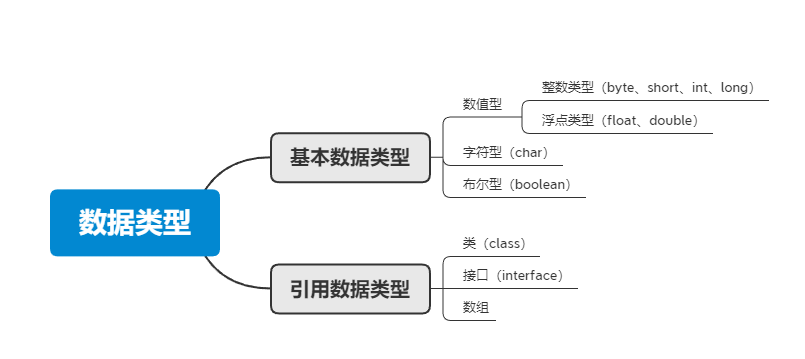
- Java八种基本数据类型的字节数:1字节(byte、boolean)、 2字节(short、char)、4字节(int、float)、8字节(long、double)
- 浮点数的默认类型为double(如果需要声明一个常量为float型,则必须要在末尾加上f或F)
- 整数的默认类型为int(声明Long型在末尾加上l或者L)
- 八种基本数据类型的包装类:除了char的是Character、int类型的是Integer,其他都是首字母大写
- char类型是无符号的,不能为负,所以是0开始的
类型转换
隐式转换:小范围类型赋值为大范围类型时,Java自动完成
byte → short → int → long → float → double
                ↑
              char 也可以自动转为 int
强制转换 :大范围类型赋值为小范围类型时,必须手动转换,(目标类型)值
字符串转换:将字符串转为其他类型
eg:转为intInteger.parseInt()
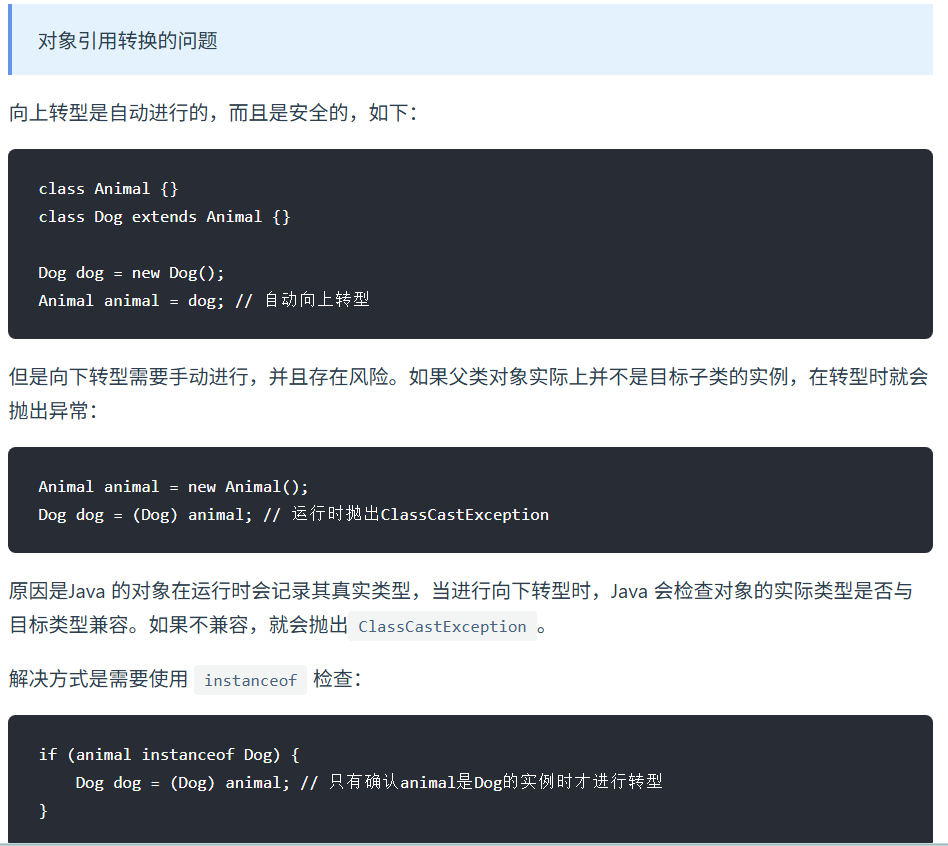
大转小可能出现的问题
- 数据溢出:此时会丢弃高位字节
- 精度损失:比如double转int小数部分会被舍弃
BigDecimal
为什么需要它?
double 和 float 用二进制存储小数,无法精确表示所有十进制数:
java
System.out.println(0.1 + 0.2);
// 输出:0.30000000000000004
//0.1+0.2 产生误差是因为二进制无法精确表示十进制小数,只能截断存储近似值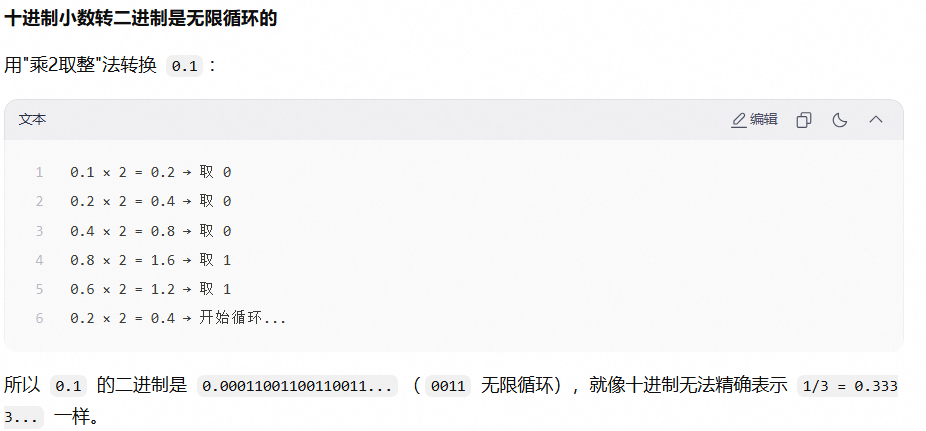
BigDecimal 底层是怎么实现高精度的
核心思路:彻底不用二进制浮点数,改用"整数 + 标度"来表示十进制数
整数在二进制中是精确的,不存在截断问题,所以从根源上避免了精度丢失
装箱和拆箱
装箱(Boxing)和拆箱(Unboxing)是将基本数据类型和对应的包装类之间进行转换的过程
java5引入自动拆装箱,编译器会在编译阶段自动帮你转换
弊端:
-
缓存机制(-128 ~ 127)
Integer.valueOf()对 -128 到 127 之间的值做了缓存,超出这个范围每次都会new新对象 -
null拆箱会抛空指针
-
性能损耗
自动装箱拆箱本质是创建对象和调用方法,频繁使用会有性能开销,循环中尽量避免
为啥要有包装类
核心原因是让基本类型也能参与到"万物皆对象"的面向对象体系中
-
泛型中的应用
在Java中,泛型只能使用引用类型,而不能使用基本类型。因此,如果要在泛型中使用int类型,必须使用Integer包装类。eg如果我们使用基本数据类型int,无法直接使用Collections.sort()方法
-
转换中的应用
在Java中,基本类型和引用类型不能直接进行转换,必须使用包装类来实现。例如,将一个int类型的值转换为String类型,必须首先将其转换为Integer类型,然后再转换为String类型
-
集合中的应用
Java集合中只能存储对象,而不能存储基本数据类型。因此,如果要将int类型的数据存储在集合中,必须使用Integer包装类
integer相比int有啥优点
核心优点在于它是对象,因此支持 null 语义、泛型与集合存储,并提供丰富的工具方法;但代价是更高的内存开销与自动装箱拆箱的性能损耗
int相比integer有啥优点
读写效率高,存储效率高
integer的缓存
integer类内部实现了一个静态缓存池,用于存储特定范围内的整数值对应的Integer对象。
默认情况下,这个范围是-128至127。当通过Integer.valueOf(int)方法创建一个在这个范围内的整数对象时,并不会每次都生成新的对象实例,而是复用缓存中的现有对象,会直接从内存中取出,不需要新建一个对象
面向对象
面向对象是一种编程范式,它将现实世界中的事物抽象为对象,对象具有属性(称为字段或属性)和行为(称为方法)。面向对象编程的设计思想是以对象为中心,通过对象之间的交互来完成程序的功能,具有灵活性和可扩展性,通过封装和继承可以更好地应对需求变化。
Java面向对象的三大特性包括:封装、继承、多态:
- 封装:封装是指将对象的属性(数据)和行为(方法)结合在一起,对外隐藏对象的内部细节,仅通过对象提供的接口与外界交互。封装的目的是增强安全性和简化编程,使得对象更加独立。
- 继承:继承是一种可以使得子类自动共享父类数据结构和方法的机制。它是代码复用的重要手段,通过继承可以建立类与类之间的层次关系,使得结构更加清晰。
- 多态:多态是指允许不同类的对象对同一消息作出响应。即同一个接口,使用不同的实例而执行不同操作。多态性可以分为编译时多态(重载)和运行时多态(重写)。它使得程序具有良好的灵活性和扩展性。
多态的体现
方法重载,方法重写,接口与实现,向上转型和向下转型
多态是指子类可以替换父类,在实际的代码运行过程中,调用子类的方法实现。多态这种特性也需要编程语言提供特殊的语法机制来实现,比如继承、接口类。
多态可以提高代码的扩展性和复用性,是很多设计模式、设计原则、编程技巧的代码实现基础。比如策略模式、基于接口而非实现编程、依赖倒置原则、里式替换原则、利用多态去掉冗长的 if-else 语句等等
面向对象的设计原则
- 单一职责原则(SRP):一个类应该只有一个引起它变化的原因,即一个类应该只负责一项职责。例子:考虑一个员工类,它应该只负责管理员工信息,而不应负责其他无关工作。
- 开放封闭原则(OCP):软件实体应该对扩展开放,对修改封闭。例子:通过制定接口来实现这一原则,比如定义一个图形类,然后让不同类型的图形继承这个类,而不需要修改图形类本身。
- 里氏替换原则(LSP):子类对象应该能够替换掉所有父类对象。例子:一个正方形是一个矩形,但如果修改一个矩形的高度和宽度时,正方形的行为应该如何改变就是一个违反里氏替换原则的例子。
- 接口隔离原则(ISP):客户端不应该依赖那些它不需要的接口,即接口应该小而专。例子:通过接口抽象层来实现底层和高层模块之间的解耦,比如使用依赖注入。
- 依赖倒置原则(DIP):高层模块不应该依赖低层模块,二者都应该依赖于抽象;抽象不应该依赖于细节,细节应该依赖于抽象。例子:如果一个公司类包含部门类,应该考虑使用合成/聚合关系,而不是将公司类继承自部门类。
- 最少知识原则 (Law of Demeter):一个对象应当对其他对象有最少的了解,只与其直接的朋友交互。
关键字
Java 中 final 作用是什么?
final关键字主要有以下三个方面的作用:用于修饰类、方法和变量。
- 修饰类:当
final修饰一个类时,表示这个类不能被继承,是类继承体系中的最终形态。例如,Java 中的String类就是用final修饰的,这保证了String类的不可变性和安全性,防止其他类通过继承来改变String类的行为和特性。 - 修饰方法:用
final修饰的方法不能在子类中被重写。比如,java.lang.Object类中的getClass方法就是final的,因为这个方法的行为是由 Java 虚拟机底层实现来保证的,不应该被子类修改。 - 修饰变量:当
final修饰基本数据类型的变量时,该变量一旦被赋值就不能再改变。例如,final int num = 10;,这里的num就是一个常量,不能再对其进行重新赋值操作,否则会导致编译错误。对于引用数据类型,final修饰意味着这个引用变量不能再指向其他对象,但对象本身的内容是可以改变的。例如,final StringBuilder sb = new StringBuilder("Hello");,不能让sb再指向其他StringBuilder对象,但可以通过sb.append(" World");来修改字符串的内容。
Java 中 static的作用是什么?
static 关键字主要用于修饰类的成员(变量、方法、代码块)和内部类,其核心作用是将成员与类本身关联,而非与类的实例(对象)关联。具体作用如下:
1、修饰变量
被 static 修饰的变量属于类本身,而非类的某个实例。所有对象共享同一份静态变量,内存中只存在一份副本。可以通过 类名.变量名 直接访问,无需创建对象(也可通过对象访问,但不推荐)。
通常用于存储所有对象共享的数据,如常量、计数器等。
java
public class Student {
    // 静态变量(所有学生共享同一个学校名称)
    public static String schoolName = "阳光中学";
    // 实例变量(每个学生有自己的姓名)
    private String name;
}

// 访问静态变量
public class Test {
    public static void main(String[] args) {
        System.out.println(Student.schoolName); // 直接通过类名访问
    }
}
2、修饰方法
静态方法属于类,不属于任何实例,因此不能直接访问类中的非静态成员(变量 / 方法) (因为非静态成员依赖于对象存在),但可以访问静态成员。通过 类名.方法名 直接调用,无需创建对象。
通常用于工具类方法(如 Math.random())、工厂方法等,不需要依赖对象状态即可完成操作。
java
public class MathUtils {
    // 静态方法(无需创建对象即可调用)
    public static int add(int a, int b) {
        return a + b;
    }
}

// 调用静态方法
public class Test {
    public static void main(String[] args) {
        int result = MathUtils.add(2, 3); // 直接通过类名调用
    }
}
3、修饰代码块
静态代码块在类初始化阶段 (即执行 <clinit> 时)执行,且只执行一次(优于对象构造方法),用于初始化静态变量或执行类级别的预处理操作。JVM 的类生命周期为:加载 → 链接(验证、准备、解析)→ 初始化,静态代码块属于"初始化"阶段而非"加载"阶段。
多个静态代码块按定义顺序执行,且先于非静态代码块和构造方法。
java
public class Database {
    private static String url;

    // 静态代码块:初始化静态变量
    static {
        url = "jdbc:mysql://localhost:3306/test";
        System.out.println("数据库连接地址初始化完成");
    }
}
4、修饰内部类
静态内部类不依赖于外部类的实例,可以独立存在,不能直接访问外部类的非静态成员(需通过外部类实例访问)。
当内部类与外部类的实例无关时使用,避免内部类持有外部类的引用导致的内存泄漏。
java
public class OuterClass {
    private static int staticVar = 10;
    private int instanceVar = 20;

    // 静态内部类
    public static class StaticInnerClass {
        public void print() {
            System.out.println(staticVar); // 可访问外部类静态变量
            // System.out.println(instanceVar); // 错误:不能直接访问非静态变量
        }
    }
}

// 使用静态内部类
public class Test {
    public static void main(String[] args) {
        OuterClass.StaticInnerClass inner = new OuterClass.StaticInnerClass();
        inner.print();
    }
}
浅拷贝深拷贝
- 浅拷贝是指只复制对象本身和其内部的值类型字段,但不会复制对象内部的引用类型字段。换句话说,浅拷贝只是创建一个新的对象,然后将原对象的字段值复制到新对象中,但如果原对象内部有引用类型的字段,只是将引用复制到新对象中,两个对象指向的是同一个引用对象。
- 深拷贝是指在复制对象的同时,将对象内部的所有引用类型字段的内容也复制一份,而不是共享引用。换句话说,深拷贝会递归复制对象内部所有引用类型的字段,生成一个全新的对象以及其内部的所有对象
反射
反射具有以下特性:
- 运行时类信息访问:反射机制允许程序在运行时获取类的完整结构信息,包括类名、包名、父类、实现的接口、构造函数、方法和字段等。
- 动态对象创建 :可以使用反射API动态地创建对象实例,即使在编译时不知道具体的类名。通常通过
Constructor.newInstance()方法实现(Class.newInstance()自 Java 9 起已被标记为@Deprecated,推荐使用clazz.getDeclaredConstructor().newInstance())。 - 动态方法调用:可以在运行时动态地调用对象的方法,包括私有方法。这通过Method类的invoke()方法实现,允许你传入对象实例和参数值来执行方法。
- 访问和修改字段值:反射还允许程序在运行时访问和修改对象的字段值,即使是私有的。这是通过Field类的get()和set()方法完成的。
反射机制就是java中代码控制代码的一种能力,让代码能动态地操控其他的代码,是实现软编码的其中一种技术
为啥字符串可以动态改变,直接new对象就不行
-
new关键字(静态编译):
使用new关键字是,必须在编译器就明确写出要创建的具体类名。编译器在翻译代码是,会严格校准这个类是否存在,如果不存在会报错。因此new的灵活性较低
-
反射机制(动态编译):
反射的核心能力是在运行期动态操作类,在反射中,类名仅仅是一个普通的字符串。对于编译器来说,字符串只是普通文本,它不会校准这个字符串对应的类是否存在,只有当程序真正运行到这一行时,JVM才会去内存中加载这个类,创建对象或调用
注解
注解本质是一个继承了Annotation的特殊接口,其具体实现类是Java运行时生成的动态代理类。
我们通过反射获取注解时,返回的是Java运行时生成的动态代理对象。通过代理对象调用自定义注解的方法,会最终调用AnnotationInvocationHandler的invoke方法。该方法会从memberValues这个Map中索引出对应的值。而memberValues的来源是Java常量池。
异常
-
Error(错误) : 表示运行环境的错误,错误是程序无法处理的严重问题,如虚拟机错误、动态链接库失效等。程序不应该尝试捕获这类错误。例如,OutOfMemoryError、StackOverflowError等。 -
Exception(异常): 表示程序本身可以处理的异常情况。异常分为两大类:
- 非运行时异常(受检异常,Checked Exception) : 这类异常在编译时就必须被捕获或者声明抛出。它们通常是外部错误,如文件不存在 (
FileNotFoundException)、类未找到 (ClassNotFoundException) 等。非运行时异常强制程序员处理这些可能出现的问题,增强了程序的健壮性。 - 运行时异常(非受检异常,Unchecked Exception 或 RuntimeException) : 这类异常特指
RuntimeException及其子类。它与Error一起构成了 Java 中的非受检异常 家族。运行时异常由程序逻辑错误导致,如空指针访问 (NullPointerException)、数组越界 (ArrayIndexOutOfBoundsException) 等。运行时异常是不需要在编译时强制捕获或声明的。
- 非运行时异常(受检异常,Checked Exception) : 这类异常在编译时就必须被捕获或者声明抛出。它们通常是外部错误,如文件不存在 (
Object
java 里 string的常用方法有哪些?
我常用的 String 常用方法有这些:
- 获取长度 :
int length():返回字符串的长度(字符个数)。例:"abc".length()→ 3 - 判断内容 :
boolean equals(Object obj):比较两个字符串的内容是否完全相同(区分大小写)。例:"abc".equals("ABC")→ false - 截取子串:
String substring(int beginIndex):从指定索引开始截取到末尾。例:"hello".substring(2)→ "llo" - 去除空格:
String trim():去除字符串首尾的空白字符(空格、制表符等)。例:" abc ".trim()→ "abc" - 替换内容:
String replace(char oldChar, char newChar):替换所有指定字符。例:"aaa".replace('a', 'b')→ "bbb" - 判断空字符串:
boolean isEmpty():判断字符串长度是否为 0(注意:null调用会报错,需先判空)。
String、StringBuffer、StringBuilder的区别和联系
1、可变性 :String 是不可变的(Immutable),一旦创建,内容无法修改,每次修改都会生成一个新的对象。StringBuilder 和 StringBuffer 是可变的(Mutable),可以直接对字符串内容进行修改而不会创建新对象。
2、线程安全性 :String 因为不可变,天然线程安全。StringBuilder 不是线程安全的,适用于单线程环境。StringBuffer 是线程安全的,其方法通过 synchronized 关键字实现同步,适用于多线程环境。
3、性能 :String 性能最低,尤其是在频繁修改字符串时会生成大量临时对象,增加内存开销和垃圾回收压力。StringBuilder 性能最高,因为它没有线程安全的开销,适合单线程下的字符串操作。StringBuffer 性能略低于 StringBuilder,因为它的线程安全机制引入了同步开销。
4、使用场景 :如果字符串内容固定或不常变化,优先使用 String。如果需要频繁修改字符串且在单线程环境下,使用 StringBuilder。如果需要频繁修改字符串且在多线程环境下,使用 StringBuffer。
对比总结如下:
| 特性 | String | StringBuilder | StringBuffer |
|---|---|---|---|
| 不可变性 | 不可变 | 可变 | 可变 |
| 线程安全 | 是(因不可变) | 否 | 是(同步方法) |
| 性能 | 低(频繁修改时) | 高(单线程) | 中(多线程安全) |
| 适用场景 | 静态字符串 | 单线程动态字符串 | 多线程动态字符串 |
java新特性
| 特性名称 | 描述 | 示例或说明 |
|---|---|---|
| Lambda 表达式 | 简化匿名内部类,支持函数式编程 | (a, b) -> a + b 代替匿名类实现接口 |
| 函数式接口 | 仅含一个抽象方法的接口,可用 @FunctionalInterface 注解标记 |
Runnable, Comparator, 或自定义接口 @FunctionalInterface interface MyFunc { void run(); } |
| Stream API | 提供链式操作处理集合数据,支持并行处理 | list.stream().filter(x -> x > 0).collect(Collectors.toList()) |
| Optional 类 | 封装可能为 null 的对象,减少空指针异常 |
Optional.ofNullable(value).orElse("default") |
| 方法引用 | 简化 Lambda 表达式,直接引用现有方法 | System.out::println 等价于 x -> System.out.println(x) |
| 接口的默认方法与静态方法 | 接口可定义默认实现和静态方法,增强扩展性 | interface A { default void print() { System.out.println("默认方法"); } } |
| 并行数组排序 | 使用多线程加速数组排序 | Arrays.parallelSort(array) |
| 重复注解 | 允许同一位置多次使用相同注解 | @Repeatable 注解配合容器注解使用 |
| 类型注解 | 注解可应用于更多位置(如泛型、异常等) | List<@NonNull String> list |
| CompletableFuture | 增强异步编程能力,支持链式调用和组合操作 | CompletableFuture.supplyAsync(() -> "result").thenAccept(System.out::println) |
序列化
Java 默认的序列化虽然实现方便,但却存在安全漏洞、不跨语言以及性能差等缺陷。
- 无法跨语言: Java 序列化目前只适用基于 Java 语言实现的框架,其它语言大部分都没有使用 Java 的序列化框架,也没有实现 Java 序列化这套协议。因此,如果是两个基于不同语言编写的应用程序相互通信,则无法实现两个应用服务之间传输对象的序列化与反序列化。
- 容易被攻击:Java 序列化是不安全的,我们知道对象是通过在 ObjectInputStream 上调用 readObject() 方法进行反序列化的,这个方法其实是一个神奇的构造器,它可以将类路径上几乎所有实现了 Serializable 接口的对象都实例化。这也就意味着,在反序列化字节流的过程中,该方法可以执行任意类型的代码,这是非常危险的。
- 序列化后的流太大:序列化后的二进制流大小能体现序列化的性能。序列化后的二进制数组越大,占用的存储空间就越多,存储硬件的成本就越高。如果我们是进行网络传输,则占用的带宽就更多,这时就会影响到系统的吞吐量。
用主流序列化框架,比如FastJson、Protobuf来替代Java 序列化。
如果追求性能的话,Protobuf 序列化框架会比较合适,Protobuf 的这种数据存储格式,不仅压缩存储数据的效果好, 在编码和解码的性能方面也很高效。Protobuf 的编码和解码过程结合.proto 文件格式,加上 Protocol Buffer 独特的编码格式,只需要简单的数据运算以及位移等操作就可以完成编码与解码。可以说 Protobuf 的整体性能非常优秀
设计模式
正确的双重检查锁定模式需要使用 volatile。volatile主要包含两个功能。
- 保证可见性。使用 volatile 定义的变量,将会保证对所有线程的可见性。
- 禁止指令重排序优化。
由于 volatile 禁止对象创建时指令之间重排序,所以其他线程不会访问到一个未初始化的对象,从而保证安全性。
代理模式和适配器模式有什么区别?
- 目的不同:代理模式主要关注控制对对象的访问,而适配器模式则用于接口转换,使不兼容的类能够一起工作。
- 结构不同:代理模式一般包含抽象主题、真实主题和代理三个角色,适配器模式包含目标接口、适配器和被适配者三个角色。
- 应用场景不同:代理模式常用于添加额外功能或控制对对象的访问,适配器模式常用于让不兼容的接口协同工作。
责任链模式使用场景是什么?
责任链模式的使用场景核心很明确,就是一个请求需要多个独立的处理逻辑来承接,同时不想让请求发起方和所有处理者产生强关联,还得让处理流程能灵活调整,简单说就是谁能处理就谁来接手,整个处理顺序和参与节点能按需改动。
策略模式
策略模式定义一系列算法,把它们一个个封装起来,并且使它们可相互替换。从而让算法可独立于使用它的客户而变化。
假设你正在开发一个电商网站的支付模块。用户可以选择支付宝、微信支付或者银行卡支付。每种支付方式的底层逻辑(比如调用的 API、加密方式、参数构造)都完全不同,但对于调用支付功能的上层业务逻辑来说,它只需要调用一个统一的 "支付" 方法即可,无需关心具体是哪种支付。
这就是策略模式的用武之地。我们把每种支付方式(支付宝、微信)都封装成一个独立的 "策略" 类,它们都遵循一个共同的接口。上层业务代码通过这个共同的接口来调用支付功能,并可以在运行时根据用户的选择,动态地切换不同的策略。
所以,策略模式适用场景如下:
- 当一个系统需要动态地在几种算法中选择一种时。
- 当一个对象有很多行为,不想使用大量的
if-else或switch-case语句来选择时。 - 当你希望算法的变化不会影响到使用它的客户端时。
责任链模式
责任链模式核心思想是为请求创建一个接收者对象的链。对请求的发送者和接收者进行解耦,让多个对象都有机会处理这个请求。请求沿着链传递,直到链上的一个对象处理它为止。
想象一下公司里的请假审批流程。一个员工要请假,他首先会把请假条交给自己的直属经理。如果请假天数很短(比如 1 天),经理自己就能批准。如果天数较长(比如 5 天),经理没有权限,就需要把请假条上报给部门总监。总监也有自己的审批权限上限,如果超过了,就需要继续上报给总经理。
在这个过程中,请假条(请求)就在一条由经理 -> 总监 -> 总经理(接收者链)上传递,直到某个角色(接收者)能够处理它。发送请假条的员工(客户端)并不知道最终是谁批准了他的假,他只需要把请求提交给链的第一个节点(经理)即可。
所以,责任链模式适用场景总结:
- 当有多个对象可以处理同一个请求,但具体由哪个对象处理需要在运行时决定时。
- 当你希望请求的发送者和接收者解耦,不直接通信时。
- 当你需要动态地指定和修改处理一个请求的对象集合时
I/O
- BIO(blocking IO):就是传统的 java.io 包,它是基于流模型实现的,交互的方式是同步、阻塞方式,也就是说在读入输入流或者输出流时,在读写动作完成之前,线程会一直阻塞在那里,它们之间的调用是可靠的线性顺序。优点是代码比较简单、直观;缺点是 IO 的效率和扩展性很低,容易成为应用性能瓶颈。
- NIO(non-blocking IO) :Java 1.4 引入的 java.nio 包,提供了 Channel、Selector、Buffer 等新的抽象,可以构建多路复用的、同步非阻塞 IO 程序,同时提供了更接近操作系统底层高性能的数据操作方式。
- AIO(Asynchronous IO) :也称 NIO.2,是 Java 1.7 引入的,对 NIO 的扩展,提供了异步非阻塞的 IO 操作方式,所以人们叫它 AIO(Asynchronous IO)。异步 IO 是基于事件和回调机制实现的,也就是应用操作之后会直接返回,不会阻塞在那里,当后台处理完成,操作系统会通知相应的线程进行后续的操作
NIO主要有三大核心部分:Channel(通道),Buffer(缓冲区), Selector。传统IO基于字节流和字符流进行操作,而NIO基于Channel和Buffer(缓冲区)进行操作,数据总是从通道读取到缓冲区中,或者从缓冲区写入到通道中。
Selector(选择区)用于监听多个通道的事件(比如:连接打开,数据到达)。因此,单个线程可以监听多个数据通道。
Native
在Java中,native方法是一种特殊类型的方法,它允许Java代码调用外部的本地代码,即用C、C++或其他语言编写的代码。native关键字是Java语言中的一种声明,用于标记一个方法的实现将在外部定义。
在Java类中,native方法看起来与其他方法相似,只是其方法体由native关键字代替,没有实际的实现代码
要实现native方法,你需要完成以下步骤:
- 生成 JNI 头文件 :使用
javac -h <dir>选项从你的 Java 类生成 C/C++ 的头文件,这个头文件包含了所有 native 方法的原型(注意:旧的独立工具javah自 Java 9 起被废弃,Java 10 已正式移除,应改用javac -h)。 - 编写本地代码:使用C/C++编写本地方法的实现,并确保方法签名与生成的头文件中的原型匹配。
- 编译本地代码:将C/C++代码编译成动态链接库(DLL,在Windows上),共享库(SO,在Linux上)
- 加载本地库:在Java程序中,使用System.loadLibrary()方法来加载你编译好的本地库,这样JVM就能找到并调用native方法的实现了
Java 进程是怎么跟操作系统交互的?
Java程序虽然是运行在JVM上的,但JVM本身就是一个操作系统进程,所以Java跟操作系统的交互,本质上是通过JVM这个中间层来完成的。
从用户态和内核态的角度说,Java代码运行在用户态,但IO、网络这些操作需要切换到内核态,这个切换是有开销的。JVM会做很多优化,比如用缓冲区减少系统调用次数。虽然JVM屏蔽了底层差异让Java代码跨平台,但在每个平台上JVM都要适配该平台的系统调用和API。