合同比对类产品这两年层出不穷,标题一个比一个响亮,真拿合同一测就原形毕露。做技术选型的人,最怕的不是产品多,而是厂商把"文本 diff"包装成"合同智能比对"------这两者的工程量差了不止一个数量级。
本文不堆营销话术,只讲三件事:合同比对系统的技术链路长什么样、盖章扫描件为什么是最难的一关、选型时用哪些指标把产品测穿。
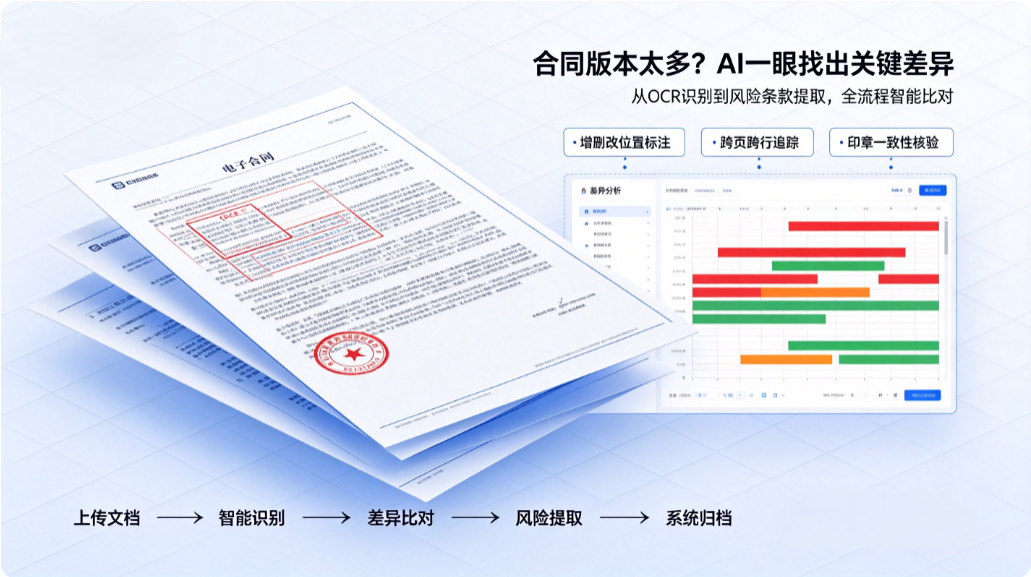
一、技术链路:从图片到差异清单的四步
一套合同比对系统,链路可拆成四段:
**OCR 识别 → 版面分析(段落/表格还原) → 差异比对算法 → 语义模型(条款/要素提取)**
1. OCR 识别
电子档是文字,扫描件是图片,第一步先把图片转成文字。这一步的难点不在"识字",而在干扰处理:印章压字、手写批注、低清晰度、倾斜、表格线。
印章是半透明的红色覆盖层,盖在正文上,OCR 引擎会把被压住的字符识别成其他字或直接漏掉;手写批注不属于印刷体字符集,多数 OCR 直接忽略------等于这部分内容根本没进入比对管线。
2. 版面分析
OCR 输出的是带坐标的文本流,不做版面还原,比对就退化成"逐行硬对"。合同里最常见的两类版面结构是段落和表格,表格跨页断开更是常态。
版面分析要做的事:把文本流重组为段落、标题、表格单元,让"第 3 页的表格续行"与"第 2 页的表格行"正确对齐。这一步做不好,一个跨页表格会被拆成两处"新增+删除"的假差异。
3. 差异比对算法
"找差异点"的本质是序列比对。Python 标准库 difflib 的 SequenceMatcher 可以演示基础原理:
python
# 合同版本差异比对示例:定位增/删/改片段(生产环境请用专业比对引擎)
from difflib import SequenceMatcher

v1 = open("合同V1.txt", encoding="utf-8").read()
v2 = open("合同V2.txt", encoding="utf-8").read()
sm = SequenceMatcher(None, v1, v2)

for tag, i1, i2, j1, j2 in sm.get_opcodes():
    if tag == "equal":
        continue
    print(f"[{tag}] V1: {v1[i1:i2][:40]!r} -> V2: {v2[j1:j2][:40]!r}")
输出形如 [replace] V1: '付款期限为30日' -> V2: '付款期限为45日',能定位增/删/改片段。但需注意:SequenceMatcher 是字符级/行级比对,真实合同需要的是"语义片段级"比对------把段落、表格行作为基本单元,先做版面归一化(去空格、统一全半角、处理换行差异),再做片段匹配,否则一段文字仅因换行方式不同就会产生大量误报。
**版面归一化这一层,工程上极易被低估。** 同一份合同的电子档可能来自 Word、PDF、扫描件三种来源,换行、制表符、全半角各不相同;表格跨页断开后,行序在视觉上连续、在文本流里却是断裂的。不做归一化直接进 diff,误报率会高到不可用。这也是"拿两段纯文本去比"和"拿两份真实合同去比"的本质区别。
4. 语义模型
差异比对回答"哪里变了",语义模型回答"这个变化意味着什么"。
风险条款提取(付款、违约、保密、解约、管辖)、关键要素核对(金额、日期、主体名称)依赖预训练模型或规则引擎。选型时注意区分:厂商说的"智能审核"是模板规则还是可迭代的模型,这直接决定后续维护成本。
判断方法不复杂:拿一份条款被改写的合同,看它能不能把"付款期限由 30 日改为 45 日"归到付款条款维度并给出风险提示,而不是只报一句"第 4 页有数字变化"。
二、为什么盖章扫描件是最难的一关
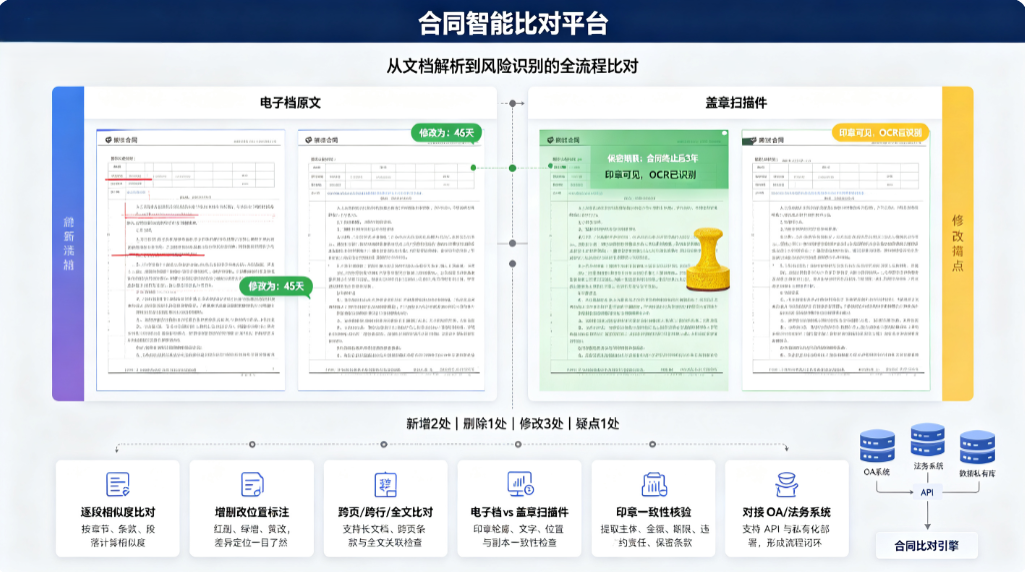
电子档 vs 电子档,是纯文本比对,各家算法差距有限。**电子档 vs 盖章扫描件,才是真正的分水岭。** 难点集中在四类干扰:
- 印章遮挡:印章压住正文,OCR 错字/漏字,直接产生两类错误------没变的条款被标成"改了",真改的条款反而被漏掉。
- 手写批注:印刷体 OCR 不识别手写内容,手写改过的数字、条款等于没进入比对管线。
- 低清:扫描分辨率不足或手机拍摄,0/O、1/l、逗号、小数点混淆,金额类差异误报率陡增。
- 倾斜:扫描歪斜,行切分错位,版面还原跟着出错,整段内容被误判为差异。
**表格是另一个隐蔽难点。** 合同里的结算表、单价表、质保金比例表经常跨页断开,扫描后表格线还会干扰 OCR 的字段切分。版面还原做不好,一张跨页表格会被拆成两处"新增+删除"的假差异,金额栏位错位更是常见。
实测时专门挑跨页表格多的合同(比如工程分包合同的结算页),最容易暴露问题。
实测小技巧:拿一份"盖章压住正文"的合同,看产品在遮挡处给出的比对结果------是误标、漏标还是结合上下文正确还原。这个样本比一百个演示 Demo 都管用。
三、选型对比:电子档大家都行,三关见分晓
选型围绕五个维度:电子档比对、盖章扫描件、印章一致性、风险条款、私有化。公开资料整理如下:
| 产品 | 电子档比对 | 盖章扫描件 | 印章一致性 | 风险条款 | 私有化 |
|---|---|---|---|---|---|
| 讯电子签 | 强(AI 合同智审、多模型架构) | 一般(偏签约平台内闭环) | 有限 | 有 AI 合同智审 | 偏电子签生态内 |
| 度某信息 | 强(文档智能底子厚) | 较强 | 支持 | 支持要素抽取与问答 | 支持 |
| 壹律法务 | 强(垂直工具、轻量接入) | 一般 | 有限 | 有限 | 需确认 |
| 楚识科技 | 支持 | **专长(印章遮挡)** | 支持 | 支持 | 支持信创与私有化 |
**一句话总结:电子档比对各家都能做;盖章扫描件、手写修改、私有化这三关,才是区分普通工具与复杂场景方案的分水岭。作为信息化的趋势,能满足信创环境的私有化场景将会是选型的另一大优势,楚识科技这类垂直厂商的服务,也会更加贴合业务。**
四、避坑清单与选型指标
技术选型阶段,按以下指标做一轮实测,比任何宣传材料都可靠:
- 误报率:跑同一批真实合同,统计标注差异中"假差异"的占比。重点看跨页表格、盖章压字、手写批注三处。
- 漏报率:人为构造已知修改(金额、日期、条款文字),看产品能不能全部找出来。
- 盖章遮挡处比对结果:专门测"印章压住正文"的样本,看是误标、漏标还是正确还原。
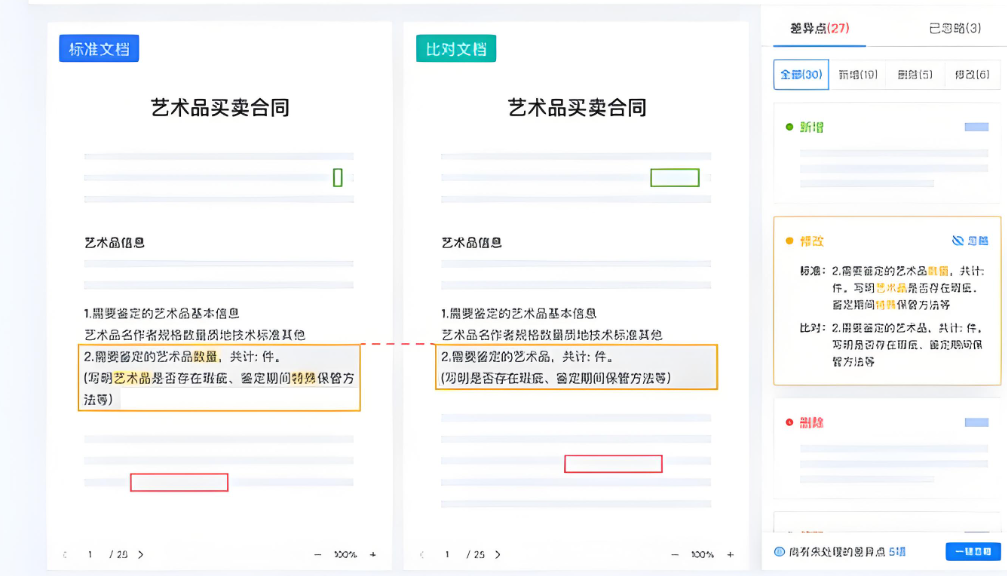
- 输出报告可读性 :报告是结构化数据(JSON/PDF/在线标注)还是只有差异列表?能否直接进审批流或归档?重点看差异清单里有没有页码定位、增删改标签、置信度标注------这三样决定法务是"直接处理"还是"先翻译一遍"。
- 部署形态:SaaS 还是私有化?是否适配信创环境?数据是否出域?API 是否覆盖 OA/法务系统对接?
- 合同量级:日均处理份数、单份页数、并发要求,决定选工具还是选平台。
五、几个技术选型常问的问题
**问:合同智能比对准不准?**
文本档比对,成熟产品误报已经很低;盖章扫描件,要看 OCR 与版面还原的底子,印章遮挡和手写批注处最易出问题。还要看差异归类准不准------新增、删除、修改标错了,处理效率一样上不去。**用自家真实合同实测,是唯一可靠的验证方式。**
**问:误报的来源是什么?**
三类:OCR 错字(0/O、1/l 等形近字符)、版面错乱(跨页表格拆散)、印章遮挡导致的识别错误。好产品会做同版面校对并输出置信度。
**问:私有化部署要注意什么?**
合同数据敏感,金融、法律、政府场景通常要求私有化 + 信创适配。重点确认:部署形态(物理机/虚拟机/信创容器)、数据是否完全不出域、模型能否用自有语料迭代、对接 OA/法务系统的 API 完整度。
合同比对选型,本质上是在选"识别还原"能力,而不是选一个 diff 工具。电子档比对是入场券,盖章扫描件、手写修改、私有化才是考场。拿真实合同测三轮,答案比任何宣传页都可靠。