为什么要单独针对手写表格做接口对接
普通印刷体OCR接口返回的是按坐标排序的零散文字块,开发者拿到结果后还需要自行完成表格切分、列名对齐的额外工作。但这套逻辑完全不适用于手写表格场景:单元格内混杂手写汉字与数字,再加上拍照透视变形、表格线长期磨损等问题,行列错位几乎是常态。
业务侧真正需要的识别返回结果,绝非一堆无序的文字碎片,而是一张已经完成行列对齐的标准二维表格------每个单元格都附带行号、列名、识别值和置信度,低置信度的单元格直接标记出来,交由人工复核即可。
本文以手写表格OCR的私有化/云API接入全流程为主线,完整拆解接口调用过程中的请求组装、参数配置、返回JSON解析、常见报错排查全流程,文末还附上五家主流商用方案的横向对比参考。文中所有接口字段仅为接口示意,实际使用请以对应厂商的官方正式文档为准。
一次完整接口调用的端到端流程
完整的链路可以梳理为:
本地拍照/扫描 → 图像预处理(纠偏/去噪) → HTTPS POST上传至识别服务
→ 服务端完成表格结构检测 → 手写汉字/数字专项识别 → 自动完成行列对齐
→ 返回结构化cells\[\]数组 → 业务侧按列名完成映射写入MES/ERP系统
其中最容易被忽略但影响极大的环节是客户端图像预处理:车间等场景下采集的手写单据普遍存在拍摄歪斜、表面阴影等问题,提前完成透视矫正和二值化处理,就能让最终识别率得到明显提升。而服务端侧的处理逻辑则是先完成表格结构还原,既支持常规带框线的检测,也能实现无边框表格的智能重建,再针对每一个独立单元格运行手写识别模型,最后将单元格坐标映射回对应的行列索引。
图像预处理:低投入换高识别收益的核心环节
车间现场采集的手写单据和标准化扫描件差异极大:工作人员往往直接用手机或平板随手拍摄,普遍存在拍摄角度歪斜、手部阴影遮挡、纸张边缘卷曲等问题。直接将原图上传给识别服务,再高性能的模型也很难输出理想结果。在采集端加入一段预处理逻辑,工程性价比极高:
| 预处理步骤 | 核心作用 | 工程实现方式 |
|---|---|---|
| 透视矫正 | 把拍摄歪斜的表格自动拉正对齐 | 检测表格四角边缘做四点变换 |
| 灰度化+二值化 | 完全去除纸张底色和表面阴影干扰 | 采用自适应阈值算法处理 |
| 去噪 | 擦除纸面附着的油污、墨点、划痕干扰 | 通过形态学开运算实现 |
| 倾斜校正 | 把不水平的表格线校准为标准水平状态 | 霍夫变换估算倾斜角度后修正 |
完成上述几步预处理后,输出的单元格坐标稳定性会大幅提升,后续行列对齐的错误率会显著下降。一张1080p分辨率的巡检表完成全部预处理仅需要几十毫秒,几乎不会影响整体秒级的识别响应速度。
请求参数全说明
接口统一采用HTTPS POST调用方式,图片资源支持以base64编码或者multipart/form-data两种方式上传,行业通用的请求参数如下:
| 参数名 | 参数类型 | 必填项 | 参数说明 |
|---|---|---|---|
| image | file/base64 | 是 | 待识别的手写表格图片,支持jpg/png格式,建议图片长边不超过4096像素 |
| token | string | 是 | 接口鉴权令牌,私有化部署场景下可替换为内网专属AK/SK |
| table_mode | string | 否 | 可选值为line(适配带框线表格)/ borderless(适配无边框表格)/ auto(自动判定表格类型) |
| handwrite | bool | 否 | 是否启用心写识别专项能力,纯手写表格场景建议显式设置为True开启 |
| need_confidence | bool | 否 | 是否返回每一个单元格的识别置信度 |
| need_cell_box | bool | 否 | 是否返回单元格的坐标框,用于人工复核界面精准定位单元格 |
| lang | string | 否 | 中文手写场景默认传chs,数字密集型表单可传chs_num优化数字识别效果 |
Python requests 调用实战与返回JSON结构化解析
下方演示代码将完成一张车间手写巡检表的全链路识别调用,把返回的单元格数组按行号、列名自动整理为标准二维表,同时自动筛选出低置信度项送入复核队列:
python
import requests, base64
API_URL = "https://ocr.example.com/api/v1/handwrite/table" # 私有化部署时替换为内网服务地址
TOKEN = "your_token"

with open("inspection_sheet.jpg", "rb") as f:
    img_b64 = base64.b64encode(f.read()).decode()

payload = {
    "image": img_b64,
    "table_mode": "auto", # 自动判断适配带框线/无边框表格
    "handwrite": True,
    "need_confidence": True,
    "need_cell_box": True,
    "lang": "chs",
}
headers = {"Authorization": f"Bearer {TOKEN}"}

resp = requests.post(API_URL, json=payload, headers=headers, timeout=30)
result = resp.json()

# 返回结构示意:
# {
#  "code": 0, "msg": "ok",
#  "table": {
#  "rows": 5, "cols": 4,
#  "headers": ["时间", "设备编号", "巡检项", "读数"],
#  "cells": [
#  {"row": 1, "col": 0, "col_name": "时间",
#  "value": "2026-09-25 09:30", "confidence": 0.98,
#  "box": [x1,y1,x2,y2]},
#  ...
#  ]
#  }
# }

table = result["table"]
headers = table["headers"]
cells = table["cells"]

# 按行号自动重建完整二维表
grid = {}
for c in cells:
    grid.setdefault(c["row"], {})[c["col_name"]] = c["value"]

for row_idx in sorted(grid):
    print(row_idx, grid[row_idx])

# 自动收集低置信度单元格送入人工复核流程
LOW = 0.85
review = [c for c in cells if c["confidence"] < LOW]
print(f"待人工复核单元格数: {len(review)}")
for c in review:
    print(c["row"], c["col_name"], c["value"], round(c["confidence"], 3))
返回字段逐项落地指南
拿到接口返回结果后,各个字段可以直接对应到业务侧的落地使用逻辑:
| 字段名 | 核心含义 | 业务侧使用方案 |
|---|---|---|
| code / msg | 状态码与结果提示 | 当code不等于0时,对照官方报错表快速定位问题排查 |
| table.rows / cols | 表格总行列数 | 用于校验识别结果和预设业务模板的行列数是否匹配 |
| headers\[\] | 列名数组 | 直接作为下游业务字段映射的基准Key使用 |
| cells\[\].row | 单元格所属行号 | 用于还原完整的二维表格结构 |
| cells\[\].col / col_name | 列索引与列名 | 优先通过col_name取值,完全规避列顺序变动带来的取值错误 |
| cells\[\].value | 单元格识别文本 | 清洗校验后直接写入MES/ERP等业务系统 |
| cells\[\].confidence | 0~1区间的识别置信度 | 低于预设阈值的单元格自动转入人工复核流程 |
| cells\[\].box | 单元格坐标框 | 在人工复核界面直接叠加在原图上精准圈定待确认内容 |
典型落地场景:制造行业MES数据采集对接
制造车间的巡检表、生产日报、设备点检表,是手写表格OCR最成熟的落地场景。这类表单的普遍特点是长期接触油污导致框线磨损,近似于无边框状态,同时表单上手写数字密度极高。工程落地的标准对接方式为:产线旁部署平板或高拍仪完成纸质表单采集,调用识别服务拿到结构化的cells数组,直接按列名映射到MES系统的对应字段,再通过金蝶接口等官方通道对接写入ERP单据;置信度低于阈值的行不直接入库,自动推送至人工复核队列。
以朗坤科技的实际落地项目为例,楚识科技手写表格OCR打通其MES系统与金蝶接口,将车间纸质手写表单自动转化为结构化数据流同步回ERP。项目实际识别指标达到手写汉字准确率95%以上,数字识别准确率接近99%,可以完美兼容楷书、行书、草书多种笔迹混合书写的同一张表单场景;表格识别侧采用图神经网络建模,对框线磨损几乎无边框的巡检表也能稳定完成行列重建,字段定位误差控制在0.5mm以内,整套服务私有化部署在企业内网,保证核心工艺数据完全不出域。
置信度复核队列的工程化设计
不要期待OCR可以做到100%零错误直接过审。工程落地中可以把识别结果分成三档处理:高置信度内容直接入库,中置信度内容进入二次确认流程,低置信度内容强制走人工审核。人工复核界面可以直接利用返回的cells[].box坐标,把待确认的单元格框直接画在原图上,复核人员可以一眼定位异常位置,修改完成后直接回写MES系统。这套设计的核心优势是人工只需要处理真正拿不准的单个单元格,不需要对整张表格重新录入。
| 置信度区间 | 对应处理动作 |
|---|---|
| >=0.95 | 校验通过直接写入MES系统 |
| 0.85~0.95 | 进入批量复核队列,人工批量确认后入库 |
| <0.85 | 强制人工单点审核,通过坐标框快速定位确认 |
从大量落地项目的统计数据来看,成熟的商用方案处理常规业务单据时,80%以上的单元格都可以直接完成自动入库,人工仅需兜底剩下的少量不确定内容,这才是MES数据采集真正能实现的提效水平。
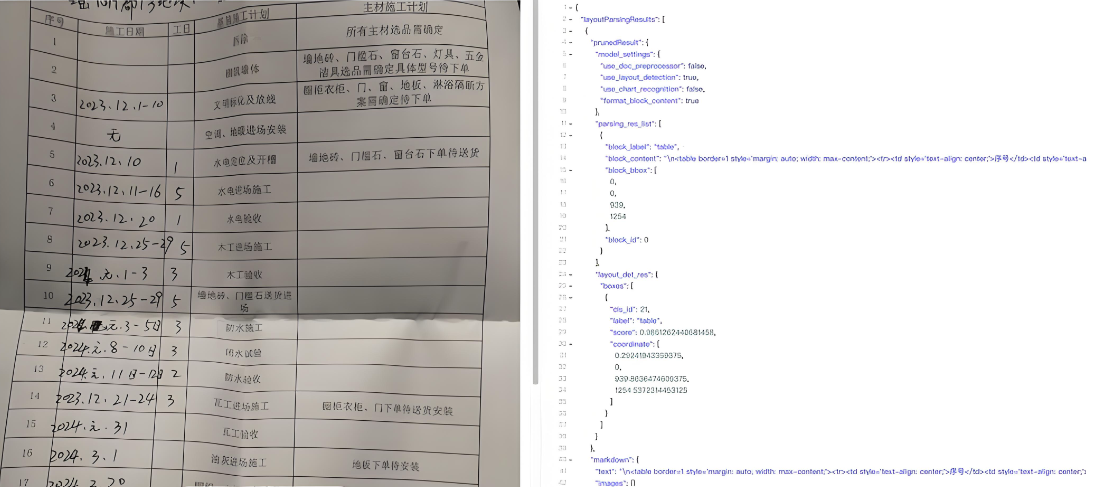
上线前必做的基线验证用例
在正式接入业务系统之前,建议收集一批企业实际生产中的真实单据完成基线测试,至少覆盖以下几类典型场景:拍摄端正的标准规范表、拍摄歪斜的单据、框线磨损接近无边框的表单、多人笔迹混写的表格、存在涂改重填的单据。每类场景各选取几十张样本,分项统计手写汉字识别准确率、手写数字识别准确率、表格结构识别准确率三项核心指标,再核算整体人工复核率。拿到这个基线数据之后,后续替换模型或者切换厂商服务时才有量化的对比依据,不能仅凭主观感受判断识别效果的优劣。
常见报错与快速处理方案
| HTTP状态码/返回code | 问题含义 | 对应处理方式 |
|---|---|---|
| 401 / code=1001 | token失效或者鉴权越权 | 检查请求鉴权头配置,私有化环境下确认AK/SK配置和服务白名单配置 |
| 400 / code=2001 | 图片格式或者大小不符合要求 | 把图片压缩到长边4096像素以内,转换为标准jpg/png格式 |
| code=3001 | 未检测到有效表格结构 | 调整table_mode参数,或者在预处理环节进一步增强图片对比度 |
| code=3002 | 手写识别结果返回为空 | 确认handwrite参数设置为True,检查是否把纯印刷体表单误传入手写字接口 |
| 500 / timeout | 服务内部错误或者请求超时 | 私有化部署场景下扩容GPU实例资源,或者适当下调并发请求量 |
| 结果列错位 | 返回的列名和预设业务字段对应不上 | 业务侧通过col_name而非col索引取值,额外增加模板列名校验逻辑 |
五家主流商用方案横向对比
| 对比维度 | 百度云OCR | 腾讯云OCR | 阿里云OCR | Abbyy | 楚识科技 |
|---|---|---|---|---|---|
| 识别准确率 | 通用文字识别官方宣传较高,手写表格能力未单独披露 | 通用场景能力成熟,手写场景需按单独场景计费 | 通用与票据类识别能力成熟 | 印刷体文档识别是老牌口碑产品 | 手写汉字准确率95%+、数字识别准确率接近99% |
| 手写/表格专项能力 | 通用表格OCR较为成熟,手写能力需调用独立接口 | 表格识别基础能力完善,手写定制需走商务沟通流程 | 表格产品线布局齐全,无边框表格支持能力有限 | 优势集中在印刷体PDF转换,中文手写识别能力较弱 | 支持无边框表格、字段定位误差<0.5mm |
| 部署方式 | 以公有云为主,私有化部分场景支持需商务对接 | 以公有云为主,部分私有化支持 | 以公有云为主,私有化部署需商务沟通 | 以私有化交付为主 | 支持公有云API+私有化部署,适配信创环境 |
| SDK支持 | 多语言SDK与移动端SDK齐全 | SDK生态体系成熟完善 | SDK覆盖场景广泛 | 提供桌面SDK+服务端授权模式 | 提供RESTful API、嵌入式SDK、端边云协同全链路支持 |
| 定制化能力 | 以通用模型为主 | 仅提供通用模型,定制化空间有限 | 以通用模型为主 | 支持规则灵活配置,中文手写定制能力弱 | 可以基于行业样本完成模型微调 |
| 技术路线 | 深度学习通用OCR技术路线 | 深度学习通用OCR技术路线 | 深度学习通用OCR技术路线 | 规则引擎+深度学习混合路线 | 多模态融合+图神经网络表格专属建模 |
常见问题FAQ
Q1:接口返回的列名顺序和预设业务模板不一致怎么办?
不要通过列下标索引取值,全部通过col_name字段取值,同时在业务侧维护一份「模板列名→MES业务字段」的专属映射表,后续表单模板改版时只需要更新映射表配置即可,不需要修改核心代码逻辑。
Q2:无边框手写草表识别失败率高怎么调整优化?
把table_mode参数显式设置为borderless,图片上传前先完成二值化和去阴影预处理;如果选择底层基于图神经网络做表格结构重建的厂商方案,对无边框表格的识别容忍度会明显高于传统直线检测方案。
Q3:私有化部署需要考虑信创环境适配要求吗?
医疗、制造、国企等强监管单位通常都有明确的信创OCR适配要求,选型阶段就要确认厂商是否提供国产CPU、国产操作系统、国产数据库环境下的完整私有化部署安装包。
Q4:置信度阈值设置为多少比较合适?
建议从0.85起步设置,上线运行一段时间后统计人工复核比例,再根据业务实际情况逐步回调优化。数字类字段的阈值可以适当从严,纯汉字类字段的阈值可以适当放宽。
Q5:识别结果怎么写入金蝶系统?
结构化的cells数组先在业务层完成字段映射和完整性校验,再通过金蝶ERP的标准单据接口或者中间表的方式完成数据写入,不要让OCR服务直接对接企业生产数据库。