目录
前言
学习赵老师讲授的强化学习的数学原理视频,本篇文章记录第八讲 Part 4:值函数近似(原理-示例与分析),记录个人学习笔记,和大家一起分享交流😄
1. Illustrative examples
下面我给出一些直观的例子来帮助大家更好地去理解,这几个例子我觉得非常直观、有代表性,希望大家看一下。
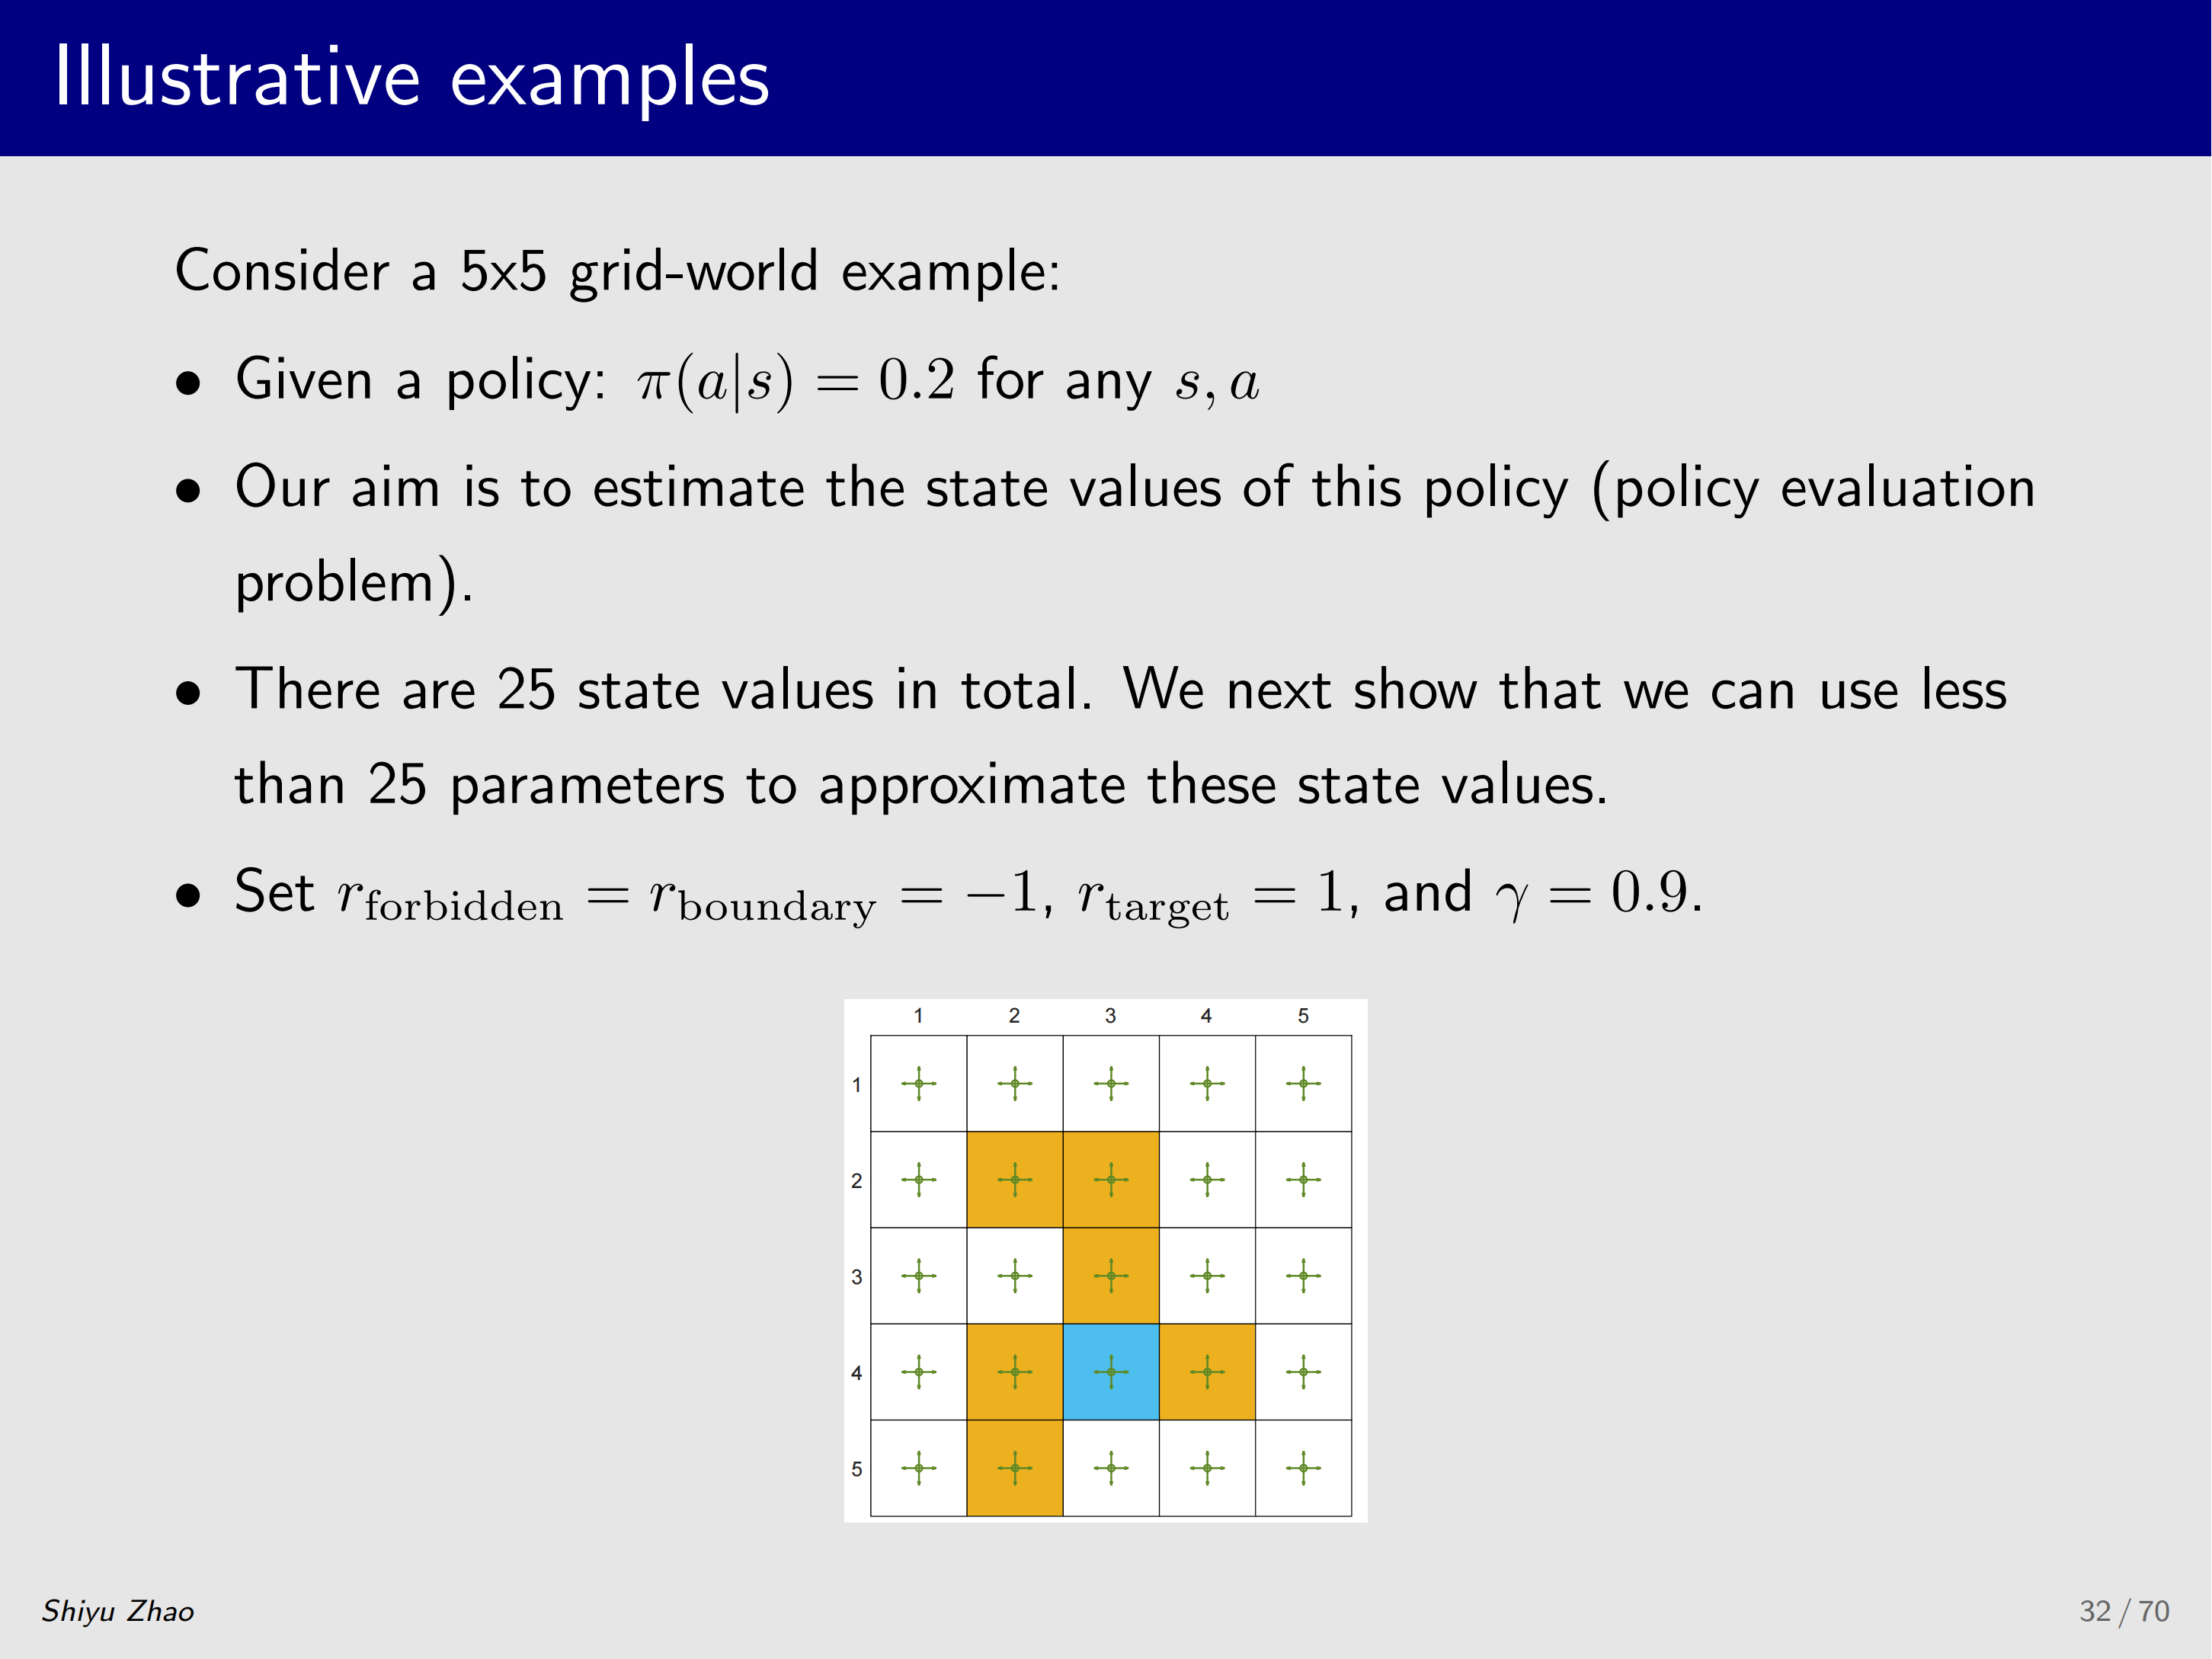
这个例子仍考虑我们的 grid-world example ,这里是 5×5 的,一共有 25 个状态,首先给出一个策略,用箭头表示(如图),大家也可以看到,这个策略是一个 探索性的策略,在每一个状态,它对 5 个 action 都有相同的概率 0.2。
我们下面要做的是什么呢?就是估计这个策略所对应的 state value ,对每个状态都要计算出它的 state value,这个本质上来说是一个 policy evaluation 的问题,如果用基于表格的方法,肯定要存储 25 个 state value,但下面我们来用 TD-Linear 的方法来计算,大家接下来会看到 用较少的参数也能较好地近似这 25 个 state value。
下面给出这个例子的一些参数:
r forbidden = r boundary = − 1 , r target = 1 , γ = 0.9 r_{\text{forbidden}}=r_{\text{boundary}}=-1, \, r_{\text{target}}=1, \, \gamma=0.9 rforbidden=rboundary=−1,rtarget=1,γ=0.9
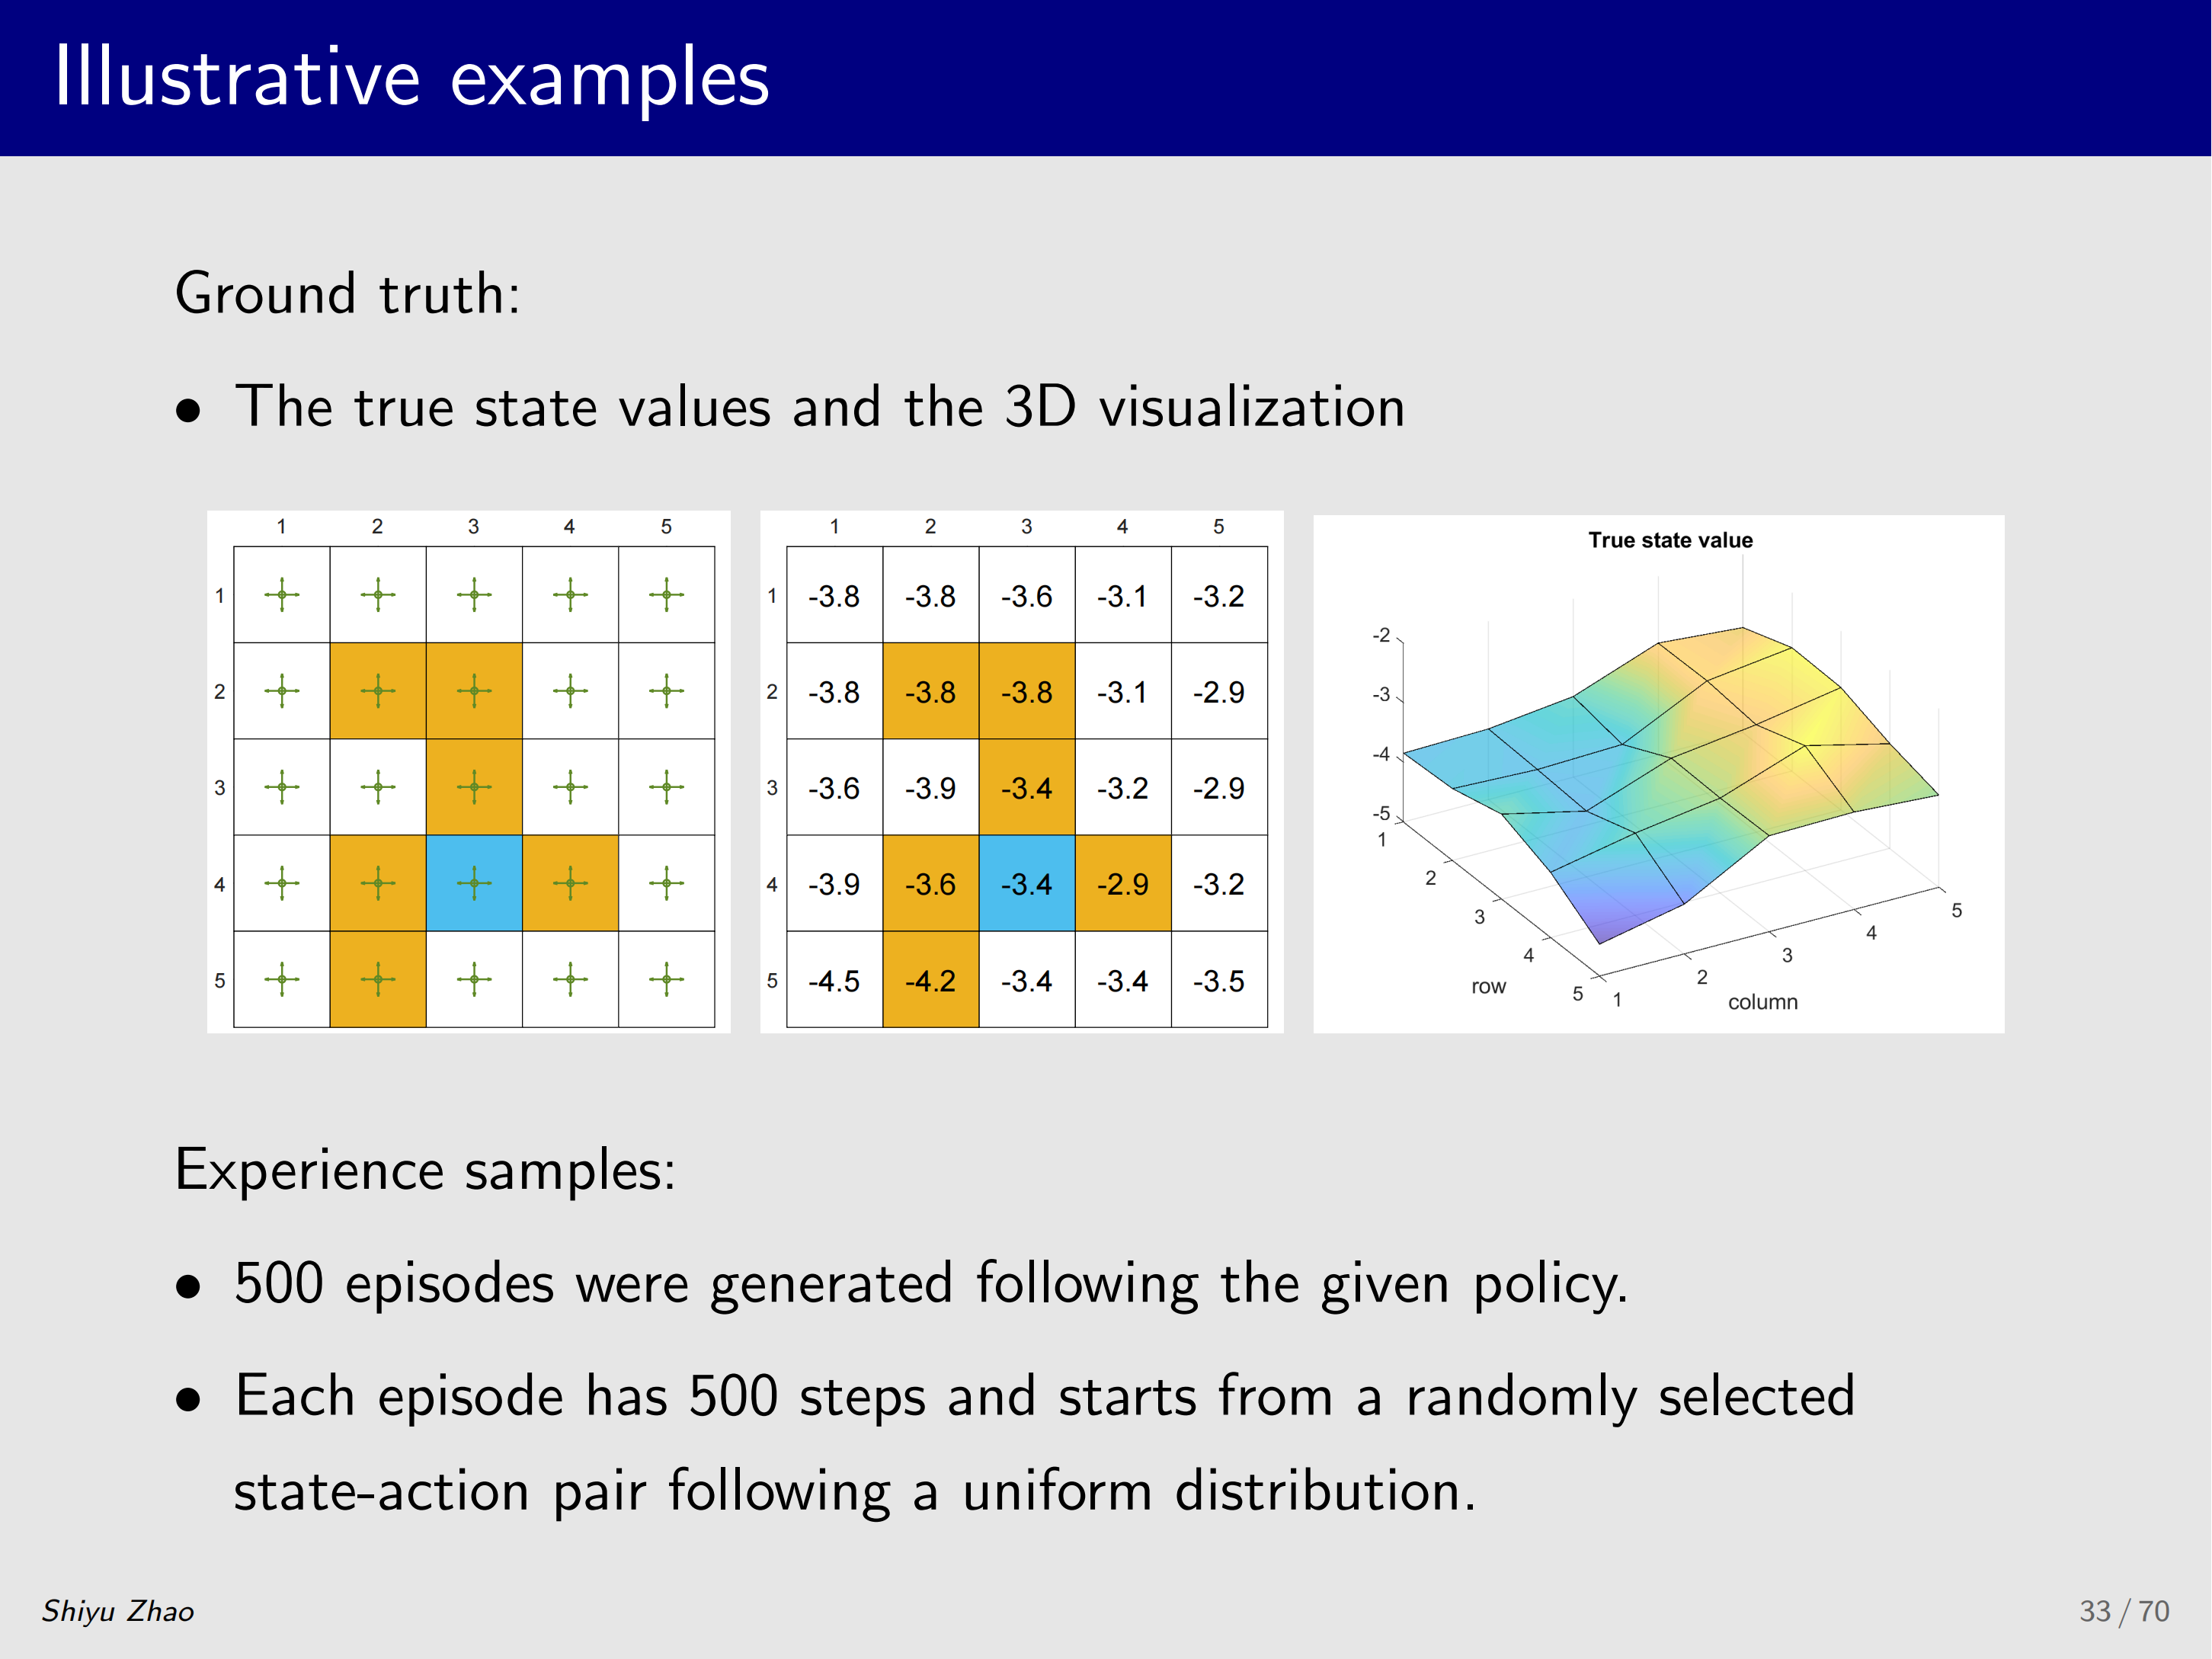
我们先来看一下 ground truth 是什么,我们不是要求 state value 吗?state value 可以先用基于模型的方法(求解贝尔曼公式)得到,之后再用 TD-Linear 求出来与之比较,看它是否把 state value 很好地求出来。
这里有一个非常重要、直观的工具: 把二维表格画成如图的三维复杂曲面 ,这个三维曲面的横轴和纵轴对应表格中的横轴和纵轴,比如说曲面最低点坐标是 (1,5),对应表格中 ( 1 , 5 ) (1,5) (1,5) 位置,然后它的值是 -4.5,-4.5 也是所有 state value 中最小的。
下面用 TD-Linear 的基本思想 是什么呢?就是要得到一个函数,它对应一个曲面,这个曲面与真实 state value 的复杂曲面越接近越好,这是一个最基本的 idea。为了实现这个目标需要数据---没有模型就依赖数据。这里的数据包含 500 个 episode,每个 500 步;每个 episode 出发的 state-action pair 随机选择、服从均匀分布。
首先用这些数据、用之前所学的 tabular TD algorithm ,也就是基于表格形式的那个算法来算一下,这个 tabular TD 这里简称 TD table,它最终得到的 state value 绘制成的曲面如下图所示:
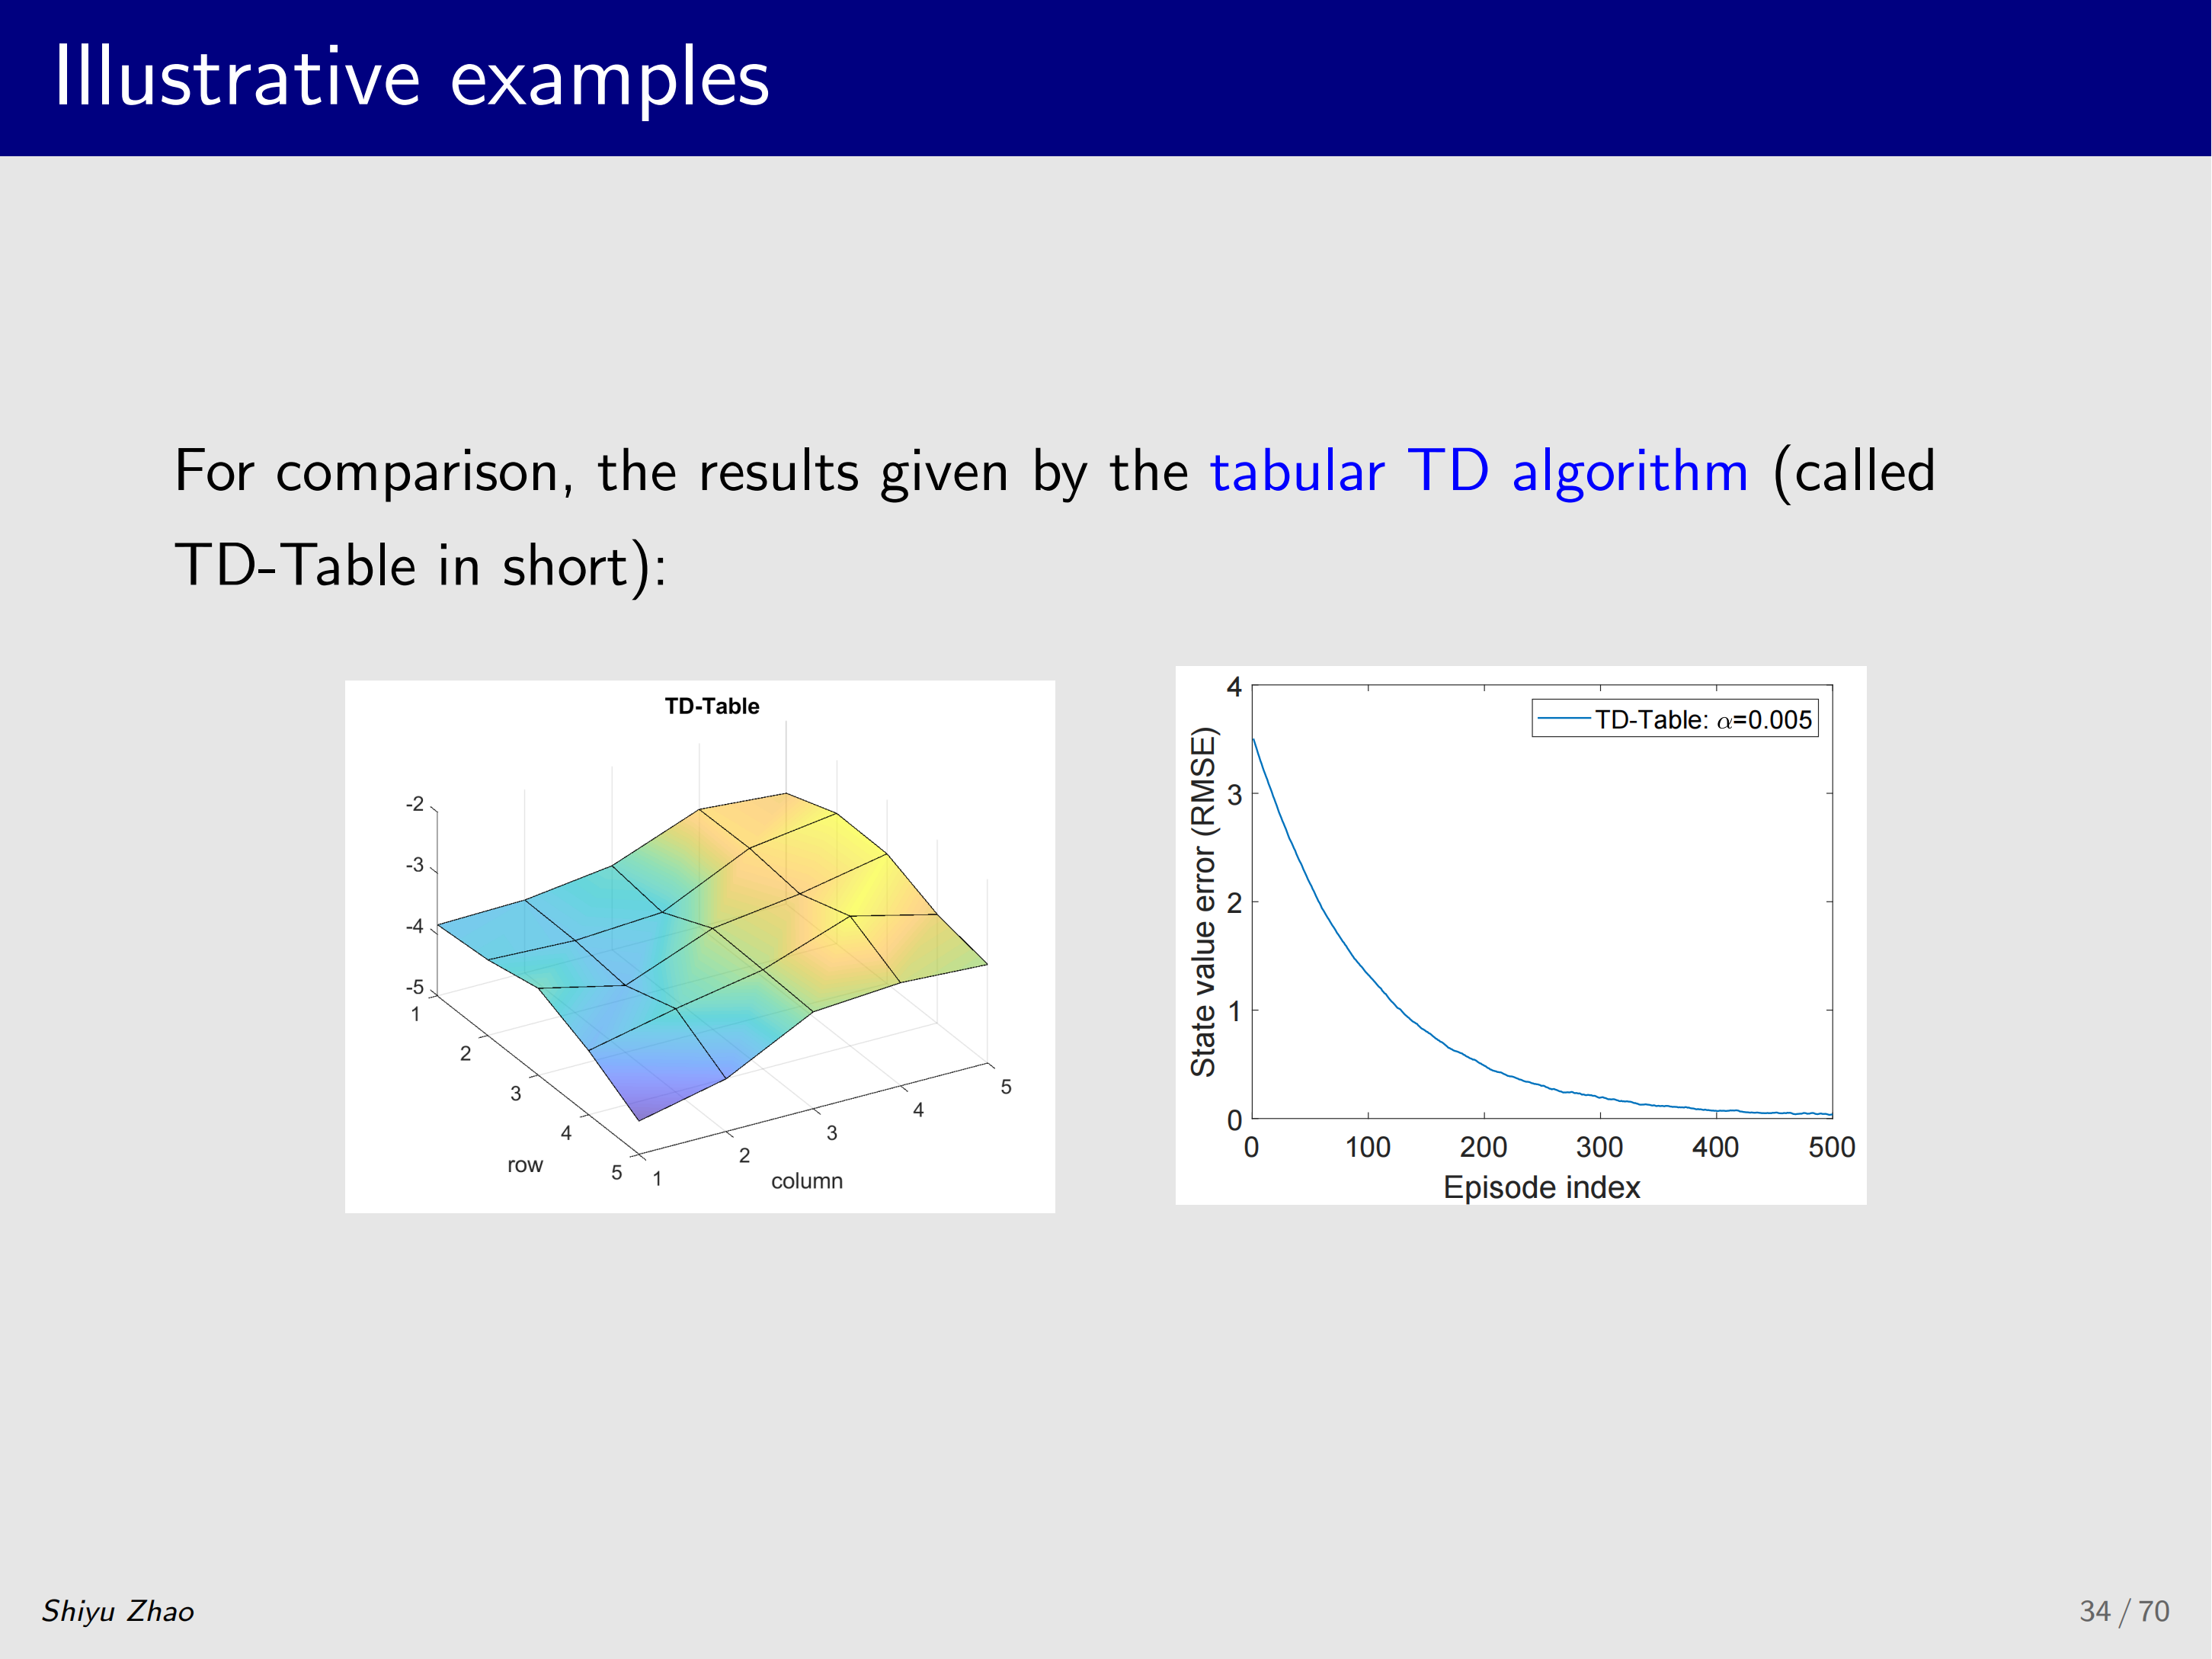
大家可以看到与刚才的三维曲面非常接近。右图也显示:随着 episode 越来越多(直到 500 个),state value 估计误差逐渐减小到 0。
下面来看 TD-Linear 是不是也能很好地估计出 state value。
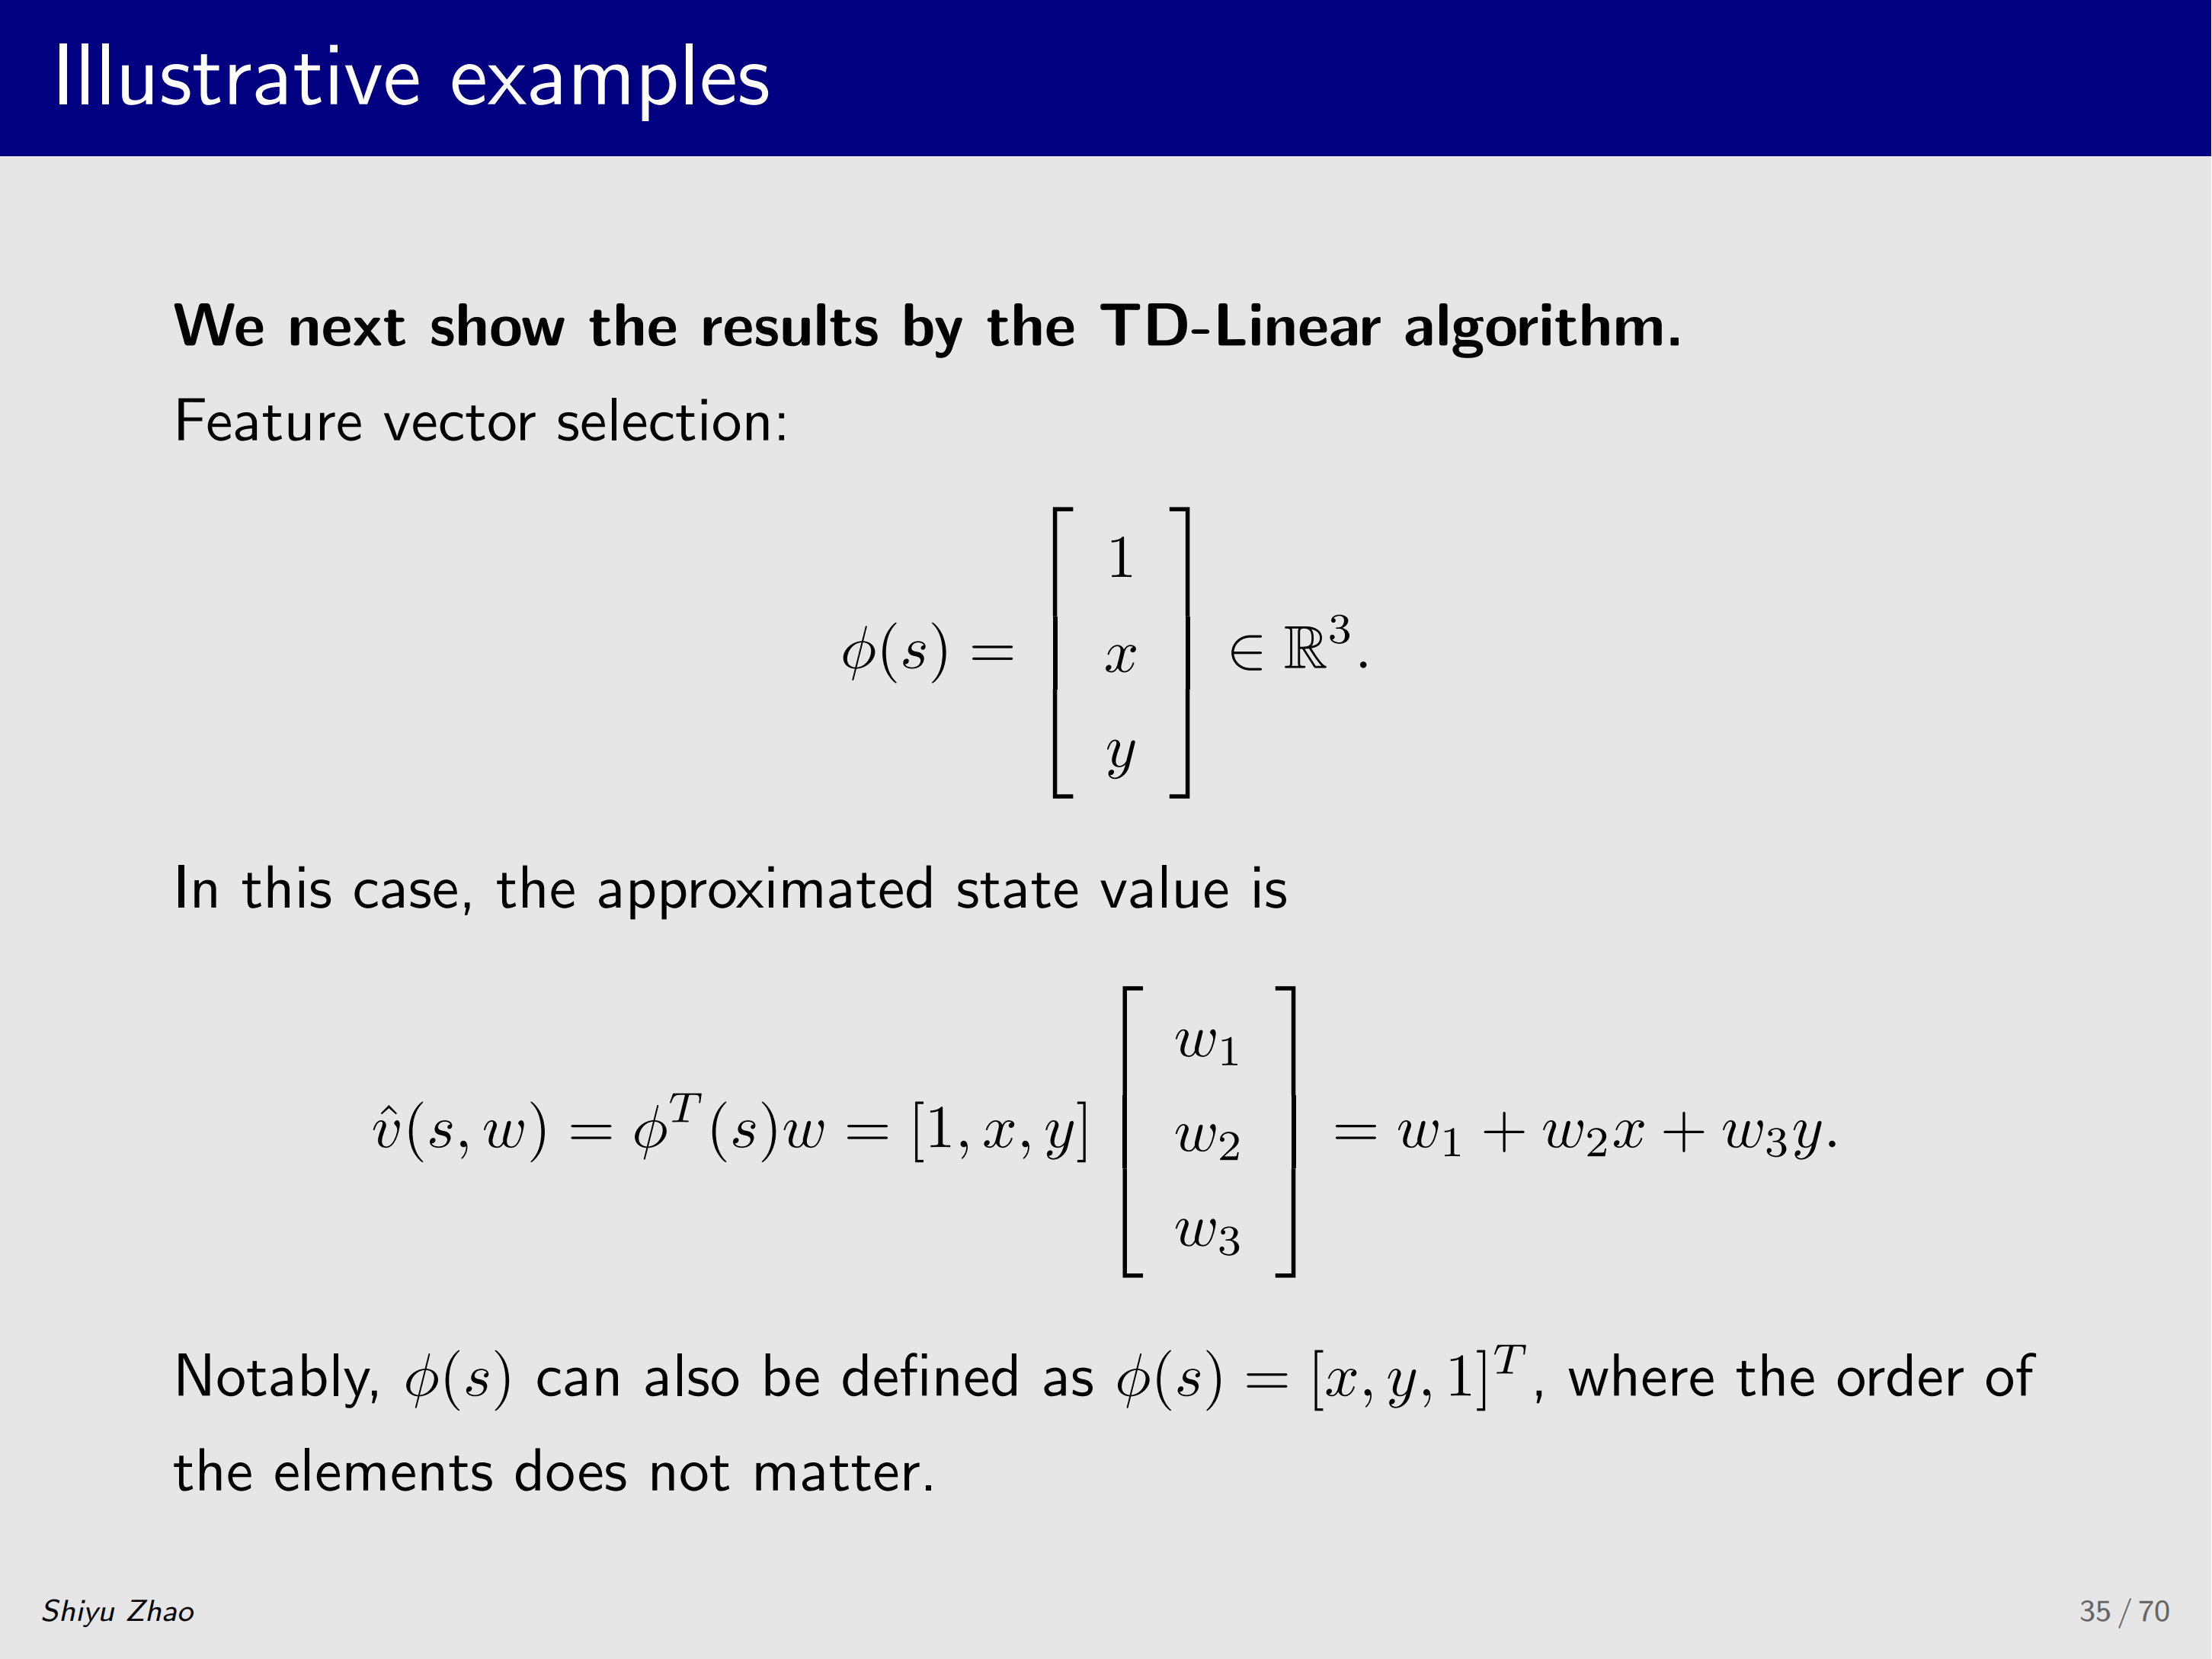
要用 TD-Linear,第一步是建立它的 feature vector ,注意:思路正如刚才所说---建立一个函数,它对应一个曲面,该曲面要能很好地拟合真实 state value 对应的曲面,那么函数对应的曲面最简单的情况是什么呢?就是 平面。
所以这时候我们选择的 feature vector 如下:
ϕ ( s ) = 1 x y ∈ R 3 . \phi(s) = \begin{bmatrix} 1 \\2pt x \\2pt y \end{bmatrix} \in \mathbb{R}^3. ϕ(s)= 1xy ∈R3.
在这种情况下 v ^ \hat{v} v^ 这个函数等于
v ^ ( s , w ) = ϕ T ( s ) w = 1 , x , y w 1 w 2 w 3 = w 1 + w 2 x + w 3 y . \hat{v}(s, w) = \phi^T(s)w = 1, x, y\begin{bmatrix} w_1 \\2pt w_2 \\2pt w_3 \end{bmatrix} = w_1 + w_2x + w_3y. v^(s,w)=ϕT(s)w=1,x,y w1w2w3 =w1+w2x+w3y.
它显然在三维空间中是一个 平面 , w 1 w_1 w1、 w 2 w_2 w2、 w 3 w_3 w3 是它的参数,这里边的 feature vector 中元素的顺序是可以调整的,没有关系。
把刚才的 feature vector 代入之前学的 TD-Linear 算法,看看最终结果:
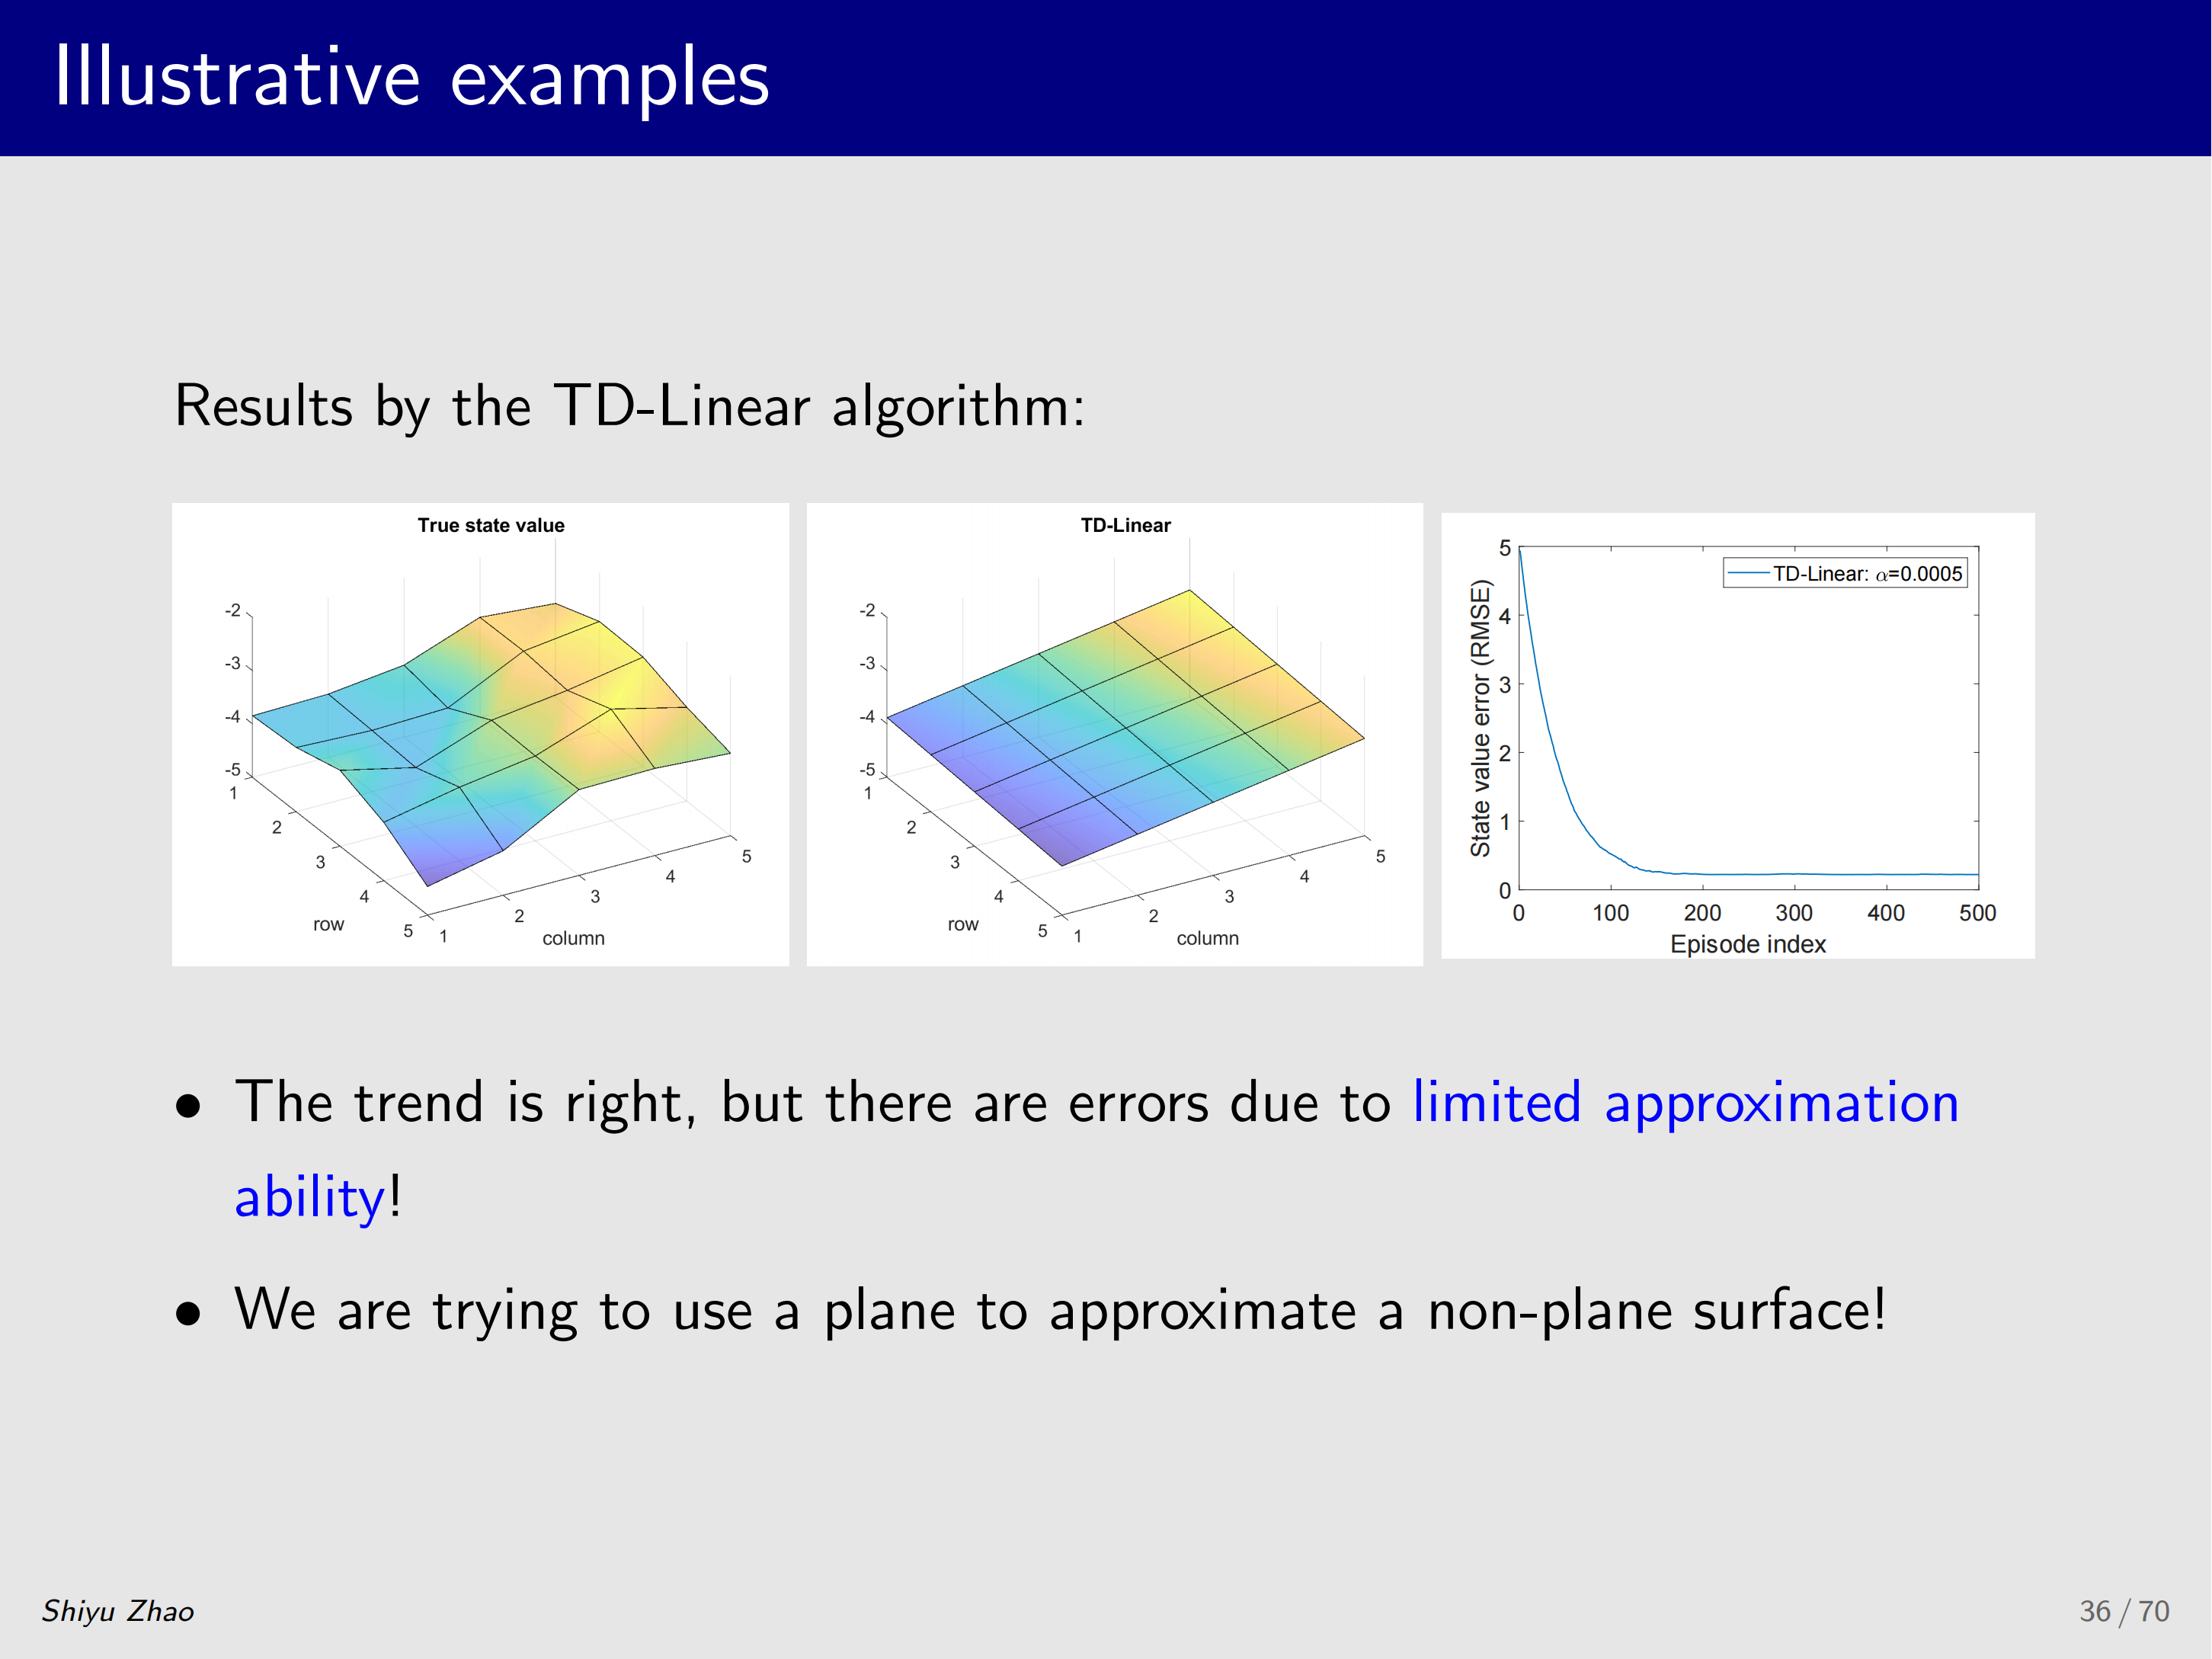
左图是真实的 state value,中间是 TD-Linear 学到的 state value,可以看到 趋势是对的(左边值小、右边值大),但很多具体点上的估计并不准确 。右图也显示:虽然最终收敛,但 收敛的误差不是 0。这是为什么呢?
原因很简单: 真实 state value 是一个非常复杂的曲面,我们却想用一个平面拟合,这怎么可能?不可能百分之百拟合,只能找到一个最优平面 。这也说明:想拟合得更好就不能再用平面,要用更复杂的高阶曲面,此时 feature vector 阶数更高、需要的 w w w 参数更多。能不能这么做呢?当然可以。
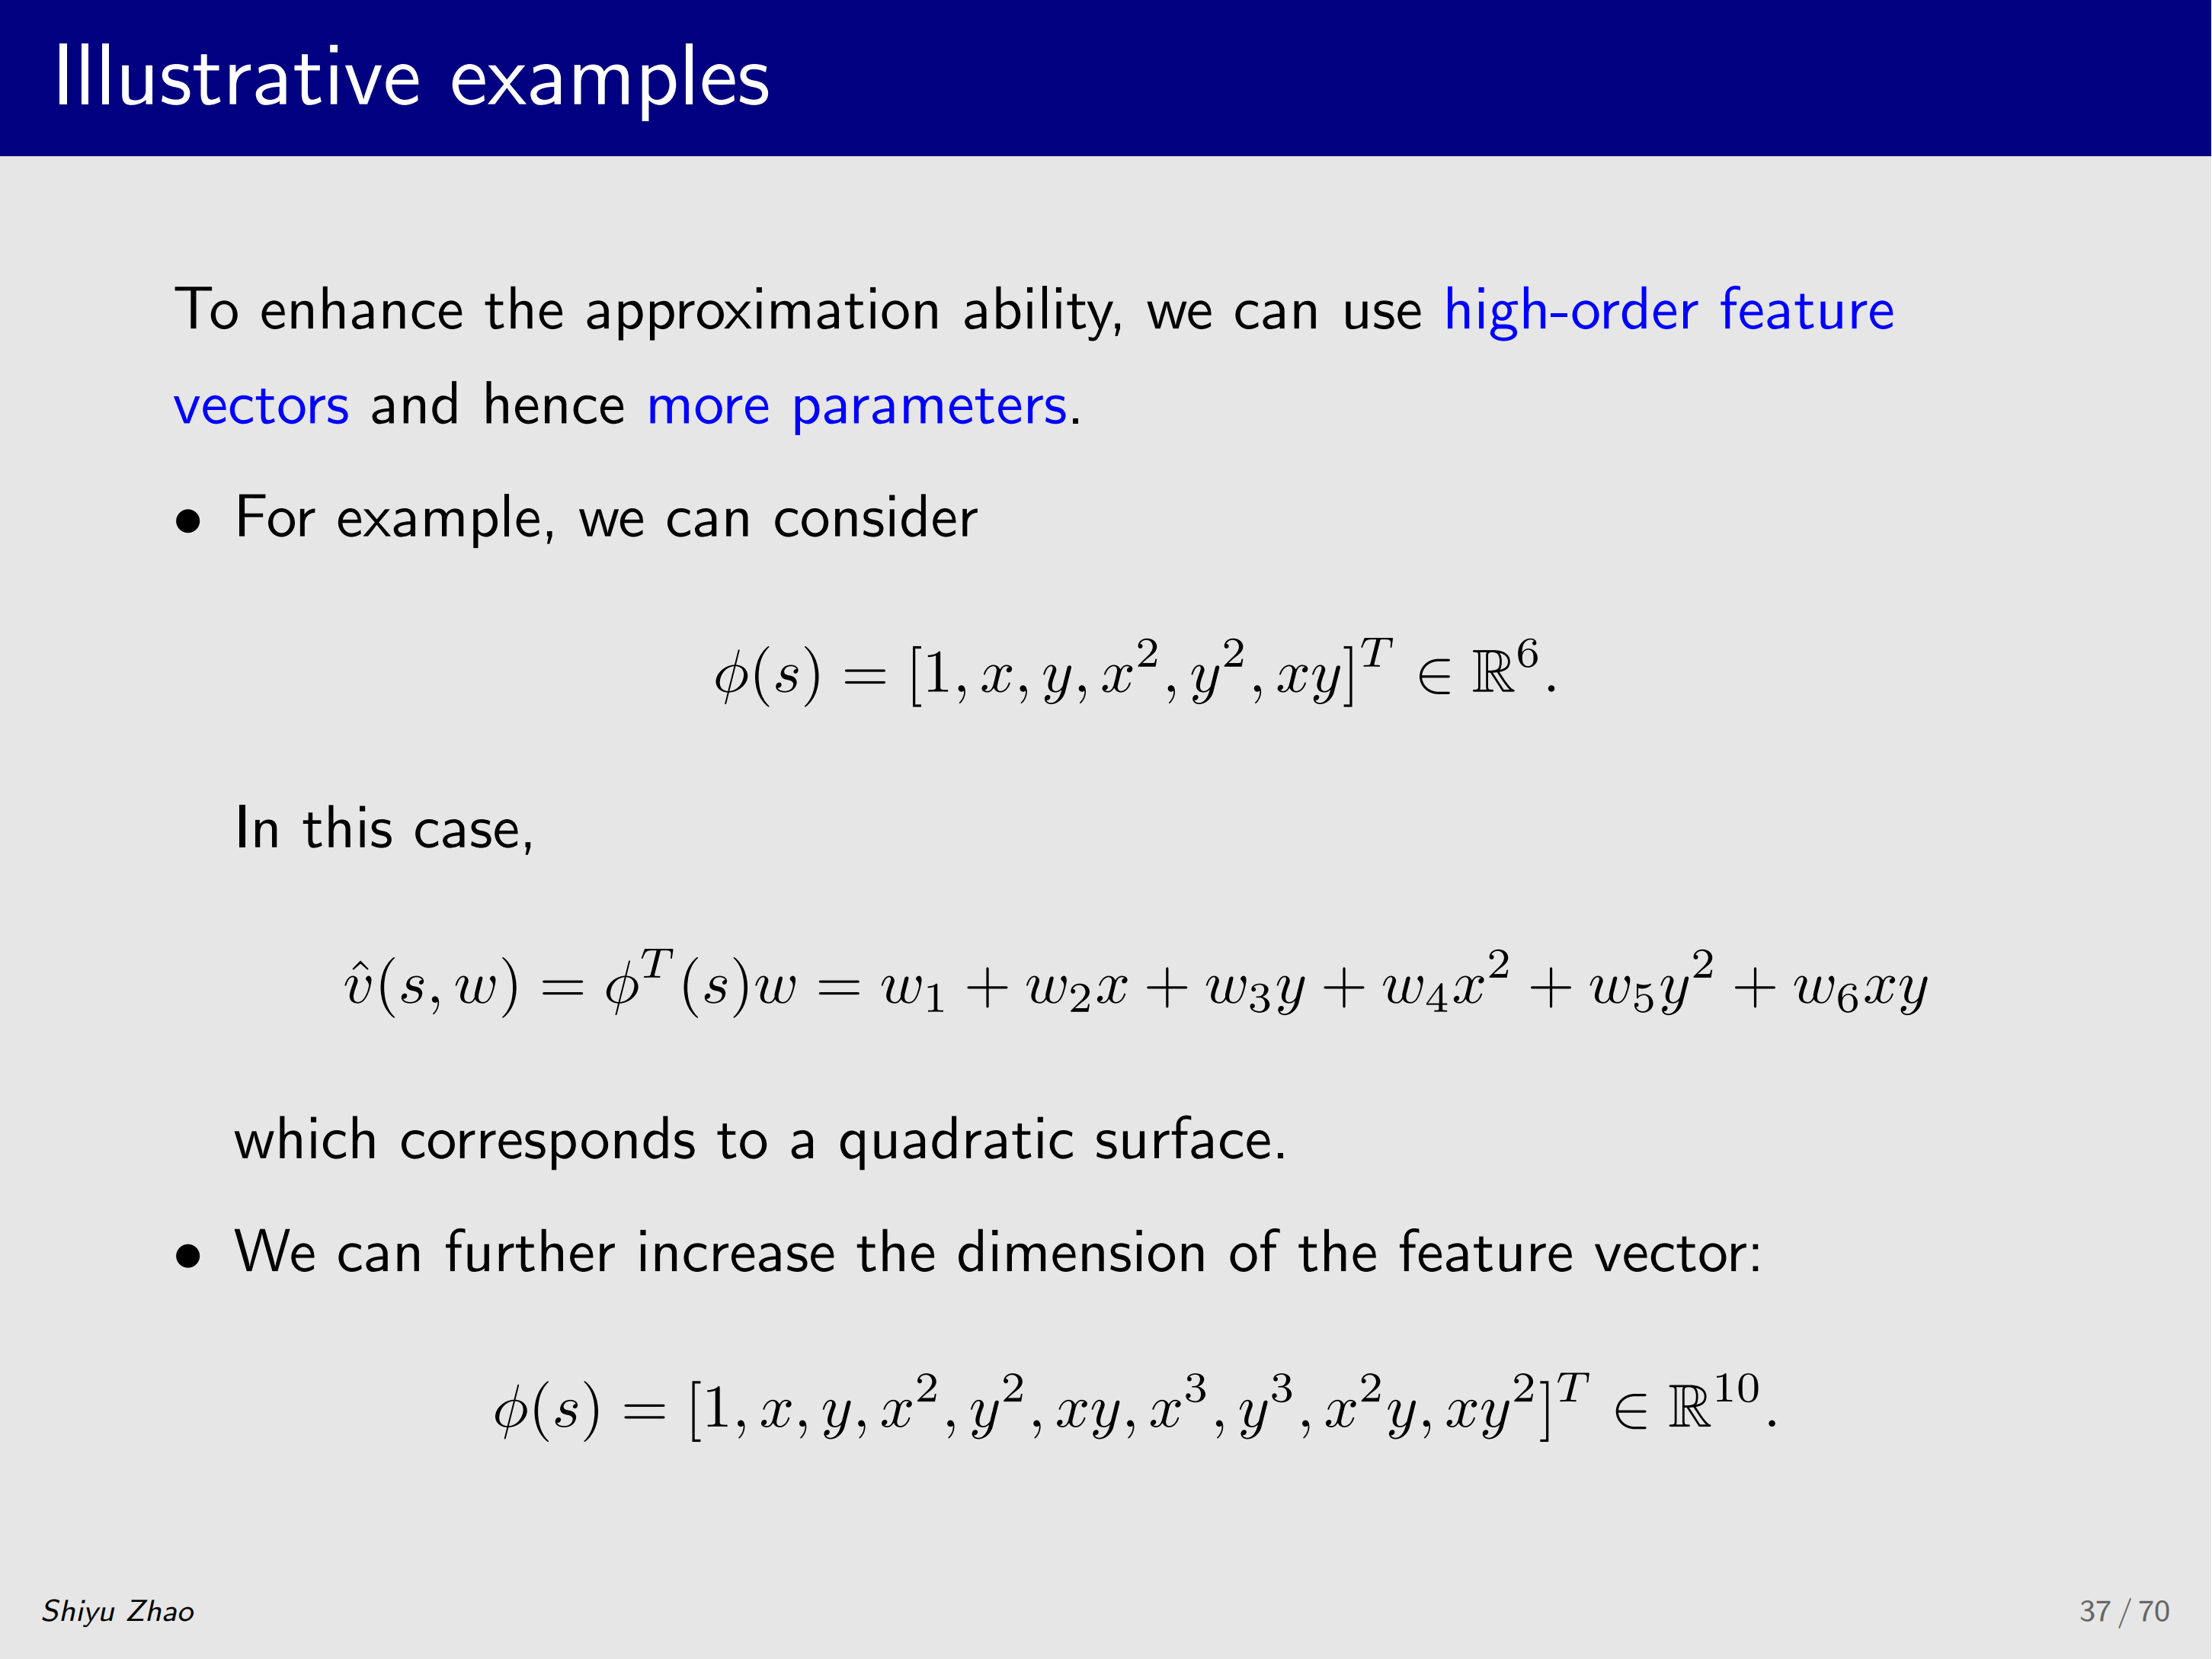
ϕ ( s ) = 1 , x , y , x 2 , y 2 , x y T ∈ R 6 . \phi(s) = 1, x, y, x\^2, y\^2, xy^T \in \mathbb{R}^6. ϕ(s)=1,x,y,x2,y2,xyT∈R6.
我们来选择上面这个 feature vector,相比刚才,我们引入了 x , y x,y x,y 的二次项,所以它的阶数会更高,所对应的函数 v ^ \hat{v} v^ 如下:
v ^ ( s , w ) = ϕ T ( s ) w = w 1 + w 2 x + w 3 y + w 4 x 2 + w 5 y 2 + w 6 x y \hat{v}(s, w) = \phi^T(s)w = w_1 + w_2 x + w_3 y + w_4 x^2 + w_5 y^2 + w_6 xy v^(s,w)=ϕT(s)w=w1+w2x+w3y+w4x2+w5y2+w6xy
它含有 x , y x,y x,y 的二次项,对应的是一个 二次曲面,我们可以设想,相比刚才的平面,它应该能更好地拟合真实 state value 的复杂曲面。我们还可以进一步再增加 feature vector 的维数以及相应的参数的个数:
ϕ ( s ) = 1 , x , y , x 2 , y 2 , x y , x 3 , y 3 , x 2 y , x y 2 T ∈ R 10 . \phi(s) = 1, x, y, x\^2, y\^2, xy, x\^3, y\^3, x\^2y, xy\^2^T \in \mathbb{R}^{10}. ϕ(s)=1,x,y,x2,y2,xy,x3,y3,x2y,xy2T∈R10.
比如把 x , y x,y x,y 的三次项也放进来,对应的 v ^ \hat{v} v^ 是三维空间中的曲面,可以想象拟合能力更强,我们来看一下结果究竟是不是这样。
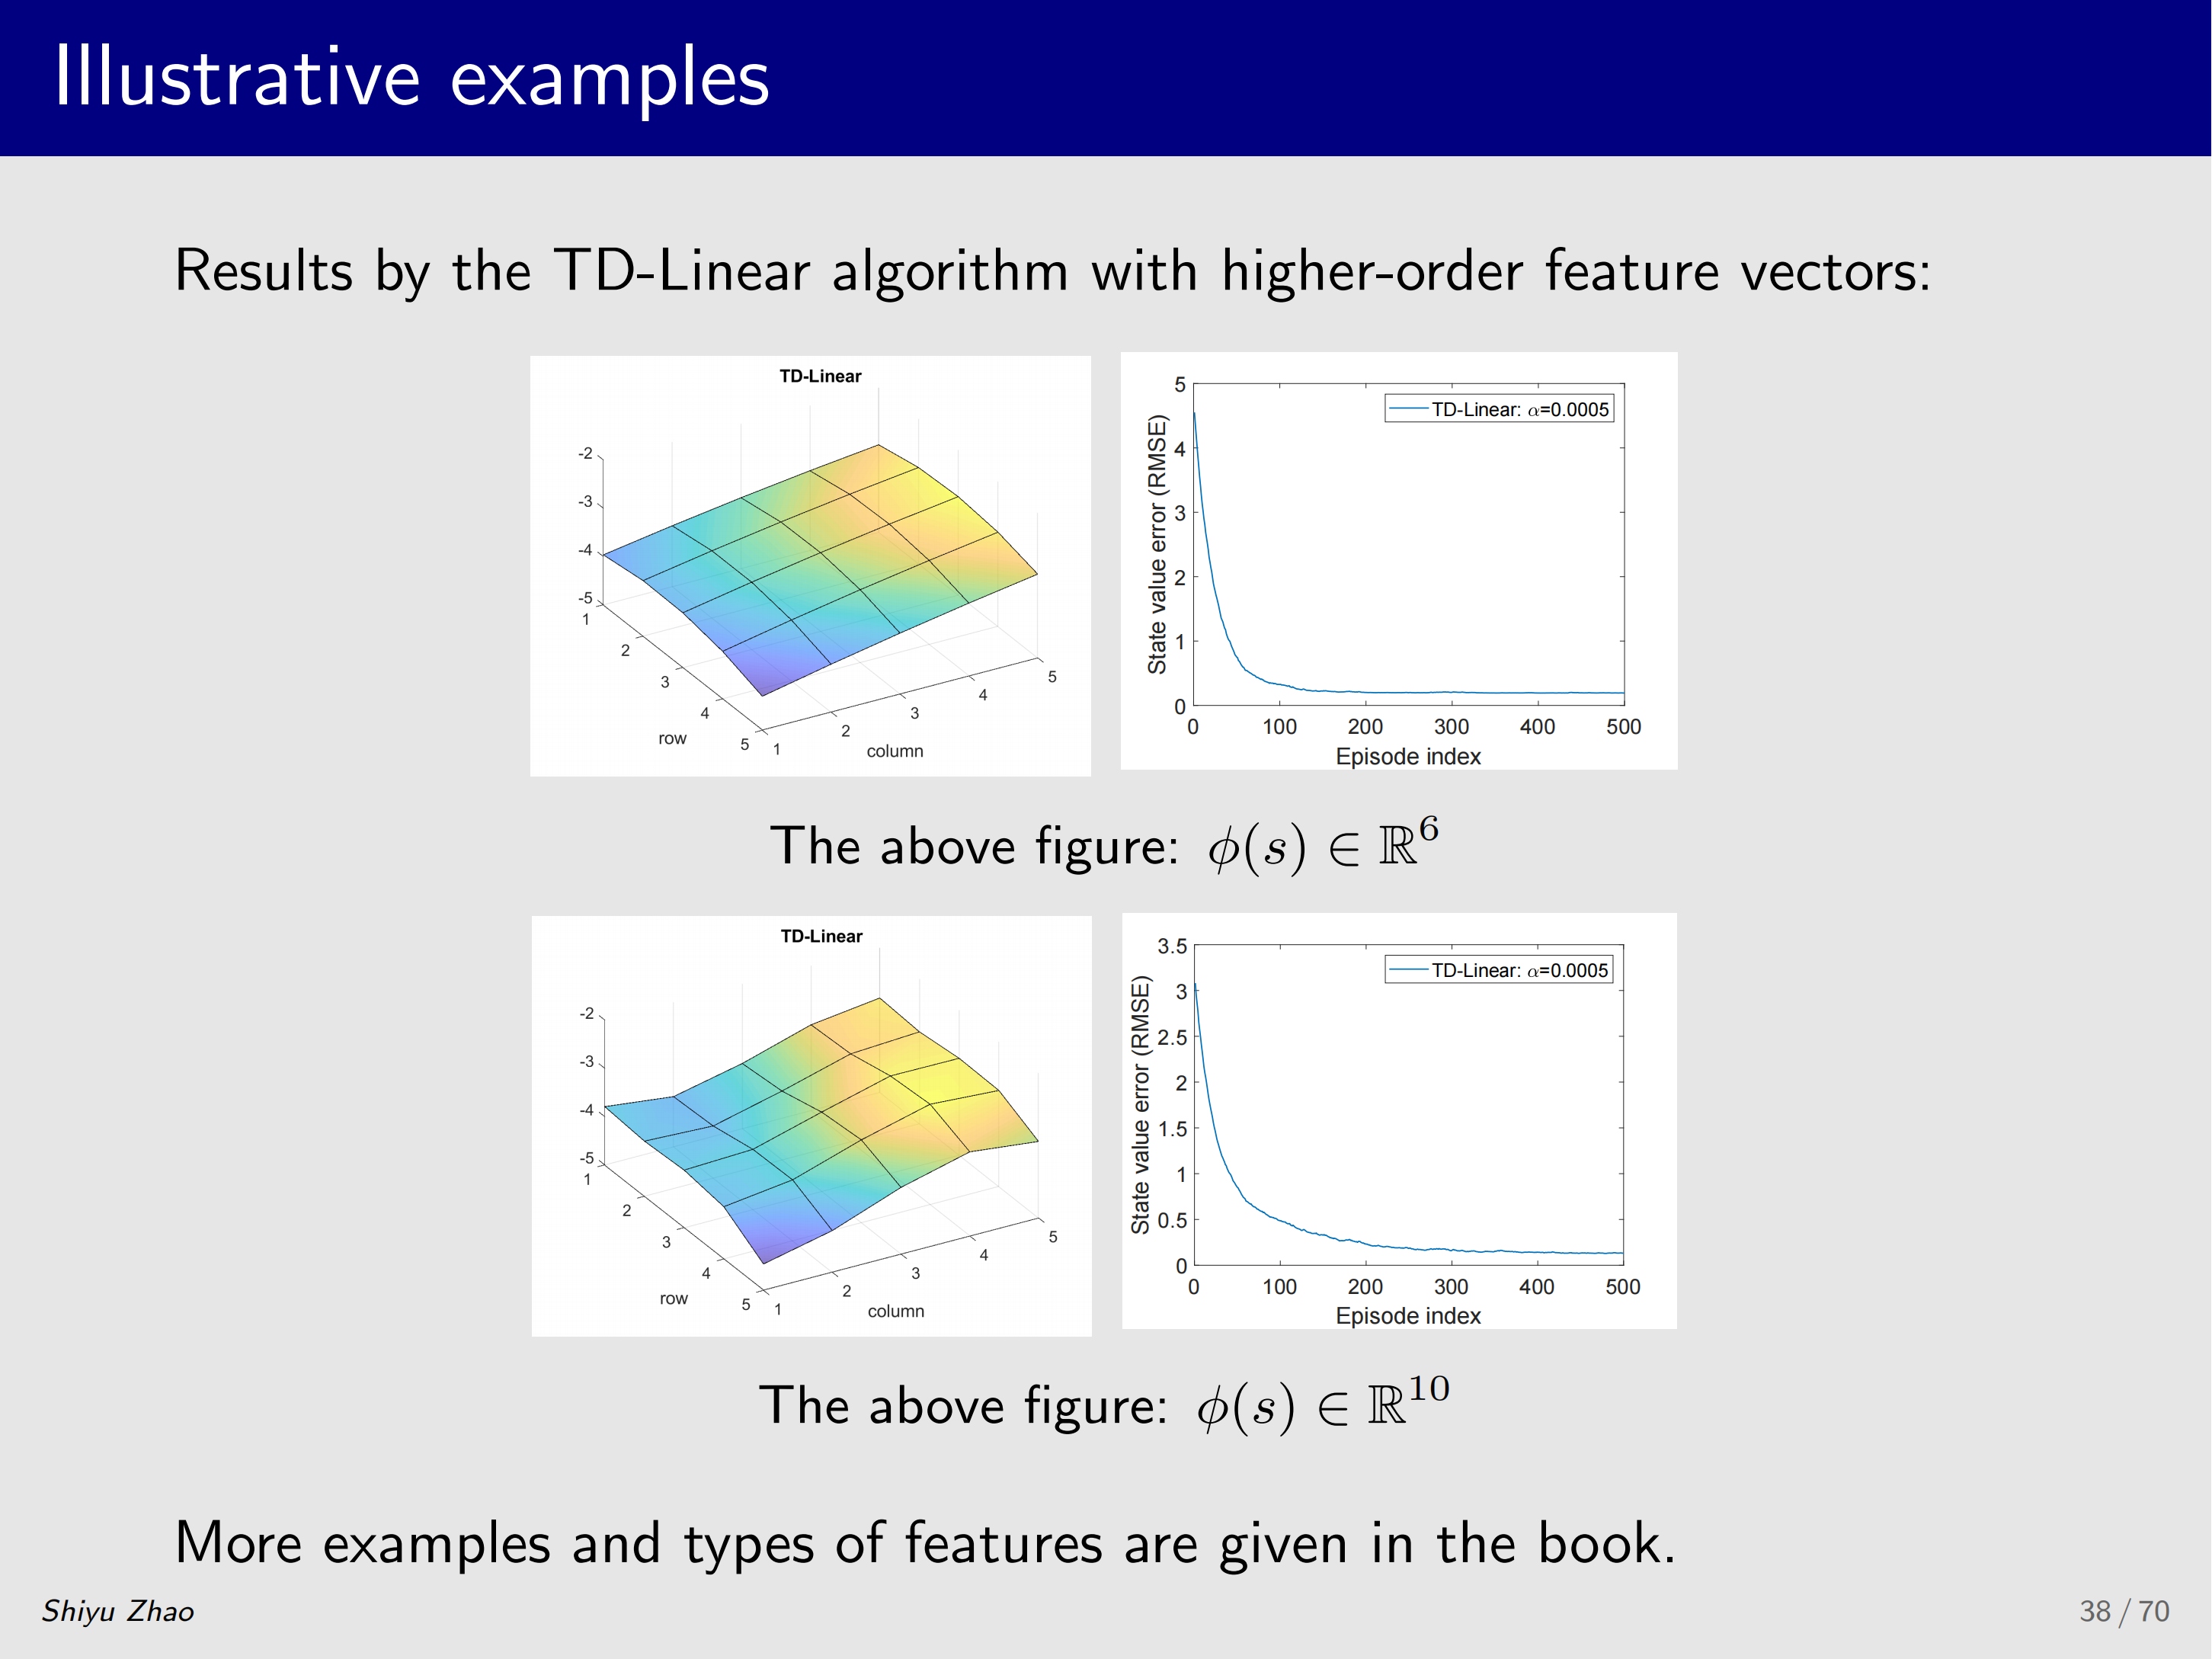
上图是刚才用二次曲面经 TD 算法拟合的效果:趋势正确,有些地方比平面拟合得更好(如 (1,5) 这个最小点)。当然用三次曲面拟合效果更好, 肉眼上看已与真实 state value 曲面非常接近;从具体数值看,收敛误差也比较小。
通过这几个例子我相信大家能够更好地去理解 value function approximation 的思想 是什么,然后大家也看到, 基本上用更多的参数就能够得到更好的拟合效果 。当然这里有 tradeoff: 参数个数不能太多,太多就和 tabular 没区别了 。另外,在 linear 情况下, 不断增加参数个数并不意味着能把拟合误差降到 0。
为什么呢?因为它终究是线性函数,结构已经固定,再增加参数也不一定能把误差降到 0,这也是为什么现在广泛使用 神经网络,理论上它可以近似任何非线性函数,关于这些例子的更多解释以及 feature vector 的选择,大家可以参考教材。
2. Summary of the story
下面我们对刚才所介绍的一系列内容做一个小结。
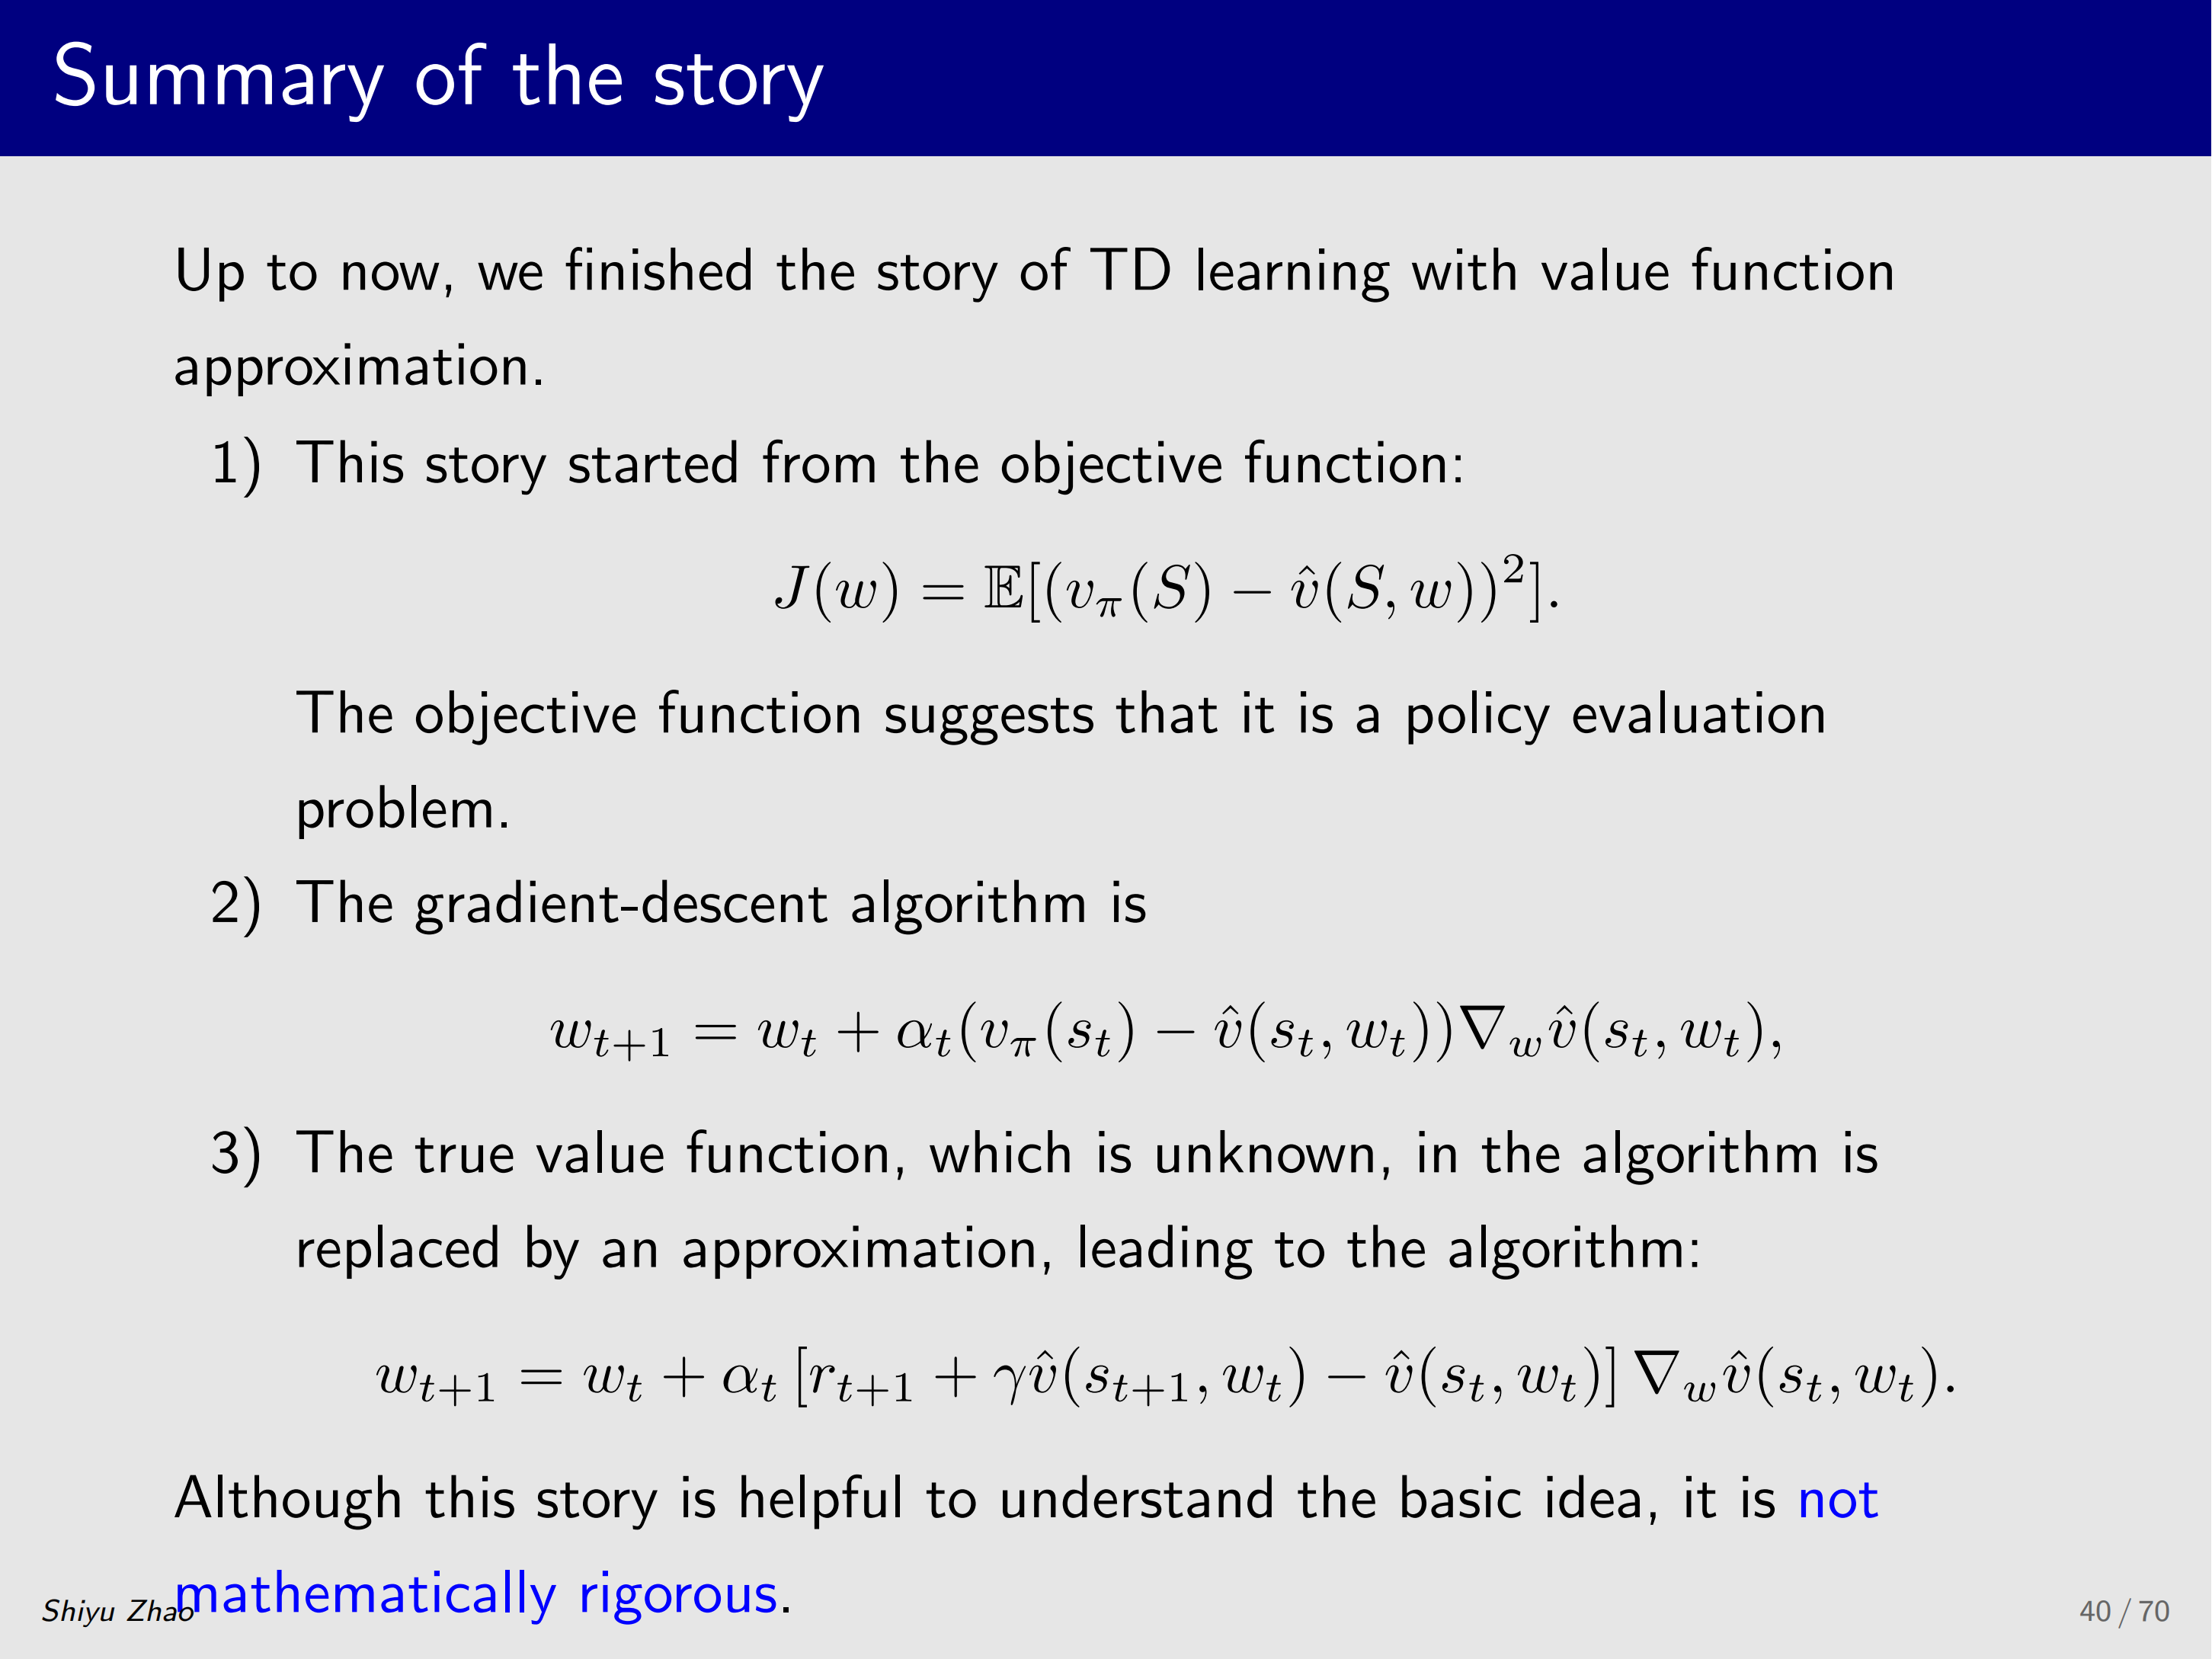
到此为止,value function approximation 的基本思想 就介绍完了,我们刚才的思路是什么样的?再来捋一下。
J ( w ) = E ( v π ( S ) − v \^ ( S , w ) ) 2 . J(w) = \mathbb{E}(v_{\\pi}(S) - \\hat{v}(S,w))\^2. J(w)=E(vπ(S)−v\^(S,w))2.
首先从 objective function 出发(如上式):它是真实与估计 state value 之差的平方的加权平均,然后对目标函数进行优化,使用的算法是 gradient descent。
w t + 1 = w t + α t ( v π ( s t ) − v ^ ( s t , w t ) ) ∇ w v ^ ( s t , w t ) , w_{t+1} = w_t + \alpha_t(v_\pi(s_t) - \hat{v}(s_t, w_t))\nabla_w \hat{v}(s_t, w_t), wt+1=wt+αt(vπ(st)−v^(st,wt))∇wv^(st,wt),
这就是对应的 gradient-descent 算法 。但问题在于 v π v_\pi vπ 未知---怎么办?可以把 v π v_{\pi} vπ 替代成 r t + 1 + γ v ^ ( s t + 1 , w t ) r_{t+1}+\gamma \hat{v}(s_{t+1},w_t) rt+1+γv^(st+1,wt) 这样一个量,这时候对应的算法就是 TD learning 和 value function approximation 相结合 所得到的算法。
w t + 1 = w t + α t r t + 1 + γ v \^ ( s t + 1 , w t ) − v \^ ( s t , w t ) ∇ w v ^ ( s t , w t ) . w_{t+1} = w_t + \alpha_tr_{t+1} + \\gamma\\hat{v}(s_{t+1}, w_t) - \\hat{v}(s_t, w_t)\nabla_w \hat{v}(s_t, w_t). wt+1=wt+αtrt+1+γv\^(st+1,wt)−v\^(st,wt)∇wv^(st,wt).
这个就是整个故事线。我想说的是什么呢?这个故事其实是非常直观的,能够帮助大家很容易地理解这里边的思路,但 它在数学上不严谨,因为这里做了替换,这种替换在严格性上是有问题的 。严格的分析我们稍后用几页幻灯片简要说明,基本结论是什么? 严格地说,这个算法实际并不是在 minimize 这个 objective function,而是去 minimize 另外一个。
为什么我们用这个故事来讲?因为不用这个故事,问题会复杂得多,要么直接给出算法、要么直接给出那个 objective function,它们都很复杂。对学习这门课的同学来说,一般了解这条故事线就行了;理论分析可到教材中查看,内容比较丰富。下面只用几页幻灯片快速过一下。
3. Theoretical analysis
一个基本结论是: 刚给出的算法实际上并不是在最小化之前提到的那个目标函数。
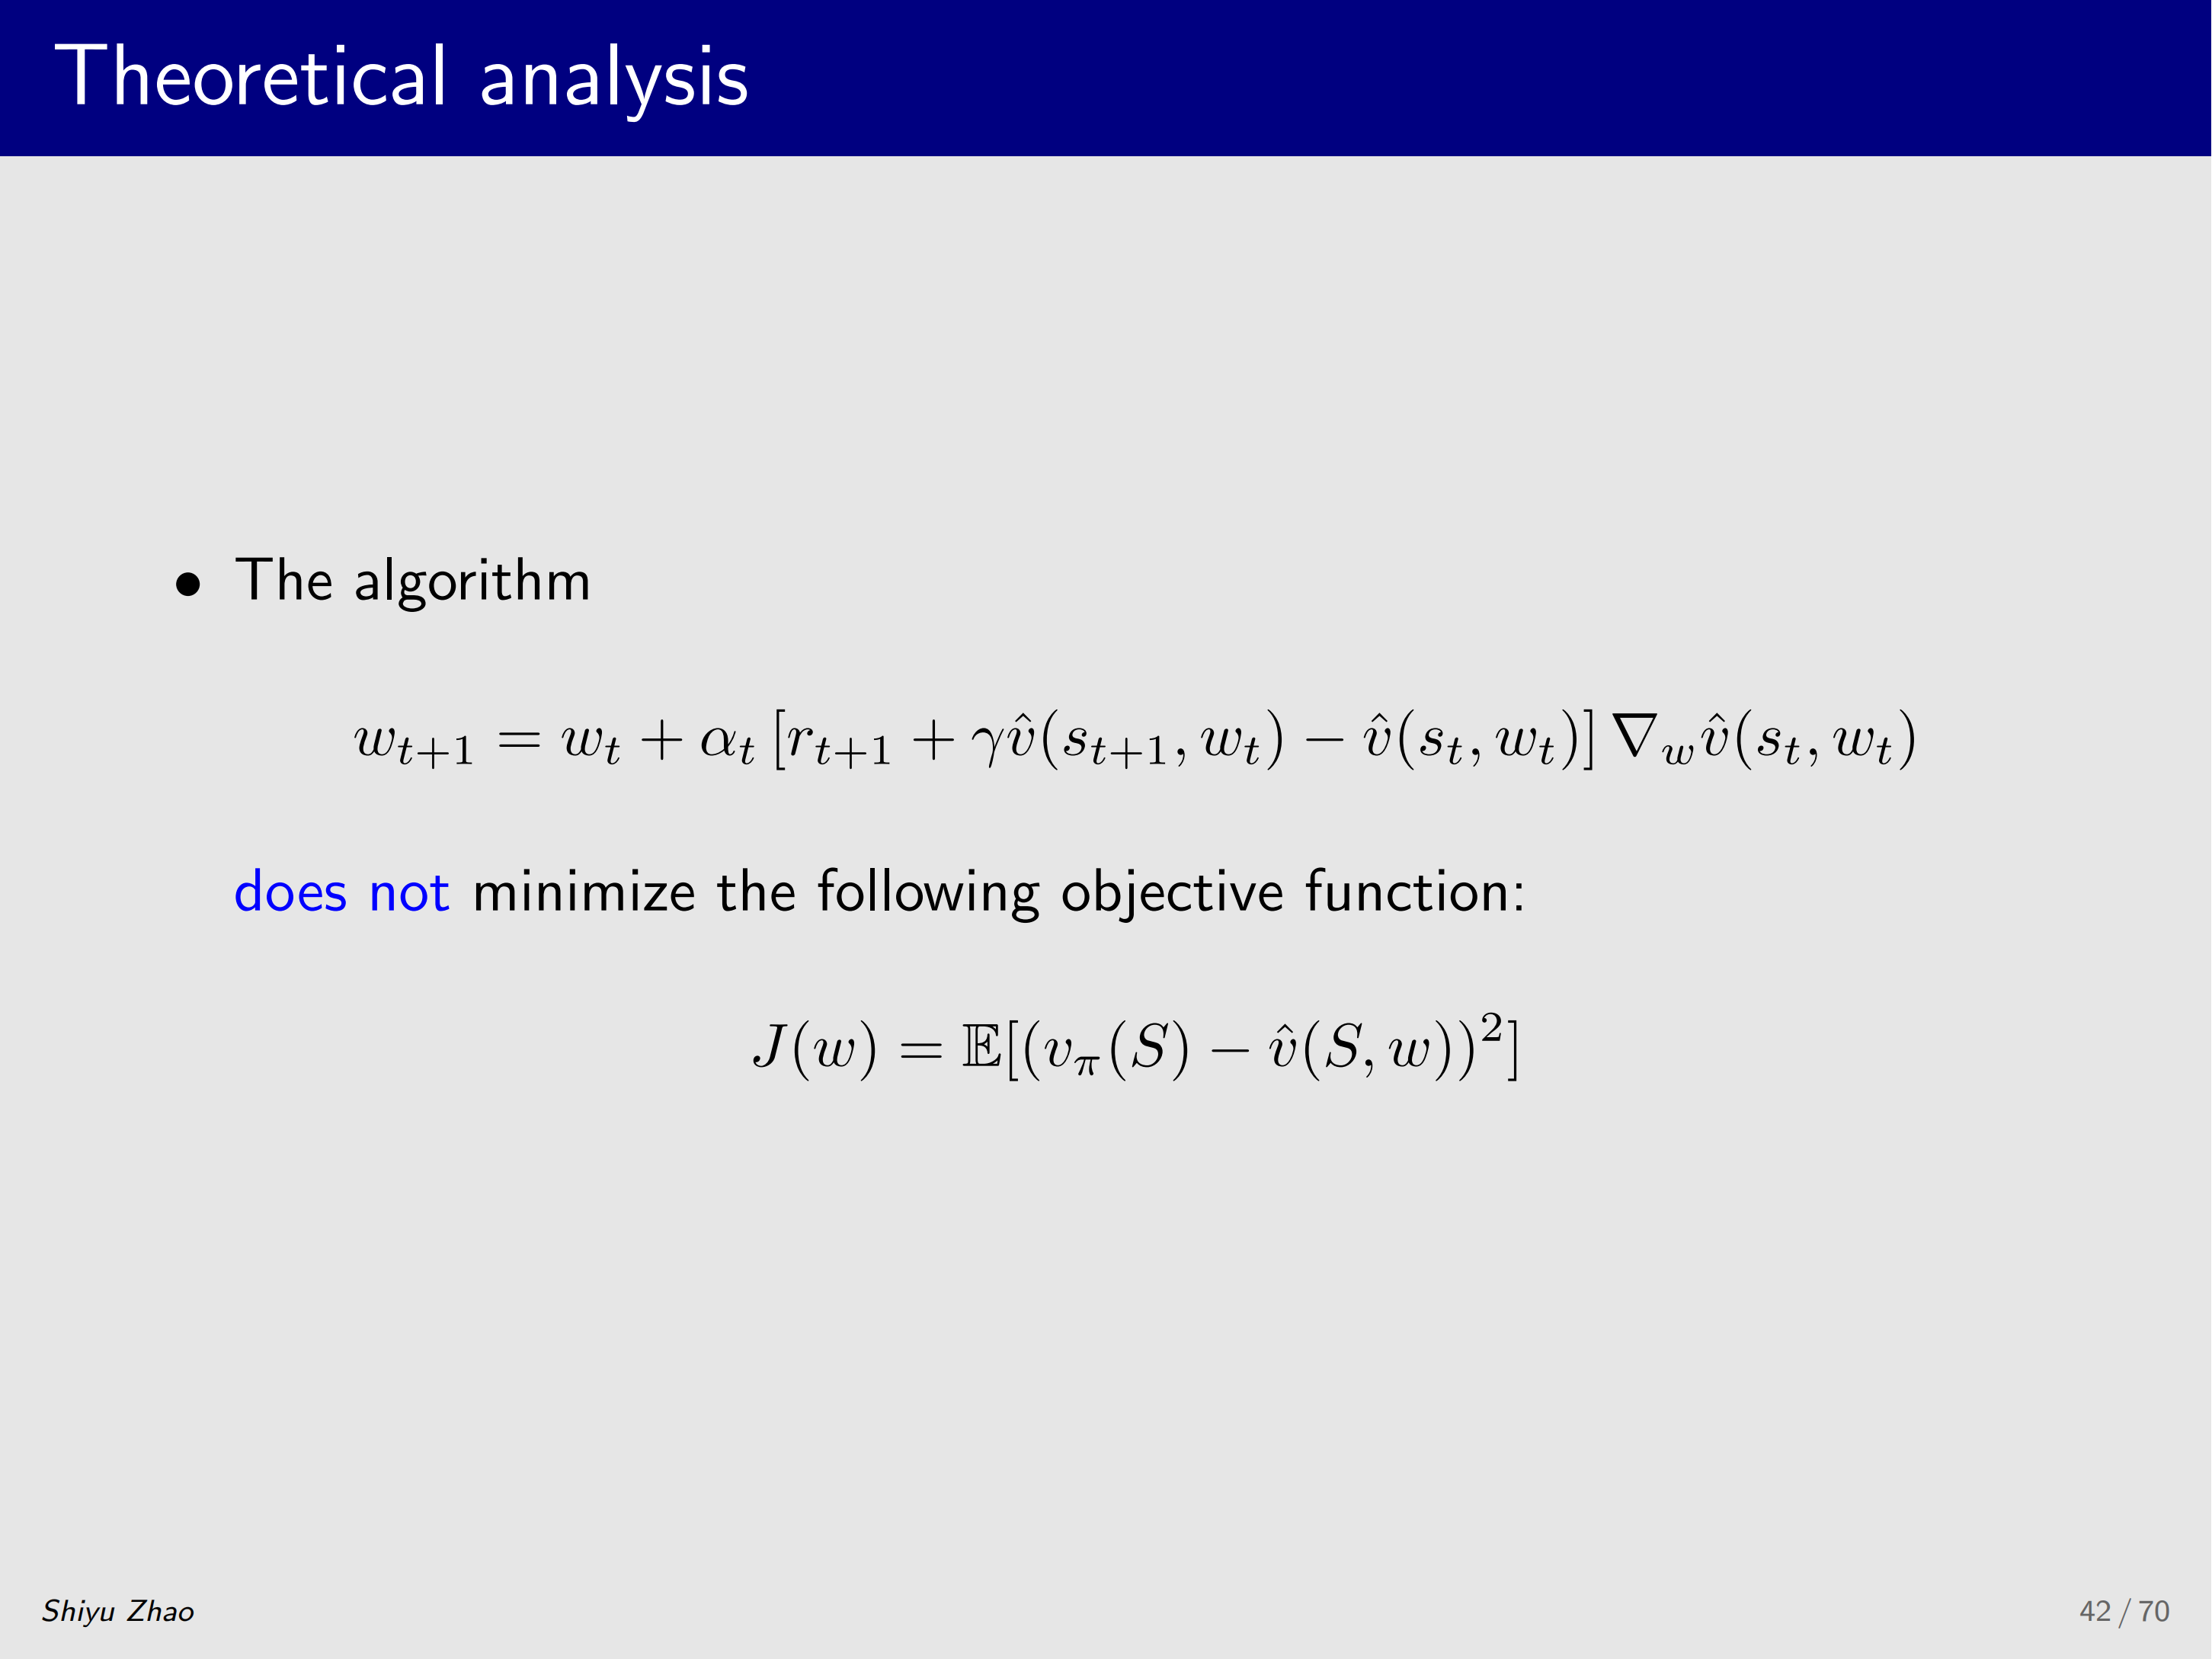
那它 minimize 的是什么呢?我们来看一下,实际上有多种 objective function,第一个就是刚才给出的:
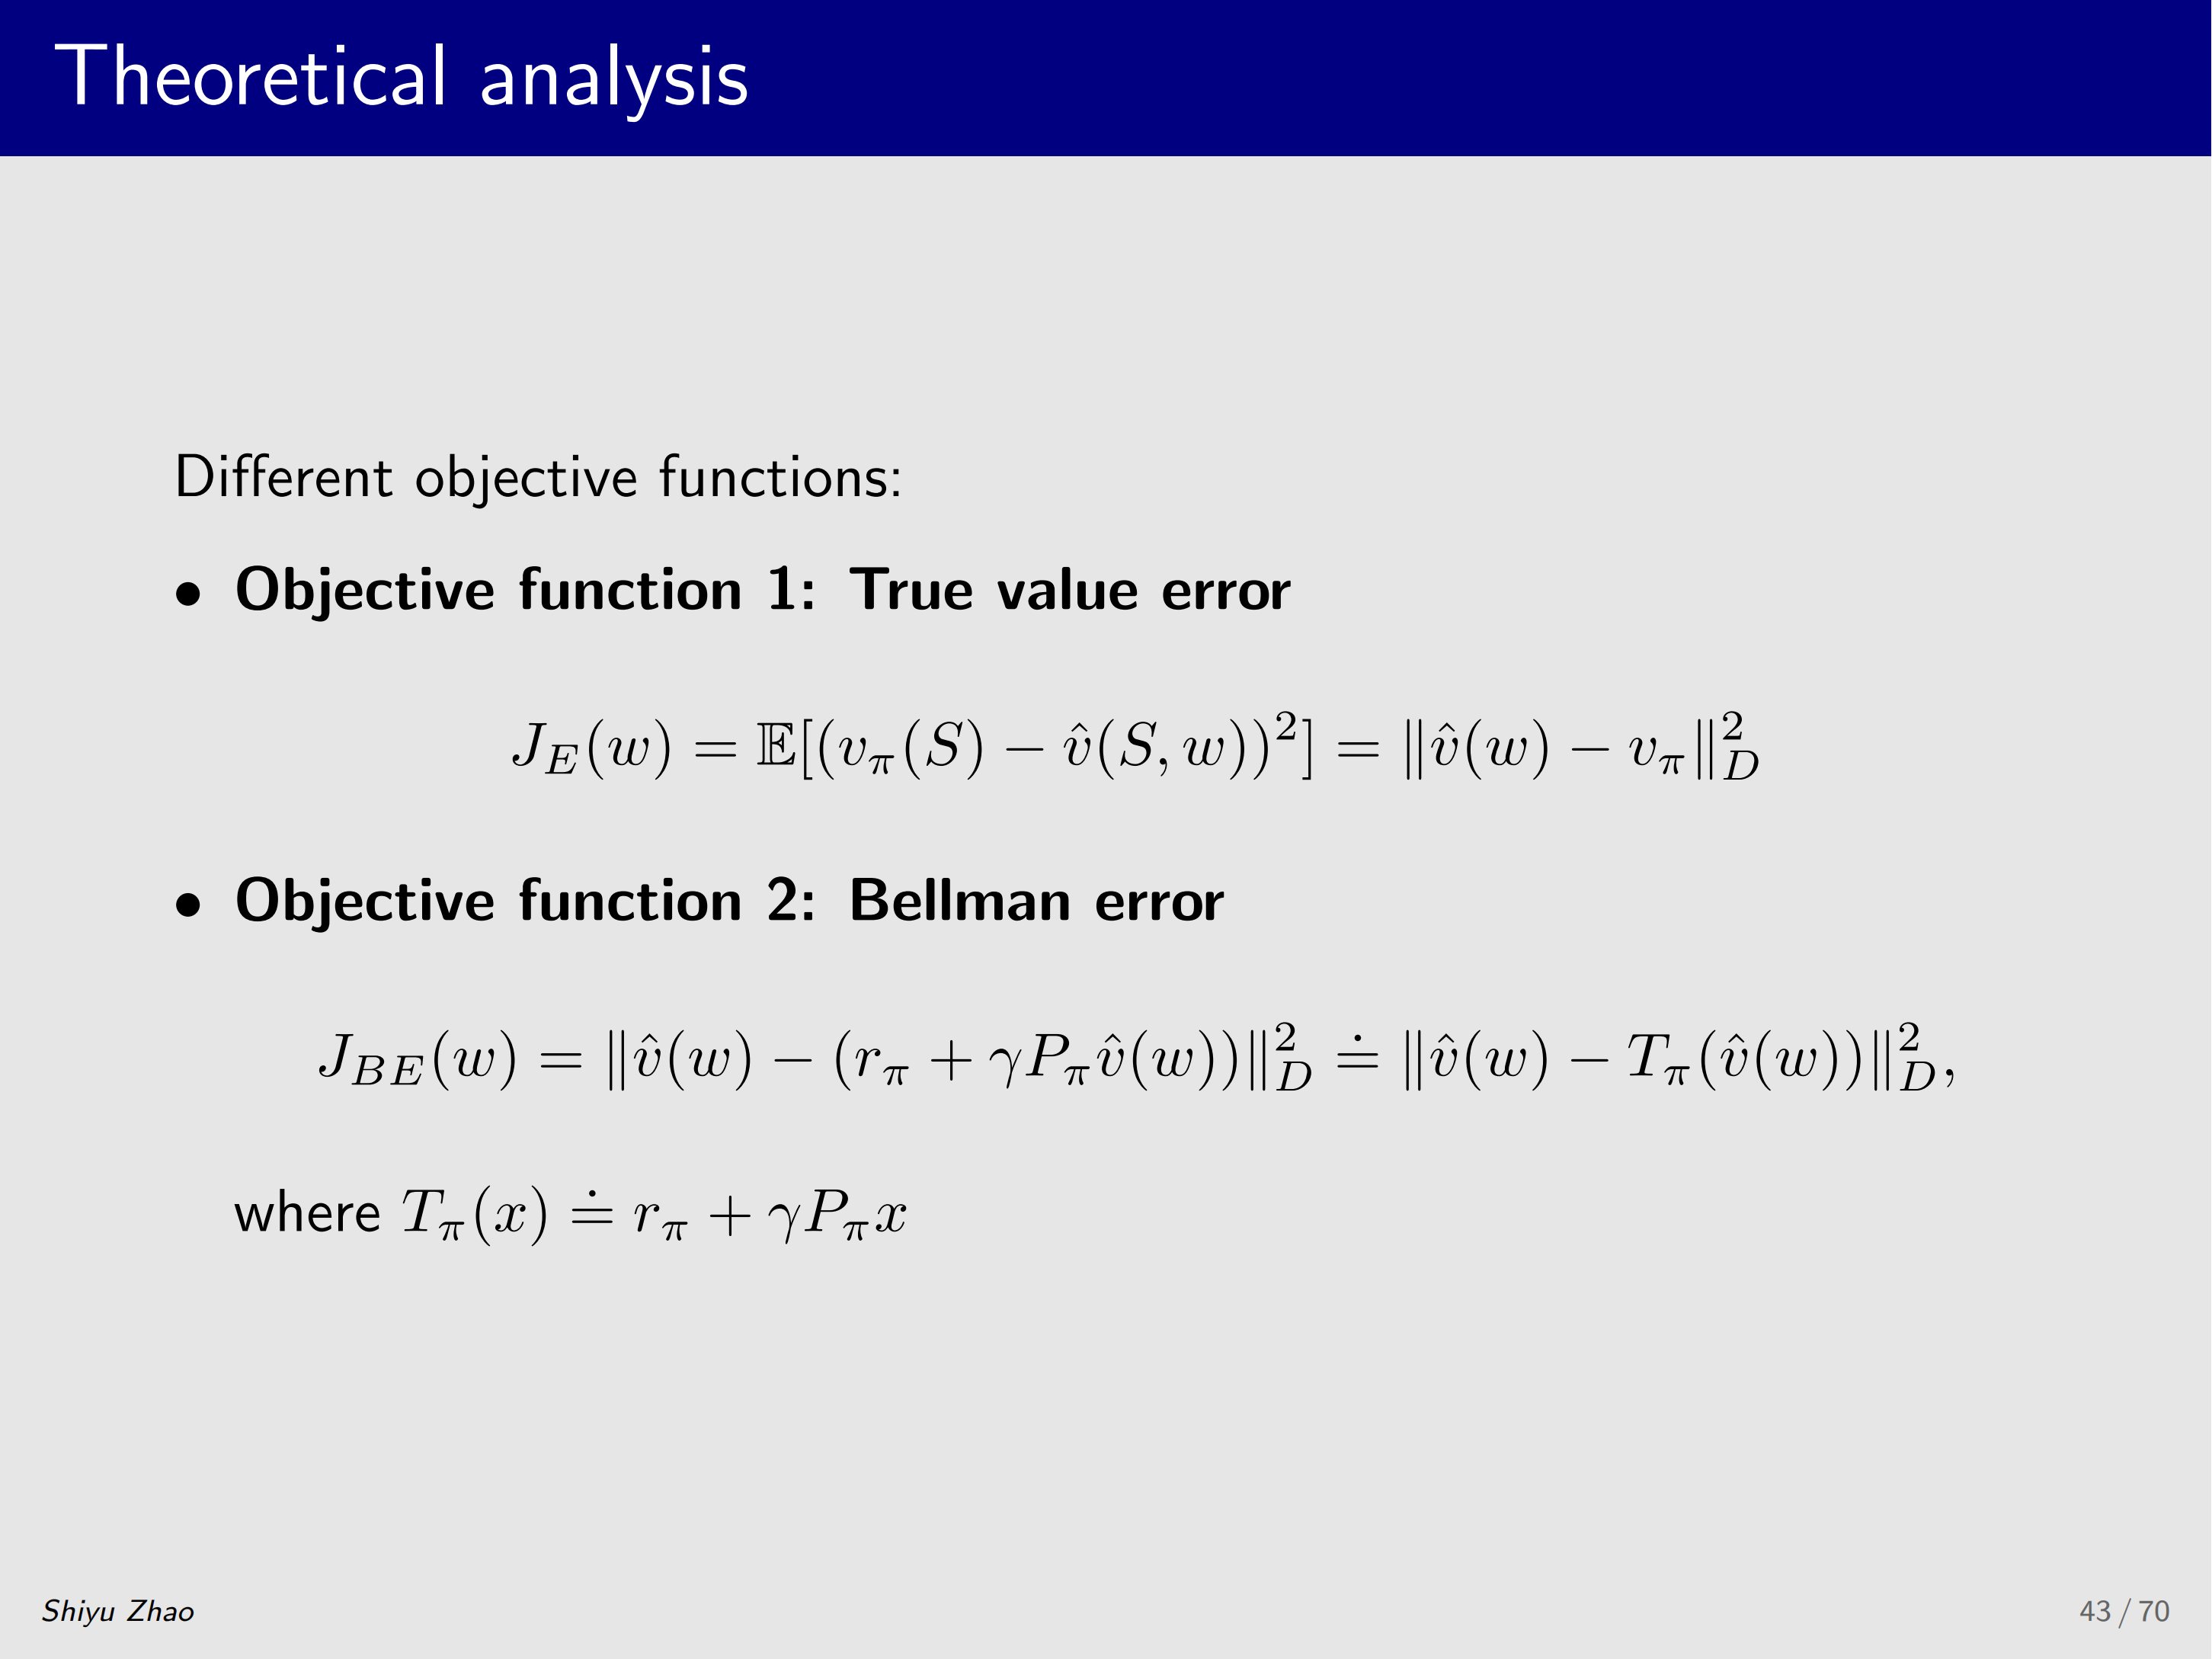
J E ( w ) = E ( v π ( S ) − v \^ ( S , w ) ) 2 = ∥ v ^ ( w ) − v π ∥ D 2 J_E(w) = \mathbb{E}(v_\\pi(S) - \\hat{v}(S, w))\^2 = \|\hat{v}(w) - v_\pi\|_D^2 JE(w)=E(vπ(S)−v\^(S,w))2=∥v^(w)−vπ∥D2
我们可以将它写成简洁形式:把 v ^ \hat{v} v^ 和 v π v_\pi vπ 写成向量,每个分量对应一个状态;双竖线是(加权)范数--- ∥ x ∥ D 2 = x T D x \|x\|D^2=x^TDx ∥x∥D2=xTDx, D D D 的对角线元素就是 S S S 的分布 d π d{\pi} dπ ,总之这就是之前给出的 objective function。
实际上还有另外一个叫 Bellman error:
J B E ( w ) = ∥ v ^ ( w ) − ( r π + γ P π v ^ ( w ) ) ∥ D 2 ≐ ∥ v ^ ( w ) − T π ( v ^ ( w ) ) ∥ D 2 , J_{BE}(w) = \|\hat{v}(w) - (r_\pi + \gamma P_\pi \hat{v}(w))\|D^2 \doteq \|\hat{v}(w) - T\pi(\hat{v}(w))\|_D^2, JBE(w)=∥v^(w)−(rπ+γPπv^(w))∥D2≐∥v^(w)−Tπ(v^(w))∥D2,
其中, T π ( x ) ≐ r π + γ P π x T_{\pi}(x) \doteq r_\pi + \gamma P_\pi x Tπ(x)≐rπ+γPπx 。
它的意思是:我们不是希望 v ^ \hat{v} v^ 逼近 v π v_\pi vπ 吗? v π v_\pi vπ 满足贝尔曼公式 v π = r π + γ P π v π v_\pi = r_\pi + \gamma P_\pi v_\pi vπ=rπ+γPπvπ;如果 v ^ = v π \hat{v} = v_\pi v^=vπ , v ^ \hat{v} v^ 也应满足 v ^ = r π + γ P π v ^ \hat{v}=r_{\pi}+\gamma P_{\pi} \hat{v} v^=rπ+γPπv^---右端可写成 T π ( v ^ ) T_\pi(\hat{v}) Tπ(v^)。理论上两者应相等,但实际可能不相等;不相等就去 minimize 这个误差,就得到上面的 Bellman error。
除此之外,还有一个 error,这个 error 实际上就是 刚才算法真正 minimize 的,它是什么呢?
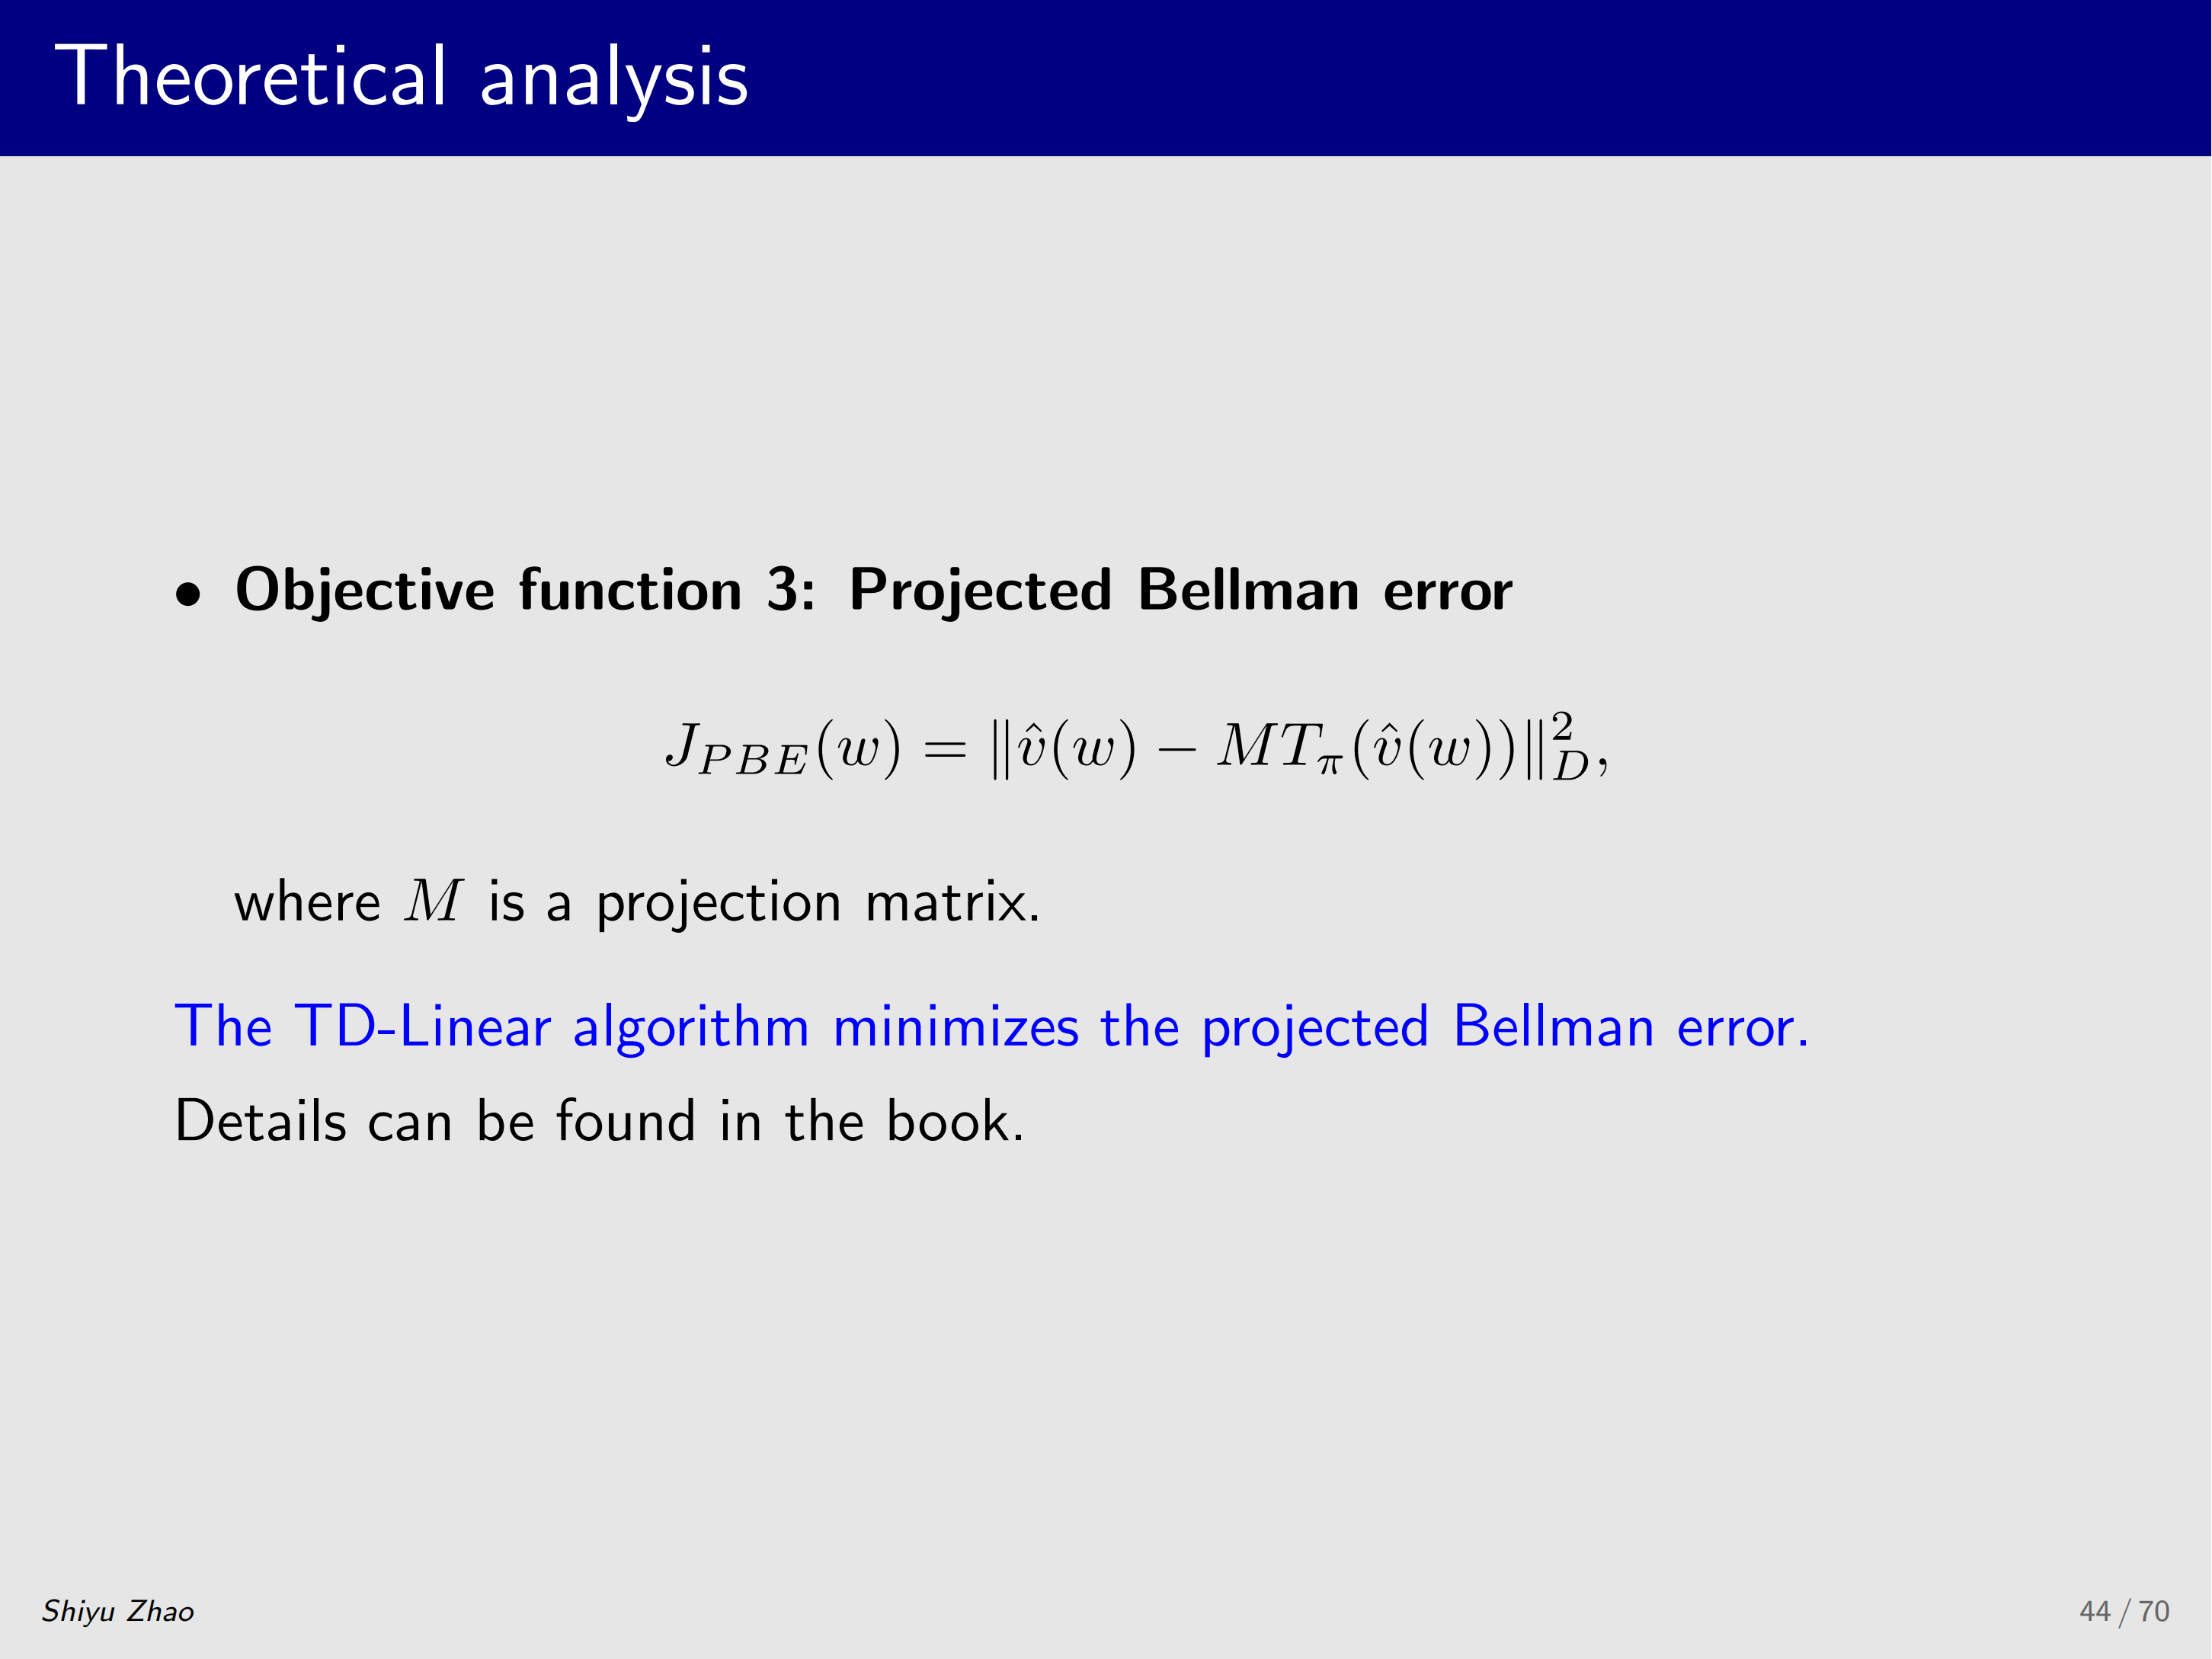
J P B E ( w ) = ∥ v ^ ( w ) − M T π ( v ^ ( w ) ) ∥ D 2 , J_{PBE}(w) = \|\hat{v}(w) - M T_\pi(\hat{v}(w))\|_D^2, JPBE(w)=∥v^(w)−MTπ(v^(w))∥D2,
它是 projected Bellman error ,它就是刚才的 Bellman error 多了一个 projection matrix(投影矩阵) ,这是什么意思? v ^ ( w ) \hat{v}(w) v^(w) 和 T π ( v ^ ( w ) ) T_{\pi}(\hat{v}(w)) Tπ(v^(w)) 这两个量可能永远不相等---由于函数结构的原因(比如它是平面), v ^ \hat{v} v^ 无法完全逼近 v π v_\pi vπ。于是把 T π ( v ^ ( w ) ) T_{\pi}(\hat{v}(w)) Tπ(v^(w)) 乘一个投影矩阵,投影到所有 v ^ ( w ) \hat{v}(w) v^(w)( w w w 变化)张成的函数空间上;这时 error 有可能等于 0。我们点到为止。
总而言之, 刚才介绍的 TD-Linear 算法所 minimize 的是这样一个 projected Bellman error,感兴趣的话可以参考教材中更多的理论分析。
结语
本讲第四部分通过 5×5 grid-world 的实例直观展示了函数近似的威力与局限:用仅 3 个参数的平面拟合 25 个 state value,趋势正确但误差不可消除;提升到 6 个参数的二次曲面效果改善,10 个参数的三次曲面已与 ground truth 几乎重合。参数越多拟合越好,但线性函数终究无法将误差降为零---结构限制决定了表达能力的天花板,这正是神经网络兴起的原因。
更重要的是,本部分坦率地指出了 "故事线" 的数学不严谨性:从目标函数出发、替换 v π v_\pi vπ 为 TD target 的推导直观流畅,但严格的结论是---TD-Linear 算法实际最小化的并非最初的 J E J_E JE(价值误差),而是 projected Bellman error J P B E = ∥ v ^ ( w ) − M T π ( v ^ ( w ) ) ∥ D 2 J_{PBE} = \|\hat{v}(w) - M T_\pi(\hat{v}(w))\|D^2 JPBE=∥v^(w)−MTπ(v^(w))∥D2 。投影矩阵 M M M 的存在,是因为函数结构(如平面)可能永远无法精确表达 T π ( v ^ ) T\pi(\hat{v}) Tπ(v^) ,只能将残差投影到函数空间内再最小化。这一理论澄清让 "故事" 与 "真相" 各归其位,为后续算法提供了坚实的立足点🤗。