ELK Stack生产环境部署指南
1. 部署架构与规划
上一篇文章介绍了 ELK 日志平台的整体架构及核心组件,本篇开始进入实际部署阶段。
本文基于 Docker Compose 搭建一套完整的 ELK Stack,包括 Elasticsearch 集群、Kibana 可视化平台以及 Logstash 日志处理服务,适合作为中小型生产环境或测试环境的部署参考。
1.1 架构选型
采用 FELK 架构,即 Filebeat + Elasticsearch + Logstash + Kibana。Filebeat 作为轻量级日志采集器部署在应用服务器上,负责收集日志并转发至 Logstash;Logstash 集中部署,负责日志的过滤与解析;Elasticsearch 集群存储并提供检索能力;Kibana 作为可视化前端。
环境说明:
- 部署方式:Docker Compose
- 镜像版本:Elasticsearch 7.8.1、Kibana 7.8.1、Logstash 7.8.1
- 集群规模:3个Elasticsearch节点 + 1个Kibana + 1个Logstash
使用docker-compose的优势:
1)环境隔离,避免依赖冲突 2)部署流程统一,便于迁移 3)升级和回滚更加方便 4)配置文件集中管理,便于维护
1.2 服务器规划
| 服务器IP | 部署组件 | 端口映射 |
|---|---|---|
| 10.1.1.1 | Elasticsearch node-1、Kibana | 9200/9300、5601 |
| 10.1.1.2 | Elasticsearch node-2 | 9200/9300 |
| 10.1.1.3 | Elasticsearch node-3 | 9200/9300 |
| 独立服务器 | Logstash | 5044/9600 |
| 各应用服务器 | Filebeat | 无(主动采集) |
网络规划 :所有容器加入名为
elastic的外部 Docker 网络,实现跨主机容器通信。
1.3 版本选择说明
本文使用 Elastic Stack 7.8.1 版本进行部署。
之所以选择该版本,主要基于以下几个原因:
- 7.x 系列在生产环境中较为成熟,稳定性较好。
- 与 Filebeat、Logstash、Kibana 保持版本一致,兼容性较好。
- 相比 8.x 版本,默认未开启安全认证,部署及学习成本更低。
- 目前仍有较多企业生产环境运行在 7.x 系列,具有一定参考价值。
如果新建生产环境且对安全要求较高,也可以直接部署 8.x 版本,但需要额外配置 xpack 安全认证及 HTTPS 通信。
2. Elasticsearch 集群部署
本文默认读者已经完成 Docker 与 Docker Compose 的安装,因此不再介绍基础环境搭建,下面直接进入 ELK 集群部署流程。
2.1 服务准备
开始部署前,建议提前完成以下环境准备工作:
- Docker 20.x 及以上版本
- Docker Compose(或 Docker Compose Plugin)
- 三台 Linux 服务器(CentOS、Ubuntu、openEuler 等均可)
- 三台服务器网络互通
- 每台服务器建议至少 2 核 CPU、4GB 内存(生产环境建议更高)
在不同的服务器上对应的/data/project-es 创建目录,编辑compose的yml文件,使用docker compose up之后相关的文件会自动创建
text
/data/project-es/
├── docker-compose.yml
├── es/
│   ├── config/
│   │   └── elasticsearch.yml
│   ├── data/
│   ├── log/
│   └── plugins/
└── kibana/
    └── config/
        └── kibana.yml
2.2 ES compose配置文件
compose 的配置文件参考如下,可以只用其中一个节点部署kibana,其他的节点只需要配置es既可以
version: '3.8'
services:
  es:
    container_name: es-node1
    image: library/elasticsearch:7.8.1
    restart: always
    environment:
      - "ES_JAVA_OPTS=-Xms1024m -Xmx1024m"
      - "TZ=Asia/Shanghai"
    ulimits:
      memlock:
        soft: -1
        hard: -1
      nofile:
        soft: 65536
        hard: 65536
    ports:
      - "9200:9200"
      - "9300:9300"
    logging:
      driver: "json-file"
      options:
        max-size: "50m"
    volumes:
      - ./es/config/elasticsearch.yml:/usr/share/elasticsearch/config/elasticsearch.yml
      - ./es/plugins:/usr/share/elasticsearch/plugins
      - ./es/data:/usr/share/elasticsearch/data
      - ./es/log:/usr/share/elasticsearch/log
    networks:
      - elastic

  kibana:
    container_name: kibana
    image: library/kibana:7.8.1
    restart: always
    environment:
      - "TZ=Asia/Shanghai"
      - "I18N_LOCALE=zh-CN"
    ports:
      - "5601:5601"
    volumes:
      - ./kibana/config/kibana.yml:/usr/share/kibana/config/kibana.yml
    depends_on:
      - es
    networks:
      - elastic

networks:
  elastic:
    external: true
其他es集群节点,只需要部署es即可
version: '3.8'
services:
  es:
    container_name: es-node2
    image: library/elasticsearch:7.8.1
    restart: always
    environment:
      - "ES_JAVA_OPTS=-Xms1024m -Xmx1024m"
      - "TZ=Asia/Shanghai"
    ulimits:
      memlock:
        soft: -1
        hard: -1
      nofile:
        soft: 65536
        hard: 65536
    ports:
      - "9200:9200"
      - "9300:9300"
    logging:
      driver: "json-file"
      options:
        max-size: "50m"
    volumes:
      - ./es/config/elasticsearch.yml:/usr/share/elasticsearch/config/elasticsearch.yml
      - ./es/plugins:/usr/share/elasticsearch/plugins
      - ./es/data:/usr/share/elasticsearch/data
      - ./es/log:/usr/share/elasticsearch/log
编辑完成之后,启动对应的服务,确定服务正常运行
docker compose up -d
docker ps -a
2.3 ES 配置文件详解
在执行compose命令后,会在本地目录挂载yml文件,我们需要修改相关的配置使服务按照我们的需要运行,配置文件在/data/project-es/es/config/elasticsearch.yml,(node-2、node-3 需相应调整 node.name 和 network.publish_host)
# 集群名称
cluster.name: elastic
# 当前该节点的名称
node.name: node-1
# 是否有资格竞选主节点
node.master: true
# 是否存储数据
node.data: true
# 最大集群节点数
node.max_local_storage_nodes: 3
# 数据存档位置
path.data: /usr/share/elasticsearch/data
# 日志存放位置
path.logs: /usr/share/elasticsearch/log
# 监听地址(0.0.0.0 表示监听所有网卡)
network.bind_host: 0.0.0.0
# 发布地址(供其他节点访问)
network.publish_host: 10.1.1.1
# HTTP 端口
http.port: 9200
# 内部节点之间沟通端口
transport.tcp.port: 9300
# 候选主节点地址列表
discovery.seed_hosts: ["10.1.1.1:9300","10.1.1.2:9300","10.1.1.3:9300"]
# 集群启动时参与选主的节点列表
cluster.initial_master_nodes: ["10.1.1.1:9300","10.1.1.2:9300","10.1.1.3:9300"]
# 集群至少恢复 1 个节点后提供服务
gateway.recover_after_nodes: 1
# 禁用安全配置
xpack.security.enabled: false| 配置项 | 说明 |
|---|---|
cluster.name |
集群名称,所有节点必须一致 |
node.name |
节点唯一标识,每个节点不同 |
node.master |
是否具备主节点选举资格 |
node.data |
是否存储索引数据 |
discovery.seed_hosts |
集群发现机制,用于节点互相发现 |
cluster.initial_master_nodes |
集群初始化时的候选主节点列表 |
gateway.recover_after_nodes |
集群恢复时至少多少节点在线才提供服务 |
除了上述配置外,Elasticsearch 还提供大量可调参数。
本文仅介绍集群部署过程中必须配置的内容,其余参数保持默认即可,后续可根据业务规模和性能需求逐步优化。
2.4 启动集群服务
依次修改每个集群服务的配置文件,确定对应的配置,然后重启服务
# 创建外部网络(仅首次执行)
docker network create elastic

# 启动所有节点(分别在对应服务器执行)
cd /data/project-es
# 启动服务
docker compose up -d
# 重启服务
docker compose restart
# 验证集群状态 访问站点
http://10.1.1.1:9200/_cluster/health?pretty
3.Kibana 服务部署
3.1 Kibana配置文件
修改对应的/data/project-es/kibana/config/kibana.yml配置文件,配置按照实际的需求调整,我此处没有设置xpack的安全设置,如有需要可以自行开启,使用账号密码访问
# 服务监听端口
# server.port: 5601

# 监听地址,0 表示所有网卡(允许远程访问)
server.host: "0"

# 最大请求体大小(CSV导出等场景需要调大)
server.maxPayloadBytes: 524288000

# Kibana 服务名称
server.name: "kibana"

# Elasticsearch 集群地址列表
elasticsearch.hosts: [ "http://10.1.1.1:9200","http://10.1.1.2:9200","http://10.1.1.3:9200" ]

# CSV导出文件大小上限(200MB,默认10MB)
xpack.reporting.csv.maxSizeBytes: 209715200

# 导出任务超时时间(30分钟,默认2分钟)
xpack.reporting.queue.timeout: 1800000

# 界面语言(中文)
i18n.locale: "zh-CN"| 配置项 | 说明 |
|---|---|
server.host |
设为 "0" 表示监听所有网络接口,允许远程访问 |
server.maxPayloadBytes |
调大以支持大日志导出 |
elasticsearch.hosts |
配置ES集群所有节点地址,实现负载均衡 |
xpack.reporting.csv.maxSizeBytes |
导出CSV文件大小上限,根据需求调整 |
xpack.reporting.queue.timeout |
导出任务超时时间,大日志导出需要调大 |
3.2 Kibana服务启动
cd /data/project-es
# 启动容器
docker compose up -d kibana
# 重启服务
docker restart kibana
4. Logstash服务部署
4.1 服务准备
此处的两个配置文件是需要修改的,使用compose启动之后会自动创建
/data/project-logstash/
├── docker-compose.yml
└── logstash/
    ├── config/
    │   └── logstash.yml
    └── pipeline/
        └── logstash.conf
4.2 logstash compose
在指定路径下编辑docker-compose.yml配置文件
version: "3.8"
services:
  logstash:
    container_name: logstash
    image: library/logstash:7.8.1
    restart: always
    environment:
      - "TZ=Asia/Shanghai"
    volumes:
      - ./logstash/config/:/usr/share/logstash/config
      - ./logstash/pipeline/:/usr/share/logstash/pipeline
    ports:
      - 5044:5044
      - 9600:9600
保存后启动服务
cd /data/project-logstash
docker compose up -d
4.3 logstash配置文件
logstash.yml 对接的ES集群,选择一个节点即可
http.host: "0.0.0.0"
xpack.monitoring.elasticsearch.hosts: [ "http://10.1.1.1:9200" ]
使用的服务器IP以及对接的ES服务器节点
input {
  beats {
    port => 5044
  }
}
output {
  elasticsearch {
    hosts => ["http://10.1.1.1:9200"]
    index => "logs-write"
  }
  stdout {
    codec => rubydebug
  }
}| 配置项 | 说明 |
|---|---|
input.beats.port |
Filebeat 连接端口(默认5044) |
output.elasticsearch.hosts |
ES集群地址(可配置多个) |
output.elasticsearch.index |
写入的索引名称,可按业务自定义 |
output.stdout |
控制台输出,方便调试(生产环境可移除) |
生产环境建议 :在
filter段添加日志解析规则(如 json 或 grok),将非结构化日志转换为结构化字段,提升检索效率。例如解析 JSON 日志:
ruby
filter {
  json {
    source => "message"
  }
}
如果日志为普通文本格式,也可以使用 grok 插件提取字段,将日志转换为结构化数据后写入 Elasticsearch,方便后续按字段进行查询和统计。
# 重启服务
docker restart logstash
5. 服务验证及问题排查
5.1生产环境优化建议
为了保证日志平台长期稳定运行,建议在生产环境中进行以下优化:
- Elasticsearch 堆内存建议设置为物理内存的 50%,最大不超过 32GB。
- 建议启用 ILM(Index Lifecycle Management)自动管理日志生命周期。
- 定期清理无用索引,避免磁盘占满。
- Filebeat 建议直接采集业务日志,不建议采集临时文件。
- Logstash 尽量保持过滤逻辑简单,复杂解析建议在应用侧完成。
- Elasticsearch 建议至少部署 3 个节点,避免单点故障。
5.2服务验证
依次进行访问验证
-
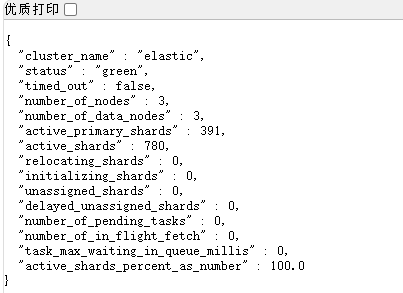
验证 Elasticsearch 集群:访问 http://10.1.1.1:9200/_cluster/health?pretty,确认节点数为3
-
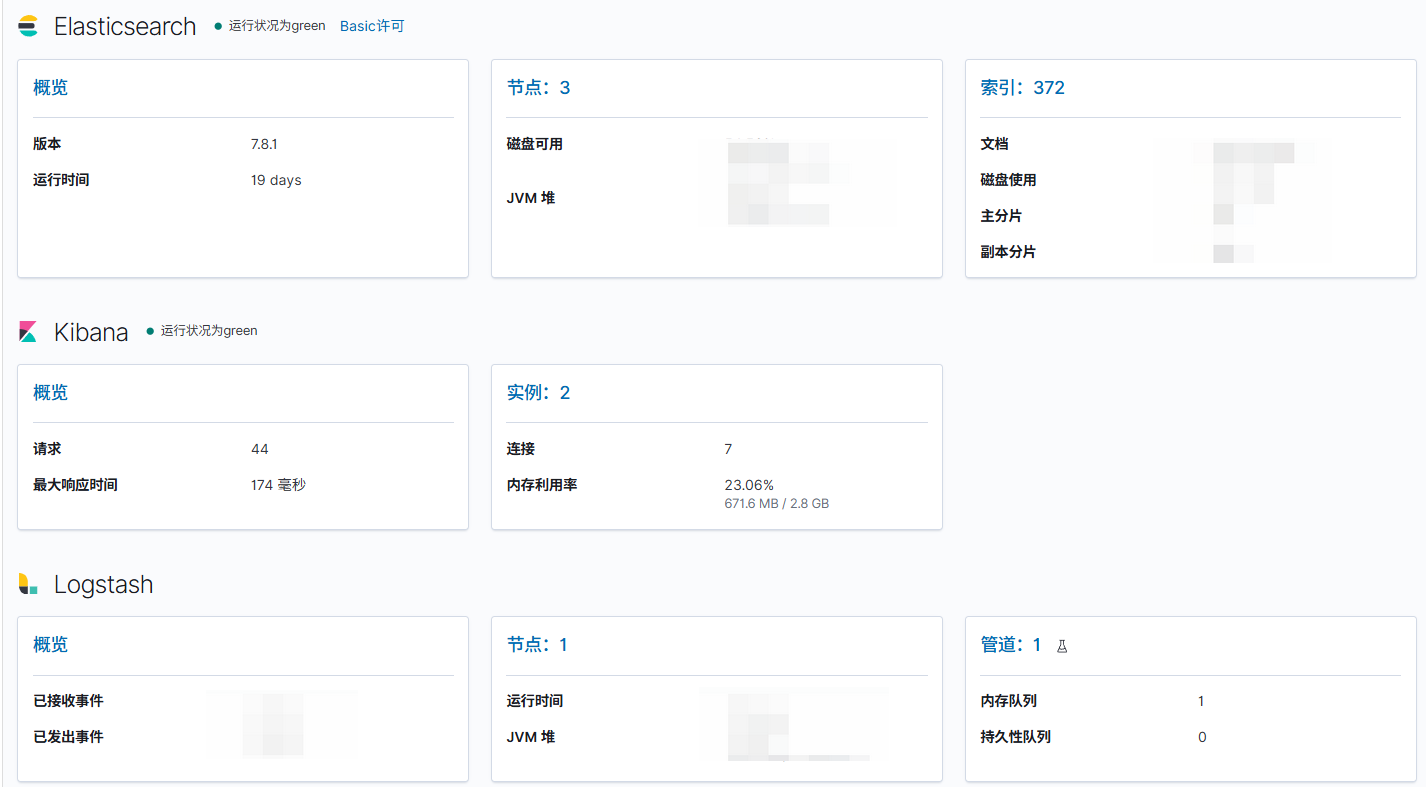
验证 Kibana:访问 http://10.1.1.1:5601,确认能正常打开
-
验证 Logstash:docker logs logstash 检查是否有报错
5.3 问题排查
| 问题现象 | 可能原因 | 解决方案 |
|---|---|---|
| ES节点无法加入集群 | discovery.seed_hosts 配置不正确 |
检查IP和端口是否正确,确保网络互通 |
| Kibana无法连接ES | ES未启动或地址配置错误 | 检查 elasticsearch.hosts 配置,确认ES已启动 |
| Logstash无法接收数据 | 5044端口未开放 | 检查防火墙和 ports 映射配置 |
| Kibana CSV导出失败 | 超时时间或文件大小限制 | 调大 xpack.reporting.queue.timeout 和 maxSizeBytes |
| ES内存溢出 | 堆内存过大或查询过重 | 调整 ES_JAVA_OPTS,建议不超过物理内存的50% |
| 容器时区不正确 | 未设置 TZ 环境变量 |
添加 - "TZ=Asia/Shanghai" 环境变量 |
6. 总结
至此,一个基础的 ELK 日志平台已经完成部署。
本文主要介绍了 Elasticsearch 集群、Kibana 以及 Logstash 的部署过程,并结合生产环境配置说明了各组件的作用及相关参数配置。
下一篇将介绍 Filebeat 的日志采集配置,包括日志目录监控、字段过滤、多业务日志分类以及接入 ELK 平台的方法。
7.后续文档
本文介绍了 ELK 日志平台的完整部署流程,之前文档已经完成了ELK整体架构的内容介绍
后续文档包括:
| 文档 | 内容 |
|---|---|
| 日志接入指南 | Filebeat 配置、日志接入流程 |
| 日志查询指南 | Elasticsearch API、Kibana 查询方法 |
| ES Log Viewer 开源项目使用说明 | 企业内部日志查询平台使用方法 |
建议按照上述顺序阅读,以便完整了解日志平台的部署及使用流程。