GRPO 的核心设计很优雅:同一个 prompt 采样 G 条轨迹,用组内的相对优势代替 critic 网络。 不需要价值网络,不需要 GAE,在数学题上跑得又快又稳。
但这个优雅建立在两个没被写出来的假设上:同一 prompt 采多次的成本是可接受的 ,且同一组的 G 条轨迹长度相近。
到了 Agent 场景,这两个假设同时崩塌。一次 rollout 可能包含几百次工具调用,耗时从几秒到几十分钟不等,分布极不均匀------于是"组内最慢的那条"决定了整组的完成时间,其余 GPU 全部空转。
NVIDIA 给出的解法极端到有点反直觉:每个 prompt 只采一条轨迹,不要组。 听起来会让梯度噪声直接爆炸。他们用三个组件把这件事压住了,并在异步 lag 约 4--8 的条件下稳定跑完 6000 次更新。更关键的是,在某个实验里,GRPO 对照组跑到第 600 步时,模型的工具调用次数已经归零。
一、旧范式的原罪:GRPO 的两个隐含假设
1.1 GRPO 到底省掉了什么
先回忆一下 GRPO(Group Relative Policy Optimization)在省什么。PPO 需要一个与策略网络同规模的 critic 来估计优势,而 GRPO 用组内的经验均值当基线:
scss
     GRPO 优势估计(第 i 条轨迹的第 t 个 token)

        Â(i,t) = r(i) − mean(r(1..G))
                 ─────────────────────
                        std(r(1..G))

     r(i) = 第 i 条轨迹的(通常是)序列级奖励

  →  不需要 critic 网络    ✓
  →  不需要 GAE            ✓
  →  但需要:同一 prompt 的 G 条 sibling rollout  ✗
代价就是那个 G。典型配置是 32 个 prompt × 4 条 rollout ,或者 64 prompt × 8 条。
1.2 假设一:多次采样的成本可接受
这个假设在数学题上成立。一道题生成 8 条 CoT,每条几十秒,长度分布集中。HF TRL 团队的调研给过一个量级参照:一个典型 GRPO 步是 64 prompt × 8 条 = 512 条 rollout,在单张 H100 上仅生成就要吃掉数分钟。
这在数学题上是"贵但能忍",在 Agent 上是"根本跑不动"。 因为 Agent 的 rollout 不只是生成 token------它包含工具调用返回、环境交互、文件读写、甚至等待外部服务。单条 rollout 的成本被放大了一到两个数量级,而 GRPO 把这个成本乘以 G。
1.3 假设二:同组轨迹长度相近(真正致命的那个)
假设一只是"贵",假设二是"卡死"。
GRPO 的组是同步的:整个组必须等最慢的那条完成才能计算基线。数学题的长度方差小,掉队者(straggler)损耗有限。但 Agent 的 rollout 时长分布是长尾的------一次失败的探索可能跑 20 分钟才发现走不通,一次成功的可能 30 秒就完成。
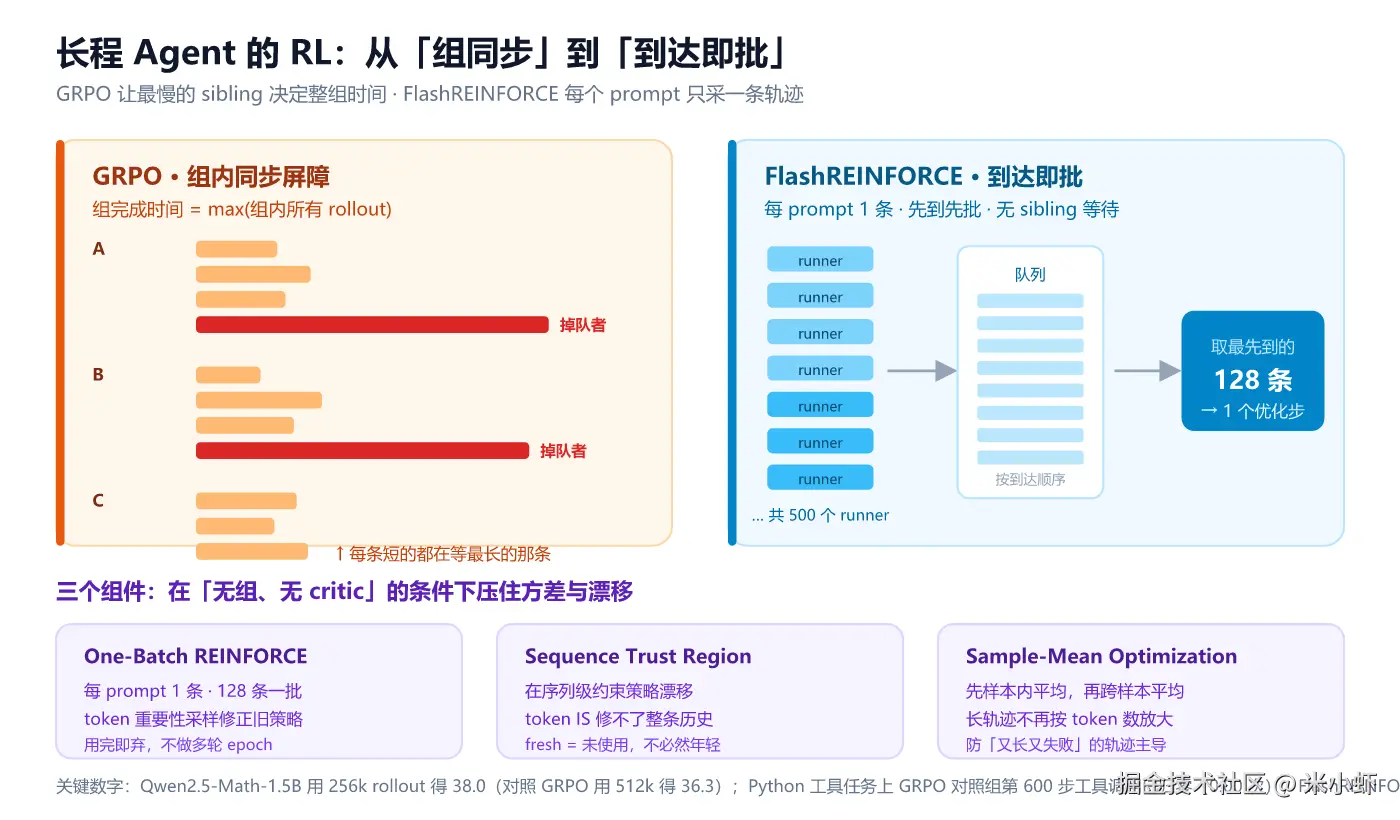
于是有了这张图:
lua
GRPO:组内同步屏障                      FlashREINFORCE:无组,到达即批

  prompt A ─┬─ 0.4 min  ✓              runner 1 ─┐
            ├─ 0.6 min  ✓              runner 2 ─┤
            ├─ 0.5 min  ✓              runner 3 ─┤
            └─ 18.2 min ✓ ← 全组等它    runner 4 ─┼─► 队列 ─► 取最先到达的
                                        runner 5 ─┤        128 条 → 一步
  prompt B ─┬─ 0.3 min  ✓                ...     │
            ├─ 0.9 min  ✓            runner 500 ─┘
            ├─ 22.0 min ✓ ← 全组等它
            └─ 0.7 min  ✓              ↑ 无 sibling 等待
                                       ↑ 无组同步屏障
  组完成时间 = max(组内所有 rollout)     步完成时间 = 第 128 个到达的 rollout
  掉队者直接乘进每一步的墙钟时间          掉队者只影响它自己
同步 RL 的根本问题在这里被 Agent 放大了:生成时训练卡空闲,训练时生成卡空闲,而长尾的 rollout 时长让"生成"这一段的长度变得不可预测。
1.4 还有第三个代价:prompt 覆盖被稀释
这一点容易被忽略,但论文把它列为首要动机。
在固定的 rollout 预算下(比如总共 512 条),GRPO 的 64×8 只覆盖了 64 个不同任务 ;改成每 prompt 一条,同样的预算能覆盖 512 个不同任务。
对长程 Agent 尤其致命------Agent 的能力来自"见过足够多的任务形态",而不是"在同一个任务上见过足够多的随机分支"。你在用 8 倍的任务多样性,去换一次组内方差削减。
二、三个组件:怎么在"没有组、没有 critic"的条件下不崩
去掉组意味着少了组内基线,去掉 critic 意味着少了价值基线,两者都是方差削减手段。FlashREINFORCE 用三个组件把方差和漂移各自管住。
2.1 One-Batch REINFORCE:一条 rollout 也是一个 batch
| 项 | 设置 |
|---|---|
| 每个 prompt | 1 条 rollout(不是 G 条) |
| 一个优化步 | 收集 128 条 rollout 组成一个 batch |
| 更新方式 | one-batch ------ 这 128 条用完后丢弃,不做多轮 epoch |
| 陈旧修正 | token 级重要性采样(token IS) |
异步意味着 rollout 是用若干步之前的旧策略生成的。token IS 用当前策略与行为策略的比值来修正:
c
    ρ_t = π_θ(a_t | s_t) / π_β(a_t | s_t)

    修正后的目标 ≈ Σ_t ρ_t · Â_t · log π_θ(a_t | s_t)
但论文明确说了它的边界:token IS 不是完整的轨迹修正。 它修正的是"在一条已存储的历史下,被采样的那个动作";而这条历史本身仍然是行为策略走出来的。这直接引出了第二个组件。
2.2 Sequence Trust Region:在序列级控漂移
既然 token IS 只修正了局部动作、没修正整条轨迹的分布,累积的策略漂移就需要一个独立的约束。Sequence Trust Region 就是干这个的------它约束的是序列级的策略变化量,而不是逐 token 的比值裁剪。
配合它的是一个反直觉的洞察,论文把它写成了一条实践原则:
"Fresh" 意味着"未被使用过",不必然意味着"年轻"。 一条轨迹在策略年龄上可以是陈旧的(比如落后 8 个更新步),但对优化来说仍然是新鲜的------只要它还没被用来更新过。信任域负责处理漂移,one-batch 训练负责避免在同一批采集数据上反复更新。
这句话把"陈旧度(staleness)"这个异步 RL 里最折磨人的概念拆成了两件独立的事:策略年龄由信任域管,数据复用由 one-batch 管。
2.3 Sample-Mean Optimization:别让长轨迹吃掉整个梯度
第三个组件解决的是一个很工程的问题:如果 loss 是按 token 求和再平均的,那么一条 20000 token 的轨迹,其梯度贡献是一条 500 token 轨迹的 40 倍。
Agent 场景里,最长的轨迹往往是失败的那条(跑偏了还在继续尝试)。于是按 token 加权会让"又长又失败"的轨迹主导整个更新方向。
Sample-Mean Optimization 把加权方式改成样本均值------先在每个样本(轨迹)内部求平均,再跨样本求平均。这样每条轨迹无论多长,权重相同。
ini
  按 token 平均:  loss = Σ_all_tokens ( ... ) / N_tokens
                   → 长轨迹权重 ∝ 长度,长失败轨迹主导

  按样本平均:     loss = (1/M) Σ_j [ (1/T_j) Σ_t ( ... ) ]
                   → 每条轨迹权重 = 1/M,与长度无关
三、实验数据:一半的 rollout 预算,更好的分数
项目页给出的结果(模型 / 设置 / 分数 / 对照):
| 任务 | 模型 | FlashREINFORCE | 对照 GRPO |
|---|---|---|---|
| 长 CoT 推理 | DeepSeek-R1-Distill-Qwen-1.5B | AIME24/25 均值 21.7 → 33.7,lag≈4 下稳定跑完 6000 次更新 | --- |
| 数学推理 | Qwen2.5-Math-1.5B | 38.0 均值,用 256k rollout | 报告值 36.3 均值,用 512k rollout |
| Python 工具调用 | Qwen2.5-7B-Instruct | 37.0 均值,轨迹平均 3.25 次工具调用 | 第 600 步时 30.3 均值,工具调用 0.00 次 |
| Python 工具调用 | Qwen3-30B-A3B | lag≈8 下稳定 | 在同预算对比下领先 6.8 分 |
| ALFWorld | Qwen2.5-7B-Instruct | seen 98.3% / unseen 96.5% | step 200、12.8k 训练轨迹后评估 |
三个值得单独拎出来的数字:
① 数学任务上,用一半的 rollout 预算拿到更高的分。 256k vs 512k,38.0 vs 36.3。这不是"省了时间",这是"同样的墙钟时间内见到了两倍的任务"。
② Python 工具任务上,GRPO 对照组在第 600 步时工具调用次数是 0.00。 这是整篇里最有说服力的一个数字------不是 GRPO 分数低一点,而是GRPO 把工具调用这个行为整个学没了。模型发现"不调用工具、直接猜答案"在短期奖励上更划算,于是坍缩。而 FlashREINFORCE 保持了 3.25 次/轨迹。
③ ALFWorld 的 98.3% / 96.5% 说明这套方法在真正的具身/交互环境里同样成立,而不只是在数学题上。
四、理想丰满,现实骨感:五个工程死结
论文作者自己在项目页上列了五条"实用原则",其中四条其实是限制条件。这部分比实验数字更值得读。
死结一:token IS 不是完整的轨迹修正
前面提过,这里再说清楚后果:重要性采样修正的是"给定历史下的动作概率比",但这条历史是行为策略产生的。 如果你依赖 token IS 来完全消除 off-policy 偏差,你会失望------它做不到,所以才必须有 Sequence Trust Region 作为第二道防线。
工程含义:不要只调 IS 的裁剪阈值,信任域才是真正的稳定器。 只把
ρ裁剪收紧,通常会同时损失掉有效梯度。
死结二:共同支撑集(support)假设会被采样参数破坏
精确的重要性修正要求 π_θ 和 π_β 有共同支撑集------凡是行为策略可能采到的动作,当前策略的概率不能为 0。
激进的 top-k 或 top-p 截断会直接违反这个假设。 一个动作如果被行为策略以 top-p 保留下来、却被当前策略的 top-k 截断掉,ρ 的分母不为零而分子为零,修正失效。
工程含义:在 RL 训练里调低 top-p / top-k 要格外小心。 推理时这么做只是让输出更确定,训练时这么做会让重要性采样悄悄失真。
死结三:没有 critic,方差削减全靠 batch size
GRPO 至少有组内均值做基线。FlashREINFORCE 每个 prompt 只有一条轨迹,组内基线不存在了。论文没有明说,但从配置看,128 条 trajectory 一个 batch 这个规模承担了方差削减的职责。
工程含义:这是个吞吐换方差的交易。 你的 rollout 池必须足够大(项目页举的是 500 个 runner 喂队列),否则 128 条 batch 的收集时间会吃掉掉队者优化带来的所有收益。小规模集群上,这套方法的优势会被削弱。
死结四:异步 lag 是需要调的超参数,不是免费的
论文里 lag 从 4(1.5B 长 CoT)到 8(30B MoE)不等,都被标注为"稳定",但这不是"lag 随便设"的意思。lag 太大,信任域压不住漂移;lag 太小,异步退化为同步,掉队者问题回来。
工程含义:lag 与模型规模、rollout 时长分布、batch 大小耦合,需要实测。 论文的 4 和 8 是他们在特定配置下跑出来的,不是默认值。
死结五:奖励稀疏的长程任务,样本均值也有副作用
Sample-Mean Optimization 让每条轨迹等权,解决了"长失败轨迹主导"的问题。但反过来:如果短轨迹恰好是"秒投降"的退化解,等权反而保护了它。
论文没有给出这个失效模式的证据,但从机制上这是等权设计的另一面。GRPO 对照组在 Python 工具任务上坍缩到 0 次工具调用,某种程度上就是长度相关偏差的反面教材。
工程含义:上了等权之后,要单独监控"轨迹长度分布"和"工具调用次数"这两个指标,它们比 reward 更早暴露坍缩。
五、作者给的五条实践原则(原文整理)
这几条是这个项目最值得抄走的部分,建议原样贴到你的 RL 训练 runbook 里:
| # | 原则 | 说明 |
|---|---|---|
| 1 | 异步 RL 是算法--系统协同设计问题 | 不能只改算法不动系统,反之亦然 |
| 2 | Prompt coverage over sibling multiplicity | 固定 rollout 预算下,每 prompt 一条能覆盖更多任务,并消除组同步屏障 |
| 3 | Fresh 意味着"未使用",不必然意味着"年轻" | 策略年龄由信任域管,数据复用由 one-batch 管,两者解耦 |
| 4 | Token IS 不是完整的轨迹修正 | 它修正被采样的动作,历史本身仍来自行为策略 → 必须配序列级漂移控制 |
| 5 | Support 仍然重要 | 精确的 IS 修正假设共同支撑集,激进的 top-k / top-p 截断会违反它 |
六、什么场景该上,什么场景别上
该上
| 场景 | 为什么 |
|---|---|
| 长程 Agent:编码、计算机操作、多步工具调用 | rollout 时长长尾、工具调用频繁,掉队者损耗最大 |
| rollout 预算固定但任务池很大 | 每 prompt 一条能把任务覆盖提到 G 倍 |
| 有大规模 rollout 池(数百 runner) | 队列模式才有意义,128 条 batch 才能快速凑齐 |
| 出现了"工具调用次数下降"的坍缩征兆 | 3.25 vs 0.00 这组对比直接对症 |
别上
| 场景 | 为什么 |
|---|---|
| 小规模集群(几十个并发以下) | 没有池子就没有"先到先批"的收益,异步退化 |
| 短输出、长度均匀的数学/单轮任务 | 掉队者问题本来就轻,GRPO 的组内基线反而更划算 |
| 需要极低方差的微调 | 没有 critic、没有组基线,方差全靠 batch |
| 你的采样配置依赖激进 top-k / top-p | 会破坏 IS 的共同支撑集假设 |
决策树
sql
你的 rollout 时长是长尾的吗(P99 / P50 > 5)?
│
├─ 否 ──► GRPO 够用。掉队者损耗有限,组内基线是好东西。
│
└─ 是 ──► 你的并发 runner 数量 > 128 吗?
          │
          ├─ 否 ──► 先把并发堆上去。FlashREINFORCE 的收益
          │         主要来自"到达即批",池子小就没收益。
          │
          └─ 是 ──► 有没有出现"工具调用 / 轨迹长度"坍缩?
                    │
                    ├─ 有 ──► 优先上 Sample-Mean Optimization(可以
                    │         单独用),并加监控:轨迹长度分布、
                    │         工具调用次数、reward 三条曲线一起看。
                    │
                    └─ 无 ──► 可以迁移。迁移顺序建议:
                              1) 先只改调度:去掉组,队列 + 到达即批
                              2) 再加 one-batch + token IS
                              3) 最后调 lag 与序列信任域(一起调)
                              4) 全程盯 lag 的实际分布,不要只看均值
七、我的判断
第一,这标志着 Agent 的 RL 训练从"算法问题"正式变成"系统问题"。 GRPO 的组设计在数学题时代是正确的工程权衡------用一点同步损耗换一个免费的基线。但 Agent 的 rollout 时长分布把这笔账算崩了。FlashREINFORCE 的真正贡献不是某个新的梯度估计量,而是承认了异步 RL 里算法和系统必须一起设计。
第二,"prompt coverage over sibling multiplicity" 这句话值得单独记下来。 它给出了一个普适的选型判据:当 rollout 预算固定,你是在买"同一任务的方差信息"还是在买"不同任务的信息"?对短任务,前者便宜;对长程 Agent,后者便宜。这个判据不只适用于 RL------你的评测集设计、你的 SFT 数据配比,面对的是同一个权衡。
第三,最值得警惕的不是分数,是 0.00。 GRPO 对照组把工具调用学到归零这件事,比任何分数差距都重要。它说明:在长程任务上,一个"看起来在涨"的 reward 曲线,可能对应着一个正在放弃核心行为的策略。 如果你在做 Agent 后训练,现在就去查一下你的训练日志里有没有"工具调用次数"这一列------如果没有,你根本不知道自己的模型是不是已经坍缩了。
第四,这套方法的门槛在池子规模,不在算法。 500 个 runner 这个量级把大多数团队挡在门外。所以更现实的落地路径是:先把 Sample-Mean Optimization 单独摘出来用(它是三个组件里最容易移植、也最独立的),再评估要不要动调度。
参考
- 论文:Jian Hu, Yifan Zhang, Hao Zhang, Binfeng Xu, Shaokun Zhang, Hongqing Peng, Zhiding Yu, Pavlo Molchanov, Jan Kautz, Yi Dong(NVIDIA).《FlashREINFORCE: Critic-Free Single-Rollout Asynchronous RL for Agentic Language Models》, 2026。
- 代码 :
github.com/yifanzhang-pro/FlashREINFORCE(开源);OpenRLHF 的--algo.advantage.estimator已支持flash_reinforce选项。 - 实验数字来源:作者项目页(yifzhang.com/blog/FlashREINFORCE),均为论文报告值。
- 对照背景:Hugging Face TRL 团队对 16 个开源异步 RL 库的七轴调研(编排、缓冲区、权重同步、陈旧度管理等),以及"同步 RL 中 GPU 空转"的量级估算。
免责说明:本文引用的实验结果为论文自报数据,GRPO 对照组在不同任务上为"报告值"或"同预算对比运行",并非全部为同配置重跑;ALFWorld 结果为 step 200、12.8k 训练轨迹后的评估。lag 取值(4 与 8)为论文在特定模型与配置下的稳定点,不代表通用默认值。