论文:Connectionist Temporal Classification: Labelling Unsegmented Sequence Data with Recurrent Neural Networks(Graves et al., ICML 2006)· PDF:cs.toronto.edu/~graves/icml_2006.pdf
一句话导读:这篇发明了 blank token 和"路径积分求和"两个核心动作,第一次让 RNN 不依赖 HMM、也不需要人工帧级对齐,就能直接从"帧数远大于标签数"的语音/手写数据端到端训出一个序列识别器。之后 20 年所有端到端 ASR 系统里,只要出现"CTC 头 / CTC loss"这两个字,血脉都能追到这一篇。
一、先被这个问题卡住
想象一段 10 秒的语音,采样成 1000 帧(每 10ms 一帧,直觉例子、非 TIMIT 实配)。你要输出的目标是 "the sound of" 这三个词------TIMIT 音素级标注下大约是 dh ax s aw n dcl d ix v 这一串 phone(跟稍后 Figure 1 展示的一致)。
现在训一个 RNN ------每一帧吐一个音素类别的概率分布。也就是 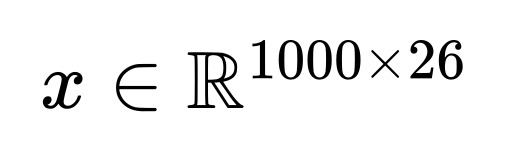 输入、
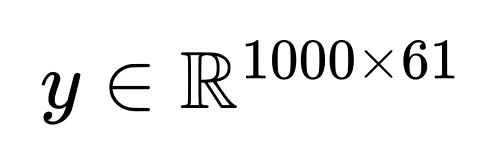 帧级概率表,但目标只有 9 个 phone。
问题一眼看出 :标准交叉熵需要帧级标签,但原始标注只给整段音频的 9 个音素,从来没告诉你第 137 帧对应哪个音素。要怎么算 loss?
2006 年之前的两条主流路:
- 纯 HMM 派:HMM 自身可以用 forward-backward / Baum-Welch 处理未对齐序列,训练目标是所有对齐路径概率的和;生成式训练目标跟判别式识别任务不完全对齐。
- RNN-HMM hybrid :RNN 只做局部帧分类,靠 HMM 提供的 Viterbi forced alignment 或状态后验作为帧级伪标签训练。伪对齐不可直接检验,pipeline 依赖这个中间假设。
问题的根 :每一帧的答案是个假问题------真实标注只声明输入和输出的对应关系,从来没规定"137 帧对应哪个音素"。CTC 的破题:承认它是假问题,把未知对齐从监督目标里挤出去。
二、CTC 的三个脑洞
脑洞 1:给模型一个"闭嘴"按钮
在原本的 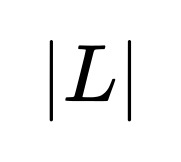 个真实 label 之外,多加一个特殊符号
-(blank)。RNN 输出层从 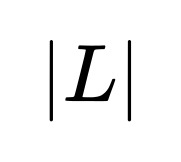 维扩到
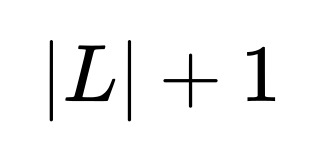 维,多出的那个维度就是"这一帧我什么也不想说"的概率。blank 有明确的结构作用(下一节展开)。
脑洞 2:Collapse 规则------路径压缩回 label 序列
一段长度 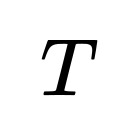 的路径(每帧一个 label,可含 blank 和重复)通过两步压缩,得到最终 label 序列:
- 先合并连续相同的符号(下表按"合并非 blank"展示,便于看清重复 label 的差异;连续 blank 合不合都行,反正下一步都删)
- 再删掉所有 blank
举几个具体例子看清楚(都以 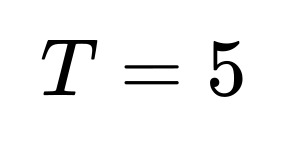 、label 表
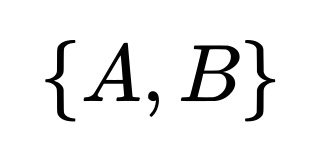 为例):
| 路径(长度 5) | 步骤 1(合并连续相同) | 步骤 2(删 blank) | 最终 label |
|---|---|---|---|
- A A - B |
- A - B |
A B |
AB |
A A - - B |
A - - B |
A B |
AB |
- - A B B |
- - A B |
A B |
AB |
A - A - - |
A - A - - |
A A |
AA |
A A A - - |
A - - |
A |
A |
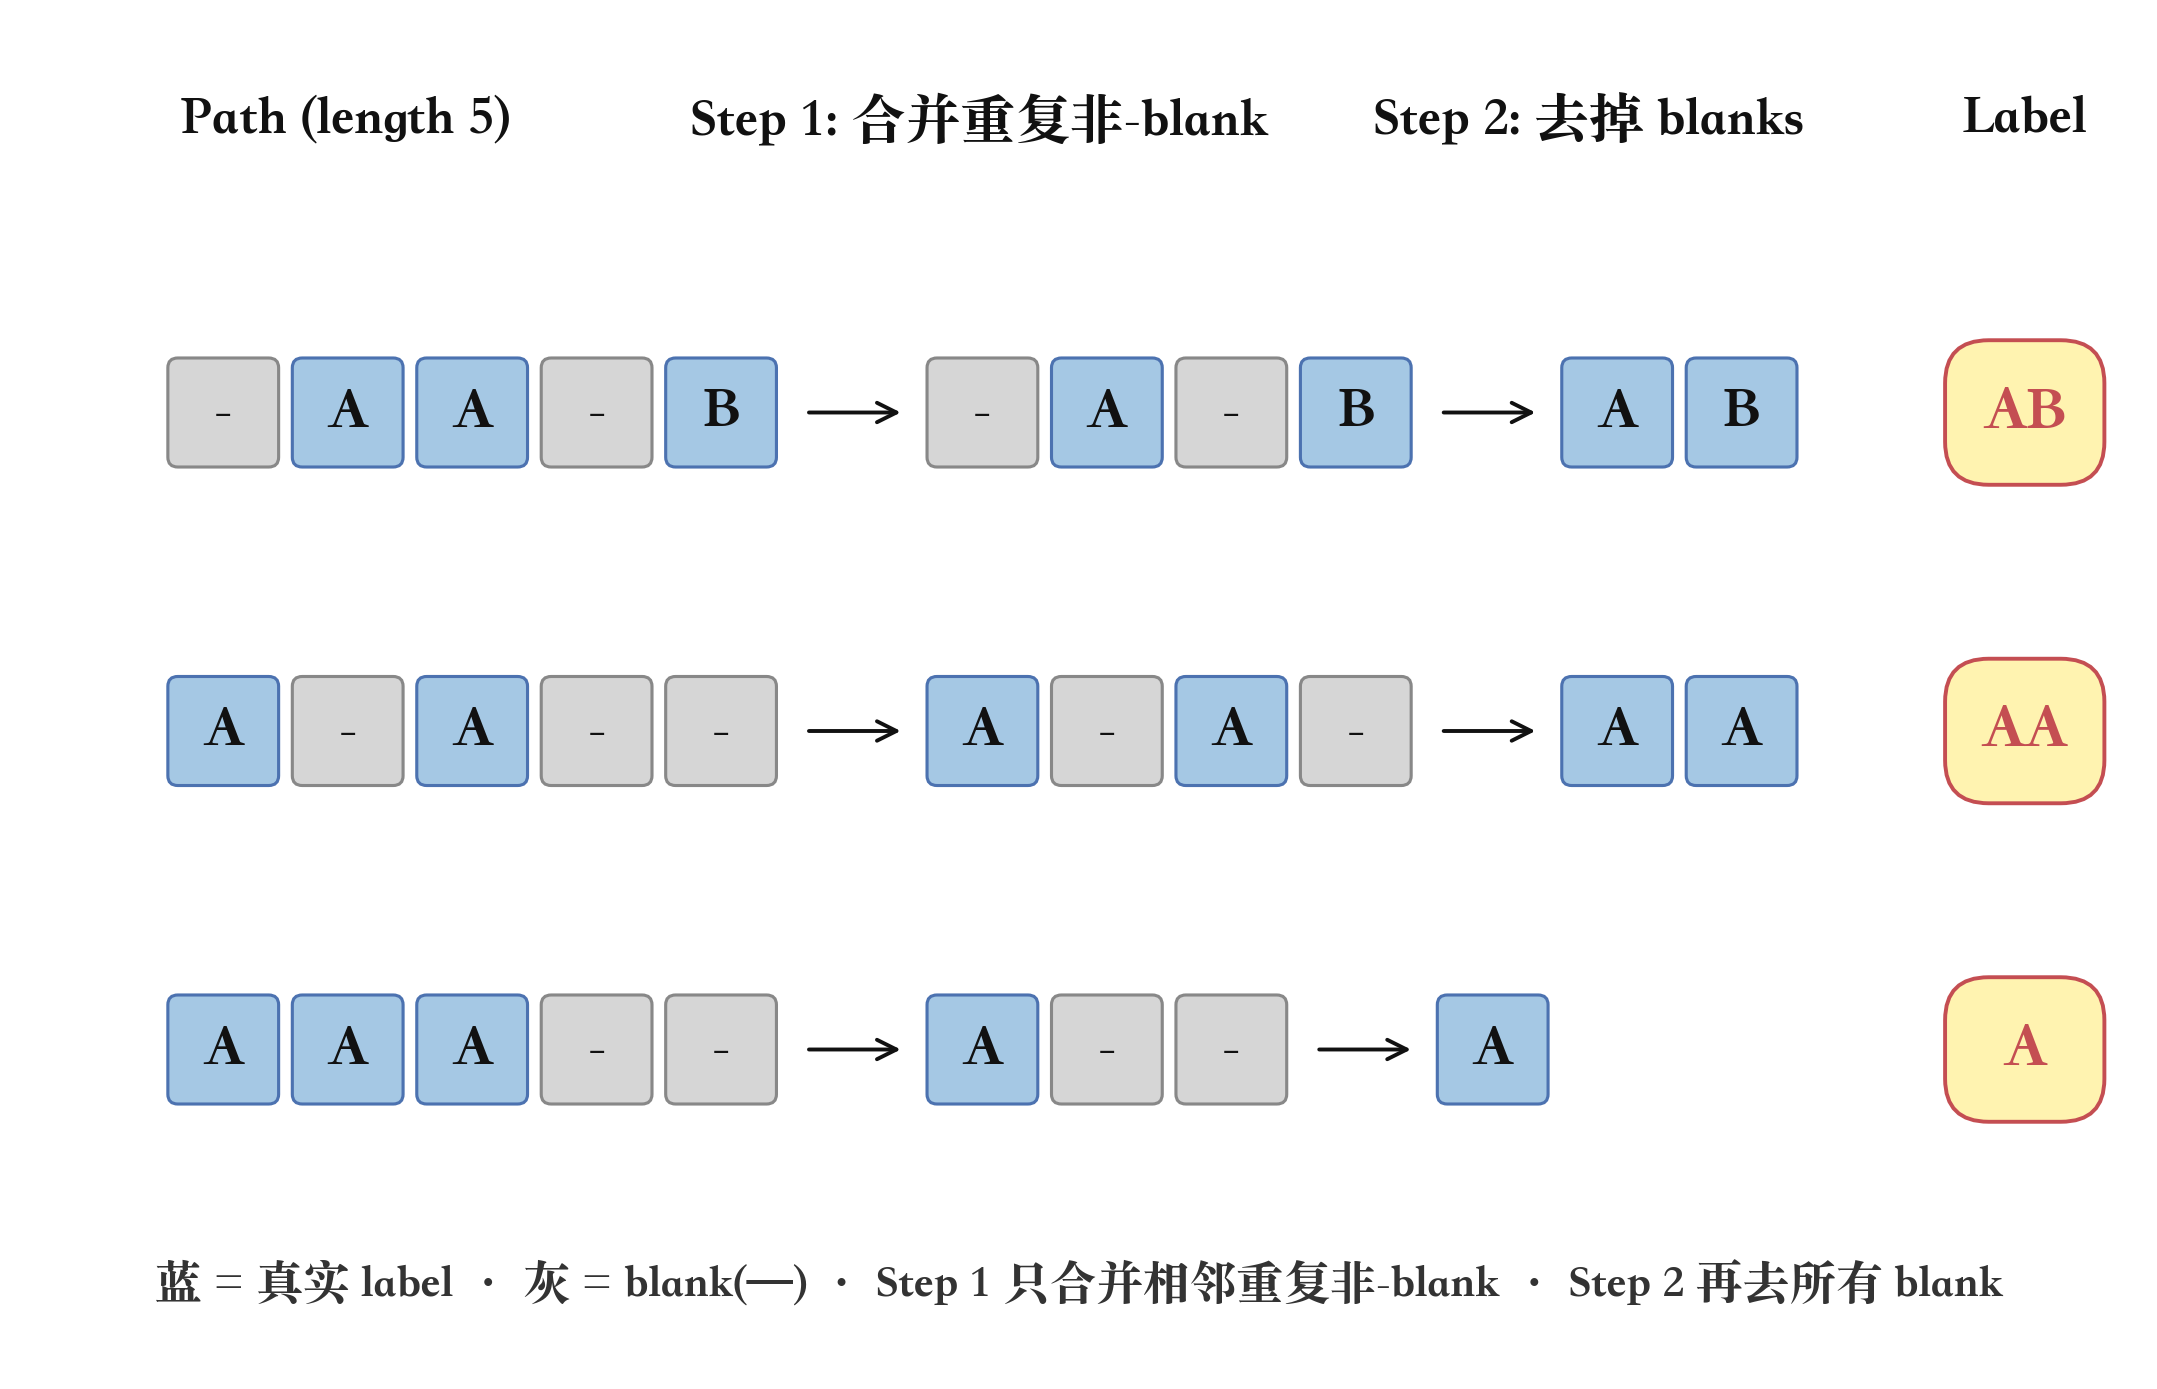
关键洞察 :blank 的深层作用是让模型能区分 AA(两个 A)和 A(一个 A 出现在多帧)。
如果没有 blank,AA 这条路径合并连续相同后变成 A------两个 A 无法区分。加了 blank 就能:想输出 AA 的路径,两组 A 之间必须至少隔一个 blank ------A-A、A--A、AA-AA 都合法;想输出 A 的路径可以是 AA、A-、-A、AAA 等。blank 同时承担两个作用:分隔相邻重复 label,并允许模型在无明确输出的帧保持沉默。
脑洞 3:不选一条对齐,把所有对齐加起来
同一个目标 label 序列 AB 对应很多种 长度 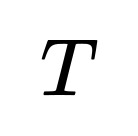 的路径------上面表格里前三行都能 collapse 成
AB。实际上 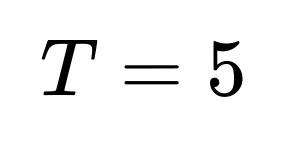 、target
AB 的合法路径还有 A-B--、-AB--、AAAB-、A--BB。
CTC 思路:不选一条对齐 。把所有能 collapse 成 AB 的路径 的概率加起来 当训练目标------训练最大化这个总和的 log likelihood,本质是把未知对齐当隐变量边缘化掉。问题被重构:未知对齐从训练目标里挤出去,变成一个不需要被回答的隐变量。
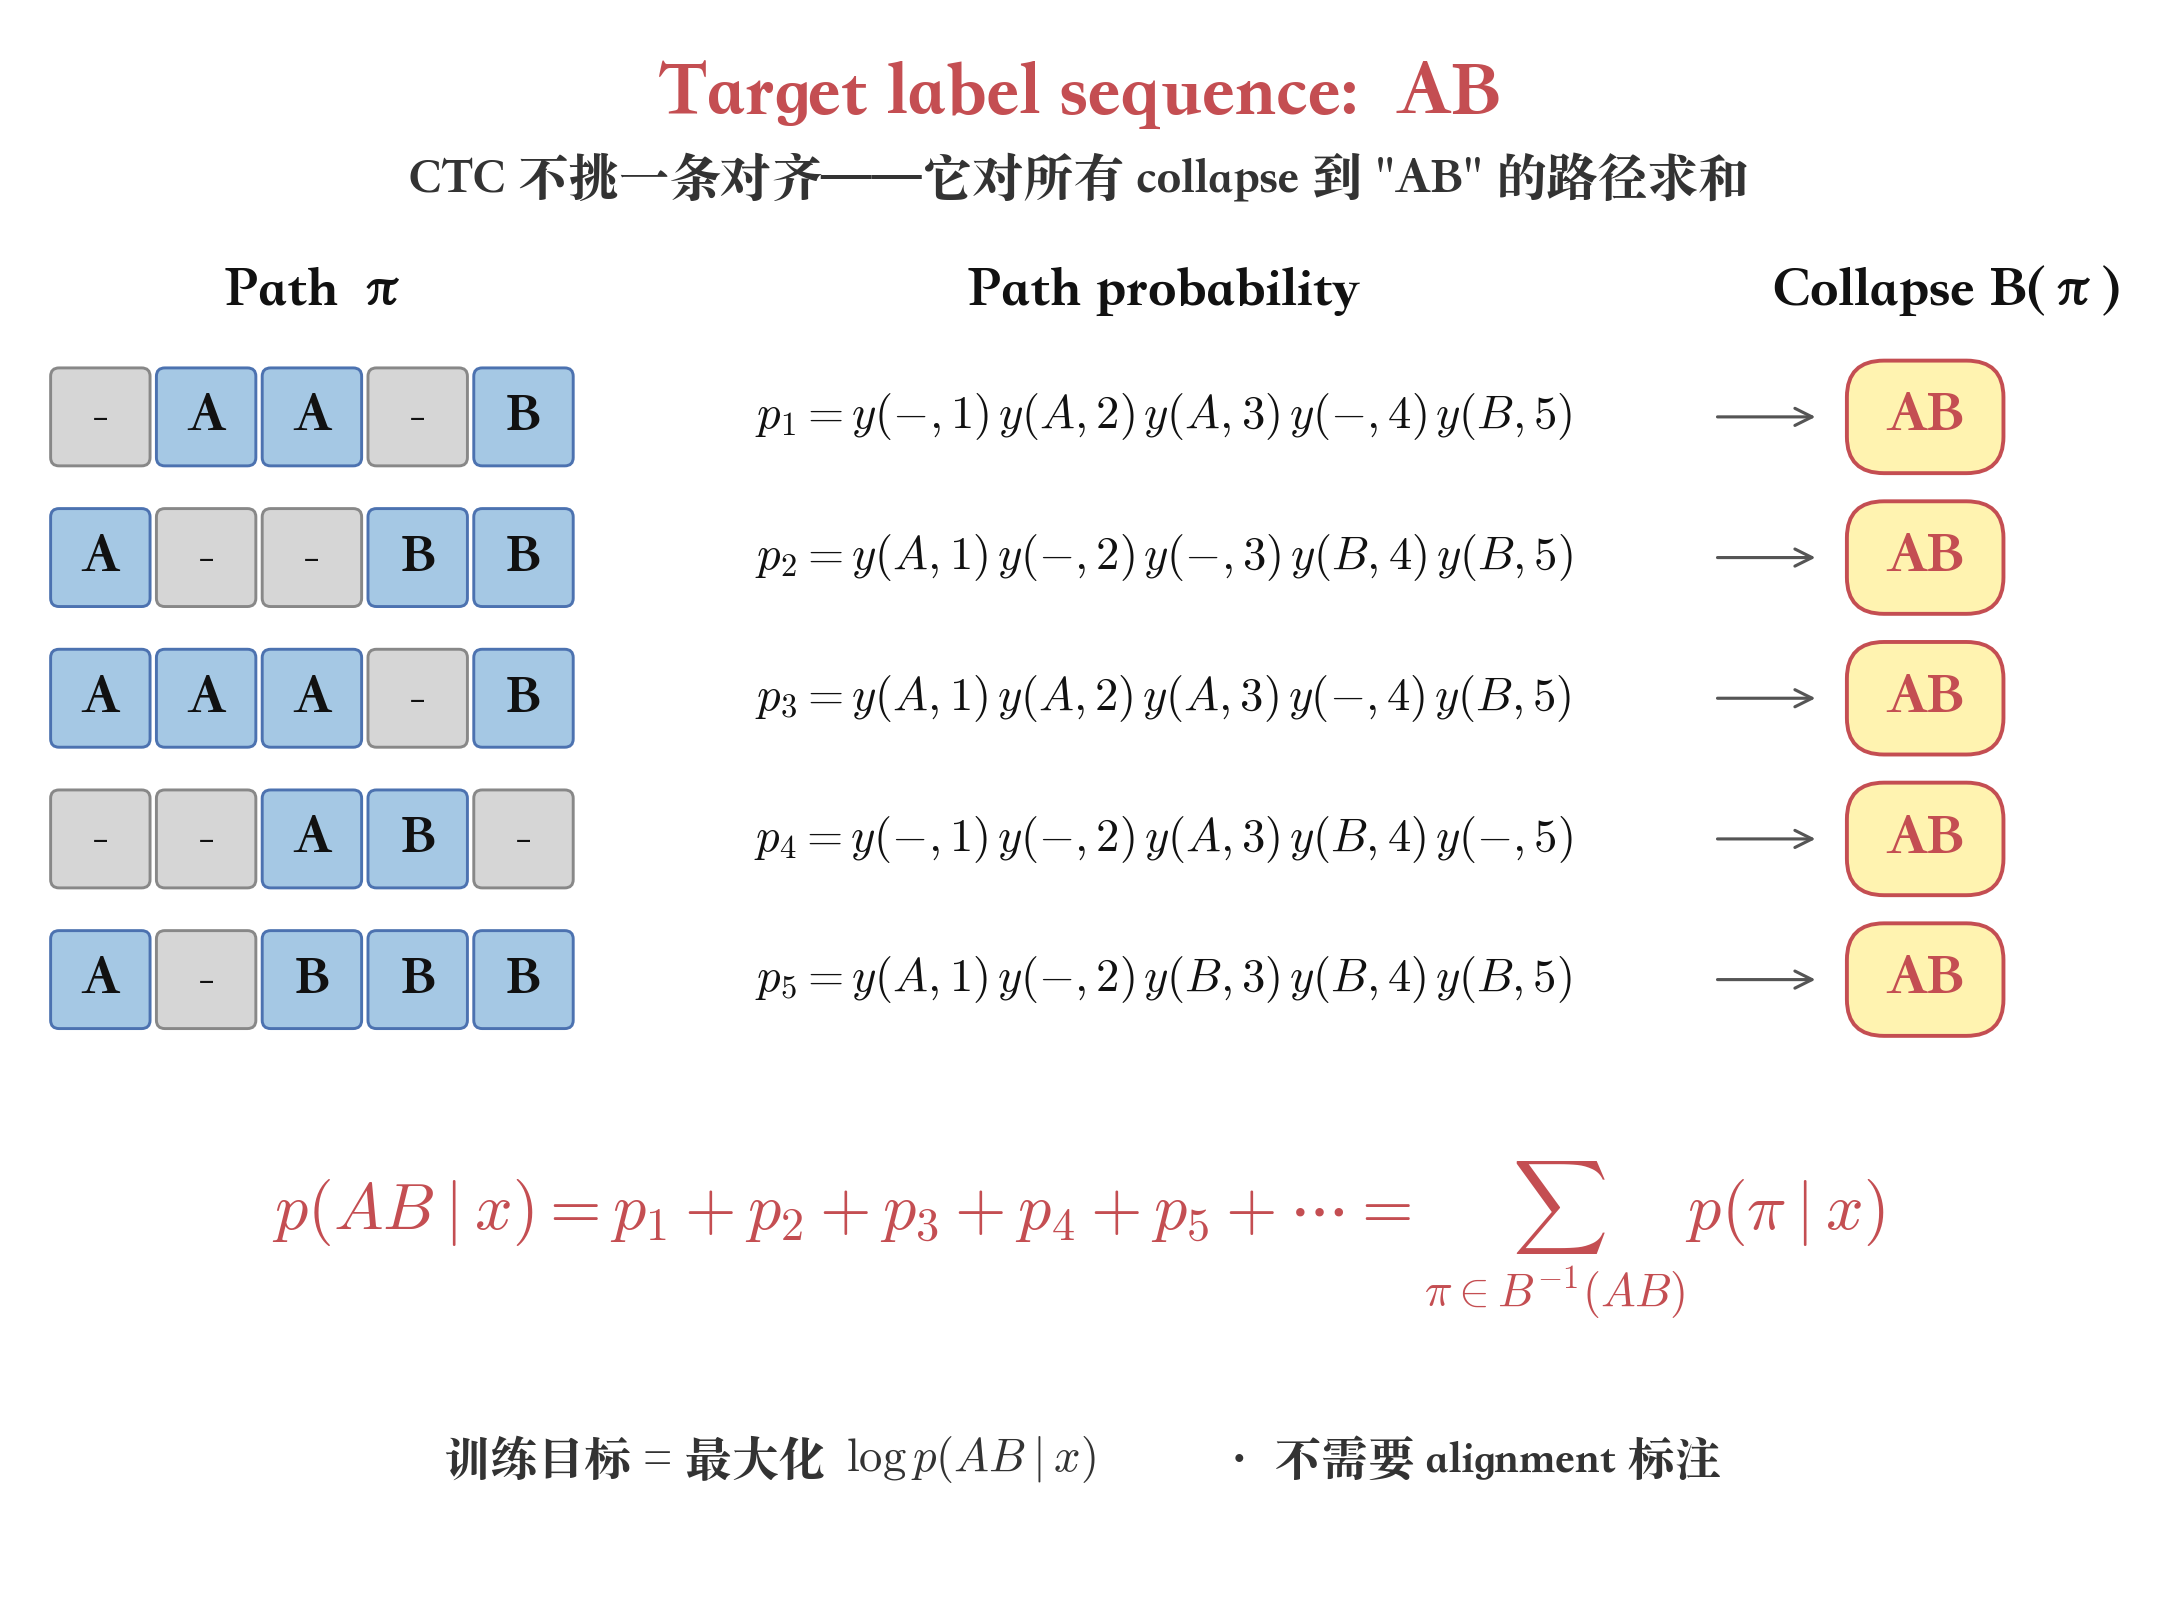
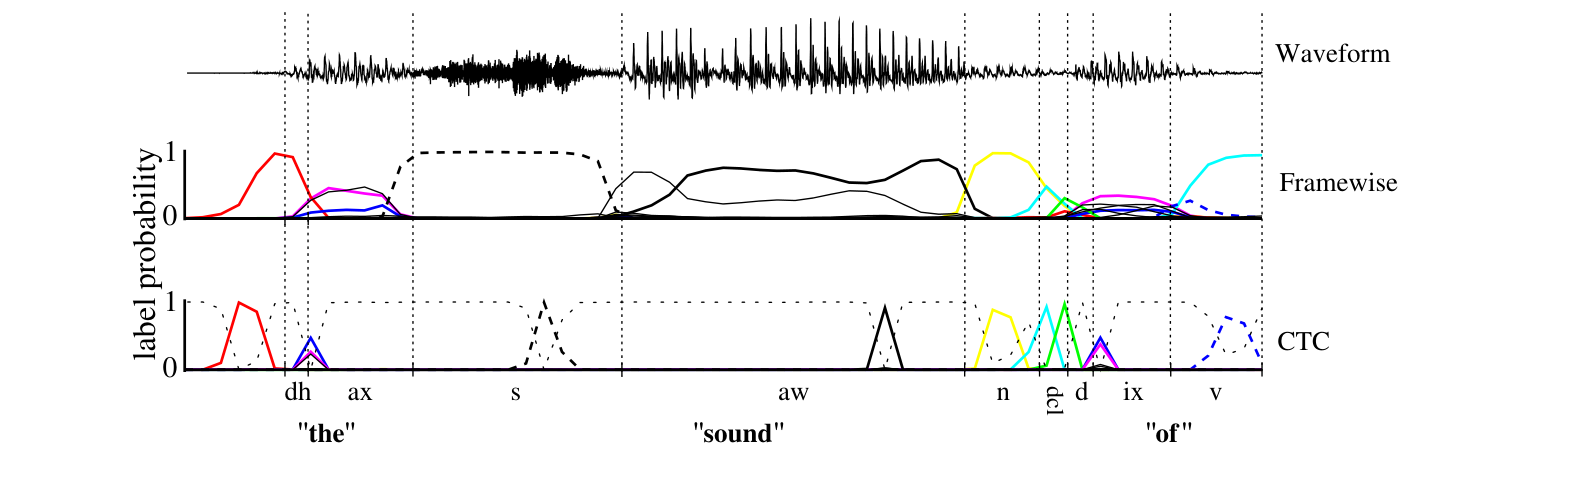
图 1 是上述三个脑洞训出来的模型在真实语音上的实际输出 。上半的 Framewise :每一帧都要给音素并贴合人工切分边界(竖线)。下半的 CTC:多数帧 blank 概率很高(横轴基线附近的空白区域),只在某几帧局部形成非 blank 的窄峰。读 CTC 输出的方式就是"顺着窄峰读一遍音素,跳过 blank",不需要任何 forced alignment 后处理。
三、三条主线公式
三个脑洞对应到公式只有三行。
路径概率------给定整段输入和 RNN 输出后,把一条路径的概率按时间步做乘积分解(帧间依赖由 RNN hidden state 隐式承载,CTC 头本身不显式建模 label 历史):
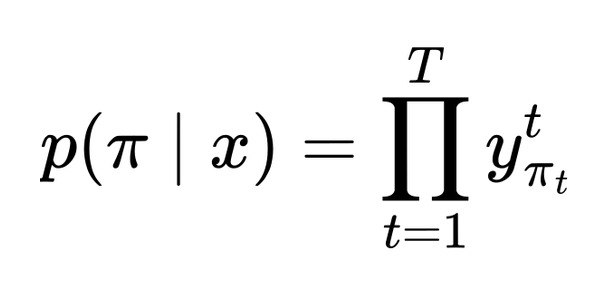
其中 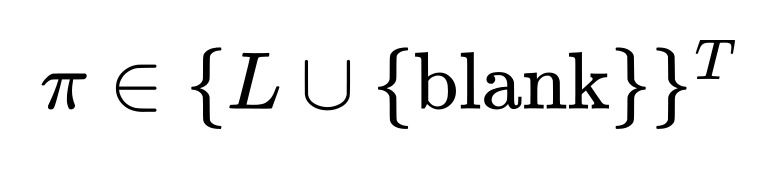 是一条长度
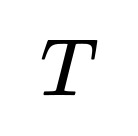 的路径,
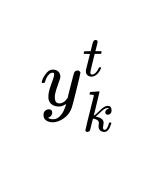 是 RNN 在第
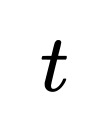 帧对 label
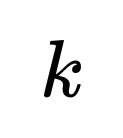 的输出概率。
Collapse 映射 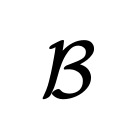 :就是上面表格里的两步压缩规则。
目标 label 序列的概率(边缘化对齐):
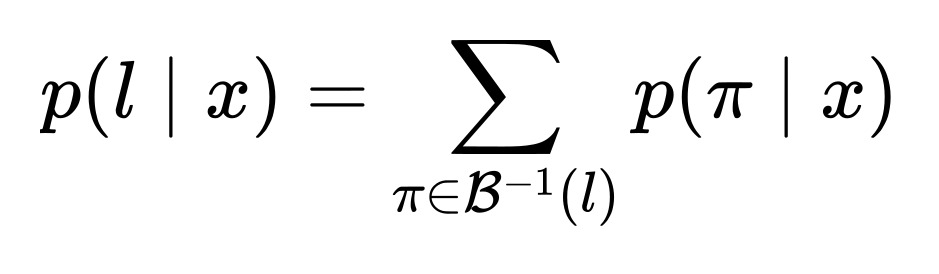
训练目标:最大化 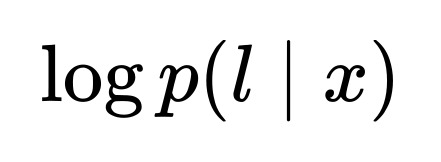 。后面的 forward-backward、梯度和解码,都是为高效计算这三个量服务。
四、求和爆炸怎么办:DP 在网格上跑
问题:暴力枚举所有长度 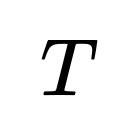 的扩展字母表路径是
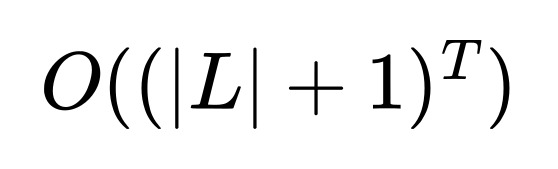 ;即使只看能 collapse 到目标的合法路径,数量也组合爆炸,不可枚举。
解法:动态规划。跟 HMM 的 forward-backward 一样------把"所有路径概率之和"分解成"到达每个中间状态的部分和",从左往右递推。
具体做法:先把目标 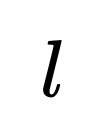 扩成
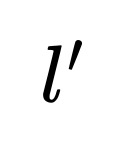 ------在首尾和每对 label 之间插一个 blank。比如
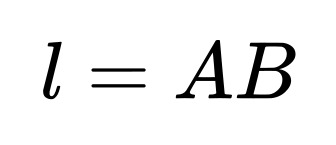 扩成
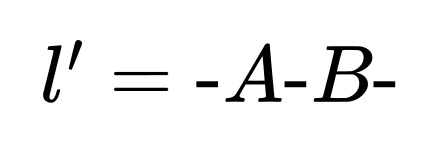 (长度
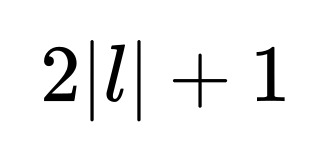 )。然后在一个"时间
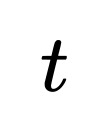 × 扩展序列位置
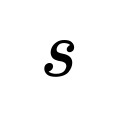 "的二维网格上跑递推。每格存
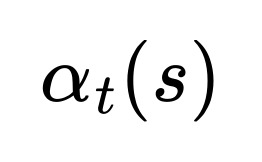 ------到第
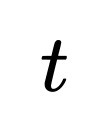 帧、已经走到扩展序列
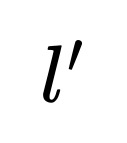 第
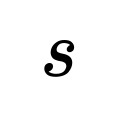 位的所有路径概率之和。
允许的转移 :从 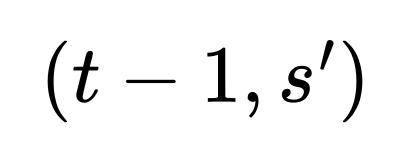 到
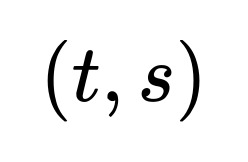 有三种候选:
- 停留 (
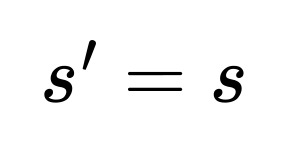 )
- 走一格 (
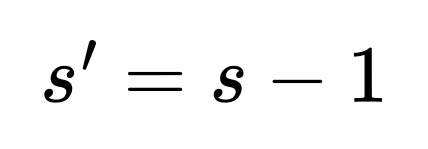 )
- 跳两格 (
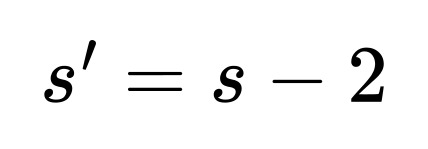 )------仅当
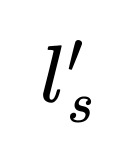 是非 blank 且
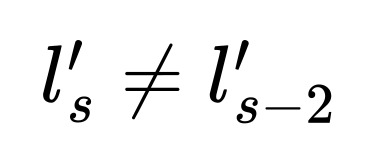 时允许
第三条的约束是关键:如果两格前是同一个真实 label,跳过中间的 blank 就会让 collapse 时被合并成一个。blank 在这里就是保证 collapse 后长度不缩水的守门员。
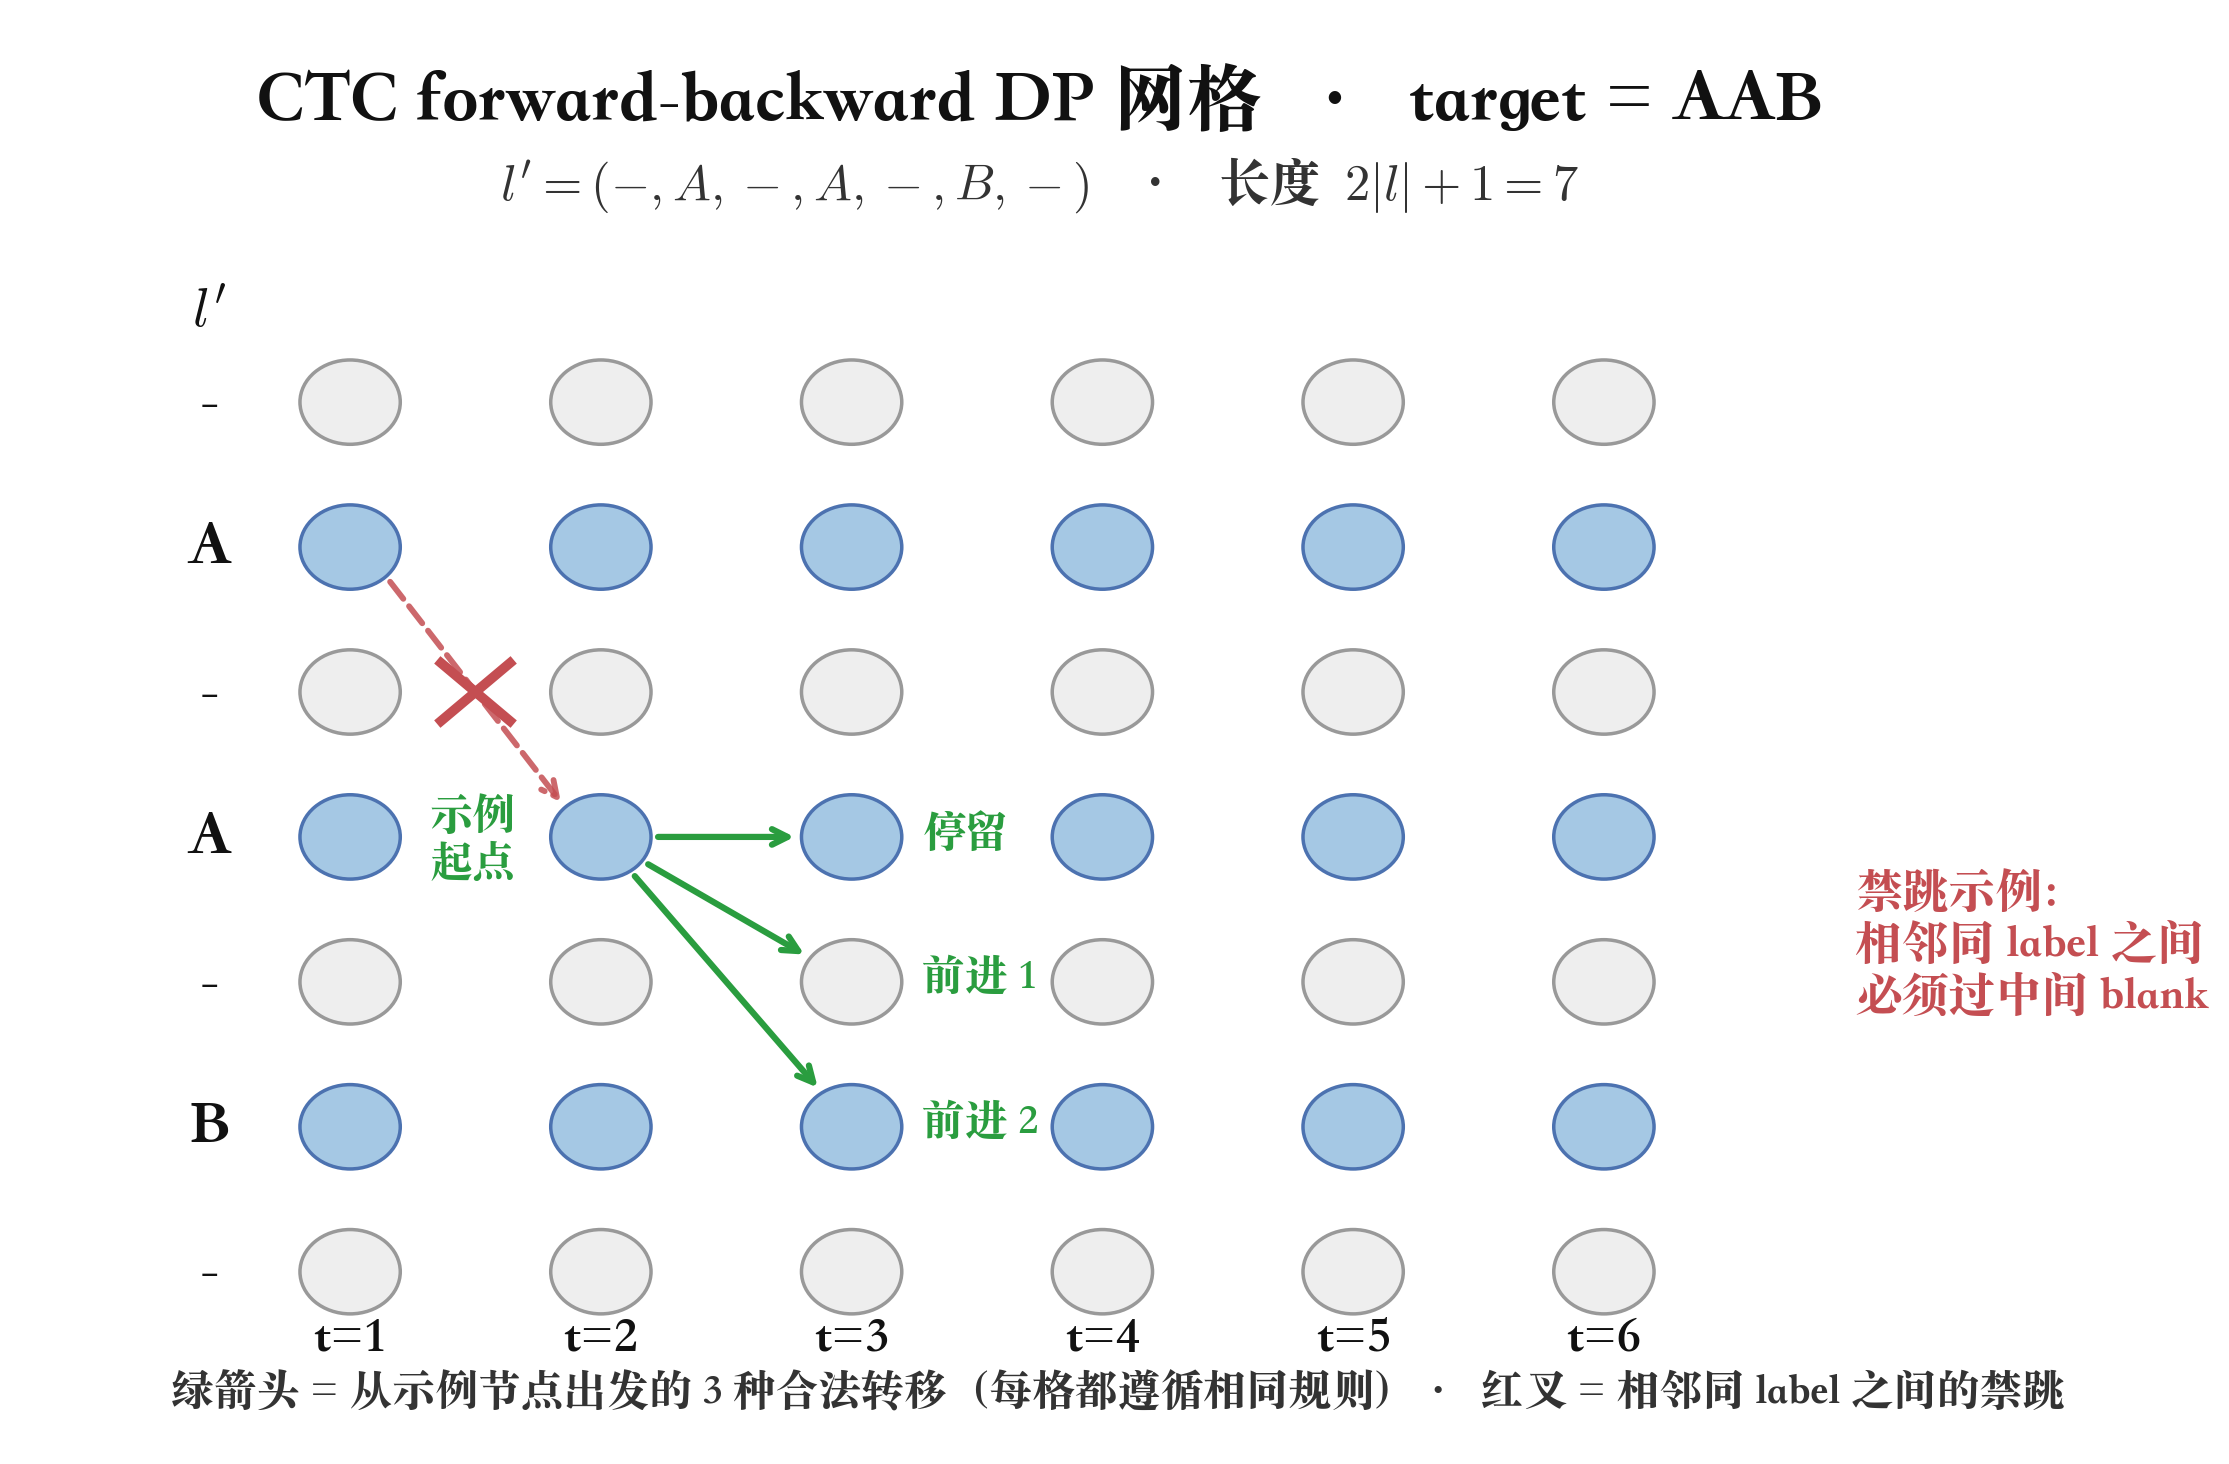
图 C 用 target = AAB 专门展示相邻重复 label 时的禁跳约束;原论文 Figure 3 的 CAT 例子里没有这种情形。
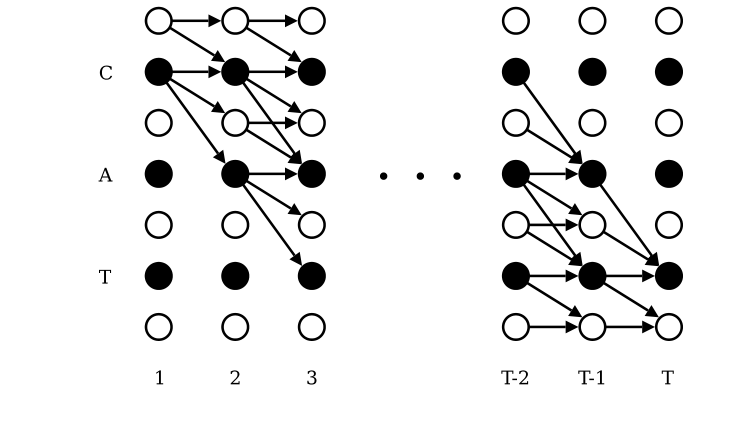
一句话概括 :DP 让"对所有路径求和"从 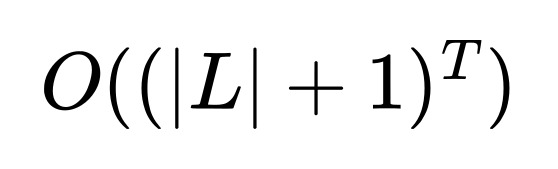 降到
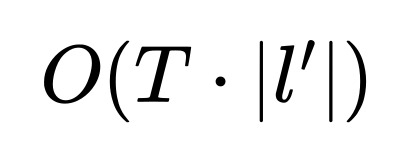 ,从纯数学变成可以在 GPU 上跑起来的东西。
完整的 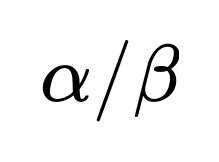 递推、rescaling 和梯度推导见原论文 §4.1-4.2;这里把 DP 理解成"精确路径求和的高效算法"就够。
五、解码:怎么把训好的模型的输出读成 label 序列
解码有两个思路。
Best path decoding (最简单):每一帧独立取 argmax,得到一条路径 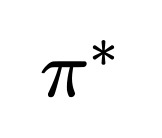 ,然后
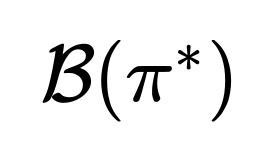 就是输出。
- 优点:一次前向就搞定,几乎没额外开销。
- 缺点:不保证得到最优 label 序列 ------最优 label 序列对应的可能是"多条路径概率的和"都很高,而不是任何单一路径概率最高。
为什么会不最优? 举个 3 帧、label 表 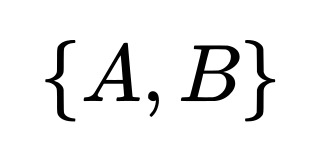 的玩具例子。假设某个 CTC 网络在这 3 帧的输出概率是:
| 帧 | P(-) | P(A) | P(B) |
|---|---|---|---|
| t=1 | 0.4 | 0.3 | 0.3 |
| t=2 | 0.4 | 0.3 | 0.3 |
| t=3 | 0.4 | 0.3 | 0.3 |
Best path 每帧都取 -(各 0.4),拼出 - - - → collapse 得到空串 (概率 0.064)。但 AB 的合法路径 AB-、A-B、-AB、ABB、AAB 每条概率 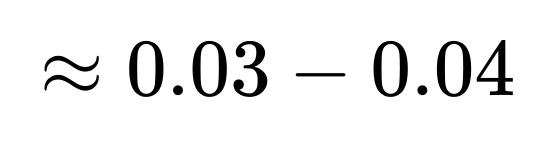 ,加起来大于 0.064 ------所以 best path 给出的空串不一定是最优。这个例子只说明 best path 可能漏掉由多条低概率路径累加出的高概率 label;全局最优要靠 prefix search 找。
Prefix search decoding(更严谨):借用 forward-backward 递推,按 label 序列 prefix 的概率一步步扩展搜索树。
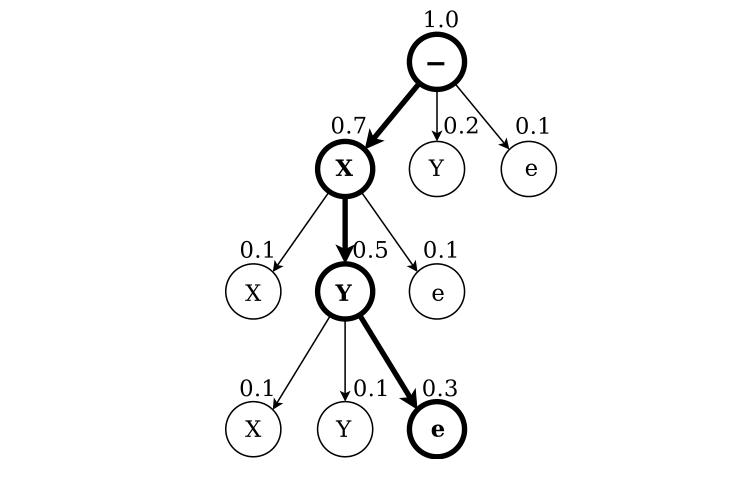
图 2 是一个玩具例子:label 表 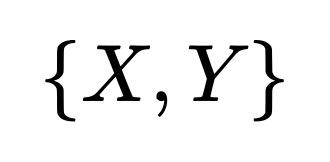 ,根节点是空 prefix
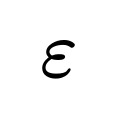 (不是 blank ------图里画成
-,这里 - 表示"空前缀"而非 blank token)。每个节点要么继续扩展一个 label(分支节点),要么终止(标 'e')。分支节点上方数字是 prefix 概率 ------以该 prefix 开头的所有 完整 label 序列的概率总和(因此是任一具体完成序列概率的上界);终止节点上方是终止概率 ------恰好停在此 prefix 的确切概率。停止条件:某完整答案的确切概率超过所有剩余 prefix 的上界。每次挑当前概率最高的活跃 prefix 扩展。
- 优点:理论上给足时间能找到最优 label 序列。
- 缺点:最坏复杂度指数------本文用了一个启发式(在 blank 概率 >99.99% 处切段、每段独立跑 prefix search)来控制搜索范围。
训好的 CTC 往往呈现 peaked 输出------多数帧概率质量集中在 blank,非 blank label 只在少数几帧形成尖锐窄峰。这意味着 best-path 和 prefix-search 在本文实验里差得不多(TIMIT 上 31.47 vs 30.51,不到 1 个点)。
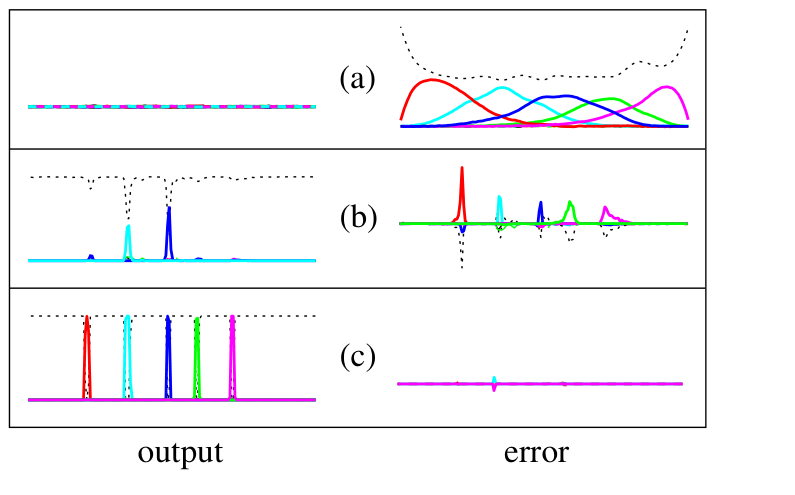
图 4 展示了 peaked 输出是怎么涌现出来的: - (a) 初期:概率接近 baseline,误差信号铺满时间轴 - (b) 中期:label 概率向少数帧集中,误差信号也聚焦到对应位置 - (c) 收敛:真实 label 集中在窄峰、其余强 blank,误差信号趋近于零
spike 是 CTC 训练动力学涌现出来的,不是显式对齐监督------用于近似对齐可以,不能当严格 forced alignment。副产物用途:解码简单、边界隐式对齐;本文的 BLSTM 天然能看未来帧,不是流式,现代流式 CTC 部署要配合因果或 chunk encoder + 延迟控制。
六、实验与批判性观察
任务:TIMIT 音素识别。61 个音素类,训练集 4620 utt / 测试集 1680 utt,指标是 LER(编辑距离归一化)。
特征:10ms 帧、5ms 滑窗;MFCC 12 维 + log-energy + 一阶差分,共 26 维。
关键 baseline 和结果:
| 系统 | LER |
|---|---|
| Context-independent HMM | 38.85% |
| Context-dependent HMM | 35.21% |
| BLSTM/HMM | 33.84 ± 0.06% |
| Weighted-error BLSTM/HMM | 31.57 ± 0.06% |
| CTC (best path) | 31.47 ± 0.21% |
| CTC (prefix search) | 30.51 ± 0.19% |
观察:
- 网络容量对齐:CTC 和 BLSTM/HMM hybrid 用了几乎相同规模的 BLSTM(114,662 vs 114,461 参数)。容量对齐较克制,但不是严格消融------训练目标、对齐机制、学习率和噪声水平都不同。
- HMM baseline 参数量大得多 (90 万+),但依然输给 11 万参数的 CTC------至少在这套 recipe 下,堆 HMM/GMM 参数并没有弥合训练目标和对齐机制带来的差距。
- Prefix search 加成很小(31.47 → 30.51,<1 点)------是"CTC 输出天然 peaked"的实验证据。但 TIMIT 是音素级、无 LM、小任务,不能外推到词/子词级工业 ASR;是否用 beam search / LM 取决于任务和延迟预算。
- 消融留白:几个我关心但论文没做的实验------(a) blank 单元的必要性(去掉 blank 后 collapse 会失效:无法区分相邻重复 label,且每帧被迫输出一个真实 label);(b) DP 求和 vs 蒙特卡洛路径采样的对比;(c) 只跑了 TIMIT,没在更大数据上验证 scale up 行为------最后这条被后续 10 年反复证明"CTC 确实能 scale",但 2006 年这篇没做。
七、局限与分析
Blank 是问题重构的胜利 ,不是数学工作------把"未知对齐"改写成 DP 可边缘化的隐变量。这套思路后来在 RNN-T / Transformer-Transducer 里被继续用。(注意别把 Whisper 的 timestamp token 也归到"blank 家族"------Whisper 是 encoder-decoder attention 架构、时间戳靠特殊 token 表达,机制不同源。)
帧间条件独立是明显的 tradeoff 。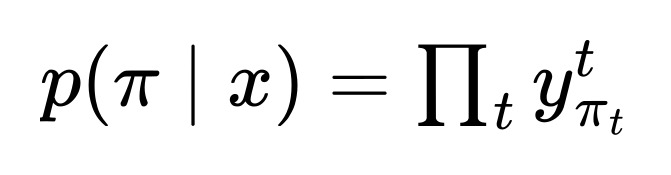 假设 label 给定 encoder 表征后条件独立------CTC 头不建模 label-to-label 语言依赖,全靠 encoder hidden state 隐式带上下文。encoder 强的时代(LSTM/Conformer 之后)问题不明显;encoder 弱或强语言先验场景就露馅。**RNN-T(Graves 2012)**站在这条 tradeoff 的另一侧------加了 prediction network 显式建模 label 历史,代价是解码格子从一维变二维、beam search 更贵、训练/实现都更重。CTC 与 RNN-T 像同一问题的两侧:一个轻,一个显式建模 label 历史但更贵。
spike 是 emergent,不是显式监督。CTC loss 里没有"输出要 peaked"或"对齐真实音素起点"的约束项,但训练完输出就是那样。后续实证发现窄峰位置跟真实音素起始有系统性但小幅度偏移------被下游任务反复利用(关键词检测、近似对齐、流式端点检测),但做严格 forced alignment 有精度天花板。
当代 ASR 里 CTC 是哪一支。今天端到端 ASR 大致有三个训练目标 / 解码接口,都在解决同一个"输入帧长 ≠ 输出 token 长"的问题:
| 家族 | 代表工作 | 对齐是否单调 | 是否显式建模 label 历史 | 典型解码 | 代价 |
|---|---|---|---|---|---|
| CTC 家 | wav2vec 2.0 微调头、Conformer-CTC | 单调(blank + collapse) | 否(帧间条件独立) | best-path / prefix beam | 语言依赖弱、需外挂 LM |
| Attention encoder-decoder 家 | Whisper、SpeechT5 | 非单调(软注意力) | 是(decoder 自回归) | beam search | 全序列注意力代价大,流式难 |
| Transducer 家 | RNN-T、Transformer-Transducer | 单调(blank + 显式两轴 DP) | 是(prediction network) | 2D beam search | 训练/解码都比 CTC 重 |
(另有一批非自回归模型如 Paraformer 把 CTC 用作辅助 loss------不属于纯 CTC 主路线,是混合训练策略。)
三个家族不能简单归为一脉血脉------是三种不同的技术路线选择。CTC 是三条路线里最简单、耐用、不过时的一条:loss 三行公式说完、DP 网格一张图讲透、代码 30 行能跑通------这在深度学习史上很罕见。