摘要
微博作为中国最具影响力的社交媒体平台之一,其热搜榜单不仅是公众关注焦点的集中体现,更是社会舆情、文化趋势与公共议题的重要风向标。然而,目前针对微博热搜的分析工具多侧重于简单的榜单罗列,缺乏对话题内容的多维度、深层次、交互式分析能力。为解决此问题,本文设计并实现了一套基于Python的微博热搜话题可视化分析系统。系统采用Python作为后端开发语言,Flask框架构建RESTful API,前端使用Vue.js结合ECharts实现数据的可视化展示,数据存储选用MySQL。系统构建了从数据采集、清洗、分析到可视化呈现的完整流程,核心功能包括热搜榜单的动态展示与历史查询、话题详情分析、基于情感词典的文本情感分类、基于TF-IDF的关键词提取以及多维度可视化图表的交互式展示。测试结果表明,系统运行稳定、界面友好,能够为用户提供一个直观、高效的热点话题分析平台,有效辅助媒体工作者、舆情分析师等用户理解热点事件,具有一定的实用价值。
关键词 : 微博热搜;Flask框架;数据可视化;情感分析;文本挖掘
目录
[1 引 言](#1 引言)
[1.1 课题研究背景](#1.1 课题研究背景)
[1.2 课题研究现状](#1.2 课题研究现状)
[1.3 课题研究内容](#1.3 课题研究内容)
[2 系统分析](#2 系统分析)
[2.1 可行性分析](#2.1 可行性分析)
[2.2 需求分析](#2.2 需求分析)
[2.3 相关技术简介](#2.3 相关技术简介)
[3 系统设计](#3 系统设计)
[3.1 系统架构设计](#3.1 系统架构设计)
[3.2 总体功能设计](#3.2 总体功能设计)
[3.3 数据流图](#3.3 数据流图)
[3.4 数据库设计](#3.4 数据库设计)
[4 系统实现](#4 系统实现)
[4.1 登录注册模块实现](#4.1 登录注册模块实现)
[4.2 数据采集模块实现](#4.2 数据采集模块实现)
[4.2 文本处理模块实现](#4.2 文本处理模块实现)
[4.3 情感分析模块实现](#4.3 情感分析模块实现)
[4.4 可视化模块实现](#4.4 可视化模块实现)
[4.5 系统管理模块实现](#4.5 系统管理模块实现)
[4.6 后端服务模块实现](#4.6 后端服务模块实现)
[5 系统测试](#5 系统测试)
[5.1 测试目的](#5.1 测试目的)
[5.2 功能测试](#5.2 功能测试)
[5.3 测试结果](#5.3 测试结果)
[6 总结与展望](#6 总结与展望)
[6.1 总结](#6.1 总结)
[6.2 展望](#6.2 展望)
引 言
1.1 课题 研究背景
在信息爆炸的互联网时代,社交媒体已成为信息传播和舆论生成的主阵地。微博作为中国最具代表性的社交媒体平台之一,其热搜榜单不仅是用户关注热点的重要风向标,更是社会舆情、公共议题、文化现象乃至商业趋势的实时晴雨表。热搜话题往往反映出公众在特定时间段内的集体注意力分配、情感倾向与价值判断,具有极高的社会分析价值与数据挖掘潜力。
有相关学者指出,热搜话题在信息扩散、公众议程设置与社会动员等方面发挥着重要作用。热搜不仅是信息的简单聚合,更是公众注意力与媒体议程互动的产物,具有一定的新闻建构功能。然而,目前针对微博热搜的分析工具多侧重于简单的榜单罗列与基础的热度趋势展示,缺乏对话题内容本身的多维度、深层次、交互式分析能力。用户(如媒体工作者、舆情分析师、市场研究人员)难以对一个热点话题进行系统性、结构化的探查,例如了解话题下的公众情感分布、核心讨论焦点是什么,以及话题热度是如何随时间演变的。因此,开发一个能够对微博热搜话题进行自动化采集、处理、分析和可视化展示的系统,具有重要的现实意义。
需求分析
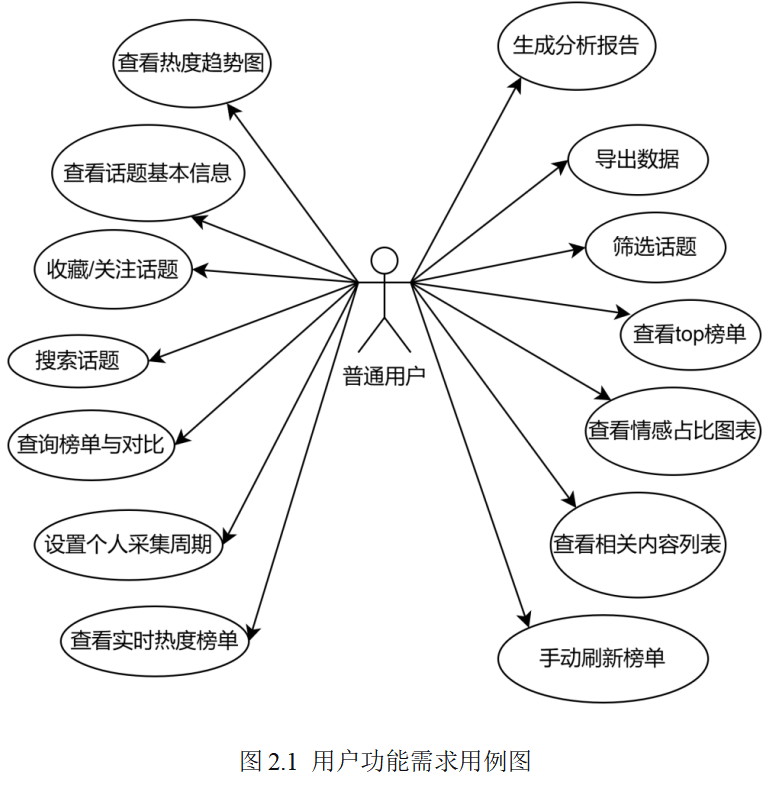
本系统的潜在用户主要包括媒体工作者、舆情分析师、市场研究人员以及对社交媒体动态感兴趣的一般公众。根据任务书中的功能要求,系统需满足以下用户需求:
2.2.1 用户端功能需求
- 热搜榜单功能:
实时展示微博热搜榜单前50条话题,包含排名、热度值、变化趋势。
支持手动点击按钮触发实时数据采集并刷新榜单。
支持自定义采集周期,并在后台配置定时更新。
支持按日期查询历史热搜榜单,支持对比分析。
支持按排名/热度/时间筛选热搜。
支持输入关键词搜索历史或实时热搜话题。
支持用户收藏或关注特定话题,便于后续追踪分析。
- 话题详情功能:
展示话题基本信息:名称、当前排名、实时热度、采集时间、持续时长等。
以折线图展示话题在选定时间段内的热度变化趋势。
展示该话题下的相关微博或评论内容列表,支持分页加载。
支持对相关内容按时间、互动量(评论/转发/点赞)排序。
支持根据关键词筛选相关内容。
对每条内容标注情感倾向(正面/中性/负面)。
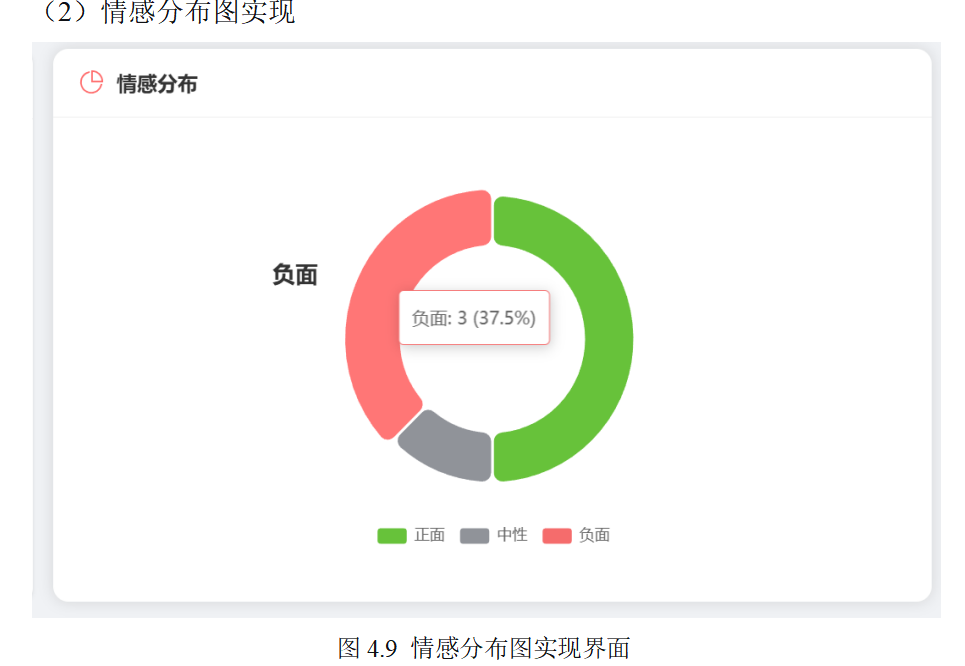
统计该话题下各类情感占比,并可视化展示。
展示从相关内容中提取的高频关键词(TopN)及词云图。
展示互动量最高的内容Top榜。
- 检索筛选与导出功能:
支持按话题名模糊搜索。
支持按时间范围筛选数据。
支持按热度阈值/排名区间筛选话题。
支持将热搜数据、文本内容、情感分析结果等导出为CSV或Excel文件。
支持一键生成包含图表与统计数据的分析报告。
管理员端功能需求
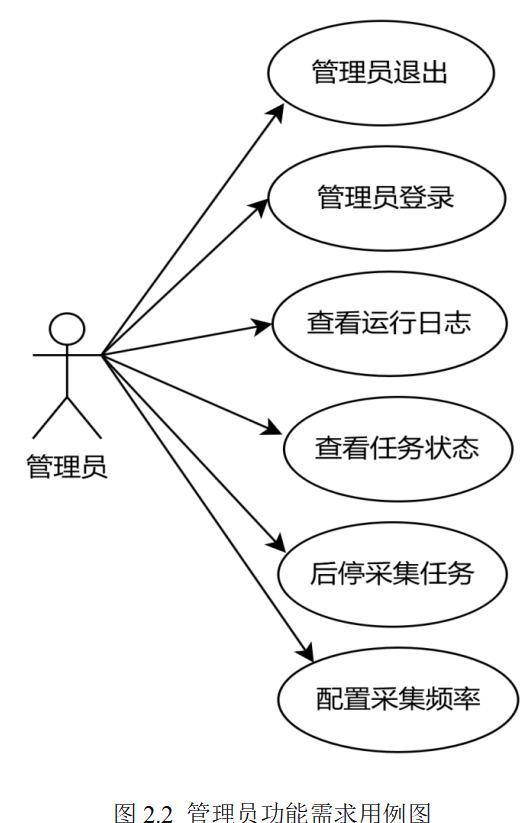
- 数据采集管理:
采集频率配置:允许管理员设置热搜榜单的定时采集周期。
采集任务启停:支持手动启动或停止后台的定时采集任务。
任务运行状态查看:实时显示当前采集任务的状态及上次采集时间。
运行日志查看:提供系统运行日志查询界面,便于排查问题。
- 系统管理:
实现管理员登录与退出功能,确保后台操作的安全性。
总体功能设计
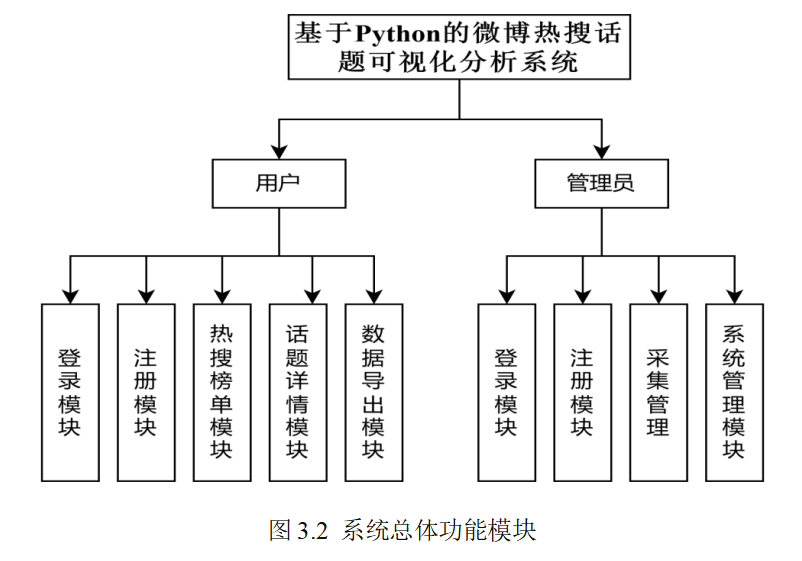
根据需求分析,系统总体功能模块划分如图3.2所示。系统主要分为两大端:用户端和管理员端。
用户端功能模块:
热搜榜单模块:实时榜单、历史榜单、榜单筛选、话题搜索、话题收藏。
话题详情模块:基本信息、热度趋势图、相关内容列表(支持排序、情感标注)、情感分布图、关键词Top榜/词云、高互动内容榜。
数据导出模块:数据导出CSV/Excel、分析报告生成。
管理员端功能模块:
采集管理模块:采集频率配置、任务启停、状态监控。
系统管理模块:管理员登录、日志查看。
数据库设计
根据系统功能,系统核心实体包括:用户(User)、热搜话题(HotTopic)、微博内容(WeiboContent)、收藏关注(Favorite)。它们之间的关系为:
一个用户可以收藏多个热搜话题,一个热搜话题可以被多个用户收藏,这是一个多对多的关系,通过中间实体"收藏关注"来实现。
一个热搜话题下可以关联多条微博内容,这是一个一对多的关系。
根据E-R图及系统功能,设计主要数据表如下:
- 热搜榜单表(hot_searches)
热搜榜单表用于存储每次采集的微博实时热搜榜单数据。
表3.1 热搜榜单表(hot_searches)
|-------------|-------------|-----------------|
| 字段名 | 类型 | 说明 |
| id | Integer | 主键 |
| rank | Integer | 排名 |
| title | String(500) | 热搜标题 |
| hot_value | Integer | 热度值 |
| trend | String(20) | 趋势(up/down/new) |
| crawl_time | DateTime | 采集时间 |
| is_archived | Boolean | 是否归档 |
| created_at | DateTime | 创建时间 |
- 话题内容表(topic_contents)
话题内容表用于存储与特定热搜话题相关的微博正文及用户信息,是后续文本分析与情感计算的核心数据来源。
表3.2 话题内容表(topic_contents)
|---------------|-------------|---------|
| 字段名 | 类型 | 说明 |
| id | Integer | 主键 |
| hot_search_id | Integer | 外键,关联热搜 |
| content | Text | 微博正文 |
| author | String(100) | 作者 |
| gender | String(10) | 性别 |
| location | String(50) | 地区 |
| fans_count | Integer | 粉丝数 |
| follow_count | Integer | 关注数 |
- 普通用户表(users)
普通用户表用于存储使用本系统的普通用户(即访客)的基本信息与账户状态。
表3.3 普通用户表(users)
|---------------|-------------|----------------|
| 字段名 | 类型 | 说明 |
| id | Integer | 主键 |
| username | String(50) | 用户名(唯一) |
| email | String(100) | 邮箱(唯一) |
| password_hash | String(255) | 密码哈希 |
| nickname | String(50) | 昵称 |
| avatar | String(255) | 头像 |
| role | String(20) | 角色(user/admin) |
| status | Integer | 状态(1正常/0禁用) |
- 管理员表(admins)
管理员表独立存储后台管理员的账户信息,与普通用户表分离以强化安全隔离。
表3.4 管理员表(admins)
|---------------|-------------|---------|
| 字段名 | 类型 | 说明 |
| id | Integer | 主键 |
| username | String(50) | 用户名(唯一) |
| password_hash | String(255) | 密码哈希 |
| role | String(20) | 角色 |
| created_at | DateTime | 创建时间 |
- 采集任务表(crawl_tasks)
采集任务表用于配置和管理数据采集任务的各项参数。
表3.5 采集任务表(crawl_tasks)
|------------|-------------|-------|
| 字段名 | 类型 | 说明 |
| id | Integer | 主键 |
| task_name | String(100) | 任务名称 |
| task_type | String(20) | 任务类型 |
| keywords | Text | 关键词 |
| max_count | Integer | 最大采集数 |
| is_active | Boolean | 是否启用 |
| created_at | DateTime | 创建时间 |
- 话题收藏表(topic_favorites)
话题收藏表记录用户对热搜话题的收藏行为,用于实现"我的收藏"功能。
表3.6 话题收藏表(topic_favorites)
|---------------|----------|---------|
| 字段名 | 类型 | 说明 |
| id | Integer | 主键 |
| hot_search_id | Integer | 外键,关联热搜 |
| created_at | DateTime | 收藏时间 |
- 系统日志表(system_logs)
系统日志表用于记录系统运行过程中的关键事件和错误信息,便于运维监控和问题排查。
表3.7 系统日志表(system_logs)
|------------|------------|------|
| 字段名 | 类型 | 说明 |
| id | Integer | 主键 |
| level | String(20) | 日志级别 |
| message | Text | 日志内容 |
| module | String(50) | 模块 |
| created_at | DateTime | 创建时间 |
系统实现
4.1 登录注册 模块实现
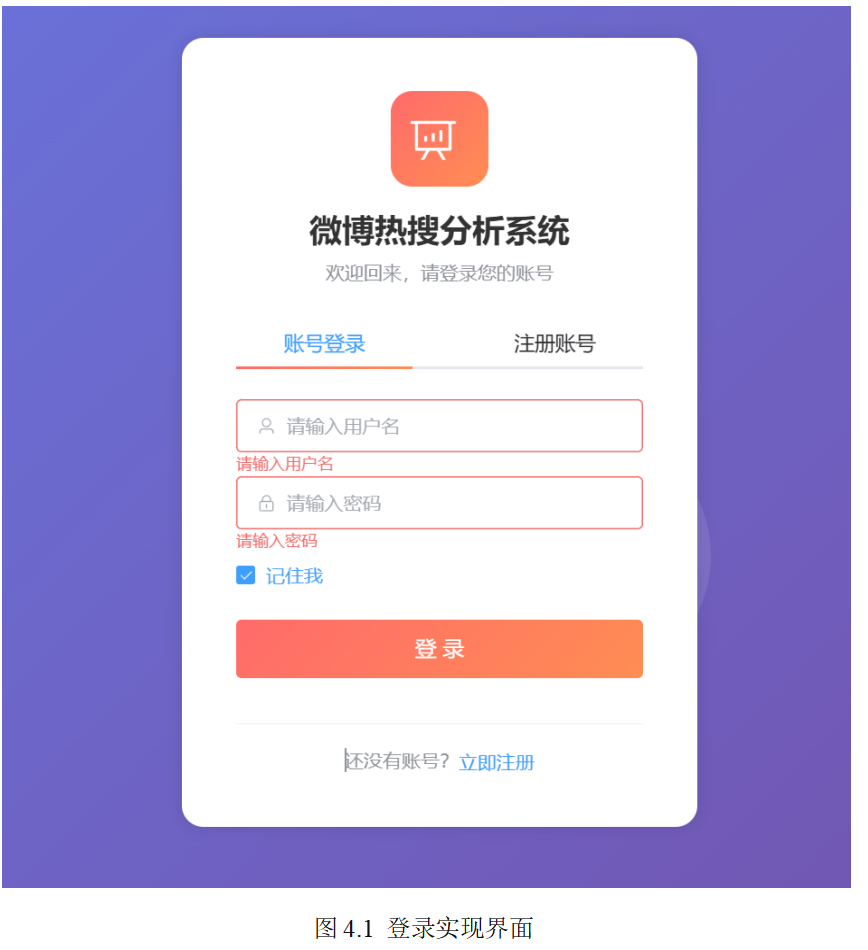
登录注册模块是系统的入口,负责用户身份的认证与管理。前端使用Vue.js构建表单,通过Axios发送请求至后端Flask API;后端使用Flask处理请求,采用JWT(JSON Web Token)进行无状态身份验证,密码经哈希加密后存储于MySQL数据库。
- 登录实现
用户输入用户名和密码,前端提交至后端/api/login接口。后端验证用户名是否存在及密码是否正确,验证通过后生成JWT令牌返回给前端。前端将令牌存储在localStorage中,并在后续请求的Authorization头中携带。
4. 2 数据采集模块实现
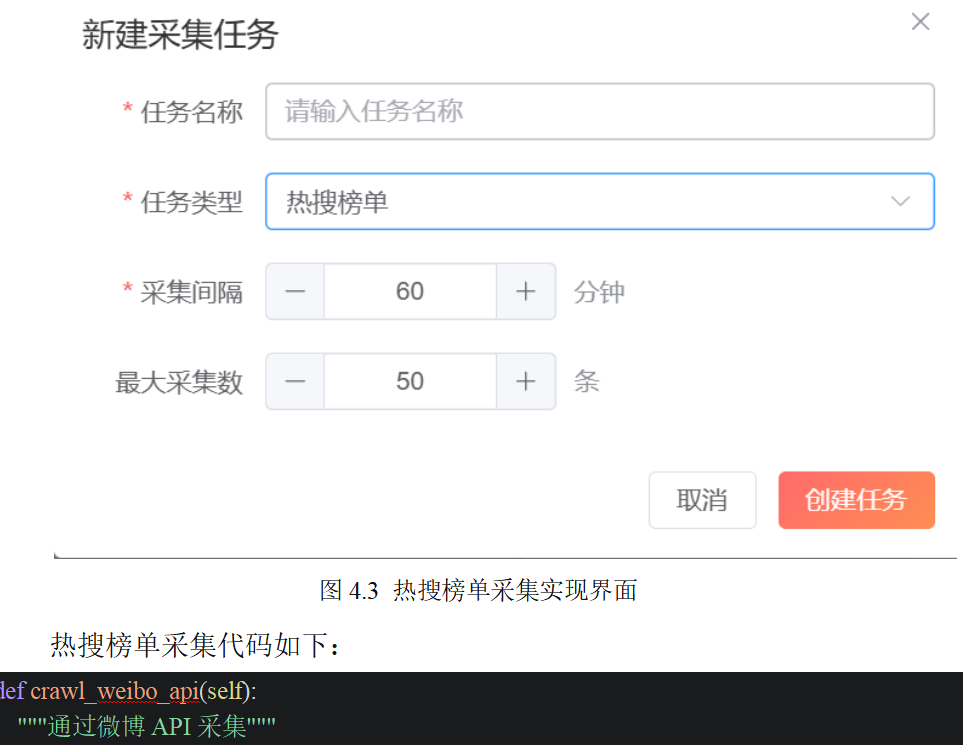
数据采集模块负责从微博平台获取实时热搜榜单及指定话题下的微博内容。该模块采用定时任务与按需触发相结合的方式,使用requests库模拟HTTP请求,解析JSON或HTML数据后存入MySQL。
(1)热搜榜单采集实现
通过分析微博热搜页面的网络请求,发现热搜数据通过API接口以JSON格式返回。系统直接请求该接口,解析JSON数据后批量存入数据库。
4.2 文本处理模块实现
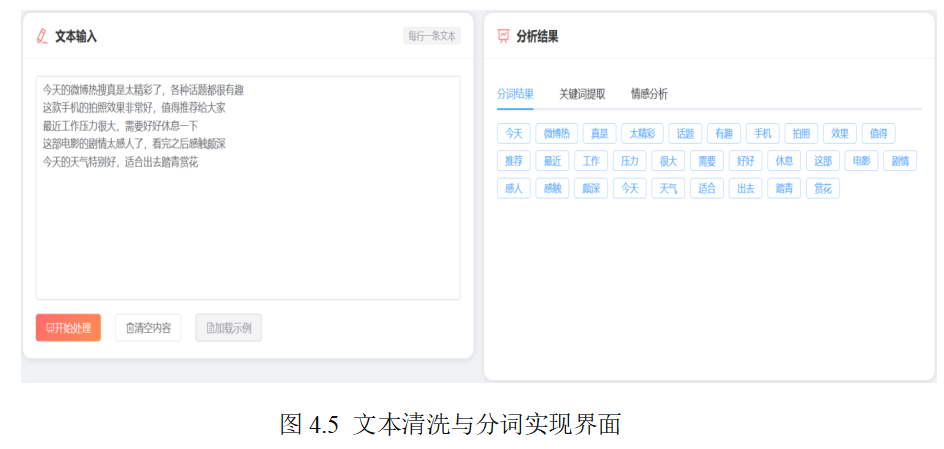
文本处理模块为微博热搜分析系统提供了完整的NLP处理能力。通过文本清洗、分词、停用词过滤、关键词提取等功能链,将原始微博文本转化为结构化的文本特征,为后续的可视化分析和数据挖掘奠定了坚实基础。
(1)文本清洗与分词
原始微博文本包含大量噪声信息(URL链接、@用户名、表情符号等),需要通过正则表达式进行清洗,然后使用jieba进行中文分词处理。
4.3 情感分析模块实现
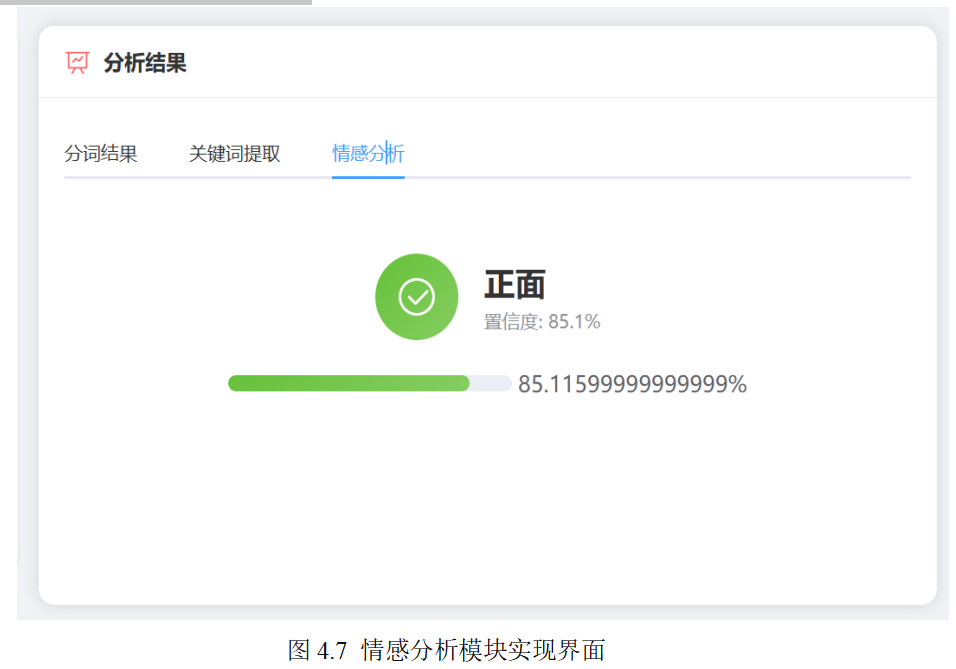
情感分析模块负责对微博文本进行情感倾向判断。系统采用基于情感词典的方法,结合自定义微博情感词典,对分词后的文本进行情感得分计算,将结果分为正面、负面、中性三类。
4.4 可视化模块实现
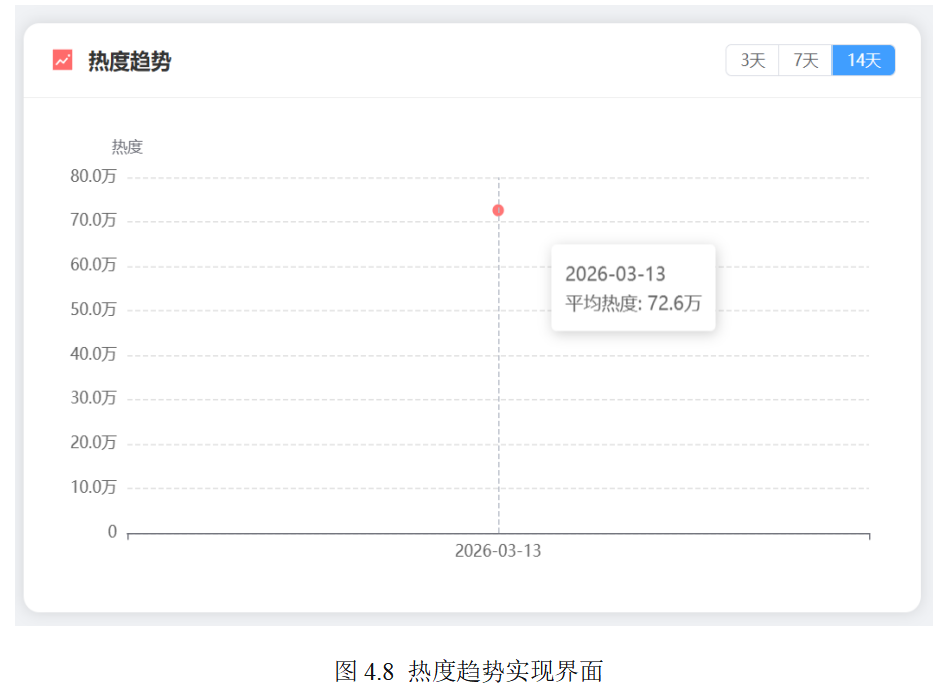
可视化模块基于ECharts库,将后端分析结果以图表形式直观展示给用户。前端通过Axios获取数据后,动态渲染图表。
(1)热度趋势图实现
总结与展望
6 .1 总结
本文设计并实现了一套基于Python的微博热搜话题可视化分析系统。系统围绕"数据采集---文本处理---情感分析---可视化展示---系统管理"这一核心流程,构建了一个功能全面的热点话题分析平台。系统采用Flask+Vue.js的前后端分离架构,MySQL作为数据库,确保了系统的可维护性和扩展性。
本系统的主要成果如下:
实现了完整的数据处理链路:从自动化数据采集、清洗存储,到文本的深度分析(情感分类、关键词提取),最终通过可视化界面呈现给用户,形成了完整的数据价值链。
提供了多维度分析视角:系统不仅展示榜单,更对一个话题的热度趋势、情感倾向和核心语义进行了多维度分析,帮助用户全面、深入地理解热点事件。
构建了交互友好的可视化界面:利用ECharts实现了多种图表的动态展示与联动,为用户提供了直观、高效的数据探查体验。
验证了技术的可行性:系统成功整合了数据采集、文本挖掘、Web开发等多种技术,证明了利用Python技术栈构建此类分析工具的可行性。
通过本次毕业设计的完整实践,我不仅加深了对Python数据分析生态和前后端分离架构的理解,也显著提升了独立解决复杂问题和系统设计的能力。
6 .2 展望
尽管系统已基本实现预期功能,但仍有不少可以改进和深化的方向:
情感分析模型的优化:当前基于情感词典的方法较为基础,对复杂语境(如讽刺、反语)的识别能力有限。未来可以考虑引入基于深度学习的情感分析模型(如LSTM、BERT),以提升分析的准确性。
实时性与数据源的扩展:可引入消息队列(如Kafka)来处理高并发的数据流,实现近实时的数据分析。同时,可以将数据源扩展到其他平台(如抖音、知乎),进行跨平台的舆情对比分析。
预测功能的引入:在积累了足够多的历史数据后,可以利用时间序列预测模型(如ARIMA、Prophet)对话题的热度走势进行预测,为用户提供更具前瞻性的决策支持。
个性化推荐:根据用户的收藏和浏览历史,为其推荐可能感兴趣的热点话题或分析报告,提升用户体验。