过去三年,针对任何企业 AI 场景下的问题,默认的工程响应都是自动化的:"只需构建一个 RAG 管道即可。"
你搭建一个向量数据库,将公司的 PDF 文件分块,生成向量嵌入,并在运行时运行语义相似性搜索。对于模糊的探索性搜索来说,它的效果已经足够好了。
但随着我们迈入 2026 年,RAG 模式的弊端已变得不容忽视。分块会破坏复杂的表格结构,向量检索本质上是概率性的(你可能得到正确的数据块,也可能得到过时的数据块),而保持嵌入向量与快速更新的数据同步则是一项极其繁琐的操作。
为了解决这个问题,谷歌云通过开源 开放知识格式(OKF v0.1) 平息了"杂乱无章"的争论。它不是新的云数据库、LLM 框架或 SDK,而是一个厂商中立、可移植的规范,正式定义了 "LLM Wiki" 范式------这正是像 Andrej Karpathy 这样的 AI 研究人员长期以来所倡导的结构化、互联的"大脑"概念。
OKF 将我们的策略从对非结构化文件进行概率搜索,转变为对鲜活的、人类和智能体可读的知识图谱进行确定性导航。
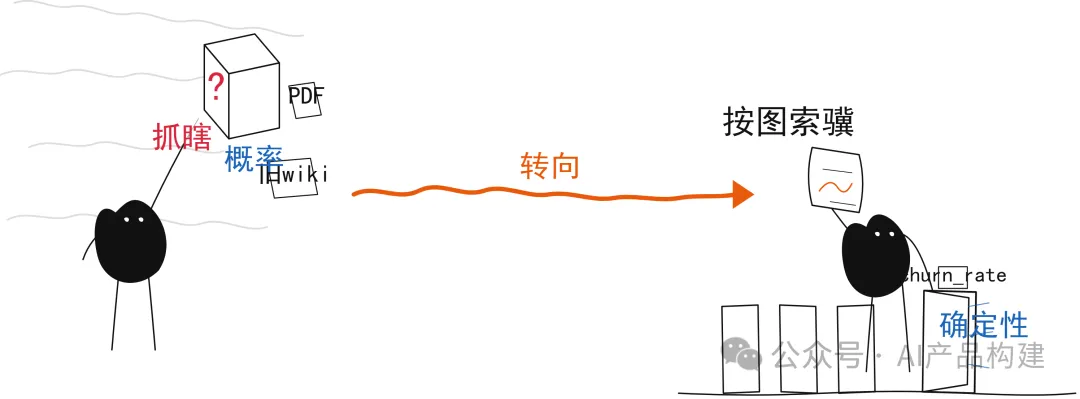
开放知识格式(OKF)究竟是什么?
OKF 规范了组织知识、业务逻辑和后端模式的结构,以便任何 AI 代理都可以原生地遍历和理解它们,而无需自定义翻译层。
OKF 集合(称为 知识包)并非昂贵的黑盒数据库,而是一个标准的纯文本 Markdown 文件目录,并用 YAML 前置元数据包裹。
OKF 包的解剖结构
在 OKF 包中,目录路径定义了概念的唯一标识。信息不是直接转储到索引中,而是被编译成高度聚焦的、单一的"概念"(例如,内部 API 合约、财务指标或数据库模式)。
text
company_brain/
├── index.md                    # 渐进式披露的根目录
├── engineering/
│   ├── index.md
│   └── service_mesh.md         # 架构概念
└── analytics/
    ├── index.md
    ├── tables/
    │   ├── customers.md        # 单个数据库概念文件
    │   └── billing.md
    └── metrics/
        └── active_users.md     # 精确的业务定义
每个概念文件都遵循严格但极简的设计:顶部是一个 YAML frontmatter 块(只需要一个字段:type),后面跟着自由格式的 Markdown 正文。
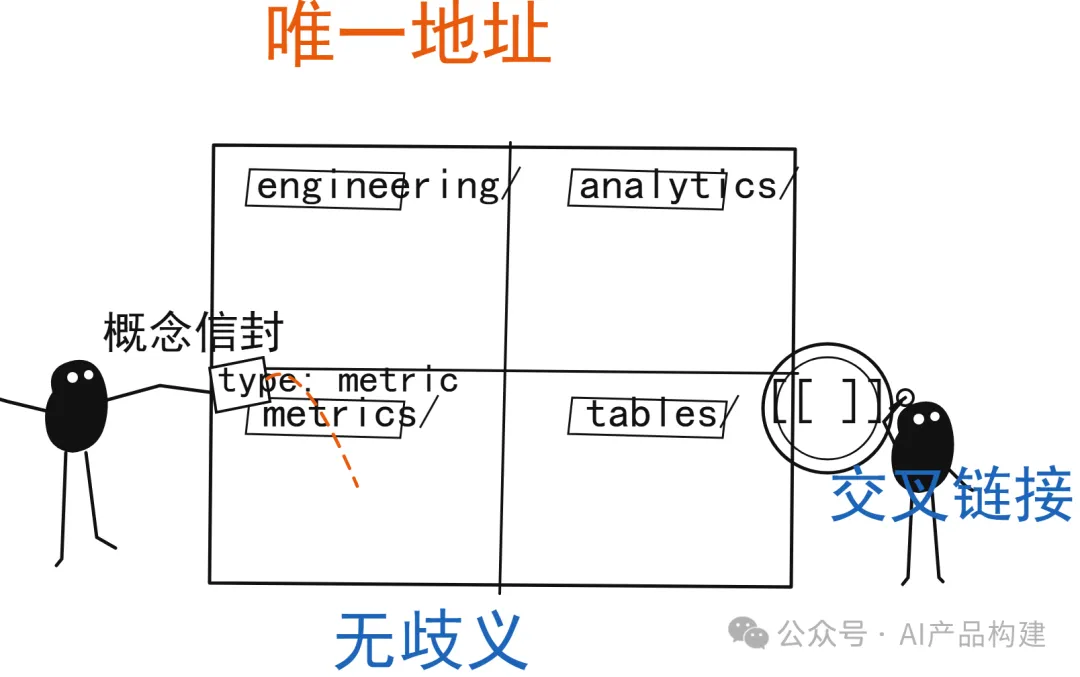
以下是一个描述关键业务指标的真实 OKF 文件示例:
rb
---
type: metric
id: analytics/metrics/active_users
title: Weekly Active Users (WAU)
owner: data-eng@company.com
updated_at: 2026-06-15
citations:
  - source: "https://github.com/internal-org/dbt/models/wau.sql"
---

# 周活跃用户数 (WAU)
在滚动 7 天窗口期内,至少触发过一次核心后端 API 事务的用户 ID 总数。

## 计算规则
我们明确排除内部 QA 和测试账户:
`WHERE user_id NOT IN (SELECT user_id FROM staging.internal_testers)`

## 相关组件
- 有关主要用户维度映射,请参阅 [[analytics/tables/customers]]。
- 有关使用情况与有效订阅周期的关联,请参阅 [[analytics/tables/billing]]。
OKF 的三大核心支柱
OKF 之所以能在传统企业维基和 RAG 系统失败之处取得成功,是因为它遵循了三条架构原则:
- 格式优先于平台: OKF 无需云账户、大型软件或定制 SDK,完全基于 Git 原生支持。你可以对其进行版本控制,通过拉取请求进行审计,并准确跟踪公司知识库随时间推移的变化。
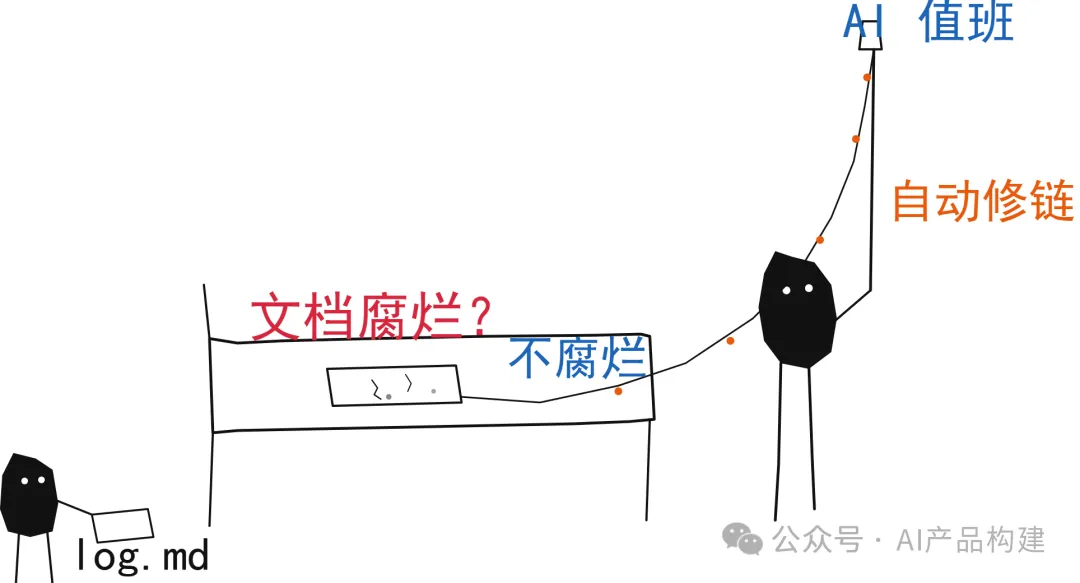
- LLM 作为 Wiki 图书管理员: 人类历来不擅长维护文档,文档很快就会腐烂。在 OKF 范式中,后台 AI 代理充当维护引擎。当开发人员更新代码或数据库模式时,代理会自动修改相关的 OKF Markdown 文件,修复交叉链接,并将更新记录到捆绑包的
log.md中。 - 通过图链接实现严格确定性: OKF 不使用余弦相似度来猜测哪些数据与查询相关,而是使用显式的 Markdown 链接
[[concept_path]]。这使得一个普通的文件目录可以转化为一个绝对、确定性的 知识图谱 ,AI 代理可以按逻辑顺序遍历该图谱。
真实场景:RAG 对阵 OKF
下面看看这会如何改变企业内部 AI 数据分析师的日常工作流程。
目标
你问你的 AI 代理:"编写一个 SQL 查询,计算我们第二季度的客户流失率。"
传统 RAG 之路
- 该代理会将你的查询转换为向量嵌入。
- 它搜索包含数千个分块 PDF、Confluence 页面和历史 Slack 日志的矢量数据库。
- 数据库返回三个部分:2023 年的 PowerPoint 演示文稿、旧的工程维基,以及两位数据工程师之间关于如何计算客户流失率的争论对话。
- LLM 将这些相互矛盾的定义结合起来,结果弄得一头雾水,写出了一个错误的 SQL 查询,从错误的模式中提取数据。
OKF 之道
- 代理读取公司 OKF 包根目录的
index.md。 - 它直接跳转到
analytics/metrics/churn_rate.md。 - 它提取经过审核的权威 SQL 代码片段和业务逻辑。
- 它跟踪文件内部明确的 Markdown 链接
[[analytics/tables/customers]],立即查到当前的模式定义和连接键。 - 该代理第一次尝试就生成了完全准确的查询,引用了确切的文件、更新时间和拥有该文件的工程师。
正面交锋:RAG 对阵 OKF
| 特征 | RAG | OKF |
|---|---|---|
| 核心结构 | 分段、碎片化的向量块 | 结构化 Markdown + YAML 前置元数据 |
| 检索引擎 | 概率性(数学最近邻) | 确定性(显式图链接遍历) |
| 人机交互 | 低(需要查询工程数据库) | 高(可在 GitHub 或 Obsidian 中原生读取) |
| 维护 | 高成本(重新索引、嵌入漂移) | 低成本(Git 提交和拉取请求) |
| 最佳用例 | 海量、非结构化、原始数据存档 | 高风险、规范的业务定义和规则 |
现代人工智能技术栈:一种混合架构
RAG 系统并没有完全消失,而是其作用发生了变化。让一个概率系统来查找公司的法定税务识别号或"收入"的定义,从根本上来说是一个糟糕的设计选择。OKF 则取代了 RAG,用于处理这些不容有失的企业核心定义与规则。
各团队正在构建一种混合架构,由 AI 路由器充当流量控制器:
text
[ 用户请求 ]
      │
      ▼
┌──────────────┐
│  AI 路由器   │
└──────┬───────┘
       │
┌──────┴────────┐
▼               ▼
[ OKF 包 ]      [ RAG 管道 ]
(核心规则、模式、(已存档 PDF、
运行手册、精度)  客户工单、规模探索)
通过 OKF 实现确定性精度,通过 RAG 搜索广泛的历史数据,企业正在构建功能强大且高度稳定的 AI 系统。OKF 并没有取代检索过程,它只是为 AI 代理提供了一张标准化的检索地图,帮助它们找到所需信息。
End