一、调整学习率
1.1学习率是什么
在神经网络训练中,参数更新最基本的形式是梯度下降。学习率决定了每次参数更新时,沿着梯度反方向走多大一步。
学习率太大:参数更新步子大;损失可能来回震荡;严重时直接发散,模型无法稳定收敛。
学习率太小:每次只移动一点点;训练非常慢;容易卡在局部极小值;训练轮数需要非常多;可能长时间无法达到好的效果。
所有学习率不能太大,也不能太小
1.2为什么需要"调整"学习率
固定学习率通常不是最优的。
训练初期:学习率大一点,快速靠近较优区域。
训练中期:学习率适中,稳定下降。
训练后期:学习率小一点,精细调整,逼近最优解。
1.3常见学习率调整策略
1.StepLR
每隔固定的epoch,把学习率乘以一个系数。
例如:scheduler = StepLR(optimizer, step_size=5, gamma=0.5)
每5个epoch,学习率乘以0.5
特点:
简单;
不依赖验证指标;
适合迁移学习微调;
但不够自适应。
2.ReduceLROnPlateau
这个调度器不按固定轮数调整,而是:监控某个指标,如果指标一段时间内不再改善,就降低学习率。
例如:
scheduler = ReduceLROnPlateau(
optimizer,
mode='min',
factor=0.1,
patience=10,
threshold=0.0001,
threshold_mode='rel',
cooldown=0,
min_lr=0,
eps=1e-8
)
**mode='min'**表示监控指标越小越好。
factor=0.1表示每次学习率降低,学习率变成原来的十分之一。
patience=10表示容最多容忍连续10个 epoch 没有进步。如果第11个 epoch 还是没进步,就降低学习率。
threshold_model='rel'表示相对阈值;threshold=0.0001,这两个参数表示什么才算改善了。
假设最好的验证损失是:best=1.0000
相对阈值是0.0001,那么只有新损失小于:1.0000*(1-0.0001)=0.9999才算明显改善。
如果新损失是 0.99995,虽然变小了,但幅度太小,不算改善。
cooldown=0表示降低学习率后,是否要等待几个epoch再重新开始计数。等于0表示降低学习率后,不额外等待,立即重新观察。
min_lr=0表示学习率下限。即使一直不改善,学习率也不会低于0。实际中一般可以设一个很小的正数,避免学习率变成0后完全不再更新。
eps=1e-8表示一个极小值,防止除零等数值问题。
优点:
自适应;
不需要手动设定在哪些epoch降学习率;
验证损失停滞时自动降低;
适合从零训练的自定义CNN。
二、核心代码讲解
2.1导入模块
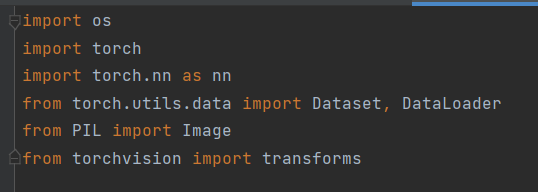
作用:
os:遍历文件夹、拼接路径、生成txt文件
torch、nn:构建模型、损失函数、优化器。
Dataset、DataLoader:自定义数据集和把数据分成一小批一小批地加载和训练。
PIL.Image:读取图片。
torchvision.transforms:图像预处理和数据增强。
2.2train_test_file:生成索引文件
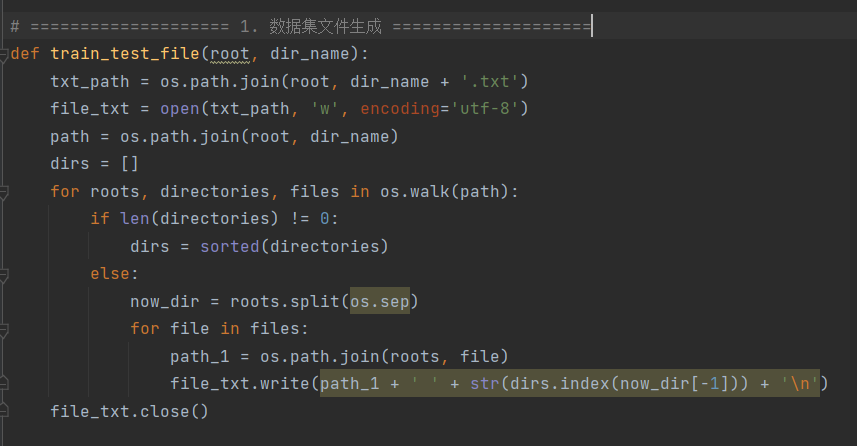
生成:food_dataset/train.txt和food_dataset/test.txt文件。
**os.walk(path)**会递归遍历目录。
第一次进入train时,directories是类别文件夹列表,例如'apple','banana',...
**dirs = sorted(directories)**对类别名排序,标签就是排序后的下标。
进入具体类别文件夹后,directories为空,files是图片文件。
**now_dir-1**是当前类别文件夹名。
**dirs.index(now_dir-1)**得到该类别对应的整数标签。
2.3数据增强data_transforms
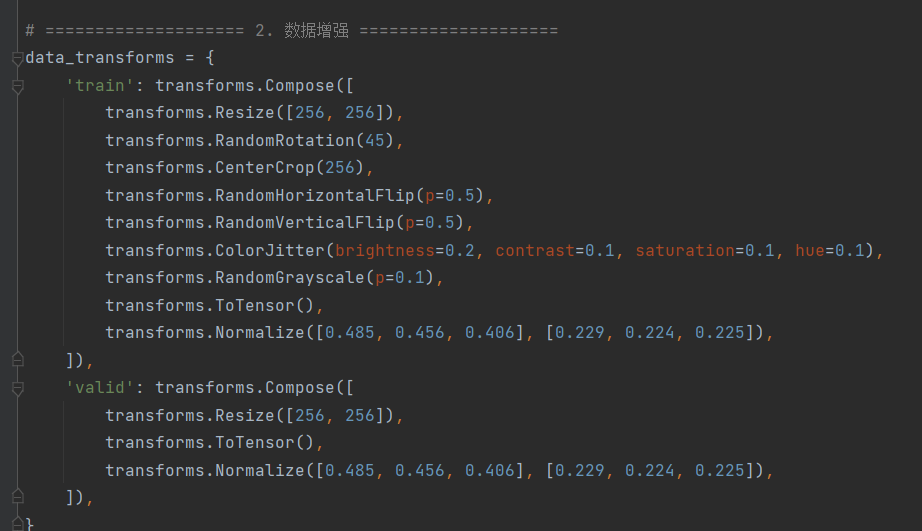
Resize(256,256):统一缩放到256*256.
RandomRotation(45):随机旋转45度。
CenterCrop(256):中心裁剪256*256.
RandomHorizontalFlip(p=0.5):随机水平翻转。
**RandomVerticalFilp(p=0.5):**随机垂直翻转。
**ColorJitter:**随机调整亮度、对比度、饱和度、色调。
**RandomGrayscale(p=0.1):**10%概率转灰度。
**ToTensor():**转成Tensor,并归一化到0,1.
**Normalize():**使用ImageNet均值和标准差标准化。
2.4food_dataset自定义数据集
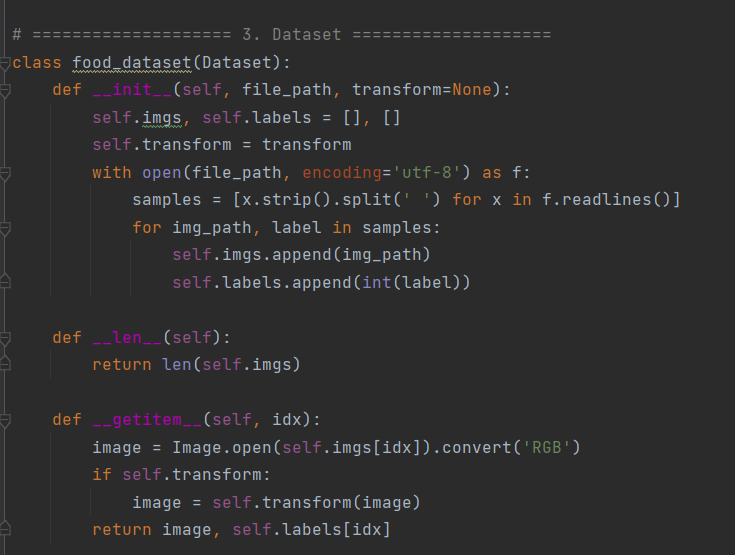
读取train.txt或test.txt。
每行拆成图片路径和标签。
**len**返回样本数量。
**getitem:**根据索引读取图片,转为RGB,应用transform,返回(image,label)。
2.5CNN模型
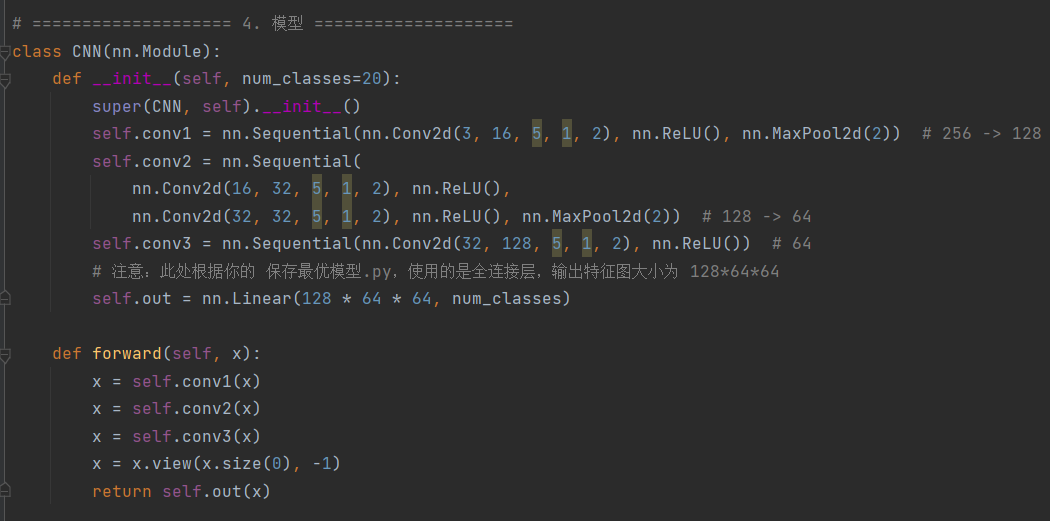
尺寸变化,输入图片是256*256*3.
conv1:Conv2d(3,16,5,1,2)保持256,MaxPool2d(2)变成128.
输出:16*128*128
conv2:两个卷积保持128,MaxPool2d(2)变成64
conv3:Conv2d(32,128,5,1,2)保持64.
输出:128*64*64
View(X.size(0),-1)展平成128*64*64=524288维
nn.Linear(128*64*64,20)输出20类。
2.6验证函数test
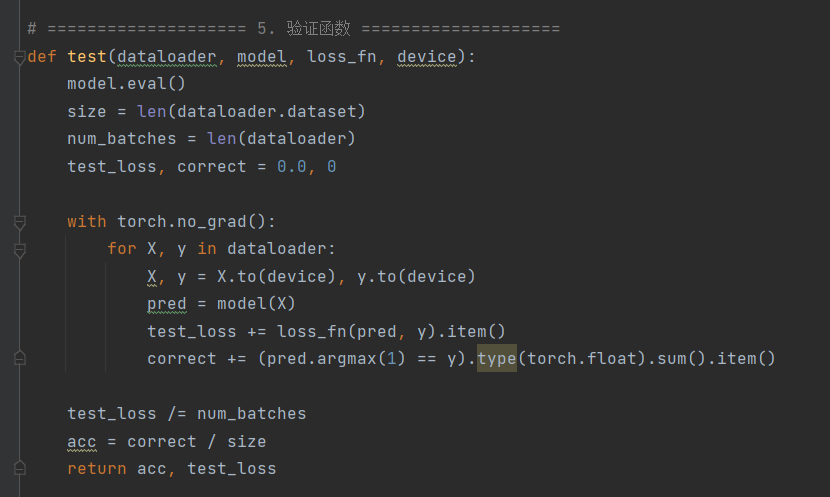
model.eval():切换到验证模式。
torch.no_gray():关闭梯度计算,节省内存。
pred.argmax(1):取预测类别
累加损失和正确数量,返回准确率和平均batch损失。