文章目录
导读
论文标题:BaCaDI: Bayesian Causal Discovery with Unknown Interventions(AISTATS 2023)
项目地址:https://github.com/haeggee/bacadi
这是发表于AISTATS 2023的因果发现领域研究成果,由苏黎世联邦理工学院、马普所等机构联合提出。论文针对 干预目标未知 + 样本量稀缺 的真实场景,提出了首个全贝叶斯、端到端可微 的因果发现框架 BaCaDI,通过连续松弛 + 粒子变分推断实现了因果结构、干预目标与机制参数的联合后验推断,在小样本场景下显著超越了现有方法。
由于这篇论文对我来说有点困难 所以整理了一篇逐章阅读版本:(AISTATS 2023)BaCaDI 逐章阅读
背景动机
识别系统的因果结构是科学研究的核心目标。理论上,通过干预(intervention)变量并观测结果,可以在大样本、无隐混杂的前提下完全识别真实因果结构。但真实世界的干预存在两大核心局限:
- 干预目标未知:例如生物实验中的药物处理、基因敲除,往往存在脱靶效应,或无法精准定位干预的具体基因;
- 样本量稀缺:单细胞测序、生物实验成本高昂,每个干预条件下只能获得少量观测样本。
现有因果发现方法无法同时应对上述两个挑战:
- 基于干预的方法(如 JCI、UT-IGSP):大多假设干预目标完全已知,无法适配未知干预场景;部分基于条件独立性检验的方法需要大样本,小样本下稳定性极差。
- 连续优化类方法(如 DCDI):将结构学习转化为连续优化问题,可处理未知干预,但仅输出点估计(单一最优图),不量化认知不确定性,小样本下极易过拟合。
- 传统贝叶斯方法:仅支持离散变量,且依赖动态规划,无法扩展到多变量的大规模图。
提出一个全贝叶斯框架,能够同时推断因果图结构、因果机制参数、未知干预的目标与效应的联合后验分布,并且通过可微设计实现高效的梯度 - based 推断,在小样本、未知干预的场景下保持性能。
核心贡献
- 首个多上下文未知干预的全贝叶斯因果发现方法:首次将因果结构、干预目标、机制参数纳入统一的贝叶斯联合推断,实现了不确定性在所有隐变量间的传播,而非分步估计。
- 离散结构的连续可微松弛:将离散的有向无环图(DAG)和干预目标都转化为连续潜变量的生成过程,结合 Gumbel-Softmax 技巧实现端到端可微,支持梯度优化。
- 基于 SVGD 的粒子变分推断:采用 Stein 变分梯度下降(SVGD)近似复杂的联合后验,配合退火策略保证渐近收敛到离散的 DAG 与干预目标,兼顾推断效率与理论一致性。
- 广泛的实验验证:在合成数据(线性 / 非线性高斯)和模拟基因表达数据上,均显著优于基线方法,尤其在小样本场景下优势明显,且对模型误设具有鲁棒性。
方法框架
给定 M 个上下文的数据集 D = { D 1 , . . . , D M } D = \{D_1,...,D_M\} D={D1,...,DM},每个数据集对应一个未知干预 I k = ( I k t a r , Θ I k ) I_k = (I_k^{tar}, \Theta_{I_k}) Ik=(Iktar,ΘIk),其中 I k t a r I_k^{tar} Iktar 是干预目标集合, Θ I k \Theta_{I_k} ΘIk 是干预效应参数。观测数据可视为干预为空的特殊上下文 D 0 D_0 D0。
目标:推断因果图 G、机制参数 Θ \Theta Θ、所有干预 I 的联合后验分布 p ( G , Θ , I ∣ D ) p(G, \Theta, I | D) p(G,Θ,I∣D)。
核心假设:稀疏机制偏移(Sparse Mechanism Shift) ------ 每个干预仅影响极少数变量 ( ∣ I k ∣ ≪ d (|I_k| \ll d (∣Ik∣≪d)。这是多上下文联合推断的前提:不同上下文的因果图大部分结构共享,仅少数节点的机制发生变化,因此可以跨上下文共享信息。
贝叶斯联合建模
已知干预的后验
如果干预目标和效应已知,后验可分解为先验、观测似然、干预似然的乘积:
p ( G , Θ ∣ D , I ) ∝ p ( G ) p ( Θ ∣ G ) ⏟ 先验 p ( D 0 ∣ Θ , G ) ⏟ 观测似然 ⋅ ∏ k = 1 M p ( D k ∣ Θ , G , I k ) ⏟ 干预似然 p(G, \Theta | D, \mathcal{I}) \propto \underbrace{p(G) p(\Theta | G)}{\text{先验}} \underbrace{p\left(\mathcal{D}{0} | \Theta, G\right)}{\text{观测似然}} \cdot \prod{k=1}^{M} \underbrace{p\left(\mathcal{D}{k} | \Theta, G, I{k}\right)}_{\text{干预似然}} p(G,Θ∣D,I)∝先验 p(G)p(Θ∣G)观测似然 p(D0∣Θ,G)⋅k=1∏M干预似然 p(Dk∣Θ,G,Ik)
未知干预的扩展
将干预也作为随机变量,引入干预目标的先验 p ( I k t a r ) p(I_k^{tar}) p(Iktar) 和干预参数的先验 p ( Θ I k ∣ I k t a r ) p(\Theta_{I_k} | I_k^{tar}) p(ΘIk∣Iktar),得到完整联合后验:
p ( G , Θ , I ∣ D ) ∝ p ( G ) p ( Θ ∣ G ) ⏟ 因果模型先验 p ( D 0 ∣ Θ , G ) ⏟ 观测似然 ⋅ ∏ k = 1 M p ( I k t a r ) p ( Θ I k ∣ I k t a r ) ⏟ 干预先验 p ( D k ∣ Θ , G , I k ) ⏟ 干预似然 p(G,\Theta ,\mathcal {I}|D)\propto \underbrace {p(G)p(\Theta |G)}{\text{因果模型先验}}\underbrace {p\left( \mathcal {D}{0}|\Theta ,G\right) }{\text{观测似然}} \cdot \prod{k=1}^{M}\underbrace {p\left( I_{k}^{tar}\right) p\left( \Theta_{I_{k}} | I_{k}^{tar}\right) }{\text{干预先验}}\underbrace {p\left( \mathcal {D}{k} | \Theta ,G, I_{k}\right) }_{\text{干预似然}} p(G,Θ,I∣D)∝因果模型先验 p(G)p(Θ∣G)观测似然 p(D0∣Θ,G)⋅k=1∏M干预先验 p(Iktar)p(ΘIk∣Iktar)干预似然 p(Dk∣Θ,G,Ik)
可微生成模型:离散结构的连续松弛
直接在离散 DAG 空间做贝叶斯推断不可行,因此论文引入连续潜变量,将离散的图和干预目标转化为连续生成过程,实现可微性。
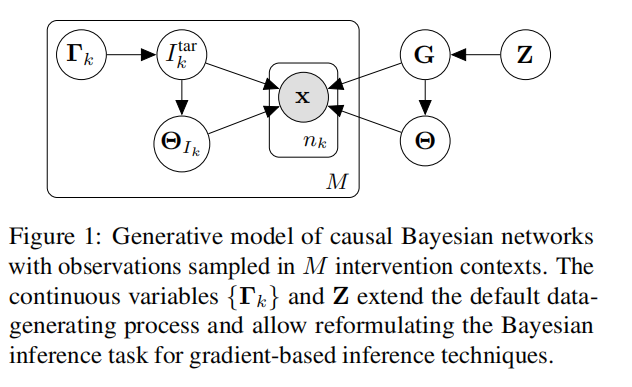
因果图 G 的生成模型
引入连续潜变量 Z = U , V Z = U, V Z=U,V(两个 d × d d\times d d×d 的嵌入矩阵),通过向量内积生成每条边的概率:
p α ( G ∣ Z ) = ∏ i , j ≠ i Bern ( g i j ∣ σ α ( u i ⊤ v j ) ) p_\alpha(G | Z) = \prod_{i,j\neq i} \text{Bern}(g_{ij} | \sigma_\alpha(u_i^\top v_j)) pα(G∣Z)=∏i,j=iBern(gij∣σα(ui⊤vj))
其中 σ α \sigma_\alpha σα 是带温度参数 α \alpha α 的 sigmoid 函数, α \alpha α 越大,边概率越趋近于 0 或 1(离散化)。同时对 Z 设计先验:
- 高斯先验:保证推断稳定性;
- 无环性先验 :基于图的迹惩罚项 h ( G ) h(G) h(G),通过逆温度参数 β \beta β 控制无环约束强度, β → ∞ \beta\to\infty β→∞ 时仅支持 DAG。
干预目标 I t a r I^{tar} Itar 的生成模型
引入连续潜变量 Γ ∈ R M × d \Gamma \in \mathbb{R}^{M\times d} Γ∈RM×d,每个元素 γ k , i \gamma_{k,i} γk,i 对应第 k 个上下文、第 i 个变量是否为干预目标的 logit 值:
p ( I t a r ∣ Γ ) = ∏ k = 1 M ∏ i = 1 d Bern ( I k , i t a r ∣ σ α ( γ k , i ) ) p\left(\mathcal{I}^{tar} | \Gamma\right)= \prod_{k=1}^{M} \prod_{i=1}^{d} \text{Bern}\left(I_{k, i}^{tar} | \sigma_{\alpha}\left(\gamma_{k, i}\right)\right) p(Itar∣Γ)=∏k=1M∏i=1dBern(Ik,itar∣σα(γk,i))
对 Γ \Gamma Γ 设计三重先验:
- 高斯先验:保证数值稳定性;
- 稀疏先验 :通过 l 1 l_1 l1 范数惩罚,鼓励干预目标稀疏;
- 尖锐先验:Beta 分布先验,让干预概率趋近于 0 或 1,避免模糊的中间状态。
可微干预似然
结合 Gumbel-Softmax 技巧,对离散的图和干预目标进行可微采样,实现每个变量在「观测似然」和「干预似然」之间的平滑切换:
p ( D k ∣ G , Θ , I k t a r , Θ I k ) = ∏ j = 1 n k ∏ i = 1 d ( p ( x i ( k , j ) ∣ x p a G ( i ) , Θ ) ( 1 − I k , i t a r ) ⋅ p ( x i ( k , j ) ∣ Θ I k ) I k , i t a r ) p\left(\mathcal{D}{k} | G, \Theta, I{k}^{tar}, \Theta_{I_{k}}\right)= \prod_{j=1}^{n_{k}} \prod_{i=1}^{d}\left(p\left(x_{i}^{(k, j)} | x_{pa_{G}(i)}, \Theta\right)^{\left(1-I_{k, i}^{tar}\right)} \cdot p\left(x_{i}^{(k, j)} | \Theta_{I_{k}}\right)^{I_{k, i}^{tar}}\right) p(Dk∣G,Θ,Iktar,ΘIk)=j=1∏nki=1∏d(p(xi(k,j)∣xpaG(i),Θ)(1−Ik,itar)⋅p(xi(k,j)∣ΘIk)Ik,itar)该设计的优势:不绑定具体的似然形式,可以接入线性模型、神经网络、硬 / 软干预等任意可微的因果机制。
变分推断:SVGD 近似后验
理论基础:命题 1
通过引入连续潜变量 Z 和 Γ \Gamma Γ,离散结构的后验期望可以转化为连续潜变量后验的期望:
E p ( G , Θ , I ∣ D ) f ( G , Θ , I ) = E p ( Z , Θ , Γ , Θ I ∣ D ) E p ( G ∣ Z ) E p ( I t a r ∣ Γ ) \[ f ( G , Θ , I ) ⋅ Ψ E p ( G ∣ Z ) E p ( I t a r ∣ Γ ) Ψ ] \mathbb{E}{p(G,\Theta ,\mathcal {I}|D)}f(G,\\Theta ,\\mathcal {I})=\mathbb{E}{p(Z,\Theta ,\Gamma ,\Theta_{\mathcal {I}}|D)}\left \\frac {\\mathbb{E}_{p(G\|Z)}\\mathbb{E}_{p(\\mathcal {I}\^{tar}\|\\Gamma )}\[f(G,\\Theta ,\\mathcal {I})\\cdot \\Psi }{\mathbb{E}{p(G|Z)}\mathbb{E}{p(\mathcal {I}^{tar}|\Gamma )}\\Psi }\right] Ep(G,Θ,I∣D)f(G,Θ,I)=Ep(Z,Θ,Γ,ΘI∣D)Ep(G∣Z)Ep(Itar∣Γ)\[ΨEp(G∣Z)Ep(Itar∣Γ)f(G,Θ,I)⋅Ψ] 其中 Ψ \Psi Ψ 是权重项,包含先验和似然。这一命题将原本的离散 - 连续混合推断问题,完全转化为纯连续空间的推断问题,为梯度优化奠定了理论基础。
SVGD 粒子变分推断
采用Stein 变分梯度下降(SVGD)来近似连续潜变量的后验 p ( Z , Θ , Γ , Θ I ∣ D ) p(Z, \Theta, \Gamma, \Theta_I | D) p(Z,Θ,Γ,ΘI∣D)。SVGD 是一种粒子 - based 变分推断算法:
- 用一组粒子近似后验分布;
- 通过得分函数(对数后验的梯度)驱动粒子向高概率区域移动;
- 通过核函数引入粒子间的排斥力,避免粒子坍缩到单点,更好地覆盖多峰后验。
相比传统变分推断(如平均场),SVGD 更适合复杂、多峰的后验分布,且只需要对数后验的梯度,不需要计算归一化常数。
退火策略与渐近一致性:命题 2
训练过程中对温度参数 α t \alpha_t αt 和 β t \beta_t βt 执行线性退火(逐渐增大),当 α → ∞ , β → ∞ \alpha\to\infty, \beta\to\infty α→∞,β→∞ 时:
- 连续松弛的边概率收敛到 0-1 离散值;
- 无环约束逐渐严格,最终仅支持合法 DAG;
- 连续潜变量的后验收敛到离散结构的后验。
这保证了方法的渐近一致性:训练结束后,每个粒子对应一个离散的 DAG 和一组离散的干预目标,共同构成后验的粒子近似。
实验分析
数据集
- 合成数据:生成 Erdős-Rényi(ER)和 Scale-Free(SF)两类随机图,节点数 (d=20),包含线性高斯、非线性高斯两种因果机制;每个干预上下文仅 10 个样本,属于典型小样本场景。
- 真实模拟数据:用 SERGIO 模拟器生成单细胞基因表达数据,模拟基因调控网络的敲除干预,数据包含非线性动力学和生物噪声,存在显著模型误设。
基线方法
所有基线均结合 bootstrap 以近似后验,保证公平对比:
- B-JCI-PC:基于条件独立性检验的多上下文因果发现方法;
- B-UT-IGSP:基于置换检验的未知干预因果发现方法;
- B-DCDI-G:基于连续优化的未知干预因果发现方法(神经网络拟合机制)。
评价指标
- E-SID:期望结构干预距离,衡量因果图的干预等价性,越小越好;
- AUPRC:边预测的精确率 - 召回率曲线下面积,衡量结构预测准确性;
- INTV-AUPRC:干预目标预测的 AUPRC;
- I-NLL:留出干预数据集的负对数似然,衡量模型泛化能力。
合成数据:全面领先基线
在线性和非线性高斯场景下,BaCaDI 在所有指标上均显著优于基线:
- 因果结构恢复(E-SID、AUPRC):大幅超越 JCI-PC、UT-IGSP 和 DCDI-G,尤其是非线性场景下优势更明显;
- 干预目标预测:与表现最好的 UT-IGSP 相当,但 UT-IGSP 在结构预测上远差于 BaCaDI;
- 泛化能力:I-NLL 显著更低,说明贝叶斯联合推断有效缓解了小样本过拟合。
SERGIO 基因数据:鲁棒性验证
在模型严重误设(数据来自随机动力学系统,而非模型假设的高斯分布)的情况下,BaCaDI 依然保持最优性能:
- 结构预测精度远超基线;
- 干预目标预测准确率极高,得益于先验知识的嵌入(敲除干预表达量接近 0);
- JCI-PC 等基于检验的方法几乎失效,接近随机猜测。
扩展实验
- 更大规模图(50 节点):BaCaDI 可扩展到更大规模的因果系统,性能依然领先基线。
- 样本量增加:随着样本量提升,所有方法性能均提升,但 BaCaDI 的优势保持稳定。
- 观测 vs 干预数据对比:即使干预目标未知,加入干预数据也能显著提升因果结构发现效果;BaCaDI 的性能接近「已知干预」的理想上限,远优于仅使用观测数据。
总结思考
BaCaDI 填补了 未知干预场景下全贝叶斯因果发现 的空白,通过连续松弛和粒子变分推断,巧妙解决了离散结构的可微推断难题,实现了因果结构、干预目标和机制参数的联合贝叶斯估计。它不仅在理论上具有渐近一致性,更在小样本、模型误设的真实场景中展现出显著的性能优势,为生物信息学等数据稀缺、干预模糊的领域提供了有力的因果发现工具。
输出后验分布而非单点估计,可用于实验设计、风险评估等对不确定性敏感的场景;贝叶斯先验 + 联合推断,在样本稀缺时比点估计方法更稳定;框架可接入任意可微的因果机制和干预类型,适配不同领域的先验知识。
局限性:
基于 SVGD 的推断在节点数超过 50 后计算成本较高,未来可探索更高效的变分近似;如果干预对分布的改变很小,有限数据下难以检测。
补充知识
- 因果贝叶斯网络(CBN)
一个因果贝叶斯网络由有向无环图 G 和参数 Θ \Theta Θ 组成,联合分布可分解为每个变量给定其父节点的条件分布的乘积: p ( x ) = ∏ i = 1 d p i ( x i ∣ x p a G ( i ) , Θ ) p(x) = \prod_{i=1}^d p_i(x_i | x_{pa_G(i)}, \Theta) p(x)=∏i=1dpi(xi∣xpaG(i),Θ)
其中 p a G ( i ) pa_G(i) paG(i) 表示图 G 中节点 i 的父节点集合,边代表直接因果关系。
- 干预
对变量 x i x_i xi 的干预指替换其原有的条件分布 p i p_i pi 为新的分布 p i I p_i^I piI:
- 硬干预(完美干预):完全切断变量与其父节点的依赖,例如基因敲除;
- 软干预(不完美干预):保留部分父节点依赖,仅改变分布参数。
论文默认假设硬干预,但框架可扩展到软干预。
- 贝叶斯结构学习
给定观测数据 D,贝叶斯推断的目标是计算 DAG 和参数的后验分布:
p ( G , Θ ∣ D ) ∝ p ( G ) p ( Θ ∣ G ) p ( D ∣ G , Θ ) p(G, \Theta | D) \propto p(G) p(\Theta | G) p(D | G, \Theta) p(G,Θ∣D)∝p(G)p(Θ∣G)p(D∣G,Θ)
但 DAG 的数量随节点数呈超指数增长 ( O ( d ! 2 d 2 / 2 ) (O(d! 2^{d^2/2}) (O(d!2d2/2)),直接计算后验是不可行的。