写在前面
欢迎大家关注Rocky的知乎:Rocky Ding
《三年面试五年模拟》AIGC/LLM/AI Agent算法工程师/开发工程师求职面试秘籍独家资源:【三年面试五年模拟】WeThinkIn/AIGC-Interview-Book,欢迎大家Star~
Rocky最新撰写的10万字AI Agent(AI智能体)深入浅出全维度解析文章: 深入浅出完整解析AI Agent(AI智能体)的核心基础知识
AIGC/LLM/AI Agent算法岗/开发岗求职面试内推学习社群 (涵盖AIGC、LLM大模型、AI Agent、传统深度学习、自动驾驶、机器学习、计算机视觉、自然语言处理、强化学习、大数据挖掘、具身智能、元宇宙、AGI等AI行业最新面试干货经验与核心知识)欢迎大家加入:https://t.zsxq.com/33pJ0
大家好,我是Rocky。
1. 核心判断:LlamaGen把视觉自回归的竞争,重新拉回表示、规模与数据
当扩散模型成为图像生成的重要路线,人们很容易把它的领先直接解释成"预测下一个token不适合图像"。LlamaGen提出了一个更具体、也更容易检验的问题:如果认真优化图像tokenizer、模型规模、训练数据与推理实现,沿用语言模型式的逐token自回归,究竟能走多远?
这项工作没有发明新的图像生成目标。它保留raster-scan顺序,用Llama风格的Transformer预测离散视觉token,再由视觉解码器还原图像。它的研究价值,在于把原本分散在视觉生成和语言模型工程中的有效设计放到同一基线上,系统检查各环节的贡献。
在ImageNet类别条件生成实验中,3.1B主干达到论文主表报告的2.18 FID,低于所比较的LDM和DiT。在文生图上,775M主干经过两阶段数据训练展示了不错的视觉质量,但仍存在文字、计数和常识错误。这两类证据应分别阅读:类别条件基准领先,不自动等于开放域文生图全面领先。
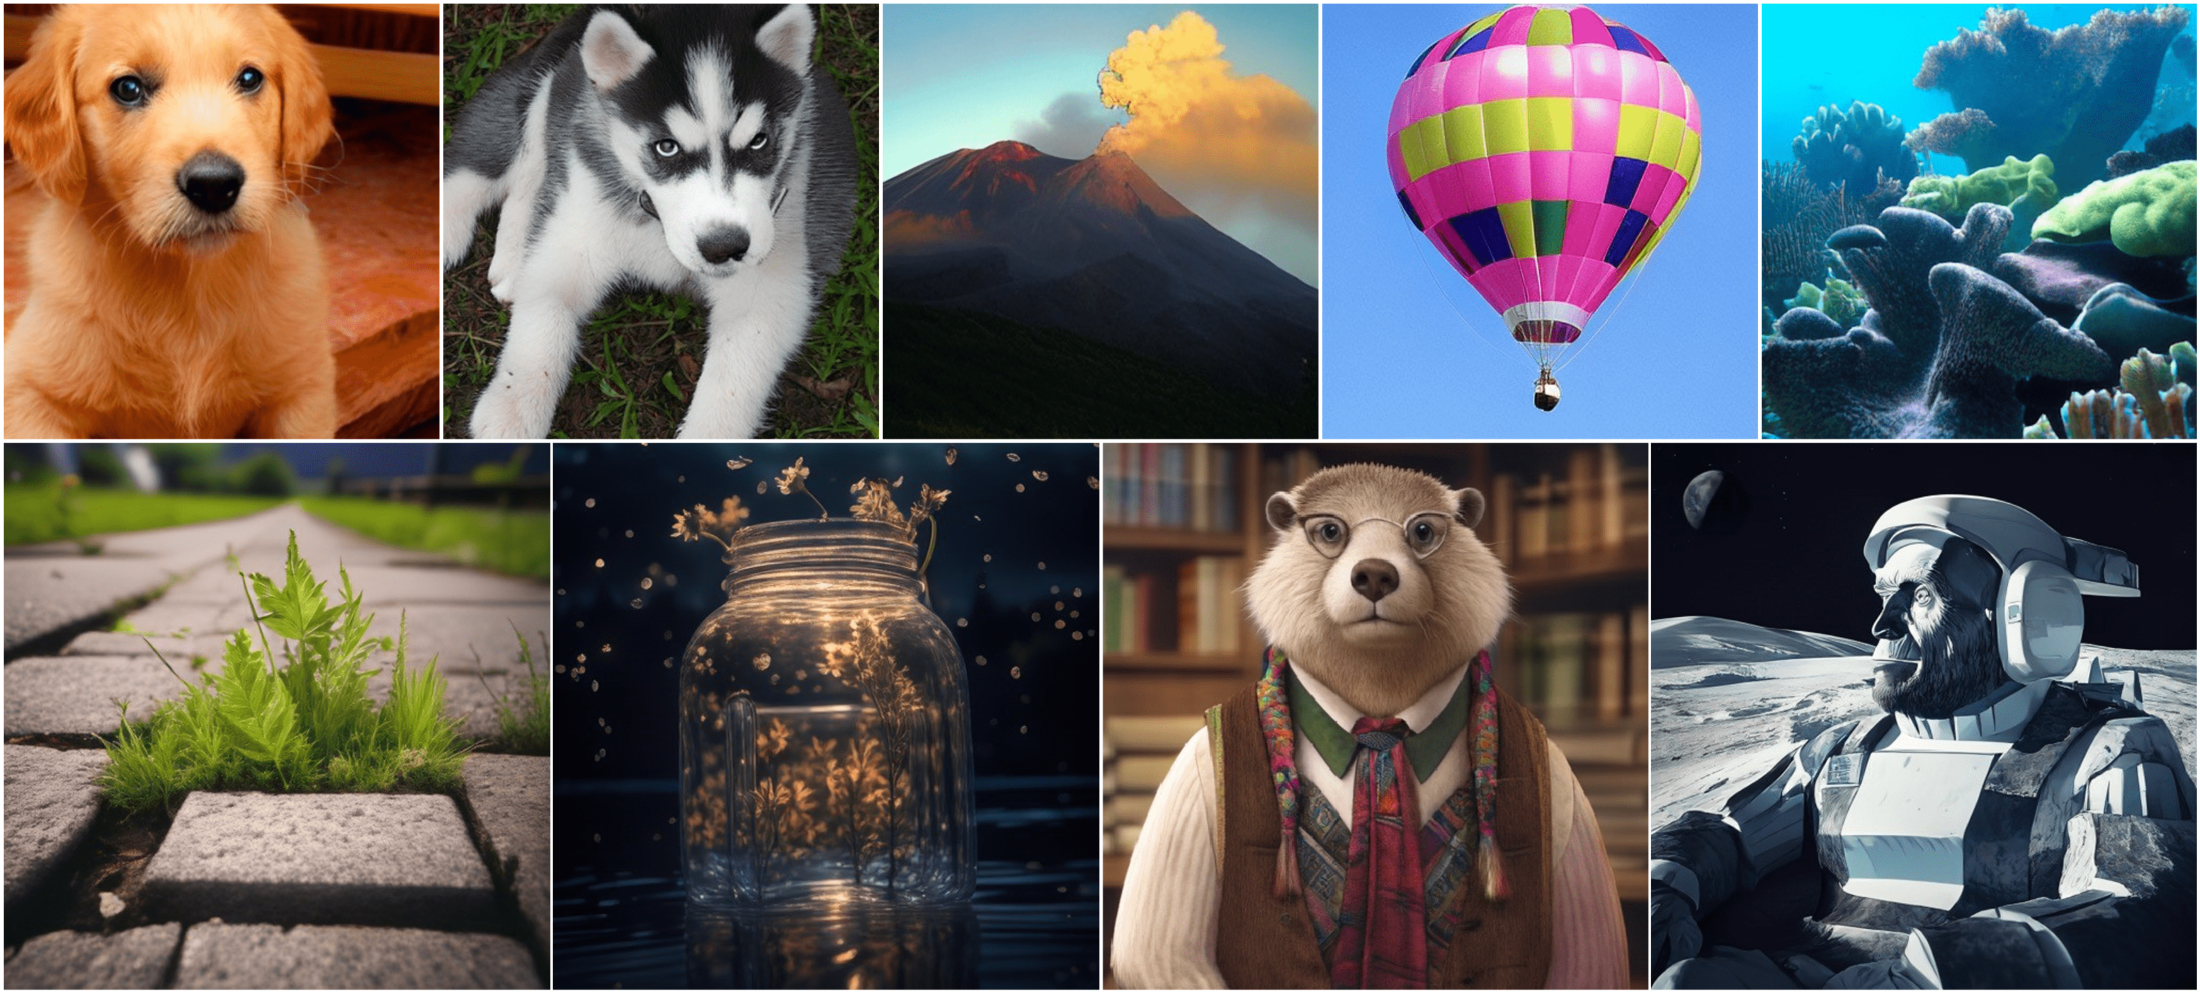
图1上排展示类别条件生成,下排展示文字条件生成。它说明同一种自回归建模方式可以接入不同条件,但两类系统的条件来源、数据与训练过程并不相同。
本文围绕2024年论文《Autoregressive Model Beats Diffusion: Llama for Scalable Image Generation》的v1版本展开。横向比较保留当时的实验范围,避免将历史基准结果当作当前图像产品排名。
2. LlamaGen如何把一张图变成下一token预测
输入图像记为 x ∈ R H × W × 3 x\in\mathbb R^{H\times W\times3} x∈RH×W×3,视觉tokenizer以 p p p倍下采样,将其转换为 h × w h\times w h×w个离散码,其中 h = H / p h=H/p h=H/p、 w = W / p w=W/p w=W/p。每个位置存储一个码本索引,而不是RGB像素。
把二维索引网格按从左到右、从上到下的顺序展平,得到 q 1 , ... , q N q_1,\ldots,q_N q1,...,qN,其中 N = h w N=hw N=hw。类别或文本条件记为 c c c,模型学习:
p θ ( q 1 , ... , q N ∣ c ) = ∏ t = 1 N p θ ( q t ∣ q < t , c ) . p_\theta(q_1,\ldots,q_N\mid c)=\prod_{t=1}^{N}p_\theta(q_t\mid q_{<t},c). pθ(q1,...,qN∣c)=t=1∏Npθ(qt∣q<t,c).
训练时使用teacher forcing,已知图像对应的真实token序列,通过因果mask并行计算各位置的下一token预测损失;推理时则必须沿着生成顺序逐个采样。训练中的并行计算,不等于推理可以把整张图的未知token一次性独立生成。
这一区别解释了LlamaGen与MaskGIT、VAR的不同。MaskGIT通过双向上下文迭代补全被遮盖的位置;VAR把生成过程组织为由粗到细的尺度预测;LlamaGen保留普通逐token因果分解。它希望验证的是,在不改写这条分解规则的情况下,强基线能否成立。
"没有视觉归纳偏置"需要谨慎理解。LlamaGen主干确实保持接近LLM的结构,没有引入AdaLN式条件调制,但它仍使用卷积视觉tokenizer与2D RoPE,也采用二维网格展平。这是一种减少视觉专用主干设计的路线,不能按字面理解成整个系统没有任何视觉结构先验。
3. LlamaGen视觉tokenizer:离散化不是随手接一个VQGAN
视觉tokenizer采用encoder---quantizer---decoder结构。卷积编码器把图像转换为特征网格 f f f,量化器从码本 Z ∈ R K × C Z\in\mathbb R^{K\times C} Z∈RK×C中为每个位置选择最近的码向量,再由解码器重建图像。 K K K表示码本项数, C C C表示单个向量的维度,两者决定不同的表示容量。
将最近邻量化写成便于理解的形式:
q ( i , j ) = arg min k ∈ { 1 , ... , K } ∥ f ( i , j ) − Z k ∥ 2 2 , z ( i , j ) = Z q ( i , j ) . q^{(i,j)}=\mathop{\arg\min}_{k\in\{1,\ldots,K\}}\|f^{(i,j)}-Z_k\|2^2,\qquad z^{(i,j)}=Z{q^{(i,j)}}. q(i,j)=argmink∈{1,...,K}∥f(i,j)−Zk∥22,z(i,j)=Zq(i,j).
论文使用码向量的 ℓ 2 \ell_2 ℓ2归一化、较低码向量维度与较大码本,以改善重建和使用率。这里的要点是:离散项数量多,不代表训练过程真的使用了这些项;若大部分输入都挤向少量码字,名义容量很大,实际信息通道却很窄。
量化操作不可微,训练使用straight-through估计器。为避免左侧变量复用,把传给解码器的张量写为:
z S T = sg z − f + f . z_{\mathrm{ST}}=\operatorname{sg}z-f+f. zST=sgz−f+f.
sg \operatorname{sg} sg表示停止梯度。前向数值等于量化向量 z z z,反向对编码器特征 f f f保留直通梯度。这不是"量化变得可微",而是一种梯度估计方式。
码本学习损失为:
L V Q = ∥ sg f − z ∥ 2 2 + β ∥ f − sg z ∥ 2 2 . \mathcal L_{\mathrm{VQ}}=\|\operatorname{sg}f-z\|_2^2+\beta\|f-\operatorname{sg}z\|_2^2. LVQ=∥sgf−z∥22+β∥f−sgz∥22.
第一项更新码向量以靠近编码器输出;第二项是commitment loss,约束编码器输出靠近所选码向量。论文使用 β = 0.25 \beta=0.25 β=0.25,没有额外加入熵损失。图像重建损失为:
L A E = ℓ 2 ( x , x ^ ) + L P ( x , x ^ ) + λ G L G ( x ^ ) . \mathcal L_{\mathrm{AE}}=\ell_2(x,\hat x)+\mathcal L_{\mathrm P}(x,\hat x)+\lambda_{\mathrm G}\mathcal L_{\mathrm G}(\hat x). LAE=ℓ2(x,x^)+LP(x,x^)+λGLG(x^).
其中包含像素重建、LPIPS感知损失及PatchGAN对抗损失, λ G = 0.5 \lambda_{\mathrm G}=0.5 λG=0.5,对抗训练在20K步后启用。公式体现了一个现实:主干自回归目标很整齐,但高质量视觉压缩仍然需要像素、感知和分布层面的多重约束。
4. LlamaGen码本消融:容量越大、维度越高,并不保证越好
表2a|码本向量维度消融。 其他默认设置为码本大小16,384、下采样16倍,使用ImageNet验证集评估。
| 码本向量维度 | rFID ↓ | PSNR ↑ | SSIM ↑ | 使用率 ↑ |
|---|---|---|---|---|
| 256 | 9.21 | 18.32 | 0.575 | 0.29% |
| 32 | 3.22 | 19.98 | 0.646 | 20.9% |
| 8 | 2.19 | 20.79 | 0.675 | 97.0% |
| 4 | 9.88 | 19.39 | 0.593 | 82.0% |
从256维降到8维,rFID由9.21改善至2.19,使用率由0.29%提高到97.0%。但进一步降到4维,rFID退化到9.88。因此,实验支持"在此训练设置下低维码更容易有效利用",不支持"维度越低越好"。
表2b|码本大小消融。
| 码本大小 | rFID ↓ | PSNR ↑ | SSIM ↑ | 使用率 ↑ |
|---|---|---|---|---|
| 4096 | 3.02 | 19.99 | 0.643 | 100.0% |
| 8192 | 2.91 | 20.41 | 0.654 | 75.0% |
| 16384 | 2.19 | 20.79 | 0.675 | 97.0% |
| 32768 | 2.26 | 20.59 | 0.663 | 85.0% |
码本从4,096扩大到16,384,rFID改善;进一步到32,768,rFID为2.26,反而略差于2.19。使用率也不是单独的优化目标:4,096码本的使用率为100%,重建却弱于16,384码本。要同时看码率、利用程度与真实重建效果。
论文的codebook usage在长度65,536的队列中统计出现过的码字,占整个码本的比例。它是特定统计窗口下的利用率,不等于全训练集熵、不等于码字分布均匀,也不等于每张图都使用97%的码本。
5. LlamaGen重建与token数量:0.94 rFID必须绑定分辨率
表3|下采样比例、图像尺寸与token数量。 所有重建结果都缩放到 256 × 256 256\times256 256×256后进行ImageNet评估。
| 下采样倍数 | 输入边长 | token数量 | rFID ↓ | PSNR ↑ | SSIM ↑ | 使用率 ↑ |
|---|---|---|---|---|---|---|
| 16 | 256 | 256 (16×16) | 2.19 | 20.79 | 0.675 | 97.0% |
| 16 | 384 | 576 (24×24) | 0.94 | 21.94 | 0.726 | 97.0% |
| 16 | 512 | 1024 (32×32) | 0.70 | 23.03 | 0.772 | 97.0% |
| 8 | 256 | 1024 (32×32) | 0.59 | 24.45 | 0.813 | 97.6% |
| 8 | 384 | 2304 (48×48) | 0.37 | 25.63 | 0.852 | 97.6% |
| 8 | 512 | 4096 (64×64) | 0.39 | 26.98 | 0.888 | 97.6% |
这张表解释了摘要中0.94 rFID的具体含义:16倍下采样、384边长输入、576个token,并把重建结果缩放到256边长评估。原生256边长、256个token的对应rFID是2.19。脱离输入和评测分辨率,只写"256基准重建达到0.94",会掩盖表示长度的变化。
同一个tokenizer增加token数,能保留更多视觉信息;但序列也变长。以16倍下采样为例,256、384、512边长分别对应256、576、1,024个token。模型最终要预测多少次,直接取决于这个选择。
v1正文在描述这一变化时另写了"2.43到0.99",与表3的2.19到0.94不一致。本文保留表中数据,并将这处正文差异视为版本内未解决的不一致,不混合两个口径形成新结论。
表4|与其他视觉tokenizer及连续VAE比较。 oim.指OpenImage训练,ukn.表示训练数据未明确,不能把所有行解释成完全相同数据预算下的实验。
| 下采样倍数 | 方法 | 向量维度 | 码本大小 | ImageNet rFID | PSNR | SSIM | COCO rFID | PSNR | SSIM |
|---|---|---|---|---|---|---|---|---|---|
| 16 | VQGAN | 256 | 1024 | 8.30 | 19.51 | 0.614 | 16.95 | 19.08 | 0.613 |
| 16 | VQGAN | 256 | 16384 | 4.99 | 20.00 | 0.629 | 12.29 | 19.57 | 0.630 |
| 16 | MaskGIT | 256 | 1024 | 2.28 | - | - | - | - | - |
| 16 | Ours | 8 | 16384 | 2.19 | 20.79 | 0.675 | 8.11 | 20.42 | 0.678 |
| 8 | V Q G A N o i m . VQGAN^{oim.} VQGANoim. | 4 | 256 | 1.44 | 22.63 | 0.737 | 6.58 | 22.289 | 0.744 |
| 8 | V Q G A N o i m . VQGAN^{oim.} VQGANoim. | 4 | 16384 | 1.19 | 23.38 | 0.762 | 5.89 | 23.08 | 0.771 |
| 8 | ViT-VQGAN | 32 | 8192 | 1.28 | - | - | - | - | - |
| 8 | Ours | 8 | 16384 | 0.59 | 24.45 | 0.813 | 4.19 | 24.20 | 0.822 |
| 8 | SD-VAE u k n . ^{ukn.} ukn. | 4 | - | 0.74 | 25.68 | 0.820 | 4.45 | 25.41 | 0.831 |
| 8 | SDXL-VAE u k n . ^{ukn.} ukn. | 4 | - | 0.68 | 26.04 | 0.834 | 4.07 | 25.76 | 0.845 |
| 8 | OAI-Decoder u k n . ^{ukn.} ukn. | 4 | - | 0.81 | 24.43 | 0.786 | 4.59 | 24.19 | 0.800 |
8倍下采样时,LlamaGen tokenizer在ImageNet rFID达到0.59,与若干连续VAE相比具有竞争力;但在COCO,SDXL-VAE的rFID 4.07低于其4.19,其他像素相似度指标也并非全面领先。
因此,"离散表示不是瓶颈"更合理的解释是:在这些重建基准上,经过认真设计的离散tokenizer不必天然落后于连续表示。它没有证明离散化在小字、高频纹理、任意高分辨率或复杂开放域生成中不再产生信息损失。
6. LlamaGen主干:Llama式结构可以复用,但模型不是预训练Llama直接改造
LlamaGen使用RMSNorm预归一化、SwiGLU和2D RoPE,保持接近语言模型的主干结构。类别条件由可学习embedding提供,作为预填充token;文字条件由FLAN-T5 XL编码,经额外MLP映射后作为前缀输入。
表1|LlamaGen系列主干配置。
| 模型 | 参数 | 层数 | 隐藏维度 | 头数 |
|---|---|---|---|---|
| LlamaGen-B | 111M | 12 | 768 | 12 |
| LlamaGen-L | 343M | 24 | 1024 | 16 |
| LlamaGen-XL | 775M | 36 | 1280 | 20 |
| LlamaGen-XXL | 1.4B | 48 | 1536 | 24 |
| LlamaGen-3B | 3.1B | 24 | 3200 | 32 |
这里的"Llama"指主要架构选择,不应直接理解为复用了一个成熟Llama语言模型的全部预训练知识。文生图版本另外依赖文本编码器,775M描述的是自回归生成主干,不能当作包含FLAN-T5 XL和视觉tokenizer的整套系统参数量。
训练中采用AdamW、梯度裁剪及dropout;类别条件有0.1概率被替换成无条件embedding,以支持CFG。图像token预先计算:类别条件训练为每张图缓存十个裁剪结果,训练时随机选一个,降低在线视觉编码成本;文字条件训练则缓存中心裁剪token与文本embedding。
这类缓存把训练资源更多集中到主干,但也固定了部分数据增强空间。若后来修改tokenizer、分辨率或captioner,就需要考虑缓存是否仍然有效。工程上的加速往往伴随对数据处理流程的约束。
7. LlamaGen扩展实验:重建更好,不保证小模型生成更好
表5|不同token长度与模型规模的生成表现。 所有模型训练50个epoch,CFG为1.75,Top-k为全码本,Top-p与temperature均为1.0;生成图统一缩放到256边长评估。
| 视觉序列配置 | 模型 | FID ↓ | IS ↑ | Precision ↑ | Recall ↑ |
|---|---|---|---|---|---|
| 256×256;256 tokens;rFID 2.19 | B | 8.69 | 124.43 | 0.78 | 0.46 |
| 256×256;256 tokens;rFID 2.19 | L | 4.21 | 200.00 | 0.82 | 0.50 |
| 256×256;256 tokens;rFID 2.19 | XL | 3.39 | 227.08 | 0.81 | 0.54 |
| 256×256;256 tokens;rFID 2.19 | XXL | 3.09 | 253.60 | 0.82 | 0.52 |
| 256×256;256 tokens;rFID 2.19 | 3B | 3.06 | 279.71 | 0.84 | 0.53 |
| 384×384;576 tokens;rFID 0.94 | B | 12.89 | 92.44 | 0.73 | 0.48 |
| 384×384;576 tokens;rFID 0.94 | L | 5.01 | 167.31 | 0.78 | 0.52 |
| 384×384;576 tokens;rFID 0.94 | XL | 3.42 | 202.93 | 0.79 | 0.56 |
| 384×384;576 tokens;rFID 0.94 | XXL | 2.89 | 236.21 | 0.80 | 0.56 |
| 384×384;576 tokens;rFID 0.94 | 3B | 2.61 | 251.90 | 0.80 | 0.56 |
B模型从256个token增加到576个token,FID由8.69恶化到12.89;L模型从4.21变为5.01。虽然视觉重建明显改善,较小主干未必有足够能力拟合更长、更细致的序列分布。到了XXL与3B,长序列开始带来收益。
表示能力与生成模型能力必须匹配。 更高码率减少视觉压缩损失,却增加了序列建模难度。只优化tokenizer的rFID,可能把主干推入更难训练、更慢推理的区域。
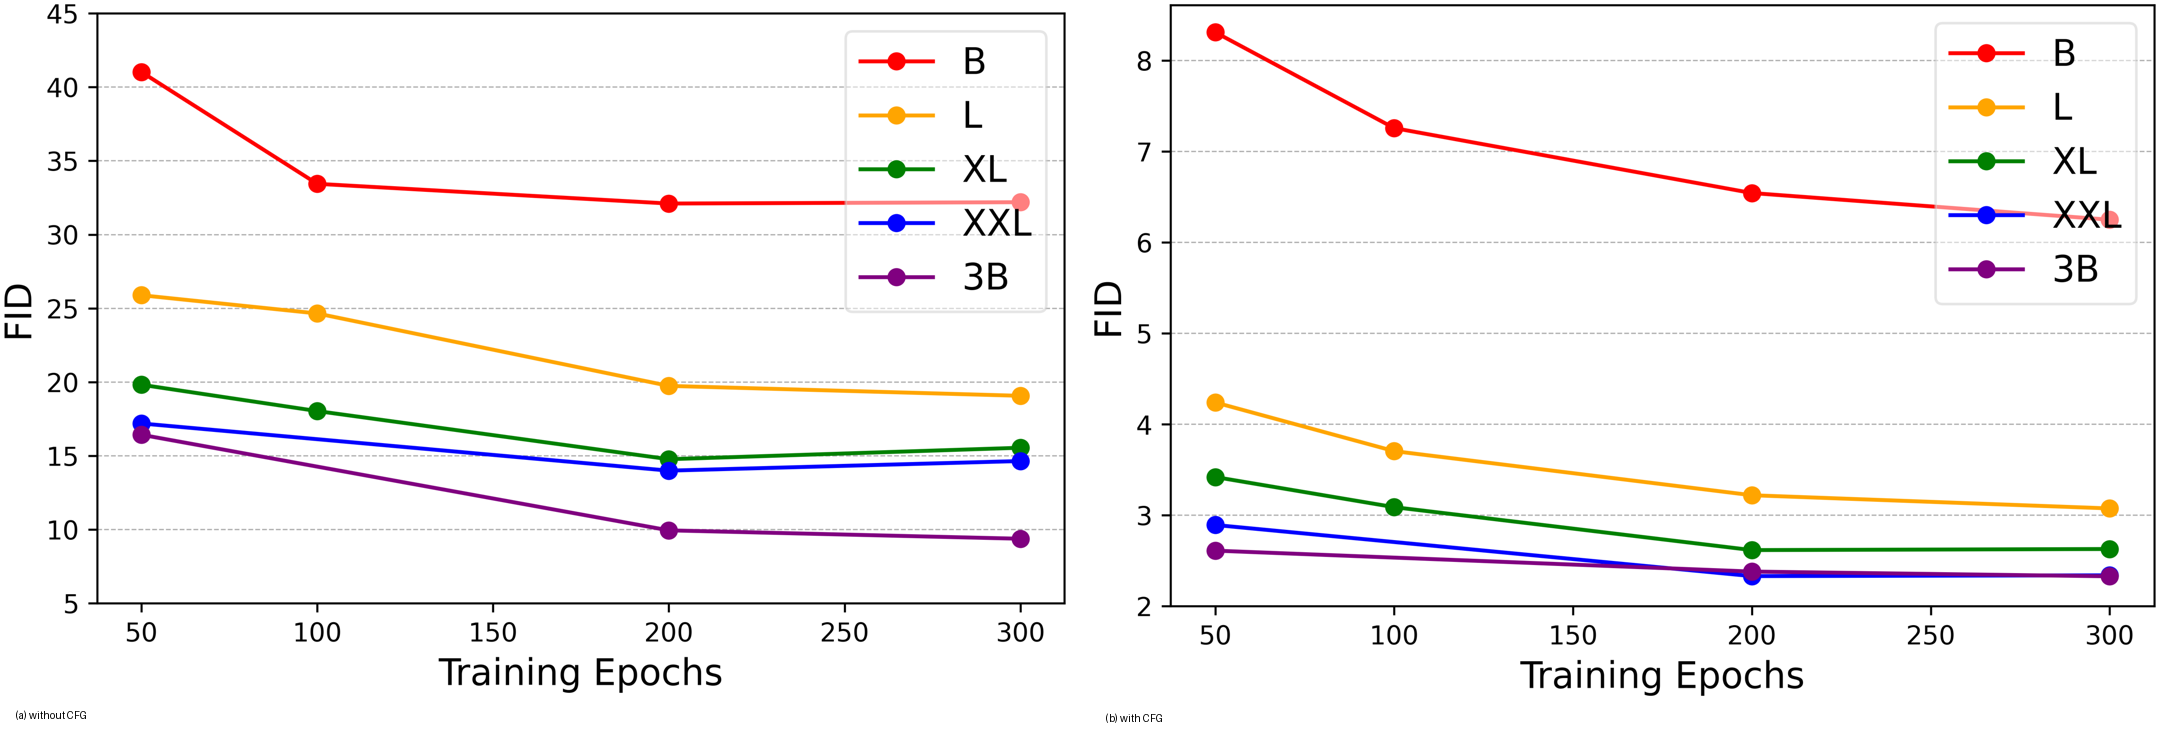
图2把有无CFG的情况分别展示。增大规模通常改善FID,但XXL到3B的收益较小。论文提出数据量可能限制进一步扩展:ImageNet约百万图像,继续增加参数未必能获得等比例有效监督。这是对现象的合理解释,尚不是严格控制数据与算力后的因果证明。
LlamaGen展示了规模扩展趋势,但没有像某些Scaling Law研究那样给出普适幂律及跨预算预测验证。讨论它时,应把"扩展有效"与"已经得到可靠的资源最优扩展定律"区分开。
8. LlamaGen采样:CFG优化的是质量与覆盖的折中
条件logits为 ℓ c \ell_c ℓc,无条件logits为 ℓ u \ell_u ℓu,CFG按下式组合:
ℓ g = ℓ u + s ( ℓ c − ℓ u ) . \ell_g=\ell_u+s(\ell_c-\ell_u). ℓg=ℓu+s(ℓc−ℓu).
然后对组合后的logits执行温度调节、截断和采样。 s = 1 s=1 s=1对应条件logits, s > 1 s>1 s>1进一步强调条件与无条件分布的差异。它改变生成分布,而不是保证逐token预测"更正确"。
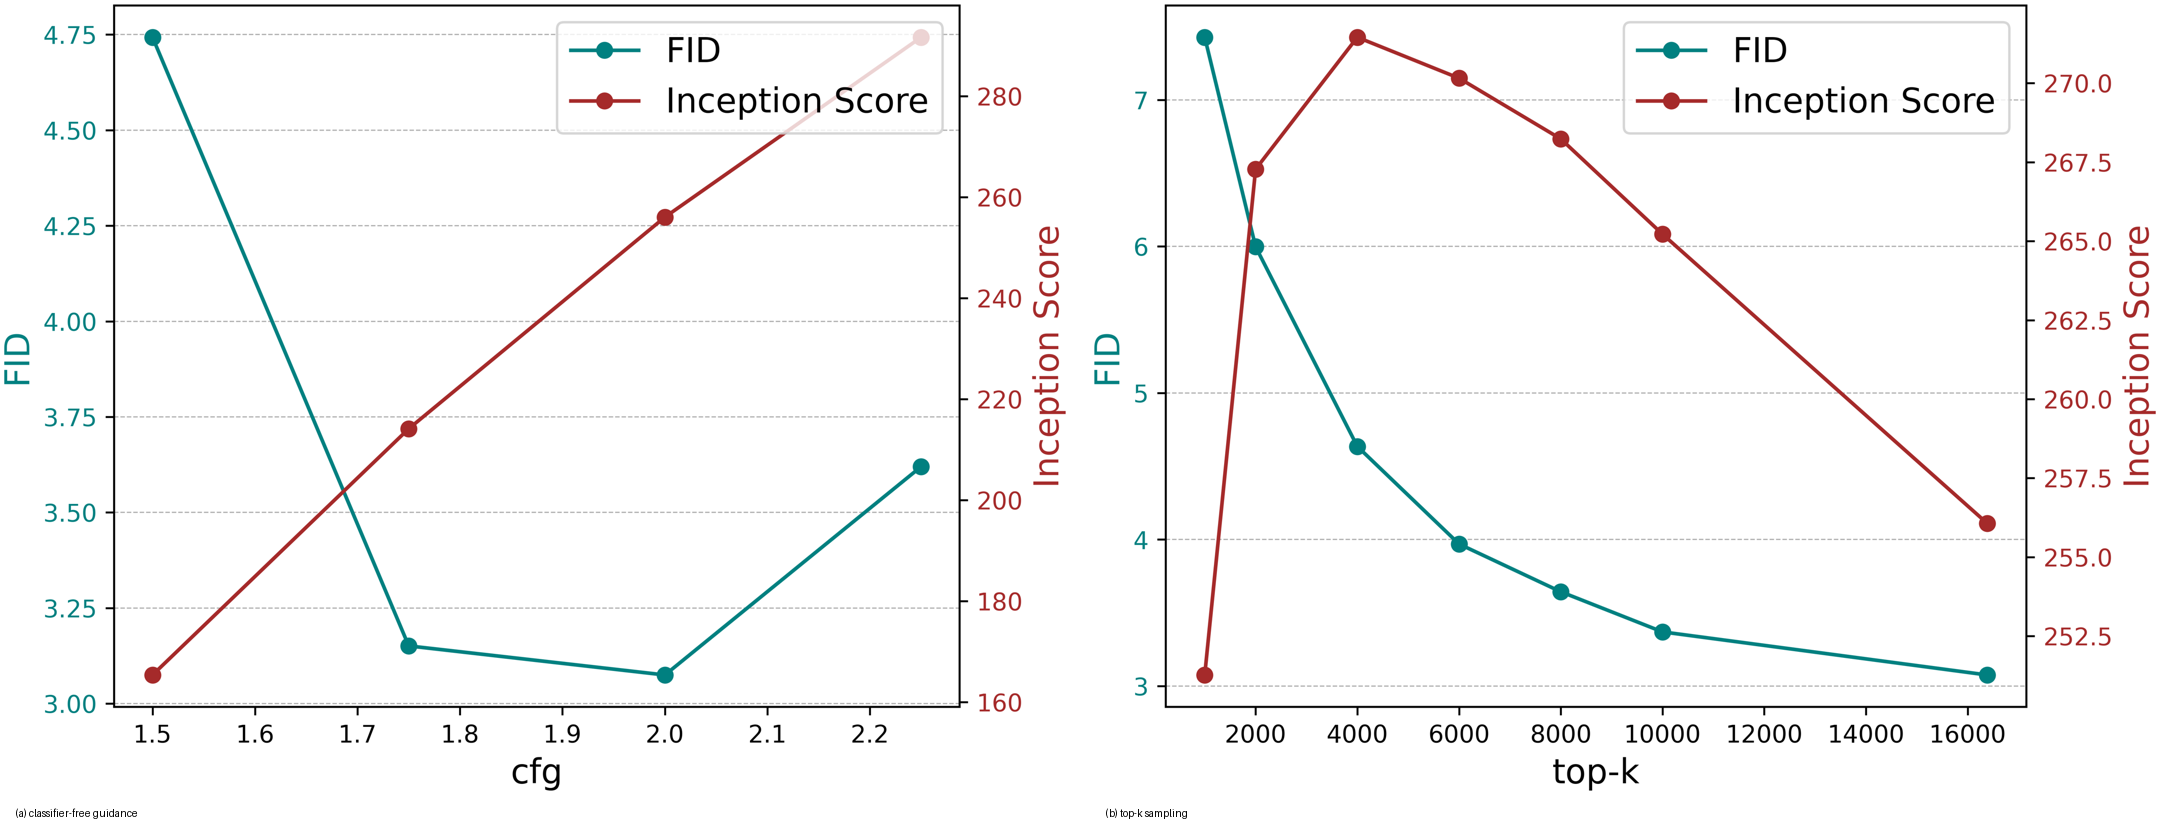
图3采用LlamaGen-L检查采样配置。CFG增大后,FID先改善后退化,而IS可以继续上升。这说明FID和IS不能互换:更集中、更容易分类的图像可能提高IS,却减少对真实分布的覆盖。
Top-k过小会过早剪掉候选码字,在这些实验中不利于整体FID。论文默认Top-k=0,含义是使用整个码本,不是保留零个候选;Top-p=1.0也表示不额外做核采样截断。这样的配置并不是所有数据与任务的通用最优解。
下列伪代码概括推理逻辑,省略具体批处理、RoPE索引和缓存实现:
python
prefix_cond = encode_condition(condition)
prefix_null = learned_null_condition()
cache_cond, cache_null = prefill(prefix_cond), prefill(prefix_null)
image_tokens = []
for position in range(image_token_count):
    logits_cond = next_logits(cache_cond)
    logits_null = next_logits(cache_null)
    logits = logits_null + cfg * (logits_cond - logits_null)
    token = sample(logits, temperature=1.0, top_k=0, top_p=1.0)
    image_tokens.append(token)
    append_token(cache_cond, token)
    append_token(cache_null, token)
image = visual_decoder(image_tokens)
关键是两个条件分支使用同一条已经采样的视觉序列,但保留各自条件对应的上下文。CFG通常增加推理计算和缓存占用,不能在比较吞吐时把它当作免费能力。
9. LlamaGen的2.18 FID:论文标题需要多大的证据边界
表6|ImageNet类别条件生成完整比较。 -re表示rejection sampling;不同CFG分别保留。参数列沿用该表口径,不代表各系统所有辅助模块的总参数。
| 类型 | 模型与采样 | 参数 | FID ↓ | IS ↑ | Precision ↑ | Recall ↑ |
|---|---|---|---|---|---|---|
| GAN | BigGAN | 112M | 6.95 | 224.5 | 0.89 | 0.38 |
| GAN | GigaGAN | 569M | 3.45 | 225.5 | 0.84 | 0.61 |
| GAN | StyleGan-XL | 166M | 2.30 | 265.1 | 0.78 | 0.53 |
| Diffusion | ADM | 554M | 10.94 | 101.0 | 0.69 | 0.63 |
| Diffusion | CDM | - | 4.88 | 158.7 | - | - |
| Diffusion | LDM-4 | 400M | 3.60 | 247.7 | - | - |
| Diffusion | DiT-XL/2 | 675M | 2.27 | 278.2 | 0.83 | 0.57 |
| Mask. | MaskGIT | 227M | 6.18 | 182.1 | 0.80 | 0.51 |
| Mask. | MaskGIT-re | 227M | 4.02 | 355.6 | - | - |
| AR | VQGAN | 227M | 18.65 | 80.4 | 0.78 | 0.26 |
| AR | VQGAN | 1.4B | 15.78 | 74.3 | - | - |
| AR | VQGAN-re | 1.4B | 5.20 | 280.3 | - | - |
| AR | ViT-VQGAN | 1.7B | 4.17 | 175.1 | - | - |
| AR | ViT-VQGAN-re | 1.7B | 3.04 | 227.4 | - | - |
| AR | RQTran. | 3.8B | 7.55 | 134.0 | - | - |
| AR | RQTran.-re | 3.8B | 3.80 | 323.7 | - | - |
| AR | LlamaGen-B (cfg=2.00) | 111M | 5.46 | 193.61 | 0.83 | 0.45 |
| AR | LlamaGen-L (cfg=2.00) | 343M | 3.07 | 256.06 | 0.83 | 0.52 |
| AR | LlamaGen-XL (cfg=1.75) | 775M | 2.62 | 244.08 | 0.80 | 0.57 |
| AR | LlamaGen-XXL (cfg=1.75) | 1.4B | 2.34 | 253.90 | 0.80 | 0.59 |
| AR | LlamaGen-3B (cfg=1.65) | 3.1B | 2.18 | 263.33 | 0.81 | 0.58 |
| AR | LlamaGen-3B (cfg=1.75) | 3.1B | 2.32 | 280.10 | 0.82 | 0.56 |
| AR | LlamaGen-3B (cfg=2.00) | 3.1B | 2.81 | 311.59 | 0.84 | 0.54 |
LlamaGen-3B在CFG 1.65时,主表报告FID 2.18,低于DiT-XL/2的2.27。它证明普通自回归路线可以达到强视觉生成基线;但主干规模为3.1B,对照DiT为675M,训练计算也未被统一。这不能改写成"相同参数、相同算力下自回归必然优于扩散"。
同一3B模型把CFG提高到2.0,FID变为2.81,IS却提高至311.59,Precision上升、Recall下降。比起单一最低分,这组变化更接近实际选型问题:用户需要更稳定的典型图像,还是更广的多样性覆盖?
附录对应最优配置给出FID 2.189,主表以2.18展示。按常规四舍五入到两位应为2.19,本文分别保留主表与附录精度,不借这处差异声称额外优势。没有重复运行方差或置信区间时,接近的指标差值也不应自动解释成稳健的普适领先。
10. LlamaGen文生图:两阶段训练同时改变了数据与分辨率
文生图主干为775M,文本由FLAN-T5 XL编码,最长文本embedding序列为120,使用左侧padding实现批处理。第一阶段使用50M LAION-COCO子集,图像分辨率为256;第二阶段使用10M内部高审美图像,分辨率提升至512。视觉tokenizer在两阶段主干训练前,也先在两类数据的联合集合上微调。
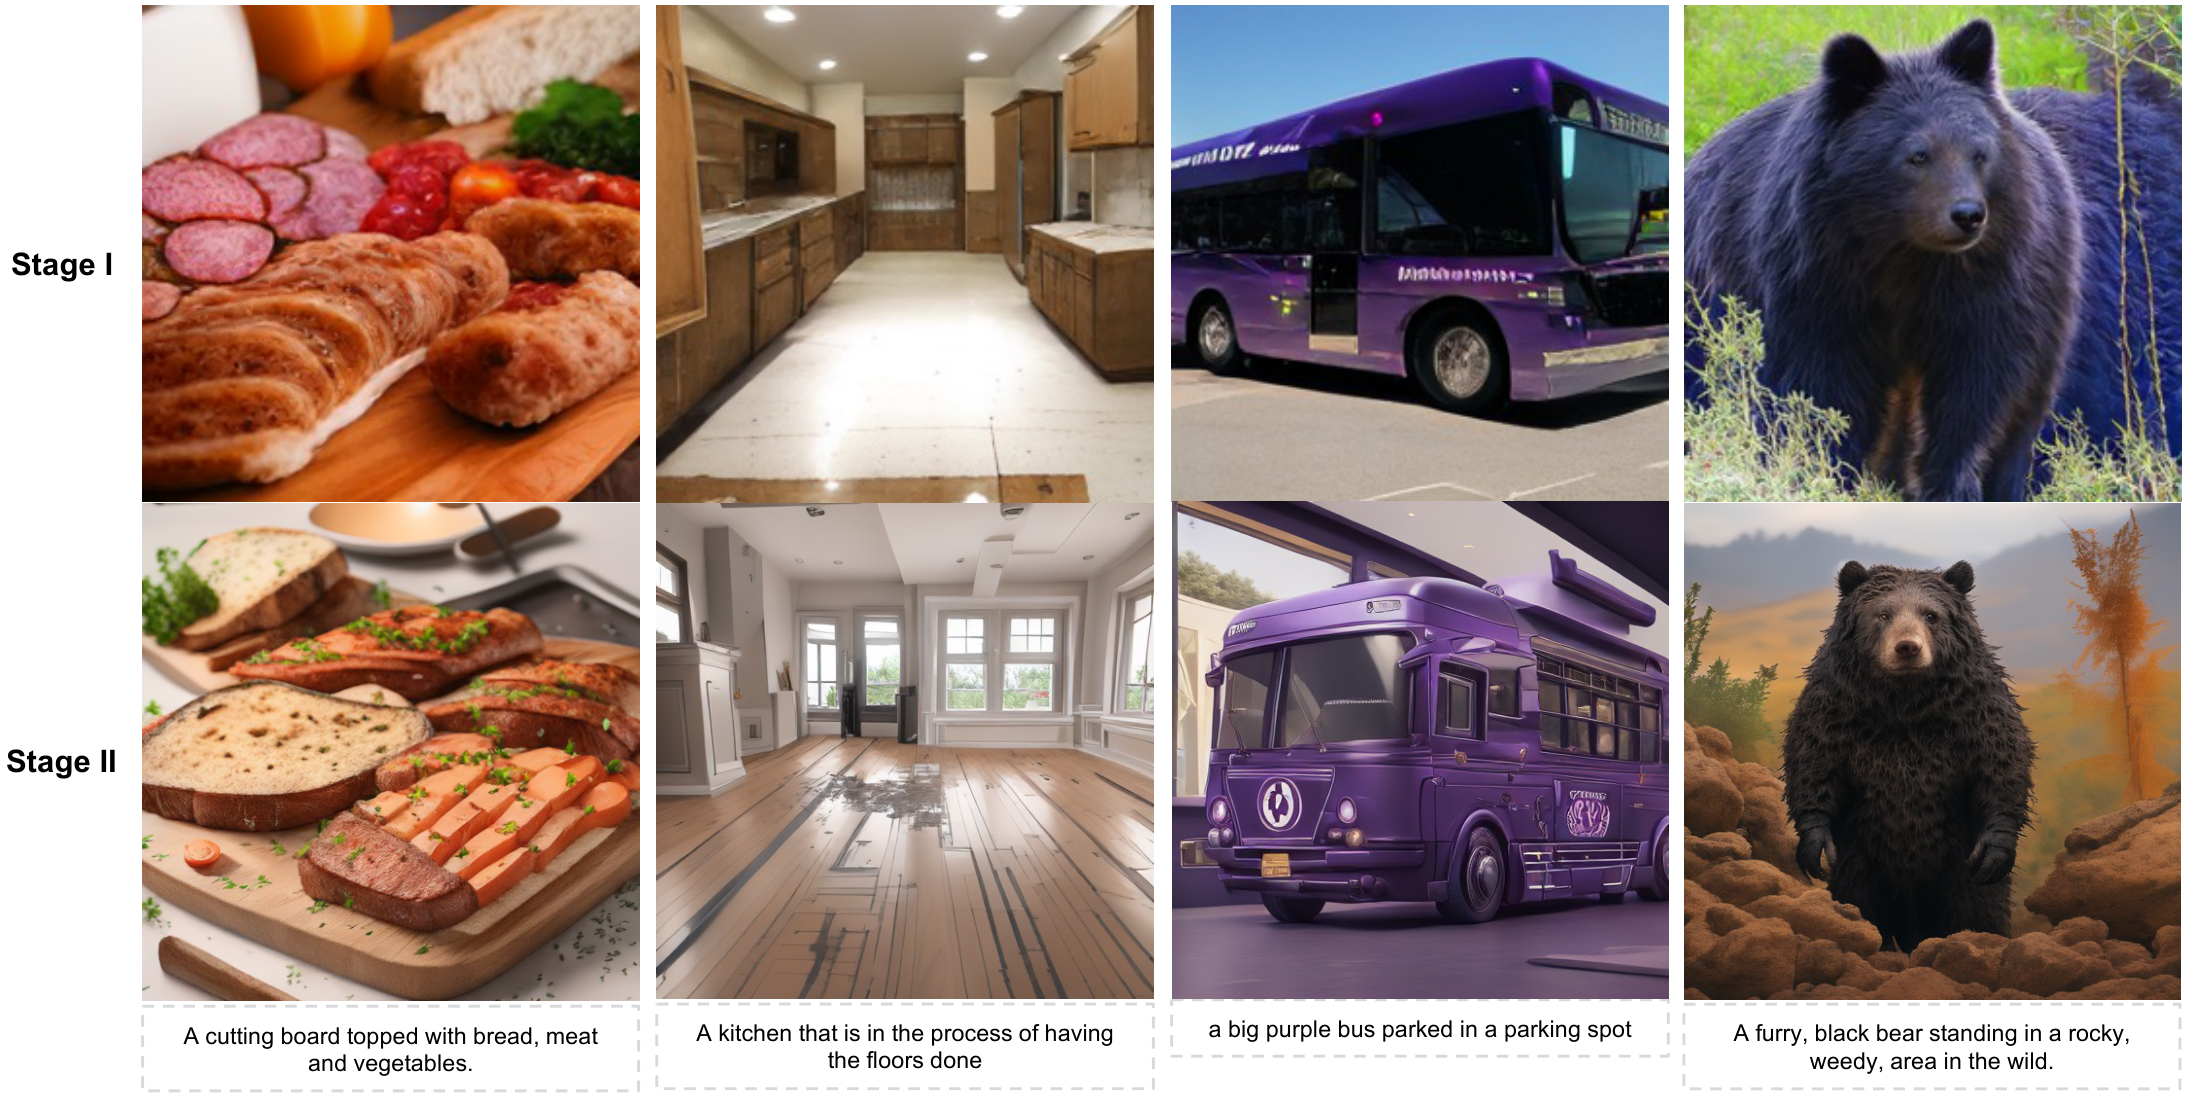
图4在COCOPrompts上比较两阶段输出。第二阶段视觉细节与审美改善明显,但数据分布、分辨率和训练过程一起变化,因此不能单独归因于"多训练了10M图"或"只提高分辨率"。
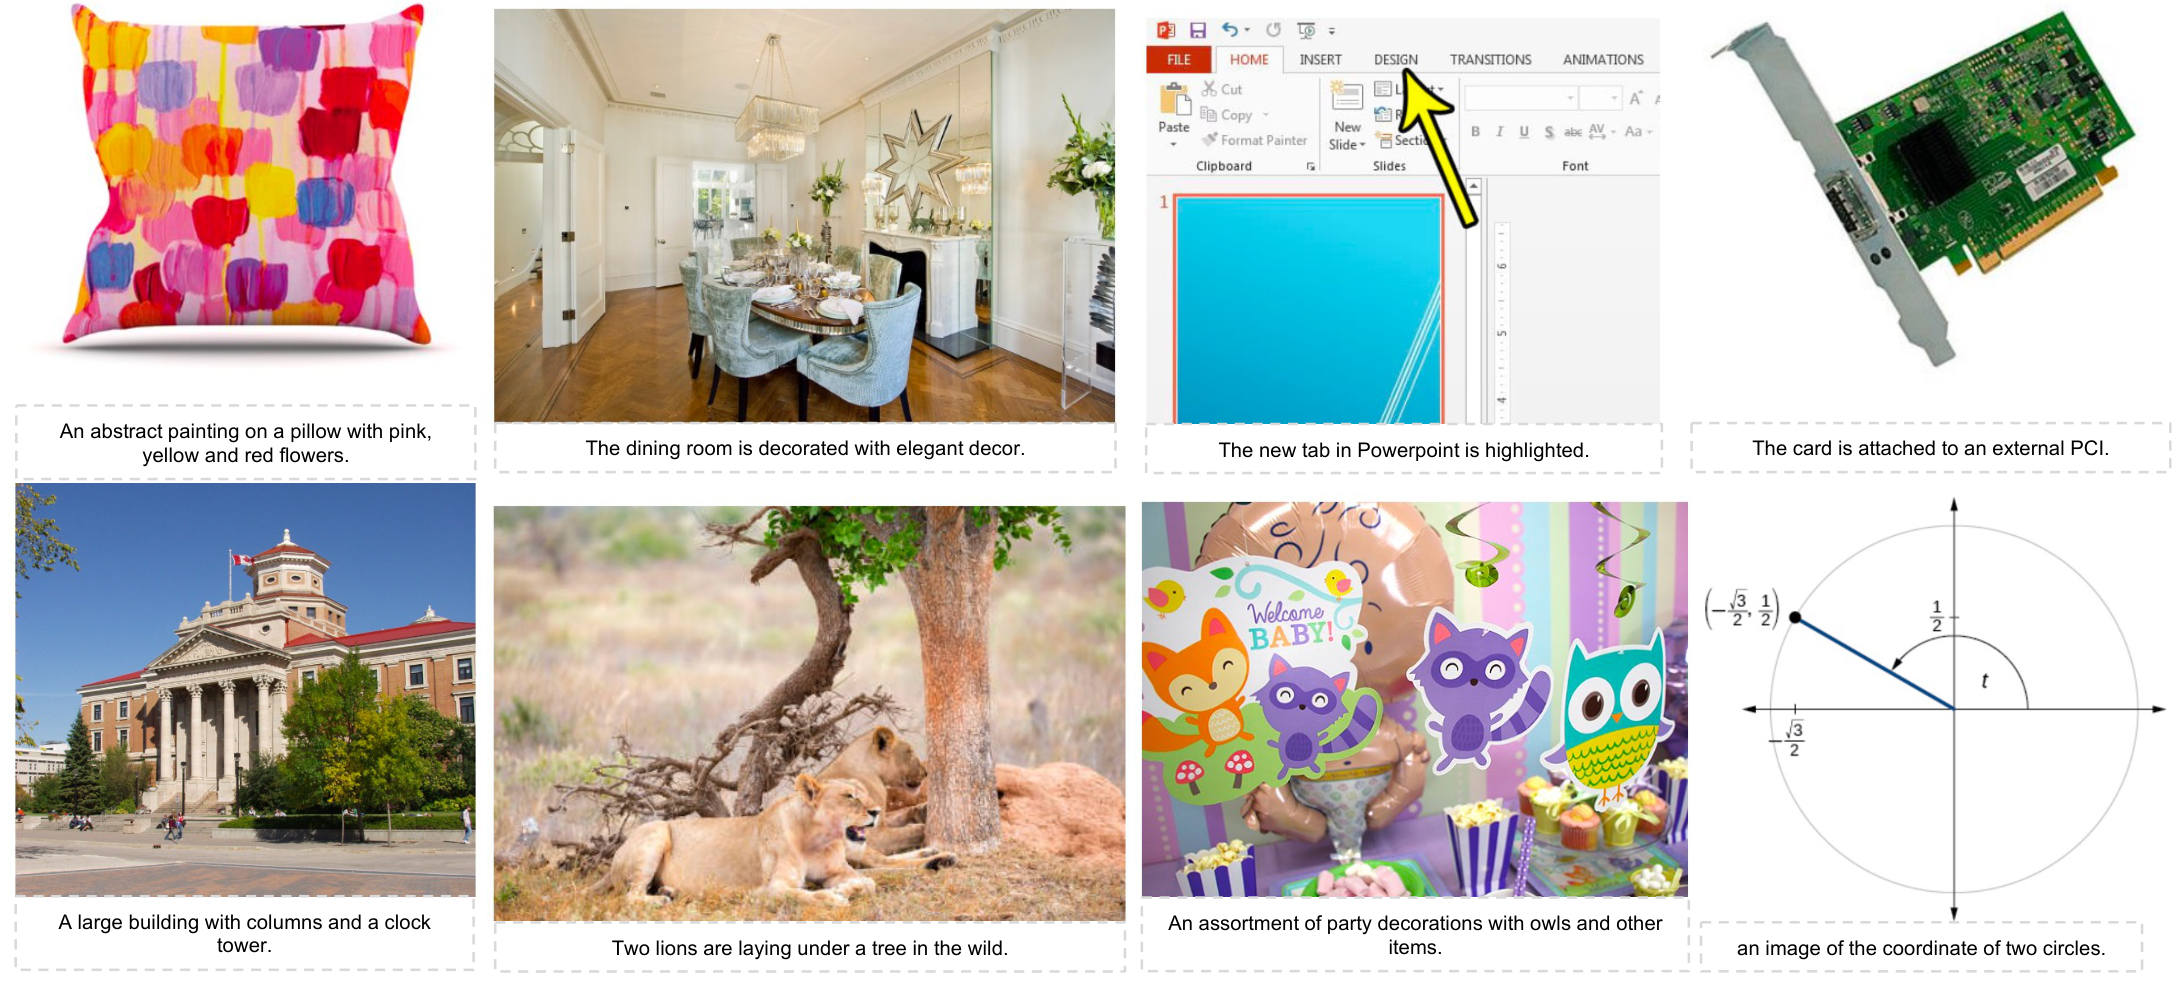
图5展示第一阶段数据。50M子集由原始LAION-COCO集合按照URL有效性、审美、水印、CLIP图文相似度和尺寸筛选而来;图中的短描述对应原有BLIP caption。样例也提醒我们:自动标注和真实可见内容可能不完全一致,长文本本身不构成高质量监督的保证。
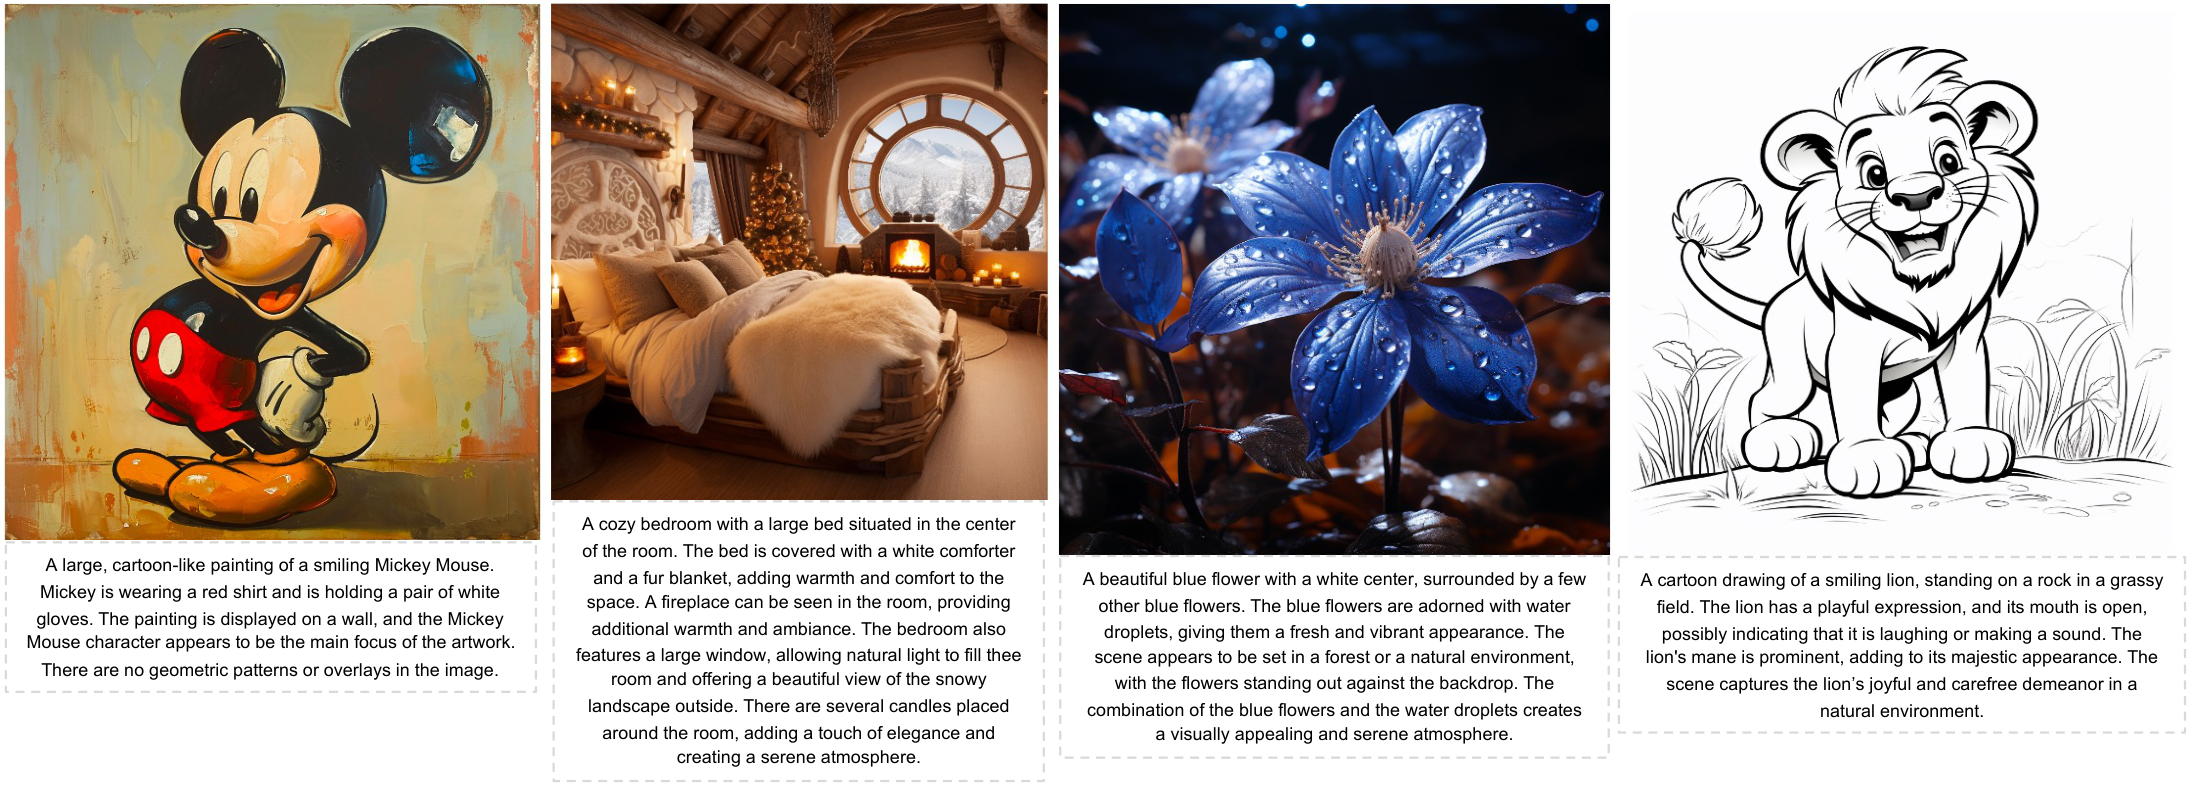
图6展示第二阶段内部高审美数据,长描述由LLaVA生成。作者还将长描述首句作为短描述来增强训练。细致caption帮助模型学习对象、属性和关系,但也可能把captioner的幻觉写入监督,因此图文一致性与描述长度需要分别评估。
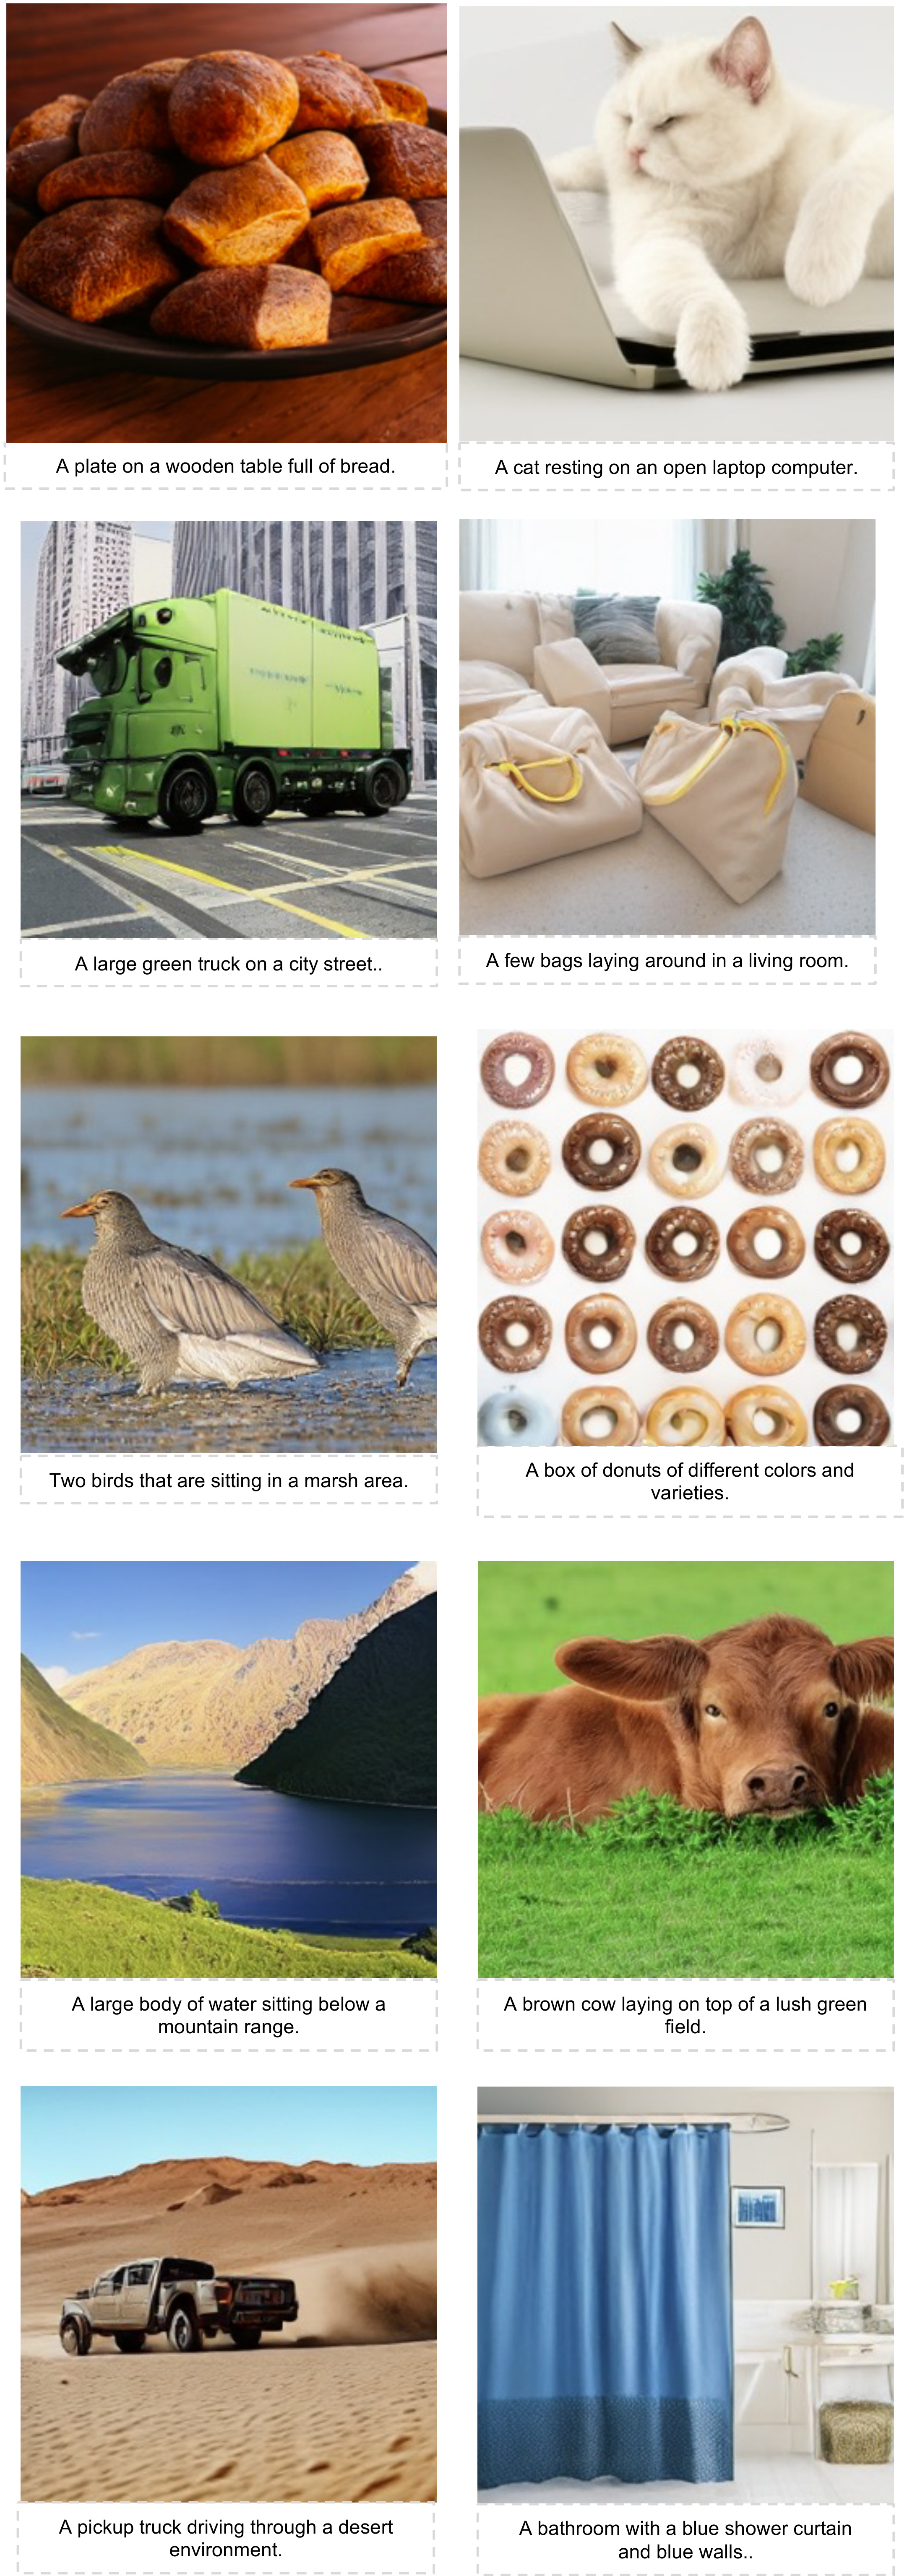
图13体现第一阶段在较常见场景上的文字条件生成。它能展示对象和场景的基础关联,却不能给出随机提示上的错误比例。
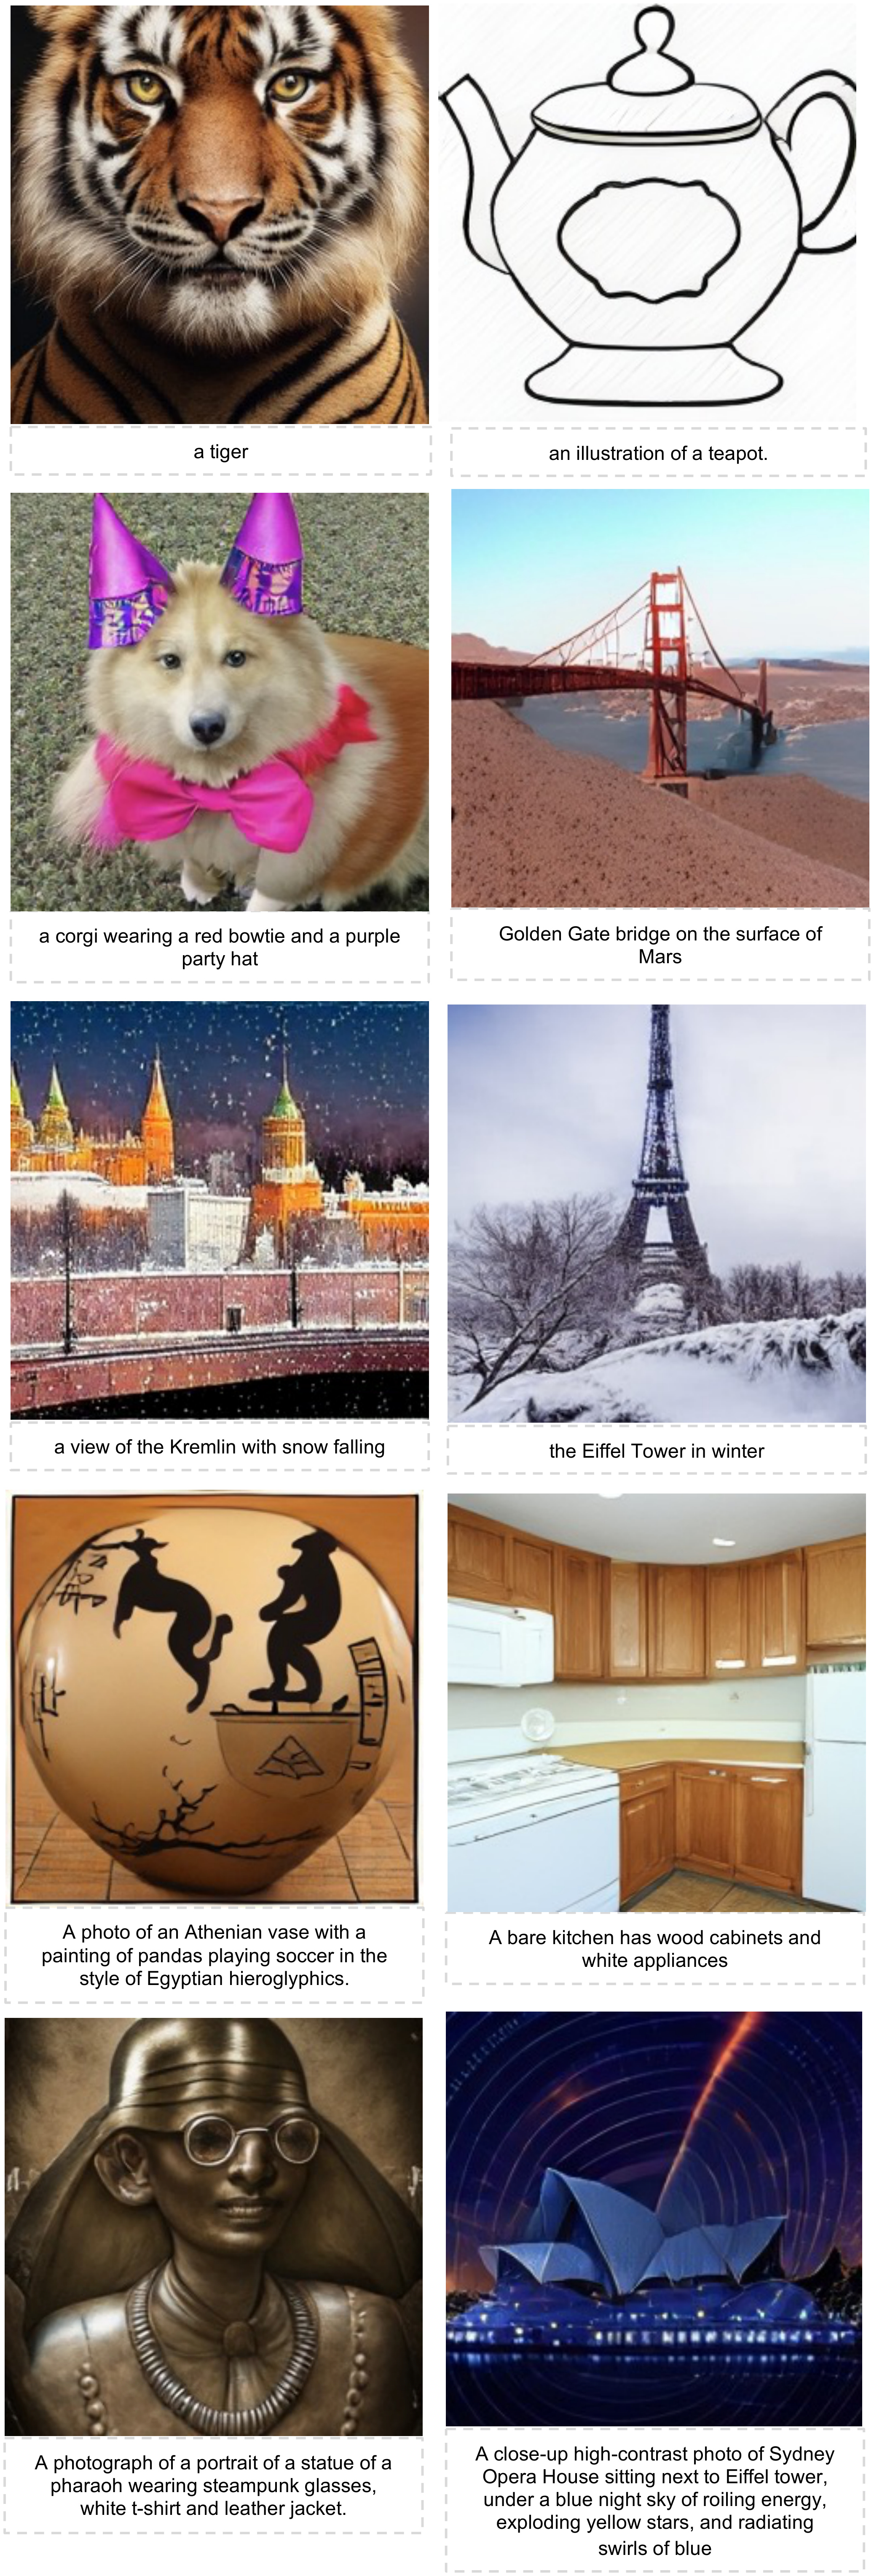
图14使用更长、更复杂的PartiPrompts,帮助观察跨对象组合、风格与细节约束。单张"看起来符合"的结果,应与提示中的每项约束逐一对应,而不只评价整体美感。
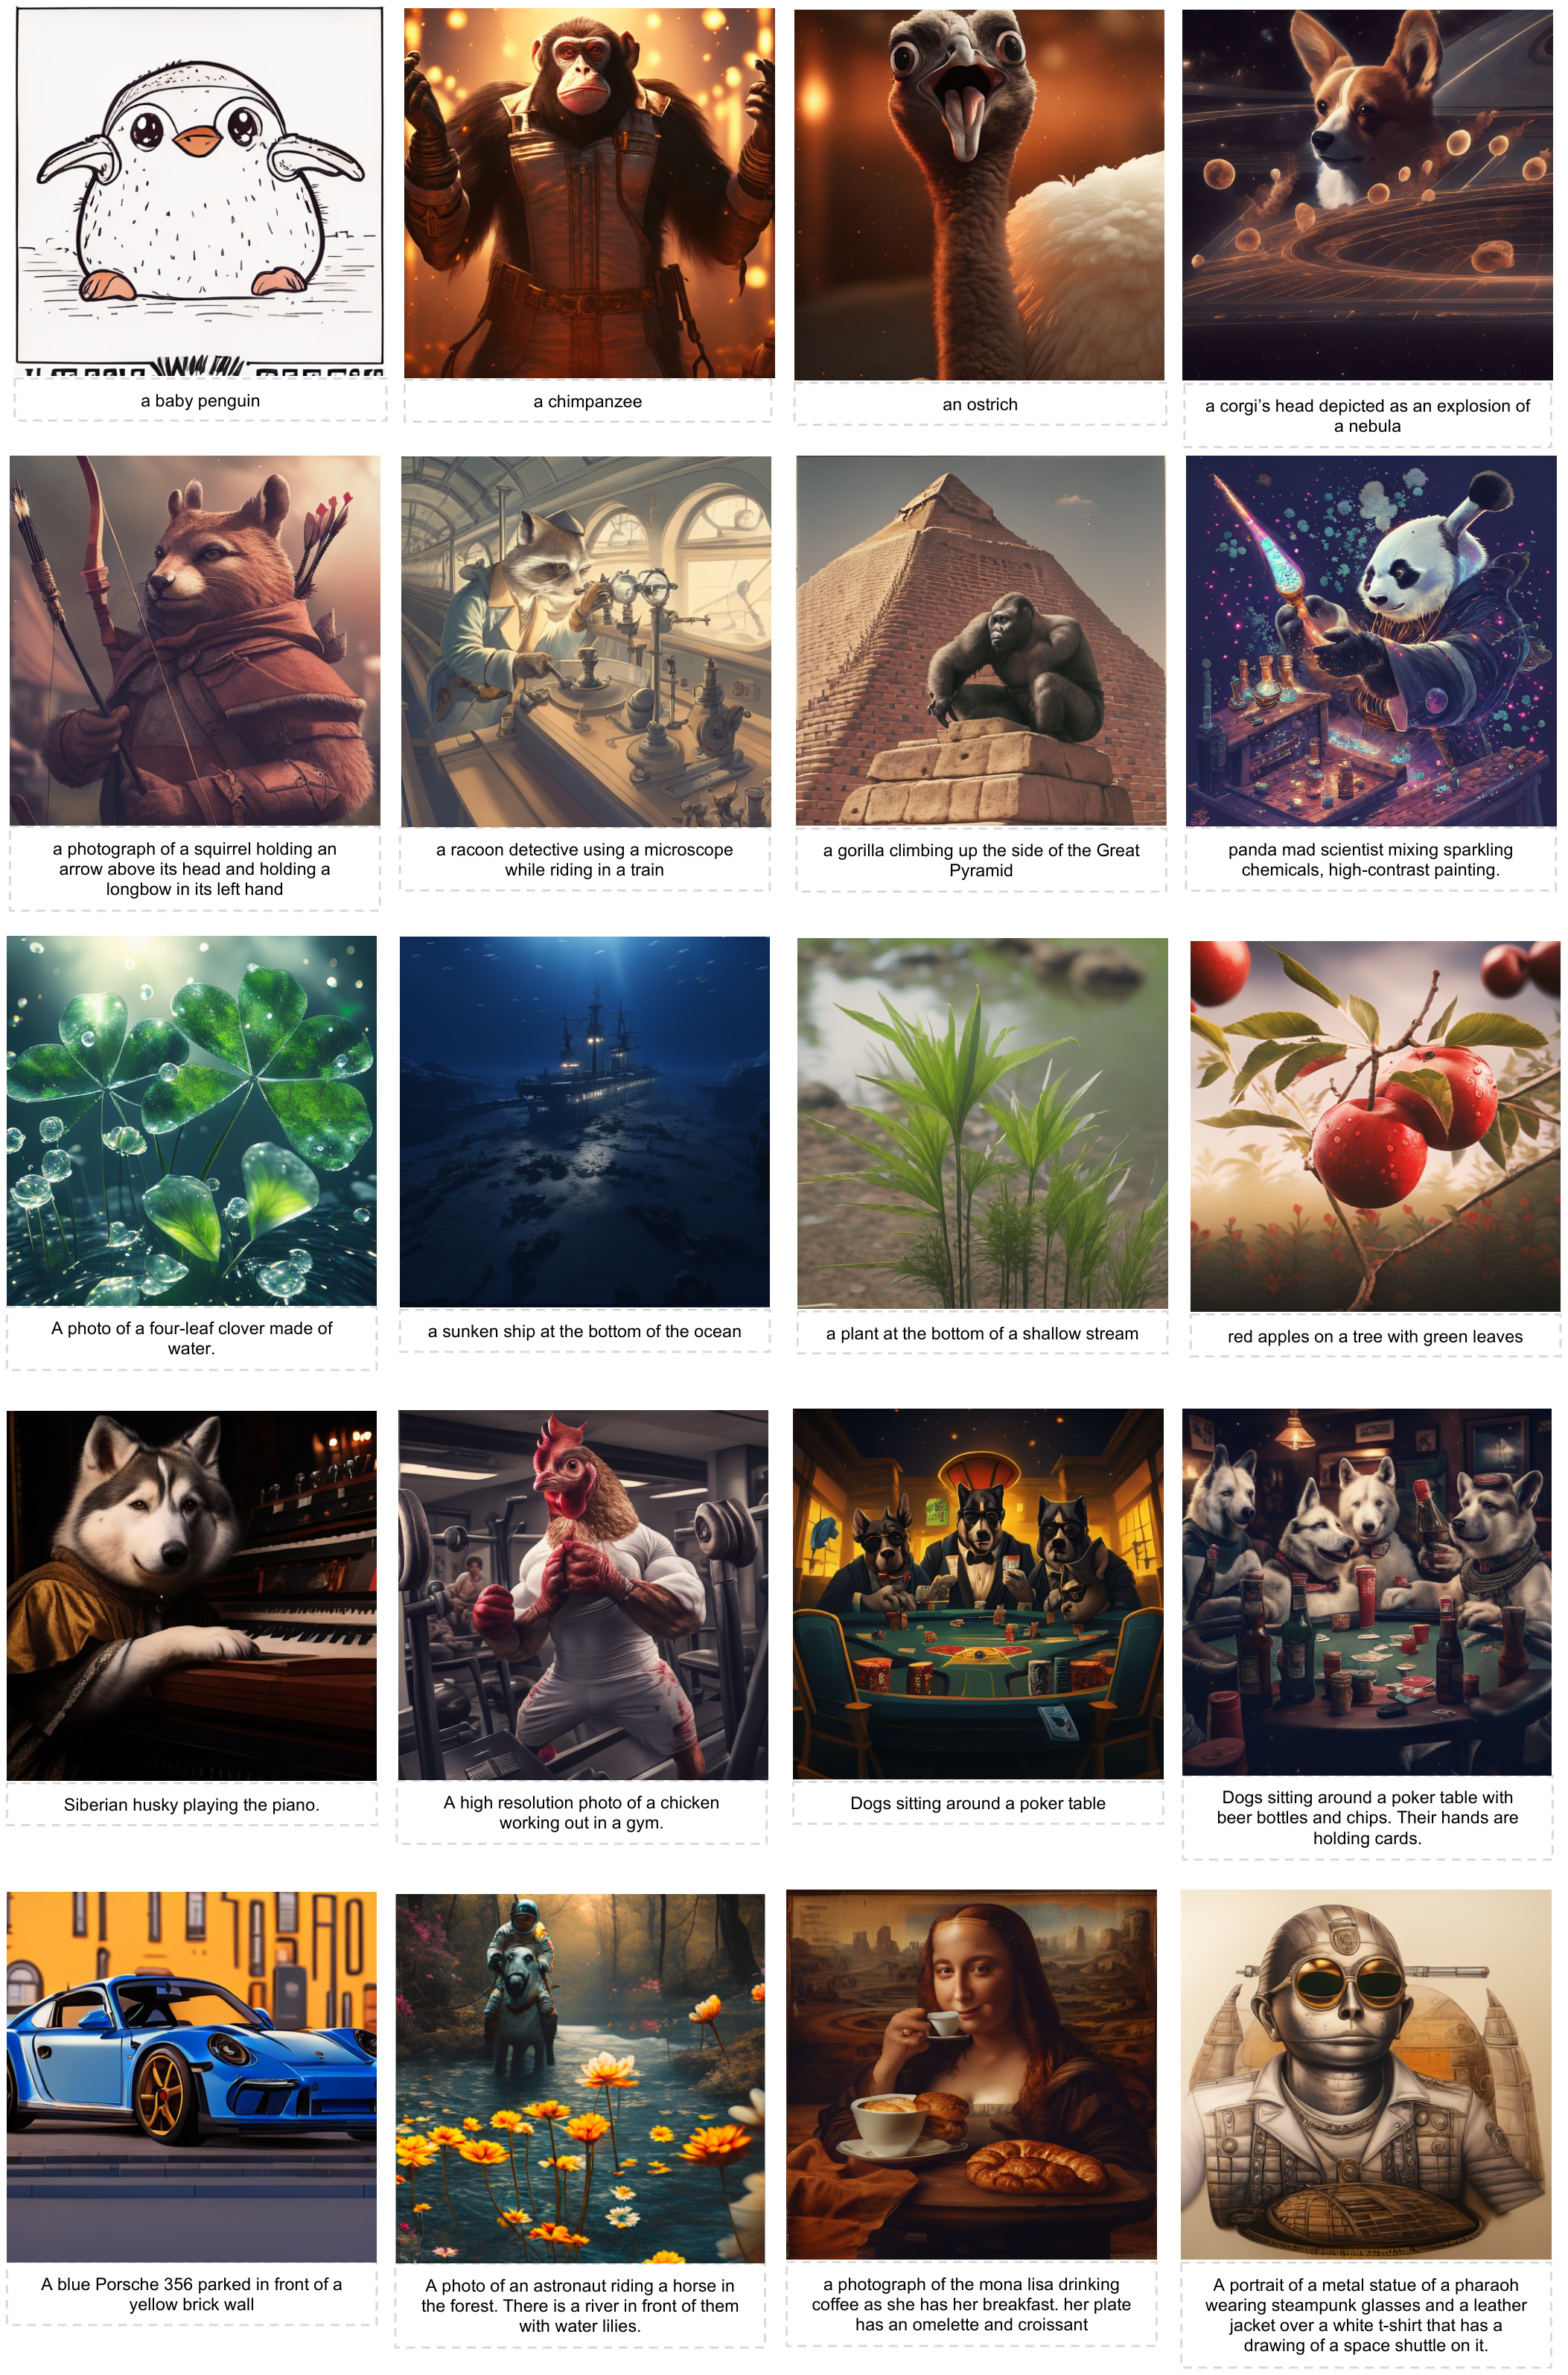
图15展示512分辨率第二阶段模型的结果。论文承认文字渲染、计数和常识错误依然存在,并明确表示当时发布的模型仍落后于部分更先进扩散生成系统。该文生图部分主要是定性展示,缺少足以支持开放域全面领先的系统性量化评测。
Rocky认为,这里的价值是一个可以继续扩展的开放研究基线:研究者能够把数据、码率、主干和采样拆开验证。若直接把精选样例当作产品可用性结论,就会忽略提示遵循、失败重试与总成本这几项上线条件。
11. LlamaGen推理优化:复用LLM基础设施,仍需核算端到端成本
表7|vLLM推理时间。 一批包含16条模型序列,使用CFG后对应8张输出图像,图像分辨率为384。基线已经启用KV Cache。
| 模型 | 参数 | 基线秒数 | vLLM秒数 | 论文加速比 |
|---|---|---|---|---|
| B | 111M | 7.80 | 2.39 | 326% |
| L | 343M | 13.72 | 3.48 | 380% |
| XL | 775M | 19.76 | 4.84 | 408% |
| XXL | 1.4B | 26.38 | 6.36 | 414% |
论文将加速比写为326%---414%。以B模型的7.80秒和2.39秒计算,吞吐倍率约为3.26倍,等价于吞吐提升约226%,不能再解释为"在原有基础上增加326%,达到4.26倍"。
L模型行还存在内部不一致:13.72除以3.48约为3.94,而表内写为380%。本文保留其报告值,并明确算术差异;不根据这行重新推断未公开的实验条件。
vLLM收益来自更加成熟的自回归推理实现,而非消除了逐token依赖。论文中3B主干每头维度为100,当时vLLM的PagedAttention不支持这一head size,因此表7没有3B结果。不能把111M---1.4B的加速倍率直接外推给最大模型。
工程选型时至少应分别测量主干生成、视觉解码、CFG开销、不同batch和不同序列长度。将一批8张图的耗时直接除以8,可以估算该设置下的平均吞吐成本,却不能当作单请求首图延迟。
12. LlamaGen附录实验:保留完整配置,避免用最优点遮住趋势
以下保留三张附录表,统一Top-k为全码本、Top-p与temperature为1.0。第一张使用256分辨率生成;后两张使用384生成,再缩放到256评测。每行同时绑定模型、epoch与CFG,便于检查成绩变化来自哪里。
表8|256分辨率生成的全部详细结果。
| 模型 | 参数 | epochs | CFG | FID ↓ | IS ↑ | sFID ↓ | Precision ↑ | Recall ↑ |
|---|---|---|---|---|---|---|---|---|
| B | 111M | 50 | no | 31.352 | 39.576 | 8.749 | 0.568 | 0.614 |
| B | 111M | 50 | 1.50 | 11.984 | 95.400 | 7.335 | 0.738 | 0.517 |
| B | 111M | 50 | 1.75 | 8.690 | 124.435 | 7.165 | 0.789 | 0.469 |
| B | 111M | 50 | 2.00 | 7.390 | 153.974 | 7.250 | 0.832 | 0.417 |
| B | 111M | 50 | 2.25 | 7.220 | 178.281 | 7.489 | 0.861 | 0.384 |
| B | 111M | 50 | 2.50 | 7.824 | 197.511 | 7.857 | 0.882 | 0.349 |
| B | 111M | 300 | no | 26.262 | 48.072 | 9.216 | 0.593 | 0.616 |
| B | 111M | 300 | 1.50 | 8.738 | 120.602 | 7.668 | 0.751 | 0.535 |
| B | 111M | 300 | 1.75 | 6.116 | 159.123 | 7.364 | 0.799 | 0.492 |
| B | 111M | 300 | 2.00 | 5.464 | 193.613 | 7.503 | 0.839 | 0.457 |
| B | 111M | 300 | 2.25 | 5.641 | 220.720 | 7.668 | 0.863 | 0.411 |
| B | 111M | 300 | 2.50 | 6.390 | 246.565 | 8.041 | 0.883 | 0.382 |
| L | 343M | 50 | no | 21.812 | 59.179 | 8.772 | 0.616 | 0.640 |
| L | 343M | 50 | 1.50 | 5.781 | 153.792 | 7.096 | 0.774 | 0.555 |
| L | 343M | 50 | 1.75 | 4.218 | 200.001 | 7.015 | 0.824 | 0.509 |
| L | 343M | 50 | 2.00 | 4.317 | 242.112 | 7.077 | 0.859 | 0.468 |
| L | 343M | 300 | no | 13.452 | 82.289 | 8.324 | 0.656 | 0.638 |
| L | 343M | 300 | 1.50 | 4.079 | 198.504 | 8.157 | 0.800 | 0.552 |
| L | 343M | 300 | 1.75 | 3.805 | 248.280 | 8.487 | 0.833 | 0.515 |
| L | 343M | 300 | 2.00 | 4.407 | 288.170 | 8.871 | 0.858 | 0.481 |
| XL | 775M | 50 | no | 19.417 | 66.196 | 8.911 | 0.610 | 0.665 |
| XL | 775M | 50 | 1.50 | 4.808 | 172.170 | 7.298 | 0.767 | 0.585 |
| XL | 775M | 50 | 1.75 | 3.391 | 227.081 | 7.022 | 0.812 | 0.542 |
| XL | 775M | 50 | 2.00 | 3.642 | 268.779 | 7.244 | 0.846 | 0.502 |
| XXL | 1.4B | 50 | no | 16.822 | 74.888 | 9.285 | 0.628 | 0.660 |
| XXL | 1.4B | 50 | 1.50 | 3.844 | 195.527 | 7.496 | 0.781 | 0.577 |
| XXL | 1.4B | 50 | 1.75 | 3.094 | 253.609 | 7.305 | 0.825 | 0.529 |
| XXL | 1.4B | 50 | 2.00 | 3.644 | 296.521 | 7.410 | 0.857 | 0.511 |
| 3B | 3.1B | 50 | no | 13.581 | 87.902 | 7.781 | 0.648 | 0.666 |
| 3B | 3.1B | 50 | 1.50 | 3.050 | 222.330 | 6.489 | 0.801 | 0.575 |
| 3B | 3.1B | 50 | 1.75 | 3.063 | 279.716 | 6.686 | 0.843 | 0.538 |
| 3B | 3.1B | 50 | 2.00 | 4.212 | 325.150 | 7.027 | 0.869 | 0.492 |
| validation data | 1.684 | 231.811 | 3.692 | 0.752 | 0.671 |
表8可以看到,某个CFG在较早epoch表现较好,并不保证在训练更久后继续最优。无CFG与有CFG结果的差距也说明,只比较各模型最终调好的最优点,会隐藏采样对成绩的贡献。
表9|384分辨率生成的B、L详细结果。 v1的表9、表10将IS和sFID表头顺序写反;数据序列本身与表5、表6可对应核对。例如B、50 epoch、CFG 1.75的92.447对应表5的IS 92.44。以下按数值含义标为IS、sFID,所有原始数值保持不变。
| 模型 | 参数 | epochs | CFG | FID ↓ | IS ↑ | sFID ↓ | Precision ↑ | Recall ↑ |
|---|---|---|---|---|---|---|---|---|
| B | 111M | 50 | no | 41.025 | 30.788 | 9.825 | 0.523 | 0.605 |
| B | 111M | 50 | 1.50 | 18.276 | 69.337 | 7.557 | 0.677 | 0.534 |
| B | 111M | 50 | 1.75 | 12.899 | 92.447 | 6.900 | 0.738 | 0.487 |
| B | 111M | 50 | 2.00 | 10.029 | 116.372 | 6.562 | 0.787 | 0.443 |
| B | 111M | 50 | 2.25 | 8.674 | 136.621 | 6.428 | 0.818 | 0.413 |
| B | 111M | 50 | 2.50 | 8.309 | 154.719 | 6.599 | 0.843 | 0.376 |
| B | 111M | 50 | 2.75 | 8.391 | 168.629 | 6.708 | 0.860 | 0.345 |
| B | 111M | 100 | no | 33.442 | 37.528 | 9.872 | 0.536 | 0.609 |
| B | 111M | 100 | 1.50 | 15.629 | 77.247 | 7.632 | 0.698 | 0.529 |
| B | 111M | 100 | 1.75 | 10.676 | 104.581 | 6.960 | 0.754 | 0.490 |
| B | 111M | 100 | 2.00 | 8.298 | 128.941 | 6.671 | 0.795 | 0.452 |
| B | 111M | 100 | 2.25 | 7.256 | 152.502 | 6.510 | 0.827 | 0.416 |
| B | 111M | 100 | 2.50 | 7.151 | 172.677 | 6.517 | 0.850 | 0.390 |
| B | 111M | 200 | no | 32.105 | 37.993 | 10.144 | 0.559 | 0.618 |
| B | 111M | 200 | 1.50 | 12.206 | 90.783 | 7.531 | 0.716 | 0.534 |
| B | 111M | 200 | 1.75 | 8.535 | 118.399 | 7.024 | 0.766 | 0.503 |
| B | 111M | 200 | 2.00 | 6.951 | 146.077 | 6.784 | 0.808 | 0.459 |
| B | 111M | 200 | 2.25 | 6.542 | 167.825 | 6.695 | 0.833 | 0.428 |
| B | 111M | 200 | 2.50 | 6.632 | 188.157 | 6.811 | 0.853 | 0.393 |
| B | 111M | 300 | no | 32.196 | 39.877 | 11.838 | 0.570 | 0.611 |
| B | 111M | 300 | 1.50 | 12.012 | 95.553 | 8.897 | 0.725 | 0.528 |
| B | 111M | 300 | 1.75 | 8.012 | 127.957 | 8.088 | 0.778 | 0.498 |
| B | 111M | 300 | 2.00 | 6.437 | 157.173 | 7.487 | 0.814 | 0.456 |
| B | 111M | 300 | 2.25 | 6.092 | 182.538 | 7.244 | 0.845 | 0.416 |
| B | 111M | 300 | 2.50 | 6.249 | 203.886 | 6.981 | 0.861 | 0.389 |
| B | 111M | 300 | 2.75 | 6.803 | 220.708 | 6.928 | 0.876 | 0.357 |
| L | 343M | 50 | no | 25.889 | 48.053 | 9.612 | 0.570 | 0.655 |
| L | 343M | 50 | 1.50 | 7.905 | 123.830 | 7.381 | 0.732 | 0.569 |
| L | 343M | 50 | 1.75 | 5.018 | 167.310 | 6.786 | 0.784 | 0.524 |
| L | 343M | 50 | 2.00 | 4.240 | 206.739 | 6.483 | 0.825 | 0.491 |
| L | 343M | 50 | 2.25 | 4.589 | 238.890 | 6.325 | 0.850 | 0.451 |
| L | 343M | 100 | no | 24.654 | 53.166 | 10.497 | 0.594 | 0.645 |
| L | 343M | 100 | 1.50 | 6.934 | 138.852 | 7.910 | 0.748 | 0.569 |
| L | 343M | 100 | 1.75 | 4.321 | 188.536 | 7.068 | 0.802 | 0.528 |
| L | 343M | 100 | 2.00 | 3.705 | 228.305 | 6.701 | 0.839 | 0.490 |
| L | 343M | 100 | 2.25 | 4.054 | 263.864 | 6.407 | 0.858 | 0.460 |
| L | 343M | 200 | no | 19.742 | 61.715 | 7.286 | 0.601 | 0.667 |
| L | 343M | 200 | 1.50 | 4.929 | 158.546 | 6.066 | 0.759 | 0.588 |
| L | 343M | 200 | 1.75 | 3.249 | 209.372 | 5.927 | 0.805 | 0.544 |
| L | 343M | 200 | 2.00 | 3.220 | 250.697 | 5.879 | 0.841 | 0.512 |
| L | 343M | 200 | 2.25 | 3.939 | 288.217 | 6.076 | 0.865 | 0.479 |
| L | 343M | 300 | no | 19.070 | 64.349 | 8.668 | 0.607 | 0.670 |
| L | 343M | 300 | 1.50 | 4.743 | 165.381 | 6.740 | 0.758 | 0.596 |
| L | 343M | 300 | 1.75 | 3.151 | 214.152 | 6.310 | 0.803 | 0.552 |
| L | 343M | 300 | 2.00 | 3.075 | 256.067 | 6.088 | 0.832 | 0.522 |
| L | 343M | 300 | 2.25 | 3.620 | 291.695 | 6.122 | 0.854 | 0.493 |
| validation data | 1.684 | 231.811 | 3.692 | 0.752 | 0.671 |
表10|384分辨率生成的XL、XXL与3B详细结果。 表头采用与表9相同的显式校正。
| 模型 | 参数 | epochs | CFG | FID ↓ | IS ↑ | sFID ↓ | Precision ↑ | Recall ↑ |
|---|---|---|---|---|---|---|---|---|
| XL | 775M | 50 | no | 19.820 | 61.363 | 8.067 | 0.601 | 0.669 |
| XL | 775M | 50 | 1.50 | 5.231 | 154.249 | 6.284 | 0.746 | 0.592 |
| XL | 775M | 50 | 1.75 | 3.420 | 202.939 | 6.090 | 0.796 | 0.560 |
| XL | 775M | 50 | 2.00 | 3.238 | 245.680 | 6.023 | 0.826 | 0.529 |
| XL | 775M | 100 | no | 18.037 | 69.879 | 8.388 | 0.616 | 0.665 |
| XL | 775M | 100 | 1.50 | 4.563 | 173.749 | 6.591 | 0.759 | 0.588 |
| XL | 775M | 100 | 1.75 | 3.089 | 225.856 | 6.157 | 0.804 | 0.551 |
| XL | 775M | 100 | 2.00 | 3.105 | 267.608 | 6.001 | 0.833 | 0.531 |
| XL | 775M | 200 | no | 14.772 | 80.826 | 6.840 | 0.620 | 0.681 |
| XL | 775M | 200 | 1.50 | 3.388 | 193.477 | 5.753 | 0.771 | 0.603 |
| XL | 775M | 200 | 1.75 | 2.617 | 245.465 | 5.652 | 0.811 | 0.566 |
| XL | 775M | 200 | 2.00 | 2.859 | 285.900 | 5.758 | 0.840 | 0.527 |
| XL | 775M | 300 | no | 15.549 | 79.157 | 7.049 | 0.616 | 0.689 |
| XL | 775M | 300 | 1.50 | 3.479 | 194.448 | 5.816 | 0.763 | 0.606 |
| XL | 775M | 300 | 1.75 | 2.629 | 244.085 | 5.594 | 0.807 | 0.579 |
| XL | 775M | 300 | 2.00 | 2.785 | 286.875 | 5.567 | 0.836 | 0.542 |
| XXL | 1.4B | 50 | no | 17.195 | 74.123 | 8.689 | 0.605 | 0.681 |
| XXL | 1.4B | 50 | 1.50 | 4.363 | 178.228 | 6.818 | 0.758 | 0.600 |
| XXL | 1.4B | 50 | 1.75 | 2.893 | 236.210 | 6.263 | 0.805 | 0.564 |
| XXL | 1.4B | 50 | 2.00 | 3.049 | 285.390 | 6.053 | 0.842 | 0.522 |
| XXL | 1.4B | 200 | no | 13.997 | 86.776 | 8.178 | 0.637 | 0.684 |
| XXL | 1.4B | 200 | 1.50 | 3.137 | 207.870 | 6.060 | 0.774 | 0.605 |
| XXL | 1.4B | 200 | 1.75 | 2.331 | 262.995 | 5.714 | 0.816 | 0.579 |
| XXL | 1.4B | 200 | 2.00 | 2.678 | 304.631 | 5.587 | 0.840 | 0.545 |
| XXL | 1.4B | 300 | no | 14.648 | 86.328 | 8.687 | 0.628 | 0.681 |
| XXL | 1.4B | 300 | 1.50 | 3.295 | 202.586 | 6.476 | 0.770 | 0.626 |
| XXL | 1.4B | 300 | 1.75 | 2.340 | 253.906 | 5.977 | 0.809 | 0.596 |
| XXL | 1.4B | 300 | 2.00 | 2.523 | 295.374 | 5.736 | 0.836 | 0.559 |
| 3B | 3.1B | 50 | no | 16.431 | 72.622 | 7.217 | 0.611 | 0.677 |
| 3B | 3.1B | 50 | 1.50 | 3.472 | 191.979 | 5.955 | 0.768 | 0.600 |
| 3B | 3.1B | 50 | 1.75 | 2.611 | 251.903 | 6.167 | 0.807 | 0.568 |
| 3B | 3.1B | 50 | 2.00 | 3.222 | 300.887 | 5.764 | 0.847 | 0.523 |
| 3B | 3.1B | 200 | no | 9.949 | 108.083 | 7.088 | 0.667 | 0.672 |
| 3B | 3.1B | 200 | 1.50 | 2.400 | 237.683 | 5.548 | 0.794 | 0.600 |
| 3B | 3.1B | 200 | 1.65 | 2.264 | 268.180 | 5.426 | 0.817 | 0.581 |
| 3B | 3.1B | 200 | 1.75 | 2.381 | 286.091 | 5.390 | 0.828 | 0.569 |
| 3B | 3.1B | 200 | 2.00 | 3.011 | 321.563 | 5.514 | 0.851 | 0.538 |
| 3B | 3.1B | 300 | no | 9.380 | 112.877 | 8.242 | 0.685 | 0.668 |
| 3B | 3.1B | 300 | 1.50 | 2.388 | 233.246 | 6.145 | 0.798 | 0.601 |
| 3B | 3.1B | 300 | 1.60 | 2.216 | 251.338 | 6.002 | 0.811 | 0.584 |
| 3B | 3.1B | 300 | 1.65 | 2.189 | 263.334 | 5.965 | 0.819 | 0.581 |
| 3B | 3.1B | 300 | 1.75 | 2.329 | 280.104 | 5.818 | 0.828 | 0.566 |
| 3B | 3.1B | 300 | 1.80 | 2.370 | 287.452 | 5.825 | 0.834 | 0.570 |
| 3B | 3.1B | 300 | 2.00 | 2.816 | 311.597 | 5.845 | 0.848 | 0.544 |
| validation data | 1.684 | 231.811 | 3.692 | 0.752 | 0.671 |
这些结果支持一个更实用的判断:当主干规模、序列长度与训练时间同时变化时,应该观察整组曲线以及质量---覆盖关系。个别最优FID不足以告诉我们在给定显存、时延或训练预算下应该使用哪种模型。
13. LlamaGen类别样例:高CFG展示不等于最低FID配置
附录的六组类别样例都由LlamaGen-3B在384分辨率、CFG 4.0下生成。这个CFG明显高于主表最低FID所使用的1.65,所以视觉展示与定量最优结果属于不同采样设置。
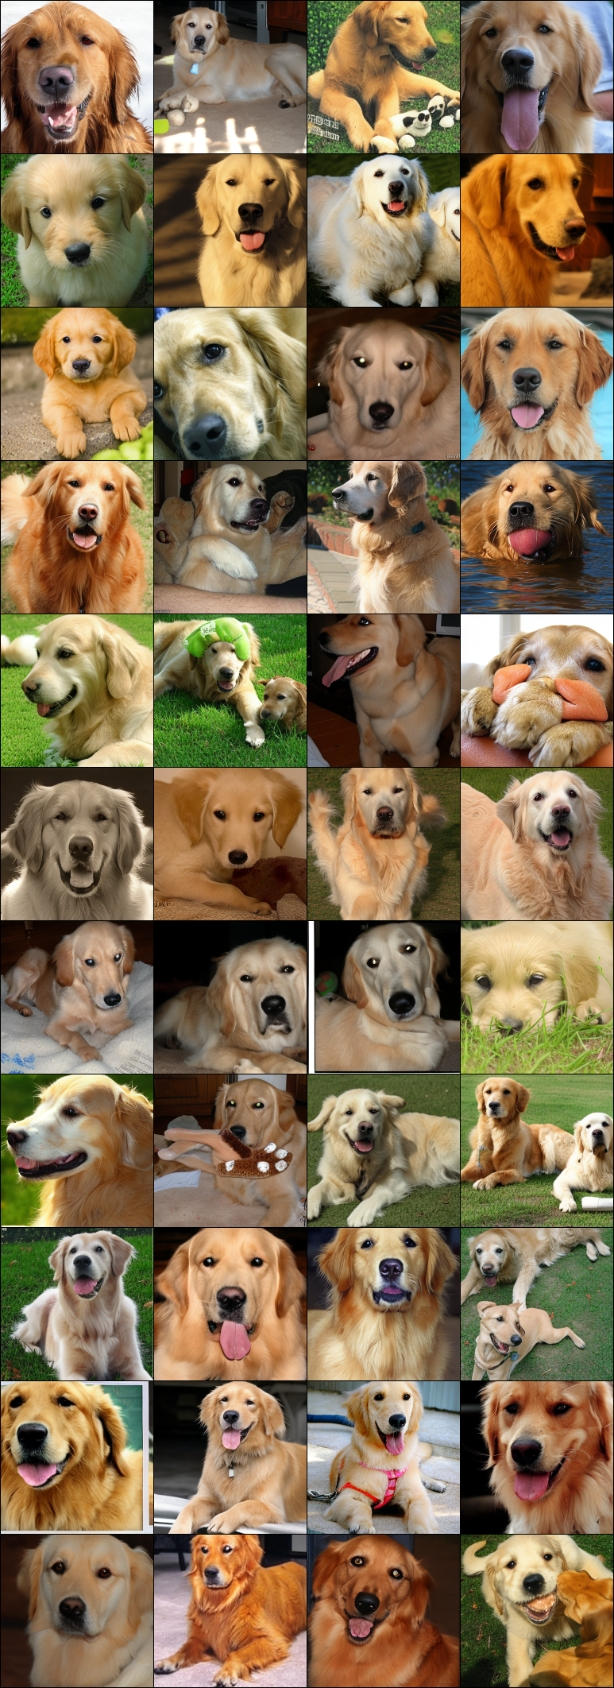
图7的金毛犬样例强调毛发、光照和背景变化。类别一致性很直观,但观察多样性时还应检查构图与姿态是否重复。
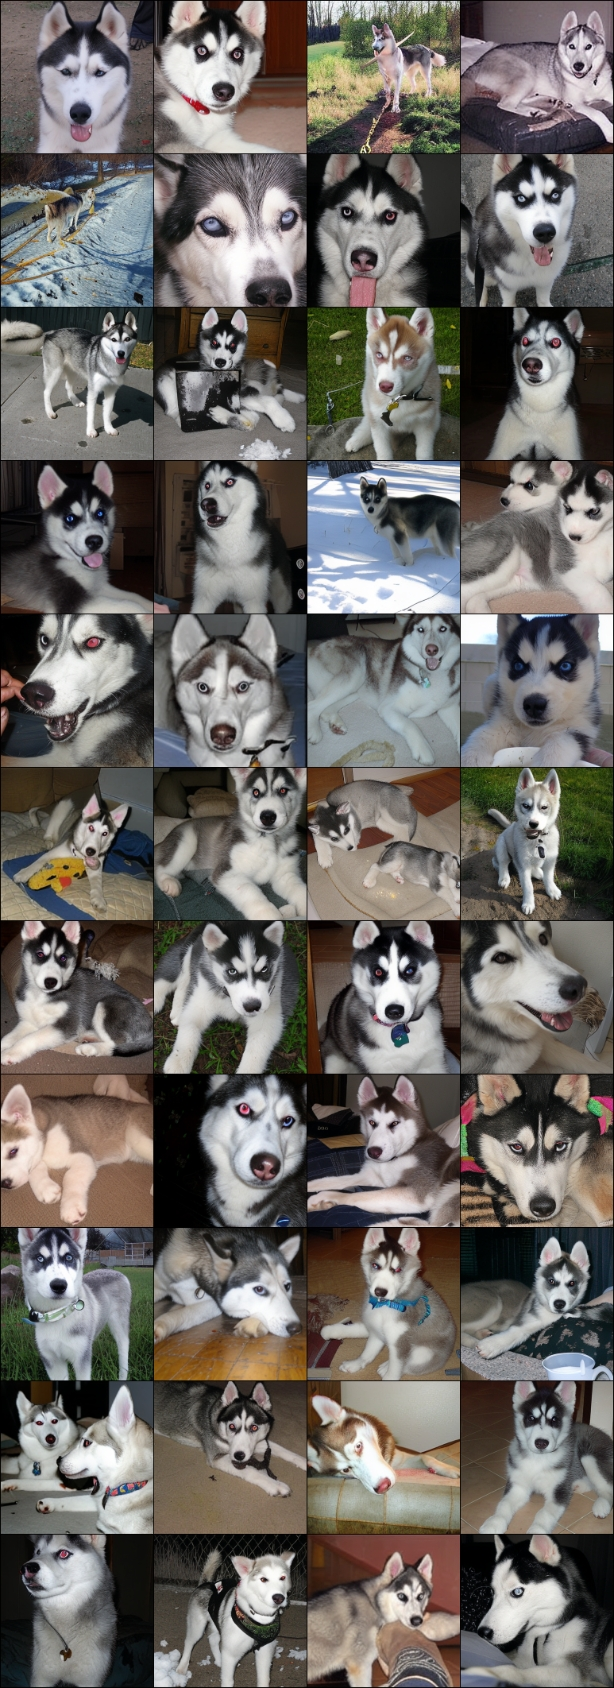
图8展示另一种犬类,可观察细粒度外观区分。这仍是给定ImageNet类别标签的生成,不能据此推断模型理解任意自然语言中的犬类关系。
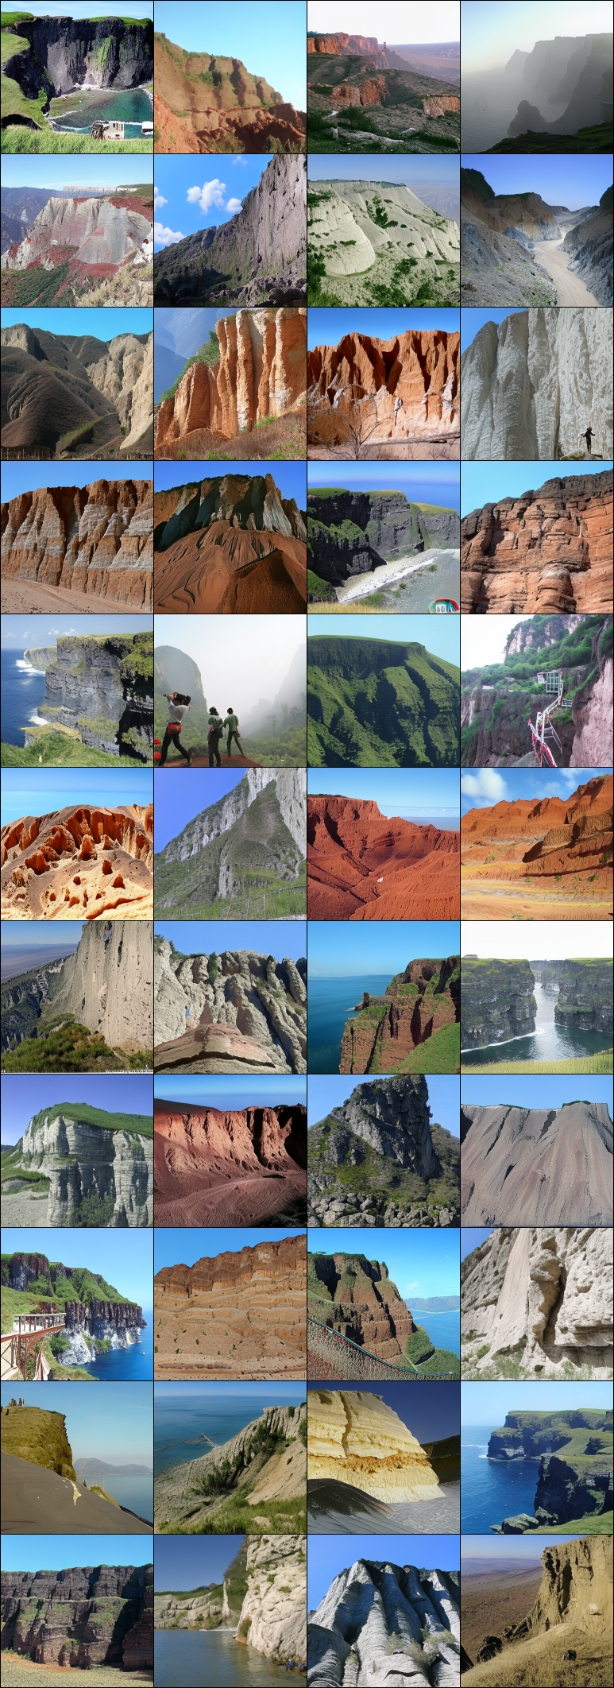
图9的自然地貌强调纹理和场景层次。高视觉真实感并不等于每处几何结构都满足真实地形约束。
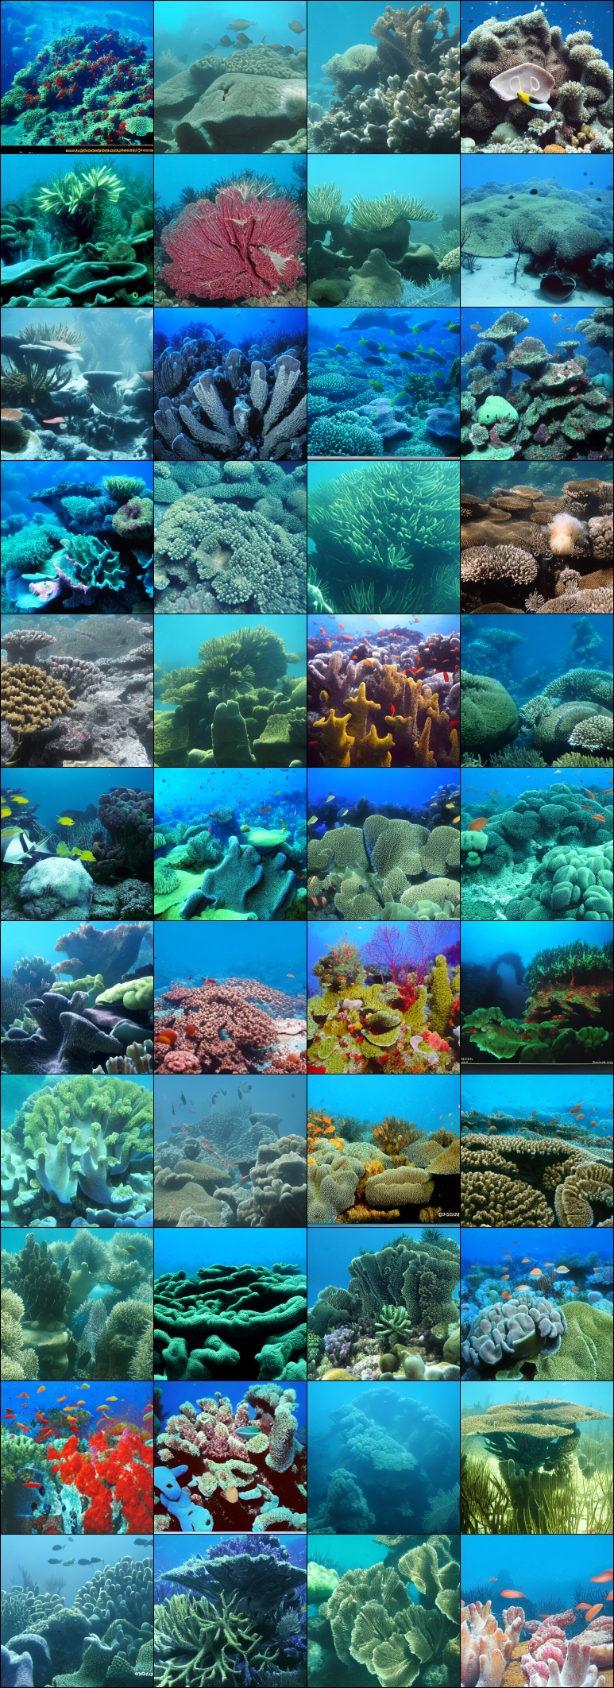
图10展示高密度局部纹理。它适合观察生成器处理复杂视觉统计的能力,但精选图无法给出该类别的整体失败率。
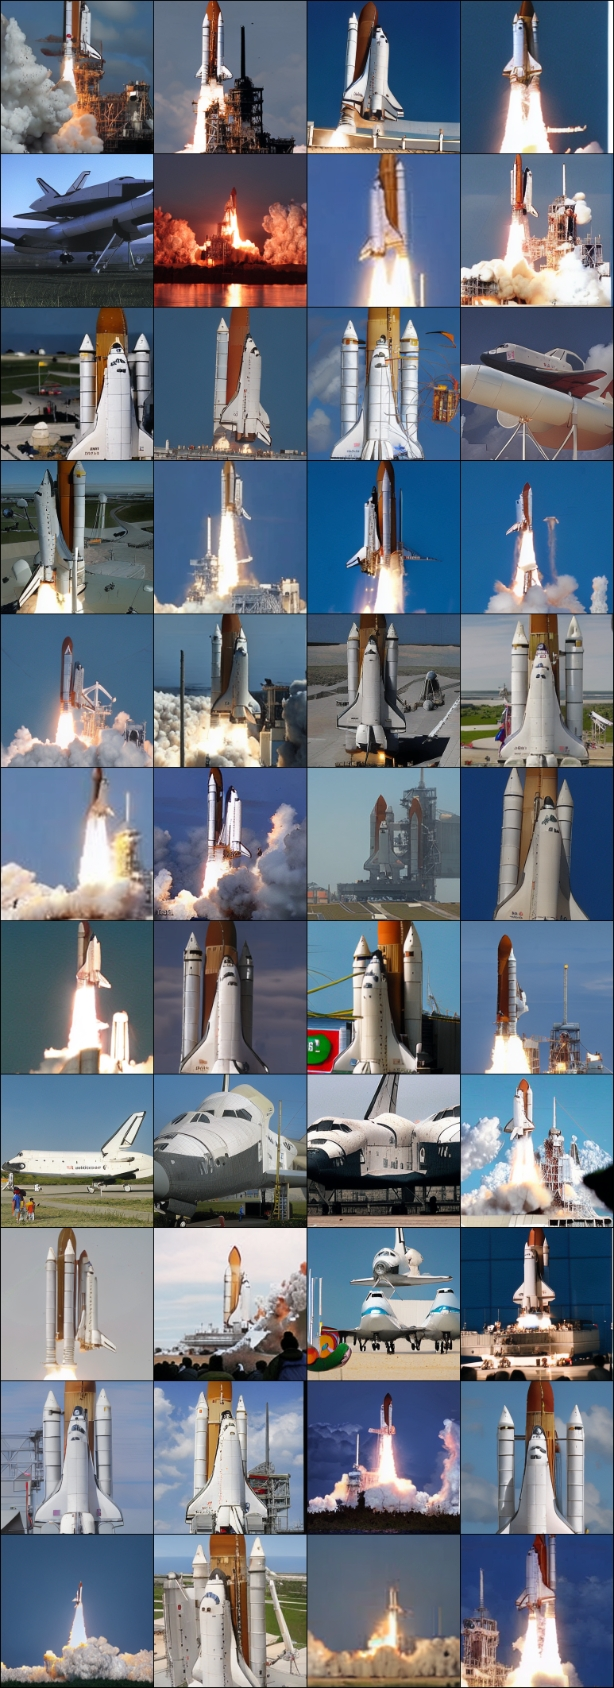
图11包含更强结构约束的人工物体。判断质量时应同时关注整体类别和局部部件关系,避免将"可识别"与"结构正确"等同。
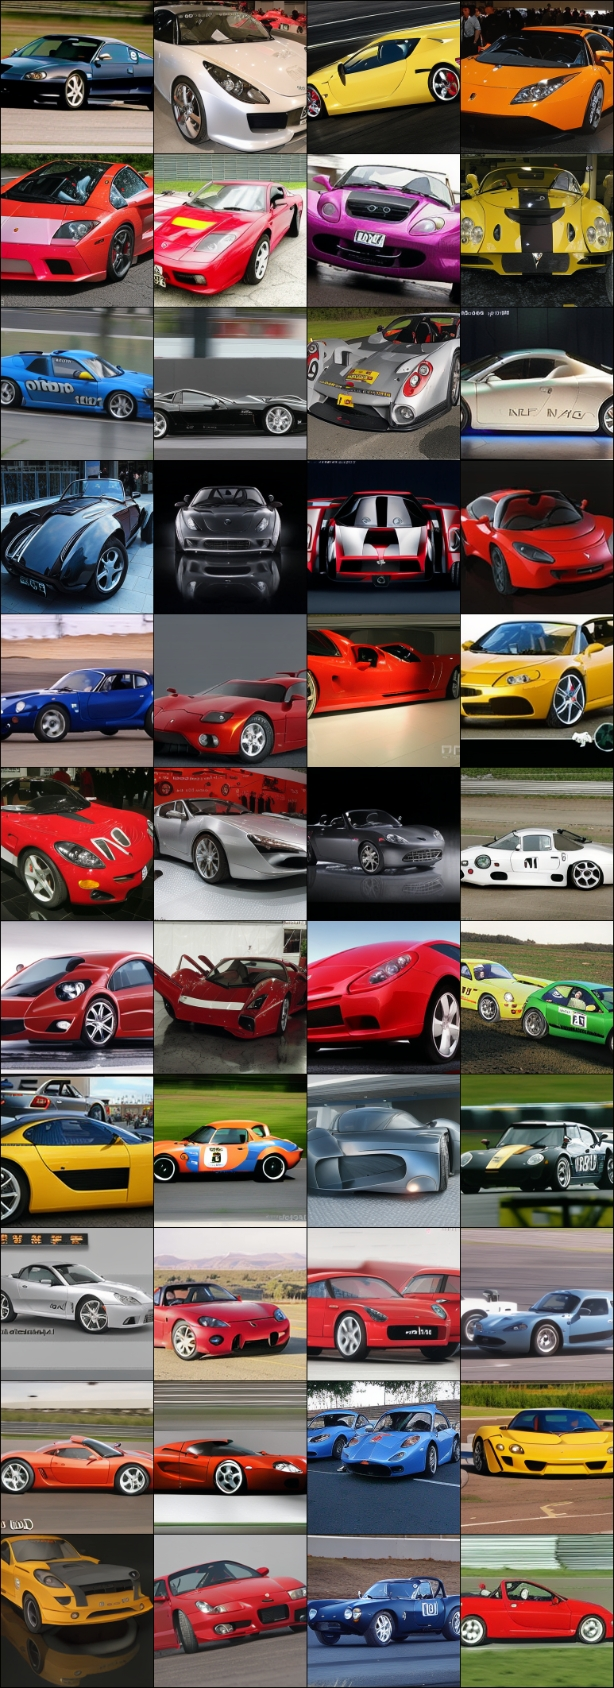
图12进一步展示人工物体上的造型、视角与材质变化。六组样例共同说明类别条件生成具有较高视觉质量,但并不能补全文生图在计数、文字和复杂指令上的证据缺口。
14. LlamaGen的跨周期价值:把生成路线还原成可复用的研究基线
LlamaGen给出的积极结论很清楚:普通逐token自回归能够生成高质量图像;tokenizer不是不可改进的前置黑盒;模型规模与token长度需要协同选择;成熟LLM训练与推理工具可以带来真实工程收益。
它的边界同样清楚:ImageNet类别条件成绩不能外推到全部开放域文生图;表中参数和速度不代表所有辅助模块的总成本;内部高审美数据使完全复现训练分布更困难;文生图质量改善尚缺少将数据与分辨率影响分离的完整消融。
对于后续研究,最值得延续的是这套分解问题的方法。先测压缩上限,再测序列建模能力;先固定采样协议,再比较模型;先解释评测分辨率,再讨论FID;先核算完整服务链条,再讨论架构是否具有部署优势。
Rocky认为,LlamaGen的长期价值在于恢复了普通自回归作为视觉生成强基线的可信度。 它让研究者可以在同一基础上继续追问:更好的tokenizer、更充分的数据、更高效的解码,以及真正统一的语言视觉词表,分别能带来多少增益。这些可拆解、可验证的增益,才是持续研究与工程投入的可靠依据。
推荐阅读
1. 深入浅出完整解析AI Agent(AI智能体)的核心基础知识
2025年可以说是AI Agent全面落地应用的元年,因此Rocky在持续撰写对AI Agent的全维度解析文章:
深入浅出完整解析AI Agent(AI智能体)的核心基础知识
2. 深入浅出完整解析扩散模型DDPM、DDIM、Score-Based、SDE、LDM、Classifier/Classifier-Free Guidance、Rectified Flow核心基础知识
Rocky对扩散模型的本质原理与和核心基础知识进行了全面系统的深入浅出分析讲解,同时不断跟进补充扩散模型的最新技术发展,希望能给大家带来帮助:
深入浅出完整解析扩散模型DDPM、DDIM、Score-Based、SDE、LDM、Classifier/Classifier-Free Guidance、Rectified Flow核心基础知识
3. 入浅出完整解析FLUX.2、Seedream(即梦)、Z-image、GLM-Image核心基础知识
Rocky对AIGC时代"中场时刻"之后的主流AIGC创作大模型的核心基础知识进行了全面系统的深入浅出分析讲解,力求让大家通俗易懂理解AIGC时代的技术浪潮的本质价值:
入浅出完整解析FLUX.2、Seedream(即梦)、Z-image、GLM-Image核心基础知识
4. 深入浅出完整解析FLUX.1 Kontext和FLUX.1 Krea核心基础知识
Rocky对FLUX.1 Kontext和FLUX.1 Krea的核心基础知识作了全面系统的梳理与解析:
深入浅出完整解析FLUX.1 Kontext和FLUX.1 Krea核心基础知识
5. 深入浅出完整解析DeepSeek系列核心基础知识
Rocky对DeepSeek系列模型的核心基础知识作了全面系统的梳理与解析:
6. 深入浅出完整解析Stable Diffusion 3(SD 3)和FLUX.1系列核心基础知识
Rocky对Stable Diffusion 3和FLUX.1的核心基础知识作了全面系统的梳理与解析:
深入浅出完整解析Stable Diffusion 3(SD 3)和FLUX.1系列核心基础知识
7. 深入浅出完整解析Stable Diffusion XL(SDXL)核心基础知识
Rocky对Stable Diffusion XL的核心基础知识作了全面系统的梳理与解析:
深入浅出完整解析Stable Diffusion XL(SDXL)核心基础知识
8. 深入浅出完整解析Stable Diffusion(SD)核心基础知识
Rocky对Stable Diffusion 1.x-2.x系列模型的核心基础知识做了全面系统的梳理与解析:
深入浅出完整解析Stable Diffusion(SD)核心基础知识
9. 深入浅出完整解析Stable Diffusion中U-Net的前世今生与核心知识
Rocky对Stable Diffusion中最为关键的U-Net结构进行了深入浅出的全面解析,包括其在传统深度学习中的价值和在AIGC中的价值:
深入浅出完整解析Stable Diffusion中U-Net的前世今生与核心知识
10. 深入浅出完整解析LoRA(Low-Rank Adaptation)模型核心基础知识
对于AIGC时代中的"ResNet"------LoRA模型,Rocky进行了深入浅出的全面讲解:
深入浅出完整解析LoRA(Low-Rank Adaptation)模型核心基础知识
11. 深入浅出完整解析ControlNet核心基础知识
AIGC图像创作开源社区已经形成以Stable Difffusion/FLUX为核心,ConrtolNet和LoRA作为首要AI辅助工具的变化万千的AIGC图像创作工作流。
ControlNet正是让AI图像创作社区无比繁荣的关键一环,它让AIGC图像创作过程更加的可控,更有助于广泛地将AIGC算法解决方案应用到各行各业中:
12. 深入浅出完整解析Sora、Seedance、keling等AI视频大模型核心基础知识
AI绘画和AI视频是两个互相促进、相互交融的领域,2024年无疑是AI视频领域的爆发之年,Rocky对AI视频领域核心的Sora、Seedance、Keling等大模型进行了全面系统的梳理与解析:
深入浅出完整解析Sora、Seedance、keling等AI视频大模型核心基础知识
13. 深入浅出完整解析AIGC时代Transformer核心基础知识
在AIGC时代中,Transformer为AI行业带来了深刻的变革。Transformer架构正在一步一步重构所有的AI技术方向,成为AI技术架构大一统与多模态整合的关键核心基座,大有一统"AI江湖"之势。Rocky也对Transformer模型进行持续的深入浅出梳理与解析:
深入浅出完整解析AIGC时代Transformer核心基础知识
14. 深入浅出完整解析ComfyUI、Diffusers、Stable Diffusion WebUI等主流AIGC创作框架核心基础知识
AIGC创作框架正是AIGC算法工作流的运行载体,目前主流的AIGC创作框架有ComfyUI、Diffusers、Stable Diffusion WebUI等 。在传统深度学习时代,PyTorch、TensorFlow以及Caffe是传统深度学习模型的基础运行框架,到了AIGC时代,Rocky相信ComfyUI就是AIGC时代的"PyTorch"、Stable Diffusion WebUI就是AIGC时代的"TensorFlow"、Diffusers就是AIGC时代的"Caffe":
深入浅出完整解析ComfyUI、Diffusers、Stable Diffusion WebUI等主流AIGC创作框架核心基础知识
15. 深入浅出完整解析ComfyUI、Diffusers、Stable Diffusion WebUI等主流AIGC创作框架核心基础知识
在AIGC时代中,如何快速转身,入局AIGC产业?如何成为AIGC/LLM/AI Agent算法/开发工程师?如何在学校中系统性学习AIGC/LLM/AI Agent知识,斩获心仪的AIGC/LLM/AI Agent算法/开发offer?
Don't worry,Rocky为大家总结整理了全面的AIGC/LLM/AI Agent算法/开发工程师成长秘籍,为大家答疑解惑,希望能给大家带来帮助:
手把手教你成为AIGC/LLM/AI Agent算法/开发工程师,斩获AIGC/LLM/AI Agent算法/开发offer!
16. AIGC产业的深度思考与分析
2023年3月21日,微软创始人比尔·盖茨在其博客文章《The Age of AI has begun》中表示,自从1980年首次看到图形用户界面(graphical user interface)以来,以OpenAI为代表的科技公司发布的AIGC模型是他所见过的最具革命性的技术进步。
Rocky也认为,AIGC及其生态,会成为AI行业重大变革的主导力量。AIGC会带来一个全新的红利期,未来随着AIGC的全面落地和深度商用,会深刻改变我们的工作、生活、学习以及交流方式,各行各业都将被重新定义,过程会非常有趣。
那么,在此基础上,我们该如何更好的审视AIGC的未来?我们该如何更好地拥抱AIGC引领的革新?Rocky准备从技术、产品、商业模式、长期主义等维度持续分享一些个人的核心思考与观点,希望能帮助各位读者对AIGC有一个全面的了解:
深入浅出全面解析AIGC时代核心价值与发展趋势(2025年版)
17. AI算法工程师的独孤九剑秘籍
为了方便大家实习、校招以及社招的面试准备,同时帮助大家提升扩展技术基本面,Rocky将符合大厂和AI独角兽价值的算法高频面试知识点撰写总结成《三年面试五年模拟》之独孤九剑秘籍:
【三年面试五年模拟】AIGC时代的算法工程师的求职面试秘籍(持续更新中)
18. 深入浅出完整解析AIGC时代中GAN(Generative Adversarial Network)系列模型核心基础知识
GAN系列模型作为传统深度学习时代的最热门生成式Al模型,在AIGC时代继续繁荣,作为Stable Diffusion/FLUX系列大模型的"得力助手",广泛活跃于AlGC图像创作的产品与工作流中:
深入浅出完整解析AIGC时代中GAN(Generative Adversarial Network)系列模型核心基础知识