你有没有遇到过这种情况:把一首十分钟的现场录音丢去做分轨,整体效果不错,但拉到某几个位置,人声会突然"虚"一下,伴奏的相位感也晃了半秒,然后又恢复正常。这些位置往往间隔均匀,像是被人按固定刻度切过。
你的直觉没错------确实被切过。问题不在你,而在于几乎所有分离模型都不是一口气看完整首歌的。
先破一个误解:模型并没有"通读"全曲
很多人以为,分离模型像人听歌一样,从头听到尾,理解完整首曲子再动手分。实际上主流的人声/多轨分离模型,没有一个这么工作。
真实流程是:先把音频切成若干固定长度的小段,每段独立送进模型推理,拿到每段的分离结果,再按顺序拼回去。你听到的"整体分离",其实是几十段局部结果的拼接。接缝处出问题,十有八九就出在这个"切了再拼"的过程里。
底层:从分帧到分段,模型眼里的音频是一叠卡片
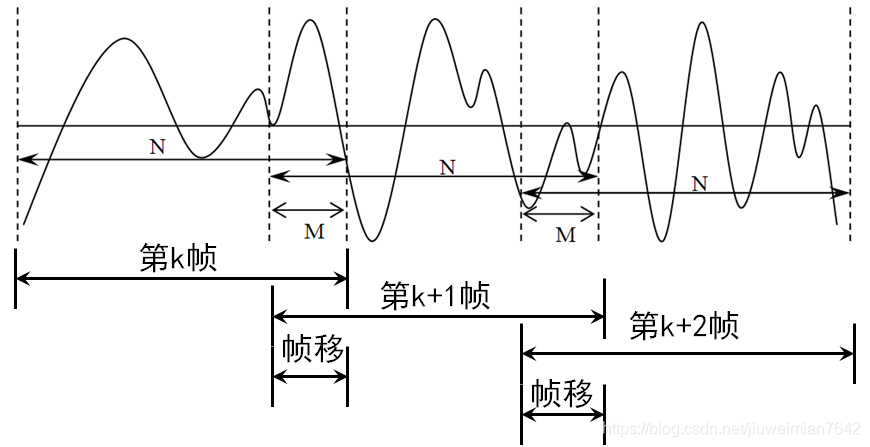
分离模型处理的不是波形本身,而是时频图。音频先经过短时傅里叶变换(STFT),按帧切开------常见配置是窗长 2048 或 4096 个采样点、帧移 512 或 1024------变换成一张"横轴时间、纵轴频率"的能量图。模型在这张图上估计每个时频格子的归属:是人声还是伴奏,是鼓还是贝斯,最后生成掩码(mask)乘回去。
关键在于,模型的输入尺寸是固定的。训练时它见过的都是比如 6 秒或 11 秒长的片段,位置编码、上下文窗口、感受野全都按这个长度设计。一首三分钟的歌在 44.1kHz 采样率下单声道就近 800 万个采样点,STFT 之后是几千帧的时频图------直接塞进去,要么超出模型的上下文范围被硬截断,要么显存直接扛不住。所以工程上只有一个选择:切成模型认识的长度,逐段算。
关键一:切多长,是一笔上下文与算力的账
切段长度不是随便定的,两头都有代价。
切得越短,每段推理越快、显存占用越低,但模型能看到的上下文越少。一首歌的副歌和主歌编曲不同,如果段落切得太碎,模型在某一段里可能根本"意识不到"这首歌的鼓是什么音色、人声在什么频段,掩码估计就缺了参照。切得越长,上下文越足,判断越稳,但推理时间和显存开销跟着涨,服务器端的并发成本也上去了。
所以主流实现把片段长度定在 6~15 秒这个区间:足够覆盖一两句唱词或几个小节,又不至于让单次推理失控。这不是算法的上限,是工程折中的甜点位。
关键二:接缝怎么拼,决定你听不听得出"刻度"
切完算完,拼回去是第二个技术点,也是接缝伪影的直接来源。
最朴素的拼法是硬拼:段 A 结尾直接接段 B 开头。问题在于,模型对每一段的掩码估计是独立的,段边界处的掩码值在 A 的末尾和 B 的开头可能对不上------边界这一格,A 说"60% 是人声",B 说"30% 是人声",拼起来就是一个突变。这种突变在听感上就是人声突然"虚"一下,或者伴奏晃一下,和裁剪不过零产生咔哒声是同一类机理。
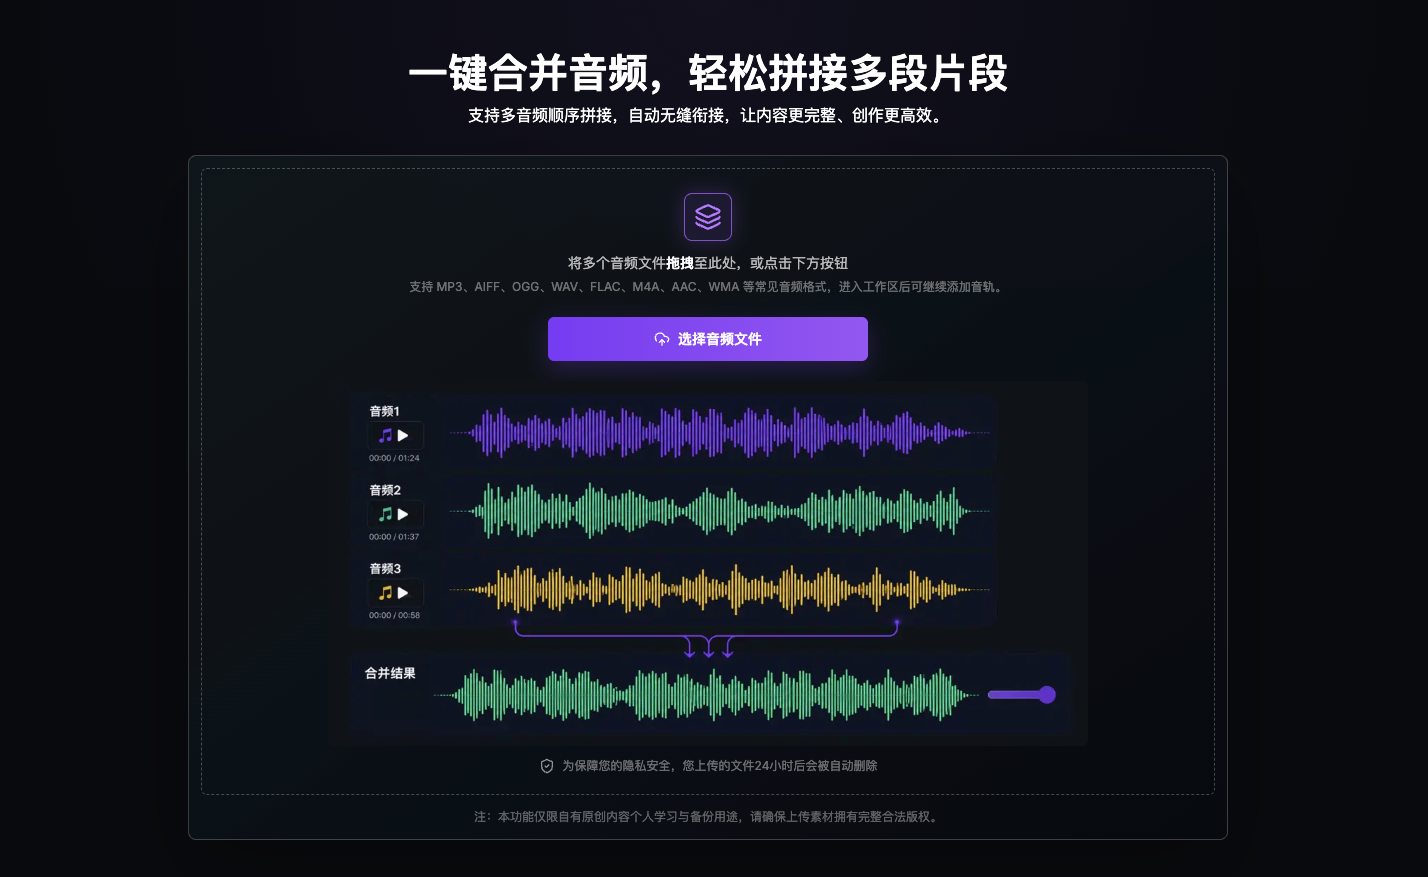
标准解法叫重叠相加(overlap-add):相邻两段之间留 25%~50% 的重叠区,重叠部分不取任何一段的原值,而是用窗函数(常用 Hann 窗)做加权交叉淡化------靠近 A 中部的位置多听 A 的,靠近 B 中部的位置多听 B 的,中间地带两者平滑过渡。这样边界处的掩码差异被"摊平"到一个几百毫秒到几秒的区间里,突变变成了渐变。
但 overlap-add 自己也有坑:如果窗函数归一化没做好,重叠区的能量会出现周期性的强弱起伏,听感像整首歌在均匀地"呼吸"。下次听到分轨结果有这种规律性的音量晃动,基本可以断定是拼接环节的窗没配平。
关键三:分段独立估计,段与段之间会"漂移"
第三个关键更隐蔽:即使拼接平滑,每段的估计基准也可能不一致。
很多实现会对每个输入段做独立的能量归一化------把这一段的响度拉到统一水平再推理,输出时再拉回去。这保证了模型输入分布稳定,但副作用是:如果整首歌的动态起伏很大(主歌轻、副歌重),每段归一化的参考点不同,段间就可能出现轻微的响度台阶或音色跳变。拼接处平滑了,基准却漂移了。
另一个漂移来源是全局信息的缺失。人耳判断"这轨人声干不干净",参照的是整首歌;模型在 6 秒的段里判断,参照只有这 6 秒。段中间的判断有前后文撑着,段边界附近的判断天然缺一半上下文------所以即使重叠相加,边界附近几拍的分离质量仍然平均低于段中部,这是分段架构的固有属性,不是哪个模型调得不好。
对使用者来说,这些参数多数被工具封装在内部,不需要手调。但知道它们存在,就能解释两个常见现象:为什么长音频处理时间大致按时长线性增长(逐段推理),以及为什么伪影位置间隔均匀(分段刻度的痕迹)。
能力边界:分段架构改不了的几件事
有几件事需要说清楚,免得对结果产生不切实际的预期。
第一,接缝处理只能降低伪影,不能消除。 重叠相加摊平的是突变,摊不平的是段边界上下文缺失带来的判断质量下降。对接缝极敏感的素材(比如人声长音正好横跨边界),换参数不如换切点------可惜切点通常不可控。
第二,段间一致性没有完美解。 全局归一化参考能缓解响度台阶,但引入新的耦合。这是架构层面的权衡,不是 bug。
第三,分段推理意味着处理时长基本随音频长度线性增长,十分钟的歌就是比三分钟的歌慢三倍多,这不是工具卡,是逐段计算的必然。
第四,在线分离工具处理的是你上传的本地音频文件,不存在贴一个网址在线抓取解析的路径。素材要先拿到本地,才能进这个流程。
落地方案
知道原理之后,操作反而是最简单的部分。以 AIFooler 为例,整个分段、推理、重叠拼接的过程全部在服务端完成,使用者要做的就是上传文件、选模式、等结果。
具体路径:打开浏览器音频处理平台,选人声分离或多音轨分离,上传本地音频文件。如果素材是现场录音、底噪明显,按前面说的顺序先跑一遍降噪再做分离,段间漂移会少很多。处理完成后试听时,重点拉几个位置:副歌与主歌的过渡处、人声长音的中段------这些地方最容易暴露接缝和漂移,也最能检验这次分离够不够用。
收尾
分轨结果的接缝不是玄学,是"切了再拼"这个架构的直接投影:段长决定上下文,重叠决定平滑,归一化决定一致性。听出接缝的位置规律,比反复重跑同一文件更有用------因为它告诉你问题出在拼接层,而不是素材层。下一次评估分离结果,先等间距地扫一遍,你就能把"这工具行不行"拆成"哪一环不行"。