"六层架构"是业界对一个可用 Agent 系统 的分层拆解。 它的价值在于:当面试官问"你怎么设计一个 Agent"时,你能按层展开而不遗漏。
图 1-1 Agent 六层架构
从上到下是调用方向,从下到上是依赖方向。面试时按这个顺序逐层说明,不会漏
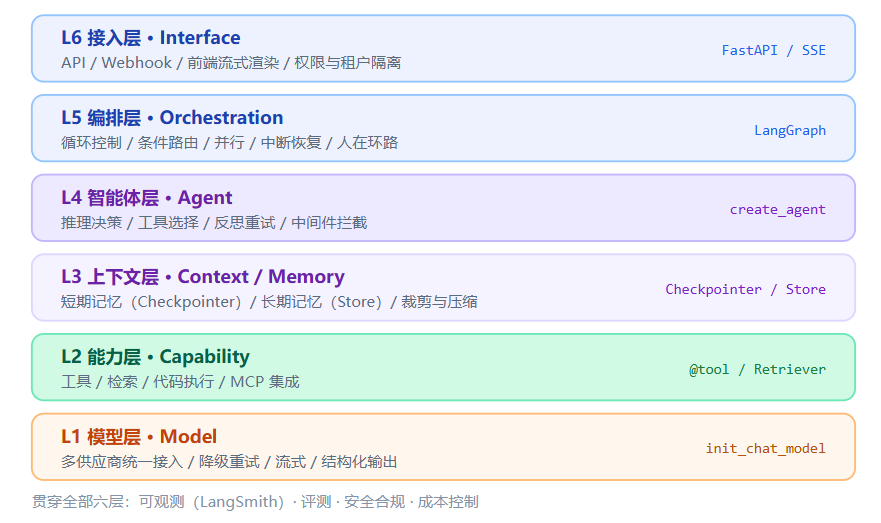
回答技巧 :不要干巴巴背六层,要每层配一句"这层的常见坑":
- L1 模型层:坑在降级------主模型挂了有没有兜底?成本有没有上限?
- L2 能力层:坑在工具描述------写得含糊,模型就不会用或乱用。
- L3 上下文层:坑在膨胀------不加管理,上下文迟早爆窗。
- L4 智能体层:坑在死循环------必须有迭代上限和熔断。
- L5 编排层:坑在状态------断点续跑、并发会话隔离有没有做。
- L6 接入层:坑在流式与超时------长任务前端怎么展示进度。
一句话速记模型 → 能力 → 上下文 → 智能体 → 编排 → 接入;答场景题时按这六层展开,每层补一个坑,就是一份高分答案。
核心代码表达:Agent 六层架构的"填坑指南"
面试时,你可以按照以下结构进行表述:"这一层的坑是......我们在代码里是这样解决的......"
L1 模型层 - 坑:主模型挂了没有兜底,成本没有上限
python
from langchain.chat_models import init_chat_model
from langchain.agents import create_agent

# 解决方案 1:降级(Fallback)
model = init_chat_model(
    "openai:gpt-4o",
    temperature=0,
    timeout=30,
    # 超时和重试是标配
    max_retries=2
)

# 推荐使用内置中间件实现降级链
agent = create_agent(
    model=model,
    tools=tools,
    middleware=[
        # 重试 3 次后仍失败,切换到备选模型
        ToolRetryMiddleware(max_attempts=3),
        # 主模型失败,自动切换到备选
        ModelFallbackMiddleware(
            "anthropic:claude-sonnet-4-6",
            # 还可以继续链式降级,比如到 gpt-4o-mini
        ),
    ]
)

# 解决方案 2:成本上限(Budget)
# 用中间件控制单次会话的模型调用次数,防止恶意刷量
from langchain.agents.middleware import ModelCallLimitMiddleware

agent = create_agent(
    model=model,
    tools=tools,
    middleware=[
        # 最多调用 15 次模型,防止死循环和成本失控
        ModelCallLimitMiddleware(limit=15, exit_behavior="end"),
    ]
)
面试加分点: "我们不仅设了超时重试,更重要的是建立了降级链。ModelFallbackMiddleware 是 v1 最重要的可靠性武器。同时,ModelCallLimitMiddleware 是我们成本控制的第一道防线,必须配。"
L2 能力层 - 坑:工具描述写得含糊,模型不会用或乱用
python
from langchain.tools import tool
from pydantic import BaseModel, Field
from typing import Annotated
from langchain.tools import InjectedToolArg

# 解决方案:编写"高质量的工具定义"
class SearchOrdersInput(BaseModel):
    """严格地描述参数,给模型清晰的指引。"""
    query: str = Field(description="搜索关键词,可以是订单号、商品名或收件人。")
    user_id: Annotated[str, InjectedToolArg] # 运行时注入,模型看不到这个参数
    limit: int = Field(default=5, ge=1, le=10, description="返回结果数量")

@tool(args_schema=SearchOrdersInput)
def search_orders(query: str, user_id: str, limit: int) -> str:
    """
    【核心工具】按关键词搜索用户的订单。
    使用场景:用户问"我的XXX订单在哪里"、"最近买了什么"。
    切勿用于:查询商品详情、修改订单状态(这是其它工具的职责)。
    如果用户未提供搜索关键词,必须主动询问,不要凭空猜测。
    """
    return f"搜索到 {limit} 条与'{query}'相关的订单..."
面试加分点: "坑在于模型把工具当黑盒。解决方法是精确地写 description 和 args_schema 。我特别强调'使用场景'和'切勿用于',极大降低了工具误选率。另外,用 InjectedToolArg 把 user_id 藏起来,彻底杜绝了模型自己编造用户 ID 的越权风险。"
L3 上下文层 - 坑:不加管理,上下文迟早爆窗
python
from langchain.agents.middleware import SummarizationMiddleware
from langchain_core.messages import trim_messages, filter_messages
from langchain.agents import create_agent

# 解决方案 1:自动摘要(Summarization)
agent = create_agent(
    model="openai:gpt-4o",
    tools=tools,
    middleware=[
        SummarizationMiddleware(
            model="openai:gpt-4o-mini", # 用小模型摘要,省成本
            trigger={"tokens": 4000},    # token 数超过 4000 时触发
            keep={"messages": 6},        # 保留最近 6 条原文,防止丢失最新上下文
        ),
    ]
)

# 解决方案 2:手动裁剪与过滤(更精细的控制)
def trim_and_filter_middleware(state, runtime):
    """在模型调用前,对消息列表进行裁剪和过滤。"""
    # 1. 过滤掉过长的工具返回 (content 太长模型也看不懂)
    filtered = filter_messages(
        state["messages"],
        # 排除 content 长度大于 3000 的 ToolMessage
        func=lambda m: not (isinstance(m, ToolMessage) and len(m.content) > 3000)
    )
    # 2. 保留最近的 2000 个 token 的消息
    limited = trim_messages(
        filtered,
        max_tokens=2000,
        strategy="last",
        token_counter=model,
        include_system=True,
        # 从人类消息开始裁,保证不切断工具调用的"消息对"
        start_on="human",
    )
    return {"messages": limited}
面试加分点: "上下文爆了不是直接裁掉,而是要分级处理 。我推荐用 SummarizationMiddleware 做自动压缩,它比手动裁剪更智能。但最常做、收益也最高的一步,其实是 filter_messages 清理掉冗余的、巨大的工具返回,这一步是零成本的。"
python
# (简化后的messages列表)
messages = [
    SystemMessage("你是XX品牌的售后客服,请根据历史记录和用户当前问题回答。"),
    HumanMessage("你好,我上周买的那个蓝色耳机,右耳没声音了。"),
    AIMessage("您好,很抱歉...请提供您的订单号..."),
    HumanMessage("订单号是 ORD-20231015-0023。"),
    AIMessage("...已申请换货..."),
    HumanMessage("...改成上海市浦东新区..."),
    AIMessage("已为您更新收货地址..."),
    # ... 中间 40 轮对话都堆在这里 ...
    AIMessage("发票问题已经处理好,新的电子发票已发送到您的邮箱。"),
    HumanMessage("那之前说好的那个换货的订单,什么时候能发货?"),  # <--- 当前问题
]
问题分析:
- Token 爆炸:这 50 轮对话(包括系统提示词)的 token 总数可能已经轻松超过 10,000 甚至 20,000。每次调用都会把这些历史全部发送,成本和延迟线性增长。
- 关键信息被淹没 :模型在理解"那个换货的订单 "和"发货 "时,需要在堆积如山的对话记录中,回忆或找到:
订单号:ORD-20231015-0023(在第1步提到,后面未再提及)当前状态: 已申请换货 (在第3步)新地址: 上海市浦东新区... (在第4步,可能影响发货仓库或物流)- 用户的原始问题(右耳没声音)已经无关紧要。
- 后来的发票、充电线问题,可能会干扰模型对"换货"这个核心任务的判断。
- "中间遗忘" (Lost in the Middle) :即使 token 没爆窗,上下文太长也会导致模型对中间部分的信息(比如"订单号"和"申请换货"这两个最关键的决策点)关注度极低,模型会"忘了"关键上下文。
最终结果 :模型可能会根据最近的几个问题(充电线、发票)来回答,给出一个答非所问或者不完整的答案。比如:"您的充电线问题已记录,请在订单里查看换货进度。"(完全没回答发货时间)。
方案2的详细解析:滑动窗口
为了解决这个问题,我们使用 trim_messages 实现滑动窗口。
核心思想 :只保留对当前问题最重要的"最近一段"对话历史,丢较旧的信息。
一个失败的滑动窗口配置(面试扣分项)
python
from langchain_core.messages import trim_messages

# 错误示范:只保留按消息条数算的最近 6 条
trimmer = trim_messages(
    max_tokens=6,  # 只保留 6 条消息
    strategy="last",
    token_counter=len,  # 按消息条数计数,不是token
    include_system=False, # 连系统提示词都丢了
    start_on="human",
    allow_partial=False
)这个配置会直接丢掉前面所有的历史,导致模型不知道订单号、不知道已经申请了换货,无法回答当前问题。这是实现了"丢窗"而不是"滑窗"。
一个正确的滑动窗口实现
正确的滑动窗口,不是简单丢弃 ,而是要保留最核心的上下文骨架。
python
from langchain_core.messages import trim_messages, filter_messages

# 正确的滑动窗口:保留系统提示 + 最近的 Key 信息
context_window = trim_messages(
    messages,
    max_tokens=2000,         # 1. 目标大小:设为一个合理的token数,比如2k
    strategy="last",          # 2. 策略:保留最新的(包括当前问题)
    token_counter=model,      # 3. 重要!使用模型自己的tokenizer精确计数
    include_system=True,      # 4. 重要!系统提示词必须保留,它是行为的锚点
    start_on="human",         # 5. 裁剪边界:确保从某个人类消息开始,避免切断成对的消息
    allow_partial=False,      # 6. 不允许截断消息,保证完整性
    include_history_from_last=2, # 7. v1新特性!裁剪完成后,从当前问题往前数,保证至少保留最后2轮完整交互
)

# 补充:裁剪前,还可以先过滤掉无用消息
filtered_messages = filter_messages(
    messages,
    exclude_names=["ToolNode", "action"], # 过滤掉某些Node发出的、可能无用的中间步骤消息
)
这个配置做了什么?
- 设定一个"窗口" :将整个上下文压缩到
max_tokens=2000。 - 保留骨架 :
include_system=True确保了Agent的行为规则不被丢弃。 - 保留最新的核心 :
strategy="last"确保了当前的提问和最近几轮对话被完整保留。根据"被遗忘曲线",最近的信息对解决问题最关键。 - 保证安全裁剪 :
start_on="human"防止在 AI 的 tool_calls 和 ToolMessage 之间切断,导致模型解析错误。 - 提供"救援网" :
include_history_from_last=2像是一个后门,确保即使历史已经很长,裁剪后也至少保留了最近两轮的完整上下文,防止关键的最后几步信息丢失。
经过正确裁剪后,Agent看到的messages可能是这样的:
python
messages = [
    SystemMessage("你是...请根据历史记录...回答。"),
    # 过去的 40 轮对话被摘要或丢弃了
    AIMessage("发票问题已经处理好,新发票已发送到您的邮箱。"), # 最近保留的
    HumanMessage("那之前说好的那个换货的订单,什么时候能发货?"), # 当前问题!
]
这样虽然丢失了"订单号"和"换货申请"的具体细节,但模型仍然知道:
- 它正在处理一个售后问题。(来自系统提示词)
- 用户提到过一个"换货的订单"。(来自用户消息)
- 需要回复"发货"相关的信息。
不过,这里出现了一个新的问题 :模型不知道"换货的订单"的订单号,所以它可能会说:"请提供您换货的订单号,我帮您查询。" 这会导致用户体验退化,用户需要重复提供信息。
这就引出了方案2的 "退化与改进"。
方案2的退化与改进:滑动窗口 + 关键信息摘要
单纯的滑动窗口会导致关键信息丢失 。因此,生产级的做法是结合上下文摘要。
改进方案(混合模式):
- 使用
trim_messages进行裁剪:如上所述,将上下文降低到一个可控的大小(如2k token)。 - 将裁剪掉的"旧信息"进行摘要 :
-
在lcEL链或Agent中间件中,当触发裁剪时,并行运行一个小模型(如gpt-4o-mini)。
-
这个模型的任务是:阅读被裁剪掉的旧消息,并输出一个结构化摘要。
-
例如:
python用户: 李明 核心事件: 申请换货 (订单: ORD-20231015-0023, 商品: 蓝牙耳机Pro-2) 关键信息: 新地址已更新为上海市浦东新区... 未解决项: 查询换货订单的配送进度。 已解决项: 发票问题、充电线投诉。 -
将摘要注入上下文 :将这个摘要追加到系统提示词后面 ,或者作为一条
SystemMessage放在trim_messages裁剪后的消息之前。 -
改进后的Agent看到的messages:
-
python
messages = [
    SystemMessage("你是XX品牌的售后客服,以下是之前的对话摘要,你需要根据摘要和最新的对话回答问题。"),
    SystemMessage("【对话摘要】\n用户: 李明\n核心事件: 申请换货 (订单: ORD-20231015-0023)\n关键信息: 已更新收货地址至上海市浦东新区...\n当前问题: 查询换货订单的配送进度。"),
    AIMessage("发票问题已经处理好,新发票已发送到您的邮箱。"),
    HumanMessage("那之前说好的那个换货的订单,什么时候能发货?"),
]
效果 :现在,模型看到了宝贵的"订单号 "和"地址变更 "信息。它可以直接回答:"您的换货订单(ORD-20231015-0023)正在处理中。由于您的地址已更新为上海,预计发货时间为...",用户体验非常好。
总结:方案2的正确打开方式
- 不要 :单纯地
trim_messages(strategy="last"),这会造成信息丢失。 - 要 :裁剪 + 关键信息摘要。让裁剪处理"量",让摘要处理"质"。
- 挑战 :增加了一次额外的模型调用 (用于生成摘要),带来了成本和延迟。这是为了保留核心上下文而必须付出的代价。通过使用更快、更便宜的小模型(
gpt-4o-mini),可以将此成本控制在可接受范围内。
这个混合方案就是你对面试官说的"我不仅知道L3有坑,我还有一种工程上可行的、平衡了成本与效果的方法来填这个坑"的最好证明。
L4 智能体层 - 坑:死循环,必须有迭代上限和熔断
python
from langgraph.types import Command
from langchain.agents.middleware import AgentMiddleware, ModelRequest

# 解决方案:双重保险 (递归上限 + 业务逻辑熔断)
class DuplicateDetectorMiddleware(AgentMiddleware):
    """检测工具调用是否陷入死循环。"""
    def before_model(self, state, runtime):
        # 获取上一条消息
        last_message = state["messages"][-1] if state["messages"] else None
        if last_message and isinstance(last_message, AIMessage):
            # 如果上一轮模型没调工具,那(可能)是正常结束,跳过检查
            if not last_message.tool_calls:
                return None

            # 记录本轮工具调用的签名(工具名+参数)
            current_fingerprint = frozenset(
                (tc["name"], str(tc["args"])) for tc in last_message.tool_calls
            )
            # 从私有状态中获取历史记录
            history = state.get("_tool_call_history", set())
            if current_fingerprint in history:
                 # 检测到重复:这是一个死循环信号!
                return Command(
                    goto="end", # 跳转到结束节点
                    update={
                        "messages": AIMessage(content="检测到重复操作,为了节省成本已自动结束。请重新描述。")
                    }
                )
            else:
                # 记录本次指纹,避免污染私有状态
                updated_history = history | {current_fingerprint}
                return {"_tool_call_history": updated_history}
        return None

# 另一道防线:在 create_agent 调用时显式设置 recursion_limit
agent = create_agent(model="...", tools=[...], middleware=[DuplicateDetectorMiddleware()])
result = agent.invoke(..., {"recursion_limit": 25})
面试加分点: "递归上限 (recursion_limit) 是底线,但不够聪明。我写了一个 DuplicateDetectorMiddleware 中间件,它能识别出模型是不是在反复调用同一个工具,这才是真正防止死循环的聪明方法。这是状态管理 和可观测性的实战应用。"
L5 编排层 - 坑:断点续跑、并发会话隔离没有做
from langgraph.checkpoint.postgres import PostgresSaver
from langchain.agents import create_agent

# 解决方案:用 Checkpointer 实现状态持久化与线程隔离
# 1. 生产环境必须用共享的数据库,而非内存
checkpointer = PostgresSaver.from_conn_string("postgresql://...")

agent = create_agent(
    model="...",
    tools=[...],
    # Checkpointer 是实现所有高级特性的基石
    checkpointer=checkpointer
)

# 2. 每次调用都必须带上 thread_id 做会话隔离
def handle_user_request(user_id, message):
    # 这里的 thread_id 设计成 user_id + 一个会话 ID(比如从客户端传过来)
    thread_id = f"{user_id}:{session_id}"
    config = {"configurable": {"thread_id": thread_id}}

    # 如果之前有中断,这里调用会从上次中断点恢复
    result = agent.invoke({"messages": [HumanMessage(content=message)]}, config)
    return result
面试加分点: "坑在于状态。没有 Checkpointer,Agent 就是无状态的。我们生产都用的 PostgresSaver,配合 thread_id 设计,不仅支持了多轮对话,还实现了断点续跑 和时间旅行 。thread_id 的设计必须包含用户信息,并做服务端校验,这是安全底线。"
L6 接入层 - 坑:长任务前端无法展示进度
from fastapi import FastAPI
from fastapi.responses import StreamingResponse

app = FastAPI()

@app.post("/chat/stream")
async def stream_chat_endpoint(request: ChatRequest):
    agent = get_agent() # 获取预先创建好的 agent 实例
    config = {"configurable": {"thread_id": request.thread_id}}

    async def event_generator():
        # 使用 stream_mode 同时输出两种信息
        async for mode, chunk in agent.astream(
            {"messages": [HumanMessage(content=request.message)]},
            config=config,
            # messages 给打字机效果,updates 给状态更新
            stream_mode=["messages", "updates"]
        ):
            if mode == "messages":
                token, _ = chunk
                if token.content:
                    yield f"data: {json.dumps({'type': 'token', 'content': token.content})}\n\n"
            elif mode == "updates":
                # chunk 是一个 dict: {node_name: state_update}
                for node_name, state_update in chunk.items():
                    yield f"data: {json.dumps({'type': 'status', 'content': node_name})}\n\n"
        yield "data: [DONE]\n\n"

    return StreamingResponse(event_generator(), media_type="text/event-stream",
                             headers={"X-Accel-Buffering": "no"})
面试加分点: "坑在用户体验。我们让前端不止看到干巴巴的回复,还要看到 Agent 的思考过程。通过 astream_events 或 astream 的 stream_mode,能够把模型的输出(打字机效果)和状态节点的切换(updates)都推送给前端。架构上的保证是 X-Accel-Buffering: no,这行头是流式上线的第一道坑,必须跟运维确认 Nginx 没缓存我们的流。"