导读:在讨论系统架构时,很多初入后端的同学常有这样一个直觉疑惑:"消息队列(MQ)不就是一个用来做'异步'的中间层吗?Node.js 天生就是非阻塞异步事件驱动,那是不是写 Node.js 就根本不需要 MQ 了?"
这是一个非常经典、且极具代表性的概念混淆 。本文将从底层原理、生产故障场景、架构设计模式三个维度,深度拆解"语言级异步"与"消息队列"的本质差异,并结合 AI 平台的真实生产案例,聊聊高可靠系统的设计之道。
一个常见的直觉误区
在单体 Web 开发中,我们习惯了用语言提供的语法糖处理非阻塞调用:
- 在 Node.js 中,我们写
async/await、Promise; - 在 Java 中,我们用
CompletableFuture、线程池或虚拟线程(Virtual Threads); - 在 Go 中,我们随手起一个
go func()。
于是有人下意识地认为:"既然我开个异步任务就能让主请求立马返回,何必大费周章地部署 RocketMQ / RabbitMQ / Kafka 这些笨重的中间件呢?"
一句话总结核心矛盾:
语言级异步 解决的是**「单机单进程内,CPU 如何不在 I/O 等待上浪费时间」的问题;
消息队列解决的是「跨进程/跨机器之间,任务如何安全持久化、削峰限速、故障重试与解耦」**的问题。
两者根本不在同一个系统抽象维度上。
裸写语言级异步的四大"生产车祸"
为了让你直观感受到两者的区别,我们设想一个典型的业务场景:用户上传 100 份大型 PDF 报告,系统需要提取文本、调用 OCR、切片分块、生成 Embedding 向量并存入向量数据库。
如果你在 Controller 里直接裸写异步调用,马上会遭遇以下四个致命问题:
CPU 密集型任务会把 Node.js 的 Event Loop 彻底锁死
Node.js 擅长的是 I/O 密集型 任务(等网络返回、等数据库读写),因为底层是 libuv 线程池和系统异步内核在等待。
但文档解析(PDF 解压、正则清洗、分词计算)是典型的 CPU 密集型任务。
- 后果 :单线程的 Event Loop 会被密集计算完全占满。在这十几秒到数分钟内,整个服务处于假死状态,所有外部用户的普通 HTTP 查询接口都会 100% 超时。
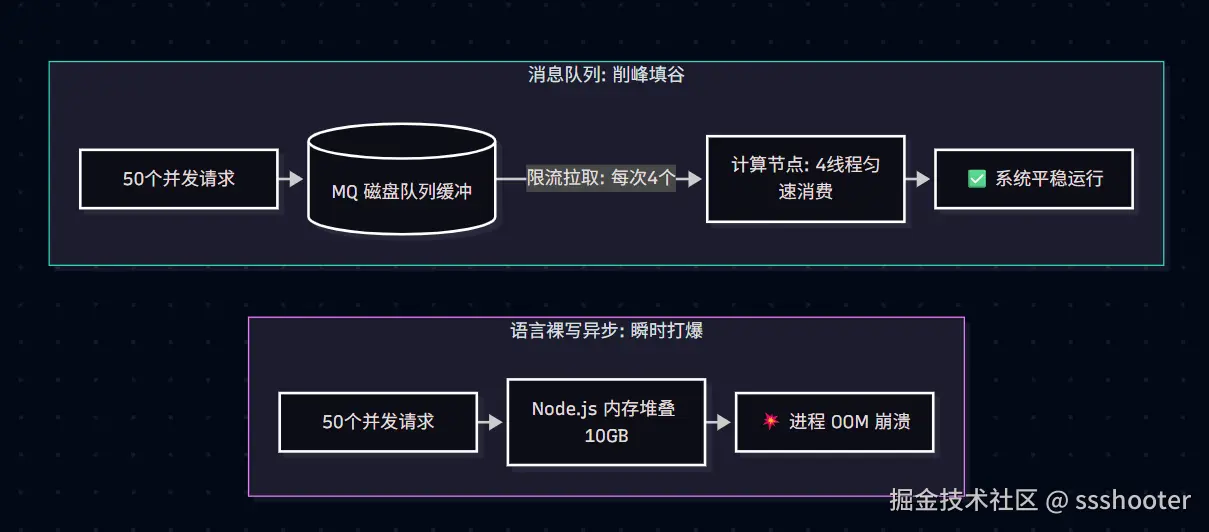
瞬间流量打爆内存(OOM 崩溃)
周一早上 9:00,刚好有 50 个用户同时上传了 50MB 的大文件。
- 语言级异步 :瞬间启动 50 个在内存里跑的任务。每个任务解压后吃 200MB 内存,系统瞬间需要
50 * 200MB = 10GB内存。 - 后果 :机器内存耗尽,系统触发 OOM Killer 强杀进程。
- MQ 的解法(削峰填谷 / 反压 Backpressure) :50 个请求在 1 秒内转化成 50 条消息进入 Broker,消费者配置了
consumeThreadNumber = 4,永远以每次 4 个的平稳速率慢慢消化,内存曲线宛如一条水平线。
服务发版/崩溃导致任务"灰飞烟灭"
- 语言级异步的本质是内存数据。一个跑了 10 分钟的复杂文档处理,正执行到 80%,此时运维做了一次日常版本发布(Pod 重启),或者进程因偶发异常崩溃。
- 后果:内存清空,进行中的任务无影无踪,数据库里的状态永远停留在"处理中",用户只能对着加载菊花无限等待。
- MQ 的解法 :消息发送到 Broker 是落盘持久化 的。Worker 节点哪怕全部宕机,重启后重新拉取未 ACK 的消息继续执行,做到零任务丢失。
容错重试与死信兜底(DLQ)
外部 AI 模型接口(如 OpenAI)和向量库(如 Milvus)经常遇到网络抖动或 HTTP 429(限流):
- 语言级异步:抛出未捕获异常后,任务直接失败;如果自己手写递归重试,一遇到机器重启依然会丢。
- MQ 的解法 :自带指数退避阶梯重试 (如 1s、5s、10s、30s、1m...)。在经过十几次重试依然失败后,消息会自动移入死信队列(Dead Letter Queue),保留原始犯罪现场,运维人员可以通过 Dashboard 一键重新投递或针对性排查。
核心维度全方位对比
| 核心维度 | 语言级异步 (async/await / 线程池) |
消息队列 (RocketMQ / Kafka / BullMQ) |
|---|---|---|
| 定位本质 | 执行控制流(单进程内不阻塞调用方) | 分布式基础设施(跨进程解耦与缓冲管道) |
| 状态载体 | 进程内存(RAM),进程崩溃任务立刻消失 | 磁盘/分布式集群持久化,高可用防丢 |
| 并发控制 | 默认不受控,并发一高容易引发 CPU/内存雪崩 | 具备反压机制(Backpressure),拉取消费,削峰填谷 |
| 水平扩容 | 任务必须绑定在接收请求的那台机器上跑 | API 节点与计算节点解耦,计算 Worker 可任意水平弹性伸缩 |
| 异常恢复 | 需硬编码捕获,机器停机无法自愈 | 天然支持 ACK 确认、梯度延迟重试、死信队列(DLQ) |
生产级实战:AI 知识库流水线是如何落地的?
在工业级 AI 平台(以 WorkDeck/agentcore 为例)中,知识库(ACK 模块)的异步文档向量化流水线便采用了标准的 MQ 架构,并融合了以下关键工程实践:
领域驱动与依赖倒置(DDD)
领域层(Domain)只定义业务契约,不引入具体的中间件依赖:
java
// 领域层只关心业务意图:提交异步文档处理
public interface AsyncProcessingGateway {
    void submitDocumentProcessing(String documentId, String knowledgeBaseId, String tenantId);
}
具备弹性容灾的"双重软降级"
在基础设施层实现中,将 MQ 视为可插拔的增强组件。即使 RocketMQ 宕机或在本地轻量级开发时,系统能够自动降级为同步运行,保证功能不瘫痪:
java
// 基础设施层实现
if (mqEnabled) {
    try {
        producer.send(documentId, knowledgeBaseId, tenantId);
        return;
    } catch (Exception e) {
        log.warn("MQ 投递失败,自动降级为同步执行: docId={}", documentId);
    }
}
// 降级执行兜底
documentService.processDocumentById(documentId);
多租户上下文穿透(TenantContext 丢失陷阱)
在分布式异步消费中,最隐蔽的 Bug 就是上下文丢失 。
Web 层的租户信息保存在主线程的 ThreadLocal 里,而 MQ Worker 消费线程是从独立线程池分配的,无法继承原有上下文。如果不手动穿透,SQL 会被多租户拦截器打上非法租户标记:
java
@Override
public void onMessage(DocumentProcessingMessage message) {
    // 关键:显式从消息载荷恢复租户上下文,并在执行完毕后自动清理防复用污染
    TenantContext.withTenant(message.tenantId(), () -> {
        documentService.processDocumentById(message.documentId());
    });
}
那么,Node.js 真实项目怎么做?
回到最初的问题:Node.js 真的不用消息队列吗?
答案是:正规 Node.js 项目不仅用,而且对任务队列的依赖更重!
因为 Node.js 单线程模型对 CPU 密集和长时间挂起的任务极其敏感,业界成熟方案如下:
- 轻量级/中小型方案 :BullMQ / Bee-Queue(Node.js 圈最主流的分布式任务队列,基于 Redis 实现,天然具备重试、延迟、优先级、并发限制与任务持久化)。
- 大型微服务方案 :接入 RabbitMQ、Apache Kafka、Apache RocketMQ 等企业级消息中间件。
只有在以下场景,你才可以裸用单机语言级异步:
- 任务执行时间极短(< 50ms);
- 纯 I/O 操作,且没有 CPU 密集计算;
- 失败了无关紧要(例如:打点上报、记录非关键调试日志);
- 即使机器崩溃丢了也不影响数据一致性。
总结金句
单进程异步治的是"等"(避免线程闲置浪费);
消息队列治的是"崩"(避免瞬时流量压垮、节点宕机丢数、计算阻塞主干)。
分清语言语法 与系统架构的边界,是工程师从"写功能代码"跨越到"架构高可用系统"的关键一步。