一张图看懂,一段代码落地。本文以一个"数据工场---数据资源页"的增删改查场景为例,讲解如何用 POM 分层 + 测试数据生命周期自治,解决 UI 自动化中"数据不存在、重跑报错、用例耦合、环境脏数据"等核心痛点。
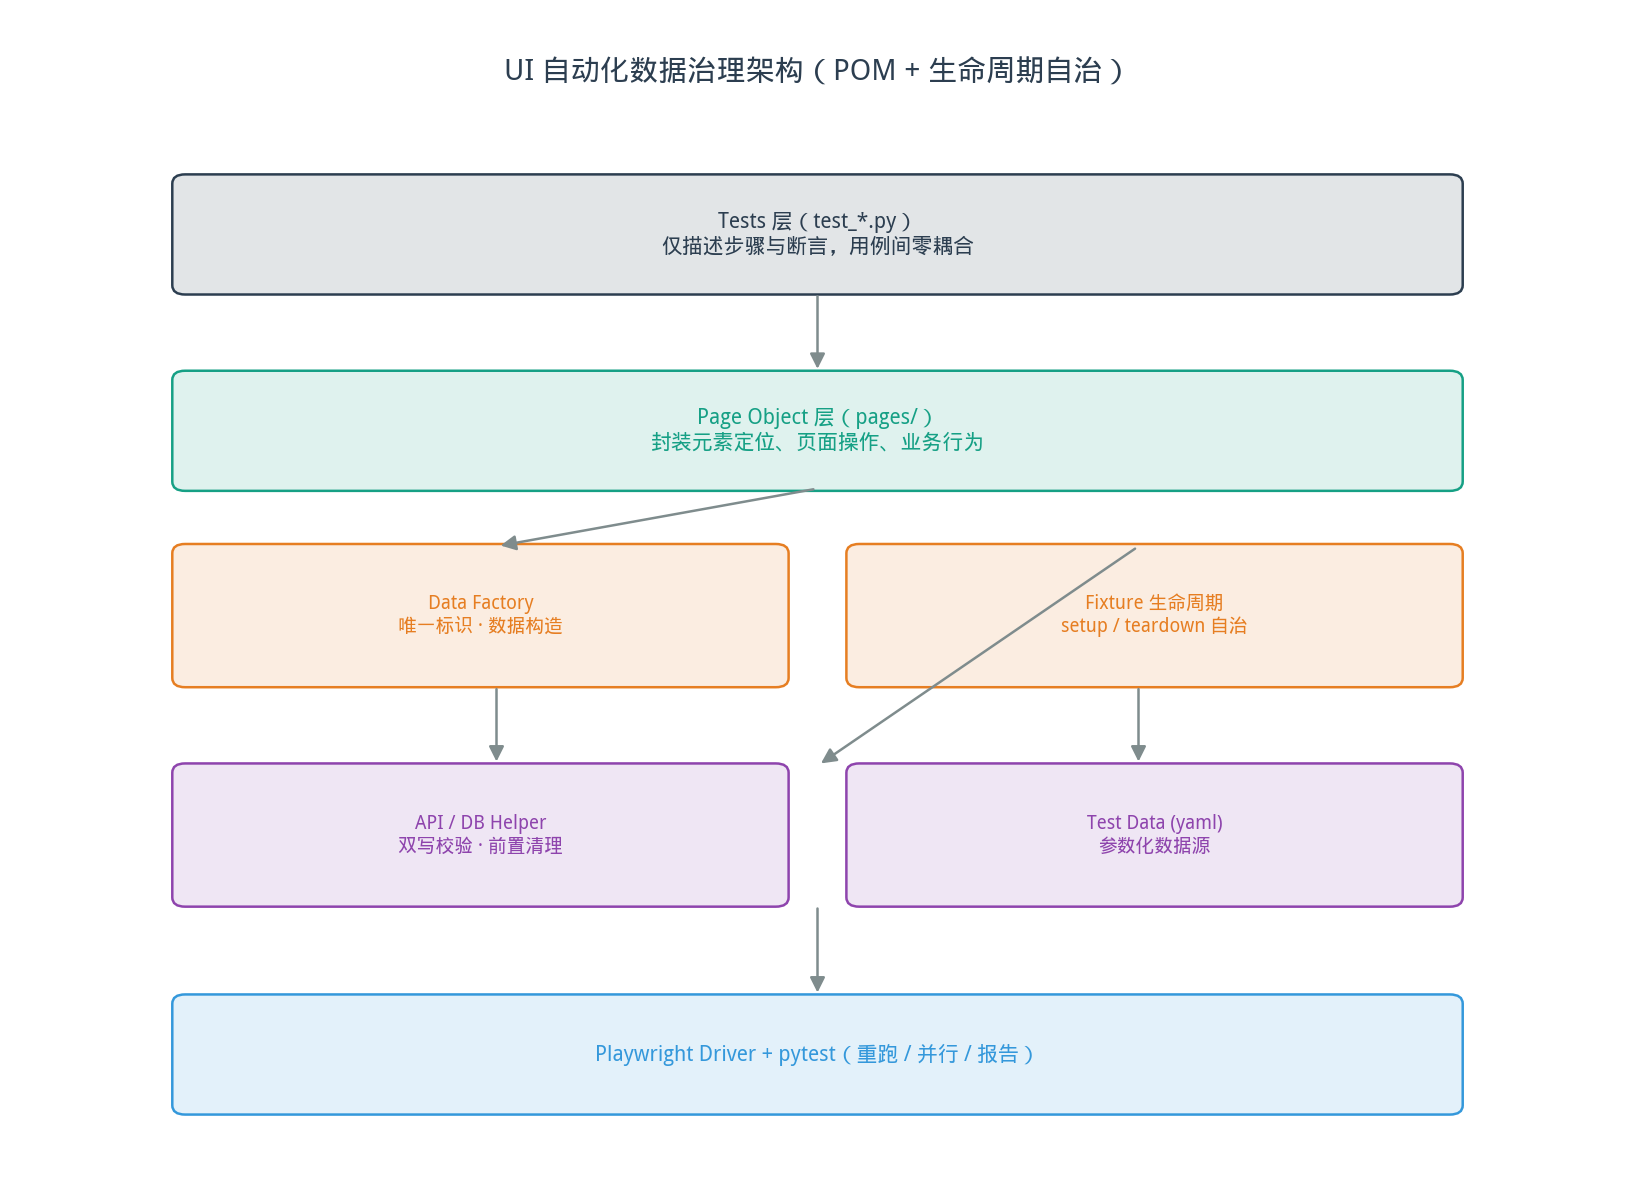
图:POM + 数据生命周期自治的分层架构
一、痛点:UI 自动化不稳定的根源往往不是定位
很多团队写 UI 自动化的体验是:
"昨天能跑,今天报错;本地能跑,CI 失败;跑一次可以,跑两次就炸。"
排查一圈,最后发现问题不在 selector,而在测试数据:
| 常见症状 | 根因 |
|---|---|
修改用例 报"数据不存在" |
用例依赖了"别人"或"上次"留下的数据 |
新增用例 第二次跑报"资源名重复" |
没有幂等设计,违反唯一约束 |
| 用例之间互相影响 | 数据未隔离、未清理 |
| CI 越跑越慢、数据越堆越多 | 缺少生命周期管理 |
| UI 断言通过但数据是假的 | 只验前端、未验后端 |
结论:
UI 自动化稳定性的天花板,取决于测试数据的可控程度,而非定位技术的优劣。
二、设计原则(先立规矩)
在动手前,先约定四条铁律:
- 谁创建,谁销毁:每个用例对自己产生的数据全权负责。
- 用例间零耦合:任意单条用例都能独立、任意顺序执行。
- 幂等优先:重复执行 N 次,结果与执行 1 次一致。
- UI 交互、API/DB 校验:UI 负责"用户视角",API/DB 负责"数据真实性"。
三、目录结构
采用 pytest + Playwright 的经典分层结构:
text
ui_test/
├── pages/
│   ├── login_page.py
│   └── data_resource_page.py     # Page Object
├── tests/
│   └── test_data_resource.py     # 测试用例
├── utils/
│   ├── data_factory.py           # 数据工厂
│   └── db_helper.py              # DB / API 清理与校验
├── test_data/
│   └── resource_data.yaml        # 参数化数据
├── conftest.py                   # fixture / 浏览器 / 登录
└── pytest.ini
各层职责清晰分离,后续维护和扩展都集中、可控。
四、POM 层:只封装行为与定位
DataResourcePage 只做元素定位 + 页面操作 + 查询 ,不包含测试逻辑和断言(断言留给用例)。
python
from playwright.sync_api import Page

class DataResourcePage:
    def __init__(self, page: Page):
        self.page = page

    def goto(self):
        self.page.goto("/data-resource")
        self.page.wait_for_load_state("networkidle")

    def add_resource(self, name, desc):
        self.page.click("text=新增")
        self.page.fill("#resourceName", name)
        self.page.fill("#resourceDesc", desc)
        self.page.click("text=确定")

    def edit_resource(self, old_name, new_name):
        self.page.fill("#searchInput", old_name)
        self.page.click("text=查询")
        self.page.click(f"text={old_name}")
        self.page.click("text=编辑")
        self.page.fill("#resourceName", new_name)
        self.page.click("text=确定")

    def delete_resource(self, name):
        self.page.fill("#searchInput", name)
        self.page.click("text=查询")
        self.page.click(f"text={name}")
        self.page.click("text=删除")
        self.page.click("text=确定")

    def resource_exists(self, name) -> bool:
        self.page.fill("#searchInput", name)
        self.page.click("text=查询")
return self.page.is_visible(f"text={name}")要点:把"判断资源是否存在"封装成方法,是后续幂等设计的关键基础设施。
五、数据工厂:统一构造入口
所有测试数据只允许从一个地方"出生",天然避免硬编码与冲突。
python
# utils/data_factory.py
import time, uuid

class DataResourceFactory:
    @staticmethod
    def unique_name(prefix="auto_res"):
        ts = int(time.time())
        rand = uuid.uuid4().hex[:6]
        return f"{prefix}_{ts}_{rand}"

    @staticmethod
    def default_resource():
        return {
            "name": DataResourceFactory.unique_name(),
            "desc": "ui_auto_test",
            "owner": "test_user",
}- 唯一后缀 (
时间戳 + uuid)保证并发、重跑都不冲突; - 复杂数据集中在此构造,便于维护。
六、生命周期自治:谁创建谁销毁
利用 pytest 的 fixture,实现用例级的数据生命周期管理:创建的数据自动登记,用例结束(含失败)后统一清理。
python
# conftest.py
import pytest
from utils.db_helper import delete_resource_by_name
from utils.data_factory import DataResourceFactory

@pytest.fixture
def resource_lifecycle():
    created_names = []          # 登记本用例产生的数据

    def builder(data=None):
        res = data or DataResourceFactory.default_resource()
        created_names.append(res["name"])
        return res

    yield builder

    # teardown:无论如何都清理
    for name in created_names:
        delete_resource_by_name(name)
db_helper.delete_resource_by_name 可走 DB 直连或内部清理接口,保证即使 UI 删除失败也能兜底清理。
七、幂等性:四大场景策略
幂等的核心不是"不报错",而是**"重复执行结果一致"**。
| 场景 | 策略 |
|---|---|
| 新增 | 唯一名(时间戳+uuid) + 前置清理 |
| 修改 | 前置 ensure 确保数据存在 |
| 删除 | 删前判断是否存在,存在才删 |
| 查询 | 不依赖数据顺序,按唯一标识定位 |
修改前"确保存在"
python
def ensure_resource(page, name):
    page_obj = DataResourcePage(page)
    if not page_obj.resource_exists(name):
        page_obj.add_resource(name, "auto create")
修改类用例不再依赖"上一条用例留下了数据",彻底解耦。
八、完整用例:增删改查 + 幂等 + 自动清理
python
def test_resource_crud(page, resource_lifecycle):
    res = resource_lifecycle()          # 自动登记、自动清理
    new_name = res["name"] + "_edited"

    page_obj = DataResourcePage(page)
    page_obj.goto()

    # 新增
    page_obj.add_resource(res["name"], res["desc"])
    assert page_obj.resource_exists(res["name"])

    # 修改
    page_obj.edit_resource(res["name"], new_name)
    assert page_obj.resource_exists(new_name)

    # 删除
    page_obj.delete_resource(new_name)
assert not page_obj.resource_exists(new_name")- 无论执行多少次,因名称唯一 + teardown 清理,绝不违反唯一约束;
- 一条用例覆盖 CRUD,且自包含、可独立运行。
九、参数化:YAML 驱动
把测试数据从代码中剥离,支持多组数据复用:
yaml
# test_data/resource_data.yaml
- name: res_001
  desc: 描述一
- name: res_002
  desc: 描述二
python
import yaml
import pytest

def load_data():
    with open("test_data/resource_data.yaml") as f:
        return yaml.safe_load(f)

@pytest.mark.parametrize("data", load_data())
def test_add_resource_param(page, data, resource_lifecycle):
    res = resource_lifecycle(data)      # 用 yaml 数据,但仍走生命周期
    page_obj = DataResourcePage(page)
    page_obj.add_resource(res["name"], res["desc"])
    assert page_obj.resource_exists(res["name"])
参数化也接入
resource_lifecycle,保证每组数据都会被清理。
十、UI + API 混合校验(大厂标配)
UI 断言只能证明"前端显示了",不能证明"数据真的写进去了"。核心链路建议双校验:
python
def test_edit_resource_hybrid(page, resource_lifecycle):
    res = resource_lifecycle()
    new_name = res["name"] + "_edited"

    page_obj = DataResourcePage(page)
    page_obj.goto()
    page_obj.add_resource(res["name"], res["desc"])
    page_obj.edit_resource(res["name"], new_name)

    # API / DB 校验数据真实落库
assert api_get_resource(new_name) is not None| 校验方式 | 优点 | 缺点 |
|---|---|---|
| UI 断言 | 贴近用户操作 | 慢、易受前端影响 |
| API/DB | 快、可信 | 不覆盖前端交互 |
最佳实践:UI 做交互、API/DB 做数据真实性校验,兼顾稳定与覆盖。
十一、CI 与重跑策略
pytest.ini 配置:
ini
[pytest]
addopts = -s -v --reruns 2 --reruns-delay 3
重试只对"可恢复异常" (网络抖动、元素暂未出现),不对"数据冲突 / 断言失败"重试------后者说明是设计或逻辑问题,掩盖只会积累技术债。
十二、一句话总结(可直接用于简历 / 面试)
采用 POM 分层 + 数据工厂 + Fixture 生命周期自治,通过唯一标识、前置数据准备、后置自动清理与 UI/API 双校验,保证 UI 自动化用例幂等、可重跑、零耦合,可在 CI 中稳定执行。
附:核心源码结构一览
| 文件 | 职责 |
|---|---|
pages/data_resource_page.py |
元素定位、页面操作 |
utils/data_factory.py |
唯一数据构造 |
utils/db_helper.py |
清理、API/DB 校验 |
conftest.py |
fixture 生命周期管理 |
tests/test_data_resource.py |
用例步骤与断言 |