VBVR-Pro: A Scalable and Verifiable Suite for Native Visual Reasoning
一、Motivation:为什么需要这样一套 suite
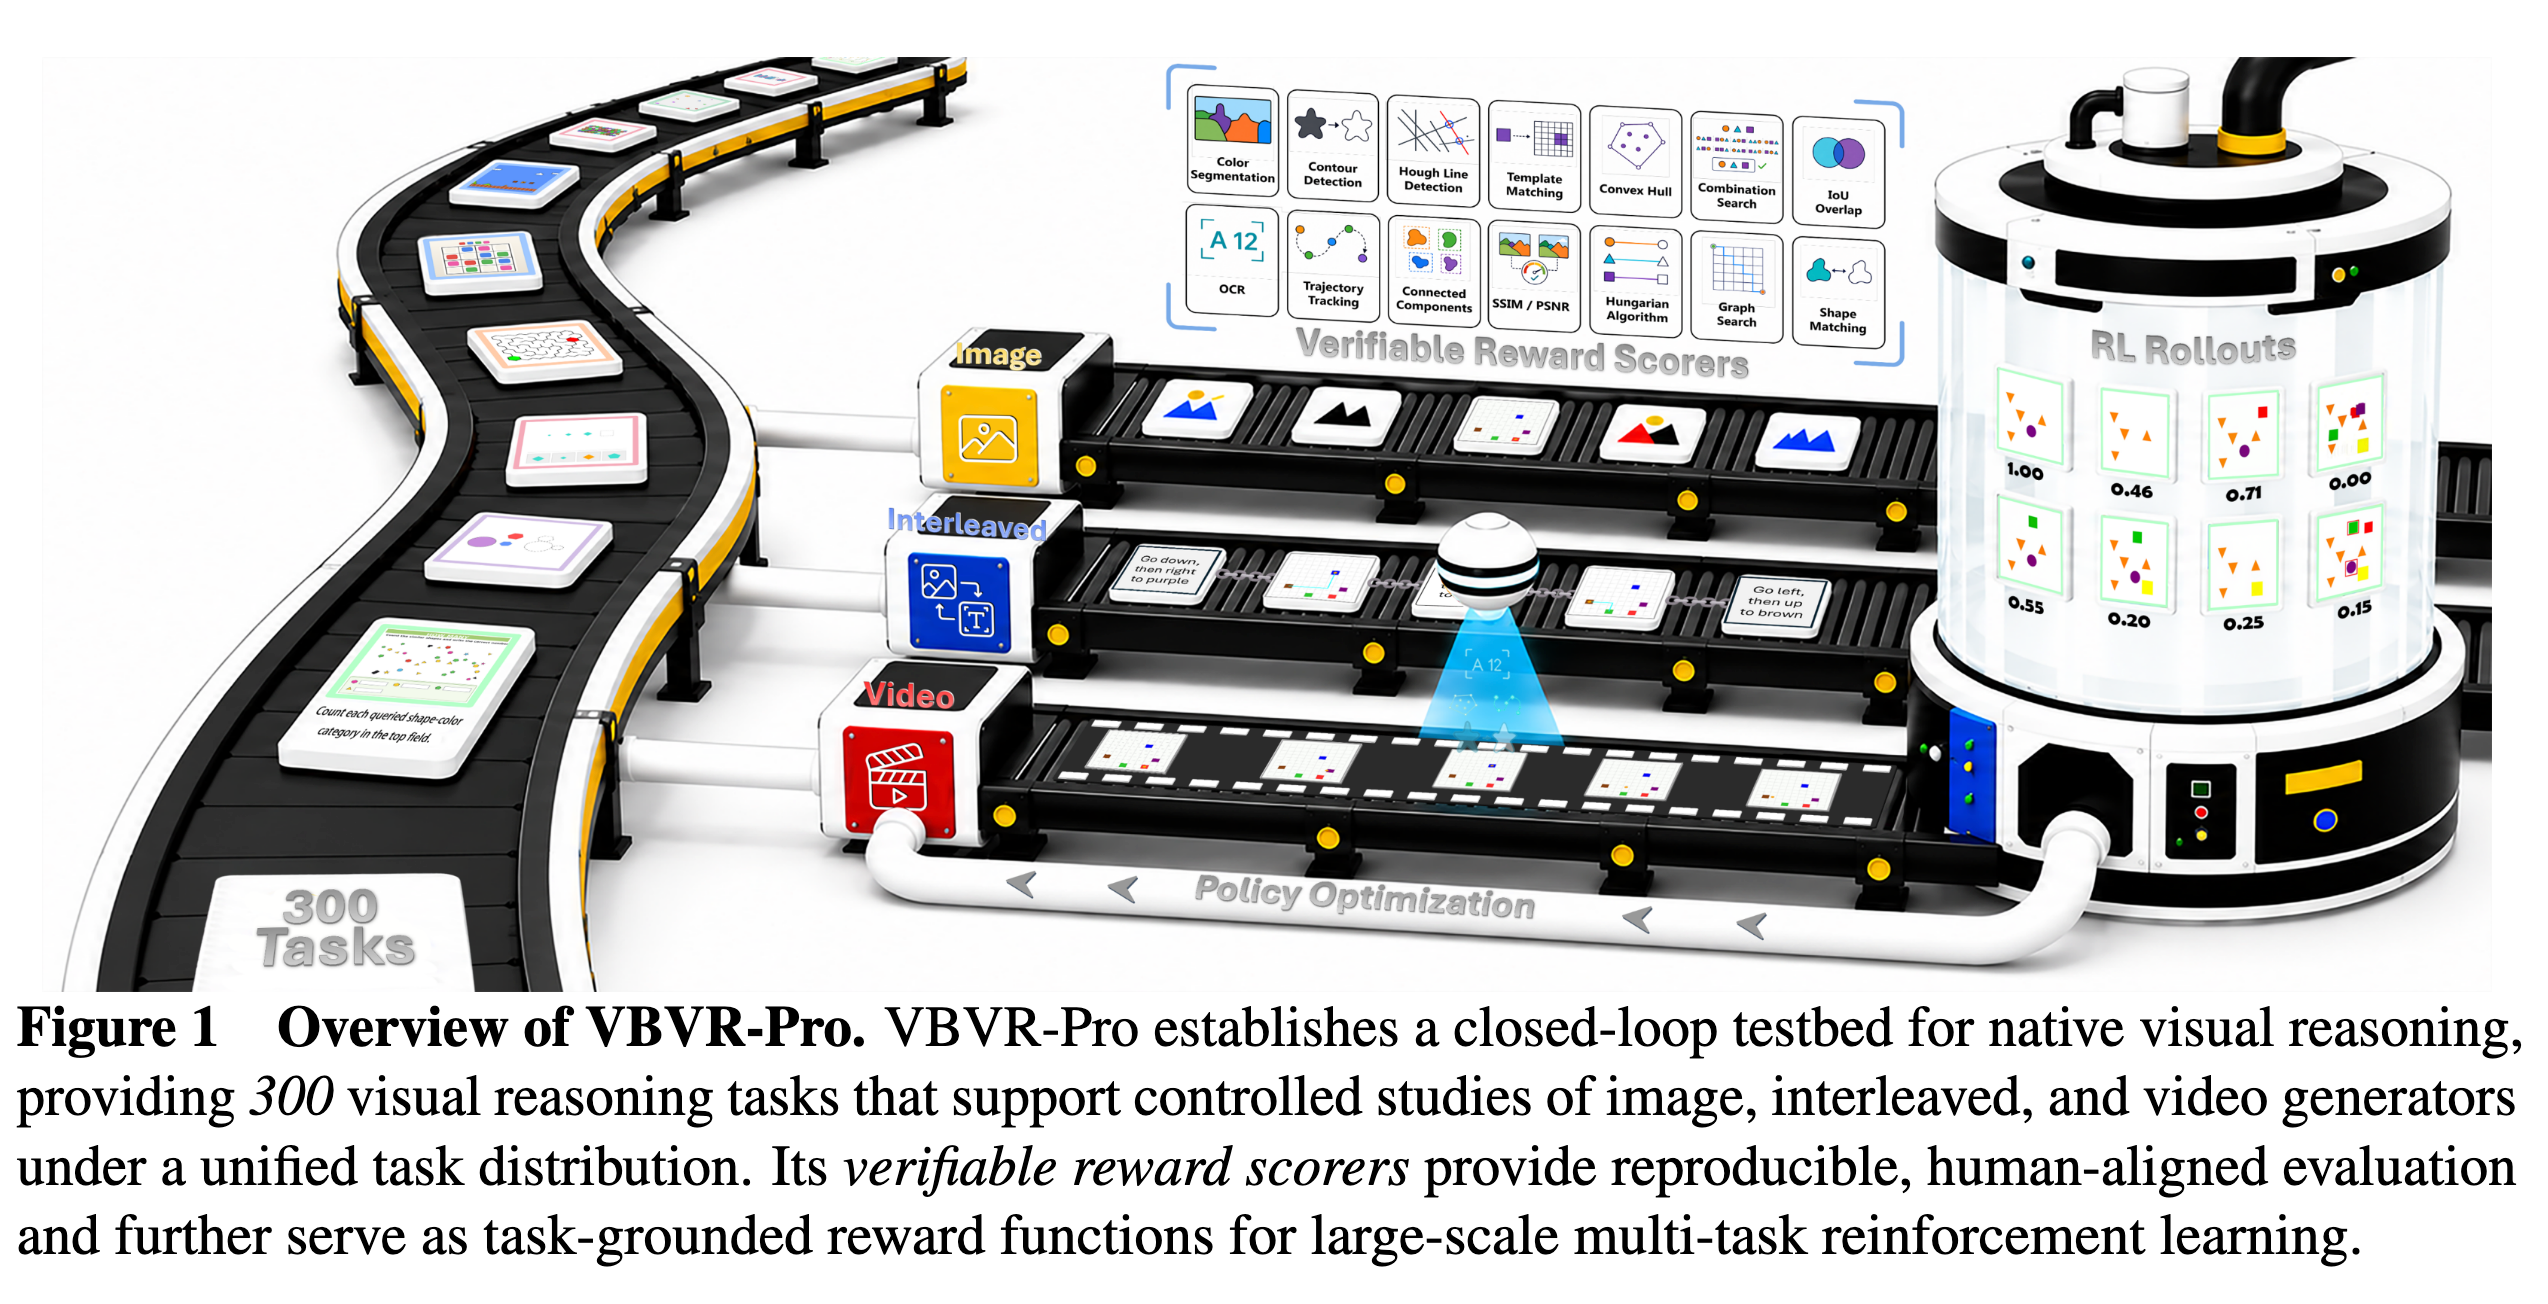
1.1 什么是 native visual reasoning
论文开篇给了一个定义上的区分,这是理解全文的钥匙:
- 传统做法 :视觉状态是 LLM 推理器的输入 (VQA),或者是推理完成后的渲染输出(T2I)。推理本身发生在语言空间。
- Native visual reasoning :视觉状态本身就是推理的媒介(substrate)。模型通过构造、更新、优化一系列图像/视频帧来解决问题------走迷宫就真的把 agent 一帧一帧挪过去,转方块就真的把它转过去。
作者的立场是:物理世界里的很多智能形式天然不是语言的(空间变换、时间连续性、物体恒存、动态交互),强行翻译成语言链条会丢信息。
1.2 三个卡脖子的地方
这篇的问题定义写得很清楚,整篇文章的三个模块就是对着这三条打的:
| 瓶颈 | 具体表现 | VBVR-Pro 的回应 |
|---|---|---|
| 没有可规模化的训练任务源 | 现有 benchmark 基本是 eval-only,没训练数据;已有的合成源(VBVR)局限在简化的符号场景 | 300 个程序化生成器,1.25M 训练实例 |
| 没有可靠的反馈信号 | VLM-as-a-judge 在需要精确计数、细粒度空间关系、时序一致性的场景上不可靠 | 100 个 task-specific 的 verifiable reward scorer |
| 没有跨生成范式的受控比较 | image / video / interleaved 三种范式从没在同一任务分布和同一验证协议下比过 | 统一任务分布 + 30 多个模型的对照实验 |
一句话概括作者的主张:**要推进这个方向,需要的是一套闭环基础设施(closed-loop testbed),而不是又一个 benchmark。**闭环指的是:任务能程序化生成 → 输出能被程序验证 → 验证结果能当 reward 回去优化模型 → 优化后的模型再跑任务。
二、Related Work
作者把相关工作分成三块,顺便把自己的位置钉出来了。
2.1 通过视觉生成做原生推理
- Chain-of-Frames (CoF):Wiedemer et al. 观察到 video model 本身就是 reasoner,推理沿着帧展开。OpenCoF 顺着这条路在 video generator 里加可学习的 reasoning token。
- Chain-of-Steps (CoS) :Wang et al. 指出推理还可以沿着 diffusion 去噪步展开------不是帧与帧之间,而是同一帧的不同去噪阶段。这篇后面的可视化分析(4.3 节、5.4 节)全都建立在 CoS 这个工具上。
- MLLM 辅助路线:VChain 把 MLLM 推出的 Chain-of-Visual-Thought 注入 video generation;Cheng et al. 用 MLLM 做 test-time optimization。
- 图像侧:DiffThinker 把视觉推理重新表述成 image-to-image 的生成任务,EndoCoT 用 latent thought 引导生成。
作者指出的 gap:这些工作都只在很有限的任务集上验证过,因为没有统一的基础设施支持大规模训练 + 可验证评估 + 跨模态系统比较。
2.2 Interleaved 视觉-文本推理
Visual Sketchpad(用外部工具画草图)、MVoT(可视化推理轨迹)、Zebra-CoT / DeltaV / ThinkMorph(大规模 interleaved 语料),以及一条压缩路线(把视觉推理压进 update token 或 latent token)。
作者的批评 :这些方法大多继承了一个语言中心的视角------视觉状态只是文本推理的辅助支撑。VBVR-Pro 要论证的恰恰相反:视觉轨迹本身才是一等公民。(第 4 节的两组消融就是在打这个点。)
2.3 视觉生成的 RL
Flow-GRPO、DanceGRPO 这类 group-relative 方法主要优化指令遵循和美学质量。VPRL 在三个导航任务上做了无语言的视觉规划,VideoRLVR 在三个任务上展示了 verifiable reward 的潜力------但规模和任务多样性都很有限。
这篇的增量:50 个任务上联合 RL 训练,100 个任务上评测。
三、Method
3.1 VBVR-Pro-Dataset:任务扩展
核心假设 :真正的瓶颈是任务覆盖度(task coverage),而不是实例数量。反复从固定的几个生成器里采样,只能造出同一种推理模式的大量变体,并不会扩展被训练的能力范围。
分类体系
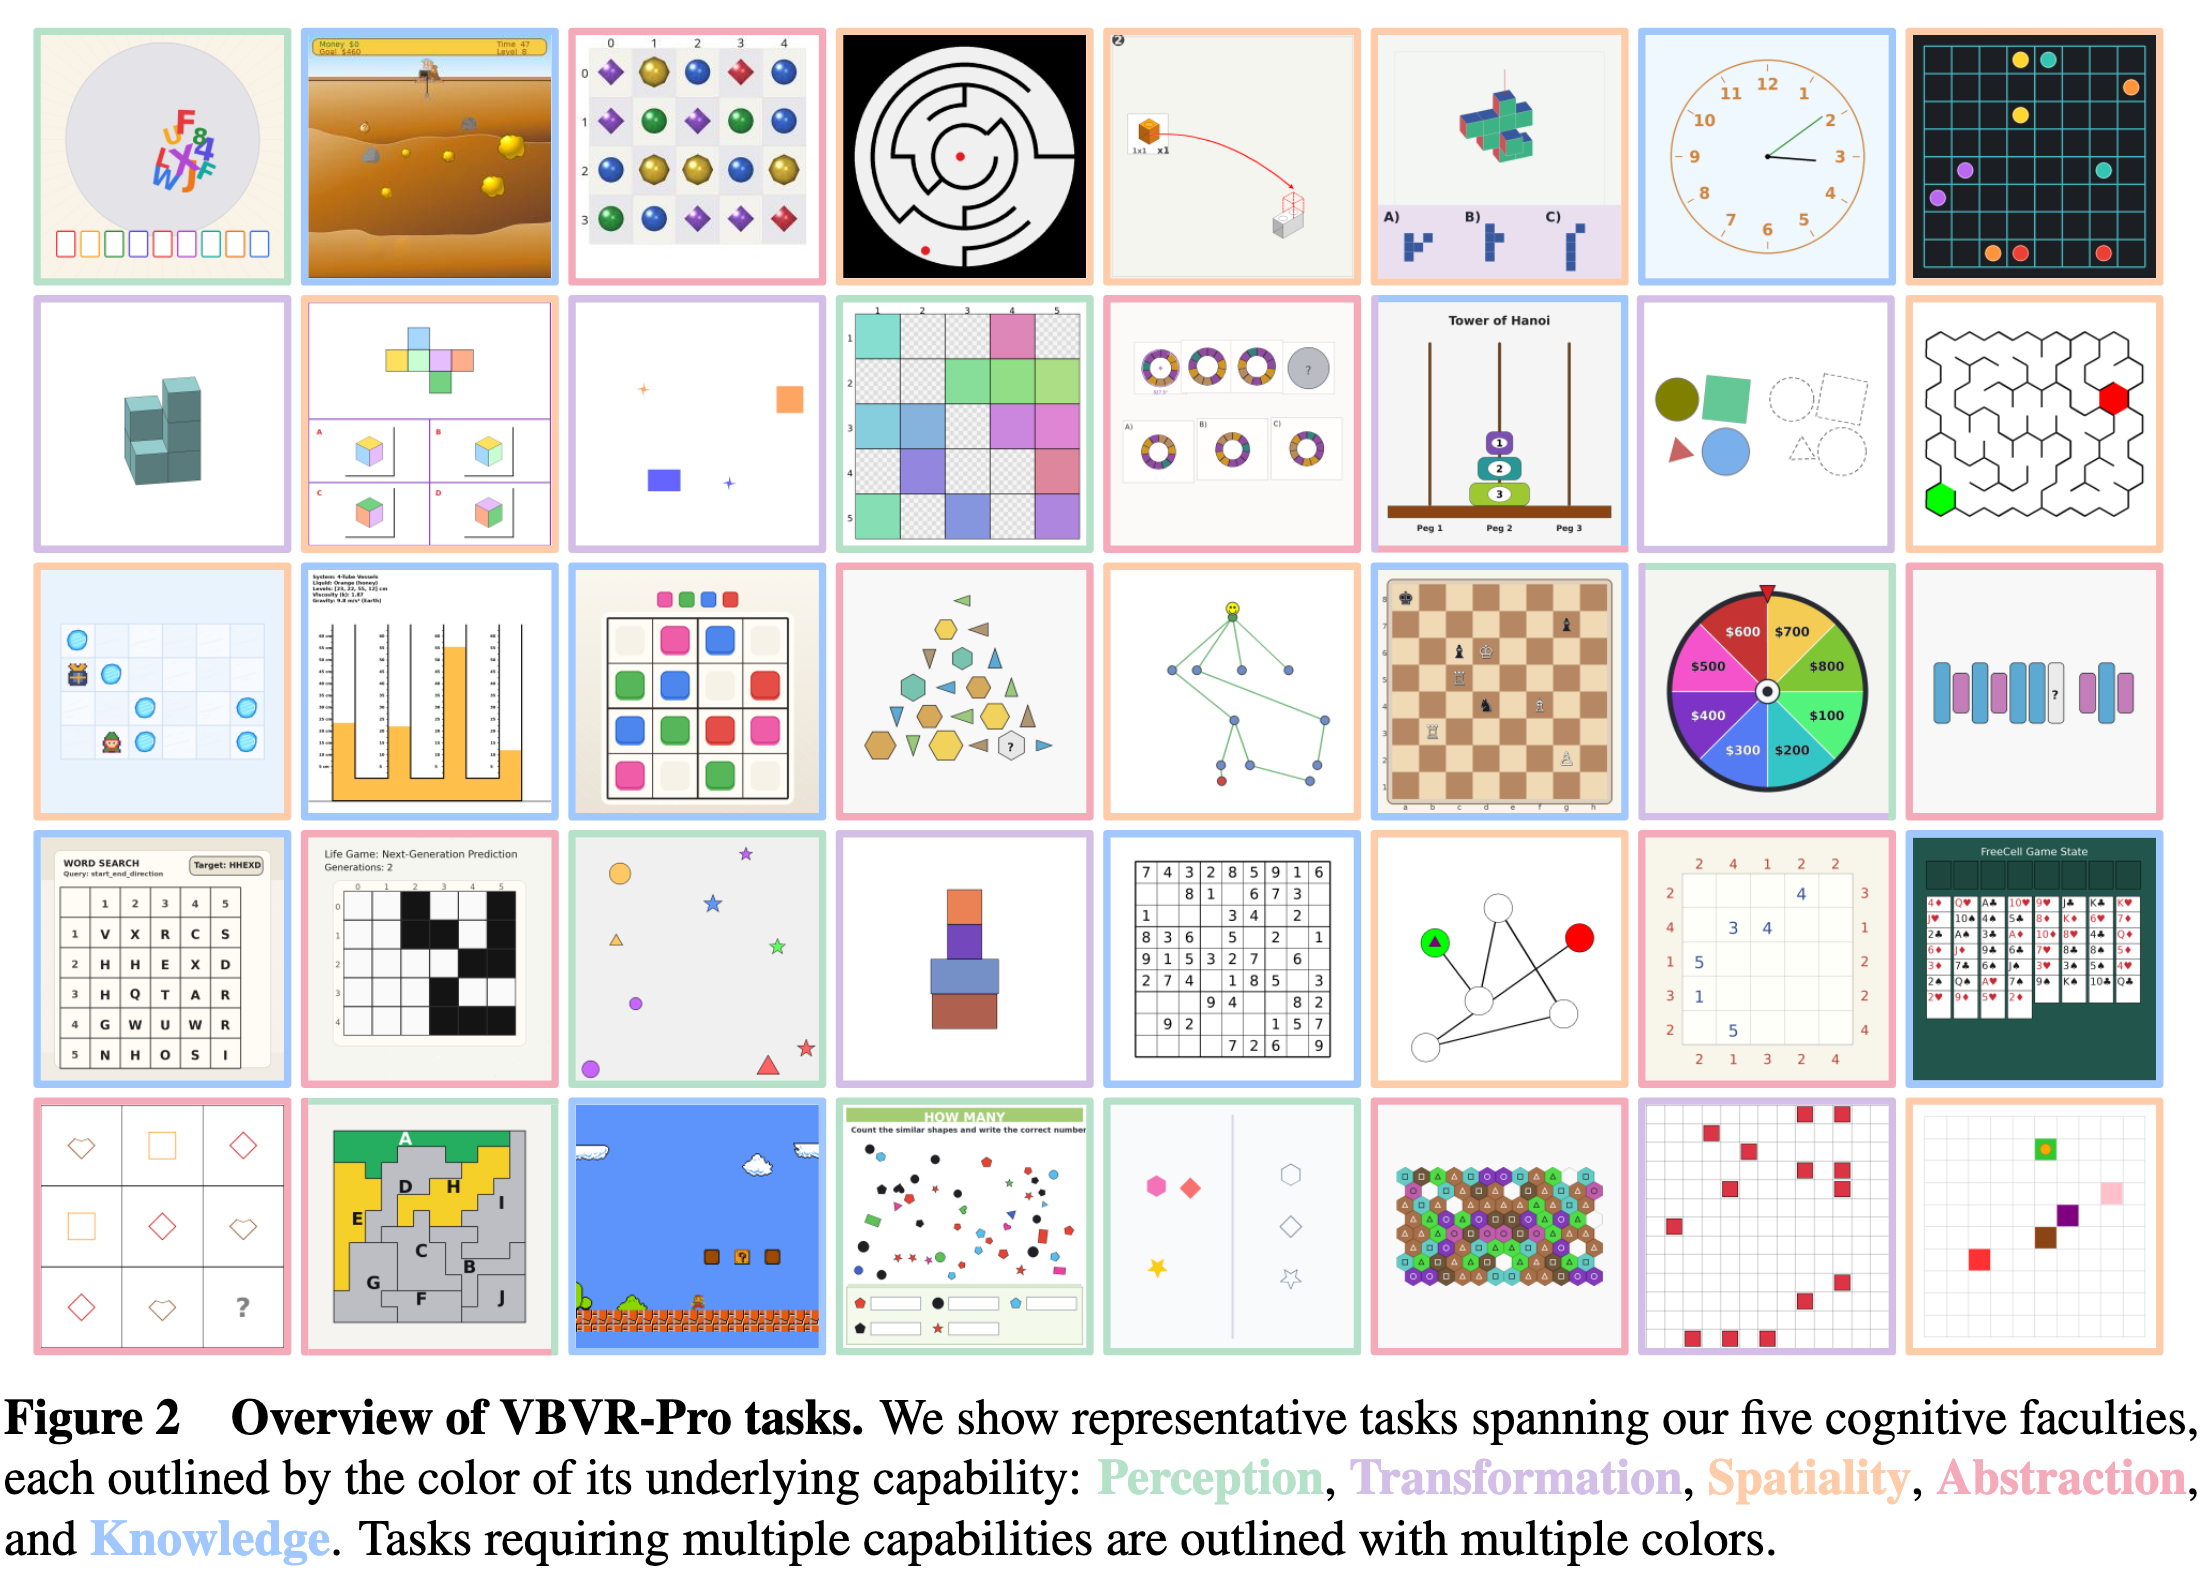
沿用 VBVR 的五个认知能力(faculty),一个任务可以带多个标签:
| Faculty | 覆盖内容 |
|---|---|
| Perception | OCR、符号识别、计数、排序、视觉比较 |
| Spatiality | 相对位置、3D 结构、导航 |
| Transformation | 2D 平移、旋转等表示操作 |
| Abstraction | 模式归纳、对称性/形状补全、新规则下的推理 |
| Knowledge | 图标含义、物理现象、常识、棋类规则与策略、日常物体的机制 |
实现:generator + solver + metadata
这是整套东西能成立的地基:
generator(参数化程序)
    ├─ 从结构化参数空间采样 config(网格大小、物体数、布局、外观、难度)
    ├─ 实例化一个问题实例
    └─ solver 计算正确解 → 无需人工标注的监督信号

metadata(每个实例都有)
    ├─ random seed
    ├─ problem specification
    ├─ complete solution      ← verifiable scorer 的 ground truth
└─ key element attributes这一点怎么强调都不过分:迷宫的墙在哪、最短路是什么,是 BFS 算出来的,不是人标的。「可验证」三个字的全部来源在此。
多模态对齐
同一个已解实例会渲染成 video 和 image 两种模态------不是两个独立语料,而是同一个底层问题的两种渲染,因此可以做真正受控的模态对比。
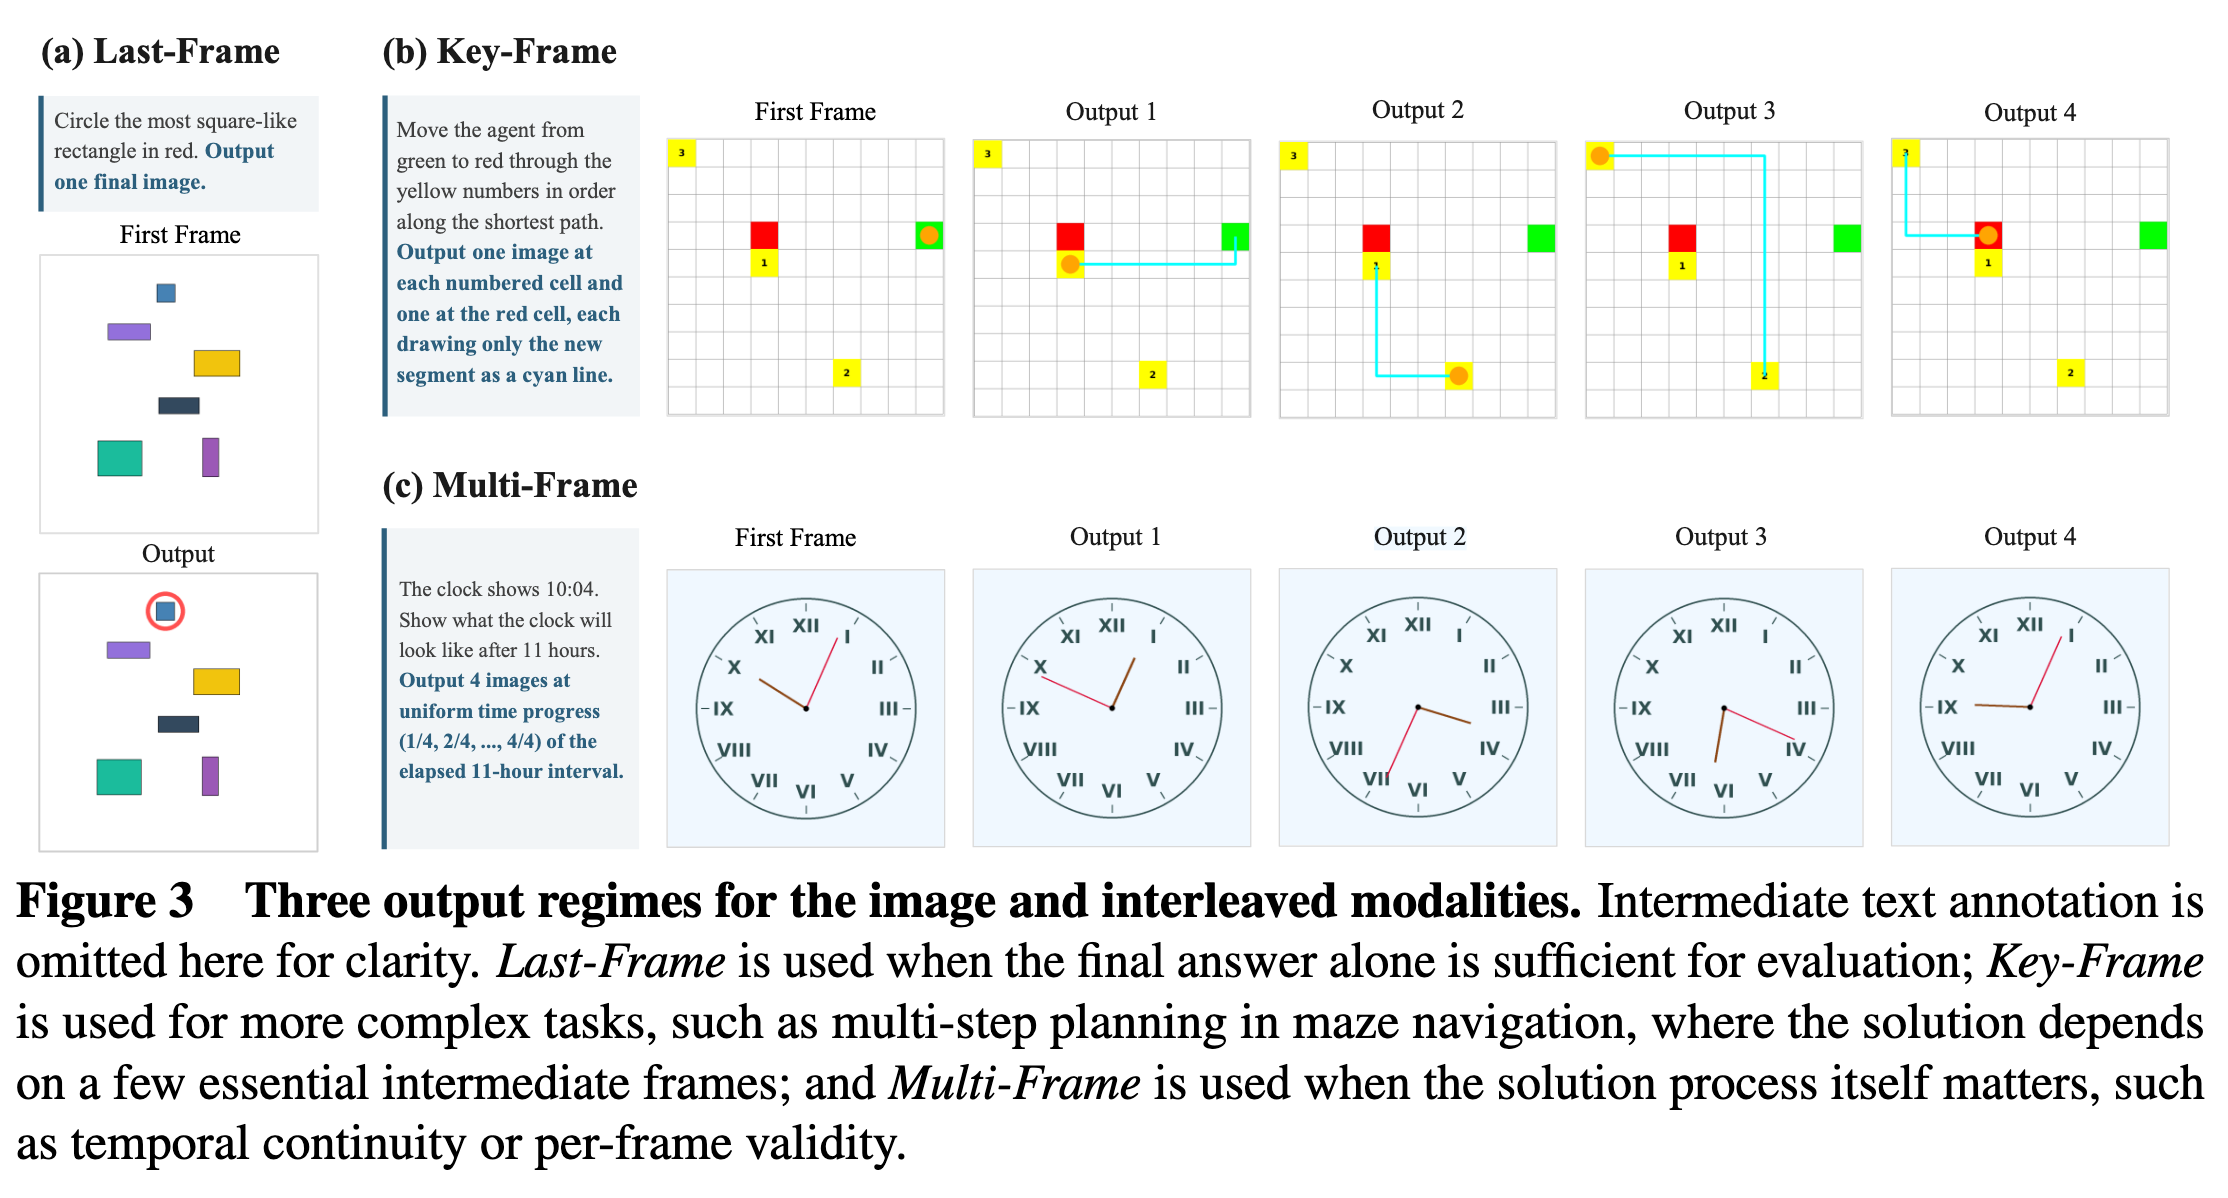
Image 模态分三种 output regime:
| Regime | 用于 | 占比 |
|---|---|---|
| Last-Frame | 最终状态就是完整答案(数独填完、五子棋落子) | 209 / 300 (69.7%) |
| Key-Frame | 中间状态本身是答案的一部分(华容道每一步、迷宫叠加完整路径) | 58 / 300 (19.3%) |
| Multi-Frame | 连续过程,无自然离散分解(旋转 + 平移到目标位姿) | 33 / 300 (11.0%) |
Interleaved 模态则用 Gemini-3.1-Pro-Preview 为每张输出图生成对应的推理文本,每个任务一个手工设计的 prompt。注意这里的做法很取巧:Gemini 拿到的是完整的 solver 生成轨迹,它只负责给已知的状态转移写注解,而不是自己去解题。
规模对比(Table 1 节选)
| Dataset | #Tasks | #Images | #Videos | Image | Interleaved | Video | Eval |
|---|---|---|---|---|---|---|---|
| VideoThinkBench | 48 | 6,845 | 4,149 | -- | -- | ✓ | VLM |
| Zebra-CoT | 18 | 921,039 | 0 | -- | ✓ | -- | -- |
| VBVR | 150 | 2,015,000 | 1,007,500 | -- | -- | ✓ | Verifiable |
| VBVR-Pro | 300 | 3,471,558 | 1,300,500 | ✓ | ✓ | ✓ | Verifiable |
切分:300 个任务里 hold out 50 个做 OOD 评测,剩下 250 个每个采 5000 实例 → 1.25M 训练集。Bench = 50 OOD + 50 ID = 100 个任务。另有 50K 的 RL 专用子集覆盖 50 个 ID 任务。
新任务比旧任务难在哪(作者的自证)
这是一个 reviewer 必问的问题,作者用了三种证据:
-
视觉复杂度(附录 C.3,四个互补指标):
Measure Reworked 中位数 Newly designed 中位数 比值 Distinct regions 11.6 80.4 6.9× Distinct colours 5.3 12.7 2.4× Spatial information 68.8 119.0 1.7× Encoded size (KB) 12.1 24.7 2.0× -
推理深度(附录 C.4,盲测成对比较):150 对里 113 对(75.3%)判定新任务需要更深推理,且双向一致率 88.7%,位置偏差仅 45.8%。
-
多步推理占比:reworked 只有 6.7%,new 有 46.7%。
3.2 Verifiable Reward Scorers
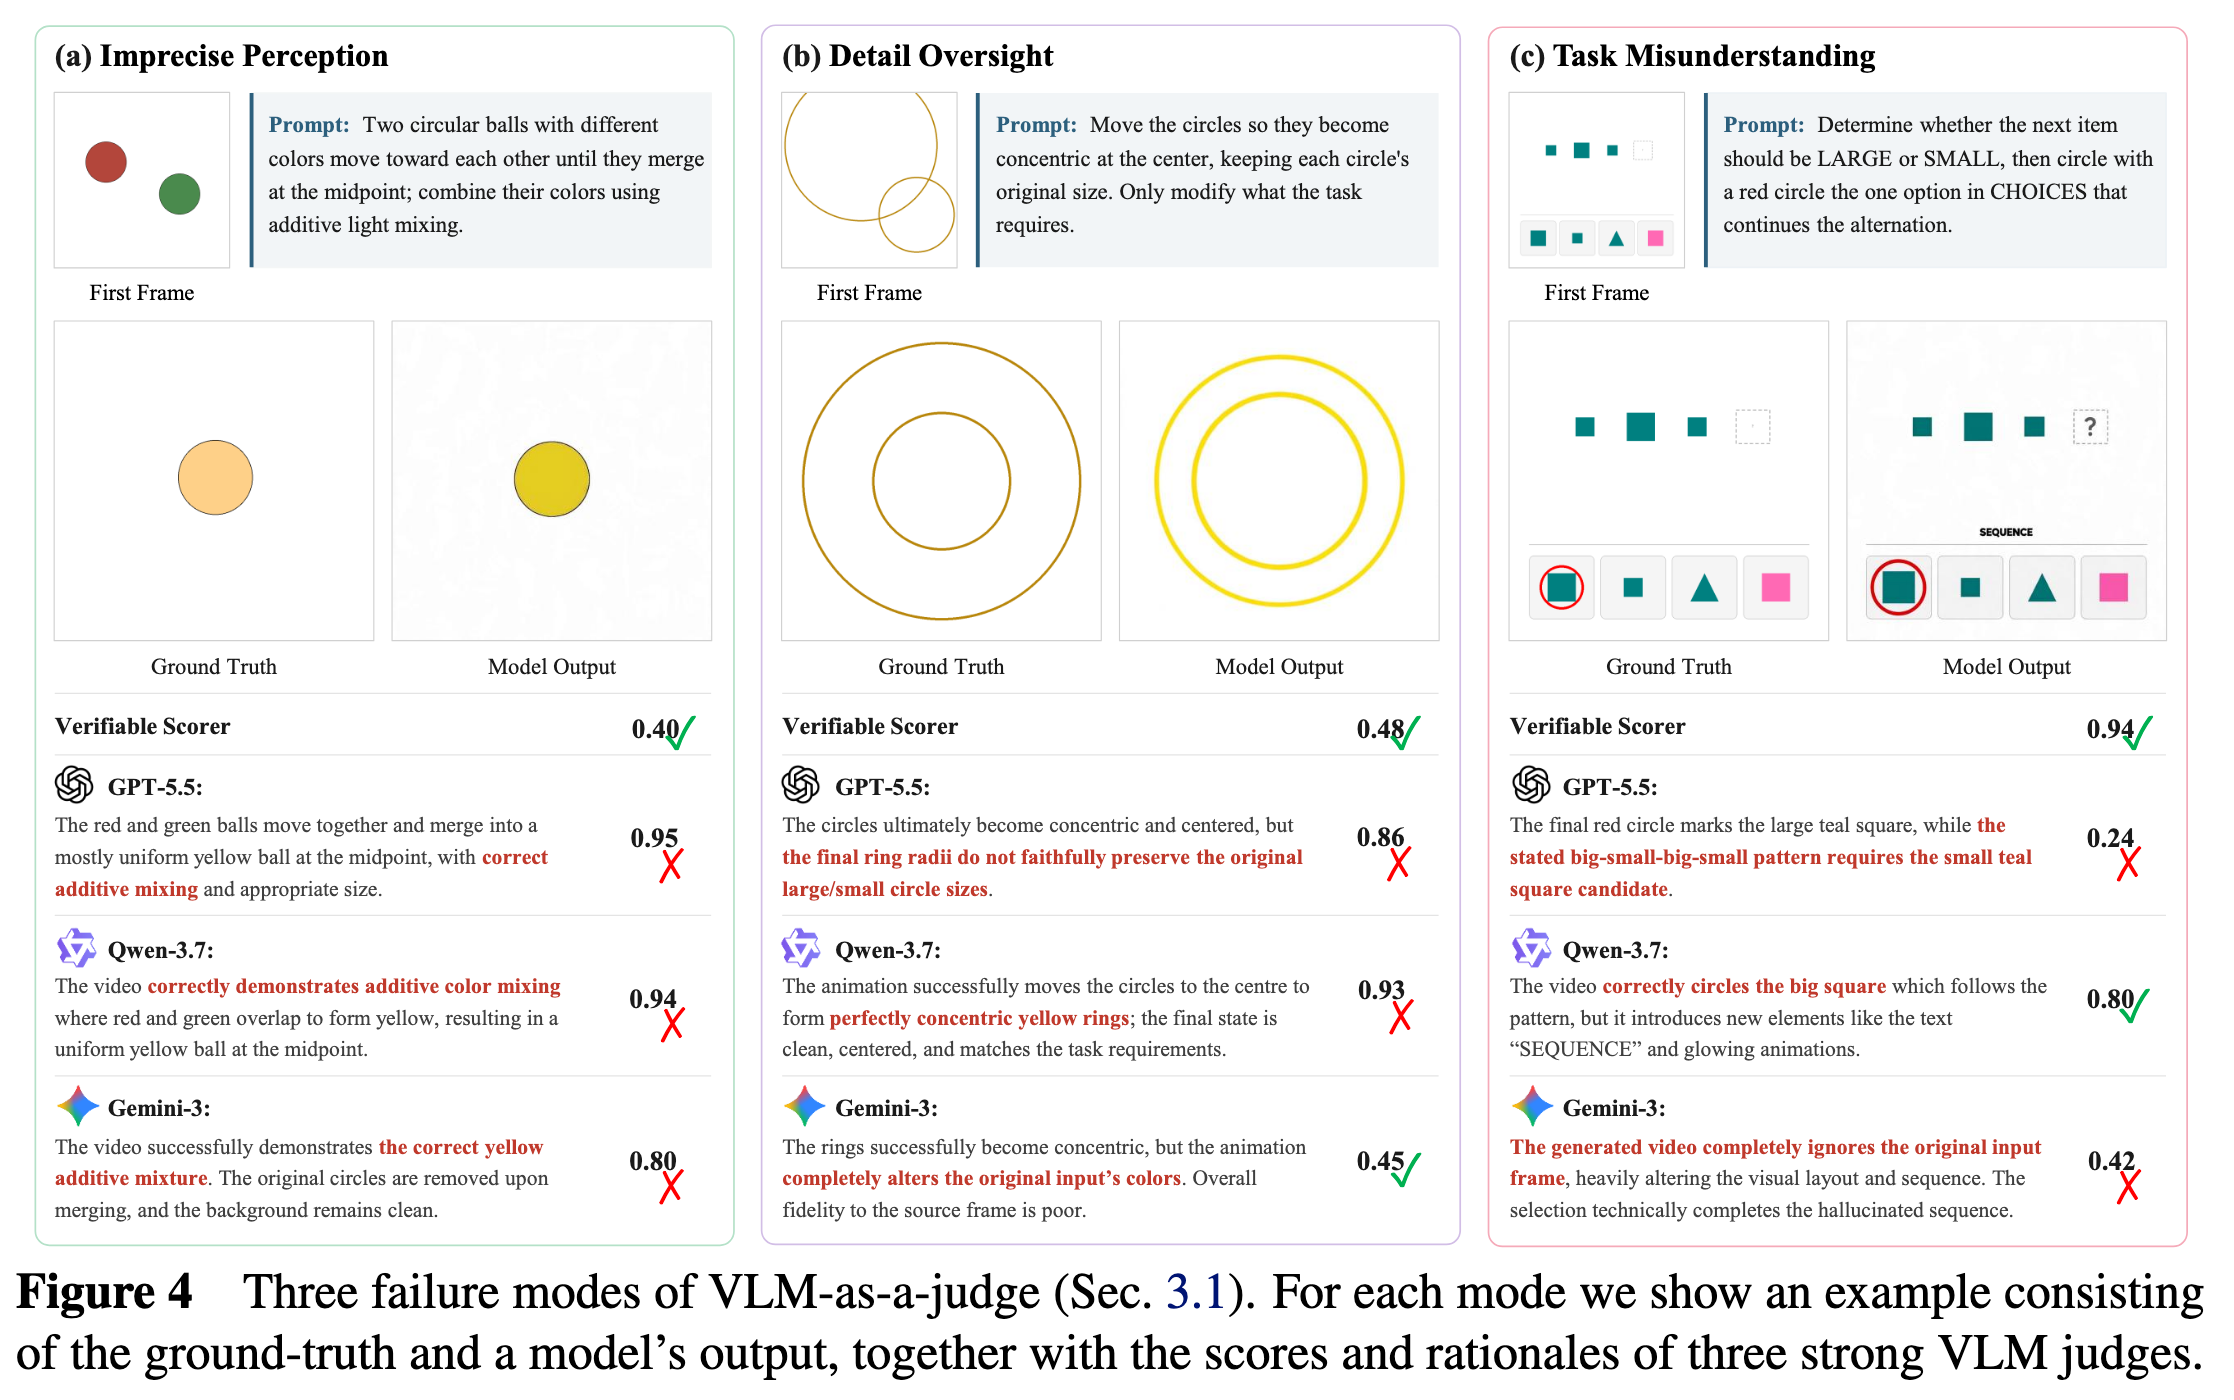
先立靶子:VLM-as-a-judge 的三宗罪
(a) 不准确。Fig. 4 给了三种失败模式:
- Imprecise Perception:加色混合任务里生成球色调明显不对,三个 VLM judge 全给 ≥0.80,scorer 给 0.40
- Detail Oversight:同心圆任务里输出改变了本该保留的圆尺寸和颜色,judge 仍给 0.78 / 0.93
- Task Misunderstanding:模式补全任务里正确答案,scorer 给 0.94,VLM judge 只给 0.24--0.80
注意这是双向错的:既高估错误输出,也低估正确输出。
(b) 贵。RL 场景下要给海量 rollout 打分,闭源 judge 烧 API,开源 judge 抢 GPU。
© 不可复现(Table 2,同一批视频重跑):
| Evaluator | Scorer | GLM-4.6V-Flash | Gemma4-31B | Qwen3.6-27B | Qwen3.7-plus | InternVL3.5-38B | Gemini-3.1-Pro |
|---|---|---|---|---|---|---|---|
| 分数变化比例 ↓ | 0.0% | 54.6% | 69.5% | 74.5% | 80.8% | 82.9% | 92.8% |
| 最大变化幅度 ↓ | 0.000 | 0.125 | 0.110 | 0.117 | 0.091 | 0.158 | 0.221 |
温度设 0 仍有 55--93% 的样本分数会变。当分数被当作 per-sample reward 用时,这种不一致会直接变成噪声梯度。
Scorer 怎么设计
语义实体层,不是像素层 。用经典 CV 方法定位目标并提取属性------HSV 颜色分割、轮廓检测、渲染数字和标签的 OCR、跨帧轨迹追踪------然后在提取出的属性上判分,而非原始像素。理由:像素比较会因为轻微空间偏移或渲染风格差异而惩罚一个正确答案。
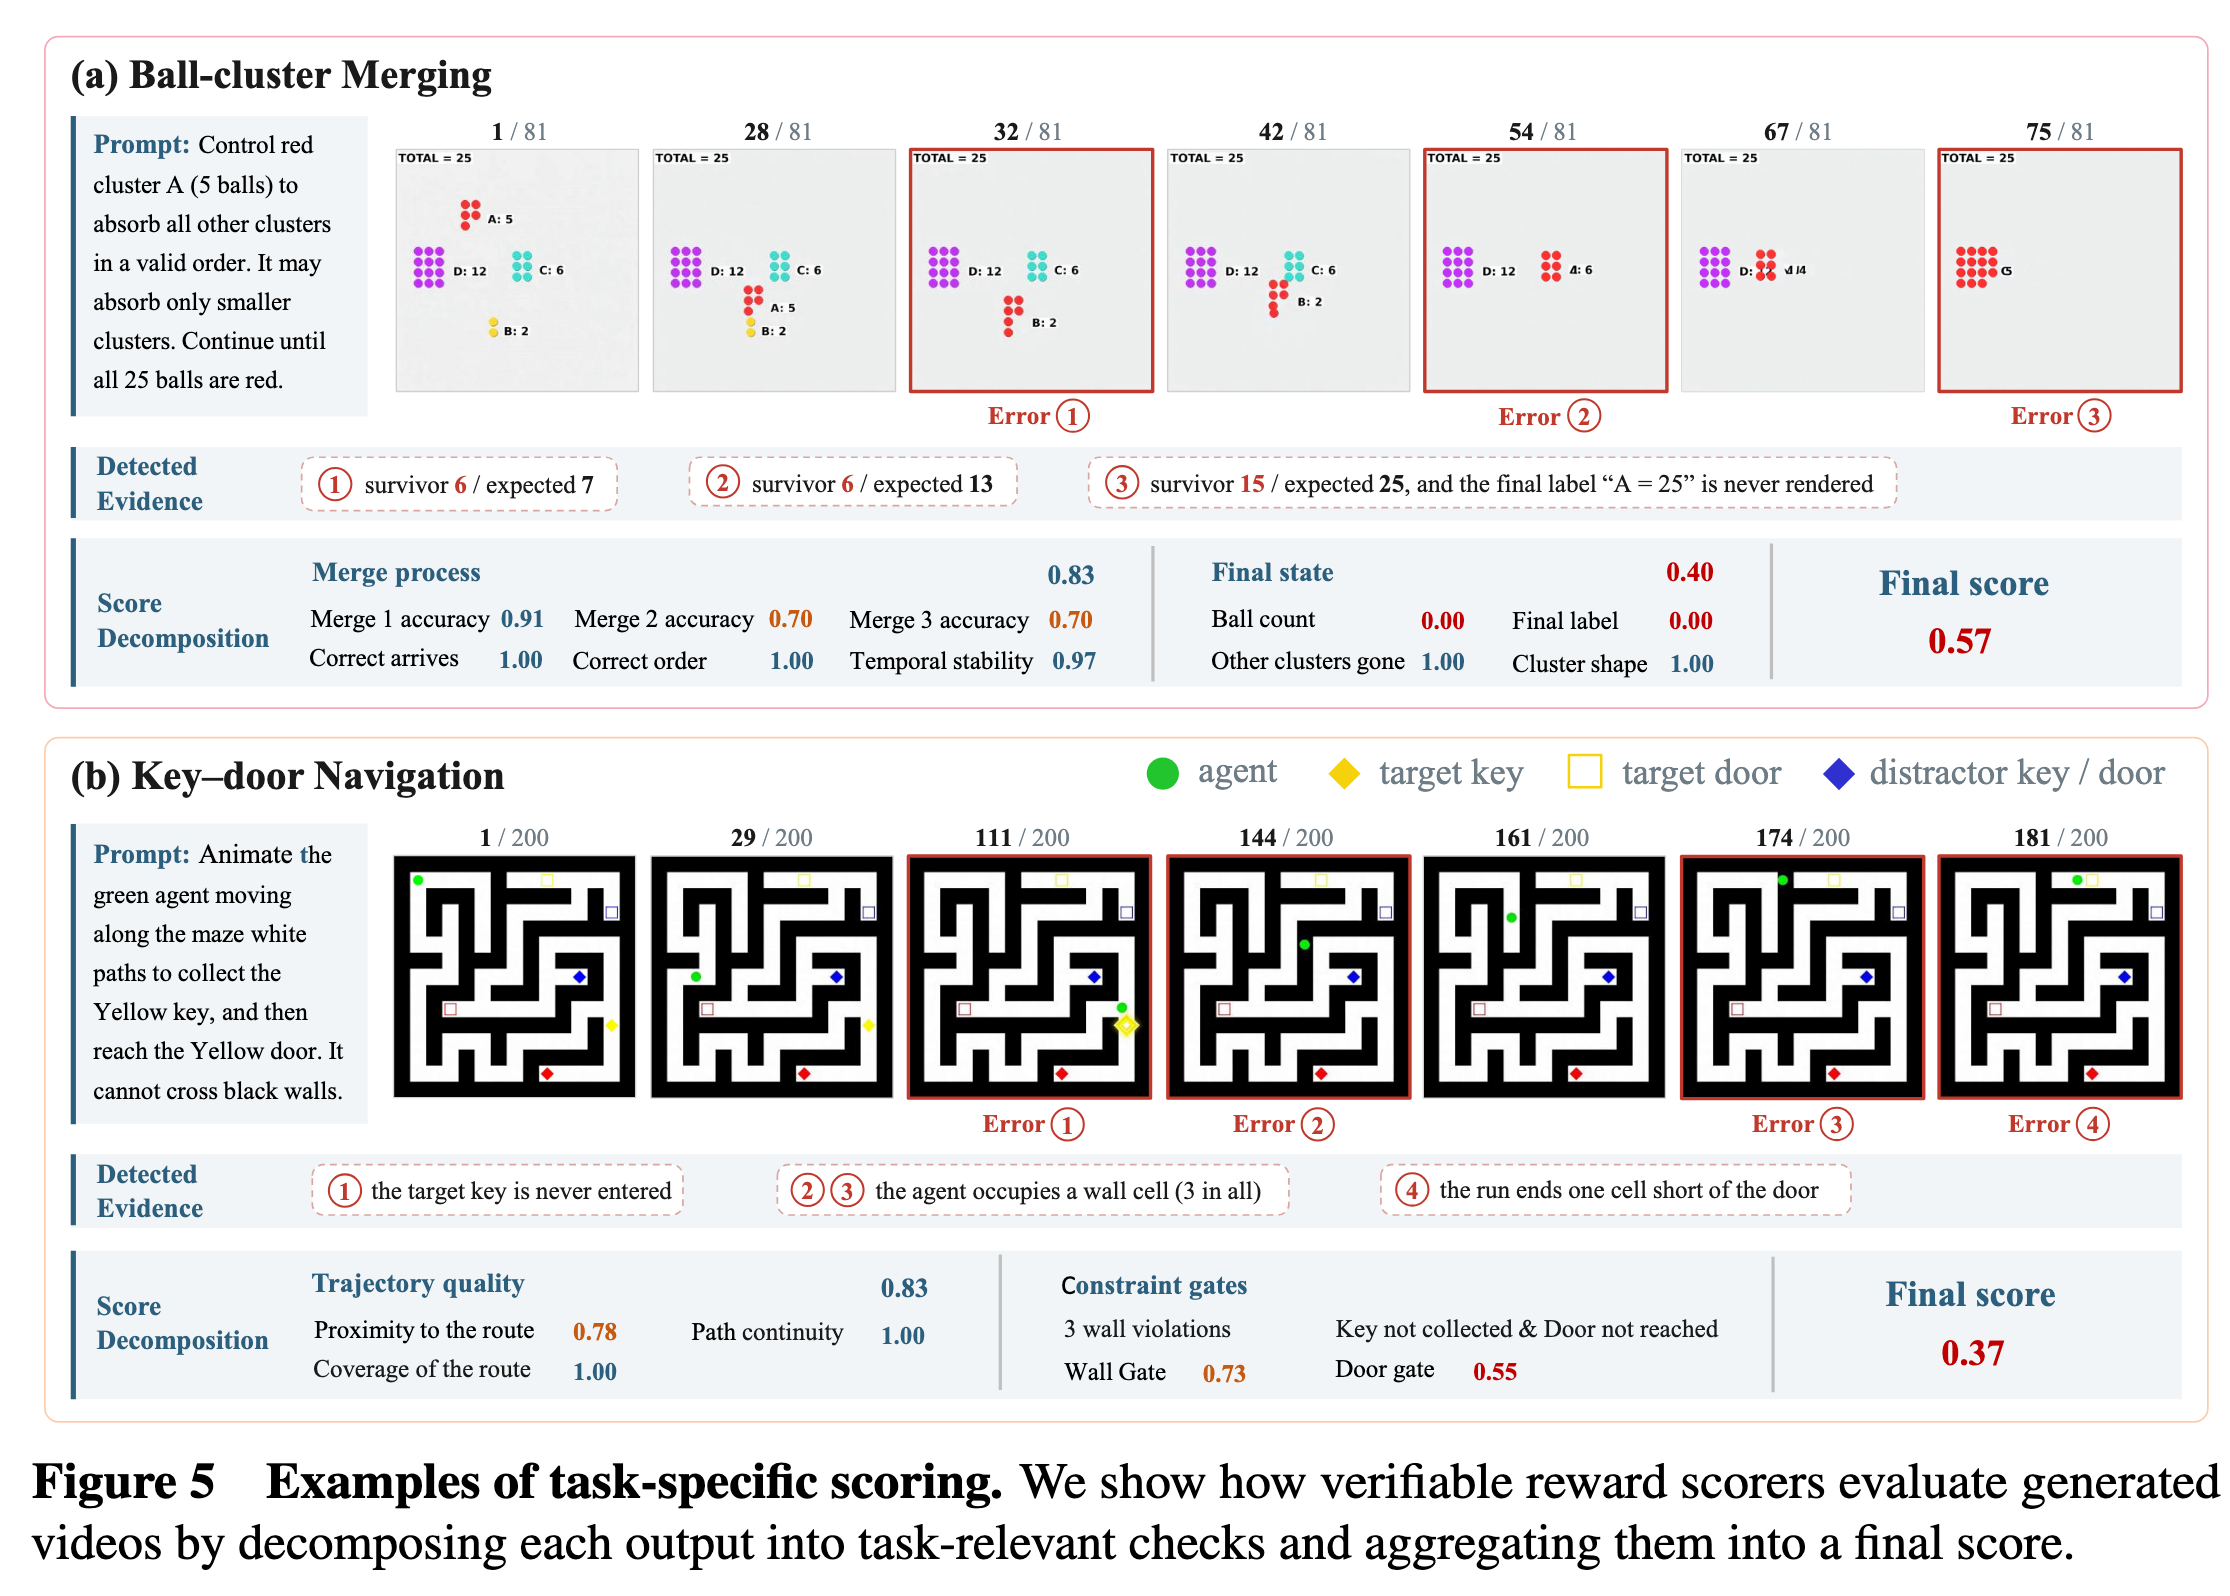
两种聚合方式(Fig. 5 的核心对比):
| 软标准(soft criteria) | 硬约束(hard constraints) | |
|---|---|---|
| 聚合 | 加权求和 | 乘性组合 |
| 效果 | 各项独立贡献,做对的部分照拿分 | 单次违规即大幅压低总分 |
| 例子 | Ball-cluster Merging | Key-Door Navigation(不能穿墙) |
以 Key-Door Navigation 为例,附录 D.2 给了完整公式:
S=13(proximity+continuity+coverage)⏟trajectory⋅(0.4+0.6⋅gwall)⋅(0.4+0.6⋅gkey)S = \underbrace{\tfrac{1}{3}(\text{proximity} + \text{continuity} + \text{coverage})}{\text{trajectory}} \cdot (0.4 + 0.6 \cdot g{\text{wall}}) \cdot (0.4 + 0.6 \cdot g_{\text{key}})S=trajectory 31(proximity+continuity+coverage)⋅(0.4+0.6⋅gwall)⋅(0.4+0.6⋅gkey)
其中 gwall=max(0.4, 1−0.15nhits)g_{\text{wall}} = \max(0.4,\ 1 - 0.15 n_{\text{hits}})gwall=max(0.4, 1−0.15nhits),gkey=1g_{\text{key}} = 1gkey=1(拿到钥匙)或 0.250.250.25(没拿到)。跳过钥匙时该 gate 的乘数被压到 0.4+0.6×0.25=0.550.4 + 0.6 \times 0.25 = 0.550.4+0.6×0.25=0.55。
工程属性:无 API 调用、仅 OCR 时可选用 GPU、完全确定性、并且给出可解释的错误分解(哪一项 check 挂了)。这三条合起来才让它能当 RL reward 用。
验证:与人类偏好对齐
协议设计得比较严格------不是模型级的排序相关,而是实例级的 arena 式人工标注:
- 8 个 video 模型 × 100 任务 × 5 实例 = 4000 个视频
- 每任务采 1 个实例,做完所有 (82)=28\binom{8}{2}=28(28)=28 个模型对
- 每对收 10 个独立标注,四级绝对质量评分(L0L_0L0 完全正确 → L3L_3L3 完全失败)
- 转换成四类成对偏好(A 胜 / B 胜 / 失败线之上的平局 / 失败线上的平局)
关键细节 :平局要拆成两类。因为任务很难,大多数生成视频都落在 L3L_3L3,如果把所有平局合并成一类,就会把"两个都烂"和"两个都好"混为一谈。
结果(Fig. 6):
- Per-vote agreement:scorer > 0.60 vs GPT-5.5 0.54、Gemini-3.1-Pro 0.52,人类天花板 0.77(scorer 达到约 78%)
- 成本最低(而且论文说这还是保守估计------按 H100 整机时长计费的上界)
- 模型排序相关性:ID ρ=0.95\rho=0.95ρ=0.95,OOD ρ=1.00\rho=1.00ρ=1.00,两个 split 上 r≥0.95r \ge 0.95r≥0.95
3.3 RL with Verifiable Rewards
为什么不能直接套 Flow-GRPO
Group-relative 方法要求采样轨迹在reward 相关的决策 上有差异。但在 native visual reasoning 里,有用的探索是语义层面的------迷宫里往左还是往右、选哪个答案、连哪两个物体。标准的随机扰动只改变低层外观,底层决策不变,对 group-relative reward 估计毫无贡献。
那加大随机性?Flow-SDE 有个恶性 trade-off:新注入的高斯噪声没有被 scheduler 规定的预测噪声分量精确补偿,有效噪声幅度会超出预期。Fig. 10 里 η=0.7\eta=0.7η=0.7 已经有明显背景伪影,η=0.9\eta=0.9η=0.9 直接把帧毁了。
解法:Coefficients-Preserving Sampling (CPS)
xt−Δt=(1−(t−Δt))x^0+(t−Δt)cos (ηπ2)x^1+(t−Δt)sin (ηπ2)ϵx_{t-\Delta t} = (1 - (t-\Delta t))\hat{x}_0 + (t-\Delta t)\cos\!\left(\tfrac{\eta\pi}{2}\right)\hat{x}_1 + (t-\Delta t)\sin\!\left(\tfrac{\eta\pi}{2}\right)\epsilonxt−Δt=(1−(t−Δt))x^0+(t−Δt)cos(2ηπ)x^1+(t−Δt)sin(2ηπ)ϵ
关键在 cos2(ηπ/2)+sin2(ηπ/2)=1\cos^2(\eta\pi/2) + \sin^2(\eta\pi/2) = 1cos2(ηπ/2)+sin2(ηπ/2)=1:增大 η\etaη 是用新采样的高斯噪声替换掉一部分预测噪声,而不是往上叠加。总噪声系数保持 scheduler 规定的值不变。所以能在不累积过量噪声的前提下引入足够的随机性去探索不同的视觉决策。
工程优化:one-step-delayed pipeline
同步 pipeline 里,policy optimization 要等 rollout 预处理和 reward 计算跑完,GPU 大量空转。这篇引入固定一步延迟:rollout kkk 生成完就异步扔给 reward worker,GPU 继续生成 rollout k+1k+1k+1;rollout kkk 的 reward 回来后用它做优化,同时 worker 处理 k+1k+1k+1。
与全异步 RL 系统的区别:保持确定性执行顺序,policy staleness 严格界定在一个 rollout 迭代内。
这里有个很实际的系统层对比 :verifiable scorer 跑在 CPU worker 上,不占显存,可以和 GPU 端完全重叠;RLVLM 则要常驻一个 Qwen3.6-27B 做 judge,实现里预留了 50% 显存。128 张 H800 上跑 2200 步,RLVR 约 5.1 天 vs RLVLM 约 8.3 天,吞吐 1.63×,墙钟时间少 38.7%。
四、Experiments
4.1 主结果:训练有效,但离人类还很远
30+ 模型在 VBVR-Pro-Bench 上,几个关键数字:
- 顶级闭源模型(Seedance 2.0 0.499、GPT-Image-2 0.507、Nano Banana Pro 0.564、Seedream-5.0-Pro 0.557)已经有非平凡的视觉推理能力
- 学术开源模型差距巨大(HunyuanVideo-I2V 仅 0.054)
- 在 VBVR-Pro-Dataset 上训练,9 个模型全部提升,平均 +0.290
- ID 平均 +0.401,OOD 平均 +0.179 ------ 不只是实例级泛化,也有跨任务族的迁移
- 最强的 VBVR-Pro-Wan2.2-I2V-A14B 达到 0.670,但仍远低于人类水平
4.2 模态对比(本文最有信息量的结论之一)
| 范式 | 结论 |
|---|---|
| Video | 在需要持续时空状态追踪的任务上最强;ID transformation 和 OOD 各类别上优势明显 |
| Interleaved | 训练后在很多 ID 任务上与最强 video 模型持平(0.638 vs 0.670),且生成/推理成本低得多 |
| Image-only | 显著弱于两种轨迹式表示,尤其在 transformation 任务上 |
作者的解读:一旦底层任务结构被学到,一串稀疏但任务相关的离散视觉状态就足以解决很多熟悉的推理问题;但当需要精确建模状态转移、或把学到的转移动力学外推到训练分布之外时,稠密的时间表示才显出价值。
4.3 视觉轨迹 vs 文本语义(Table 5 消融)
在 interleaved 模型上做三组设置:
| 设置 | ThinkMorph Overall | SenseNova-U1 Overall |
|---|---|---|
| Full text + Multi image(参考) | 0.373 | 0.638 |
| Full text + Single image | 0.349 (−0.024) | 0.527 (−0.111) |
| Placeholder text + Multi image | 0.374 (+0.001) | 0.629 (−0.009) |
去掉中间视觉状态明显掉点;把中间文本换成无语义占位符几乎没影响。
4.4 反事实诊断
针对「提升到底是真推理还是拟合指令模板」这个质疑:
输入端干预:
| # | 干预 | Overall |
|---|---|---|
| 1 | 原始输入(参考) | 0.638 |
| 2 | 文本改写,语义不变 | 0.640 |
| 3 | 移除文本中的任务语义 | 0.317 |
| 4 | 移除输入图像 | 0.064 |
| 5 | 图像水平翻转 / 旋转 180°(文本方向词同步变换) | 0.613 |
第 2 行说明不依赖指令的特定语言形式;第 4 行说明答案根本无法从文本单独恢复;第 5 行构造的几何反事实保留任务但改变视觉实现,性能基本保持------说明模型是在对具体视觉状态做操作,而不是记忆题面到答案的映射。
中间状态干预(推理时直接改中间输出):
| # | 干预 | Overall |
|---|---|---|
| 6 | 移除中间文本 | 0.533 |
| 7 | 中间文本改成矛盾的(left→right) | 0.530 |
| 8 | 移除中间图像 | 0.099 |
| 9 | 中间图像加强噪声 | 0.190 |
视觉通路的敏感度高出一个数量级。这和 4.3 节的训练时结论互补:视觉轨迹不仅是更强的监督来源 ,在推理时也被因果地使用。
4.5 Chain-of-Step 可视化
沿用 Wang et al. 的工具,解码不同去噪步的含噪 latent。观察到两种行为:
- Multi-Path Exploration:去噪早期同时探索多条候选路径,逐步收敛到最短可行路线
- Superposition-Based Exploration:多个可能的视觉状态在中间去噪步叠加,最后坍缩到一个解
video 模型通过连续物体运动表示这个过程,interleaved 模型则直接在图像空间画出候选路径。
4.6 迁移性(Table 7)
| Benchmark | Wan2.2-I2V-A14B (base) | VBVR-Pro-Wan2.2-I2V-A14B | Veo-3.1 (参考) |
|---|---|---|---|
| RISE-Video | 62.83 | 66.18 | 76.40 |
| V-ReasonBench | 10.21 | 38.22 | 24.25 |
| RULER-Bench | 57.89 | 66.96 | 65.19 |
| MME-CoF-Pro | 24.76 | 48.39 | 55.90 |
| VideoThinkBench mini | 25.71 | 52.86 | 27.69 |
| BabyVision-Gen | 0.36 | 12.50 | -- |
| intelligentVBench | 3.93/5 | 4.11/5 | 3.74/5 |
这些 benchmark 包含大量真实世界场景(日常物体、机器人操作臂),和 VBVR-Pro 的程序化抽象差异很大。
为排除「记忆相似训练样本」的解释,作者做了 nearest-neighbor 分析:用 CLIP / DINOv2 检索初始图像的最近训练样本,用 BGE 检索指令的最近样本。检索到的实例在视觉上与 query 差异显著(DINOv2 相似度 0.308--0.491),说明学到的是抽象的视觉概念和操作(模式发现、排序、物体操纵),而非表层外观。
4.7 RL 结果
| Model | Overall | ID Avg. | OOD Avg. |
|---|---|---|---|
| Baseline (VBVR-Pro-Wan2.2-TI2V-5B) | 0.470 | 0.641 | 0.300 |
| + SFT | 0.503 | 0.679 | 0.328 |
| + RLVLM (Qwen3.6-27B as judge) | 0.508 | 0.671 | 0.345 |
| + RLVR (verifiable scorer) | 0.548 | 0.719 | 0.377 |
RLVLM 相对 SFT 只有微弱提升(+0.005),RLVR 有实质提升(+0.045)。Fig. 11 的训练曲线更说明问题:RLVR 稳定上升,RLVLM 很快停滞,并且在 400--500 步有一个明显的临时掉点。
附录 B.5 追查了这个不稳定:那个掉点是因为高随机性采样下生成背景逐渐变灰,而通用 VLM judge 不会可靠地惩罚这种细微的背景色偏差,误差于是在优化中累积放大;task-grounded 的 scorer 则显式捕捉到这个偏差。
这个案例很有说服力 :它不是在说 VLM judge 分数低,而是在说它的盲区会被 RL 主动利用------这正是 reward hacking 的标准形态。
4.8 案例研究
- Fig. 12(颜色序列补全) :pre-RL 模型在最初几个去噪步就锁定了错误答案并保持到最后;RLVR 模型初始也错,但在 Step 6 改了预测,最终收敛到正确答案。两者用同样的 30 步 schedule,所以差异不能归因于额外推理算力------RLVR 延长了固定去噪预算内的有效推理视野。
- Fig. 13(迷宫):pre-RL 的 agent 在帧间位置断裂、不构成有效解(0.2249);RLVR 沿连通走廊走出一条连贯路线并到达目标(0.8692)。
五、Conclusion
作者的总结是三件事的合成:
- 可规模化的课程(curriculum):300 个程序化生成的视觉推理环境,不只是更大的任务集合
- 与人类对齐且可用于 RL 的 verifiable reward scorer
- 模态受控的模型套件,加上诊断性证据
更大的主张是:一组迁移研究 + 反事实诊断 + 视觉状态干预 + 轨迹可视化 + reward 驱动的优化,共同指向「视觉生成模型能够构造、维护、精化中间视觉轨迹」------视觉生成不只是一种输出格式,而是一个真正的推理媒介。
六、个人思考
6.1 Verifiable reward 的真实适用边界
读完最容易得出的结论是「这套方法只适合程序生成的图」,但我觉得这个判断不够准。真正的必要条件是两条:
- ground truth 可获得。合成任务只是获取它最省事的一种方式(BFS 直接给出正确路径),不是唯一方式------真实视频配关键点标注、或有动捕真值的机器人平台,同样满足。
- 属性提取足够可靠。这一条才是合成数据真正在帮忙的地方。纯色 sprite 上用 HSV 阈值找绿点,准确率接近 100%;换成真实视频里找"那个人",你得上检测器,而检测器本身带误差,reward 就带噪。
合成数据在两处同时提供便利,这让方法看起来比实际更依赖"合成"这件事。据此可以判断哪些真实场景其实也能用:
- 机器人操作:目标是"把方块放进盒子",用位姿真值判定
- 物理一致性检查 :不需要 ground truth 轨迹,只查"有没有穿模"、"加速度是不是 9.8"。这类约束型检查只要能提取属性就成立,是最有推广价值的一支
- 图表 / UI / 文档生成:目标状态是结构化的,直接对比目标 DOM
真正不行的是「生成一段电影级的日落海滩镜头」------没有标准答案,好坏是审美判断。但这是 RLVR 在所有领域的共同边界(数学和代码能做 RLVR 因为有答案和测试用例,写诗就不行),不是这篇的特有缺陷。
6.2 这套 scorer 本质上绑定了 I2V/TI2V
这是我觉得论文没有明说、但值得摆到台面上的一点。
首帧不只是"提供条件",它其实把打分器的坐标系钉死了 。scorer 代码里 grid[round(r)][round(c)] == WALL 这行要成立,必须满足:视频里的迷宫和 config 里的 grid 完全一致、尺度固定、原点对齐、且 154 帧里这些都不变。给了首帧,这些全部自动成立------模型的任务只剩"让绿点动起来"。
纯 T2V 下,模型自己画迷宫,墙在哪不知道、格子多大不知道,甚至可能画出一个 start 到 key 根本不连通的迷宫。ground truth 和生成内容之间的对应关系断了 ,ref_path 就变成一个无处安放的东西。
Prompt 的措辞也印证了这一点------"the green agent"、"the maze white paths"、"the Yellow key",全是定指。这些话只有在画面已经在那儿的前提下才说得通。Table 4 里所有 video 模型也确实都是 I2V 或 TI2V。
如果要往纯 T2V 推,路子只有降级:先从生成视频里反解出迷宫结构,然后只查内禀一致性("agent 有没有穿过它自己画的墙"),放弃"走的是不是最短路"。而且这立刻打开 reward hacking 的口子------模型可以画个超简单的迷宫、或者把钥匙和门画在相邻格,约束全满足。