一、先说清楚这节课到底要干什么
之前咱们写了一个网络版的命令执行器:客户端发命令,服务端 fork 出进程执行,把结果通过管道倒腾回来再发给客户端。那节课的重点是把一个 TCP 服务器的骨架跑通。
这节课换业务了------写一个网络版计算器 :客户端发 10 + 20,服务端算完把 30 回回来。业务听起来简单,但它逼出了一个真问题:
内存里的对象(一堆成员变量),怎么变成一串字节发到网络上?对端拿到这串字节,又怎么还原成对象?
这就是序列化和反序列化。所以这节课的代码在上一课基础上多了三样东西:
Socket 封装升级 :裸的 socket/bind/listen 包成了类,而且用的是设计模式里的模板方法模式;
协议层
Protocol.hpp:定义请求Request和应答Response,里面放序列化/反序列化的接口(这节课先搭空架子);jsoncpp 的使用 :不自己手搓字符串了,用 JSON 这种通用格式做对象和字符串之间的转换,演示代码都在
testjson.cc里。
内容分上下两篇。上篇 把模板方法、序列化概念、jsoncpp 这套工具讲透;下篇再把空架子填上,实现真正的计算器,并且解决 TCP 字节流的报文边界问题(粘包)。
这节内容涉及的环境:Ubuntu 22.04,g++ 11.4,C++17,jsoncpp 1.9.5(apt install libjsoncpp-dev)。
二、工程鸟瞰:十个文件各管什么
先把整个工程摊开看,不然后面讲代码容易迷路:
| 文件 | 职责 | 本篇待遇 |
|---|---|---|
Common.hpp |
退出码枚举、NoCopy 防拷贝、CONV 地址强转宏 |
基础设施 |
InetAddr.hpp |
sockaddr_in 的 C++ 包装,IP/端口主机序与网络序互转 |
基础设施 |
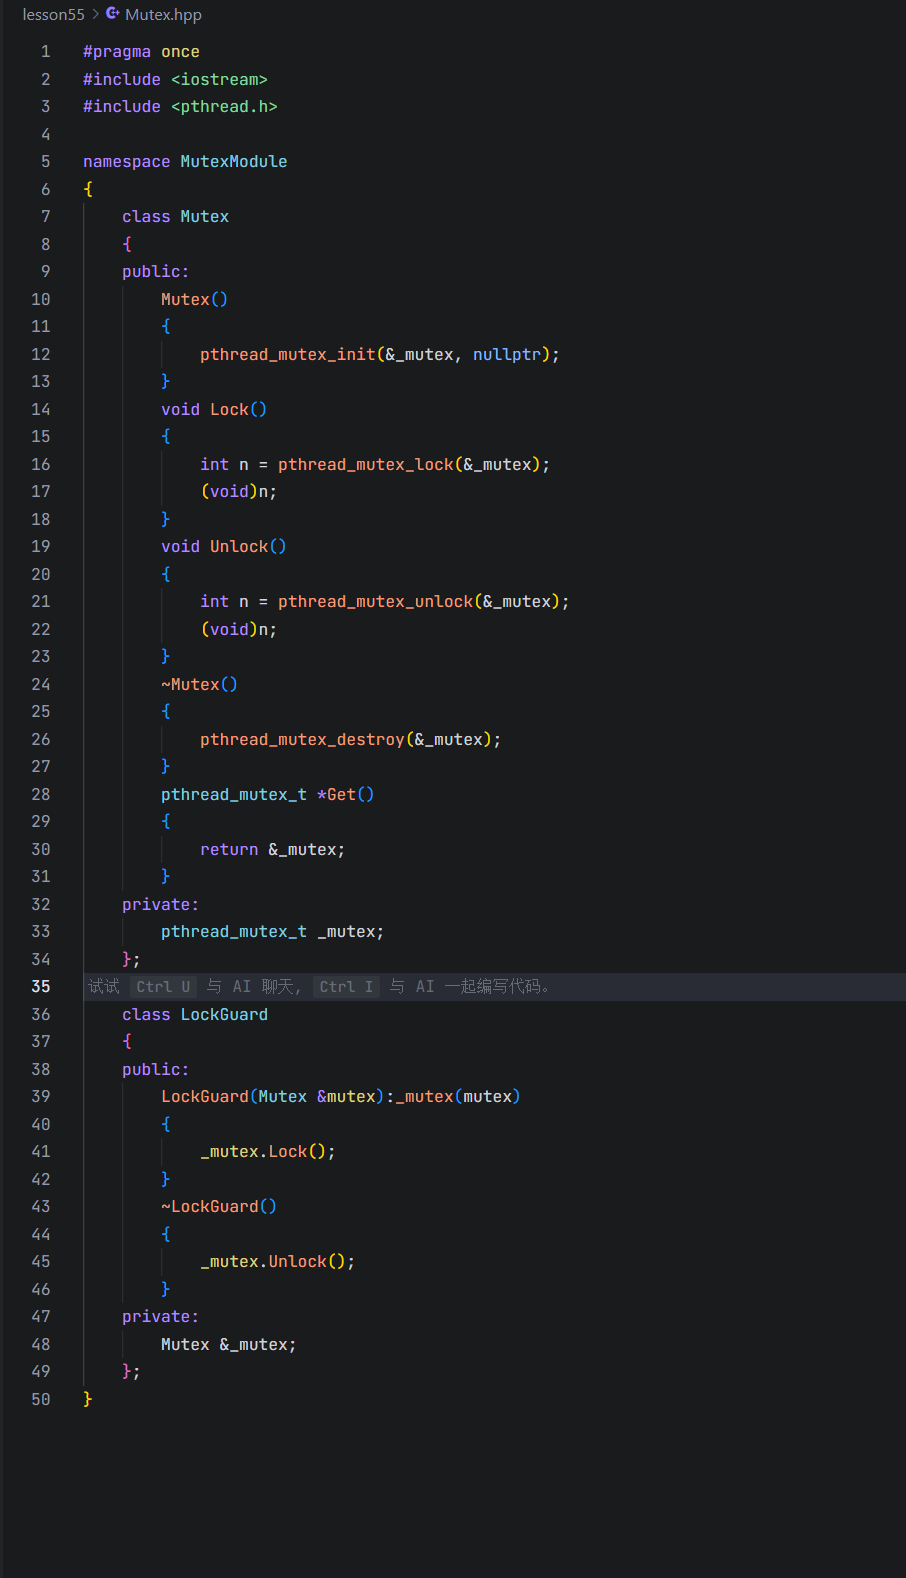
Mutex.hpp |
互斥量 + RAII 锁守卫(给日志模块用) | 基础设施 |
Log.hpp |
日志模块,策略模式,可选择打屏或写文件 | 基础设施,顺带对比模板方法 |
Socket.hpp |
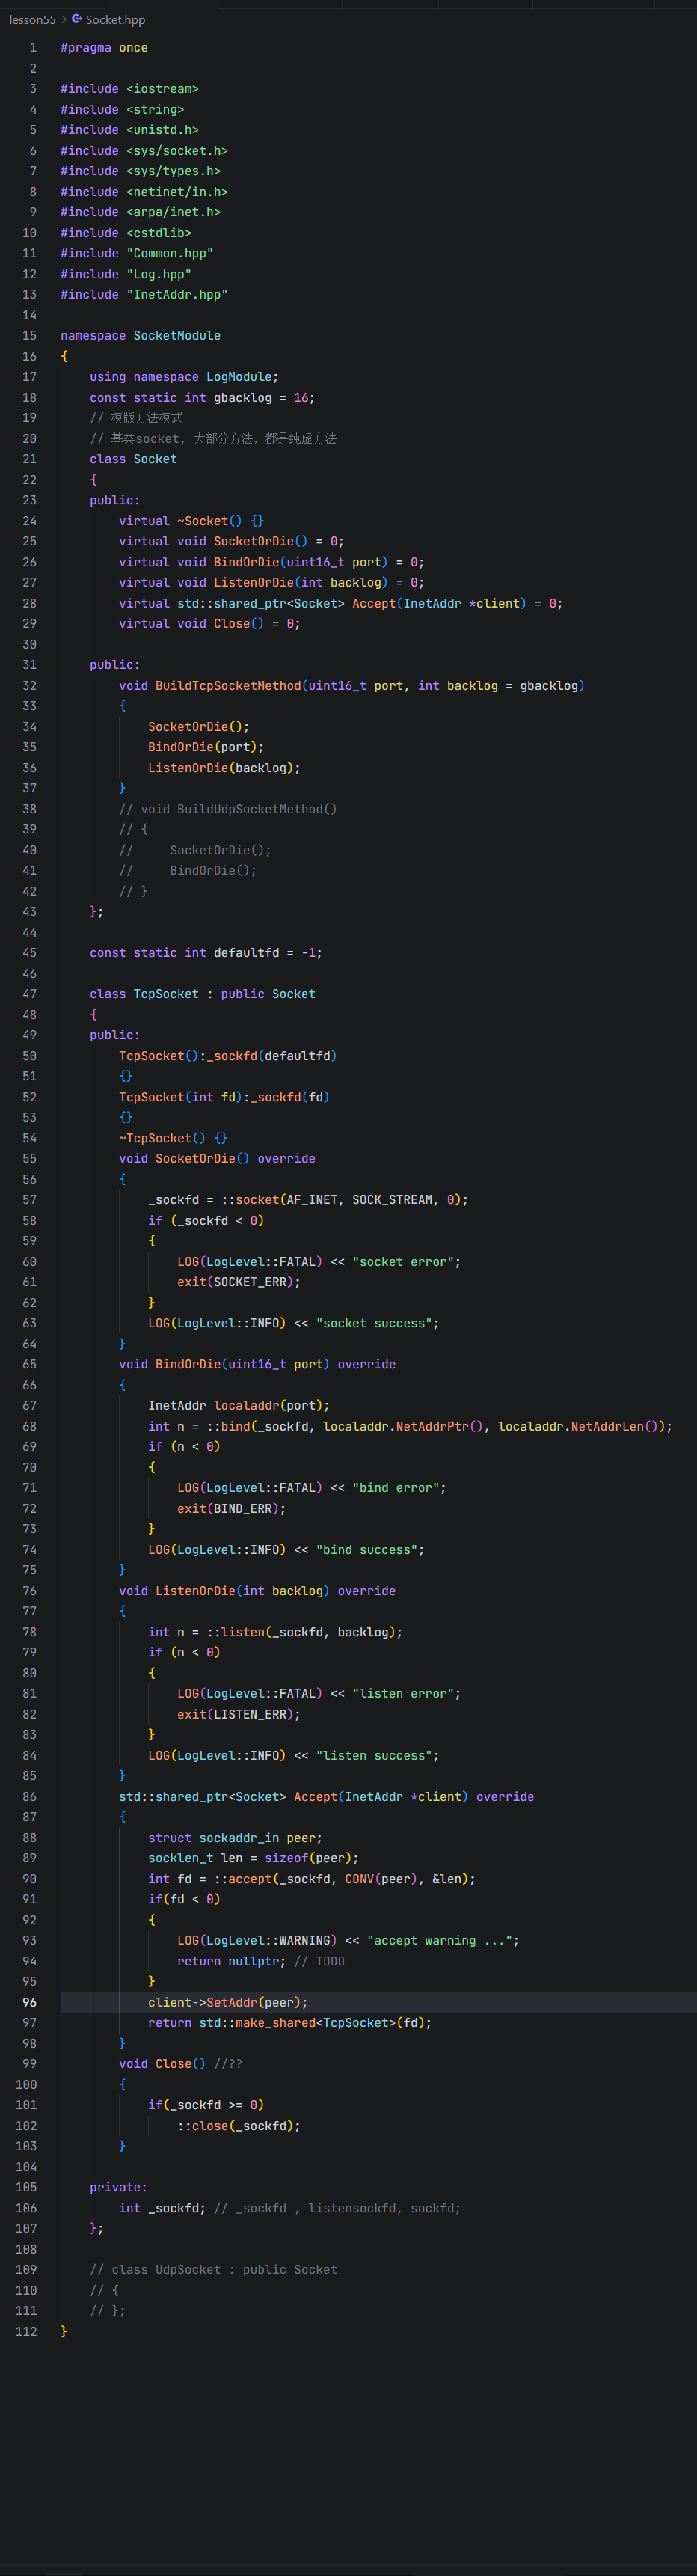
socket 封装,模板方法模式 ,抽象基类 + TcpSocket 实现 |
重点 |
TcpServer.hpp |
TCP 服务器:accept 循环 + 双 fork 进程模型 + 回调注入 | 重点 |
Protocol.hpp |
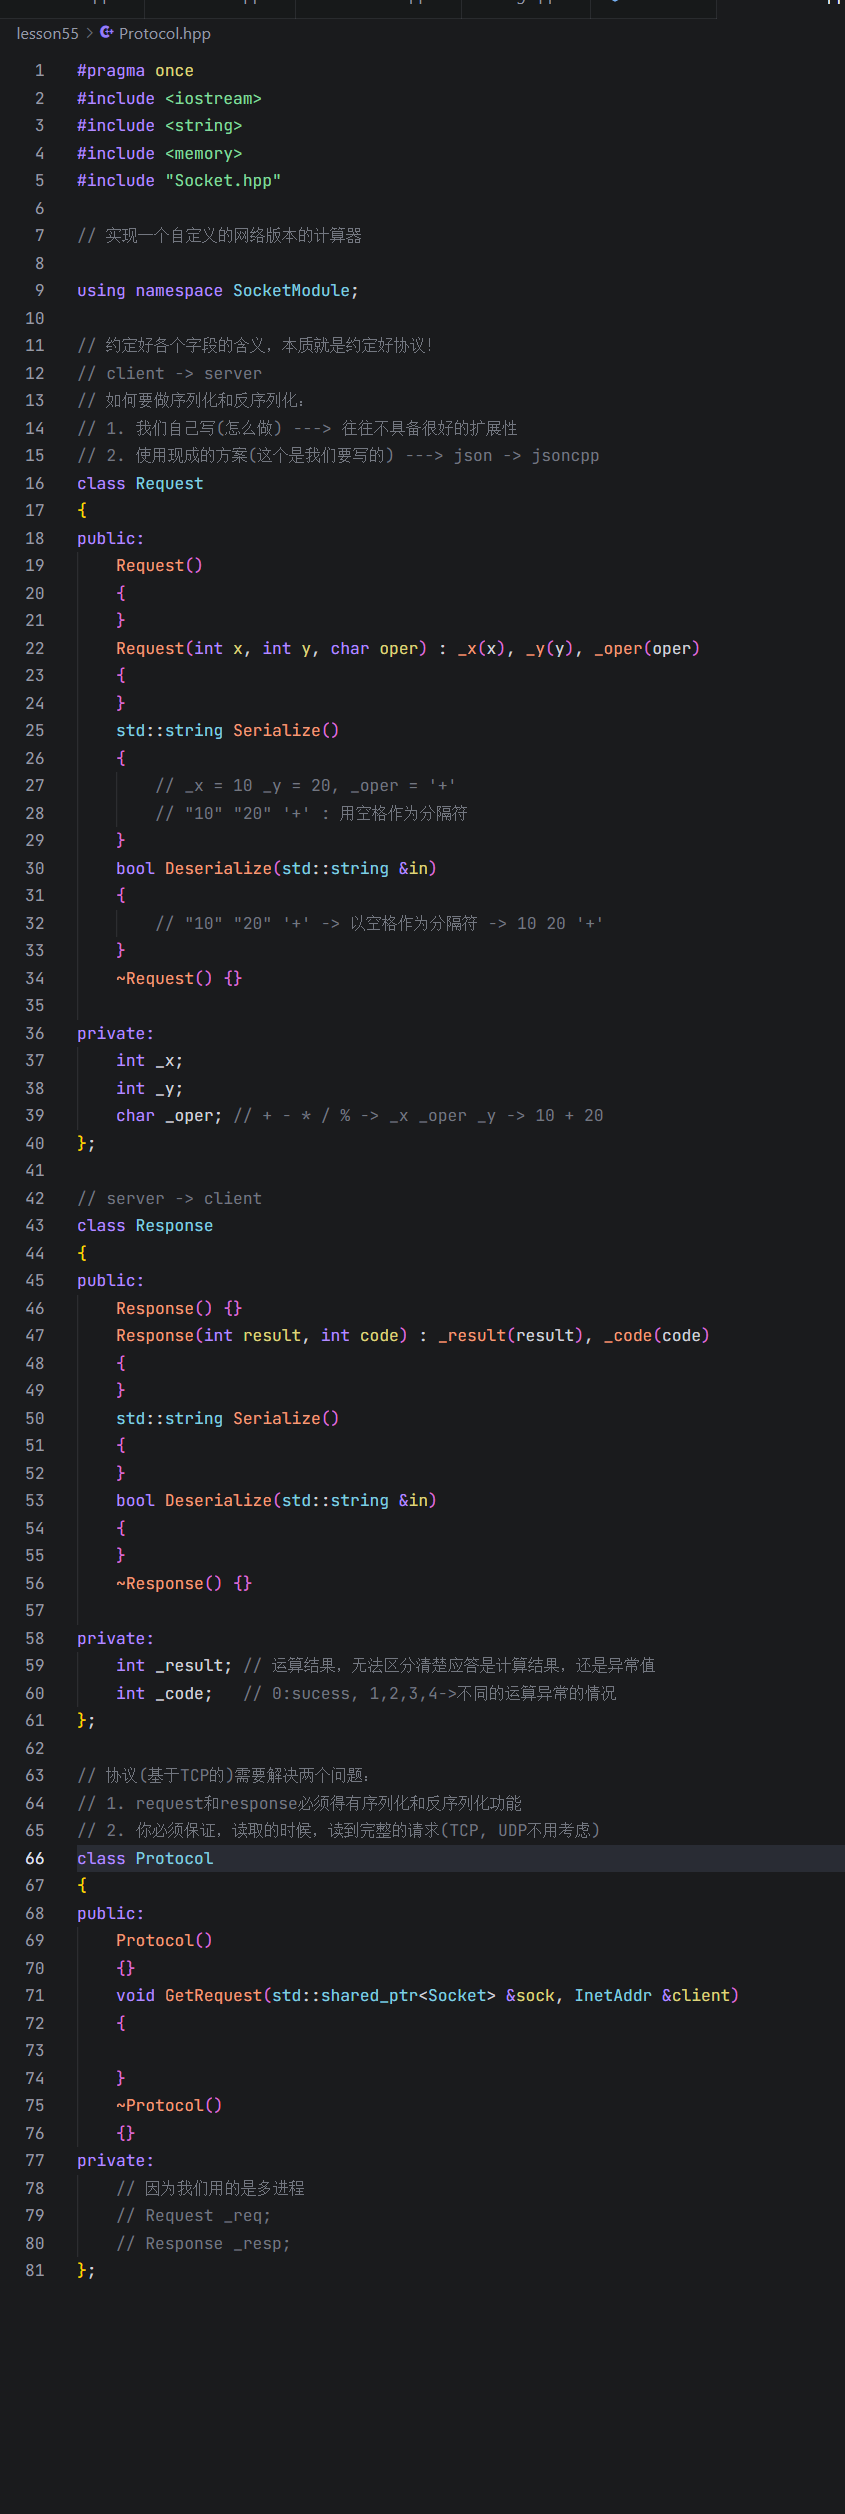
计算器协议:Request/Response/Protocol,序列化接口空架子 |
重点 |
Main.cc |
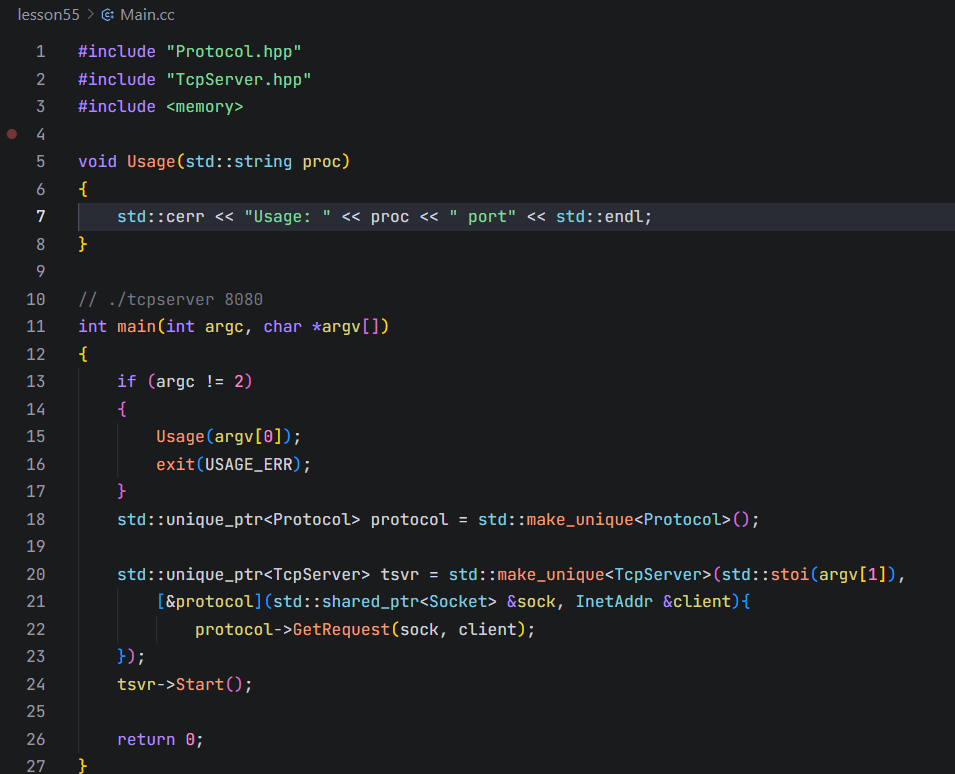
入口:组装协议对象和服务器,lambda 注入业务回调 | 串讲 |
testjson.cc |
jsoncpp 试验场:Value、Reader、各种 Writer | 重点 |
TcpClient.hpp |
空文件,下篇的客户端 | 占位 |
模块之间的依赖关系长这样:
cpp
                       Main.cc
                         |
           +-------------+-------------+
           |                           |
      TcpServer.hpp              Protocol.hpp
           |                           |
        Socket.hpp  <------------------+  (Protocol 里 GetRequest
           |                                的参数是 Socket 基类指针)
   +-------+--------+----------------+
   |       |        |                |
InetAddr.hpp  Log.hpp  Common.hpp  Mutex.hpp
                         ^
                         |
                    testjson.cc  (独立试验,不进服务器编译,单独链 -ljsoncpp)
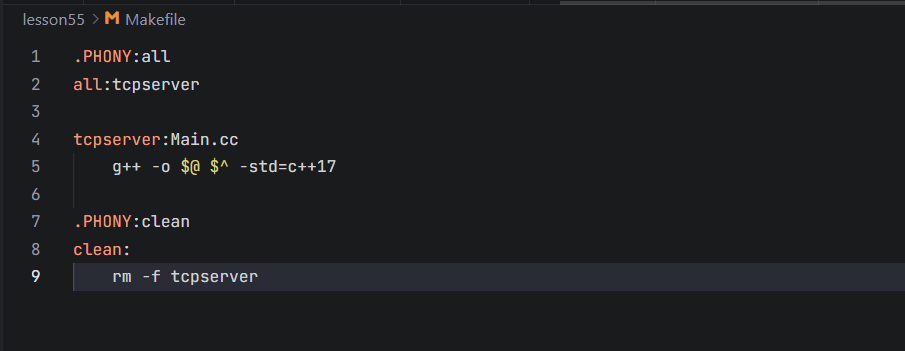
Makefile 这节课很简单,只编译 Main.cc 生成 tcpserver,没有链 jsoncpp:
cpp
tcpserver:Main.cc
	g++ -o $@ $^ -std=c++17
也就是说 testjson.cc 不在服务器的编译范围内,想玩它得单独编译,这个第七节讲。
三、基础设施模块:老伙计们快速过一遍
这几个文件上几节课都写过,这里只讲和这节课架构有关的要点,不灌水。
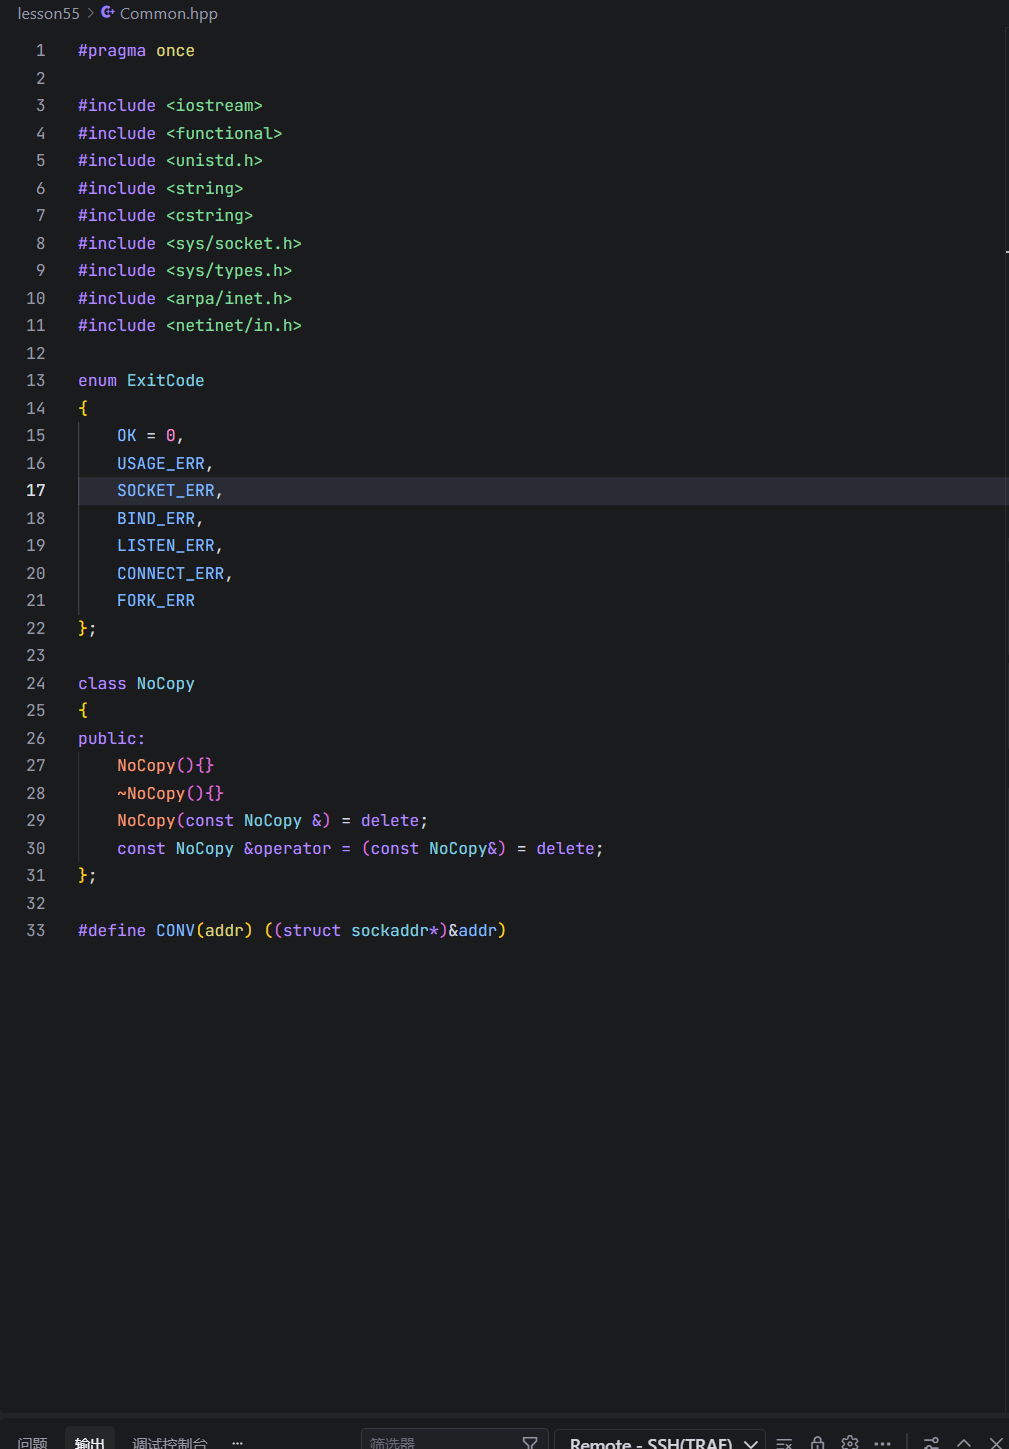
3.1 Common.hpp:退出码、防拷贝、强转宏
cpp
enum ExitCode
{
    OK = 0,
    USAGE_ERR,   // 1
    SOCKET_ERR,  // 2
    BIND_ERR,    // 3
    LISTEN_ERR,  // 4
    CONNECT_ERR, // 5
    FORK_ERR     // 6
};
第一个枚举值显式给 0,后面不写值就逐个 +1。这种写法的好处是新增错误码往中间插不会打乱后面的值 ,exit(错误码) 时父进程 waitpid 拿到的退出状态也有据可查。
cpp
class NoCopy
{
public:
    NoCopy(){}
    ~NoCopy(){}
    NoCopy(const NoCopy &) = delete;
    const NoCopy &operator = (const NoCopy&) = delete;
};

#define CONV(addr) ((struct sockaddr*)&addr)
NoCopy 是经典的防拷贝基类:拷贝构造和赋值运算符 = delete,谁继承谁就不能被拷贝。说句实话,我 grep 过整个工程,这个类在咱们 lesson55 里并没有被任何类继承,属于工具库里常备着的东西。
CONV 宏就一件事:sockaddr_in* 强转成 sockaddr*。bind、accept 这些系统调用的参数类型是通用的 struct sockaddr*,而咱们手里实际拿的是 IPv4 的 sockaddr_in,每次手写强转太丑,包成宏。它就是个纯宏,没有类型检查,用的时候心里清楚自己传的是什么就行。
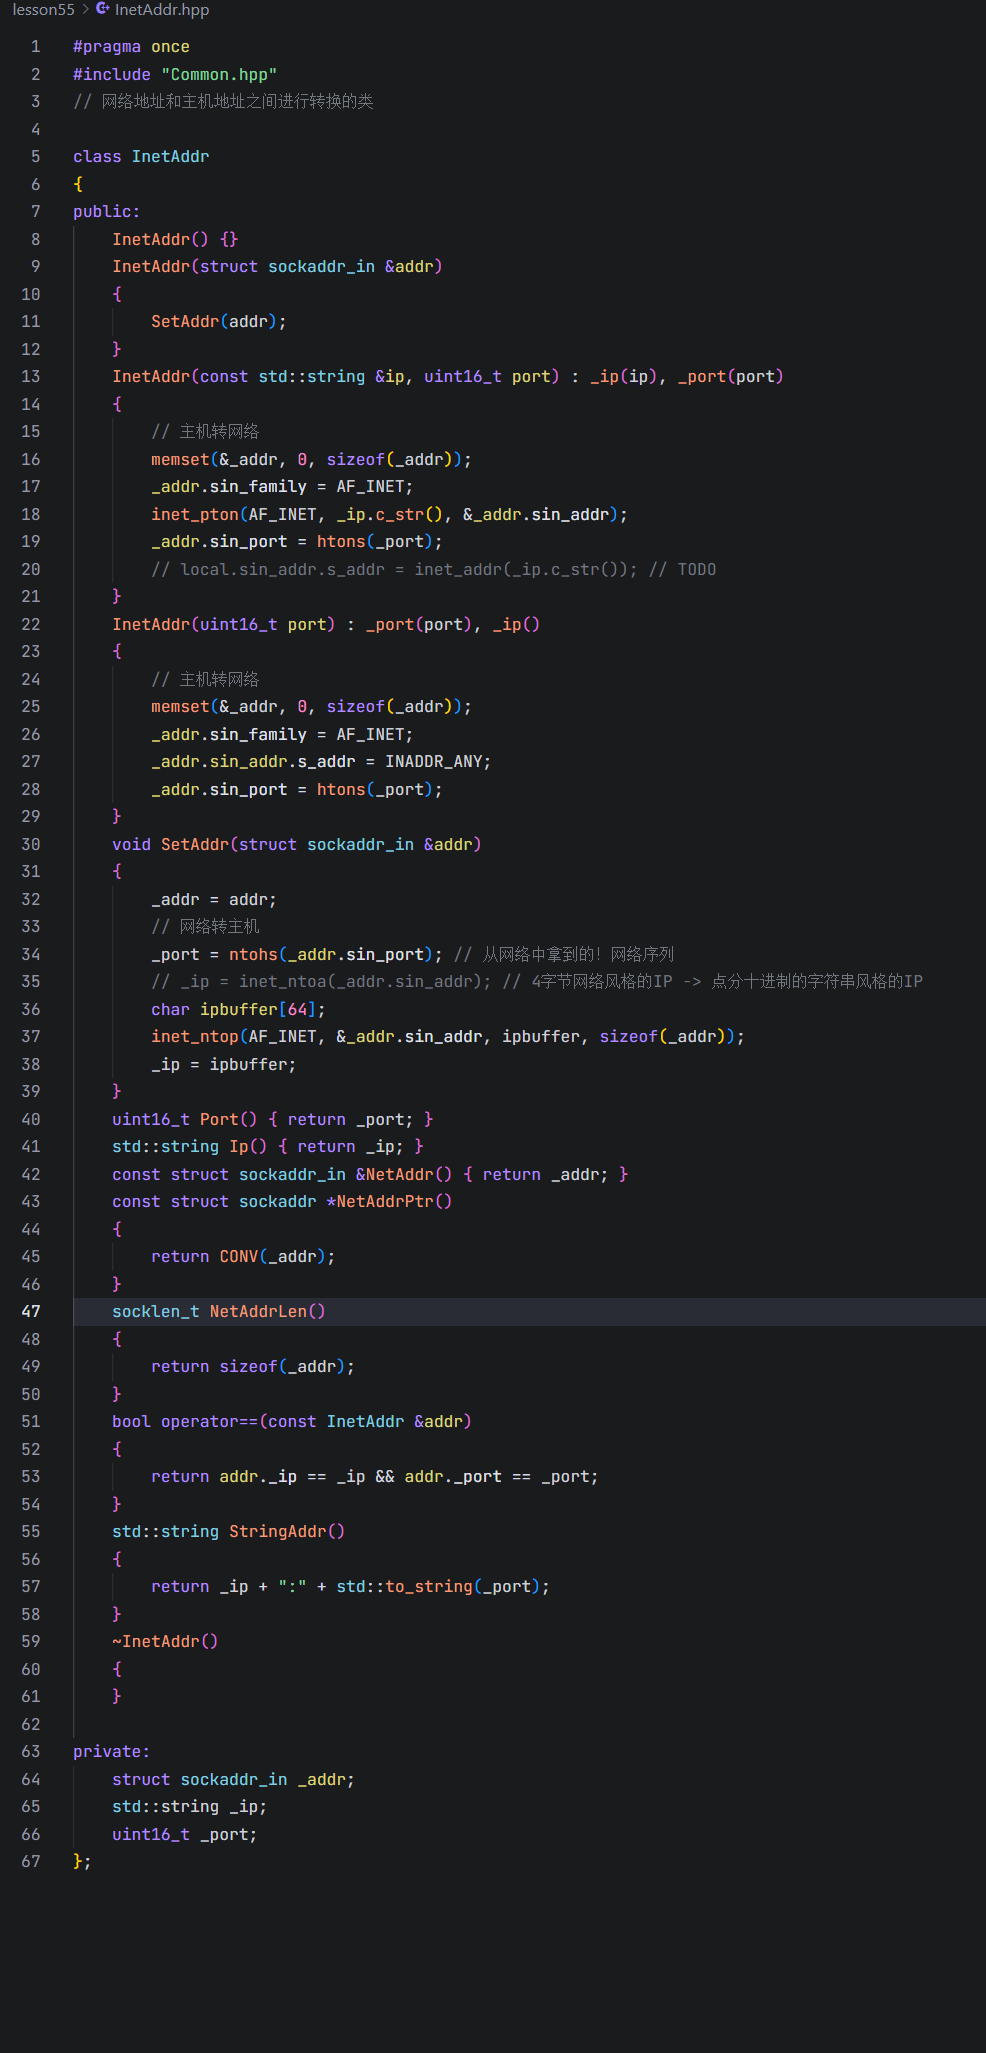
3.2 InetAddr.hpp:网络字节序那点事
这个类把裸的 struct sockaddr_in 包了一层,核心解决两个方向的转换:主机序 → 网络序 (绑定前)和网络序 → 主机序(拿到对端地址后)。
服务端绑定用的是这个构造函数:
cpp
InetAddr(uint16_t port) : _port(port), _ip()
{
    memset(&_addr, 0, sizeof(_addr));
    _addr.sin_family = AF_INET;
    _addr.sin_addr.s_addr = INADDR_ANY;  // 0.0.0.0,本机哪块网卡都收
    _addr.sin_port = htons(_port);      // 主机序 -> 网络序(大端)
}
逐行说:
memset先清零。sockaddr_in里有sin_zero[8]这种填充字段,不清零留着垃圾值,有些系统调用会挑刺;
sin_family填AF_INET,告诉内核这是 IPv4 地址;
INADDR_ANY就是0.0.0.0,意思是不挑网卡,本机所有 IP 上的连接都接。服务器标准姿势;
htons:h ost to n etwork short,把 16 位端口从主机字节序(x86 是小端)转成网络字节序(规定大端)。这个函数要是忘了,绑出来的端口是字节翻转过的,客户端死活连不上,我以前带新人时这是高频翻车点。
accept 拿到对端地址后走的是另一条路:
cpp
void SetAddr(struct sockaddr_in &addr)
{
    _addr = addr;
    _port = ntohs(_addr.sin_port);   // 网络序 -> 主机序
    char ipbuffer[64];
    inet_ntop(AF_INET, &_addr.sin_addr, ipbuffer, sizeof(_addr));
    _ip = ipbuffer;
}
ntohs是htons的反操作。inet_ntop(network to presentation)把 4 字节的二进制 IP 转成"1.2.3.4"这种点分十进制字符串,它是老函数inet_ntoa的线程安全替代品------inet_ntoa返回静态缓冲区,多线程一调就互相覆盖。这里有个代码隐患必须指出来 :
inet_ntop第四个参数要求传目标缓冲区的大小,代码里传的是sizeof(_addr)(也就是sockaddr_in的大小,实测 16 字节),不是sizeof(ipbuffer)(64)。IPv4 点分十进制最长也就"255.255.255.255"共 15 个字符加结尾\0(INET_ADDRSTRLEN就是 16),所以侥幸刚好不溢出 。但语义上传 16 是错的,哪天换成 IPv6(INET6_ADDRSTRLEN要 46 个字符)就炸了。正确写法:
cpp
inet_ntop(AF_INET, &_addr.sin_addr, ipbuffer, sizeof(ipbuffer));另外几个成员都是配套的取接口:
NetAddrPtr()返回sockaddr*给bind/accept用,NetAddrLen()返回地址长度,StringAddr()拼出"ip:port"给日志打印用。没什么花活。
3.3 Mutex.hpp:RAII 锁
cpp
class Mutex
{
public:
    Mutex()  { pthread_mutex_init(&_mutex, nullptr); }
    void Lock()   { pthread_mutex_lock(&_mutex); }
    void Unlock() { pthread_mutex_unlock(&_mutex); }
    ~Mutex() { pthread_mutex_destroy(&_mutex); }
    pthread_mutex_t *Get() { return &_mutex; }
private:
    pthread_mutex_t _mutex;
};

class LockGuard
{
public:
    LockGuard(Mutex &mutex):_mutex(mutex) { _mutex.Lock(); }
    ~LockGuard() { _mutex.Unlock(); }
private:
    Mutex &_mutex;
};就一个思想:RAII 。构造时
lock,析构时unlock,中间代码无论怎么 return、抛异常,出作用域析构函数必然执行,锁不可能忘解。这玩意就是 C++ 版的lock_guard,咱们手写了一遍而已。注意LockGuard里持有的是Mutex&引用,它不拥有锁,只负责自动加解锁。
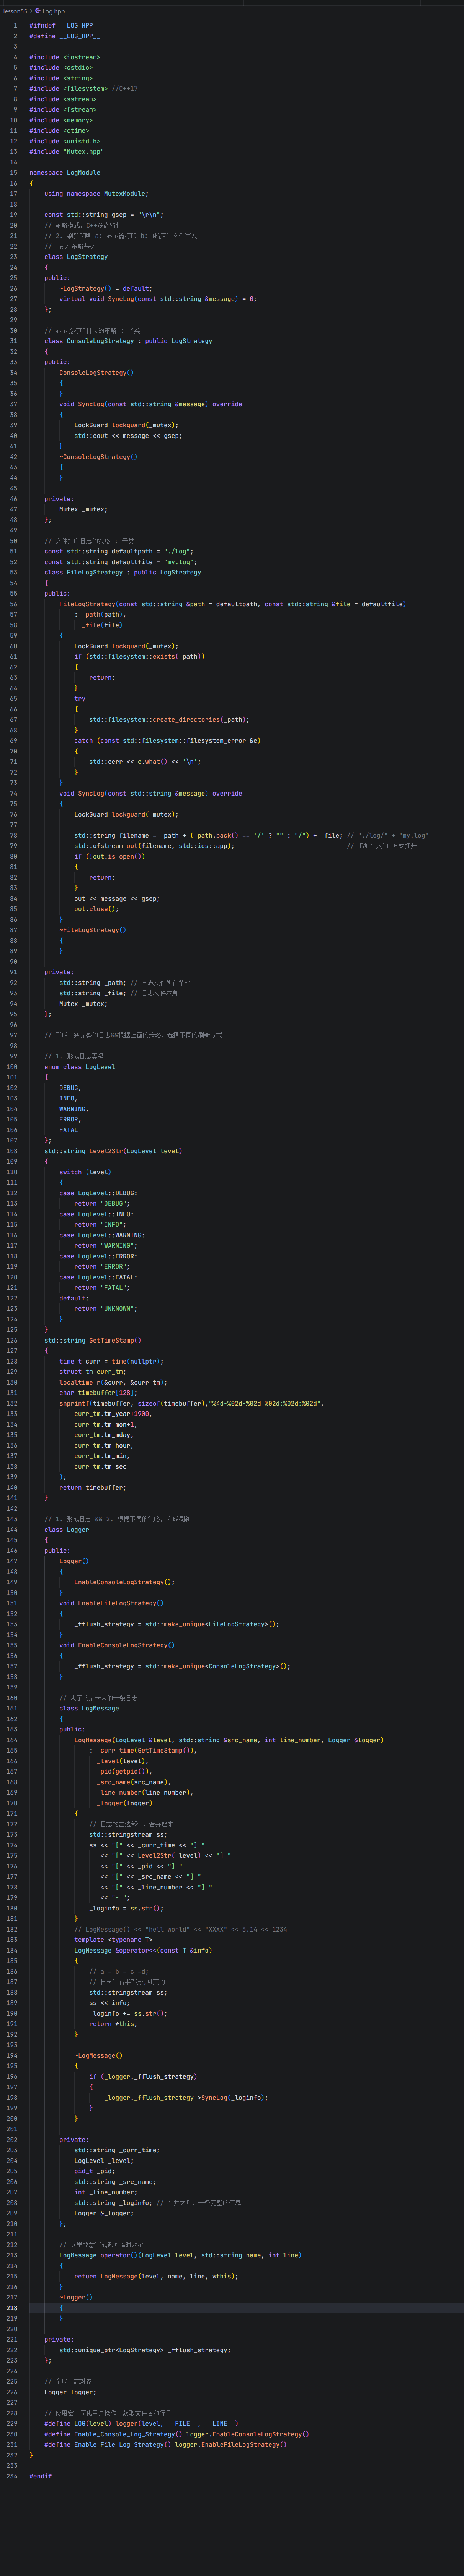
3.4 Log.hpp:策略模式(重点是为了和后面的模板方法对比)
日志模块这节课没改,但它里面用的策略模式 和 Socket 里的模板方法模式是设计模式课里特别容易混的一对,这里先过一遍,后面专门对比。
先定义一个"刷新策略"的抽象基类:
cpp
class LogStrategy
{
public:
    ~LogStrategy() = default;
    virtual void SyncLog(const std::string &message) = 0;
};
然后两个实现:
ConsoleLogStrategy(打屏)和FileLogStrategy(写文件,构造时用 C++17 的std::filesystem::create_directories建./log目录,以追加方式打开my.log)。它俩各自内部持有一把Mutex,因为将来多个进程/线程可能同时写日志。
Logger 类里用一个指针持有"当前策略":
cpp
std::unique_ptr<LogStrategy> _fflush_strategy;

void EnableFileLogStrategy()    { _fflush_strategy = std::make_unique<FileLogStrategy>(); }
void EnableConsoleLogStrategy() { _fflush_strategy = std::make_unique<ConsoleLogStrategy>(); }注意这个结构:Logger 拥有策略对象,靠组合(成员指针)+ 多态,运行时想换策略就换一个对象塞进去。先记住"组合、整体替换"这两个词,第四节讲模板方法时你就知道区别在哪了。
日志拼一条完整消息靠的是内部类 LogMessage:
cpp
// 构造时拼好日志左半部分:[时间] [等级] [pid] [文件名] [行号] -
LogMessage(LogLevel &level, std::string &src_name, int line_number, Logger &logger)
// 右半部分用模板 operator<< 不断追加任意类型
template <typename T>
LogMessage &operator<<(const T &info)
// 析构时通过当前策略把整条日志刷出去
~LogMessage() { _logger._fflush_strategy->SyncLog(_loginfo); }这是个很妙的设计:LOG(DEBUG) << "xxx" 产生一个临时对象,链式 << 把内容攒进 stringstream,整条语句结束时临时对象析构,日志才真正刷出去 ,保证一条日志的原子性。宏 #define LOG(level) logger(level, __FILE__, __LINE__) 帮咱们把文件名和行号自动填上。
日志分隔符是 "\r\n",等级从低到高是 DEBUG/INFO/WARNING/ERROR/FATAL。
四、重头戏一:Socket 与模板方法模式
这节课设计模式上的主角,在 Socket.hpp。
4.1 先想想不封装会是什么样
裸写 TCP 服务器的起手三件套,大家已经背熟了:
cpp
int listenfd = socket(AF_INET, SOCK_STREAM, 0);  // 1. 创建套接字
bind(listenfd, ...);                             // 2. 绑定
listen(listenfd, backlog);                       // 3. 监听
// 然后 accept / recv / send / close这三步有个特点:顺序永远固定,缺一不可,但每一步具体怎么做可能变 。比如将来写 UDP,第一步还是 socket(但参数是 SOCK_DGRAM),第二步还是 bind,第三步 listen 就没有了。再比如 accept,IPv4 和 IPv6 填充的地址结构都不一样。
如果每个使用方都自己按顺序调一遍,迟早有人漏调、乱序。怎么把"固定的流程"和"可变的步骤"隔开?这就是模板方法模式要解决的事。
4.2 模板方法模式的大白话定义
定义一个操作的算法骨架,把骨架里某些步骤延迟到子类去实现。骨架(流程)在父类里写死,步骤的细节由各个子类各写各的。
对应到 C++ 的手法就两板斧:
父类里把可变步骤写成纯虚函数,只声明不实现,逼着子类实现;
父类里写一个普通(非虚)函数,按固定顺序调用这些虚函数。这个函数就是"模板方法"。
先澄清一个命名坑:这里的"模板"跟 C++ 泛型 template<typename T> 没有任何关系,纯属中文翻译撞词。
4.3 抽象基类 Socket 逐行看
cpp
namespace SocketModule
{
    using namespace LogModule;
    const static int gbacklog = 16;

    class Socket
    {
    public:
        virtual ~Socket() {}
        virtual void SocketOrDie() = 0;
        virtual void BindOrDie(uint16_t port) = 0;
        virtual void ListenOrDie(int backlog) = 0;
        virtual std::shared_ptr<Socket> Accept(InetAddr *client) = 0;
        virtual void Close() = 0;

    public:
        void BuildTcpSocketMethod(uint16_t port, int backlog = gbacklog)
        {
            SocketOrDie();
            BindOrDie(port);
            ListenOrDie(backlog);
        }
    };
逐行拆:
const static int gbacklog = 16;:listen 队列长度默认 16。这个队列装的是"已完成三次握手但还没被 accept 取走"的连接(全连接队列),16 对学习用够了;
virtual ~Socket() {}:虚析构函数 。一个类只要打算被当父类、通过基类指针操作子类,析构函数就得是虚的,这是多态基类的卫生习惯。虽然这里用的是shared_ptr(它的删除器记住了真实类型,即使析构非虚也能正确析构子类),但写上虚析构是本分,别把智能指针的特殊行为当通用结论;五个
= 0的纯虚函数 就是五个"步骤":建套接字、绑定、监听、接受连接、关闭。名字后缀OrDie表达的语义是:这些操作失败了程序就没救了(端口被占、fd 耗尽),直接日志 +exit;
Accept的返回值是std::shared_ptr<Socket>------注意返回基类类型的智能指针,实际返回的是子类对象,这是多态的体现,4.6 细讲;最后那个
BuildTcpSocketMethod就是模板方法本板 :它不是虚函数,子类不该重写它;它的函数体把三个步骤按socket → bind → listen的铁顺序调一遍。谁都不能乱序,因为使用方只调这一个函数。
默认参数 backlog = gbacklog 写在定义处,所以后面 TcpServer 只传端口就能调。
基类里还留了一段注释掉的 BuildUdpSocketMethod(只有 socket + bind),这就是模板方法的扩展性证据:同一批步骤函数,换个模板方法就能拼出 UDP 的流程 。下面还有个注释掉的 class UdpSocket : public Socket,将来真要支持 UDP,继承 Socket、实现那几个纯虚函数就行,老代码一行不用动。这就是面向接口编程的味道。
4.4 子类 TcpSocket 逐行看
cpp
const static int defaultfd = -1;

class TcpSocket : public Socket
{
public:
    TcpSocket():_sockfd(defaultfd)
    {}
    TcpSocket(int fd):_sockfd(fd)
    {}
    ~TcpSocket() {}
两个构造函数必须分开讲,这是这节课的一个细节设计:
无参构造
TcpSocket():_sockfd初始化成 -1,表示"手里还没有 fd"。这个对象是给监听套接字 准备的------接下来调BuildTcpSocketMethod,里面的SocketOrDie会真正调系统调用给_sockfd赋值;带 fd 的构造
TcpSocket(int fd):直接把一个已经存在的 fd 包进对象。这是给 accept 回来的通信套接字准备的------fd 是内核给的,不需要再 socket/bind/listen,包一层只是为了让它也拥有面向对象的接口。
一个类,两种出生方式,分别对应监听 socket 和通信 socket。记住这个区分,后面 TcpServer 和 Accept 全靠它串。
接着是五个步骤的实现:
cpp
void SocketOrDie() override
{
    _sockfd = ::socket(AF_INET, SOCK_STREAM, 0);
    if (_sockfd < 0)
    {
        LOG(LogLevel::FATAL) << "socket error";
        exit(SOCKET_ERR);
    }
    LOG(LogLevel::INFO) << "socket success";
}
::socket前面的::是全局作用域限定符,明确调的是系统的socket而不是本类成员(本类也叫 Socket,不加容易绕晕)。失败返回 -1,打 FATAL 日志后exit(SOCKET_ERR),退出码正是Common.hpp枚举里那个。
cpp
void BindOrDie(uint16_t port) override
{
    InetAddr localaddr(port);
    int n = ::bind(_sockfd, localaddr.NetAddrPtr(), localaddr.NetAddrLen());
    if (n < 0) { /* FATAL 日志 + exit(BIND_ERR) */ }
    LOG(LogLevel::INFO) << "bind success";
}
绑定不自己拼
sockaddr_in,直接InetAddr localaddr(port)造一个地址对象(3.2 讲的那个INADDR_ANY + htons构造),然后把地址指针和长度喂给bind。这就是封装的好处,系统调用那堆啰嗦参数全藏到对象里了。
cpp
void ListenOrDie(int backlog) override
{
    int n = ::listen(_sockfd, backlog);
    if (n < 0) { /* FATAL + exit(LISTEN_ERR) */ }
    LOG(LogLevel::INFO) << "listen success";
}
listen把套接字从主动态变被动态,backlog 传模板方法给的 16。
cpp
std::shared_ptr<Socket> Accept(InetAddr *client) override
{
    struct sockaddr_in peer;
    socklen_t len = sizeof(peer);
    int fd = ::accept(_sockfd, CONV(peer), &len);
    if(fd < 0)
    {
        LOG(LogLevel::WARNING) << "accept warning ...";
        return nullptr;
    }
    client->SetAddr(peer);
    return std::make_shared<TcpSocket>(fd);
}
accept 这块信息量大,逐个点说:
peer是出参,内核 accept 成功后会把客户端的地址 填进去;len既是入参(告诉内核缓冲区多大)又是出参(实际填了多长),所以必须初始化成sizeof(peer),不能是野值;accept 失败这里不 exit 了,只打 WARNING 返回
nullptr。为什么和前面不一样?因为服务器是常驻循环,accept 失败很多时候是暂时的(比如被信号打断返回 EINTR),因为一次偶发失败把整个服务器弄死不值得。上层拿到 nullptr 决定怎么办;
client->SetAddr(peer):把内核填的裸地址交给 InetAddr 对象保存,顺便完成网络序到主机序的转换;
return std::make_shared<TcpSocket>(fd):把新 fd 用带参构造 包成 TcpSocket 对象,但返回类型声明的是基类shared_ptr<Socket>。派生类指针隐式转基类指针,这就是多态。
cpp
void Close()
{
    if(_sockfd >= 0)
        ::close(_sockfd);
}
这个函数在语义上就是对基类纯虚
Close()的覆盖,不写override也成立 ,因为函数签名(名字、参数、const 属性)和基类完全一致。但override关键字的价值是让编译器帮你校对------签名一旦写错(比如手滑加了个参数),写了override直接编译报错,不写就会悄悄变成"定义了一个新函数",基类纯虚没被实现,类都实例化不了。所以规范写法是补上override。函数体先判断_sockfd >= 0是为了防重复关闭、防关闭那个初始 -1。
4.5 调用链回看:模板方法是怎么跑起来的
后面 TcpServer 的构造函数里就一行:
cpp
_listensockptr->BuildTcpSocketMethod(_port);这一行的实际执行路径是:
cpp
TcpServer 构造
  └─ 持有 unique_ptr<Socket>,实际对象是 TcpSocket(无参构造,fd=-1)
       └─ BuildTcpSocketMethod(8080)     ← 父类的模板方法,流程在这写死
            ├─ SocketOrDie()   ── 动态绑定 ──→ TcpSocket::SocketOrDie()
            ├─ BindOrDie(8080) ── 动态绑定 ──→ TcpSocket::BindOrDie()
            └─ ListenOrDie(16) ── 动态绑定 ──→ TcpSocket::ListenOrDie()
流程归父类管,步骤归子类管 ,这就是模板方法模式的全部。虚函数的动态绑定发生在运行时,
_listensockptr表面是Socket*,实际调的是TcpSocket的实现。
4.6 为什么 Accept 返回基类指针
假设不用多态,Accept 直接返回 shared_ptr<TcpSocket>,那将来有了 UdpSocket、UnixDomainSocket,函数签名就得改,依赖这个函数的上层代码全得跟着改。
返回 shared_ptr<Socket> 之后,上层(TcpServer、Protocol)只跟基类接口打交道:拿到这个对象能 Close,将来需要收发数据就在基类加 RecvOrDie/SendOrDie 纯虚函数。上层知道的越少越好 ,这就是 TcpServer.hpp 注释里那句"TcpServer 需不需要关心自己未来传递的信息是什么?不需要关心"的底层逻辑。
4.7 模板方法 vs 策略模式:这对必须分清楚
两个模式都在搞"变化隔离",新手特别容易混,我列个表:
| 对比项 | 模板方法(Socket.hpp) | 策略模式(Log.hpp) |
|---|---|---|
| 复用手段 | 继承 | 组合(持有一个策略指针) |
| 谁定流程 | 父类把算法骨架写死,子类只填空 | 没有骨架,整个算法被整体替换 |
| 变化粒度 | 流程中的某几个步骤可变 | 整个策略可换(打屏/写文件) |
| 什么时候定 | 编译期由继承关系定死 | 运行期换个 make_unique 就能切 |
| 代码长相 | 纯虚步骤 + 非虚模板方法 | 抽象策略指针 + N 个具体策略类 |
一句话记忆:模板方法是"老子定流程,儿子填细节";策略模式是"我不管你怎么干,给我个会干这活的对象就行"。
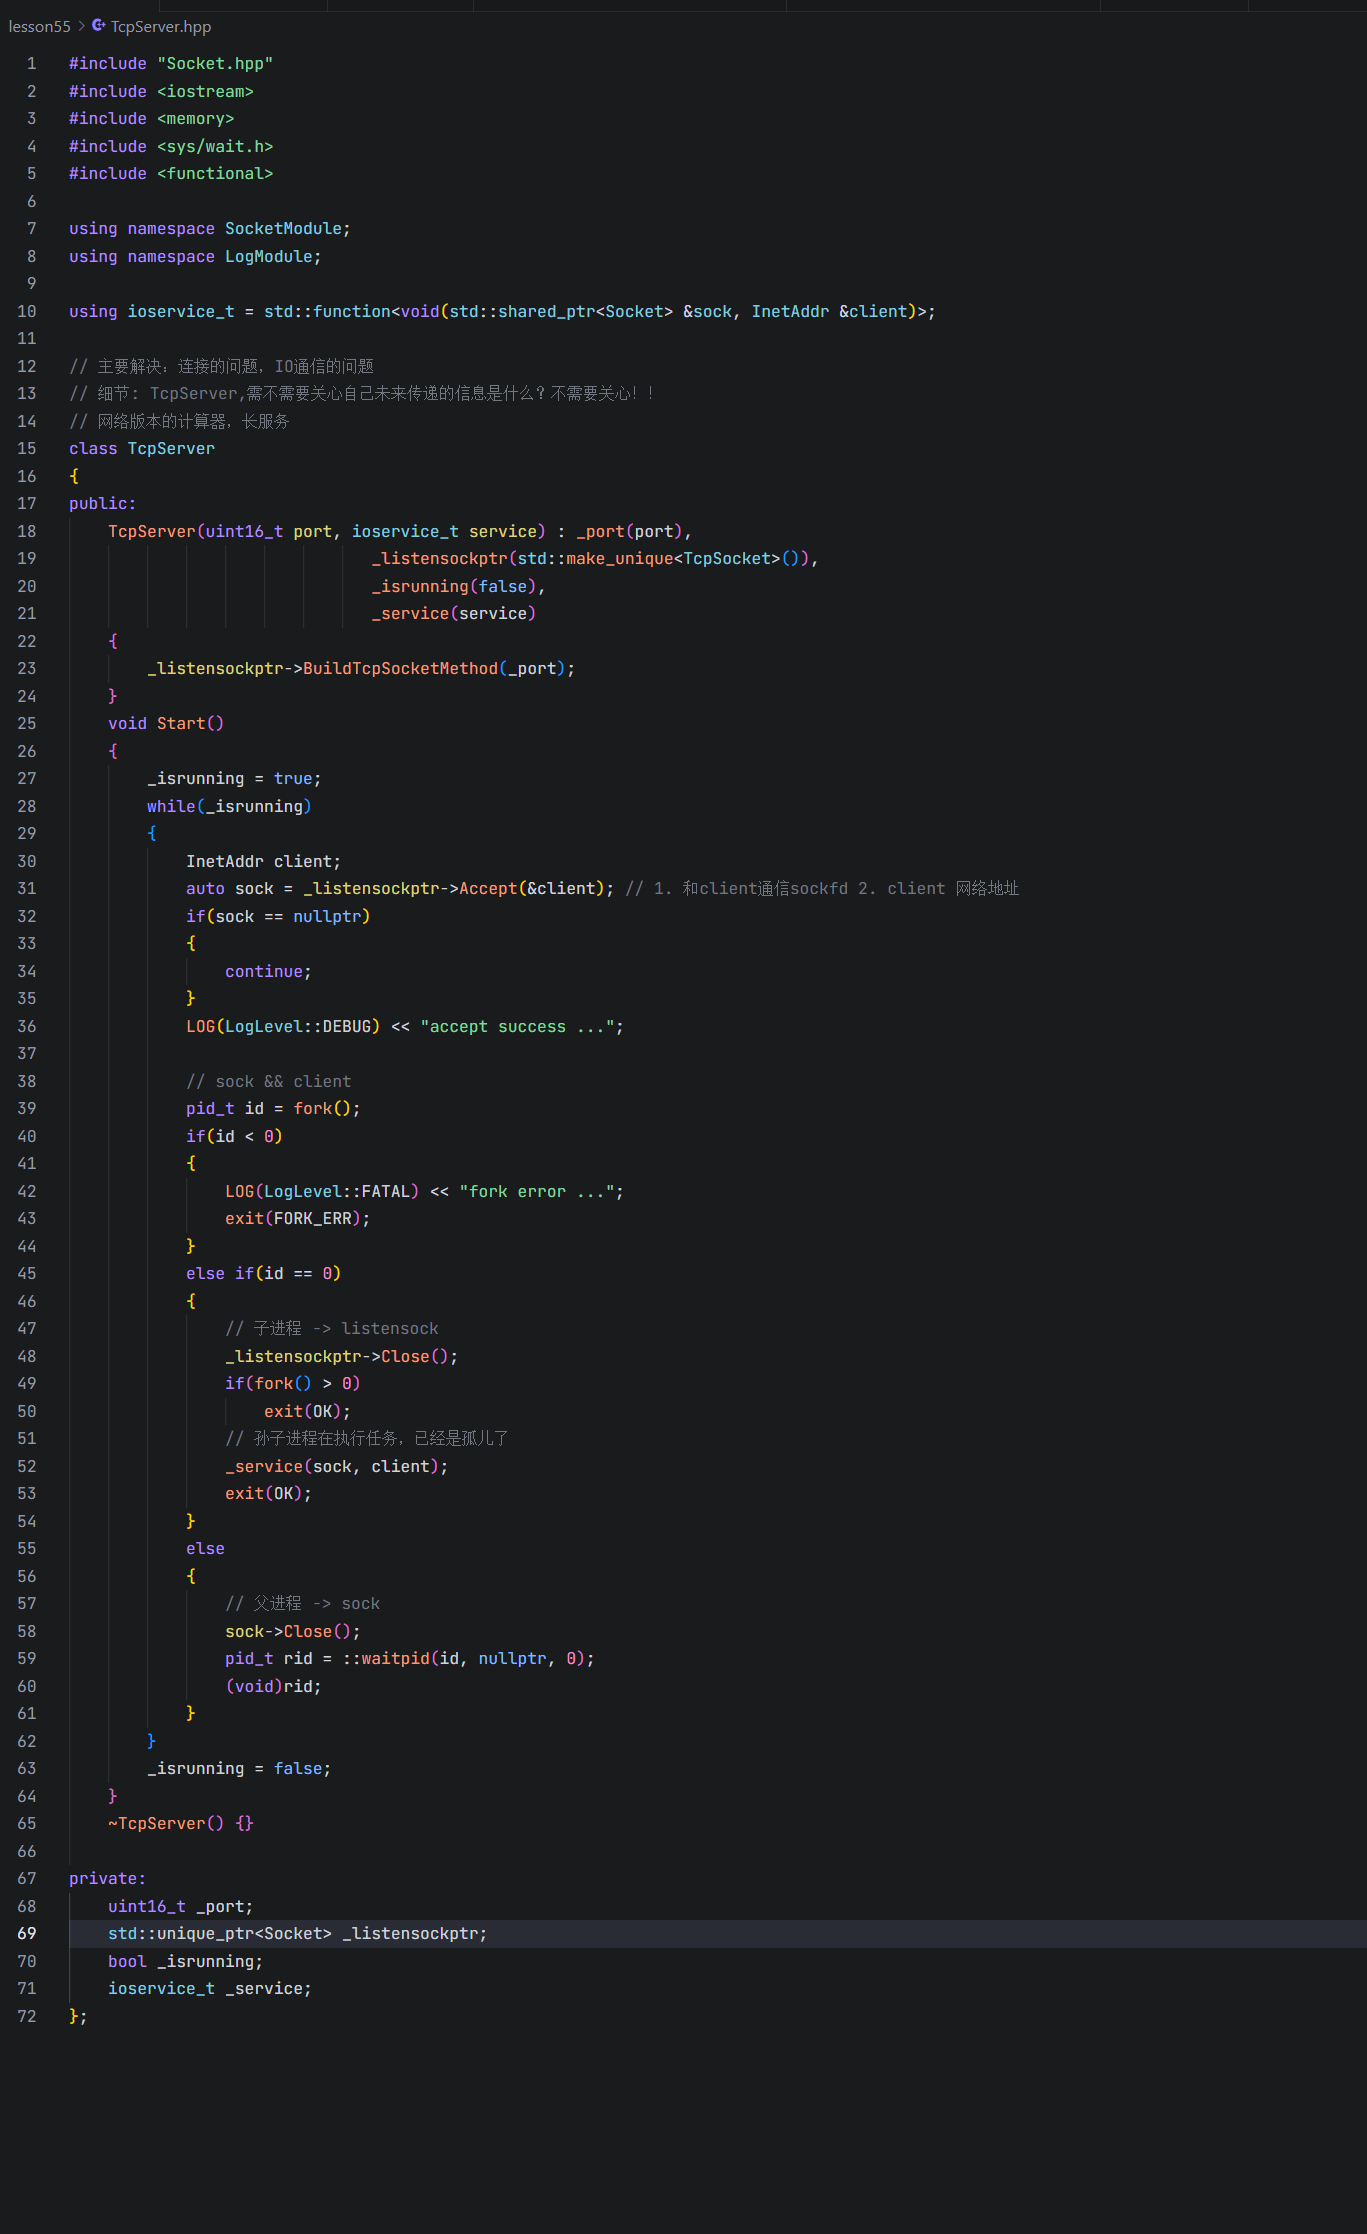
五、TcpServer:回调注入 + 双 fork 进程模型
服务器主体 TcpServer.hpp 不长,但每个点都是真功夫。
5.1 业务怎么塞进来:std::function 回调
cpp
using ioservice_t = std::function<void(std::shared_ptr<Socket> &sock, InetAddr &client)>;这行给"业务处理函数"定了类型:吃一个通信套接字和客户端地址,不返回。它可以是函数指针、lambda、仿函数,任何能被调用的东西都行。
cpp
class TcpServer
{
public:
    TcpServer(uint16_t port, ioservice_t service) : _port(port),
                               _listensockptr(std::make_unique<TcpSocket>()),
                               _isrunning(false),
                               _service(service)
    {
        _listensockptr->BuildTcpSocketMethod(_port);
    }
成员 _service 把业务存起来。注意初始化列表里干的事:
_listensockptr装的是make_unique<TcpSocket>()------无参构造,监听专用,fd 此刻还是 -1;构造函数体调
BuildTcpSocketMethod(_port),第四节那条调用链走完,监听套接字就就位了;服务器此时完全不知道将来业务是计算器、命令执行还是聊天服务器,业务全靠构造参数注入。这是和模板方法一脉相承的思路:框架和业务解耦。
5.2 accept 主循环逐行
cpp
void Start()
{
    _isrunning = true;
    while(_isrunning)
    {
        InetAddr client;
        auto sock = _listensockptr->Accept(&client);
        if(sock == nullptr)
        {
            continue;
        }
        LOG(LogLevel::DEBUG) << "accept success ...";
Accept 就是基类接口,多态调到 TcpSocket::Accept。失败返回 nullptr 时 continue 回到循环继续等------呼应 4.4 说的"偶发失败不要弄死服务器"。
拿到连接后是这节课进程模型的核心,双 fork:
cpp
        pid_t id = fork();
        if(id < 0)
        {
            LOG(LogLevel::FATAL) << "fork error ...";
            exit(FORK_ERR);
        }
        else if(id == 0)
        {
            // 子进程 -> listensock
            _listensockptr->Close();
            if(fork() > 0)
                exit(OK);
            // 孙子进程在执行任务,已经是孤儿了
            _service(sock, client);
            exit(OK);
        }
        else
        {
            // 父进程 -> sock
            sock->Close();
            pid_t rid = ::waitpid(id, nullptr, 0);
            (void)rid;
        }
    }
    _isrunning = false;
}
5.3 双 fork 的流程图和 fd 变化
第一次 fork 之后,父子各有一份 fd 表(fork 复制 fd 表项,语义类似 dup:父子的 fd 指向同一个内核 file description):
cpp
父进程(监听循环)                第一次 fork 出的儿子
  listenfd  ──┐                   listenfd(继承来的)
  sockfd    ──┤                   sockfd  (继承来的)
              │
       fork() ┘
进入儿子分支(id == 0):
_listensockptr->Close():儿子关掉监听 fd。监听是爹的活,儿子拿着没用,反而会让 fd 引用计数不减、将来重启端口时埋雷;
if(fork() > 0) exit(OK);:儿子再 fork 一次 ,生出孙子。fork 返回值在儿子里大于 0(是孙子的 pid),于是儿子立刻exit(OK)去死;孙子拿到的 fork 返回值是 0,不进 if,往下落到
_service(sock, client)真正干活,干完exit(OK)。
爹分支(id > 0):
sock->Close():爹关掉通信 fd,它只负责接客,聊天是子孙的事;
waitpid(id, nullptr, 0):阻塞收尸。注意它等的是第一次 fork 出来的儿子,而儿子在第二次 fork 后立刻就 exit 了,所以这个 waitpid 瞬间返回,根本不会等孙子。
最终格局:
cpp
父进程 tcpserver(accept 循环)
  │ waitpid 立刻收走秒退的儿子 → 儿子不产生僵尸
  │
  └─(儿子已死)
       └─ 孙子(真正干活的 _service)
             亲爹死后被 PID 1(init/systemd)收养
             孙子退出时由 init 收尸,照样不产生僵尸
5.4 为什么非要绕这一圈?
我以前也觉得直接 fork 一次让儿子干活、爹 waitpid 不就行了?踩过坑就知道绕这一圈解决的是两个矛盾:
爹要一直 accept,不能被 wait 阻塞 :单 fork 模型里,儿子干活期间爹要么阻塞
waitpid(没法接新连接),要么不 wait(儿子变僵尸);干活的进程不能留僵尸:双 fork 后亲爹秒死,孙子变孤儿被 PID 1 收养,而 init 的天职就是不停 wait 养子,孙子干完活一退出立刻被回收。
实测一把(我在临时副本里把空的 GetRequest 换成 sleep 20 秒,连上一个客户端),进程关系看得明明白白:
cpp
UID        PID    PPID  CMD
ubuntu   2328800 2328798 ./svtest 8091     ← 父进程(accept 循环)
ubuntu   2328809       1 ./svtest 8091     ← 孙子进程,PPID 已经是 1
孙子 PPID 直接是 1,儿子连影子都没了(秒退被收走)。
但要提醒一句:这不是完整的守护进程(daemon)写法 。正经 daemon 还要 setsid 摆脱控制终端、切工作目录、重设 umask、关掉 0/1/2 标准描述符,这里一个都没做。双 fork 在这儿只为"托孤收尸",别背错经书。
5.5 一个真实的坑:日志重定向到文件会打印两遍
我把服务器输出重定向到文件再连客户端,日志出现了两份一模一样的内容,连 pid 都一样:
cpp
[time] [INFO] [父pid] [Socket.hpp] [63] - socket success
... bind success / listen success / accept success
[time] [INFO] [父pid] [Socket.hpp] [63] - socket success   ← 又来一遍
...
原因是标准库缓冲 + fork 撞一起了:
日志打终端 时,
cout是行缓冲,遇到\n立刻刷出去,fork 的时候缓冲区是空的;日志重定向到文件 时,
cout变成全缓冲(攒够才刷),fork 之前那几条日志还躺在缓冲区里;fork 把整个用户空间复制,连没刷的缓冲区一起复制给儿子、再复制给孙子;
儿子和孙子 exit 时各自刷一份,于是看到两遍(爹被信号杀死不刷,所以是两遍不是三遍)。
pid 相同也解释得通:日志文本(包括 pid 字段)是爹在 fork 前就拼好放在缓冲区里的,fork 只复制字符串,不会重新取 pid。
通用解法:fork 前手动 fflush/std::cout.flush(),或者子孙进程里别用继承来的带缓冲日志。
六、重头戏二:到底什么是序列化
工程和服务器讲完了,进入这节课的软件核心。先看 Protocol.hpp 里的架子:
cpp
// 约定好各个字段的含义,本质就是约定好协议!
// client -> server
class Request
{
public:
    Request() {}
    Request(int x, int y, char oper) : _x(x), _y(y), _oper(oper) {}
    std::string Serialize()        // 当前空实现
    { }
    bool Deserialize(std::string &in)  // 当前空实现
    { }
    ~Request() {}
private:
    int _x;
    int _y;
    char _oper; // + - * / % -> _x _oper _y -> 10 + 20
};

// server -> client
class Response
{
public:
    Response() {}
    Response(int result, int code) : _result(result), _code(code) {}
    std::string Serialize() { }
    bool Deserialize(std::string &in) { }
    ~Response() {}
private:
    int _result; // 运算结果,无法区分清楚应答是计算结果,还是异常值
    int _code;   // 0:sucess, 1,2,3,4->不同的运算异常的情况
};
6.1 先回答:为什么结构体不能直接 send
有同学肯定想:_x、_y、_oper 就在对象内存里,send(sock, &req, sizeof(req), 0) 一把梭不行吗?我年轻时候也想过,这里头有四宗罪:
第一宗:内存对齐,各平台各编译器排布可能不一样。
Request 里 int、int、char,按对齐规则编译器可能在 char _oper 后面塞 3 字节填充,sizeof(Request) 可能是 12 不是 9。你以为发的是数据,其实发了 3 字节栈上的随机垃圾。换个编译器、换个平台,排布还可能变。
第二宗:字节序。
int 是多字节的,x86 小端存,网络规定大端传。直接把内存发出去,对端如果是大端机器,10 能给你读成 0x0A000000。char 是单字节不受影响,但 int 字段全军覆没。
第三宗:指针和不定长数据根本没法发。
这节课的计算器字段全是定长的,还看不出危害。将来字段里有 std::string、char*、vector 呢?对象内存里存的只是一个本进程的地址,你把地址数字发过去,对端同一块地址上是别人的东西,一解引用直接崩。带指针的结构体大小都不代表数据大小。
第四宗:就算发过去了,对端不知道一条消息在哪结束。
TCP 是字节流,没有消息边界。你发一个 12 字节结构体,对端可能分三次 recv 才凑齐,也可能两个请求被粘在一块一次递上来。sizeof 能解决定长情况的收齐问题,但字段一变长就废(这个问题下篇正面解决)。
6.2 序列化和反序列化的定义
想明白上面四宗罪,定义就是水到渠成的事:
序列化(Serialize) :把内存里的对象,按约定格式转换成一串可以直接发出去的字节序列(字符串);
反序列化(Deserialize):把收到的字符串,按同一套约定还原成对象。
整条链路长这样:
cpp
发送端                                          接收端
内存对象                  网络(TCP字节流)                 内存对象
Request{10,20,'+'}                          Request{10,20,'+'}
      │                                            ▲
      │ Serialize()         "字节串"       Recv()   │ Deserialize()
      └──────────────→  send ────────→  收进buffer ──────────────┘
例: {"x":10,"y":20,"oper":"+"}关键点:两端必须事先约定好格式 ,key 叫什么、字段什么顺序、异常怎么表示------这个约定就是应用层协议。所以文件注释说"约定好各个字段的含义,本质就是约定好协议"。
6.3 字段设计里的门道:Response 为什么要有 code
Request 三个字段没什么悬念:操作数 x、y 和运算符 oper,表达 x oper y。
Response 有两个字段,_result 和 _code,注释点破了原因:光有 result,你分不清返回值是正常结果还是异常 。比如客户端发 10 / 0,服务端除零了,返回个 -1?万一人家算的就是 5 - 6 = -1 呢?正常结果和错误码共用一个字段,歧义无解。
所以拆成两个字段:
_code:状态码,0 表示成功,1/2/3/4 分别代表除零、模零、运算符非法等不同错误(下篇会填具体枚举);
_result:成功时才有意义的运算结果。
这和 HTTP 响应里有状态码、系统调用失败靠 errno 区分错误类型,是同一个工程思想。
6.4 协议要解决的两个问题
Protocol.hpp 末尾的注释把话说明白了:
cpp
// 协议(基于TCP的)需要解决两个问题:
// 1. request和response必须得有序列化和反序列化功能
// 2. 你必须保证,读取的时候,读到完整的请求(TCP, UDP不用考虑)
第一条是这节课的主题。第二条是 TCP 字节流的报文完整性问题------读少了是半条残报文没法解析,读多了夹带了下一条的开头。UDP 不用管是因为 UDP 一个个数据报天然有边界,recvfrom 一次就是一条完整消息。第二条留给下篇,咱们先把第一条的工具备好。
6.5 手搓字符串 vs JSON
文件注释里列了两条路:
cpp
// 如何要做序列化和反序列化:
// 1. 我们自己写(怎么做) ---> 往往不具备很好的扩展性
// 2. 使用现成的方案(这个是我们要写的) ---> json -> jsoncpp
自己写是什么样?注释里给了思路:用空格当分隔符,序列化成 "10 20 +",反序列化时按空格切三刀再转回 int/char,用 stringstream 或 split 就能干。这方案定长简单字段没问题,但毛病也真实:
加字段得改两端的拼接/解析代码,老版本新版本不兼容;
字段类型和名字对不上,全靠位置和注释,字段一多就是
data[3]这种玄学;字符串内容里要是本身带空格(比如将来传消息文本),分隔符就崩了,还得搞转义。
JSON 是工业界通用的文本格式:{"x":10,"y":20,"oper":"+"},自带字段名、自带类型区分(数字不带引号、字符串带引号)、嵌套对象数组都支持,加字段对老端透明。C++ 标准库没有 JSON,咱们用第三方库 jsoncpp ,这就是 testjson.cc 的内容。
七、重头戏三:jsoncpp 实战(testjson.cc)
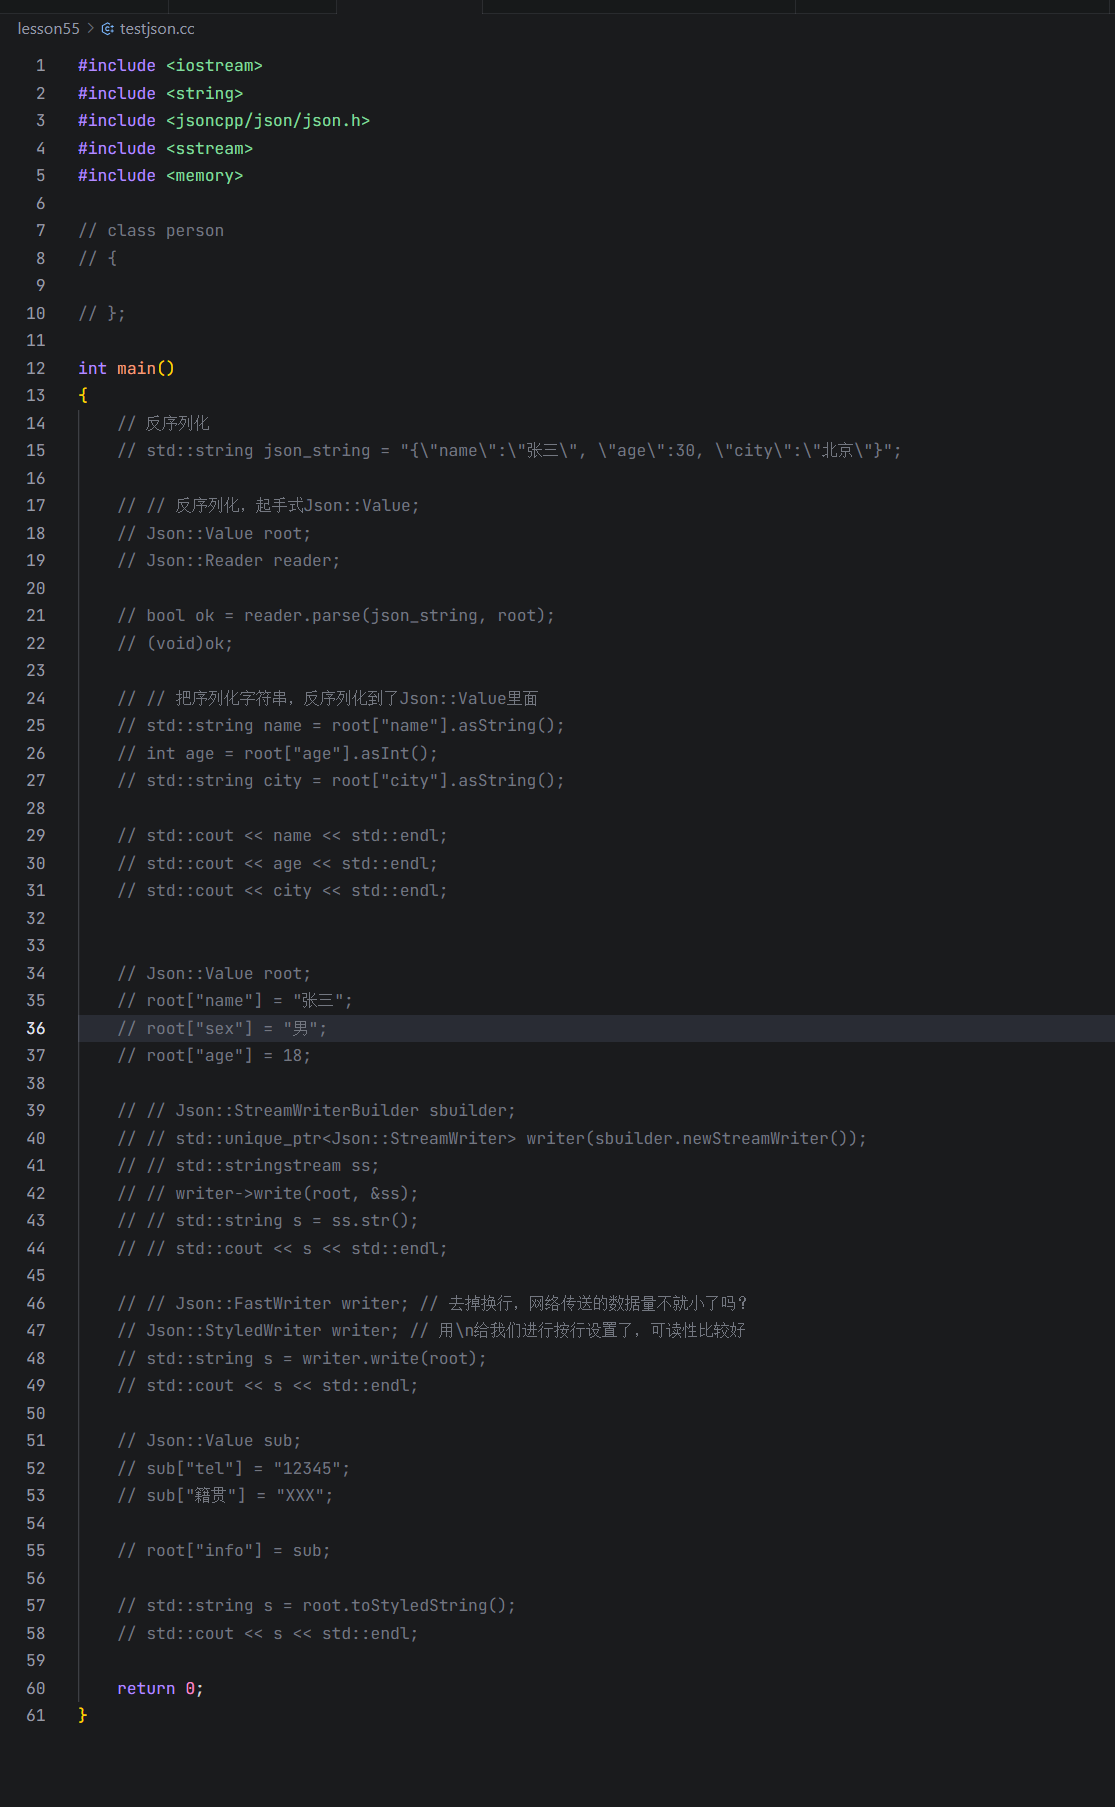
testjson.cc 现在整文件都是注释------它是个试验场,每一段都是可以单独放开跑的。我把里面每种写法都实际编译运行过,下面给出的输出全是真机实跑结果,不是对着文档脑补的。
7.1 环境和编译方式
机器上装开发包:sudo apt install libjsoncpp-dev。我这台装的是 1.9.5,头文件在 /usr/include/jsoncpp/json/json.h,所以代码里 include 长这样:
cpp
#include <jsoncpp/json/json.h>动态库是 libjsoncpp.so,编译时必须手动链 -ljsoncpp,不然满屏 undefined reference:
cpp
g++ -std=c++17 testjson.cc -o testjson -ljsoncpp顺带一提,当前 Makefile 没链它,因为服务器主体还没用上 JSON,testjson.cc 是独立试验。
7.2 Json::Value:jsoncpp 的万能容器
不管序列化还是反序列化,核心类型都是 Json::Value。它是个 union 式的动态类型容器,一个 Value 对象可以表示任意 JSON 值:null、布尔、整数、浮点、字符串、数组、对象(键值对集合)。这就是为什么代码里敢这么写:
cpp
Json::Value root;
root["name"] = "张三";   // Value 从空对象变成带字符串字段的对象
root["sex"]  = "男";
root["age"]  = 18;      // 同一个 root,int 直接塞
root["key"] = 值 用起来像 map 的 [],但右值可以是任意类型,Value 内部自动包装。
7.3 反序列化四步:Reader 老写法
文件开头注释的第一段就是反序列化:
cpp
std::string json_string = "{\"name\":\"张三\", \"age\":30, \"city\":\"北京\"}";

// 反序列化,起手式Json::Value;
Json::Value root;
Json::Reader reader;

bool ok = reader.parse(json_string, root);
(void)ok;

// 把序列化字符串,反序列化到了Json::Value里面
std::string name = root["name"].asString();
int age = root["age"].asInt();
std::string city = root["city"].asString();
四步走,这是所有 jsoncpp 反序列化的固定套路:
准备输入:一段符合 JSON 格式的字符串;
造一个空 Value 和一个解析器 :
Json::Value root; Json::Reader reader;;parse :
reader.parse(字符串, root),字符串解析后填进 root,返回 bool 表示格式合不合法(代码里(void)ok;表示这试验里故意不检查,工程代码必须检查);按类型取值 :
asString()、asInt()、asDouble()、asBool()......key 是什么就用中括号取。
实跑输出:
cpp
张三
30
北京
7.4 现代写法:CharReaderBuilder
得说句实在的:Json::Reader 在 jsoncpp 官方已经标记为废弃接口 ,推荐 CharReader + CharReaderBuilder。不过别慌,你机器上这个 1.9.5 的 Ubuntu 包头文件里,废弃标记只写在注释(\deprecated)中,类上没挂 __attribute__((deprecated)) 属性,所以我用 -Wall -Wextra 实测不会报警告 ,旧代码和教材里到处都是它,必须认识。新写代码建议这样:
cpp
#include <memory>
Json::CharReaderBuilder crb;
std::string errs;
Json::Value parsed;
std::unique_ptr<Json::CharReader> cr(crb.newCharReader());
std::string raw = "{\"x\":10,\"y\":20,\"oper\":\"+\"}";
bool ok = cr->parse(raw.data(), raw.data() + raw.size(), &parsed, &errs);
// 实测:ok=1  parsed["x"].asInt()=10  oper=[+]
区别就是用 builder 造一个 CharReader,parse 时传字符串的首尾指针(半开区间),出错信息进 errs。写法啰嗦一点,但错误处理更规范,也是官方现在主推的路子。
7.5 序列化姿势一:FastWriter,给网络用的紧凑格式
注释里的老写法:
cpp
Json::FastWriter writer; // 去掉换行,网络传送的数据量不就小了吗?
std::string s = writer.write(root);
std::cout << s << std::endl;
实跑(三个字段 name/sex/age)拿到的字符串是(我用 > < 把首尾边界标出来):
cpp
>{"age":18,"name":"\u5f20\u4e09","sex":"\u7537"}
<
单行、无缩进、无多余空白,这就是给机器传输用的------少几个空格,网络上就是少几个字节,高并发下差距能累积出来。注释里"去掉换行"说的是它和后面 StyledWriter 的风格对比。这里有两个实测细节必须知道:
FastWriter 的返回值末尾其实带一个
'\n'(上面的<在下一行)。我用s.size()量过,这个换行符算在长度里。它不是毛病是设计:RPC 场景下这个\n恰好可以当报文分隔符。不想要可以调专门的接口writer.omitEndingLineFeed(),调完再 write 就没尾换行了,实测长度刚好缩短 1;中文默认不是直接输出的,见 7.9 的坑表。
7.6 序列化姿势二:StyledWriter,给人看的格式
cpp
Json::StyledWriter writer; // 用\n给我们进行按行设置了,可读性比较好
std::string s = writer.write(root);
实跑输出(数据就是前面 root["name"]="张三"、root["sex"]="男" 那份):
cpp
{
   "age" : 18,
   "name" : "\u5f20\u4e09",
   "sex" : "\u7537"
}
3 空格缩进、冒号两边有空格、每个字段一行。注意中文照样是 \uXXXX 转义形态------别以为换个"给人看"的 Writer 中文就自动变原文了,1.9.5 里这几个老 Writer 默认都转义,统一在 7.9 的坑里讲。这格式发给网络纯属浪费,但写配置文件、打日志调试时看着舒服。它和 FastWriter 一样是官方文档标注的废弃接口,认识即可。
7.7 序列化姿势三:StreamWriterBuilder 三件套
文件里注释着的现代写法:
cpp
Json::StreamWriterBuilder sbuilder;
std::unique_ptr<Json::StreamWriter> writer(sbuilder.newStreamWriter());
std::stringstream ss;
writer->write(root, &ss);
std::string s = ss.str();
std::cout << s << std::endl;
这次的搭配是"builder 造 writer,writer 往流里写":
StreamWriterBuilder:writer 的工厂,默认产出带缩进的美化风格;
newStreamWriter()返回裸指针,立刻用unique_ptr接住,出作用域自动释放;
write(root, &ss)不直接返回字符串,而是写进一个输出流(stringstream、ofstream、cout都行,想直接写文件就传文件流,省一道内存拷贝);最后
ss.str()把流里的内容取成 string。
默认输出是 tab 缩进风格(终端里显示成一段空白),注意它末尾不自动加换行。
这套 builder 真正的价值是能配置。网络传输想要紧凑单行,我实测过这样配:
cpp
Json::StreamWriterBuilder b;
b["indentation"] = "";   // 空缩进 = 单行紧凑
b["emitUTF8"] = true;    // 中文直接输出 UTF-8 原文
std::string s = Json::writeString(b, root);
Json::writeString(builder, value) 是库给的便捷函数,内部帮你把 writer 往 stringstream 里写那一套包了。带嵌套对象的实跑结果:
cpp
>{"age":18,"info":{"tel":"12345"},"name":"张三"}<无缩进、无尾换行、中文原文------这就是下篇真正要发在网络上的形态。
7.8 序列化姿势四:toStyledString 与嵌套对象
文件最后一段演示嵌套:
cpp
Json::Value sub;
sub["tel"] = "12345";
sub["籍贯"] = "XXX";

root["info"] = sub;                 // Value 当 value 塞进去,就是嵌套对象

std::string s = root.toStyledString();
std::cout << s << std::endl;
JSON 对象可以当字段值,于是形成树形结构。toStyledString() 是 Json::Value 自己的成员函数,等价于"内部临时造个 StyledWriter 把自己写一遍",一行出美化字符串,最省事。实跑(注意:连中文的 key "籍贯" 都被转义了;info 内部 tel 排在"籍贯"前面,是因为 jsoncpp 按 key 存储的原始字节排序------tel 首字节 0x74 小于"籍"的 UTF-8 首字节 0xE7,排序发生在转义之前,跟输出长什么样无关):
cpp
{
        "age" : 18,
        "info" :
        {
                "tel" : "12345",
                "\u7c4d\u8d2f" : "XXX"
        },
        "name" : "\u5f20\u4e09",
        "sex" : "\u7537"
}
7.9 jsoncpp 踩坑实录(全是实跑验证)
这几个坑我建议直接抄进小本本,都是光看代码看不出来、跑一遍才知道的行为:
| 坑 | 实测现象 | 应对 |
|---|---|---|
| key 不保插入序 | 先插 name 再插 age,输出顺序是 age, name, sex |
Value 对象内部按 key 字节序排列(纯 ASCII 时看着就是字母序),协议解析永远按键名取值,别靠位置 |
| 中文默认被转义 | "张三" 输出成 "\u5f20\u4e09"("男"是 \u7537),FastWriter、StyledWriter、toStyledString 以及默认配置的 StreamWriterBuilder 全都转义,连中文 key 也不放过 |
想直接发 UTF-8 原文:builder 里设 b["emitUTF8"]=true。反序列化不用慌,\uXXXX 也能正确还原成 UTF-8 |
| FastWriter 尾换行 | write() 返回的字符串末尾藏一个 \n,长度都算进去了 |
需要就 pop_back(),或调 omitEndingLineFeed();留着它当报文分隔符反而是妙用 |
[] 访问不存在的 key 有副作用 |
非 const 的 root["x"] 读一个不存在的 key,会往对象里插入一个 null ,再序列化就多了 "x":null |
用前先 root.isMember("x") 判断,或通过 const 引用访问(const 版不插入) |
| 取错类型不报错但值没意义 | null 调 asString() 得空串、asInt() 得 0 |
取值类型要和协议约定一致,parse 后先校验再用 |
| 老接口废弃 | Reader/FastWriter/StyledWriter 官方文档已标 deprecated | 新代码用 CharReaderBuilder/StreamWriterBuilder,老代码得能看懂 |
补一个中文反序列化的实测,证明转义只是传输形态、不丢信息:输入 "\u5f20\u4e09" parse 后取字符串,打出来就是"张三",底层字节是 e5 bc a0 e4 b8 89,标准 UTF-8 编码。
八、Main.cc:把所有模块拧成一股绳
最后看入口,短,但能看出各层是怎么拼的:
cpp
#include "Protocol.hpp"
#include "TcpServer.hpp"
#include <memory>

void Usage(std::string proc)
{
    std::cerr << "Usage: " << proc << " port" << std::endl;
}

// ./tcpserver 8080
int main(int argc, char *argv[])
{
    if (argc != 2)
    {
        Usage(argv[0]);
        exit(USAGE_ERR);
    }
    std::unique_ptr<Protocol> protocol = std::make_unique<Protocol>();

    std::unique_ptr<TcpServer> tsvr = std::make_unique<TcpServer>(std::stoi(argv[1]),
        [&protocol](std::shared_ptr<Socket> &sock, InetAddr &client){
            protocol->GetRequest(sock, client);
    });
    tsvr->Start();

    return 0;
}
命令行必须正好两个参数(程序名 + 端口),不对就打 Usage 并以
USAGE_ERR(值为 1)退出;
std::stoi把字符串端口转 int,再隐式转uint16_t;先造协议对象
protocol,再造服务器。第二个参数是个 lambda ,签名正好匹配ioservice_t:拿到通信套接字和客户端地址,转手调protocol->GetRequest(sock, client)。[&protocol]是引用捕获------lambda 不拥有 protocol,只引用 main 栈上那个;生命周期是安全的:
tsvr->Start()内部才会通过回调使用 protocol,而 Start 不返回服务器就一直跑,protocol 在 main 栈上活得比它久。这里要是手滑写成 protocol 在 Start 之后才定义,或者对象先析构了,回调里就是悬空引用;这就是"回调注入"的现场:TcpServer 框架代码里没有一行计算器逻辑,业务全在这个 lambda 背后的 Protocol 里。下篇要写计算器,改的就是 Protocol,框架一行不动。
九、编译运行实测:当前版本跑起来是什么德行
直接 make:
cpp
$ make
g++ -o tcpserver Main.cc -std=c++17
Protocol.hpp: warning: no return statement in function returning non-void [-Wreturn-type]
(共 4 条,分别对应 Request/Response 空的 Serialize/Deserialize)
警告的原因前面埋过伏笔:四个空函数声明了非 void 返回值(std::string/bool)但函数体为空。它们当前从来没被调用过(类内定义的成员函数不被使用就不产生实际代码),所以能链接成功;等下篇填上实现,警告自然消失。属于半成品阶段的正常现象,不是病。但记牢:这种函数一旦真被调用,没有返回值就是未定义行为。
跑起来:
cpp
$ ./tcpserver 8090
[time] [INFO] [...] [Socket.hpp] [63] - socket success
[time] [INFO] [...] [Socket.hpp] [74] - bind success
[time] [INFO] [...] [Socket.hpp] [84] - listen success
另开一个终端确认监听状态:
$ ss -ltnp | grep 8090
LISTEN 0  16  0.0.0.0:8090  0.0.0.0:*  users:(("tcpserver",pid=...,fd=3))
0.0.0.0:8090 就是 INADDR_ANY,16 正是 backlog,fd=3 也符合预期(0/1/2 被标准输入输出错误占着,socket 是第一个新 fd)。
客户端连上去会发生什么?实测:TCP 连接能建立(服务端日志打 accept success),但客户端立刻 recv 到 0 字节(EOF)。原因链条很清楚:
cpp
GetRequest 是空函数
  → 孙子进程调完它立刻 exit(OK)
    → 进程退出,通信 fd 自动 close
      → 对端 recv 收到 FIN,返回 0(连接对端关闭)
所以这个版本的服务器是个"会接电话但不说话"的服务器。下篇把 GetRequest 填上"反序列化请求 → 计算 → 序列化应答 → 发回",它才真正会算账。
十、上篇收束
这节课的代码虽然业务还没跑通,但骨架里的每块骨头都值得啃明白:
模板方法模式 :
Socket基类用纯虚函数定义步骤(socket/bind/listen/accept/close),用非虚的BuildTcpSocketMethod钉死流程,TcpSocket只负责填步骤。和 Log.hpp 的策略模式(组合、整体换算法)要能分清楚;服务器框架与业务解耦 :
std::function回调把业务从 TcpServer 里剥出去;双 fork + 爹 wait 秒退的儿子,让真正干活的孙子托孤给 PID 1,accept 循环不阻塞、系统不攒僵尸(实测孙子 PPID 就是 1);序列化的必要性 :结构体不能裸发(对齐、字节序、指针、字节流边界四宗罪),必须两端约定协议,把对象转成字符串再传输;
Response用 result + code 两个字段区分正常结果和异常;jsoncpp 这套工具 :Value 装一切;反序列化记住
Value + Reader/CharReader + parse + asXxx;序列化按场景选 FastWriter(紧凑传输)、StyledWriter(人读)、StreamWriterBuilder(现代可配置)、toStyledString(偷懒神器);key 按字节序排列(不保插入顺序)、中文默认\uXXXX转义、尾换行、不存在 key 的插入副作用,这几个坑心里有数;编译要点 :服务器走 Makefile 编
Main.cc;玩 testjson 要单独g++ -std=c++17 testjson.cc -ljsoncpp,头文件路径是<jsoncpp/json/json.h>。
下篇预告 :把 Protocol.hpp 四个空函数用 JSON 填满,实现 10 + 20 → 30 的完整链路;写 TcpClient.hpp;正面解决文件注释里留的第二个问题------TCP 字节流上怎么保证读到一条完整报文(报文分隔与粘包处理)
十一.代码如下: