文章目录
- [一、 负载均衡](#一、 负载均衡)
-
- [1. LVS](#1. LVS)
- [2. Nginx](#2. Nginx)
- [3. Keepalived](#3. Keepalived)
- [二、 容灾](#二、 容灾)
-
- [1. 两地三中心](#1. 两地三中心)
- [2. 三地五中心](#2. 三地五中心)
高可用架构
在互联网高并发场景中,单台服务器很难承载海量请求,因此高可用成为系统架构的核心目标,负载均衡和容灾是必备的核心能力。
一、 负载均衡
百万级并发架构设计
在高并发互联网系统中,单点性能和可用性往往难以同时满足业务增长需求。
面对百万级并发访问场景,仅依赖单台应用服务器或简单的负载均衡方案。
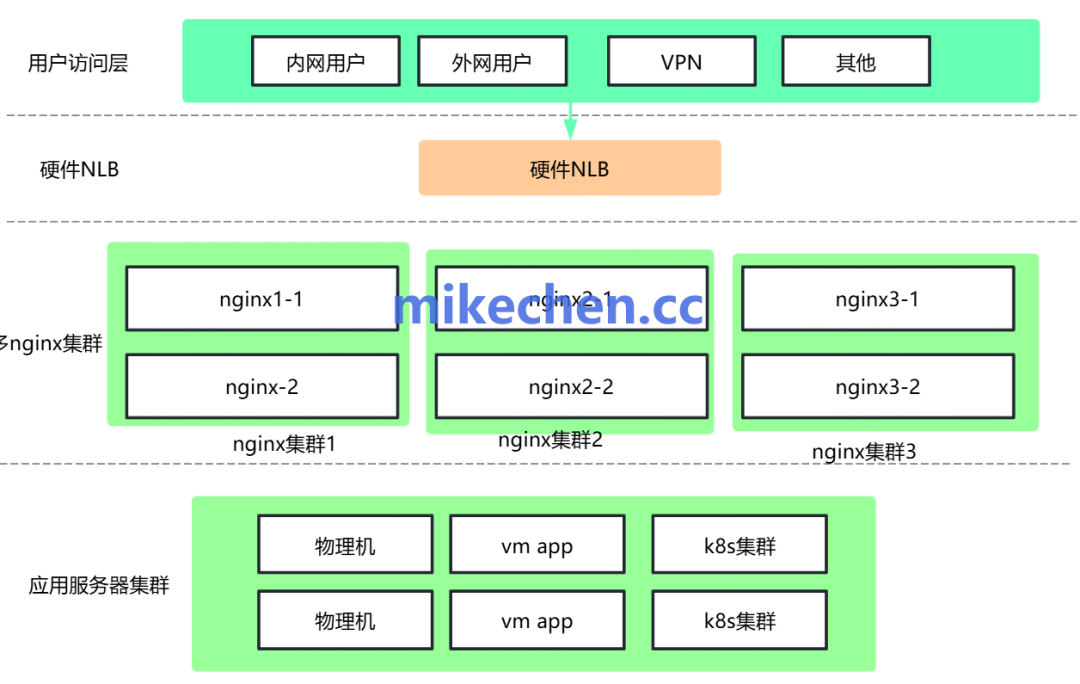
通常会在吞吐能力、故障恢复和扩展性方面遇到瓶颈。
因此,构建一套稳定、高性能、易扩展的高可用架构,成为大型系统设计的核心任务之一。
LVS、Nginx 与 Keepalived 的组合,正是当前较为经典且成熟的解决方案之一。
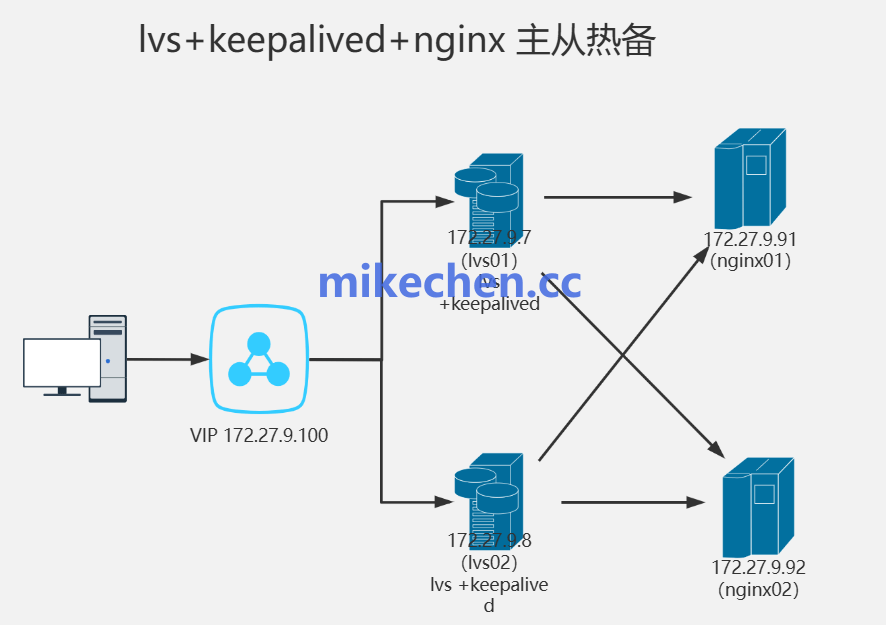
三者分工明确、层次清晰。
LVS 负责四层高性能转发,Nginx 负责七层业务分发与内容处理,Keepalived 则保障入口服务的高可用切换。
该架构既能支撑亿级流量的入口分发,也便于后续横向扩展与运维管理。
1. LVS
高性能四层负载均衡
LVS(Linux Virtual Server)通常位于负载均衡体系的最前端,承担最核心的流量调度任务。
内核态四层转发,性能极高(单机可达数十万甚至百万级并发连接),只做 IP + 端口调度。
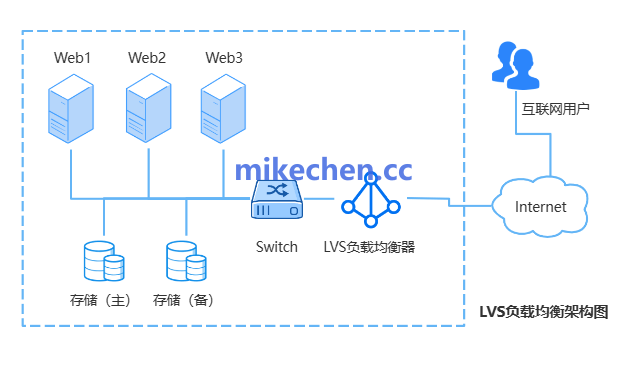
它工作在 TCP/IP 四层,主要依据源地址、目标地址、端口等信息进行分发.
不解析具体的 HTTP 内容,因此性能极高,开销极低。
LVS 的优势在于处理能力强、性能损耗低,能够轻松应对极大规模并发连接,适合做"流量总入口"。
它不解析应用层协议,仅根据 IP、端口、协议等信息进行转发,因此在百万级连接场景下表现稳定。
在实际部署中,LVS 常采用 DR(Direct Routing)模式,以减少网络转发损耗,提升吞吐能力。
对于海量请求场景来说,LVS 像是一道坚固的闸门,先以极高效率完成粗粒度的流量分流。
nginx
vrrp_instance VI_1 {
    state MASTER
interface eth0
    virtual_router_id 51
    priority 100
    advert_int 1
    authentication {
        auth_type PASS
        auth_pass yourpassword
}
    virtual_ipaddress {
192.168.1.100
}
# 可选:监控 Nginx 或 LVS 状态的脚本
    track_script {
        chk_nginx
}
}
2. Nginx
七层接入与业务分发
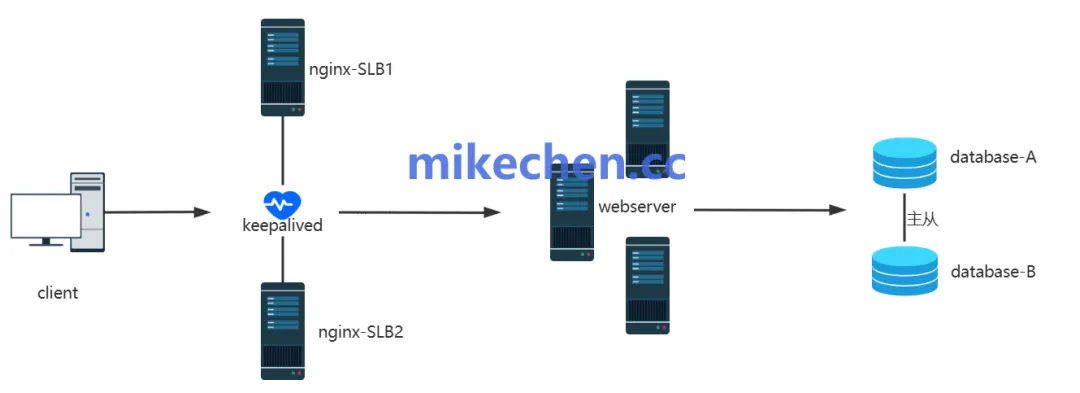
Nginx 位于 LVS 之后,承担更细粒度的七层负载均衡职责。
适合作为 Web 服务入口层,负责处理 HTTP 请求、SSL 终止、限流、压缩、缓存及静态资源服务。
nginx
upstream backend {
    least_conn;# 或 ip_hash / 加权轮询
    server 192.168.1.201:8080 weight=5 max_fails=3 fail_timeout=10s;
    server 192.168.1.202:8080 weight=5;
    keepalive 64;# 长连接复用,提升高并发性能
}

server {
    listen 80;
    location /{
        proxy_pass http://backend;
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_http_version 1.1;
        proxy_set_header Connection"";
}
    location /health {
return200'OK';
}
}
在 LVS 之后部署 Nginx,可以进一步将请求按 URI、域名、Header 等规则精细分流到不同的业务集群,从而实现更灵活的流量治理。
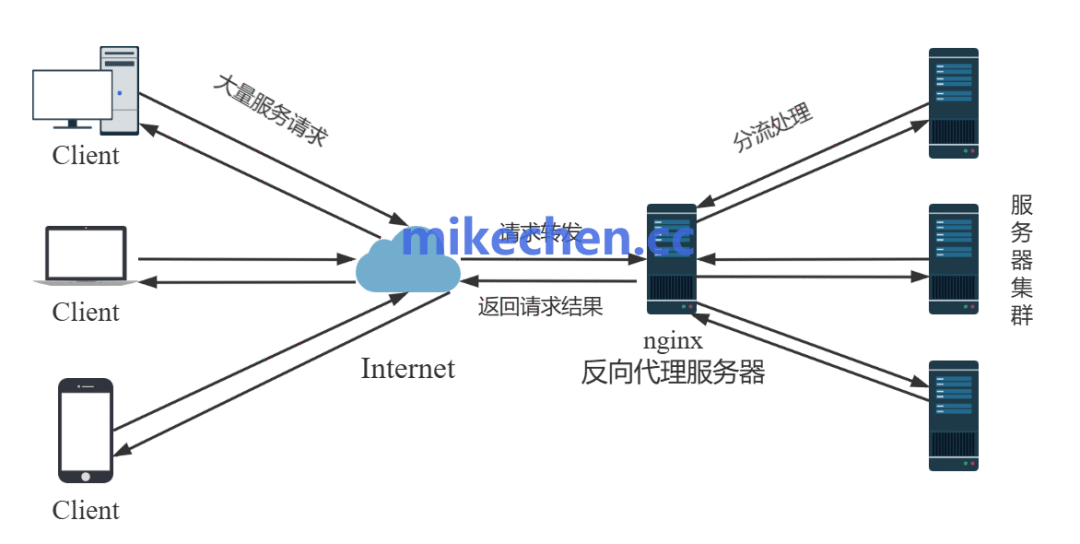
与 LVS 只看"包头"不同,Nginx 能够识别 HTTP/HTTPS 协议。
基于域名、URL、Header、Cookie 等信息进行精细化路由。
它不仅可以实现反向代理和负载均衡,还能承担静态资源服务、缓存控制、限流、压缩和 SSL 终止等任务。
在大厂架构中,Nginx 常被用作业务网关或应用层调度器。
将 LVS 已经初步分流后的请求,按照业务规则进一步转发到不同的后端服务集群。
这样既增强了灵活性,也提升了服务治理能力。
3. Keepalived
高可用保障
Keepalived ,则解决了"单点故障"问题。
Keepalived 的核心价值在于实现 VIP 漂移和健康检查。
当主负载均衡节点异常时,备节点迅速接管虚拟 IP,使外部访问无需感知底层故障,从而将服务中断时间降到最低。
对于关键业务系统而言,这种机制是保障稳定性的基础。
无论 LVS 还是 Nginx,只要作为入口节点,就必须具备高可用能力。
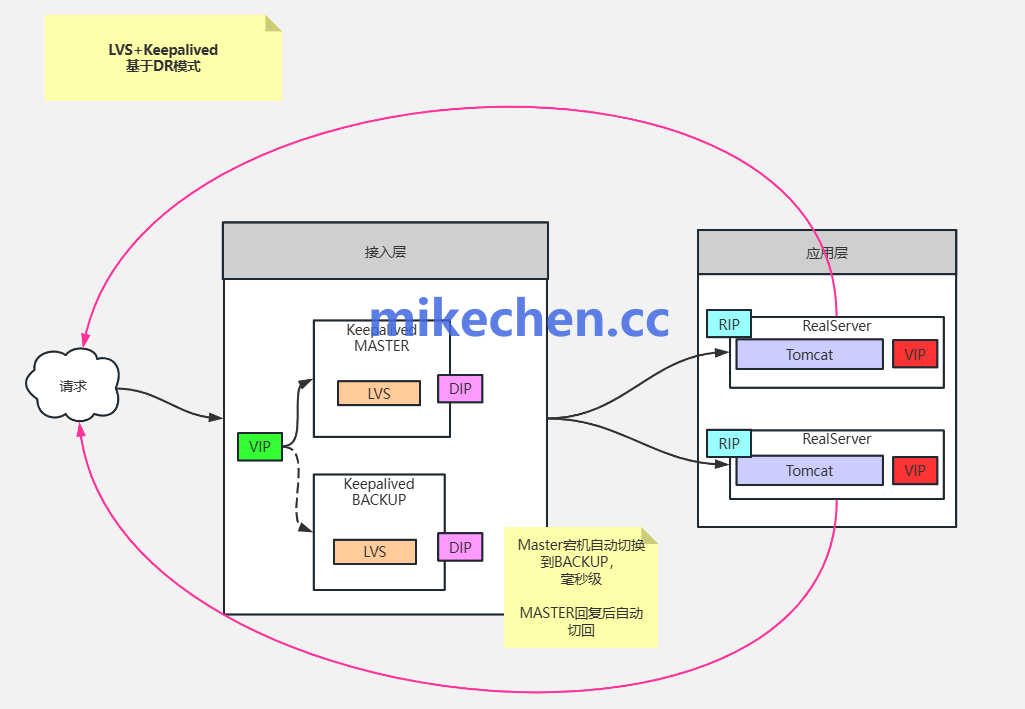
Keepalived 基于 VRRP 协议,通过主备节点间的心跳检测和虚拟 IP(VIP)漂移机制,实现故障自动切换。
当主节点异常时,备用节点会迅速接管 VIP,对外表现为服务地址未变,业务中断时间极短。
这种机制对于金融、电商、社交等对可用性极其敏感的系统尤为重要。
可以说,Keepalived 是整个负载均衡体系的"保险丝",保障入口层在故障面前依然稳定可用。
二、 容灾
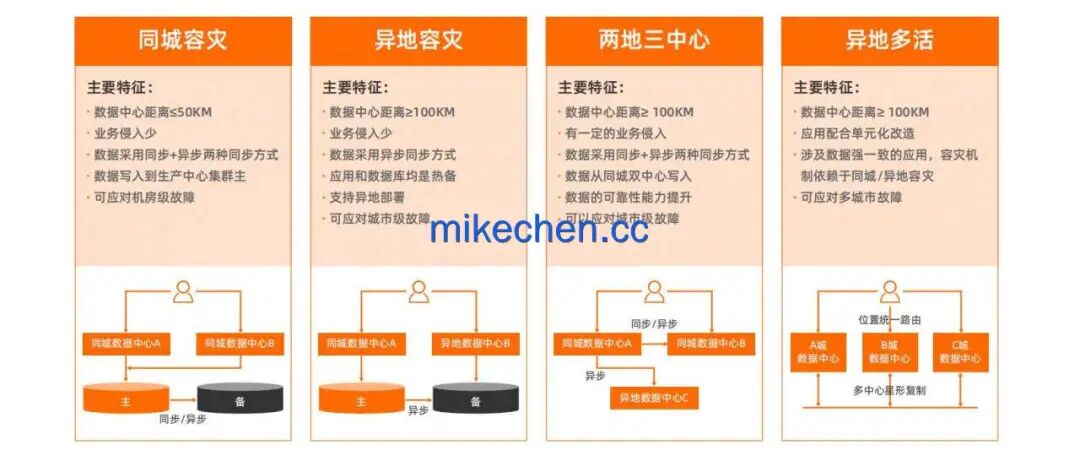
1. 两地三中心
什么是两地三中心
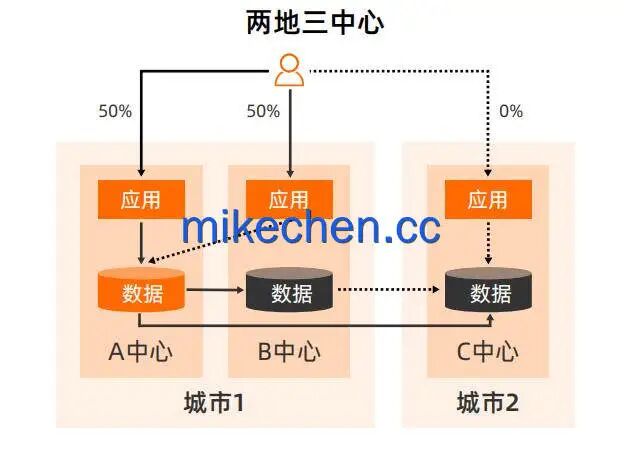
"两地三中心"中的"两地",指的是两个地理位置相隔较远的城市或区域;
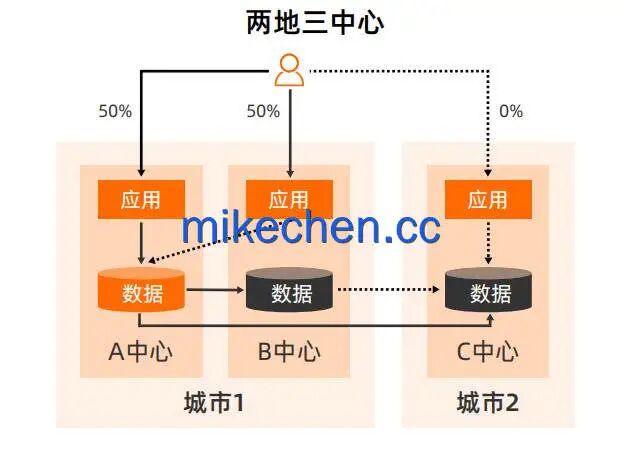
例如:北京为同城双中心所在地,上海、或杭州作为异地灾备城市。
"三中心"则通常指三个数据中心,分别承担生产、同城容灾和异地灾备等职责。
A 中心:同城生产中心------通常承接主要流量、核心写请求和主数据处理。
B 中心:同城容灾中心------与 A 同城但具备物理隔离,承担同城级故障接管,常可分担流量。
C 中心:异地灾备中心------应对城市级、电力级、运营商级或大范围自然灾害,通常承载关键业务的备用能力。
其本质,是通过跨地域部署多个中心节点,降低单点故障和区域性风险带来的业务中断概率。
两地三中心的核心架构思路
阿里的两地三中心架构,并不是传统意义上的"主备机房"简单复制,而更接近于"分层容灾+多活协同"的模式。
以北京+上海为例,整体架构如下:
textile
- Internet
- │
- ▼
-                 DNS / GSLB
- │
- ┌──────────────┴──────────────┐
- ││
- ▼▼
- 城市A生产中心城市A灾备中心
- Center-A1                     Center-A2
- ││
- ┌─────┴─────┐┌─────┴─────┐
- ││││
- SLB          Nginx             SLB          Nginx
- ││││
- └─────┬──────┘└─────┬──────┘
- ││
- 应用集群应用集群
- ││
- Redis/ MQ / RPC                Redis/ MQ / RPC
- ││
- └──────────┬───────────────────┘
- │
- 数据层
- │
- ┌────────┴────────┐
- ▼▼
- MySQLRedis
- ││
- └───────┬─────────┘
- │
- 异步复制
- │
- ▼
- 城市B灾备中心
- Center-B1
- │
- ┌─────────┴─────────┐
- ││
- 应用集群数据库
- StandbyStandby
同城(北京):IDC1(生产)+ IDC2(同城容灾),双活或主备,实时同步。
异地(上海):IDC3(灾备),异步或半同步备份。
数据副本常见模式(以分布式数据库为例,如OceanBase / PolarDB-X):5副本"2+2+1":同城两个机房各2个副本,异地1个副本。
基于Paxos/Raft多数派共识(至少3副本确认即提交)。
同城强同步(低延迟),异地异步或半同步。
分层架构:网络层:环形专线 / 高速通道 / CEN(云企业网)互联,低延迟高带宽。
应用层:无状态服务双活 + 有状态服务(DB)主备或单元化。
流量层:智能DNS / GTM / 全局负载均衡,按就近或权重调度。
管理层:统一监控、演练平台、自动切换编排。
两地三中心如何切换?
两地三中心的另一个关键问题是:
故障发生以后,用户怎么从 A 城市切到 B 城市?
通常在最上层增加:
bash
DNS/ GSLB / GTM例如:
textile
用户
│
▼
DNS/ GSLB
│
┌───────┴───────┐
▼▼
城市A             城市B
A1/ A2             B1
单机房故障(中心 A 崩溃): 仲裁触发同城切换,将流量秒级切至中心 B,中心 B 接管写服务,RPO=0,RTO<30s。
城市级灾害(中心 A+B 同时崩溃): 启用异地应急预案,将流量切至中心 C,中心 C 升为主库,保证业务底线可恢复。
2. 三地五中心
什么是三地五中心
"两地三中心"中的"两地",指的是两个地理位置相隔较远的城市或区域;
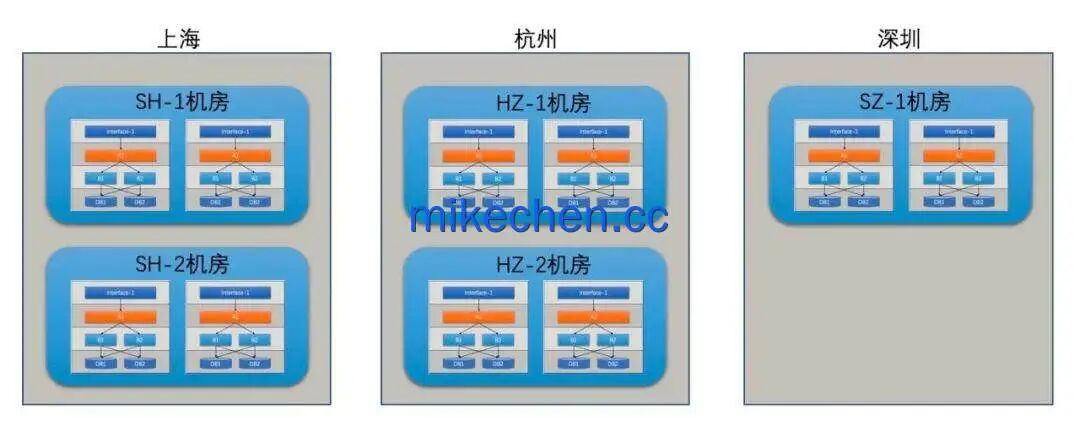
"三地五中心"可以理解为:在三个地理区域内,部署五个数据中心。
 -mikechen")
其中:
三地:通常指三个相对独立的地理区域,彼此之间具备一定物理隔离,避免同城灾害或网络故障同时影响全部系统。
- 城市 A:杭州
- 城市 B:上海
- 城市 C:异地灾备城市
五中心:指分布在三地中的五个数据中心或业务中心,承担不同层次的计算、存储和容灾职责。
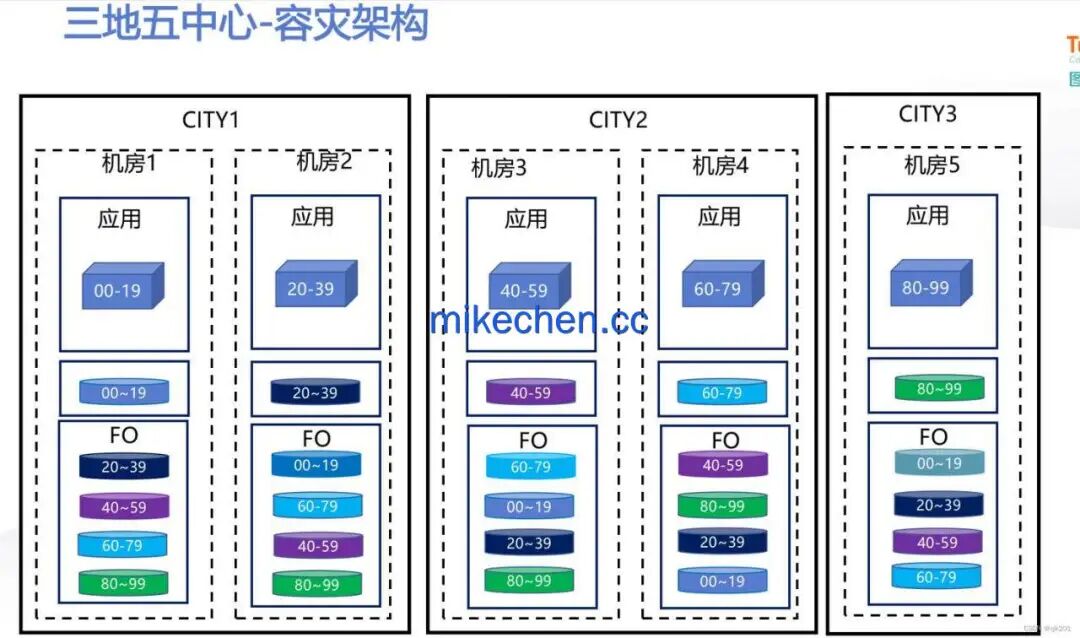
阿里三地五中心架构
阿里三地五中心架构,如下图所示:
 -mikechen")
将应用与数据按用户维度(如 UID),进行 Sharding 拆分。
textile
UserID
↓
Hash(UserID)
↓
分片号
↓
RegionalZone
↓
业务单元
例如:
textile
User-A →Unit-01→杭州
User-B →Unit-02→杭州
User-C →Unit-03→上海
User-D →Unit-04→北京
最终形成:
textile
用户
│
UserID分片
│
┌───────┼───────┐
↓↓↓
杭州上海北京
│││
Unit-A   Unit-C   Unit-D
城市 A:部署 2 个 IDC(机房 1、机房 2),承担主要的读写流量(同城双活/多活)。
城市 B:部署 2 个 IDC(机房 3、机房 4),距离城市 A 约 几百千米(异地双活)。
城市 C:部署 1 个 IDC(机房 5),距离更远(如 >1000 千米),主要用于远端极小流量或纯多数派选主投票。
总之,阿里三地五中心并不是一个单一产品,而是一整套围绕高可用与灾备设计的系统架构理念。
它的核心逻辑是:通过地理隔离、资源冗余和自动切换,构建能够抵御多级故障的业务基础设施。
本文的引用仅限自我学习如有侵权,请联系作者删除。
参考知识
百万级并发架构设计:LVS+Nginx+Keepalived负载方案!