文章目录
-
- [一、从文字到数字:为什么需要 Embedding](#一、从文字到数字:为什么需要 Embedding)
- [二、Embedding 本质上是查表](#二、Embedding 本质上是查表)
- [三、Embedding 怎么通过训练学出来](#三、Embedding 怎么通过训练学出来)
- [四、Word2Vec:CBOW 和 Skip-gram](#四、Word2Vec:CBOW 和 Skip-gram)
- 五、负采样:不要每次比较整个词表
- 六、用余弦相似度看语义距离
- 七、从静态词向量到上下文相关表示
- [八、Transformer 里的 Token Embedding](#八、Transformer 里的 Token Embedding)
- 九、输出层和权重绑定
- [十、RAG 里的 Embedding 和模型内部 Embedding](#十、RAG 里的 Embedding 和模型内部 Embedding)
- [十一、Embedding 模型如何用于检索](#十一、Embedding 模型如何用于检索)
- [十二、Embedding 的常见问题](#十二、Embedding 的常见问题)
-
- [问题 1:语义相近但关键词不同](#问题 1:语义相近但关键词不同)
- [问题 2:关键词相同但语义不同](#问题 2:关键词相同但语义不同)
- [问题 3:长文档被压成一个向量会丢信息](#问题 3:长文档被压成一个向量会丢信息)
- [问题 4:领域术语不匹配](#问题 4:领域术语不匹配)
- [问题 5:向量相似不等于答案正确](#问题 5:向量相似不等于答案正确)
- 十三、常见误区
- 十四、你应该记住的最小心智模型
- 总结
- 大模型视角
- 下一篇
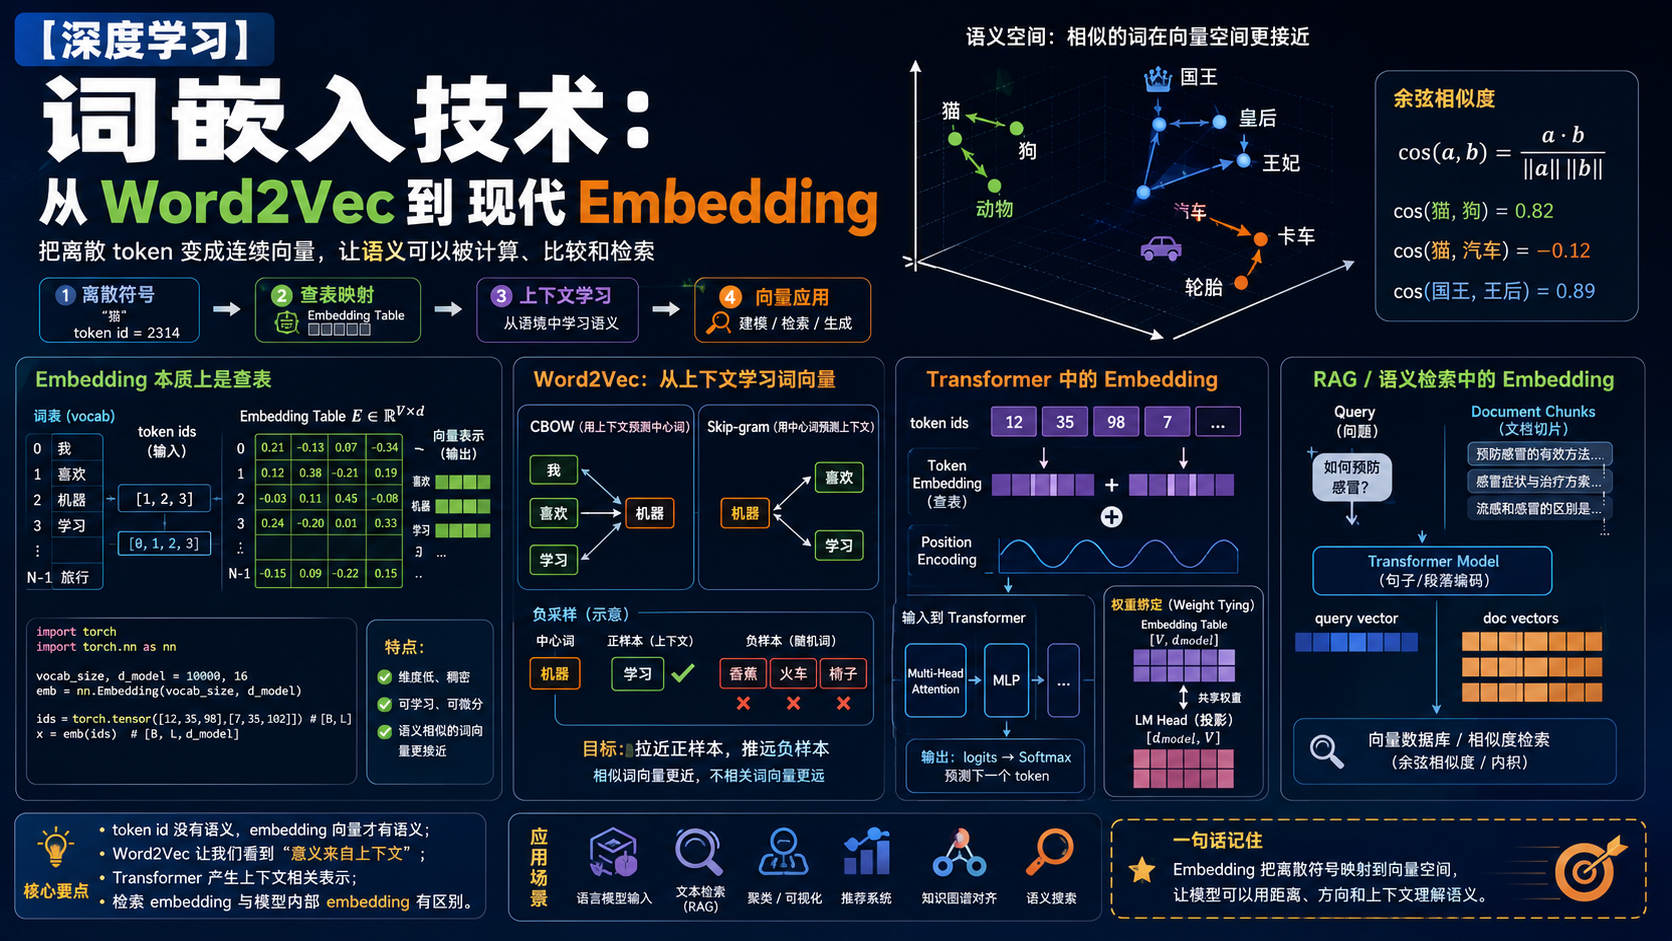
摘要:模型不能直接理解文字,必须先把离散 token 变成连续向量。Embedding 的本质是一张可学习的查表矩阵:每个 token id 对应一行向量。Word2Vec 让我们看到"词的意义可以从上下文中学出来",Transformer 把 token embedding、位置编码和上下文表示进一步结合,现代 RAG 和语义检索又把 embedding 用作文本相似度搜索的基础。本文从 one-hot 为什么不够讲起,解释 embedding 查表、Word2Vec 的 Skip-gram/CBOW 直觉、余弦相似度、Transformer token embedding、上下文相关 embedding、权重绑定,以及模型内部 embedding 和检索 embedding 的区别。
前置知识 :向量与矩阵, Softmax,反向传播
阅读时间 :约 65 分钟
代码环境:Python 3.10+,numpy >= 1.24,torch >= 2.0
入门导读:先抓住主线
Embedding 要解决的问题很简单:文字是离散符号,神经网络需要连续向量。
例如:
text
"猫" -> token id 2314 -> 向量 [0.12, -0.08, 0.31, ...]这个向量不是人工写出来的,而是在训练中学出来的。训练目标会让经常出现在类似上下文里的词,向量逐渐靠近。
从 Word2Vec 到现代大模型,核心思想一直在:
一个 token 的意义,来自它在上下文中的使用方式。
但要注意,现代语境里的 embedding 有两个含义:
- 模型内部 token embedding:把 token id 查成向量,作为 Transformer 输入;
- 检索/语义 embedding:把一句话、一段文档编码成向量,用于相似度搜索。
它们相关,但不是同一件事。
读完先达到这个程度就够了:
- 能解释 one-hot 表示为什么不适合直接建模语义;
- 能理解 embedding table 本质上是查表;
- 能说清 Word2Vec 如何从上下文学习词向量;
- 能用余弦相似度比较向量接近程度;
- 能理解 Transformer token embedding 和 position embedding 的作用;
- 能区分模型内部 embedding 和 RAG 里的语义 embedding。
带着这 3 个问题读:
- 为什么 token id 不能直接当成模型输入?
- Word2Vec 为什么能让语义相近的词向量更接近?
- RAG 里用的 embedding 和大模型输入层 embedding 有什么区别?
一、从文字到数字:为什么需要 Embedding
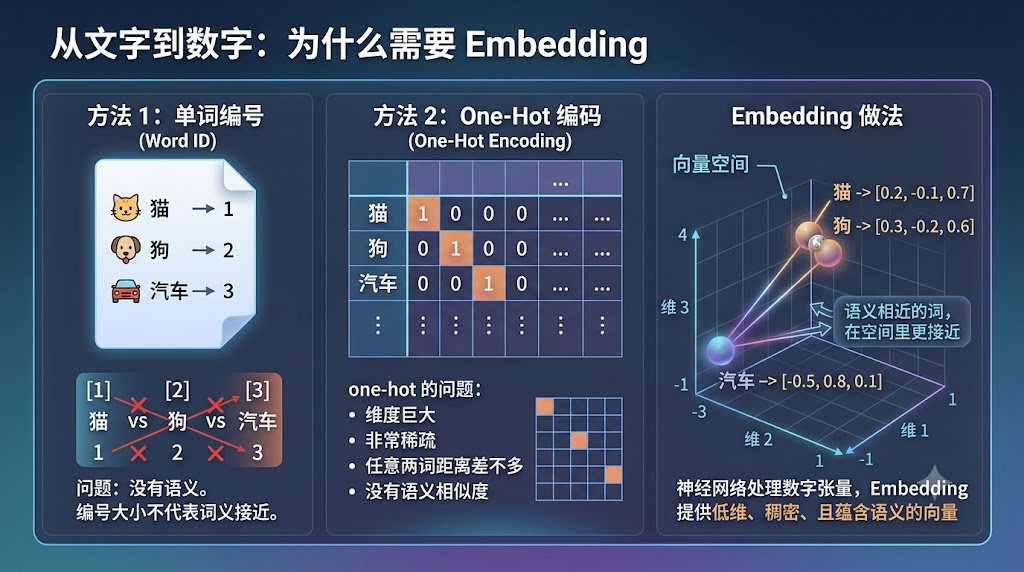
神经网络处理的是数字张量,不是文字。
最直接的方法是给每个词一个编号:
text
猫 -> 1
狗 -> 2
汽车 -> 3但编号本身没有语义。猫=1、狗=2、汽车=3 不表示猫和狗比猫和汽车更接近。
另一种方法是 one-hot:词表有多大,向量就有多长。某个词对应位置为 1,其余为 0。
text
猫   -> [1, 0, 0, 0]
狗   -> [0, 1, 0, 0]
汽车 -> [0, 0, 1, 0]
one-hot 的问题:
- 维度巨大;
- 非常稀疏;
- 任意两个不同词距离都差不多;
- 没有语义相似度。
Embedding 的做法是把每个 token 映射成一个低维稠密向量:
text
猫   -> [0.2, -0.1, 0.7]
狗   -> [0.3, -0.2, 0.6]
汽车 -> [-0.5, 0.8, 0.1]
这样语义相近的词,有机会在向量空间里更接近。
二、Embedding 本质上是查表
在神经网络里,embedding table 是一个矩阵:
text
[vocab_size, embedding_dim]每个 token id 对应矩阵中的一行。
PyTorch 示例:
python
import torch
import torch.nn as nn

vocab_size = 10000
embedding_dim = 16
embedding = nn.Embedding(vocab_size, embedding_dim)

token_ids = torch.tensor([[12, 35, 98], [7, 35, 102]])
x = embedding(token_ids)

print(token_ids.shape)  # [batch, seq_len]
print(x.shape)          # [batch, seq_len, embedding_dim]
nn.Embedding 本质上就是查表。输入是整数 id,输出是对应行向量。
这些向量一开始通常随机初始化,训练过程中通过反向传播更新。
如果某个 token 在训练中频繁出现在类似上下文里,它的向量会被推向能帮助模型完成预测的位置。
三、Embedding 怎么通过训练学出来
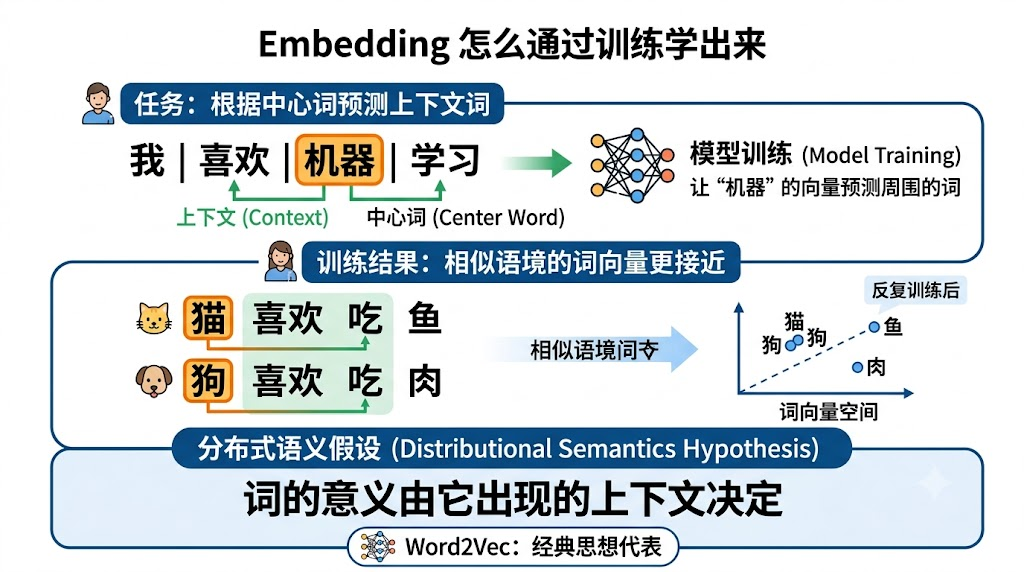
假设我们做一个很简单的任务:根据中心词预测上下文词。
句子:
text
我 喜欢 机器 学习如果中心词是"机器",上下文可能是"喜欢""学习"。模型训练目标是让"机器"的向量能预测它周围的词。
训练反复进行后,出现在相似上下文中的词会拥有相似向量。
例如:
text
猫 喜欢 吃 鱼
狗 喜欢 吃 肉
"猫"和"狗"经常出现在类似语境里,它们的向量可能更接近。
这就是分布式语义假设的直觉:
词的意义由它出现的上下文决定。
Word2Vec 就是这个思想的经典代表。
四、Word2Vec:CBOW 和 Skip-gram
Word2Vec 有两种常见训练方式。
CBOW
CBOW 用上下文预测中心词。
text
上下文:我 喜欢 [MASK] 学习
目标:机器
Skip-gram
Skip-gram 用中心词预测上下文。
text
中心词:机器
目标:喜欢、学习
两者都在学习一个目标:让语义相关、上下文相似的词在向量空间中更接近。
简化 Skip-gram 训练样本生成:
python
sentence = ["我", "喜欢", "机器", "学习"]
window = 1
pairs = []

for i, center in enumerate(sentence):
    for j in range(max(0, i - window), min(len(sentence), i + window + 1)):
        if i != j:
            pairs.append((center, sentence[j]))

print(pairs)
输出类似:
text
("喜欢", "我")
("喜欢", "机器")
("机器", "喜欢")
("机器", "学习")
真实 Word2Vec 会用负采样等技巧避免对整个词表做完整 softmax,从而提升训练效率。
五、负采样:不要每次比较整个词表
如果词表有 100 万词,每次训练都对整个词表做 softmax,成本很高。
负采样的思路是:
text
正样本:真实上下文词
负样本:随机采样几个不是上下文的词
模型只需要区分"这个词是不是中心词的真实上下文"。
例如中心词"机器",正样本"学习",负样本"香蕉""火车""椅子"。
训练目标让:
text
机器 和 学习 的相似度变高
机器 和 随机负样本 的相似度变低
这大幅降低计算成本,也让词向量训练更高效。
现代大规模对比学习、embedding 检索模型里,也能看到类似"正样本拉近、负样本推远"的思想。
六、用余弦相似度看语义距离
Embedding 向量训练好后,常用余弦相似度衡量方向接近程度。
公式:
c o s ( a , b ) = a ⋅ b ∥ a ∥ ∥ b ∥ cos(a, b) = \frac{a \cdot b}{\|a\|\|b\|} cos(a,b)=∥a∥∥b∥a⋅b
代码:
python
import numpy as np

def cosine_similarity(a, b):
    a = np.array(a)
    b = np.array(b)
    return float(a @ b / (np.linalg.norm(a) * np.linalg.norm(b)))

cat = [0.2, 0.1, 0.7]
dog = [0.25, 0.05, 0.65]
car = [-0.5, 0.8, 0.1]

print("cat-dog:", cosine_similarity(cat, dog))
print("cat-car:", cosine_similarity(cat, car))
余弦相似度更关注方向,而不是向量长度。
在检索系统里,常见做法是把 query 和 document 编码成向量,再用余弦相似度或内积找最近文档。
七、从静态词向量到上下文相关表示
Word2Vec 这类词向量通常是静态的:同一个词只有一个向量。
这会遇到多义词问题。
例如"苹果":
text
我买了一个苹果。
苹果发布了新手机。
静态 embedding 里,"苹果"只有一个向量,很难同时表达水果和公司。
Transformer 里的表示是上下文相关的。
输入层 token embedding 仍然是查表得到的静态向量,但经过多层 self-attention 后,每个 token 的 hidden state 会融合上下文信息。
text
输入层:苹果 -> 同一个 token embedding
经过 Transformer:
  水果语境里的苹果 -> 一种上下文表示
  公司语境里的苹果 -> 另一种上下文表示
这就是现代语言模型强于早期静态词向量的重要原因之一。
八、Transformer 里的 Token Embedding
在 Transformer 语言模型中,第一步通常是:
text
token ids -> token embedding形状:
text
input_ids: [batch, seq_len]
token_embedding: [vocab_size, d_model]
output: [batch, seq_len, d_model]
PyTorch:
python
import torch
import torch.nn as nn

batch, seq_len = 2, 4
vocab_size, d_model = 50000, 768

input_ids = torch.randint(0, vocab_size, (batch, seq_len))
tok_emb = nn.Embedding(vocab_size, d_model)

x = tok_emb(input_ids)
print(x.shape)
然后通常还要加入位置信息:
text
x = token_embedding + position_embedding或者在 attention 的 Q/K 上使用 RoPE。
Token embedding 解决"是什么 token",位置编码解决"在哪里"。
九、输出层和权重绑定
语言模型最后要把 hidden state 映射回词表 logits:
text
hidden: [batch, seq_len, d_model]
logits: [batch, seq_len, vocab_size]
这通常通过 LM Head 完成:
python
lm_head = nn.Linear(d_model, vocab_size, bias=False)
logits = lm_head(hidden)
有些模型会使用 weight tying,也就是输入 embedding 矩阵和输出投影矩阵共享权重。
直觉:输入时每个 token 有一个向量,输出时也需要判断 hidden state 和哪个 token 向量最匹配。共享权重可以减少参数,也可能改善表示一致性。
PyTorch 示意:
python
tok_emb = nn.Embedding(vocab_size, d_model)
lm_head = nn.Linear(d_model, vocab_size, bias=False)

lm_head.weight = tok_emb.weight
权重绑定不是所有模型都必须用,但它是语言模型里常见技巧。
十、RAG 里的 Embedding 和模型内部 Embedding
现代应用里,说到 embedding,很多人想到的是 RAG 检索向量。
例如:
text
query -> embedding vector
document chunk -> embedding vector
向量数据库检索相似 chunk
这和模型内部 token embedding 有区别。
| 类型 | 输入 | 输出 | 用途 |
|---|---|---|---|
| Token Embedding | token id | 每个 token 一个向量 | 作为语言模型内部输入 |
| 语义 Embedding | 句子/段落/文档 | 整段文本一个向量 | 检索、聚类、相似度 |
RAG embedding 通常来自专门训练的 Encoder 模型或 embedding API。它输出的是整段文本的语义向量,目标是让相关文本在向量空间接近。
模型内部 token embedding 则是大模型参数的一部分,主要服务于后续 Transformer 计算。
不要把两者混为一谈。
十一、Embedding 模型如何用于检索
一个最小语义检索流程:
python
import numpy as np

def normalize(x):
    x = np.array(x, dtype=float)
    return x / np.linalg.norm(x)

query = normalize([0.2, 0.1, 0.7])
docs = np.array([
    normalize([0.21, 0.12, 0.69]),
    normalize([-0.4, 0.9, 0.1]),
    normalize([0.18, 0.08, 0.72]),
])

scores = docs @ query
ranking = np.argsort(-scores)
print(scores)
print(ranking)
真实系统会用向量数据库做近似最近邻搜索,例如 FAISS、Milvus、Qdrant、pgvector 等。
RAG 效果不仅取决于 embedding 模型,还取决于:
- 文档切分 chunk 是否合理;
- query 是否需要改写;
- 向量维度和归一化;
- top-k 取多少;
- 是否使用 reranker;
- 检索结果如何放入 prompt;
- 是否保留引用和来源。
Embedding 是 RAG 的基础,但不是 RAG 的全部。
十二、Embedding 的常见问题
问题 1:语义相近但关键词不同
好的 embedding 应该能找到语义相近内容,而不只是关键词重合。
text
query:如何重置密码?
doc:忘记登录口令后的找回流程
问题 2:关键词相同但语义不同
Embedding 也可能被表面相似迷惑。
text
苹果 水果
aapl 苹果公司股票
上下文和领域训练很重要。
问题 3:长文档被压成一个向量会丢信息
一篇很长的文档包含多个主题,如果只编码成一个向量,细节可能被稀释。所以 RAG 常常需要 chunk。
问题 4:领域术语不匹配
通用 embedding 模型可能不懂医疗、法律、金融、代码库里的专业语义。领域任务可能需要专门模型或微调。
问题 5:向量相似不等于答案正确
检索相似文档只是第一步。最终回答还要看生成模型是否忠实使用证据。
十三、常见误区
误区 1:token id 大小有语义。
没有。id 只是查表索引,语义来自 embedding 向量和训练过程。
误区 2:Embedding 向量每一维都有明确人工含义。
通常没有。单个维度很难解释,语义更多体现在整体方向和距离上。
误区 3:Word2Vec 已经过时,所以不值得学。
Word2Vec 是理解分布式语义和上下文学习的经典入口,思想仍然影响现代 embedding。
误区 4:模型内部 embedding 就是 RAG embedding。
不是。前者是 token 输入表示,后者是整段文本语义检索表示。
误区 5:向量最相似的文档一定最有用。
相似不等于相关,更不等于能回答问题。检索常需要 rerank 和任务评估。
误区 6:Embedding 维度越高越好。
维度高可能表达力更强,也会增加存储、检索成本和过拟合风险。要看任务和模型。
十四、你应该记住的最小心智模型
Embedding 可以这样记:
text
token id 本身没有语义
embedding table 把 id 查成向量
训练目标让有用的向量关系逐渐形成
Transformer 进一步把静态 token embedding 变成上下文相关 hidden state
RAG embedding 把整段文本变成向量用于检索
核心区别:
text
模型内部 token embedding:服务模型计算
语义检索 embedding:服务相似度搜索
看到 embedding,不要只问"维度是多少",还要问:
text
它是为哪个目标训练的?
输入粒度是 token 还是文本段?
相似度用于什么任务?
是否经过领域适配?
总结
Embedding 是把离散符号变成连续向量的关键技术。one-hot 表示稀疏且没有语义距离,embedding table 通过训练学习每个 token 的稠密向量。Word2Vec 证明了词义可以从上下文中学习,CBOW 和 Skip-gram 分别用上下文预测中心词或用中心词预测上下文。Transformer 在 token embedding 基础上加入位置和多层上下文建模,让同一个词在不同语境中形成不同表示。
现代应用中的 embedding 还包括语义检索向量,用于 RAG、搜索、聚类和推荐。它和模型内部 token embedding 相关但不同:一个服务语言模型输入,一个服务文本相似度检索。
第一遍记住一句话:Embedding 的本质是把离散 token 或文本映射到向量空间,让模型可以用距离和方向学习语义关系。
大模型视角
后续你看 tokenizer、Transformer、RAG、向量数据库和 embedding 模型时,都会反复遇到本篇概念。大模型内部靠 token embedding 开始计算,外部知识系统靠语义 embedding 找资料。理解这两类 embedding 的区别,是理解现代 LLM 应用架构的基础。
下一篇
RNN 与 LSTM:序列建模的前 Transformer 时代 ------ Embedding 把 token 变成向量,接下来要处理顺序。下一篇看 Transformer 出现前,RNN 和 LSTM 如何用隐藏状态建模序列。