欢迎大家关注Rocky的知乎:Rocky Ding
《三年面试五年模拟》AIGC/LLM/AI Agent算法工程师/开发工程师求职面试秘籍独家资源:【三年面试五年模拟】WeThinkIn/AIGC-Interview-Book,欢迎大家Star~
Rocky最新撰写的10万字AI Agent(AI智能体)深入浅出全维度解析文章: 深入浅出完整解析AI Agent(AI智能体)的核心基础知识
AIGC/LLM/AI Agent算法岗/开发岗求职面试内推学习社群 (涵盖AIGC、LLM大模型、AI Agent、传统深度学习、自动驾驶、机器学习、计算机视觉、自然语言处理、强化学习、大数据挖掘、具身智能、元宇宙、AGI等AI行业最新面试干货经验与核心知识)欢迎大家加入:https://t.zsxq.com/33pJ0
码字不易,希望大家能多多点赞!
大家好,我是Rocky。
Rocky认为在2025年的下半年,AIGC图像创作/AI绘画领域迎来了"中场时刻"。
不管是最新发布的开源FLUX.2系列、Z-Image系列、Qwen-Image系列、GLM-Image、FLUX.1 Kontext,还是火爆全网的闭源GPT-Image系列、Nano Banana系列、Seedream(即梦)系列,这些"明星"AIGC图像创作大模型都将对AIGC图像创作算法产品、AIGC图像算法解决方案以及AIGC图像生成技术栈进行彻底的重构。
Rocky的核心判断是:AIGC图像创作领域已经进入"群雄逐鹿"的新阶段 ,不再是Stable Diffusion系列和FLUX系列两家独大,而是由GPT-Image、Nano Banana、Seedream(即梦)、FLUX.2系列、Z-image、Qwen-Image、GLM-Image等共同推动和繁荣。当前我们尚不能判断未来哪个大模型及其生态将主导整个领域的发展,亦或是持续维持着"群雄逐鹿"的局面,但我们唯一能确定的是,每个大模型都有其独特的技术特点与生态特点,值得我们深入学习与研究,从而总结跨周期的技术认知与技术本质。
AIGC图像创作/AI绘画领域迎来了"中场时刻",各大AIGC图像创作大模型"群雄逐鹿"
**同时,在长期的"群雄逐鹿"阶段特别考验围绕在这些核心AIGC图像创作大模型周围的辅助AIGC技术,跨周期性将成为对它们本质价值的首要评判标准。**随着核心AIGC图像创作大模型持续的架构升级与能力扩展,必然会导致大量(80%-90%)的辅助AIGC技术过时淘汰,转化为沉没成本,最终成为AIGC时代里的数字尘埃。
Rocky认为未来单纯的AIGC文生图大模型意义已经不太大了 。文本生成图像、图像编辑生成(增删改查)、风格迁移、身份保留生成(Identity-Preserving Generation)、多主体一致性生成(Multi-Subject Consistency)等功能将是未来AIGC图像创作大模型的必备,技术架构上会朝着统一的原生多模态大模型发展,这是AIGC时代的必然趋势。未来AIGC图像创作大模型的架构会聚焦于:
- 基于DiT-Transformer的扩散模型架构
- 基于Transformer的自回归模型 + 扩散模型组合架构
我们能够发现,在GPT-Image系列展示的生成图片例子中,也揭秘了其架构是自回归模型结合了扩散模型,很大概率是自回归生成的视觉特征,用一个扩散模型作为Decoder来解码,使得GPT-Image的图像生成做到了很高的质量。
与此同时,在AIGC时代的中场时刻,各路大厂也像传统深度学习时代那样,在观察了几年之后,开始大规模all in AIGC了。大厂旗下的庞大资金、算力集群、数据资源、科技工人们的持续投入,开始快速攫取AIGC时代的核心价值。
在大厂的持续投入和无情打击下,AIGC时代的的"明星"初创公司、大模型初创公司、传统公司里的大模型部门,在AIGC图像创作大模型的方向上开始变得越来越跟不上、越来越掉队了。
就如同传统深度学习时代那样,互联网大厂和安防领域大厂对所谓"AI X小龙"们的歼灭战。像GPT-Image系列、Nano Banana系列、Seedream即梦系列这些现象级的AIGC产品,其背后是数据、算力、人才密度以及强大资源投入构建的AIGC时代行业"战争机器"体系。
而AIGC"明星"初创公司、大模型初创公司、传统公司里的大模型部门们如果还是精打细算的让一群天真、死板和聪明的AIGC工程师日以继夜的奋战,花费无数个日夜去优化单一AIGC图像创作大模型的细节,去研究如何让AIGC图像创作大模型的美感更加细腻,尽可能调优每一个参数,像是匠人一般在低维度上持续做打磨"艺术品"的工作,这样的过程在AIGC"中场时刻"和AI Agent技术革新中将毫无价值。但大部分AIGC科技工人们缺乏对宏观战略与时代变迁的认知,他们天真的相信,只要把手里所谓的"艺术品"做到极致,就能赢得用户的尊重和市场。
但是大厂们推动的AIGC技术跨越式发展和AI Agent的深度革新,就像是从天而降的"高达",对"艺术品"工人进行从容的降维打击。
这时,能够识别哪些AIGC技术工具具备跨周期价值,哪些AIGC技术工具是未来的基石,就成为了AIGC时代最强的护城河能力。在这些火种和基石技术上,我们可以构建AIGC产品和AIGC算法解决方案,去持续探索AIGC的可能性。
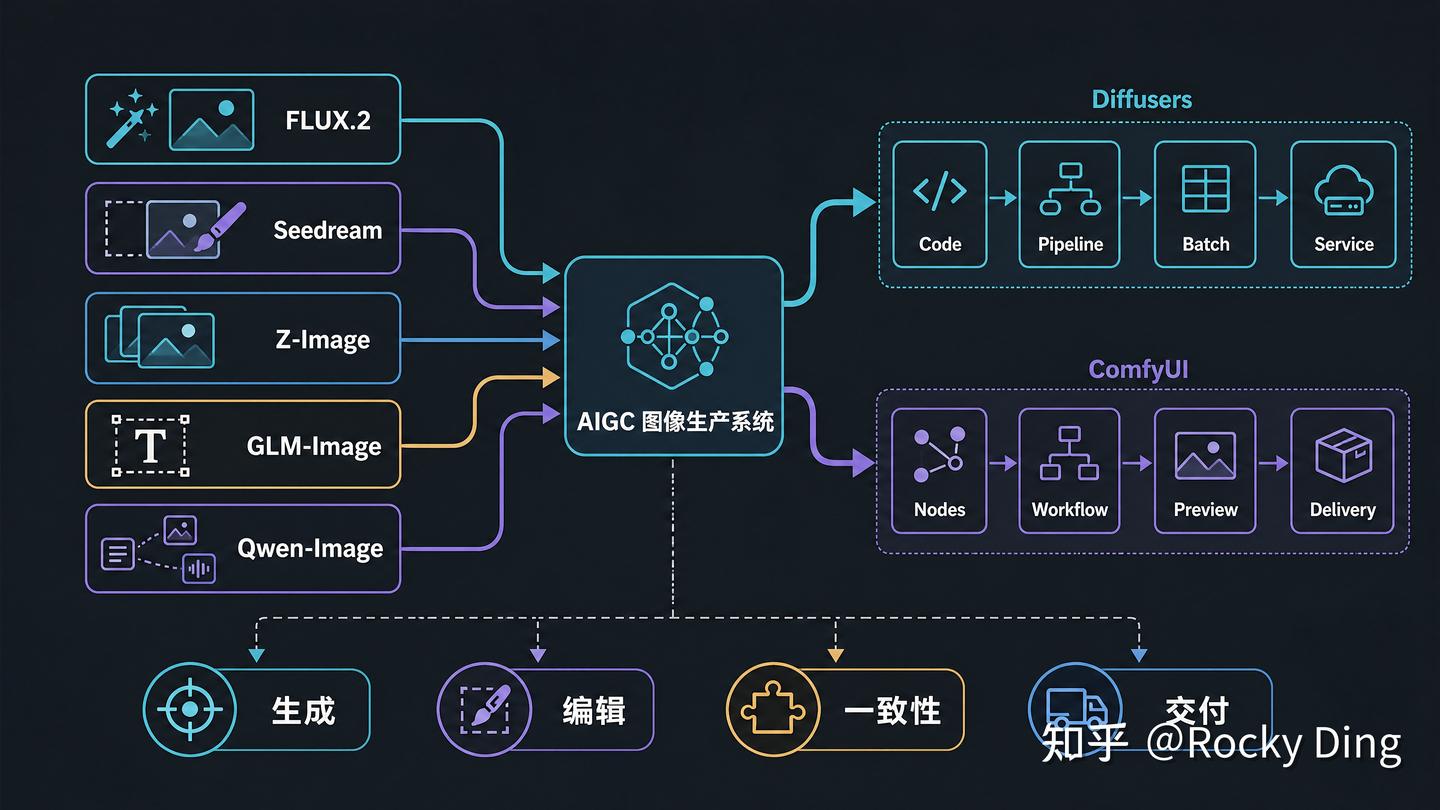
AIGC图像创作/AI绘画领域迎来了"中场时刻",各大AIGC图像创作大模型"群雄逐鹿"
因此,在本文中,Rocky将深入浅出完整讲解在"群雄逐鹿"阶段里那些具备跨周期价值的AIGC图像创作大模型,并深入浅出详细讲解每个模型的核心基础知识,希望能给大家带来帮助。
1. FLUX.2、Seedream、Z-image、Qwen-Image和GLM-Image资源整合汇总
- FLUX.2项目地址:https://github.com/black-forest-labs/flux2
- FLUX.2官方博客:https://bfl.ai/research/representation-comparison
- FLUX.2模型地址:https://huggingface.co/collections/black-forest-labs/flux2
- Seedream 2.0论文地址:https://arxiv.org/html/2503.07703v1
- Seedream 3.0论文地址:https://arxiv.org/abs/2504.11346
- Seedream 4.0论文地址:https://arxiv.org/abs/2509.20427
- Z-Image项目地址:https://github.com/Tongyi-MAI/Z-Image
- Z-Image论文地址:https://arxiv.org/abs/2511.22699
- GLM-Image项目地址:https://github.com/zai-org/GLM-Image
- GLM-Image模型地址:https://huggingface.co/zai-org/GLM-Image
- Qwen-Image论文地址:Qwen-Image Technical Report
- Qwen-Image项目地址:Qwen-Image 官方仓库
- Qwen-Image-2.1项目地址:wen-Image-2.1 官方仓库
- Qwen-Image-2.1官方博客:https://qwen.ai/blog?id=qwen-image-2.1
2. 深入浅出完整讲解FLUX.2核心基础知识
时隔一年多,Black Forest Labs终于发布最新的图像生成大模型FLUX.2!
2.1 FLUX.2系列模型初识
**FLUX.2系列是基于Latent Flow Macthing架构的Transformer大模型,是一个 图像生成与编辑能力融合的统一架构。**在FLUX.1系列基础上,对VAE、DiT backbone以及Text Encoder三大架构都做了优化改进。FLUX.2原生支持文生图、图像编辑和多图像参考生成,并且从头开始进行预训练(pre-training done from scratch),是FLUX系列正统的第二代AIGC图像生成编辑大模型。
FLUX.2能够生成高质量图像,同时在多个参考图像中保持风格和特征的一致性,遵循结构化提示词,读写复杂文本,并能可靠地处理光照、布局和Logo等特征。同时FLUX.2可以编辑高达400万(4MP)像素的图像,并且保留细节和连贯性。
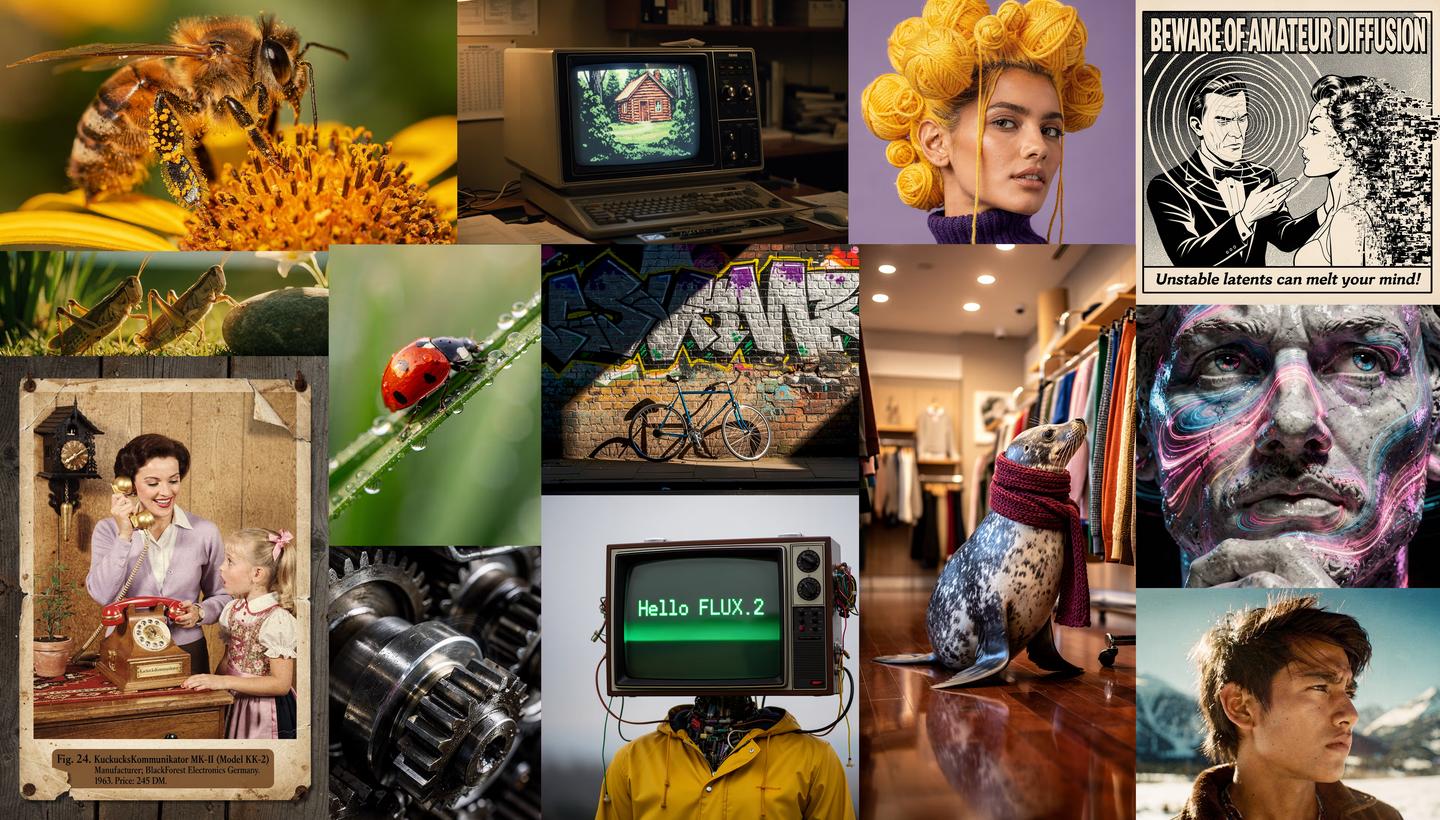
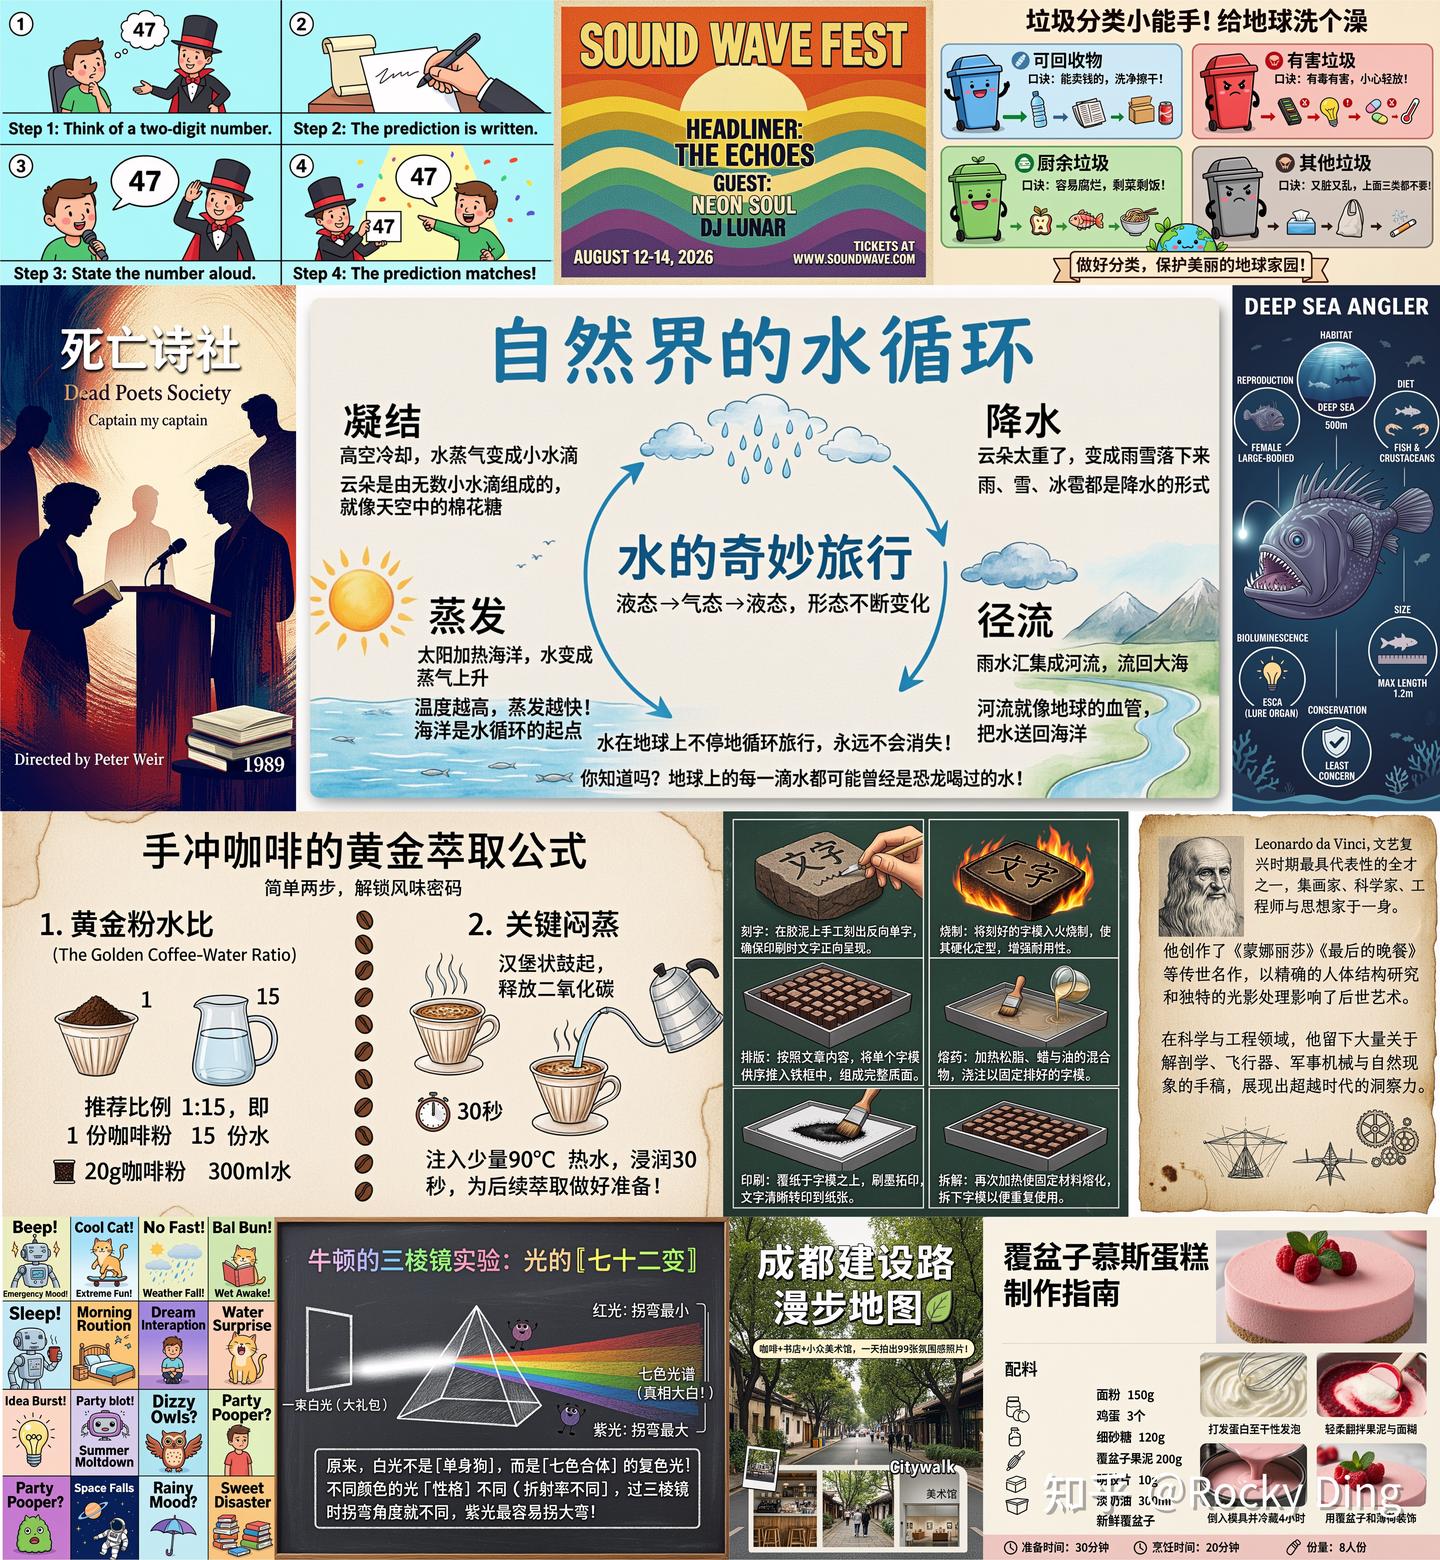
FLUX.2图像生成效果示例
目前,FLUX.2系列共推出四款模型,分别是 FLUX.2 pro、FLUX.2 flex、FLUX.2 dev 以及 FLUX.2 klein 。作为 AIGC 图像生成领域的"开源领袖",Black Forest Labs 已开源了 FLUX.2 dev 和 FLUX.2 klein,同时还发布了一款全新的 VAE 模型------FLUX.2-VAE。
- FLUX.2 pro :具备媲美顶尖闭源模型的图像质量,在文本遵循能力和视觉保真度方面表现卓越,同时生成速度更快、成本更低,实现了质量与效率的出色平衡 。该模型现已登陆BFL Playground、BFL API等官方的合作伙伴平台,支持多张参考图像的生成与编辑(输入图像总像素最高达 900 万)。通过API调用最多可使用8张参考图,官方Playground则最多支持 10 张。
- FLUX.2 flex :提供对部分模型参数(如步数和引导比例)的灵活控制,使开发者能够全面调节生成质量、响应速度与输出流畅度 。该模型在文本渲染与精细细节表现上尤为出色。用户现可通过 bfl.ai/play、BFL API 及合作伙伴渠道获取,最多支持 10 张参考图像(输入图像总像素最高达 1400 万)。
- FLUX.2 dev :这是一款基于FLUX.2基础架构、拥有32B参数的开源模型,也是当前性能强大的开源AIGC图像创作大模型 。其权重已在 Hugging Face 发布,并可通过 FAL、Replicate、Runware、Verda、TogetherAI、Cloudflare 及 DeepInfra 等平台的 API 端点调用。大家可在单块 RTX 4090 显卡上使用由 NVIDIA 与 ComfyUI 合作优化的 fp8 参考实现进行本地推理运行。如需商业授权,请访问 BFL 官方网站获取更多信息。
- FLUX.2 klein :基于 FLUX.2 基础模型进行轻量化得到的开源模型,有4B和9B两个版本 ,采用 Apache 2.0 协议。与同等规模、从零训练的模型相比,该版本功能更强、对开发者更友好,并保留了原教师模型的诸多核心能力。目前该模型已经正式发布。
- FLUX.2-VAE :一种新版本的变分自编码器(VAE),用于隐空间表征,在可学习性、生成质量与压缩效率之间实现了更优的平衡 。该模型是所有FLUX.2系列模型的基础组件,目前已于 Hugging Face 上发布,同样遵循 Apache 2.0 许可证。
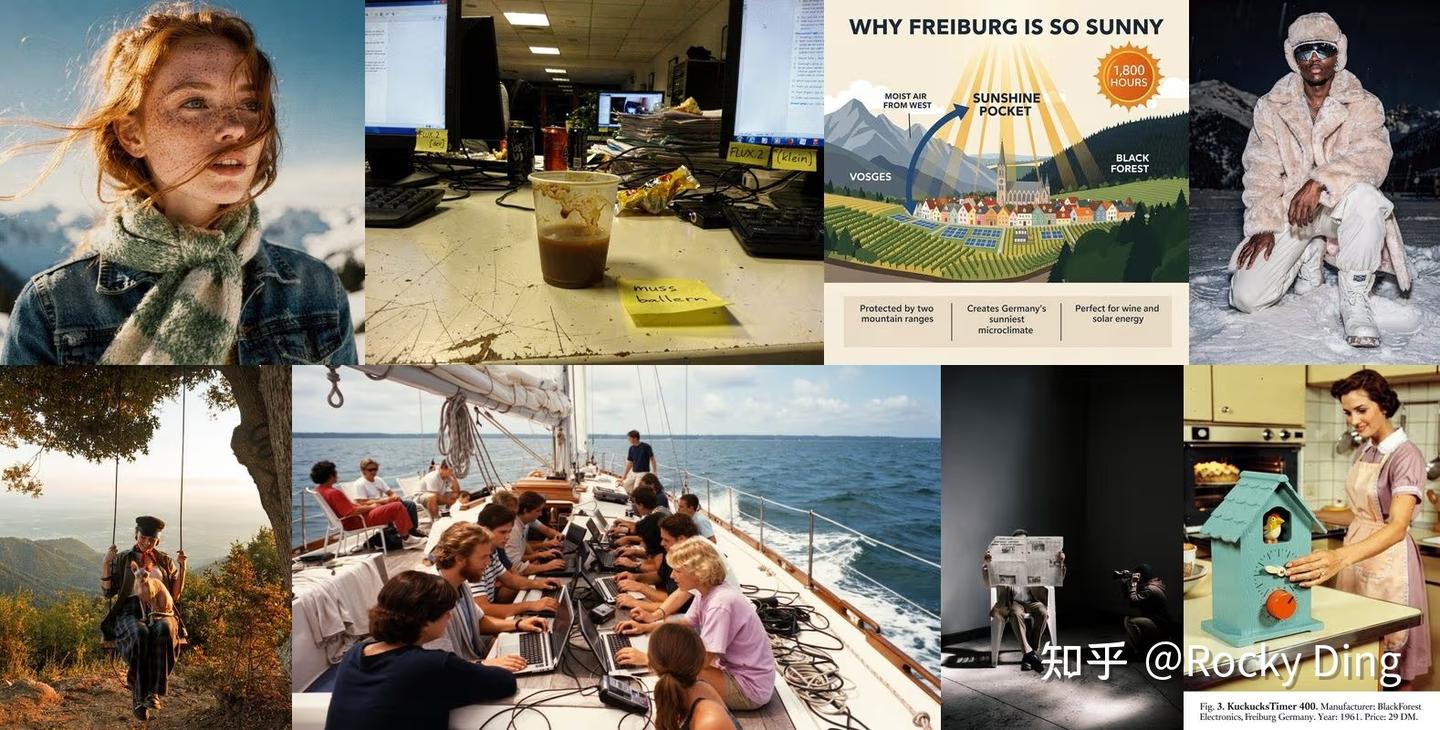
关于本次 FLUX.2系列更新的新特性与核心优化亮点,具体如下:
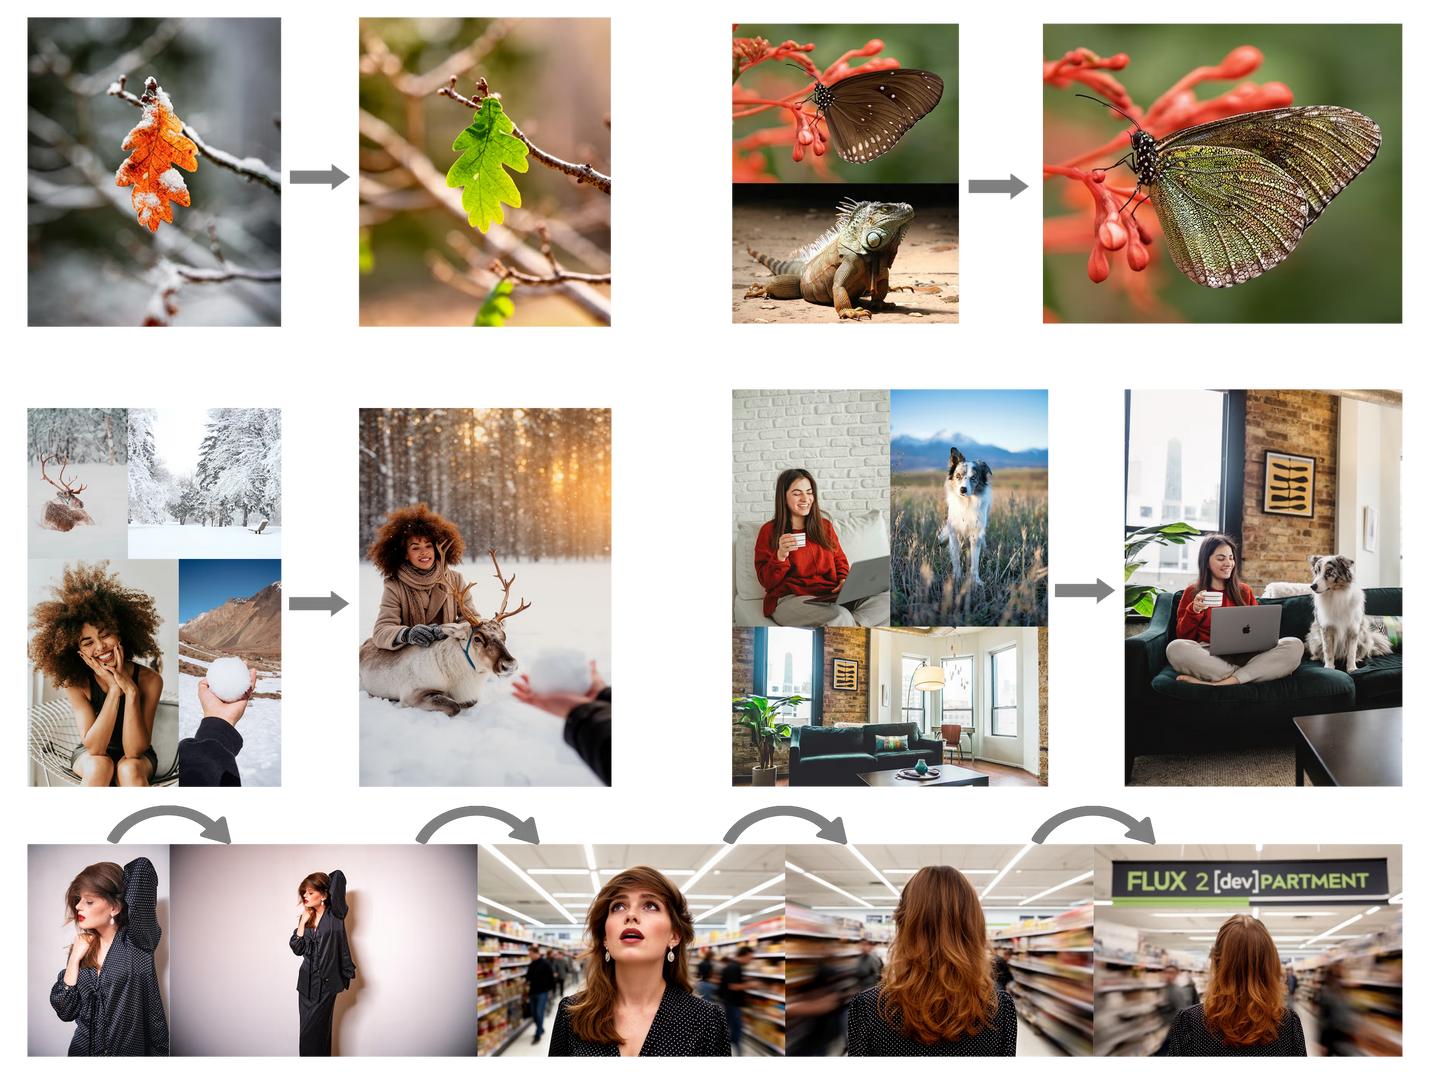
- 支持参考图生成:最多可输入10张参考图像,在角色、产品及风格一致性上达到当前最佳水平。支持显式图像索引,用户可在提示词中通过编号引用特定图像,例如"将图 2 中的衣服穿在图 1 的角色身上"。
- 图像细节与照片级真实感:生成图像具备更丰富的细节、更清晰的纹理与更自然的光照表现,适用于产品摄影、可视化及类似专业摄影场景。
- 文本渲染能力提升:可稳定生成复杂排版、信息图表、表情包及含细小文字的 UI 界面模型,支持中文输入与中文文字渲染,已具备生产环境可用性。
- 增强的提示词遵循:能够更准确地理解并执行复杂的结构化指令(支持 JSON 格式),包括多部分提示词及构图约束。
- 丰富的世界知识:模型在现实世界知识、光照逻辑与空间关系方面表现更加合理,可生成场景更连贯、行为更符合预期的图像。
- 更高分辨率与灵活的宽高比:支持最高 4MP(例如 1920×1920)的图像编辑分辨率,并允许灵活的输入与输出比例。
- 支持十六进制颜色描述 :可通过如
#DDC57A的十六进制代码精准描述对象颜色,在色彩控制方面表现优异。
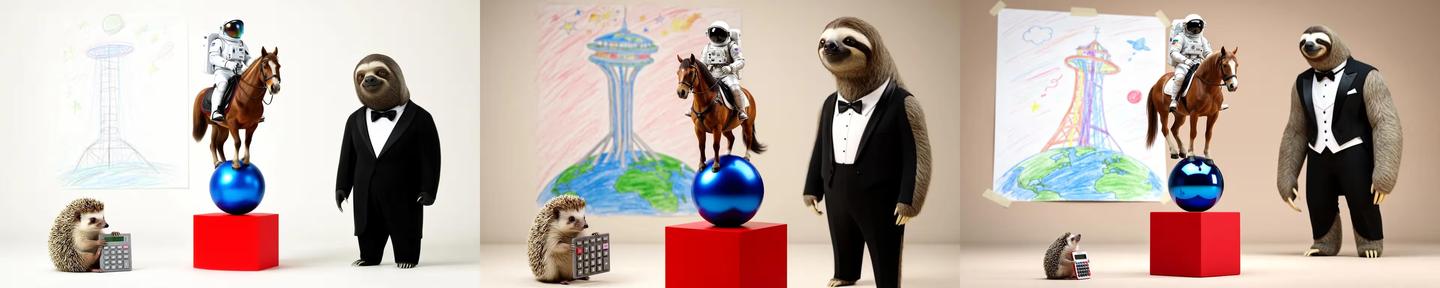
此外,FLUX.2 flex 特别提供了"步长"参数,用户可在排版精度与生成延迟之间进行权衡,也可通过调整步长控制图像细节层次。以下为不同步长效果示意(从左至右):6 步、20 步、50 步。
2.2 FLUX.2 VAE模型架构
FLUX.2在官方技术报告中首次明确指出了Latent Diffusion Model(LDM)的潜空间三元权衡难题(潜空间特征设计的可学习性-重建质量-压缩率三元固有冲突)是FLUX.2之所以被研发的核心出发点:
- 可学习性(空间语义维度) :生成模型(即DiT)在潜在特征空间(Latent特征空间)中学习生成新样本的难易程度。若潜空间具备良好的语义化特征(过滤掉所有与高层语义无关的细节噪声,只保留「物体类别、空间布局、姿态、风格、语义关系」等有明确意义的结构化特征),生成任务将更易建模,因为模型仅需捕捉高层语义关系,而无需重构低层感知细节。然而,这种设计往往会牺牲图像重建质量,并降低压缩效率。
- 重建质量(感知失真维度):解码器从潜空间中还原原始图像的保真度。过度压缩会导致感知失真、细粒度细节丢失;基于感知损失和对抗损失训练的VAE能够维持重建质量,但压缩率提升必然带来保真度下降。更关键的是:若VAE只优先保证重建保真度,却没有对潜在空间语义特征施加语义正则化约束,其生成的潜在空间会存在高频噪声或不规则结构,让生成模型极难学习有效的高质量分布。
- 压缩率(维度):潜在空间维度的降低幅度。更高的压缩率能提升建模计算效率,但同时会削弱重建保真度,也会损害生成模型拟合完整数据分布的能力。
**这三个目标本质上相互制约:**提升压缩率通常会降低重建质量、损害可学习性;追求极致的重建保真度需要降低压缩率;而为提升语义层面的可学习性,又可能不得不放弃部分底层感知细节。
因此,理想优雅的潜在空间设计,核心是剔除人眼不可感知的信息,同时完整保留生成模型能高效学习的语义结构------这正是FLUX.2 VAE的核心设计目标 。在可学习性、重建质量与压缩率三者间实现更优的平衡。
FLUX.2先系统性对比了4类主流VAE自编码器的设计与缺陷,为FLUX.2 VAE的创新提供了基准:
| VAE(自编码器) | 核心设计思路 | 核心优势 | 核心缺陷 |
|---|---|---|---|
| SD VAE | 经典潜扩散VAE,基于感知损失+对抗损失训练,信息瓶颈压缩率高 | 压缩率高、推理速度快 | 重建保真度差,潜空间可学习性一般 |
| FLUX.1 VAE | 相比SD VAE,潜空间维度扩大4倍,放宽信息瓶颈、降低正则化权重 | 重建保真度大幅提升,满足图像编辑需求 | 无显式语义正则化,潜空间存在不规则结构,可学习性显著下降 |
| RAE(表征自编码器) | 直接用冻结的DINOv2视觉大模型作为编码器,仅训练解码器 | 可学习性极致优秀,生成模型训练难度极低 | 无像素级重建目标约束,重建保真度极差,无法用于图像编辑场景 |
| FLUX.2 AE | 维度扩容+语义正则化双优化,为流匹配框架深度定制 | 重建保真度全面超越所有基线,同时可学习性接近RAE | 压缩率低于SD/FLUX.1,推理算力开销略有提升 |
相较于FLUX.1 VAE,FLUX.2 VAE在保持重建质量的同时,显著提升了可学习性。具体改进包括:在保持空间压缩率为8倍的前提下,进一步增加潜在特征的维度(SD-VAE为4维,FLUX.1 VAE为16维,FLUX.2 VAE提升至32维)。潜在维度的增加并未改变DiT处理的token数量,因此不会带来额外计算负担。此外,在训练过程中引入了语义正则化机制,进一步优化了潜在空间的语义组织结构与可学习性。
FLUX.2接着再使用2×2 patching把潜特征图里 2×2 的空间邻域特征,展平合并成一个 Transformer 的输入 token,因此单 token 的维度 = 潜空间通道数 ×patch 的像素总数:
- SD VAE:每个token输出16个通道
- FLUX.1 VAE:每个token输出64个通道(SD的4倍)
- FLUX.2 AE:每个token输出128个通道(SD的8倍)
- RAE:每个token输出768个通道
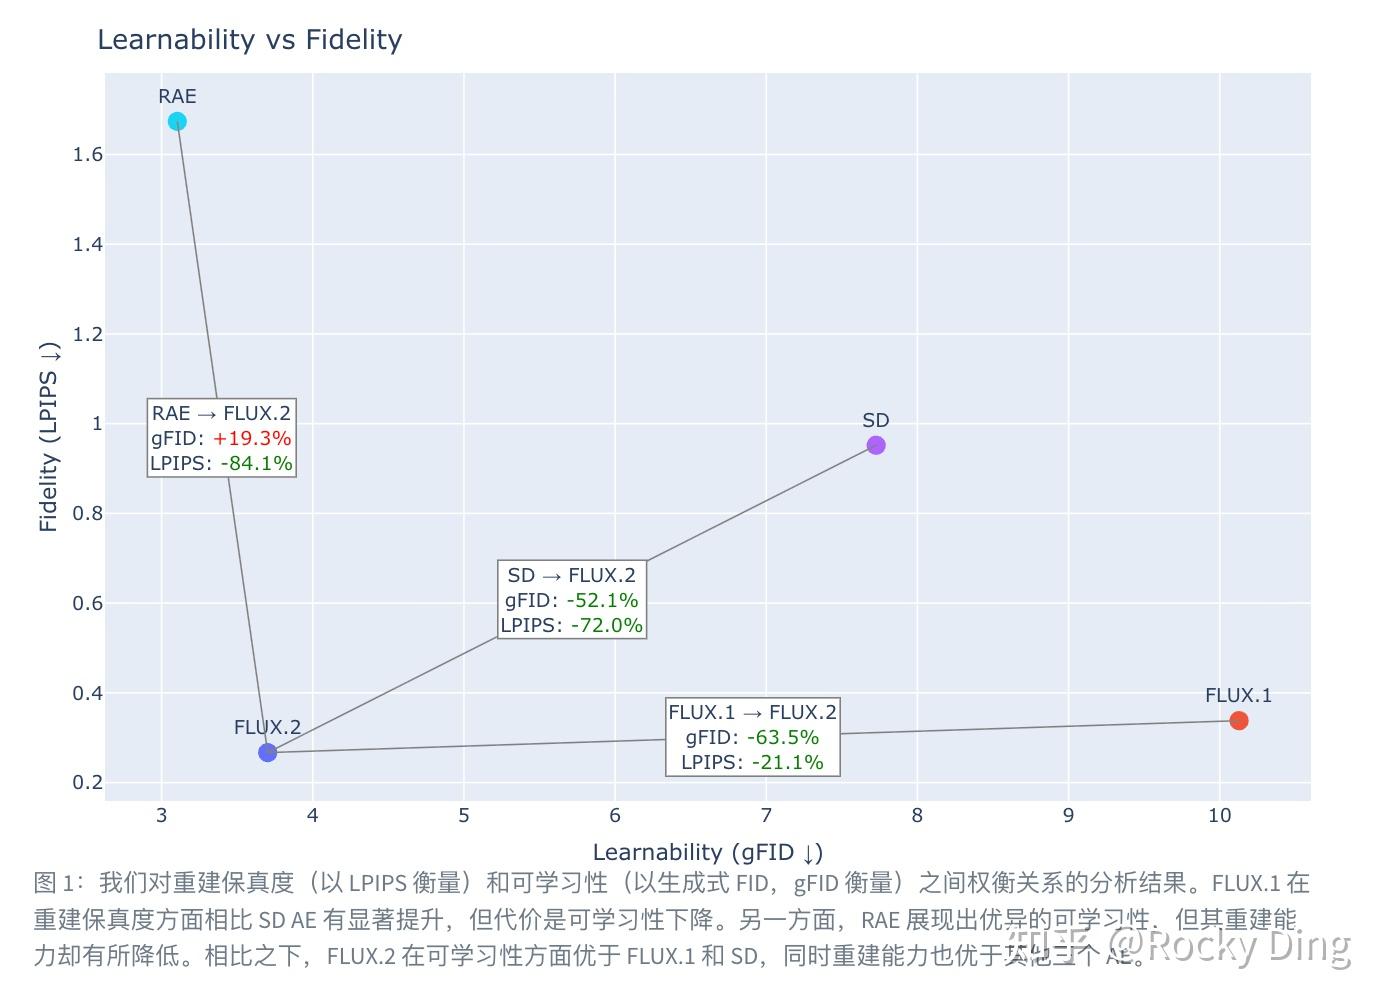
FLUX.2 VAE在损失函数部分的核心创新是在传统VAE的像素回归、感知损失、对抗损失之外,引入了面向生成的语义表征对齐(REPA)正则化。
- REPA技术核心:将VAE的潜表征与DINOv2等视觉基础模型的高层语义特征对齐,让潜空间不仅包含人眼可感知的细节信息,还具备结构化、易学习的高层语义信息。
- FLUX.2实验验证:REPA对齐对所有自编码器的性能都有一致性提升,即便是可学习性极强的RAE,也能通过REPA获得进一步优化。
- 痛点解决:FLUX.1 VAE仅优化了重建保真度,无显式语义正则化,导致潜空间结构不规则、难学习;FLUX.2 AE通过REPA正则化,让潜空间同时具备高保真重建能力和优秀的可学习性。
FLUX.2实验中通过4项AIGC行业通用指标,全面验证了FLUX.2 VAE的重建能力(数值越低性能越好,SSIM/PSNR除外):
| 模型 | LPIPS(感知相似度) | SSIM(结构相似性) | PSNR(峰值信噪比) | rFID(重建FID) |
|---|---|---|---|---|
| RAE | 1.6737 ± 0.0057 | 0.4962 ± 0.0026 | 18.8272 ± 0.0429 | 0.6107 |
| SD VAE | 0.9519 ± 0.0054 | 0.6976 ± 0.0121 | 25.0520 ± 0.0673 | 0.6451 |
| FLUX.1 VAE | 0.3380 ± 0.0026 | 0.8893 ± 0.0058 | 31.1312 ± 0.0745 | 0.1761 |
| FLUX.2 AE | 0.2668 ± 0.0017 | 0.9038 ± 0.0049 | 31.4632 ± 0.0633 | 0.1124 |
FLUX.2 AE在所有重建指标上均实现了AIGC图像生成领域最优:LPIPS比FLUX.1降低21.1%,比SD VAE降低72.0%,比RAE降低84.1%;SSIM、PSNR均为最高,rFID也是最低,重建保真度全面超越前代与竞品。RAE仅无参考指标rFID尚可,核心参考型指标全面拉胯,完全无法满足图像编辑等需要像素级对齐的场景;而FLUX.2 AE同时实现了最低的rFID和最优的像素级重建能力。
FLUX.2实验中用gFID(生成FID,数值越低=可学习性越好) 衡量可学习性,用LPIPS衡量重建保真度,核心对比结果如下:
| 模型 | gFID | LPIPS | 相对FLUX.2的性能变化 |
|---|---|---|---|
| FLUX.2 | 3.7017 | 0.2668 | 基准 |
| FLUX.1 | 10.1279 | 0.3380 | gFID+63.5%,LPIPS+21.1% |
| SD VAE | 7.7271 | 0.9519 | gFID+52.1%,LPIPS+72.0% |
| RAE | 3.1040 | 1.6737 | gFID-19.3%,LPIPS+84.1% |
从上表中我们可以看出,FLUX.1相比SD VAE提升了重建保真度,但代价是可学习性显著恶化;RAE实现了极致的可学习性,但重建保真度完全不可用。**FLUX.2实现了双向突破,**相比FLUX.1和SD VAE,可学习性大幅提升(gFID分别降低63.5%、52.1%);同时相比所有3个基线模型,重建保真度均实现了显著提升。同时仅RAE的gFID略低于FLUX.2,但这是以重建保真度暴跌84.1%为代价,在实际工业场景中无落地价值。
2.3 FLUX.2 Text Encoder模型架构
在FLUX.2的Text Encoder部分,文本编码器不再使用T5和CLIP,而是采用了**Mistral-3-24B视觉语言大模型(VLM大模型,Mistral-Small-3.2-24B-Instruct-2506),**作为文本条件与视觉条件的统一编码器。视觉语言大模型提供真实世界知识和上下文理解,增强了对世界、材质、空间关系和构图的建模能力。同时使用单个文本编码器极大地简化了Prompt Embeddings的计算过程。
核心作用是将用户的文本提示词、单/多张参考图像等条件信息,编码为深层语义特征,为下游DiT Backbone提供精准的条件引导,实现文本生成、参考图编辑、风格迁移等多任务的统一支持。
2.4 FLUX.2 Backbone模型架构
**在FLUX.2的DiT Backbone部分,**沿用了与FLUX.1相同的MM-DiT(双流模块) + 并行DiT(单流模块)相结合的整体架构。简言之,MM-DiT模块首先在独立处理图像潜变量和条件文本,仅在注意力计算环节将二者融合,因此被称为"双流"块。随后的并行DiT模块则对拼接后的图像与文本流进行操作,可视为"单流"块。
从FLUX.1到FLUX.2,DiT架构的核心改进如下:
- 对DiT部分进行了Scaling,参数量从FLUX.1的12B增加32B。
- 时间与引导信息(Timestep and Guidance Scale,以 AdaLayerNorm-Zero 调制参数的形式)分别在所有双流块和所有单流块间共享,而非如FLUX.1中为每个块单独设置调制参数,从而降低整体参数量。
- 模型中所有层均不再使用偏置参数。具体而言,两种变换器块中的注意力子块与前馈子块在其任何层中均未使用偏置参数。
- 在FLUX.1中,单流变换器块将注意力输出投影与前馈网络输出投影进行了融合。FLUX.2的单流块进一步将注意力QKV投影与前馈网络的输入投影相融合,从而实现了完全并行的Transformer块结构:
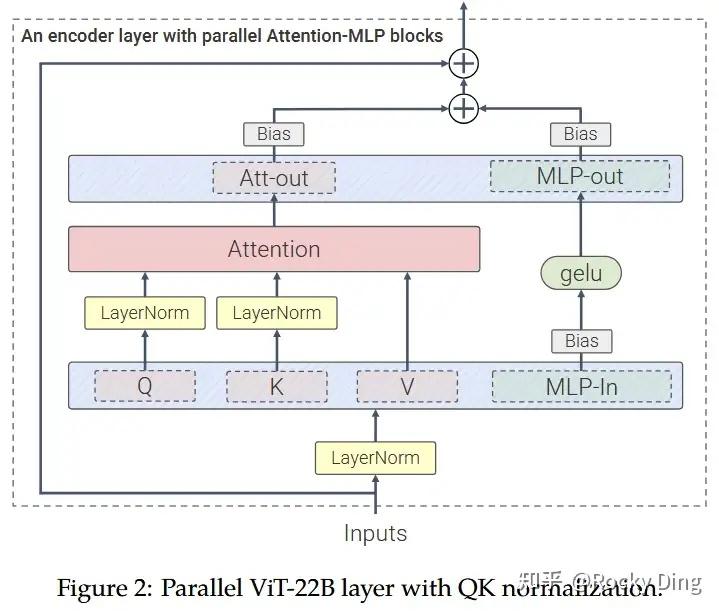
需要注意的是,与上图中的 ViT-22B 块相比,FLUX.2 采用了SwiGLU作为多层感知机的激活函数,而非使用GELU激活函数(同时也不使用偏置参数)。SwiGLU激活函数作为当前大模型领域广泛验证的最优激活函数之一,能够替代传统的ReLU/GELU,大幅提升Transformer的特征拟合能力与训练稳定性。
FLUX.2 中单流模块的比例显著提高(双流块与单流块的数量比为 8:48,而 FLUX.1 为 19:38)。这意味着单流模块在 DiT 参数中所占比例更大:FLUX.1dev-12B 约有 54% 的参数位于双流块中,而 FLUX.2dev-32B 仅有约 24% 的参数在双流模块内(约 73% 的参数集中在单流模块中)。
最后,FLUX.2 在位置编码设计上也进行了调整。FLUX.1 采用 3D RoPE,其中前两维分别编码图像的宽(w)和高(h),第三维为时间维度 t,在生成时固定为 0;而在 FLUX.1 Kontext 版本中,该 t 值对于输入条件图像设为 1,以区分目标图像与条件图像。
FLUX.2 则升级为 4D RoPE 编码:第一维为 t,用于区分目标图像与条件图像------目标图像(对应噪声潜变量 token)的 t 设为 0,而条件图像的 t 则以 10 为间隔依次递增(如 10、20......);第二维和第三维仍分别对应图像宽高(w 和 h);第四维为 l,专门用于编码文本 token 的序列位置,对于图像潜变量则固定为 0。因此,新增的第四维主要作用是为文本 token 赋予位置信息,而此前 FLUX.1 中所有文本 token 的位置编码均固定为 0,并未区分其顺序。
2.5 FLUX.2的数学原理
【流匹配训练的时间步优化技术】
FLUX系列基于条件流匹配(CFM) 框架训练,而非传统扩散模型,文档针对流匹配的训练动态,做了系统性的时间步优化,这也是FLUX.2训练高效性的核心保障。
FLUX.2中定义的CFM损失函数如下:
L CFM ( θ ) = E t ∼ p , u ∼ p data , ϵ ∼ N ∥ v θ ( ( 1 − t ) E ( u ) + t ϵ ; t ) − ( ϵ − E ( u ) ) ∥ 2 \mathcal{L}{\text{CFM}}(\theta) = \mathbb{E}{t \sim p, u \sim p_{\text{data}}, \epsilon \sim \mathcal{N}} \|v_\theta\left( (1-t)E(u) + t\epsilon; t \right) - \left( \epsilon - E(u) \right)\|_2 LCFM(θ)=Et∼p,u∼pdata,ϵ∼N∥vθ((1−t)E(u)+tϵ;t)−(ϵ−E(u))∥2
- 其中 E E E是冻结的图像编码器(FLUX.2 VAE), u u u是训练图像, t t t是时间步, ϵ \epsilon ϵ是标准正态噪声;
- 时间步 t t t决定了输入的信噪比,其采样分布 p p p会显著影响训练动态和最终性能,而最优 p p p与潜空间的维度、尺度、频谱特性强相关。
【时间步偏移函数与采样分布优化】
FLUX.2提出了通用的时间步偏移函数,适配不同维度的潜空间:
s ( α , ⋅ ) : t ↦ α t 1 + ( α − 1 ) t s(\alpha, \cdot): t \mapsto \frac{\alpha t}{1 + (\alpha-1)t} s(α,⋅):t↦1+(α−1)tαt
该函数的核心作用是在不同潜空间维度下,保持样本估计的不确定性一致,实现训练的稳定性。FLUX.2测试了 α ∈ { 1.00 , 1.78 , 2.95 , 4.63 , 6.93 } \alpha \in \{1.00, 1.78, 2.95, 4.63, 6.93\} α∈{1.00,1.78,2.95,4.63,6.93}的偏移参数,同时验证了3种时间步采样分布:偏移均匀分布、偏移对数正态分布、平台型对数正态分布,得到了如下的核心实验结论:
- 最优分布选择:对数正态(ln)和平台型对数正态(pln)分布始终优于偏移均匀分布,是所有模型的最优选择;
- 最优训练偏移参数:与潜空间维度正相关,SD VAE最优为1.00,FLUX.1为1.78,FLUX.2为4.63,RAE为6.93;
- 最优采样偏移参数:所有模型的最优采样偏移均略高于训练偏移,FLUX.2和RAE的最优值均为6.93;
- 参数敏感性:训练偏移参数对性能影响最大,FLUX.1最优与最差配置性能差距达86.42%,FLUX.2达73.3%;采样偏移的影响相对更小;
- REPA的影响:REPA对齐不会改变大部分模型的最优偏移参数,仅FLUX.1加入REPA后,最优训练偏移从1.78降至1.00,证明REPA能进一步降低潜空间的学习难度。
3. 深入浅出完整讲解Seedream核心基础知识
AIGC时代元年至今,虽然AIGC图像创作领域有Stable Diffusion、Midjourney、FLUX等现象级的大模型问世。但长期以来,国内AIGC图像大模型始终面临着三座大山:**原生中英双语能力的失衡、中文文化与语义理解的缺失、文本渲染与商业落地能力的短板。**更不用说在全球AIGC图像大模型在架构、训练范式、推理效率上依旧存在很大的优化迭代空间。
面对这些问题,字节跳动Seed团队推出的Seedream系列大模型,从2025年3月的2.0版本,到4月的3.0版本,再到9月的4.0版本,用短短半年时间完成了三次技术跃迁,直面"三座大山"持续优化,走出了一条"双语原生-能力全维升级-多模态范式革新"的整体技术路线。
在本章节中,Rocky会从Seedream系列模型的数据处理技术、模型架构设计、训练全链路优化、推理加速技术、核心能力迭代五大核心维度,完整拆解每个版本的创新点和全链路迭代优化逻辑。
Seedream系列发展至今,已经形成了一个基于扩散DiT-Transformer架构 的高性能AIGC多模态图像创作大模型系统,Rocky认为其核心是基于Seedream大模型 + 前处理模块 + 后处理模块的AIGC系统级产品,它具备文本到图像生成、图像编辑和多图像参考创作、深度思考创作等原生生成编辑能力。
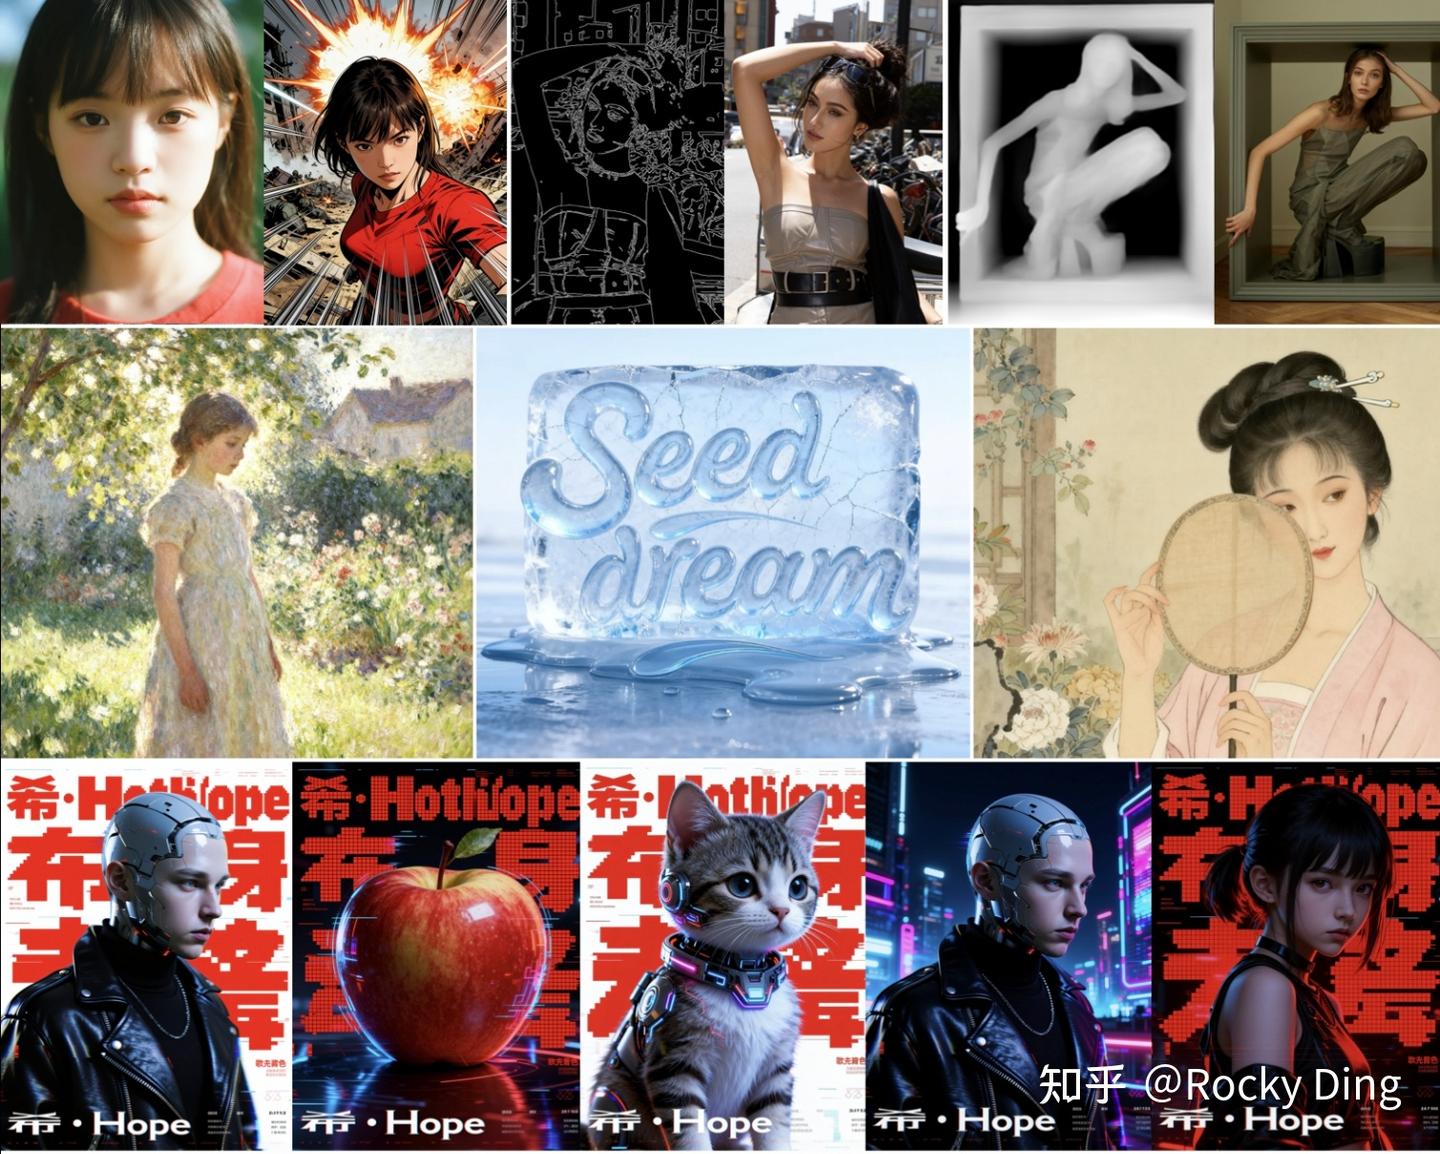
3.1 Seedream(即梦)系列的模型架构与技术原理
Seedream 2.0是整个系列的奠基之作,发布于2025年3月,它的核心目标非常明确:解决当时主流AIGC图像大模型(FLUX、SD3.5、Midjourney v6.1等)的三大行业级痛点,打造一款真正原生支持中英双语的AIGC图像大模型:
- 模型偏科严重:主流模型普遍存在"长板突出、短板致命"的问题,比如Midjourney极致侧重美学表现,却牺牲了prompt跟随能力和结构正确性;Ideogram文本渲染能力强,但在中式美学和复杂场景生成上存在明显短板。
- 多语言文本渲染能力缺失:几乎所有头部AIGC大模型都只针对英文做了文本渲染优化,对中文这种象形文字的渲染能力极差,长文本、复杂汉字、多段落排版更是重灾区,无法满足海报、设计等商业场景的核心需求。
- 中国文化特性理解不足:海外模型对中国传统文化、中式美学、地域特色元素的语义理解存在根本性缺失,无法精准生成符合中国人审美的、文化内涵准确的图像内容。
基于这三大痛点,Seedream 2.0从数据、架构、训练三大底层环节做了全链路的原创设计,最终实现了中英双语场景下的SOTA表现,也为后续3.0、4.0的迭代打下了坚实的技术底座。
当然的,在本章节中,我们首先对Seedream系列的模型架构展开讲解。关于数据系统和训练策略,Rocky将在后续的章节中娓娓道来。
我们从Seedream 2.0开始。Seedream 2.0的基础架构以MMDiT(Multi-Modal Diffusion Transformer)为主体,核心创新在于自研双语LLM文本编码器、Glyph-Aligned ByT5字符级文本编码器、Scaling RoPE位置编码三大模块,从底层解决了双语理解、文本渲染、分辨率泛化三大核心问题。Seedream 2.0的推理生成流程遵循扩散模型的经典逻辑,但同时做了深度的定制化优化:
- 输入图像通过自研VAE编码到隐空间,经过patchify处理后转化为图像token;
- 输入的文本prompt分别通过双语LLM文本编码器 和Glyph-Aligned ByT5编码器处理,生成融合语义与字形特征的文本token;
- 图像token与文本token拼接后,输入MMDiT Transformer块做融合处理;
- MMDiT块采用单自注意力层同时处理图像和文本token,针对图文两种模态设计了独立的MLP,通过自适应层归一化(AdaLN)对每个注意力层和MLP层做调制;
- 训练过程中采用QK-Norm提升训练稳定性,通过FSDP(Fully Sharded Data Parallel)实现大规模分布式训练。
紧接着,在Seedream 2.0的基础上,官方通过全面的评测,发现了Seedream 2.0仍存在的四大核心瓶颈:
- 复杂prompt的对齐能力仍有不足,尤其是数字精度、多物体空间关系的描述;
- 细粒度排版生成能力有限,小字号文本、多行长文本的排版效果仍有提升空间;
- 视觉美学与保真度仍有短板,电影级场景、人像质感的表现仍有优化空间;
- 原生输出分辨率受限,依赖后处理超分模块,无法原生生成高分辨率图像。
基于这些痛点,Seed团队在2025年4月发布了Seedream 3.0,在Seedream 2.0的技术架构上,实现了数据、架构、训练、加速四大维度的全链路升级,不仅原生支持2K分辨率输出,更在Artificial Analysis竞技场以1158的ELO得分登顶全球第一,超越了同期的GPT-4o、Midjourney v6.1等所有头部AIGC大模型。
技术的边界总是在不断被推动,Seedream 3.0已经实现了文生图能力的全球领跑,但AIGC图像领域仍存在一个根本性的架构瓶颈:文生图、图像编辑、可控生成等任务,普遍采用分治的架构设计,需要多个专用模型配合完成,无法实现端到端(End-To-End)的原生统一生成。比如AIGC的经典方案中,文生图用AIGC基础大模型,编辑用InstructPix2Pix类模型,可控生成用ControlNet系列模型,特征保持使用LoRA系列模型,不仅整个Pipeline流程复杂,更无法实现多任务能力的相互增益。
因此在2025年9月发布的Seedream 4.0,核心目标就是打破这一瓶颈,将文生图、图像编辑、多图合成三大核心能力,统一到单一模型架构中,从单一的文生图模型,升级为统一多模态图像生成系统,同时原生支持4K分辨率,推理速度比3.0再提升10倍以上,登顶Artificial Analysis文生图、图像编辑双榜单全球第一。
我们了解了Seedream系列大模型的发展历程,接下来Rocky就带着大家详细讲解Seedream系列模型一路走来的核心模块,包含PE(Prompt Engineering)模块、VAE(Variational Auto-Encoder,变分自编码器)模块、Text Encoder模块、DiT-Transformer(Base Model)模块以及Refiner模块,如下图所示。Rocky在本章节中将按照图中的顺序详细讲解每个模块的核心基础知识。
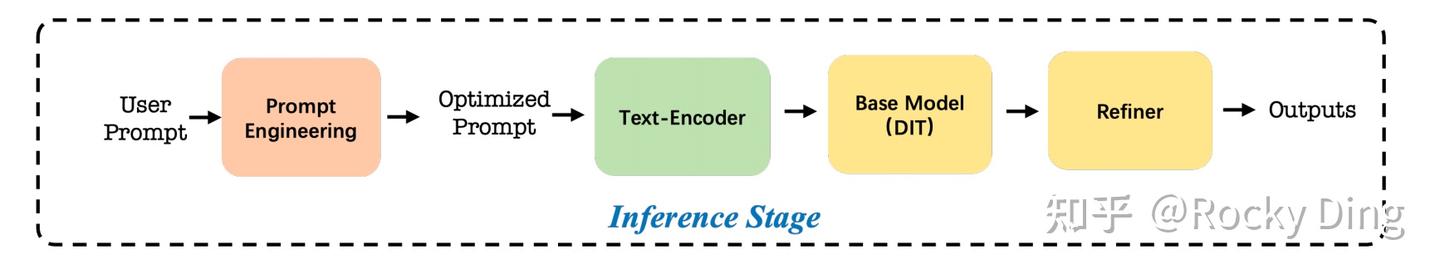
Seedream(即梦)系列模型的整体架构
【Seedream的Prompt Engineering模块】
Prompt Engineering(PE)模块是整个Seedream系列模型架构中的前置预处理模块,并不是Seedream系列模型推理必须的,但是作为能够"热插拔"的模块,在Seedream系列产品级的视角下,是提升整体效果极其重要的一环。
在AIGC图像创作产品侧,用户通常输入的文本提示词非常简单整洁(极简的大白话如"一只坐在草地上的猫"),很难直接生成高质量的满意图像。究其本质,是因为主流的AIGC图像创作大模型都是用高质量的Caption标签训练的,这些Caption通常比人工快速输入的文本提示词要复杂得多,同时包含更详细的关键信息(包含结构完整、细节丰富的专业文本,包含主体属性、空间关系、光影风格、画质参数、美学约束等全维度信息)。这意味着我们需要重新扩展优化用户输入的提示词来匹配AIGC图像创作大模型的偏好,以实现最佳创作性能。
为了解决上述问题,Seedream系列引入了PE模块,通过利用Seedream自研的LLM大模型来优化提示词,来促进扩散模型生成质量更高的图像。论文中实验发现,PE模块能够让Seedream系列模型的生成美学质量显着提高30%,图像-文本对齐性能优化了5%,并大幅增加了生成图像的多样性。具体效果如下图所示:
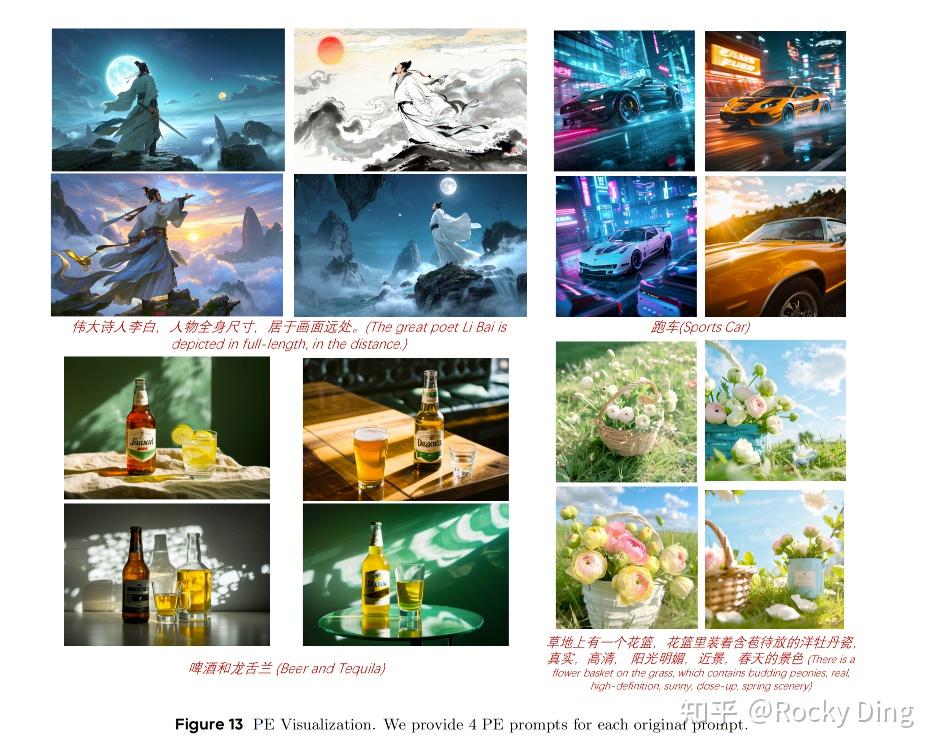
用户输入的简单提示词经过PE模块后,注入到Seedream中的效果示意图
PE模块核心由两个关键阶段组成:大语言模型有监督微调(Supervised Fine-Tuning,SFT)与基于人类反馈的强化学习(Reinforcement Learning from Human Feedback,RLHF)。
PE模块以一款中英双语能力优异的成熟大语言模型为基础,通过精心构建的提示词数据集样本对其开展SFT微调训练,采用大语言模型标准的自回归语言建模损失(Auto-Regressive Loss),核心目标是让大语言模型先习得「用户极简提示词」到「扩散模型偏好的高质量提示词」的基础映射关系 。数据集可表示为 D = < u , r > D = <u, r> D=<u,r>(其中 u u u 代表用户初始输入提示词, r r r 代表PE模型输出的改写后的优化提示词)。提示词对数据的构建质量,直接决定了PE模块的最终性能。Seedream设计了两套独立的训练数据构建方案:
- 以用户输入为起点的正向构建( u → r u \to r u→r) :对用户输入的初始提示词 u u u 进行人工改写优化,再将优化后的提示词输入Seedream模型中进行图像生成;持续重复这一过程,直至生成高质量图像,最终将该图像对应的改写提示词定为样本 r r r 。
- 以高质量改写提示词为起点的反向构建( r → u r \to u r→u) :首先从Seedream模型训练集中筛选出优质图像样本的详尽完整描述提示词,随后通过大语言模型对高质量描述提示词做"降级处理"(例如剔除改写描述语中与美学相关的细节描述),最终反向得到用户初始提示词 u u u 。
在完成SFT微调训练后,模型学会了"把简单prompt改成详细prompt",但仍无法保证改写后的prompt一定能生成符合人类审美、匹配用户语义的图像。所以我们接着再对PE模块进行基于人类反馈的强化学习(RLHF)训练,RLHF阶段的核心目标就是把「人类对最终生成图像的偏好」注入PE模块,让PE模块从"会写详细prompt"进化到"会写能生成高质量图像的prompt",实现End-to-End的效果闭环。具体实现流程如下:
- 收集一批用户提示词,对每一个用户提示词 u u u ,用SFT微调后的PE模块生成多个不同的改写版本 r 1 、 r 2 . . . r n r_1、r_2...r_n r1、r2...rn .
- 再将这些改写后的提示词输入已训练完成的Seedream模型,生成一一对应的图像。
- 以美学质量(画面清晰度、光影自然度、风格统一性、整体观感)、图文对齐度(画面主体、属性、场景是否完全匹配用户的初始需求,无额外无关内容、无核心信息遗漏)为核心评判标准,从生成的图像中筛选出「最高质量-最低质量」图像进行配对,对应的prompt就形成了<偏好选中项, 偏好拒绝项>的配对训练数据。
- 最终,将配对训练数据通过**简单偏好优化(Simple Preference Optimization, SimPO)**算法对PE模块做进一步训练,让PE模块的输出效果与人类偏好实现更深层次的对齐。
值得一提的是,经典大语言模型的RLHF策略,一般是人类直接对模型的文本输出打分;而PE-RLHF策略则以扩散模型的生成结果为反馈媒介 ,人类不对prompt文本本身打分,而是对「prompt生成的图像」打分,再把偏好反向传递给PE-LLM。这种设计能够把prompt优化和最终的图像生成效果绑定,避免了"改写后的prompt看起来详细,但生成效果差"的问题。
总的来说,Rocky认为PE模块的核心创新是把传统"人工堆砌提示词"的高成本经验式提示词工程,升级为End-to-End、与扩散模型深度绑定、对齐人类偏好的自动化提示词优化系统,从根源上解决了AIGC图像创作模型"训练-推理输入的分布偏移"这个AI行业痛点问题。
在Seedream系列版本来到4.0后,PE模块的功能有了更多新扩展,将Seed1.5-VL作为Base训练了成为端到端原生多模态大模型(VLM),能够同时处理文本提示词和图像提示词 。它是整个Seedream 4.0图像创作系统的"前置理解大脑",核心功能包括:
- 处理用户的多模态提示词输入:文本prompt、单张参考图像、多张参考图像。
- 生成对应的优化多模态提示词输出:优化后的参考图像、优化后的文本prompt,作为后续Seedream模型的输入。
- **额外能力:**任务路由、带自动思考的prompt优化重写、待生成图像的预先最优画面宽高比估计。
同时PE模块在逻辑推理中还使用了AdaCoT(Adaptive Chain-of-Thought,自适应思维链)思想 ,AdaCoT根据「输入任务复杂度,自适应分配推理资源、平衡性能与延迟」的核心设计,让PE模块根据用户任务的复杂度,动态调整自身的思考预算(Thinking Budgets),实现了推理资源的自适应分配。具体适配与落地分为两个维度:
- **低复杂度任务:缩减思考预算,极致降低延迟。**对于简单的图像创作需求(如基础文生图"画一只白色的猫"、简单的图片属性修改),PE模块会参考AdaCoT对简单查询关闭CoT的逻辑,分配极少的思考预算,跳过不必要的深度推理步骤,快速生成符合Seedream模型要求的输入内容。 这一设计直接对应AdaCoT的核心收益:大幅降低简单任务的推理Tokens消耗与延迟,提升用户交互的流畅度,同时不影响基础生成效果。
- **高复杂度任务:提升思考预算,保证生成质量。**对于复杂的多模态任务(如多图参考的风格迁移与生成、带精准空间约束的图像编辑、需要上下文推理的漫画续画、专业公式/图表的可视化生成、多角色连贯的多图输出),PE模块会自动分配更高的思考预算,启用深度推理步骤,充分理解用户的复杂意图、对齐多模态输入的语义与空间信息,保证后续DiT生成的指令遵循度与画面质量。 继承了AdaCoT对复杂查询保留CoT、保障推理性能的核心设计。
动态的思考预算调整,让模型既能满足用户快速出图的轻量化需求,也能完成需要复杂多模态推理的专业创作任务,最终支撑了Seedream模型的精准编辑、多图参考生成、上下文推理生成、多图连贯输出等一系列高级能力,更好地对齐用户的真实创作意图。
Rocky在这里也简单介绍一下AdaCoT技术的原理。AdaCoT是字节跳动Seed团队提出的原本用于大语言模型的自适应推理框架,核心解决传统Chain-of-Thought(CoT,思维链)无差别触发带来的计算冗余、推理效率低下的问题,通过帕累托优化与强化学习,让模型根据查询的隐式复杂度,自适应决定是否触发CoT推理。
CoT prompting通过让模型生成逐步推理过程,显著提升了大模型的复杂推理能力,但存在致命缺陷,即无差别推理:对简单查询(如"1+1等于几")也生成冗长的推理步骤,造成巨大的Tokens消耗、推理延迟和部署成本提升。而AdaCoT的核心创新是将自适应推理建模为一个双目标的帕累托优化问题,在最大化模型性能的同时,最小化CoT的使用成本。
【Seedream的VAE模块】
Seedream系列在VAE模块部分使用了自研的高保真VAE模型,在论文介绍中阐述了其对图像进行压缩后,能够大幅降低图像Tokens,同时图像重建的性能优异,这使得Seedream模型能够在Latent空间中高效训练。
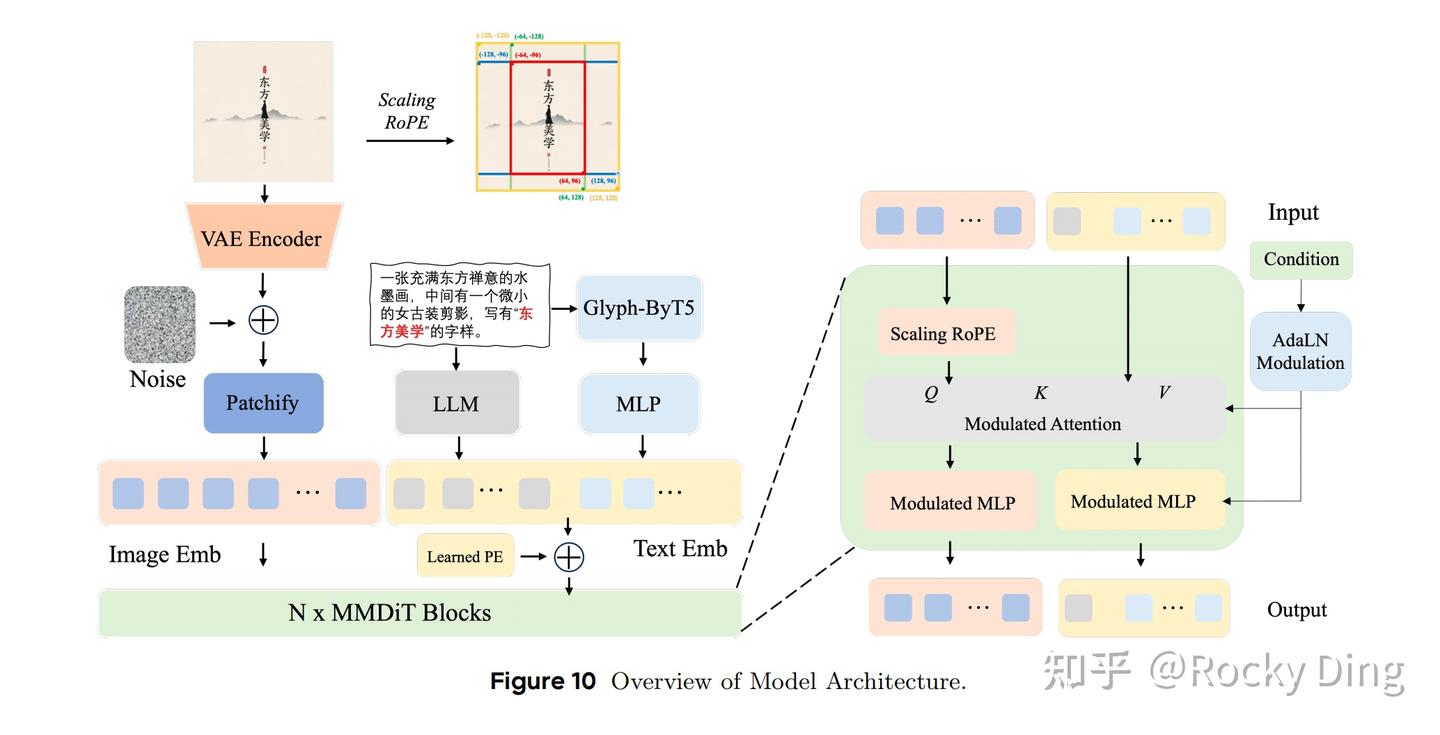
Seedream系列模型的整体架构
具体来说,对于输入图像 I I I,Seedream采用自研的VAE模型对输入图像进行编码,得到维度为 x ∈ R C × H × W \boldsymbol{x} \in \mathbb{R}^{C×H×W} x∈RC×H×W的Latent Feature。随后,我们将隐向量 x \boldsymbol{x} x进行分块化(patchified)处理,得到 H p × W p \frac{H}{p} × \frac{W}{p} pH×pW个图像分块( p p p为单个分块的尺寸)。这一流程最终将输入图像转换为 H × W 4 \frac{H×W}{4} 4H×W个图像Tokens(Image Tokens);这些图像Tokens会与经文本编码器编码得到的文本Tokens(Text Tokens)在序列维度拼接,随后输入至DiT-Transformer模块中。
主流AIGC图像创作大模型的VAE一般设置8倍下采样,例如3x1024×1024的RGB图像,经VAE编码后会变成4×128×128的隐空间特征图(对应原文 x ∈ R C × H × W \boldsymbol{x} \in \mathbb{R}^{C×H×W} x∈RC×H×W,其中 C = 4 C=4 C=4为通道数, H / W H/W H/W为隐空间的高/宽),计算量直接压缩到原来的1/64。Rocky认为Seedream模型的VAE大概率是采用了大倍率的压缩比策略,同时通过增加模型容量来提升特征重建性能。
【Seedream的Text Encoder模块】
为了在模型中实现有效的提示词编码,经典AIGC图像大模型通常采用 CLIP 或 T5 作为扩散模型的文本编码器。CLIP 文本编码器能够捕捉与视觉表征或嵌入高度对齐的判别性信息,但对复杂细粒度文本、中文语义的理解能力极差。而 T5 编码器则在理解复杂、细粒度的文本信息方面表现出色,但原生的中英双语对齐能力不足,且对中文文化特征的捕捉存在天然短板。
总的来说,无论是 CLIP 还是 T5,在理解中文文本时能力都较为有限。而Decoder-only的大语言模型(LLM)具备极强的多语言理解能力,但其生成的文本嵌入特征分布,与CLIP/T5的编码器特征分布存在巨大差异,无法直接适配扩散模型的训练,会导致训练严重不稳定。
正是基于上述的这些问题,Seedream 2.0使用了大规模图文对数据对自研的Decoder-only双语LLM做定制化微调,解决了传统CLIP/T5文本编码器中文理解能力弱的痛点,也是Seedream系列高价值的架构创新:
- 用图文对数据做校准,让LLM生成的文本嵌入特征,与扩散模型的图像隐空间实现精准对齐,解决了训练不稳定的问题;
- 基于LLM强大的双语能力,让模型能直接从海量中英双语原生数据中学习语义知识,实现对中文长文本、专业词汇、文化内涵的原生理解;
- 大幅提升了模型对复杂prompt的跟随能力,尤其是包含多层级语义、多物体空间关系、专业领域描述的prompt。
接着在Text Encoder模块部分,Seedream系列就使用了上述自研的双语大语言模型(LLM)作为文本编码器的核心架构,使其能够直接从海量数据中学习中文知识,同时通过多轮校准训练,文本编码器能够获得更强的双语对齐能力。这使Seedream系列模型能够生成高保真图像,准确呈现中英文描述中的文化细微差别和美学表达。
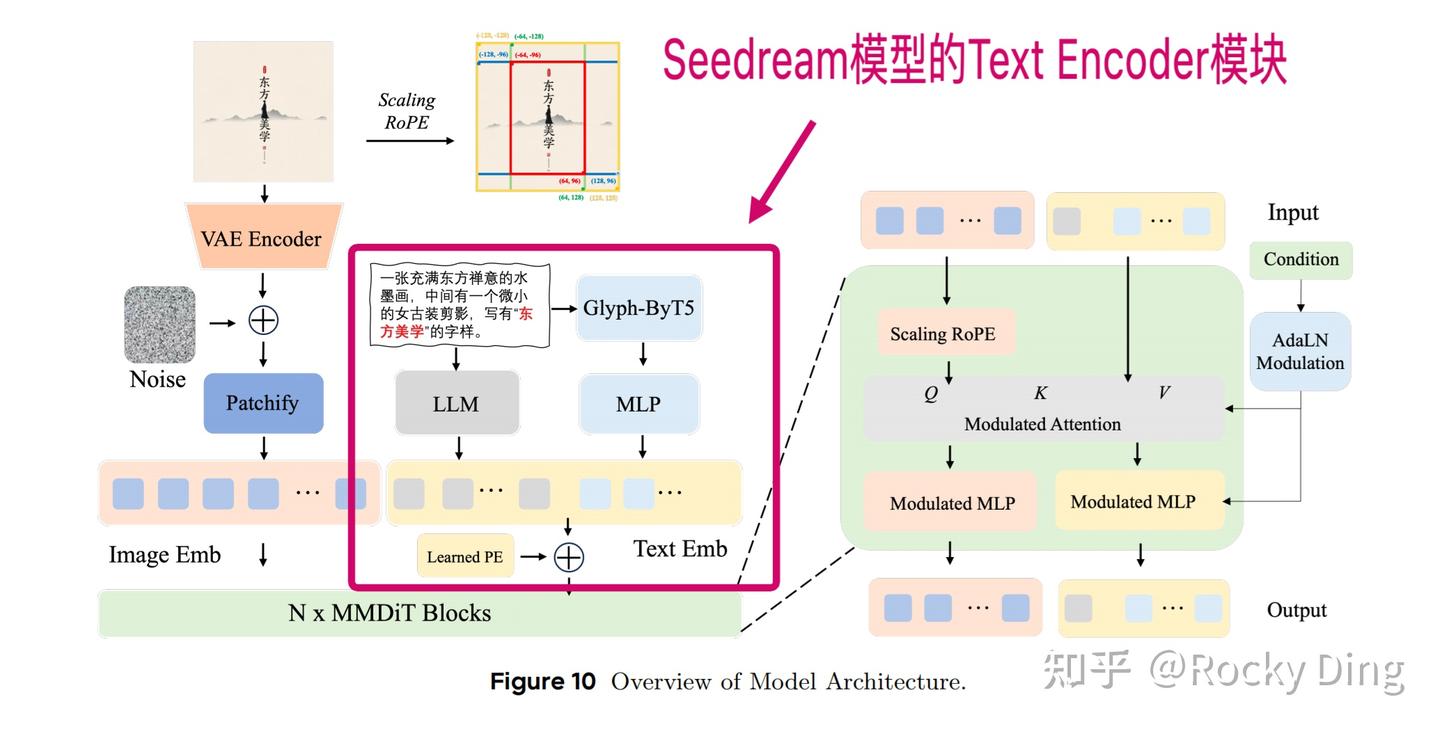
除此之外,考虑到双语文本字形(尤其是汉字)的复杂性,**Seedream系列中还应用了Glyph-Aligned ByT5(字形对齐模型,Character-level Text Encoder)字符级编码器来实现灵活的字符级别的文本渲染。**该模型能够提供准确的字符级特征Embedding,并确保渲染出的文本与文本提示词的字形特征保持一致。
接着我们将常规文本特征和字符级特征进行拼接(concat)再输入到后续的DiT模块中:
- **双语LLM大模型编码器:**该分支核心负责对prompt的全局语义、主体属性、空间关系、美学风格、光影色彩、场景构图逻辑进行深度编码,输出Seedream模型所需的全局语义条件特征。输入为用户输入的中英双语文本prompt,输出维度为 L , D L, D L,D 的全局语义文本Embeddings( L L L 为文本Tokens长度, D D D 为特征维度)。
- **双语文字渲染Glyph-Aligned ByT5编码器:**该分支针对文字渲染场景优化,使用Glyph-Aligned ByT5模型,专门负责对prompt中的文字内容、字形、字体、排版等细粒度信息进行字符级编码,针对prompt中指定的文字渲染需求(如文案内容、字体风格、字号、颜色、排版位置),进行逐字符的细粒度解析编码,输出维度为 M , D M, D M,D 的字符级字形嵌入(M为字符数量,D为特征维度)。接着再与全局语义文本Embeddings在tokens维度进行拼接,形成最终的多维度文本条件嵌入,维度为 L + M , D L+M, D L+M,D ,可直接作为条件信息输入到后续DiT扩散模块中,为整个扩散流程提供精准的文本引导。
Glyph-Aligned ByT5编码器在预训练阶段基于百万级文本渲染图像-文本对进行对齐训练,学习字符的字形结构、笔画特征、字体风格与视觉特征的映射关系,解决了传统编码器对文字字形特征捕捉不足的问题。 接下来,我们就学习一下Glyph-Aligned ByT5编码器是如何进行对齐预训练的。
Glyph-Aligned ByT5编码器在对齐训练过程中采用Box-level Contrastive Objective损失函数 ,结合DINOv2视觉编码器完成文本 - 图像嵌入特征对齐。Glyph-Aligned ByT5的对齐预训练核心目标,是在完整保留原生ByT5字节级编码能力与特征空间的基础上,让文本编码器习得字符级的字形视觉表征,实现文本嵌入与视觉字形嵌入的细粒度跨模态对齐。
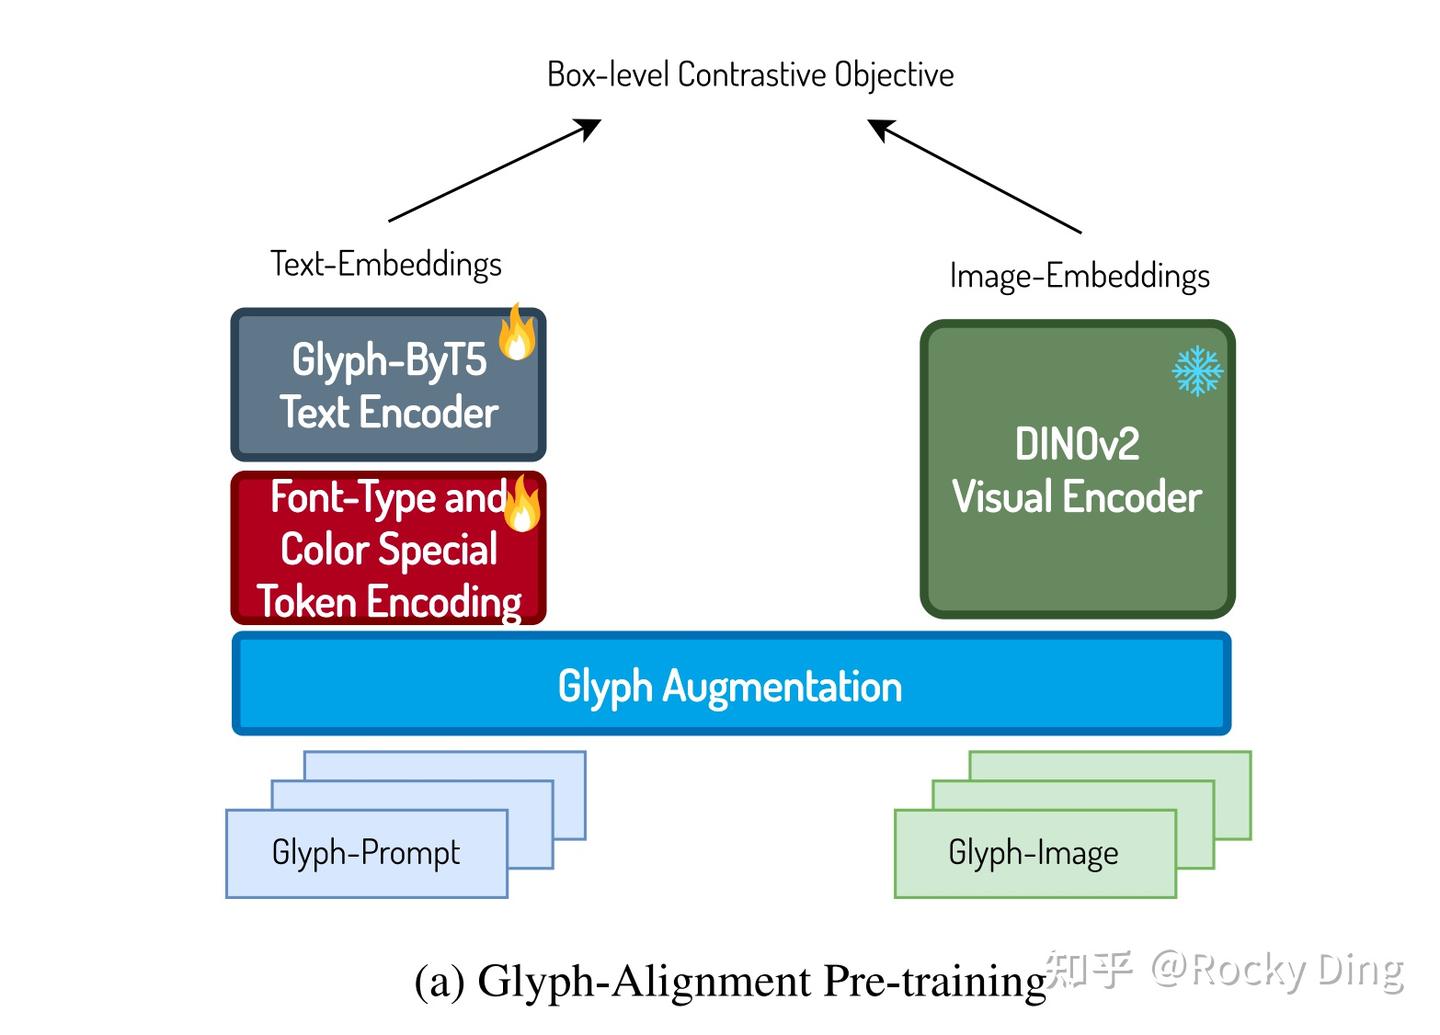
Glyph-Aligned ByT5编码器的对齐训练过程
- **对齐预训练模型权重设置:**冻结DINOv2视觉编码器(DINOv2 ViT-B/14,86M参数量)全部权重,冻结ByT5解码器的全部权重,仅微调ByT5文本编码器(ByT5-Small,217M参数量)。这样处理的好处是固定视觉特征空间,强制文本编码器单向适配视觉表征,避免模态双向更新带来的"特征漂移",保证跨模态对齐的稳定性。
- **对齐预训练数据集体系构建:**高质量、可扩展的字形-文本配对数据集,是预训练与对齐实现的核心前提,为此Glyph-Aligned ByT5构建了三级数据集体系,覆盖单字符、短句、段落级全场景,同时支持多语种扩展。预训练核心语料规模覆盖50万~100万对 ( I g l y p h , T t e x t ) (I_{glyph}, T_{text}) (Iglyph,Ttext) 字形图像-文本配对样本。
- **Glyph-Aligned ByT5完整对齐预训练流程:**预训练全流程分为4个核心步骤。**步骤1:**权重初始化与冻结策略执行。**步骤2:**输入数据预处理与双分支特征提取,针对Batch-Size内的每一组 ( I g l y p h , T t e x t ) (I_{glyph}, T_{text}) (Iglyph,Ttext) 配对样本,分别执行视觉分支与文本分支的特征提取,用于后续损失函数计算。**步骤3:**Glyph-Aligned ByT5的参数优化,计算Box-level Contrastive Loss(框级对比损失),优化参数实现全局框级对齐与细粒度字符级对齐。
按照上面的训练流程,即可完成Glyph-Aligned ByT5的对齐预训练。总的来说,Glyph-Aligned ByT5对齐预训练的最终成果是实现Glyph-ByT5文本嵌入与DINOv2视觉嵌入的跨模态对齐。
一般来说,传统文本渲染方案普遍存在两个致命问题:一是仅用单一模型编码文本特征,对长文本容易出现字符重复、布局混乱的问题;二是需要引入OCR渲染的图像特征作为额外条件,大幅增加了训练和推理的复杂度,无法实现端到端生成。Seedream 2.0使用常规文本特征和字符级特征的解决方案,实现了效果与效率的双重突破:
- 采用ByT5模型对渲染文本的字形内容做字符级编码,提供精准的字符级特征,保证渲染文本的字形特征与prompt文本的一致性;
- 针对单一模型语义理解不足的问题,采用LLM文本编码器+ByT5模型双路编码的方案:用MLP层将ByT5的嵌入投影到与LLM文本编码器对齐的特征空间,再将两路特征拼接后输入DiT块训练;
- 全程仅使用文本特征作为条件,不引入任何OCR图像特征,完全不改变原生文生图的训练和推理流程,大幅降低了管线复杂度;
- 通过重字幕模型描述文本的字体、颜色、大小、位置等渲染特征,由LLM编码器编码,让模型端到端学习文本的渲染规律,无需额外的布局规划模块。
【Seedream的DiT-Transformer模块】
Seedream系列的DiT-Transformer核心架构遵循了Stable Diffusion 3(SD 3)中的多模态扩散Transformer(MMDiT)的设计原则,采用MMDiT双流结构 。每个MMDiT Block模块仅包含一个自注意力层 ,能够同时处理图像Tokens和文本Tokens(两者拼接后进入同一个自注意力层),并捕捉两种数据模态之间的关系。随着Seedream系列版本的更新,官方高效scaling up了DiT核心架构的总参数,并持续引入改进技术与策略,从而增强了DiT核心架构的可扩展性、泛化能力和视觉-语言对齐性。
考虑到图像与文本两种模态之间的特性差异,Seedream采用了相互独立的多层感知机(MLP)分别对两种模态的特征进行处理。接着使用自适应层归一化(Adaptive LayerNorm,AdaLN)对每个注意力层与MLP层进行特征调制;同时采用QK-Norm提升训练稳定性,并借助全分片数据并行(Fully Sharded Data Parallel, FSDP)实现模型的分布式训练。
FSDP的核心是"分片存储",将模型权重、梯度、优化器状态全部切分为N份(N为GPU数量),每个GPU只存储1份。计算时按需收集权重分片,计算完成后立即释放,极大降低单GPU显存占用,实现超大模型的多机多卡分布式训练。
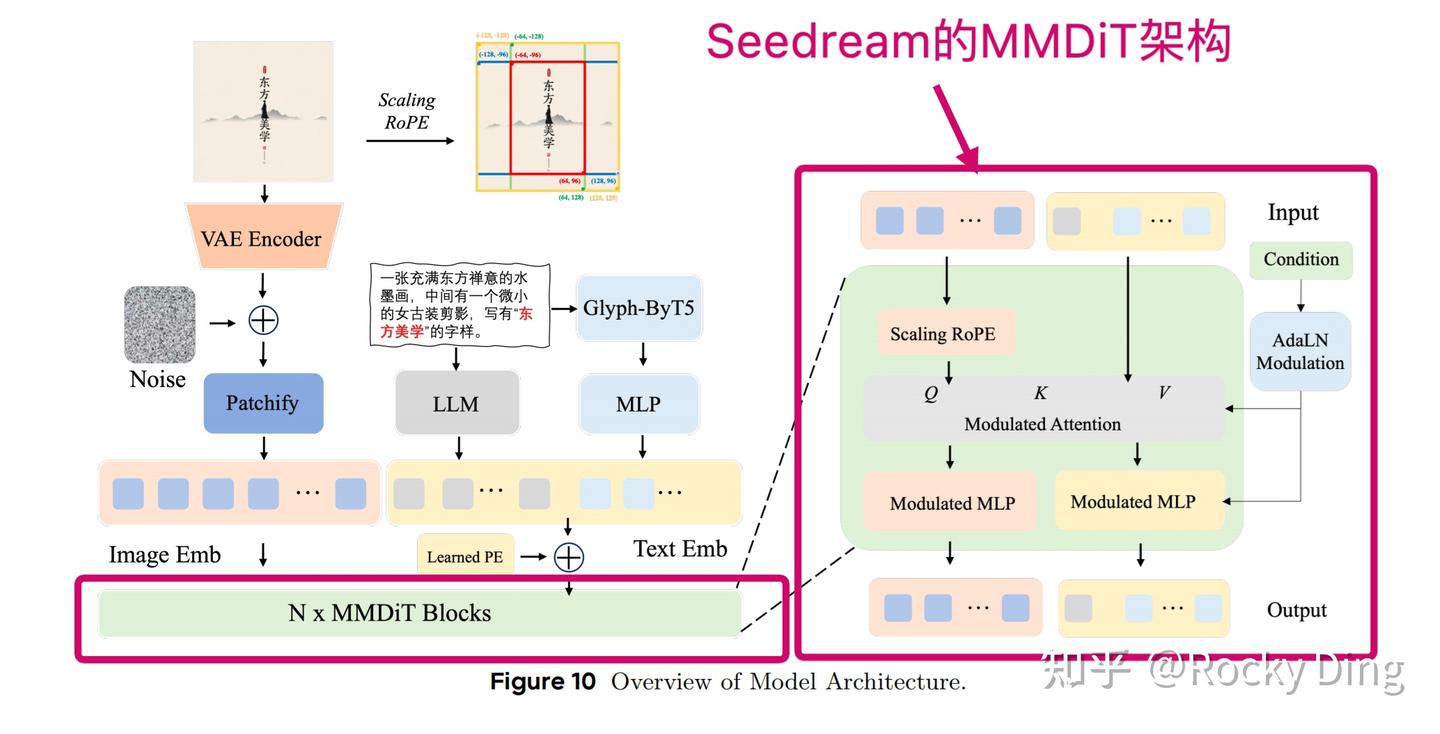
同时在细节优化策略上,Seedream 2.0为文本Tokens添加了可学习的位置嵌入(Learned Positional Embedding,Learned PE),并为图像Tokens应用了二维旋转位置编码(2D Rotary Positional Embedding,2D RoPE)。与常规RoPE不同的是,为了解决模型对未训练分辨率、宽高比的泛化能力不足的问题 ,Seedream设计了一种二维RoPE的变体,即缩放型旋转位置编码(Scaling RoPE) 。如上图所示,通过基于图像分辨率配置不同的缩放因子,让位于图像中心区域的图像块可以在不同分辨率下共享相近的位置ID。这一设计使得Seedream 2.0模型在推理阶段,能够在一定程度上泛化至训练时未见过的宽高比与分辨率,为后续3.0、4.0、5.0版本的高分辨率生成打下了基础。
Seedream 3.0继承了Seedream 2.0的MMDiT核心架构,同时扩大了模型的整体参数量。除此之外,Seedream 2.0的Scaling RoPE只针对图像token做了优化,Seedream 3.0将其升级为跨模态RoPE,实现了图文token的位置关系联合建模:
- 把文本token视为形状为1, L的2D token,对其应用2D RoPE;
- 文本token的列位置ID,在对应图像token之后连续分配,让模型能精准建模文本token之间、图像token之间,以及文本与图像token之间的位置关系;
- 最终效果:大幅提升了图文对齐能力和文本渲染精度,尤其是多物体空间关系、长文本排版的生成效果。
Seedream 4.0继续对DiT架构做了深度优化,在大幅提升模型容量的同时,显著降低了训练和推理的FLOPs,实现了三大核心优势:
- 极致的效率提升:训练和推理的计算量,相比Seedream 3.0降低10倍以上,同时生成性能大幅提升;
- 极强的可扩展性:架构设计天然支持模态容量、任务覆盖、多模态泛化的规模化扩展;
- 统一的多任务支持:单架构原生支持文生图、单图编辑、多图编辑、多图参考、多图输出等任务,无需额外的分支或专用模型。
【Seedream的Refiner模块】
在Seedream 2.0中,由于当时只能生成512分辨率的图像,而这需要进一步放大到1024分辨率或者更高分辨率的图像,所以引入了Refiner模块来进行后处理生成与精修,提升分辨率的同时,优化结构细节、人脸特征、纹理质感。
而在Seedream 3.0以及后续的版本中,Seedream模型已经能够原生生成2K乃至4K的超高分辨率图像,因此在后续的版本中就不再加入Refiner模块。
尽管如此,Rocky认为Refiner模块及其对应的技术思想是跨周期的,具备较强的技术韧性。Refiner模块思想最早在Stable Diffusion XL(SDXL)中被提出,用于提升提生成图像的分辨率和优化图像结构细节(例如人脸细节优化、增强纹理质量等)。同时,在自回归 + 扩散Decoder生成式架构中,Refiner模块作为扩散Decoder部分,更是跨越了周期,持续发展演进。
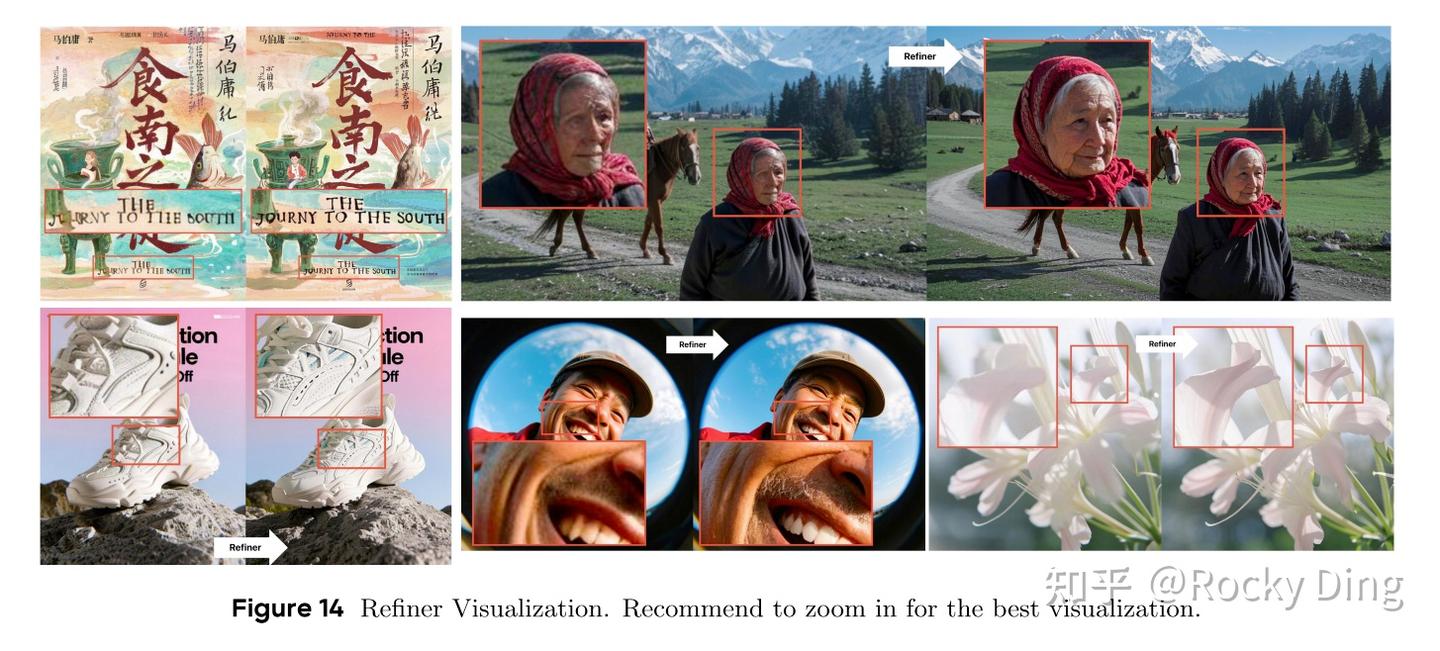
因此,Rocky在这里展开讲解Seedream中是如何训练Refiner模块的。Refiner模块基于Seedream 2.0基础模型作为Base构建,其训练过程包括1024分辨率微调训练和纹理RLHF(基于人类反馈的纹理强化学习)两个阶段:
- 1024分辨率微调训练:使用CT(Continuing Training)阶段的数据进行1024分辨率训练,其中排除了分辨率低于1024的图像,同时在保持高分辨率图像纵横比的情况下将其调整为1024,保证基础的超分效果。
- Refiner RLHF:在Refiner模块上执行RLHF过程,来增强生成图像中的纹理细节。数据构建如下:官方手动收集了一组高纹理图像,对其进行随机退化处理以构建用于训练的配对数据。然后,我们使用这些退化图像训练基于分数的纹理奖励模型(Reward Model,RM),并利用该纹理RM指导精炼器模型的优化,以生成更丰富、更有意义的图像。
3.2 Seedream(即梦)系列训练数据的构建方法
在本章节中,Rocky将带着大家详细讲解Seedream系列模型的训练数据构建方法与策略。
我们知道,高质量的训练数据是AIGC生成大模型的知识根基,Seedream 2.0的核心突破,就是构建了一套面向中英双语、覆盖全场景、兼顾质量与多样性的预训练数据流水线,解决了开源AIGC图像大模型数据中文内容缺失、质量参差不齐的问题。
Seedream 2.0的预训练数据由四大核心模块构成,每个模块都针对性解决了特定的模型能力问题:
| 数据模块 | 核心构成 | 解决的核心问题 |
|---|---|---|
| 高质量核心数据 | 基于清晰度、美学表现、来源分布筛选的高画质图文对,覆盖全场景 | 保证模型的基础生成质量和下限 |
| 分布维护数据 | 基于数据源降采样+多层级聚类采样,平衡数据分布 | 解决数据长尾问题,避免模型对高频场景过拟合 |
| 知识注入数据 | 核心为中文特色数据集,包括汉字、中式动植物、美食、建筑、民俗文化等图文对,辅以多模态检索引擎做数据增强 | 解决模型对中文文化、专业语义理解不足的痛点 |
| 针对性补充数据 | 动作导向数据、反事实数据等模型表现较差的难例数据,通过主动学习引擎分类整合 | 补齐模型的边缘场景能力,提升复杂prompt的跟随能力 |
为了保证数据集的质量,Seedream 2.0接着设计了三级递进式的清洗流程,层层过滤低质量数据,同时最大化保留有效信息:
- 第一阶段:通用质量评估:对全量数据做基础质量打分,包括图像清晰度、运动模糊、无意义内容的通用质量分;水印、文字叠加、logo等元素的通用结构分;以及全图OCR检测与文本内容归档,剔除不达标的样本。
- 第二阶段:精细化质量评估:对过滤后的样本做专业美学打分、特征嵌入提取、全量去重,以及多层级语义聚类,给每个数据点打上语义类别标签,为后续分布调整提供支撑。
- 第三阶段:Caption标签生成与重写:对最终留存的数据做分层字幕标注,高质量样本获得多视角、更丰富的全新Caption标签,低质量样本做重写优化,保证图文对的语义对齐精度。
当然的,Seedream 2.0的数据构建系统还不止于此,还包含了主动学习引擎与双轨Caption标签系统:
- 主动学习引擎:通过"小样本人工标注→训练分类器→预测未标注数据→筛选难例再标注"的迭代流程,持续优化数据分类器,保证数据集的质量持续提升,同时精准捕捉模型的能力短板,针对性补充难例数据。
- 双轨Caption标签系统:这是Seedream 2.0实现双语对齐的核心设计之一,分为通用Caption标签和专业Caption标签两大体系:(1)通用Caption标签生成中英双语的短Caption标签(精准捕捉核心内容)和长Caption标签(全维度细节描述,包含合理的推理与想象),保证基础的图文语义对齐。(2)专业Caption标签针对不同场景做专项优化,包括描述风格、色彩、构图、光影的艺术Caption标签,聚焦图像内文本信息的文本Caption标签,以及捕捉超现实、奇幻元素的超现实Caption标签,让模型能精准理解专业维度的prompt描述。
最后,针对当时AIGC图像领域普遍的文本渲染痛点,Seedream 2.0专门构建了一套大规模视觉文本渲染数据集,处理流程如下:
- 从内部数据源过滤低质量数据,用OCR工具筛选富含视觉文本内容的图像;
- 检测并提取文本区域,裁剪水印与无效内容,过滤低质量文本框,保留清晰有效的文本区域;
- 用重Caption标签模型对提取的文本做高质量描述,最终生成适配文本渲染任务的高质量图文对。
接着,Seedream 3.0在Seedream 2.0的数据体系基础上,做了两大颠覆性的迭代,不仅大幅扩大了有效训练集的规模,更解决了2.0版本数据分布的长尾问题。Seedream 2.0为了保证数据质量,采用了极其严格的过滤策略 ,直接剔除了所有带水印、叠加文字、马赛克等缺陷的样本,而这类样本占原始数据集的35%,极大限制了训练数据的规模。Seedream 3.0基于缺陷感知训练范式,解决了这一矛盾:
- 基于主动学习引擎,用15000个人工标注样本训练了专门的缺陷检测器,能通过边界框预测精准定位图像中的缺陷区域;
- 对缺陷总面积占比小于20%的样本,不再直接剔除,而是采用掩码隐空间优化的方案:在隐空间的扩散损失计算中,通过空间注意力掩码机制,排除缺陷区域的特征梯度;
基于上述策略,最终在保证训练稳定的前提下,有效训练数据集直接扩大21.7%,同时让模型学习到了更多场景的有效信息,提升了泛化能力。
同时Seedream 2.0采用的纯自上而下重采样策略,存在两个核心缺陷:一是整体分布中自然图像占比过高,二是知识型细粒度概念的覆盖不足。因此Seedream 3.0构建了双轴协同数据采样框架,从视觉形态和语义分布两个正交维度做联合优化,解决数据长尾与分布失衡的问题:
- 视觉模态:沿用2.0的层级聚类方法,保证不同视觉模式的均衡表达;
- 文本语义维度:通过TF-IDF方法实现语义均衡,彻底解决了描述文本的长尾分布问题;
- 配套升级了跨模态检索系统,构建了图文对的联合嵌入空间,实现了专家知识的定向注入、基于相似度加权采样的分布校准,以及跨模态特征增强。
此外,针对CT和SFT阶段的数据,Seedream 3.0训练了多版本的专业Caption标签模型,能对美学、风格、排版、构图等专业维度做精准描述,让模型能更好地响应专业设计、摄影、艺术等领域的prompt,大幅提升了对专业描述的跟随能力。
到了Seedream 4.0,官方研究发现Seedream 3.0的双轴协同采样框架仍存在两个核心缺陷:一是整体分布中自然图像占比过高,二是知识型细粒度概念(教学内容、数学公式、专业图表等)的覆盖严重不足。Seedream 4.0针对这两个问题,对数据构建Pipeline做了重构,核心是知识型数据的专项建设。
针对知识型、专业场景的生成需求,Seedream 4.0将知识数据分为自然子集和合成子集,构建了完整的处理流程:
- 自然知识数据:从内部教材、科研论文、小说等PDF文档中,提取高质量的图表、教学插图,先通过低质量分类器过滤模糊、杂乱、背景噪点多的样本,再训练难度分级分类器,将图像分为易/中/难三个等级,训练时对极难样本做降采样,保证训练稳定;
- 合成知识数据:基于OCR输出和LaTeX源码,生成结构、符号密度、分辨率多样化的公式图像,大幅拓宽了细粒度知识概念的覆盖范围,解决了纯自上而下采样带来的知识型数据偏见问题。
接着,Seedream 4.0针对图文对质量、分布均衡性、图文对齐度三大核心问题,也完成了5项核心升级:
- 文本质量过滤:训练文本质量分类器,检测并过滤原始描述文本中的低质、错误、不匹配内容;
- 精细化去重:融合语义嵌入与底层视觉嵌入的去重管道,在去重的同时平衡数据的细粒度分布,避免样本同质化;
- 图文对齐增强:优化精细化描述生成模型,为图像生成更细粒度的视觉描述,同时升级跨模态嵌入模块,强化图文检索与对齐能力;
- 难度分级采样:为知识类数据训练三级难度分类器(易/中/难),对极端困难样本做下采样,保证预训练的稳定性;
- 编辑数据增强:为编辑任务数据设计三级细节粒度的描述文本,统一参考图与目标图的相似性描述术语,提升模型对编辑指令的理解精度。
3.3 Seedream(即梦)系列模型的训练全流程
Seedream系列大模型从Seedream 2.0开始构建了一套完整的、针对AIGC图像大模型的多阶段训练流水线框架,实现了模型能力的逐层优化,同时平衡了美学表现、prompt跟随、结构正确性、文本渲染等多维度能力,避免了模型偏科。后续3.0、4.0版本始终沿用这套训练框架,并持续迭代完善。
Seedream 3.0-4.0的训练流程都遵循了Seedream 2.0以来的整体框架,主要包含了**「Model Pre-training、Model Continue Training(CT)、Model Supervised Fine-Tuning(SFT)、Model Feedback Alignment(RLHF)」的四阶段端到端闭环训练**,核心目标是在单框架内统一文生图、图像编辑、多图合成能力,同时实现训练/推理效率与生成质量的平衡。
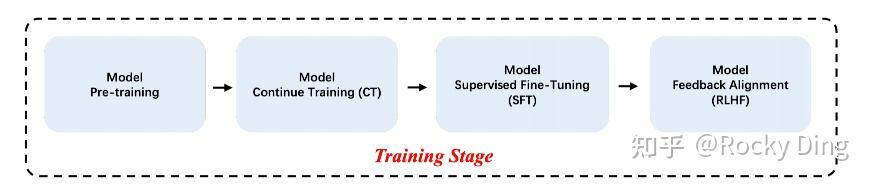
【第一阶段:模型预训练------通用生成能力的基础构建】
Transformer架构天然支持可变长度的token输入,这一特性也被验证在ViT视觉任务中有效。Seedream 3.0首次将混合分辨率训练大规模应用到AIGC图像大模型中:
- 训练流程:先在256²的平均分辨率下完成基础预训练,再在512²到2048²的高分辨率数据上做微调;
- 核心优化:引入尺寸嵌入作为额外的条件输入,让模型能感知目标分辨率,适配不同的宽高比;
- 最终效果:大幅提升了训练数据的多样性,让模型能完美泛化到训练中未见过的分辨率,原生支持2K分辨率输出,无需任何后处理超分。
Seedream 2.0采用的是经典的扩散训练目标,Seedream 3.0开始升级为流匹配训练目标,同时引入了表征对齐损失(REPA),大幅提升了大模型的训练收敛速度:
- 流匹配目标:采用线性插值的方式构建噪声样本,相比扩散目标,训练更稳定,更适配大参数量模型的规模化训练;
- 表征对齐损失REPA:计算MMDiT中间特征与预训练DINOv2-L模型特征的余弦距离,作为辅助损失,权重λ=0.5;
- 最终效果:大幅加速了大规模文生图模型的训练收敛速度,同时让模型生成的图像具备更真实的视觉特征与细节质感。
针对高分辨率训练的特点,Seedream 3.0设计了分辨率感知的时间步采样策略:
- 先从对数正态分布中采样时间步,再根据训练分辨率做时间步偏移;
- 核心逻辑:在高分辨率训练时,偏移时间步分布,提升低信噪比(SNR)时间步的采样概率;
- 推理时,根据目标分辨率和宽高比,动态计算偏移因子,适配不同的生成需求;
- 最终效果:大幅提升了高分辨率图像的生成质量,避免了高分辨率下细节模糊、结构崩坏的问题。
到了Seedream 4.0 其核心目标是让DiT架构+高压缩比VAE架构学习通用的图像生成与视觉语义理解能力,同时原生适配1K-4K高分辨率生成。因此预训练的核心架构底座全程围绕**「高效可扩展DiT骨干 + 高压缩比VAE」**的架构设计展开,这也是其实现10倍以上训练/推理加速的核心:
- 高压缩比VAE:大幅降低潜空间的图像token数量,在保证重建保真度的同时,实现极致的维度压缩,让1K-4K原生高分辨率的训练与生成成为可能,解决传统模型高分辨率训练成本过高的问题;
- 高效DiT骨干:在大幅提升模型容量的同时,显著降低训练与推理的FLOPs,相比Seedream 3.0 实现10倍以上的计算效率提升,且硬件友好,易于规模化扩展。
为平衡通用能力学习与高分辨率生成效果,Seedream 4.0 采用分阶段预训练范式,固定VAE权重后,对DiT主干进行端到端训练:
第一阶段:基础分辨率通用预训练
- 训练分辨率:以512×512为平均分辨率,同时支持多种自适应宽高比;
- 训练目标:让模型学习基础的图文对齐、视觉结构建模、纹理生成能力,完成数十亿级图文对的通用视觉知识与语义理解学习;
- 核心作用:构建模型的底层生成能力,为后续高分辨率迁移与多任务适配打下基础。
第二阶段:高分辨率迁移微调
- 训练分辨率:覆盖1024×1024到4096×4096的全范围高分辨率;
- 训练目标:让模型适配高分辨率下的细节生成、长距离结构一致性,原生支持4K商业级图像生成;
- 核心优势:得益于高压缩VAE与高效DiT的架构设计,4K分辨率训练依然保持高效,无需额外的超分模块,避免传统模型高分辨率下的结构崩坏、细节失真问题。
同时为了支撑百亿级数据、大参数量模型的长周期稳定训练,Seedream官方设计了高度优化的分布式训练系统,核心包含三大模块:
- 并行与内存优化:采用混合分片数据并行(HSDP),无需张量并行或专家并行即可支撑大规模训练;通过隐藏状态及时释放、激活值卸载、增强FSDP支持优化内存占用,让大模型在现有GPU资源上可高效训练;
- 内核与负载均衡优化:性能关键操作通过torch.compile+手写CUDA内核+算子融合加速,减少冗余内存访问;针对变长序列带来的负载不均衡,引入全局贪心样本分配策略+异步流水线,实现单GPU利用率的均衡优化;
- 多级容错机制:内置模型、优化器、数据加载器状态的周期性checkpoint,启动前节点健康检查,低开销初始化等能力,保证长周期分布式训练的稳定性与持续吞吐量。
【第二阶段:多模态联合后训练------生成与编辑能力的统一与对齐】
基于预训练完成的DiT-Transformer架构,Seedream官方通过持续训练-有监督微调-人类偏好对齐的三阶段范式,完成多任务联合训练,同时配套训练了多模态Prompt Engineering(PE)模块,解锁全场景多模态交互能力。后训练的核心设计思路:
- 基于SeedEdit 3.0 的多模态架构扩展,通过DiT框架中的因果扩散设计,实现文生图(T2I)与图像编辑任务的联合训练,单模型统一多模态输入输出能力,无需多个专用模型;
- 多任务联合训练的效果显著优于单任务独立训练,每个子阶段均能带来持续的性能提升,最终实现指令跟随、参考一致性、生成质量的全面优化;
- 配套端到端VLM作为PE模块,打通用户多模态输入与DiT模型之间的链路,实现复杂指令理解、多图上下文推理、任务自适应路由。
【子阶段1:持续训练(Continuing Training, CT):平衡美学提升与基础能力保留】
预训练完成的扩散模型,往往受限于预训练数据集的美学标准,生成的图像无法满足人类的审美偏好。但直接用美学数据微调,极易导致模型丢失prompt跟随、结构正确性等基础能力。因此Seedream 2.0设计了CT阶段,针对性解决了这一矛盾:
- 数据设计:采用双数据源混合训练,一是通过自研图像质量评估(IQA)模型,从预训练数据中过滤出的高质量图文对;二是从艺术、摄影、设计等专业领域,人工精选的百万级高美学数据集,通过合理的采样比例,避免模型对小数据集过拟合。
- 核心技术创新:引入VMix策略,对每张图像按颜色、光影、纹理、构图四大美学维度打标签,作为训练时的补充条件,让模型在去噪过程中直接学习细粒度的美学特征,大幅提升了生成图像的美学上限。
- 训练目标:在提升图像美学表现的同时,完整保留模型的prompt跟随能力和结构生成精度,避免了传统微调"顾此失彼"的问题。
接着,Seedream 3.0在CT阶段引入了分辨率平衡训练策略,对不同分辨率的训练数据做均衡采样,保证模型在不同分辨率下,都能保持优秀的prompt跟随能力,避免了高分辨率训练导致的低分辨率能力退化。
到了Seedream 4.0,核心目标是 拓宽模型的多任务基础能力,重点突破图像编辑的指令跟随能力,让模型从纯文生图生成,适配到「文本+参考图」的多模态编辑输入场景;因此训练数据是大规模编辑任务数据集,每个样本包含参考图、目标图、编辑指令,配合三级粒度的描述文本做数据增强;让模型同时具备文生图与图像编辑的基础能力,打通生成与编辑的底层链路,为后续精细化微调奠定基础。
【子阶段2:有监督微调(Supervised Fine-Tuning, SFT):强化美学表现与真实感】
SFT阶段的核心目标,是进一步强化模型的艺术美感与图像真实感,同时解决生成图像"假、塑料感"的问题。
- 数据设计:用极少量的精选高美学图像,训练了专门的字幕模型,能精准描述图像的美感与艺术性,同时给图像打上风格标签和细粒度美学标签,保证覆盖主流的艺术风格与创作类型。
- 核心技术创新:在训练中引入模型生成的劣质图像作为负样本,与真实图像样本联合训练,让模型学习区分真实与虚假图像,提升生成内容的自然度与真实感;同时自研了数据重采样算法,完美平衡了美学提升与图文对齐能力,避免SFT阶段导致的prompt跟随能力下降。
Seedream 3.0同样在SFT阶段引入了分辨率平衡训练策略,对不同分辨率的训练数据做均衡采样,保证模型在不同分辨率下,都能保持优秀的prompt跟随能力,避免了高分辨率训练导致的低分辨率能力退化。
而Seedream 4.0的核心目标是 精细化优化模型的指令遵循、参考一致性、艺术质感,同时补齐文本渲染、专业内容生成、结构稳定性等细粒度能力;训练数据是 高质量、细粒度的多任务标注数据,全覆盖文生图、单图编辑、多图编辑、参考生成、可控生成等核心场景,重点优化编辑任务中参考图与生成图的一致性,解决编辑场景中"过度修改"的核心痛点;训练设计为通过三级细节粒度的描述文本做数据增强,统一参考图与目标图的相似性描述术语,提升模型对编辑指令的理解精度;大幅提升参考图与编辑结果的一致性,同时在视觉美学、图文对齐、结构完整性上全面超越Seedream 3.0 与SeedEdit 3.0。
【子阶段3:基于人类反馈的强化学习(RLHF):全维度对齐人类偏好】
这是Seedream系列大模型后训练的核心环节,也是模型实现SOTA表现的关键。行业内针对扩散模型的RLHF方案,普遍存在单奖励模型偏科、训练不稳定、多维度能力无法同步提升的问题。Seedream 2.0针对扩散模型定制了完整的RLHF流程,解决了这些问题:
- 偏好数据构建:开发了百万级多维度prompt系统,构建了跨版本、跨模型的标注流水线,采用多维度融合标注规则,同时覆盖图文匹配、文本渲染、美学表现等维度,保证单奖励模型能实现多维度能力的同步优化。
- 多奖励模型体系 :针对性训练了三大奖励模型,均采用支持中英双语的CLIP作为基座,用排序损失做训练,分别对应图文对齐奖励模型、美学奖励模型、文本渲染奖励模型;其中文本渲染奖励模型会在prompt包含文本渲染需求时选择性激活,大幅提升了字符级文本生成的精度。
- 核心训练优化:采用REFL范式作为反馈学习算法,通过调整学习率、选择合适的去噪时间步、权重EMA,实现了稳定的反馈学习训练;同时对DIT主干和LLM文本编码器做联合微调,大幅放大了模型在图文对齐和美学提升上的收益。
- 迭代优化机制:采用"优化扩散模型→对新模型做偏好标注→训练坏例感知的奖励模型→再优化扩散模型"的迭代流程,持续提升RLHF的性能上限,同时保证训练的稳定性与可控性。
Seedream 2.0采用CLIP作为奖励模型的基座,而Seedream 3.0直接升级为视觉语言模型(VLM)作为奖励建模框架,彻底释放了奖励模型的规模化潜力:
- 受大语言模型生成式奖励建模技术的启发,将指令明确为查询query,用VLM输出的"Yes"响应token的归一化概率作为奖励值;
- 这一设计天然利用了预训练大语言模型的内置知识,同时能享受LLM的缩放定律红利;
- 团队将奖励模型从1B参数量,规模化扩展到20B+参数量,实验验证了奖励模型的性能随参数量提升显著增强,实现了奖励质量的飞跃。
到了Seedream 4.0,其核心目标是解决自动评估指标与人类感知不一致的问题,让模型的输出精细对齐人类的审美偏好、指令意图、实用需求。基于团队自研的RewardDance、DanceGRPO等奖励模型与强化学习算法,针对美学质感、指令跟随、内容一致性、结构完整性等核心维度构建多层级奖励体系,通过强化学习端到端优化模型参数。在人类盲测中实现全面领先,截至2025年9月18日,在Artificial Analysis Arena的文生图、图像编辑双赛道均登顶ELO榜单,超越Inagen 4、Gemini 2.5、GPT-4o、FLUX系列等主流模型。
【基于SeedEdit的图像编辑能力优化】
Seedream 2.0同时适配了指令式图像编辑模型SeedEdit,针对编辑时人脸ID保留能力不足的行业痛点,做了三大专项优化:
- 多专家数据融合:融合了人脸专家工作流生成的ID数据,以及真实环境下不同场景、不同相机参数的人脸ID保留数据,提升了模型对真实人脸的ID保留能力;
- 人脸感知损失:对人脸ID保留效果好的图像对,通过AdaFace人脸相似度模型引入额外的感知损失,结合扩散损失联合训练,大幅提升了人脸特征的相似度;
- 数据优化:用更鲁棒的数据过滤器和更多样的采样策略,进一步优化了编辑数据集的质量。
【训练全流程闭环:训练效果的评估与优化迭代】
Seedream 4.0 构建了「自动评估+人工评估」的双轨评估体系,贯穿训练全流程,为每个阶段的模型迭代提供精准、可量化的反馈,确保训练方向与效果目标对齐:
- **自动评估:**自研DreamEval多模态基准,覆盖4大生成场景、128个子任务、1600条prompt,通过细粒度视觉问答实现可解释、确定性的打分,同时设置易/中/难三级难度,分别评估模型的基础生成能力、高级生成能力、高阶理解与推理能力。该基准与人类评估结果高度对齐,可实现大规模、快速的训练效果反馈,支撑模型的快速迭代。
- 全维度人工评估体系:(1)**公开竞技场盲测,**在Artificial Analysis Arena的公开竞技平台,与全球主流商用/开源模型进行实时盲测对比,Seedream 4.0 在文生图、单图编辑双赛道均登顶ELO榜单;(2)**自研精细化基准测试,**构建MagicBench 4.0 多模态基准,覆盖三大核心任务:文生图赛道包括325条中英双语prompt,评估prompt对齐、结构稳定性、视觉美学、文本渲染、知识理解、上下文推理能力;单图编辑赛道包括300条中英双语prompt,评估指令跟随、内容一致性、结构完整性、文本编辑能力;多图编辑赛道包括100条中英双语prompt,评估指令对齐、跨图一致性、结构完整性,核心GSB指标超越竞品近20%。
3.4 Seedream(即梦)系列模型推理&部署性能优化技术
Seedream 2.0的加速方案主要集中在量化优化,而Seedream 3.0则直接重构了整个加速框架,基于Hyper-SD和RayFlow的核心思想,设计了两大原创加速技术(一致噪声期望稳定采样和重要时间步学习采样),在保证生成质量无损的前提下,实现了4-8倍的推理速度提升,1K分辨率端到端生成仅需3秒。
首先我们来讲一致噪声期望稳定采样,传统扩散模型的采样过程,不同时间步的噪声分布存在波动,导致少步采样时画质严重下降。Seedream 3.0的解决方案是:
- 通过预训练模型估计出统一的噪声期望向量,作为所有时间步的全局参考;
- 基于这个全局参考,对齐整个去噪过程,保证采样过程的平滑与一致;
- 最终效果:在不损失生成画质的前提下,大幅压缩了所需的采样步数,实现了极速采样。
接着是重要时间步学习采样,传统扩散模型训练时,对时间步做均匀采样,这会导致大量计算资源浪费在对损失贡献极小的时间步上,同时损失的方差极高,训练收敛慢。 Seedream 3.0引入了基于学习的重要性采样机制:
- 结合随机斯坦因差异(SSD),用一个神经网络学习数据依赖的时间步分布;
- 这个网络会预测哪些时间步对降低训练损失的贡献最大,在训练时优先采样这些时间步;
- 最终效果:训练收敛速度更快,计算资源的利用效率大幅提升,同时进一步优化了少步采样的生成质量。
Seedream 4.0在Seedream 3.0的加速框架基础上,构建了以对抗学习为核心的整体加速系统,同时结合硬件感知量化、投机解码两大技术,实现了极致的推理加速:2K分辨率图像生成最快仅需1.4秒,比3.0版本再提升10倍以上,同时完全不损失生成质量。
Seedream 4.0设计了**对抗蒸馏后训练(ADP)+对抗分布匹配(ADM)**的两阶段加速框架,彻底解决了传统少步采样模式崩溃、画质下降的问题:
- 第一阶段ADP:采用混合判别器做对抗蒸馏后训练,为少步采样提供稳定的初始化;
- 第二阶段ADM:采用可学习的、基于扩散的判别器做细粒度调优,替代传统的固定散度指标,规避了模式崩溃问题,大幅提升了生成稳定性和样本多样性;
- 最终效果:实现了高效的少步采样,大幅降低了所需的函数评估次数(NFE),在几十步的基线模型基础上,实现了画质持平甚至超越的效果。
为了进一步提升推理性能,同时保证画质无损,Seedream 4.0采用了硬件感知的自适应4/8比特混合量化方案:
- 先通过离线平滑处理,优化模型层内的分布离群值;
- 基于敏感度指标,搜索不同层的最优量化位宽和粒度;
- 通过后训练量化(PTQ)敲定最终参数,同时为不同位宽、不同粒度设计了硬件专属的高效算子,最大化推理性能。
此外,针对VLM PE模块的推理延迟问题,Seedream 4.0基于Hyper-Bagel做了深度优化:
- 将特征预测条件于前序特征序列和前进一步的token序列,提供确定性的预测目标,解决了随机token采样带来的投机解码不确定性;
- 对KV缓存加入损失优化,实现推理时的高效复用;
- 加入logits上的辅助交叉熵损失,优化草稿模型的预测精度;
- 最终效果:PE模块的推理速度大幅提升,端到端生成延迟进一步降低。
同时,为了支撑大参数量模型、4K高分辨率的大规模预训练,Seedream 4.0设计了高度优化的训练系统,核心包括:
- 并行与内存优化:采用混合分片数据并行(HSDP),高效分片模型权重,无需张量并行和专家并行,即可支撑大规模训练;通过隐藏状态及时释放、激活卸载、增强的FSDP支持,优化内存占用,让大模型能在现有GPU资源中稳定训练。
- 算子与负载优化:通过torch.compile结合手写CUDA算子、算子融合,加速性能关键操作,减少冗余内存访问;引入带异步流水线的全局贪婪样本分配策略,解决可变序列长度带来的负载不均衡问题,实现更均衡的单GPU利用率。
- 多级容错机制:内置了模型、优化器、数据加载器状态的周期性 checkpoint,启动前健康检查,以及初始化开销优化,保证长周期分布式训练的稳定性与持续吞吐量。
- 两阶段分辨率训练:先在512²平均分辨率下完成基础预训练,再在1024²到4096²的高分辨率数据上做微调,保证模型在全分辨率段的优秀表现。
3.5 Seedream(即梦)系列模型的应用功能和性能指标
为了让大家更清晰地看到Seedream系列从2.0到4.0的全链路迭代逻辑,Rocky把核心模块的演进做了完整的对比汇总,一目了然:
| 核心维度 | Seedream 2.0 | Seedream 3.0(迭代优化) | Seedream 4.0(范式革新) |
|---|---|---|---|
| 核心定位 | 原生中英双语文生图基座 | 原生2K高分辨率全维升级文生图模型 | 多模态统一图像生成系统 |
| 核心解决痛点 | 模型偏科、中文文本渲染拉胯、中国文化理解缺失 | 复杂prompt对齐不足、细粒度排版短板、分辨率限制、美学保真度不足 | 单任务架构瓶颈、多模态能力缺失、专业场景知识生成不足、高分辨率推理效率低 |
| 数据处理核心技术 | 四大数据组件、三级清洗、主动学习引擎、双轨Caption标签系统、文本渲染专项数据集 | 缺陷感知训练范式(有效数据+21.7%)、双轴协同采样框架、专业Caption标签系统升级 | 知识型数据专项Pipeline、语义+视觉联合去重、跨模态检索引擎升级 |
| 架构核心创新 | 双语LLM文本编码器、Glyph-Aligned ByT5、Scaling RoPE、MMDiT主干 | 混合分辨率训练、跨模态RoPE、流匹配目标+REPA损失、分辨率感知时间步采样 | 高压缩比高效VAE、高效可扩展DiT主干、端到端VLM PE模型、多任务统一架构 |
| 训练核心框架 | CT→SFT→RLHF→PE→Refiner五阶段后训练,CLIP基多奖励模型 | 继承五阶段框架,淘汰Refiner,VLM基规模化奖励模型,分辨率平衡训练 | 多任务联合后训练范式,多模态奖励模型,两阶段高分辨率预训练,极致的分布式训练优化 |
| 加速核心技术 | 基础量化优化 | 一致噪声期望稳定采样、重要时间步学习采样,1K生成3秒 | 两阶段对抗加速框架、自适应4/8比特混合量化、VLM投机解码优化,2K生成最快1.4秒,比3.0提速10倍+ |
| 核心分辨率能力 | 原生512,Refiner超分到1024 | 原生2K,兼容更高分辨率 | 原生1K-4K,自适应宽高比 |
| 文本渲染核心指标 | 中文可用率91%,准确率78%,命中率82% | 中英双语可用率94%,中文可用率+16%,小字/长文本排版超越人工模板 | 专业级文本渲染,支持公式、图表、多段落排版,端到端文本编辑能力 |
| 核心榜单成绩 | 中英双语评测全面领先同期模型 | Artificial Analysis竞技场ELO 1158,全球第一 | Artificial Analysis文生图+图像编辑双榜第一 |
| 配套能力 | 基于SeedEdit的基础图像编辑,人脸ID优化 | 图像编辑能力升级,人像写实能力与Midjourney并列第一 | 单模型统一文生图、单图/多图编辑、多图参考/输出、可控生成全能力 |
从Seedream 2.0到4.0,我们能清晰地看到一条完整的、自主可控的AIGC图像大模型技术演进路线:
- 第一步,Seedream 2.0从底层解决了中英双语原生理解、中文文本渲染、中国文化内涵捕捉的行业痛点,打造了属于自己的技术底座,实现了从0到1的突破;
- 第二步,Seedream 3.0在底座之上,实现了分辨率、美学、速度、文本渲染的全维升级,实现了从1到100的优化提升,登顶全球榜单;
- 第三步,Seedream 4.0直接打破了AIGC行业的架构范式,用单一模型实现了多模态多任务的统一生成,实现了从100到N的范式革新,重新定义了AIGC图像大模型的能力边界。
更重要的是,Seedream系列的所有技术创新,都是针对国内用户的核心需求、行业的真实痛点,做的全链路原创设计,实现了"用技术解决真实问题",也为AIGC图像领域的持续发展,提供了一套完整的、可参考的技术路径。
4. 深入浅出完整讲解Z-Image核心基础知识
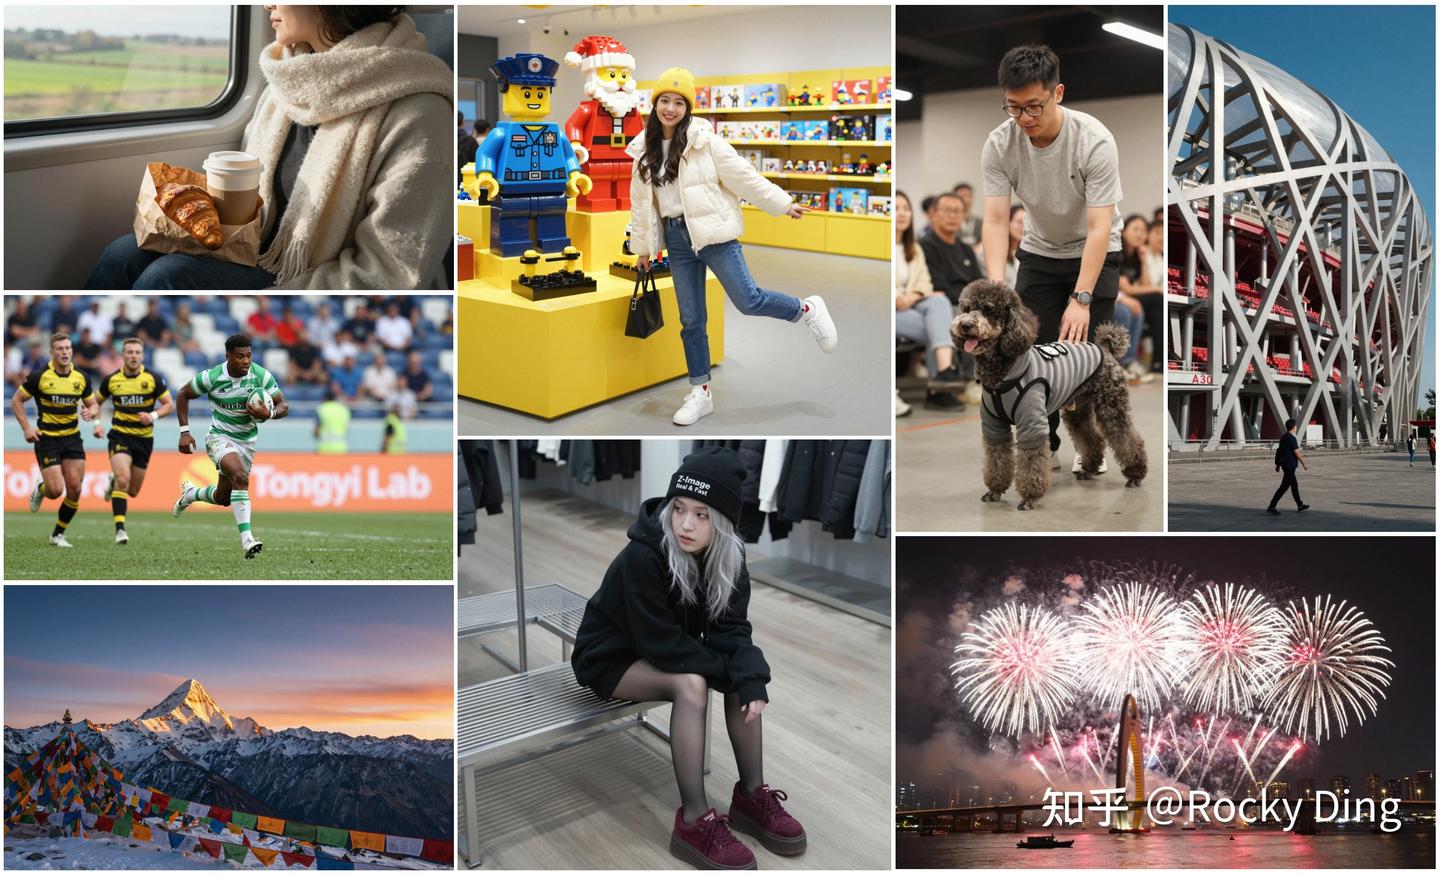
Z-Image图像生成效果示例
Z-Image是一款功能强大、效率极致的图像生成模型系列,整体参数量为60亿(6B)。目前该系列共推出4个版本,各版本定位与核心能力如下:
- Z-Image-Turbo:Z-Image-Turbo是Z-Image的蒸馏优化版本 ,仅需8次函数评估(NFE,Number of Function Evaluations,是生成式模型的核心性能指标,次数越少、生成速度越快),生成效果即可比肩甚至超越行业头部竞品。在企业级H800显卡上可实现亚秒级推理延迟,同时能完美适配显存16G的消费级硬件,无需超高配置即可流畅运行;在写实风图像生成、中英双语文字渲染、强提示词遵循度三大场景中表现尤为突出。
- Z-Image:Z-Image是Z-Image-Turbo背后的基础基座大模型,核心聚焦于高质量生成、丰富的美学表现力、极强的生成多样性与可控性,非常适配创意生成、模型微调及下游二次开发场景。 它支持丰富多样的艺术风格,可高效实现负向提示词控制,同时在人物身份、姿态、画面构图、版式设计等维度,都能实现极高的生成多样性。
- Z-Image-Omni-Base:Z-Image-Omni-Base是一款通用型基础模型,可同时支持图像生成与编辑双重任务。官方开源了模型权重,旨在充分释放社区驱动的微调与定制化开发潜力,为开源社区提供一个最"原生"、泛化能力最全面的开发起点。
- Z-Image-Edit:Z-Image-Edit是基于Z-Image专项微调而来的版本,专为图像编辑任务打造。它支持创意类图生图生成,拥有极强的指令遵循能力,可基于用户输入的自然语言提示词,完成高精度的图像编辑操作。
Z-image最大的价值是证明了AIGC时代,"小模型"也能达到很好的图像生成效果。Z-Image的提出不再是某种scaled up model"秀肌肉式"的展示,这篇工作的动机开始转向贯穿data、training、inference的部署效率问题上。
4.1 Z-Image系列模型初识
AIGC时代元年至今,AIGC图像领域陷入了一个近乎无解的"军备竞赛怪圈": 闭源AIGC图像大模型把性能卷到了新高度,却始终锁在黑盒里,普通开发者连微调的机会都没有;开源AIGC图像大模型则走上了"堆参数换效果"的不归路,从12B的FLUX.1到32B的FLUX.2,再到80B的混元Image 3.0,参数规模一路飙升,带来的是消费级显卡根本跑不动的推理门槛,和动辄数百万美元的训练成本。 更尴尬的是,很多小参数开源AIGC图像模型走了"抄近路"的捷径------用闭源AIGC图像大模型的生成数据做蒸馏,看似快速出效果,实则陷入了"能力上限被老师锁死"的闭环,永远无法超越闭源模型的边界。
就在这个时候,阿里通义MAI团队放出的Z-Image,直接给整个AIGC图像领域打了个样:
- 仅6B参数量,比主流开源模型小了5-13倍,H800上亚秒级推理,16G显存消费级显卡就能流畅运行;
- 全流程训练仅消耗314K H800 GPU小时,折算成本仅约63万美元,是同类大模型训练成本的零头;
- 登顶Artificial Analysis开源文生图榜单,总榜排名第8,力压FLUX.2 dev等一众大参数开源模型,比肩Google、字节的闭源顶流;
- 突破性的中英双语文字渲染能力,直接把文生图的"文字老大难"问题解决到了商用级别,同时在写实生成、指令跟随上做到了全球第一梯队。
这个巨大的AIGC超前认知,在整个AIGC业界都把AIGC图像生成大模型越做越大的时候,Z-Image尝试了一种逆向思维,不再跟风把模型持续scaling up,而是在6B参数的模型架构上持续打磨Data、Training、Inference的整体效率上。
Rocky认为其实这个灵感思路是有迹可循的,是有跨周期价值的。早在FLUX.1发布时,开源社区就构建了FLUX.1 Lite -8B-alpha的轻量化模型,将FLUX.1模型从12B精简到8B的参数量(通过减少FLUX.1-dev中MM-DiT Blocks的数量),再提升推理速度的同时,并不影响图像生成质量。
这给了我们什么启示呢?图像数据分布的流形维度可能没有我们想象中那么高,以至于大规模DiT-Transformer架构冗余很大,很多网络层权重对图像生成几乎不产生影响,而这给了Z-Image进行高效架构打磨提供的本质思考。
Z-Image的核心突破,不是单点的算法优化,而是彻底抛弃了文生图赛道"规模至上"的范式,从"堆算力"转向了"提效率",打造了一套全链路的效率优化体系。它的核心逻辑是:在模型生命周期的每一个环节,都最大化信息增益,最小化计算浪费,最终用极小的参数量和训练成本,拿到了比肩顶级闭源模型的效果。
整个体系由四大核心支柱构成,也是Rocky后续会逐一拆解的内容:
- 高效数据基础设施:从源头过滤无效数据,让每一个训练样本都能带来最大的信息增益,避免算力浪费;
- 高效模型架构:设计了S3-DiT单流扩散Transformer架构,最大化参数利用率,用6B参数实现了大模型的跨模态建模能力;
- 高效训练策略:三阶段渐进式训练课程,配合全流程的工程优化,让每一个GPU小时都花在刀刃上;
- 高效推理优化:通过Decoupled-DMD和DMDR两大核心算法,实现了8步极速推理,同时解决了速度与质量的经典权衡难题。
基于这套体系,Z-Image团队推出了覆盖全场景的模型家族,兼顾了社区研发、创意生成、极速推理、图像编辑四大核心需求:
| 模型版本 | 核心定位 | 核心能力 | 适用场景 |
|---|---|---|---|
| Z-Image-Omni-Base | 原生预训练基座 | 无SFT/RL,支持生成+编辑,多样性拉满,易微调 | 社区二次开发、定制化微调、多任务拓展 |
| Z-Image | 基础生成模型 | 高质量生成、强美学表现、高可控性、丰富风格支持 | 创意生成、商业设计、下游定制化开发 |
| Z-Image-Turbo | 极速推理版本 | 8步NFEs出图,亚秒级推理,极致写实、双语文字渲染、强指令跟随 | 端侧部署、交互式生成、大规模商用推理 |
| Z-Image-Edit | 图像编辑专属模型 | 精准遵循双语编辑指令,灵活的图生图创意修改 | 图像精修、创意改图、批量内容编辑 |
4.2 Z-Image的模型架构
Z-Image的核心架构基于Scalable Single-Stream Diffusion Transformer(S3-DiT,可扩展单流扩散Transformer),这是一套专为高效图像生成与编辑设计的早融合单流Transformer架构,彻底区别于传统扩散模型的双流/U-Net架构。
它通过模态统一输入、全层密集跨模态交互、轻量化高效设计,实现了6.15B参数量下对标20B-80B大模型的生成效果,同时原生兼容文生图、指令式图像编辑两大核心任务。
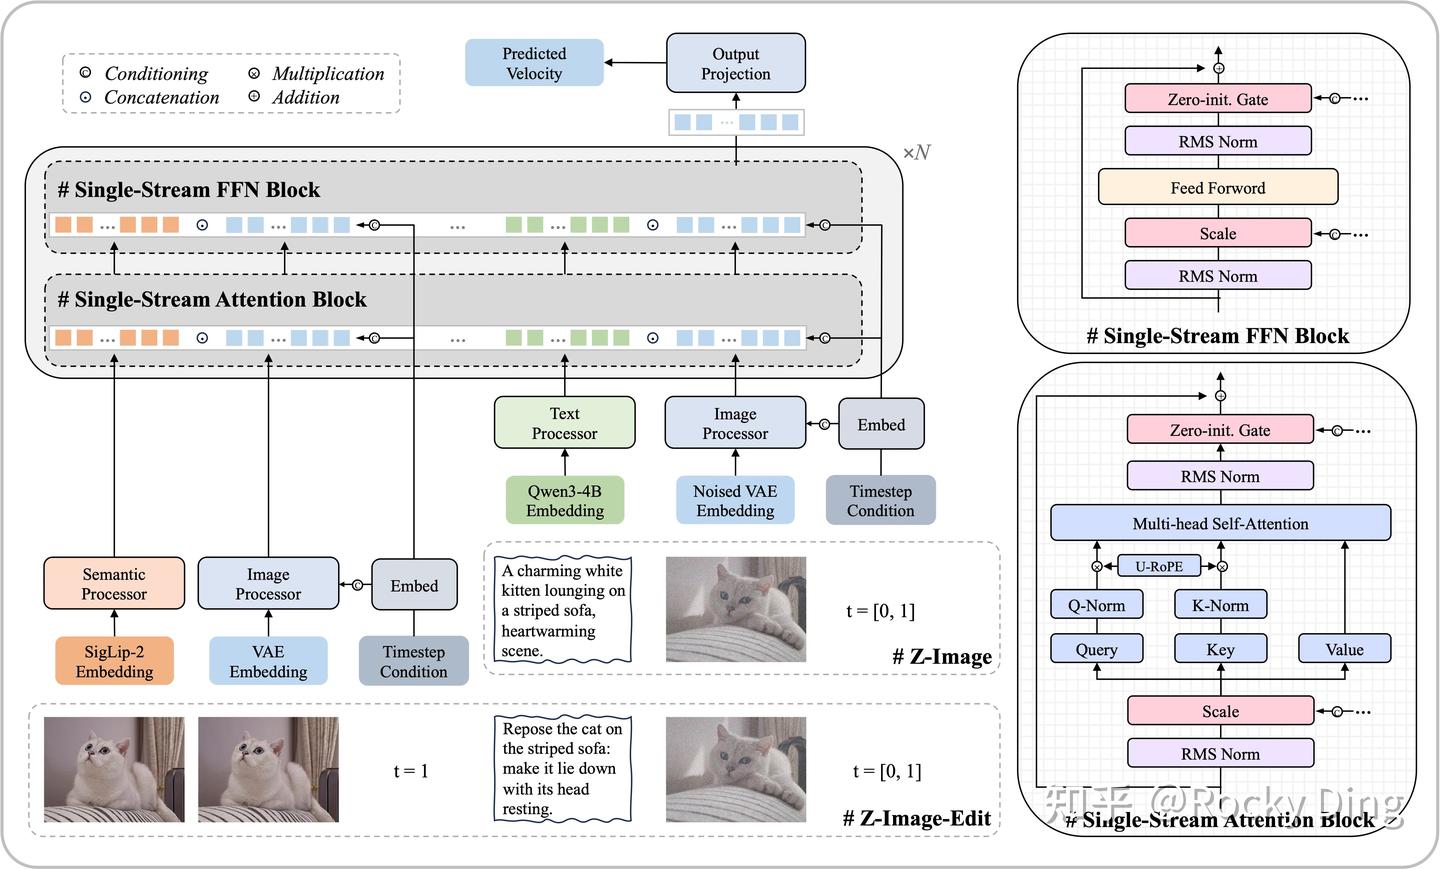
效率与稳定性是S3-DiT架构设计的两大核心锚点,具体落地为三个关键目标:
- 极致参数效率:打破"唯参数规模论",通过架构设计最大化每一个参数的利用率,用极小参数量实现顶级生成效果;
- 原生多任务兼容:在统一框架内无缝支持文生图、图生图、指令式图像编辑任务,无需为不同任务设计独立主干;
- 训练与部署友好:保证深层Transformer的训练稳定性,同时降低推理与微调的硬件门槛,最终实现16G消费级显卡即可运行。
经典扩散模型(如Stable Diffusion、FLUX)普遍采用双流架构:文本条件与图像特征分别在独立分支处理,仅通过交叉注意力层做稀疏的跨模态交互,存在参数复用率低、跨模态对齐不充分的问题。
而S3-DiT采用单流早融合范式 :将文本Tokens、图像VAE Tokens、视觉语义Tokens在序列维度直接拼接,形成统一的输入流 送入Transformer主干。这一设计让所有模态的Tokens在Transformer的每一层都能进行全连接、密集的跨模态交互,所有参数同时服务于文本理解、视觉生成、跨模态对齐,从根本上提升了参数效率,也是6B参数量能实现越级效果的核心原因。
架构的最底层是模态专属的输入编码与预处理模块,负责将文本、图像、语义信息转化为Transformer可处理的Tokens序列,同时为文生图、编辑任务提供差异化的输入适配。所有模态编码器在训练全程保持冻结,仅训练DiT主干与轻量级模态处理器,大幅降低训练显存占用与计算开销。
【文本编码模块】
- 核心编码器 :采用轻量化的Qwen3-4B作为文本编码器,核心看中其优秀的中英双语理解能力,负责将输入的自然语言提示词转化为文本嵌入向量,是模型实现强指令遵循、精准双语文字渲染的底层基础。
- 模态预处理 :文本Embeddings经过Text Processor处理------这是一个由2个Transformer块组成的轻量级模态专属处理器,负责完成文本特征的初始对齐,让文本Tokens更好地适配后续单流主干的交互模式。
【图像VAE编码模块】
- 核心编码器 :采用业界公认重建质量最优的FLUX.1 VAE,负责将像素空间的图像压缩为潜在空间的Tokens序列,同时在推理阶段将模型输出的潜在Tokens还原为像素图像。
- 模态预处理 :VAE输出的图像Tokens经过Image Processor处理,和文本处理器一致,由2个Transformer块组成,完成图像特征的初始标准化。
- 任务差异化输入:文生图任务(Z-Image)输入为加噪的VAE Embeddings ,对应扩散时间步
t ∈ [0,1];图像编辑任务(Z-Image-Edit)同时输入两路VAE Tokens,一路是t=1的干净参考图像VAE Embeddings,另一路是t ∈ [0,1]的目标加噪图像VAE Embeddings。
【视觉语义编码模块(仅编辑任务启用)】
- 核心编码器 :采用SigLIP 2多模态编码器,专门为编辑任务从参考图像中提取抽象视觉语义,保证编辑过程中主体身份、核心特征、画面一致性的保留,避免编辑后主体"变脸"、场景错乱。
- 模态预处理 :SigLIP输出的语义嵌入经过Semantic Processor(2个Transformer块)处理,转化为可融入单流序列的语义Tokens。
【时间步条件编码】
扩散模型的核心全局条件,对应流匹配目标中从高斯噪声x₀到原始图像x₁的线性插值路径。时间步t通过Embed模块转化为高维嵌入向量,作为全局条件注入到Transformer主干的每一层,控制模型的去噪/生成过程。
经过模态预处理后的文本、图像、语义Tokens,会在序列维度直接拼接,形成一个统一的输入序列,送入S3-DiT的主干网络。
主干网络由30层重复的Transformer块 堆叠而成,每一个Transformer块由**Single-Stream Attention Block(单流注意力块)和Single-Stream FFN Block(单流前馈网络块)**串联组成,整体采用Pre-Norm的结构设计,同时配套了完整的训练稳定性优化机制。
S3-DiT主干的核心配置如下:
| .配置项 | 核心参数 |
|---|---|
| 总参数量 | 6.15B |
| Transformer层数 | 30层 |
| 隐藏层维度 | 3840 |
| 注意力头数 | 32个 |
| FFN中间维度 | 10240 |
| 3D U-RoPE维度 | (32, 48, 48) |
【单流注意力块(Single-Stream Attention Block)】
这是主干网络的核心交互单元,负责实现模态内、跨模态的全信息交互,内部结构做了多项针对性优化,具体拆解如下:
- 前置RMS Norm:输入序列先经过RMSNorm归一化,论文中所有归一化操作统一采用RMSNorm,替代传统的LayerNorm,在保证归一化效果的同时降低计算开销,提升训练稳定性。
- 条件缩放(Scale):将时间步全局条件向量投影为缩放参数,对归一化后的输入特征进行调制,让全局生成条件能够影响每一层的注意力计算,是扩散条件注入的核心环节。
- QKV投影与QK-Norm:将调制后的特征投影为注意力计算所需的Query、Key、Value向量;同时对Q和K分别做独立的Q-Norm与K-Norm,规范注意力激活的数值范围,解决深层Transformer中注意力分数爆炸、训练不稳定的问题。
- 3D统一RoPE(U-RoPE):为混合模态的序列注入位置信息,是单流架构适配多模态、多任务的关键设计:
- 对图像VAE Tokens:在空间维度(宽、高)扩展位置编码,保证图像的空间结构一致性;
- 对文本Tokens:在序列/时间维度递增位置编码,适配文本的序列语义;
- 对编辑任务的参考/目标图像Tokens:为两者分配对齐的空间RoPE坐标,同时在时间维度设置单位间隔的偏移,再配合不同的时间条件值,清晰区分干净参考图像与加噪目标图像,避免编辑时的特征混淆。
- 多头自注意力(Multi-head Self-Attention):经过RoPE编码后的QKV执行多头自注意力计算。区别于传统双流架构的交叉注意力,单流架构的自注意力天然实现了文本与图像、参考与目标特征的全连接、无差别交互,让跨模态对齐更充分、更高效。
- 零初始化门控(Zero-init. Gate):注意力输出经过一个零初始化的门控层,初始阶段门控权重为0,不会对输入残差信号造成干扰,随着训练逐步学习有效权重,完美解决深层Transformer训练中的梯度消失/爆炸问题,让30层的主干网络可以平稳训练。
- 残差连接:门控后的输出与块的原始输入做残差相加,完成注意力块的计算,送入后续的FFN块。
【单流FFN块(Single-Stream FFN Block)】
负责对注意力块输出的特征进行非线性变换与特征提纯,同时配套了和注意力块一致的稳定性优化设计:
- 前置RMS Norm:和注意力块一致,先对输入做RMSNorm归一化,论文中采用Sandwich-Norm设计,在FFN块的输入和输出端都做了信号幅度约束,进一步提升训练稳定性。
- 条件缩放(Scale):同样用全局条件向量投影的scale参数,调制归一化后的输入特征,让全局条件同时影响注意力与FFN计算,保证条件注入的完整性。
- 前馈网络(Feed Forward):采用标准的Transformer前馈结构,中间维度10240,是隐藏层维度的2.67倍,为特征变换提供充足的表达能力。
- 零初始化门控(Zero-init. Gate):和注意力块的门控设计一致,保证深层网络的训练稳定性。
- 残差连接:门控后的输出与块输入做残差相加,完成一个完整的Transformer层计算。
【输出投影层】
经过30层Transformer块的特征提取后,最终的序列特征经过Output Projection 输出投影层,映射为和VAE潜在空间维度一致的向量,预测流匹配目标中的速度场vₜ = x₁ - x₀,完成扩散生成的核心预测任务。
S3-DiT采用低秩分解的adaLN调制方案,实现全局条件(时间步、文本全局特征)对主干网络每一层的精准控制,同时大幅降低参数开销:
- 核心逻辑:将输入的全局条件向量,投影为scale(缩放)和gate(门控)两组参数,分别对注意力块、FFN块中归一化后的输入与输出进行特征调制,让全局生成条件能够深度影响每一层的特征变换。
- 低秩优化 :为了降低条件注入的参数开销,将投影过程分解为低秩配对:一个共享的、层无关的下投影层 + 多个层专属的上投影层。既实现了逐层的条件调制,又避免了为每一层单独设计全连接层带来的参数冗余,进一步提升了架构的参数效率。
S3-DiT的单流架构设计,让同一个主干网络可以无缝适配文生图、图像编辑两大核心任务,仅需调整输入序列的组成,无需修改主干结构,这也是Z-Image能高效产出Z-Image、Z-Image-Edit两大变体的核心架构基础。
1. 文生图任务(Z-Image/Z-Image-Turbo)
- 输入序列组成:文本Tokens(Text Processor输出) + 加噪图像VAE Tokens(Image Processor输出);
- 核心目标:基于文本提示词,预测从噪声到目标图像的流匹配速度场,实现端到端的文生图生成;
- 架构简化:无需启用SigLIP语义编码器与Semantic Processor,输入序列更简洁,推理速度更快。
2. 图像编辑任务(Z-Image-Edit)
- 输入序列组成:编辑指令文本Tokens + 参考图像VAE Tokens + 目标加噪图像VAE Tokens + 参考图像语义Tokens(SigLIP输出);
- 核心目标:基于编辑指令与参考图像,预测目标图像的速度场,实现指令驱动的精准编辑,同时保留参考图像的核心主体与场景一致性;
- 架构适配:通过3D U-RoPE的空间对齐、时间偏移设计,让参考图像与目标图像的特征在注意力中实现精准的空间对应,保证编辑的局部修改、全局一致性保留能力。
【架构配套的训练与推理效率优化】
除了核心主干设计,Z-Image还为S3-DiT架构配套了全链路的效率优化,让小参数量模型实现极致的训练与推理性能:
- 分布式训练优化:对冻结的VAE、文本编码器采用数据并行(DP),对参数量巨大的DiT主干采用FSDP2分片策略,将优化器状态、梯度、模型参数分片到多个GPU上,大幅降低单卡显存占用;同时对全DiT层开启梯度检查点,用可接受的计算开销换取显存的大幅节省。
- 计算加速优化:用torch.compile对DiT块进行即时编译,优化算子执行效率,同时配合FlashAttention-3加速注意力计算,最终在H800显卡上实现亚秒级推理延迟。
- 混合分辨率训练优化:设计序列长度感知的批次构建策略,根据图像分辨率预估序列长度,将长度相近的样本分到同一批次,同时采用动态批量大小(长序列小批量、短序列大批量),最小化混合分辨率训练中的padding算力浪费,最大化硬件利用率。
4.3 Z-Image的数据构建流程
Z-Image的"地基",从源头解决计算浪费。很多团队做AIGC图像大模型,上来就堆架构、堆训练算力,却忽略了一个最核心的行业共识:数据的上限,决定了模型的上限;数据的效率,直接决定了训练的成本。Rocky认为这是AI行业从传统深度学习时代到AIGC时代跨越周期的箴言。
Z-Image团队最聪明的地方,就是先做了一套完整的高效数据基础设施,从源头就把"无效数据"筛掉,让每一个训练样本都能给模型带来最大的信息增益。这也是它能用极低训练成本,拿到顶级效果的核心前提。
这套数据基建,由四个协同工作的核心模块组成,Rocky带着大家逐一拆解背后的逻辑和实现:
【Data Profiling Engine(数据画像引擎):给每一张图片做"全身体检"】
这个模块的核心作用,是对海量原始数据做多维度的特征提取和量化,从技术质量、语义内容、跨模态一致性三个维度,把低质量、低信息密度的样本直接拦在训练集之外。
它做了这几件决定模型下限的关键事:
- 基础元数据与精准去重:先缓存分辨率、文件大小等基础信息,用感知哈希pHash做快速的底层去重,先把重复、近重复的图片删掉,避免无效的重复训练;
- 技术质量的多维度过滤:从压缩伪影、色偏、模糊、水印、噪声多个维度,用自研的质量评估模型做量化打分,过滤低质图;同时通过边框像素方差、JPEG重编码字节密度两种方式,计算图像信息熵,过滤掉低复杂度的图片(比如大面积纯色背景),保证训练样本的信息密度;
- 语义与美学的定向筛选:用专业标注数据训练的美学打分模型,筛选高视觉吸引力的样本;同时训练了专门的AIGC内容检测器,把AI生成的图片全部过滤掉------这一点至关重要,彻底避免了"用AI生成数据训AI"的闭环,保证了模型的原生能力上限不会被锁死;另外还做了精细化的语义标签和安全过滤,尤其是针对中国文化相关的概念做了专项优化,这也是它中文能力远超同类模型的源头之一;
- 跨模态一致性校验:用CN-CLIP计算图文对齐分数,直接扔掉图文不匹配的样本,保证文本监督信号的有效性,从源头减少模型的图文对齐误差。
更重要的是,这个引擎不是一次性的过滤工具,而是为后续的动态课程学习提供了量化基础------它给每个样本都打了复杂度标签,让模型在不同训练阶段,能吃到"刚好匹配当前能力"的数据,避免了"简单数据重复学,难数据学不会"的算力浪费。
【Cross-modal Vector Engine(跨模态向量引擎):解决数据冗余与长尾补全】
传统的去重方法,在十亿级样本面前会遇到严重的扩展性瓶颈,而且只能做表层去重,做不到语义级的冗余过滤。Z-Image团队在这里做了一个关键的架构升级,彻底解决了这个问题。
他们把传统的去重任务,重构为一个可扩展的、基于图的社区发现任务:
- 把传统耗时的range_search替换成了高效的k近邻(k-NN)搜索,基于k-NN距离构建邻接图,再用社区发现算法做聚类去重。最终在8张H800上,10亿条数据的全流程处理只需要8小时,效率直接拉满;
- 除了去重,这个引擎更核心的作用,是模型缺陷的闭环修复:当模型在某个概念、某个场景上出现生成错误时,能直接通过跨模态检索,定位到训练集中对应的缺陷数据簇,要么删掉劣质数据,要么补充对应的高质量样本,精准填补模型的能力短板,避免了盲目扩大数据集带来的成本飙升。
【World Knowledge Topological Graph(世界知识拓扑图):给模型装一个"结构化知识大脑"】
文生图模型的很多低级错误,本质上是对世界知识的理解缺失------比如分不清"松鼠鳜鱼"是一道菜,而不是"长着松鼠头的鱼",就是因为没有结构化的知识体系做支撑,只能靠字面组合做推理。
Z-Image团队专门构建了一套完整的世界知识拓扑图,作为整个数据基建的语义骨架:
- 先从维基百科的实体和超链接构建初始知识图谱,再用中心性过滤掉孤立、低引用的节点,用VLM过滤掉无法可视化的抽象概念,保证图谱的实用性;
- 再用海量图文数据的标签和文本嵌入,做自动的层级化补充,构建完整的分类树,重点补充了大量中文场景、中国文化的专属概念;
- 最后给高频用户prompt的概念做权重上调,同时主动加入新兴的、趋势性的概念,保证图谱的时效性。
这个图谱的核心作用,就是语义级的平衡采样:训练时,把每个样本的标签映射到图谱的对应节点,结合BM25分数和层级关系,计算每个样本的采样权重。这样就能保证,长尾概念、小众实体不会被高频样本淹没,既避免了模型的灾难性遗忘,又让模型的知识覆盖足够全面,不用靠堆数据集规模来补全长尾能力。
【Active Curation Engine(主动筛选引擎):让数据基建变成"自优化的闭环系统"】
前面三个模块,已经能构建出高质量的初始训练集,但Z-Image团队更进一步,做了一个主动筛选引擎,让整个数据系统能跟着模型的训练过程,持续自我优化。
这个引擎有两个核心功能,形成了完整的闭环:
- 前沿探索:自动采样识别模型表现差的"难例"和知识空白的长尾概念,比如中文里的专属菜品、地标、文化符号等容易被组合推理误解的内容;
- 闭环数据标注:针对这些难例,通过跨模态检索补充高质量样本,再通过"人在回路"的主动学习循环,不断优化标注器和奖励模型,让每一轮训练都能针对性地补全模型的短板,而不是靠盲目堆数据碰运气。
【专为编辑任务设计的高效数据构建方案】
除了文生图的基础数据,Z-Image还专门为编辑任务(Z-Image-Edit)设计了一套可扩展的数据构建策略,解决了编辑任务训练数据稀缺、多样性不足、标注成本高的行业痛点:
- 专家模型混合编辑数据:先构建完整的编辑任务分类体系,用任务专属的专家模型合成高质量训练数据,同时把多个编辑动作整合到一个样本里,让模型一次训练就能提升多个编辑能力;
- 图形化表示的零成本数据扩增:对一张输入图,合成多个不同编辑任务的输出图,再通过任意的两两组合,零成本生成大量编辑对,同时还能生成逆序对,大幅提升数据质量和训练效率;
- 视频帧天然配对数据:从海量视频帧里提取语义相关的图片组,通过余弦相似度过滤高相关的配对,天然就包含了人物姿态、场景变化等复杂编辑关系,解决了编辑任务多样性不足的问题;
- 可控文本渲染系统:专门为文本编辑任务做了可控的文本渲染系统,能精准控制文本的内容、字体、颜色、大小、位置,系统性生成大规模文本编辑配对数据,彻底解决了文本编辑的训练数据短板。
【Z-Captioner:给模型配上"精准的眼睛和嘴巴"】
数据的最后一环,就是图文描述(Caption)的质量------Caption写得好不好,直接决定了模型能不能精准理解文本指令,能不能生成符合要求的图片。
Z-Image团队专门做了一个全功能的图像描述模型Z-Captioner,从三个维度,把Caption的质量做到了极致,这也是它指令跟随能力、文字渲染能力拉满的核心原因:
- 带OCR信息的精细化描述:他们通过实验发现,Caption里明确包含OCR信息,和生成图片里的文字渲染精度直接强相关。所以他们用了类似思维链(CoT)的方式,先让模型识别出图片里的所有文字,保留原始语言不翻译,再基于OCR结果生成描述,彻底解决了长文本、多区域文本渲染的漏字、错字问题;
- 带世界知识的多级Caption:设计了标签、短句、长描述、模拟用户prompt等5种不同粒度的Caption,全部融入了世界知识,能精准识别地标、名人、知名事件,大幅减少了实体幻觉;同时不同粒度的Caption,让模型既能适配长细节prompt,也能适配用户日常的短prompt,泛化能力拉满;
- 专为编辑任务设计的差异Caption:针对图生图编辑任务,用三步思维链的方式生成编辑指令:先分别给源图和目标图生成带OCR的精细化描述,再做差异分析,最后基于差异合成简洁的编辑指令。这让Z-Image-Edit能精准理解用户的编辑需求,不会出现"改了不该改的,没改该改的"的问题。
4.4 Z-Image的训练流程
Z-Image的完整训练流程是一套端到端、分阶段、渐进式 的全链路优化体系,打破了行业"唯参数规模论"的范式,全程仅消耗31.4万H800 GPU小时(总成本约63万美元),最终产出Z-Image-Omni-Base、Z-Image、Z-Image-Turbo、Z-Image-Edit四大核心模型。
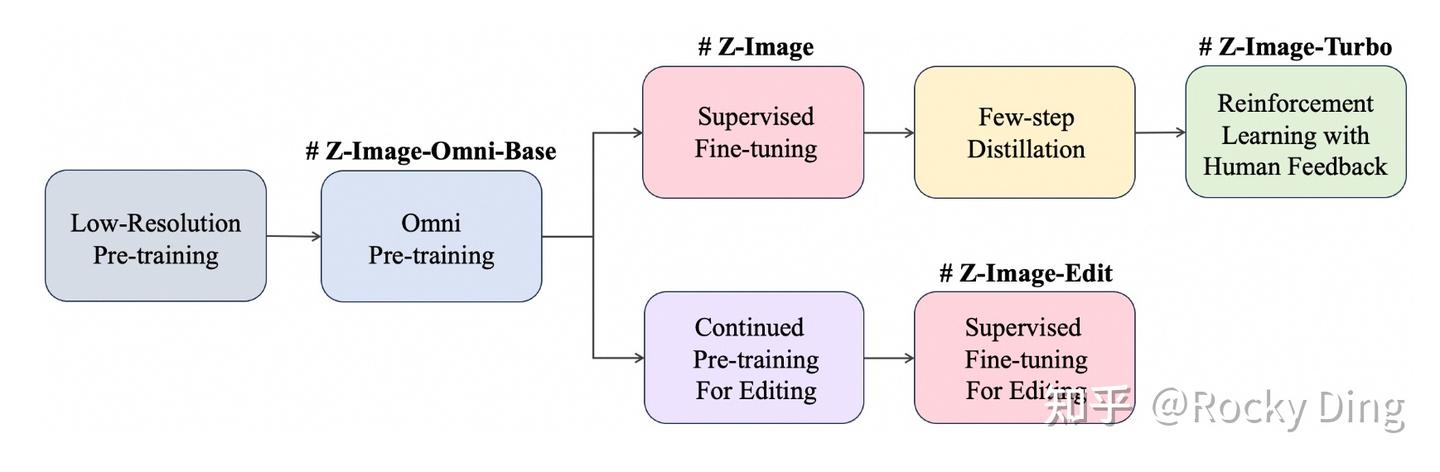
从上面的训练流程图可以看到,Z-Image的完整训练过程可分为两大前置支撑体系 、两大核心预训练阶段 、两条并行下游分支管线三大模块,各阶段环环相扣、能力逐层递进,具体拆解如下:
【训练的前置核心支撑体系】
训练的底层基础是高效数据基础设施 与S3-DiT核心架构,二者决定了模型的能力上限与训练效率,也是Z-Image实现"小参数、高性能"的核心前提。
Z-Image全程未使用其他模型的合成数据做蒸馏,完全基于真实世界数据训练,通过四大协同模块构建了全流程数据闭环,实现"正确的数据匹配正确的训练阶段",最大化数据利用效率、避免冗余计算:
- 数据画像引擎:提取图像的元数据、技术质量、信息熵、语义美学、跨模态一致性等多维度特征,实现基础过滤、去重与数据复杂度量化,为动态课程学习提供基础信号;
- 跨模态向量引擎:基于数十亿级嵌入实现大规模语义去重,同时通过跨模态检索定位模型能力缺陷、填补数据概念空白,解决长尾分布问题;
- 世界知识拓扑图:构建层级化的知识图谱,实现语义级别的均衡采样,保证训练数据的概念覆盖广度,同时为长尾概念的权重分配提供依据;
- 主动筛选引擎:形成"模型诊断-数据补全-迭代优化"的闭环,自动识别模型表现差的"困难案例",针对性补充高质量数据,同时通过人在环的主动学习持续优化标注质量。
在此基础上,团队还构建了Z-Captioner多粒度图像描述生成器,为训练数据生成带OCR信息的详细描述、融入世界知识的多层级描述、面向编辑任务的差异描述,是模型实现强指令遵循、精准双语文字渲染的核心数据基础。
【两大核心预训练阶段(模型能力地基)】
预训练阶段是Z-Image能力构建的核心,分为低分辨率预训练 与Omni全预训练两个连续阶段,最终产出通用基座模型Z-Image-Omni-Base,也是后续两条分支训练的共同起点。
第一阶段:低分辨率预训练(Low-Resolution Pre-training)
- 核心目标:为模型注入基础的视觉-语义对齐能力、基础视觉合成知识,是整个模型的"能力地基"。
- 训练设置:固定256×256分辨率,纯文生图单任务训练,消耗14.75万H800 GPU小时,占总预训练算力的50%以上。
- 核心技术细节:
- 训练目标采用流匹配(Flow Matching) 损失函数:构建高斯噪声x₀与原始图像x₁的线性插值
xₜ = t·x₁ + (1-t)·x₀,训练模型预测向量场的速度vₜ = x₁ - x₀; - 采样策略:采用对数正态噪声采样器,让训练聚焦于中间时间步;同时引入动态时间偏移策略,适配不同分辨率的信噪比变化,保证训练有效性;
- 数据输入:采用Z-Captioner生成的多粒度双语描述(标签、短描述、长描述、带OCR的详细文本),让模型同步学习基础的文本-图像对齐、物体识别、中英双语文字渲染能力。
- 阶段产出:模型掌握了基础视觉概念生成、跨模态语义对齐、中英双语基础理解能力,为后续高分辨率、多任务训练完成核心初始化。
第二阶段:Omni全预训练(Omni Pre-training)
- 核心目标:扩展模型的任意分辨率生成、多任务兼容能力,为文生图、图像编辑任务提供统一的初始化权重,是整个训练流程的"核心枢纽"。
- 训练设置:消耗14.25万H800 GPU小时,与低分辨率预训练算力基本持平,是多任务联合训练阶段。
- 核心的"Omni"三大设计:
- 任意分辨率训练:设计分辨率映射函数,将原始图像映射到预定义的训练分辨率范围,让模型在不同分辨率、不同宽高比的图像上训练,学习跨尺度视觉信息,避免固定分辨率下采样的信息损失,最终模型支持最高1k-1.5k分辨率的生成;
- 文生图+图生图联合训练:将图生图任务整合进预训练框架,利用大规模自然弱对齐图像对(视频帧配对、同场景多版本图像),学习自然图像之间的语义关系,为下游编辑任务提供极强的初始化能力,且实验证明该联合训练不会对文生图任务造成性能下降;
- 多粒度+双语描述训练:继续采用Z-Captioner的双语多粒度描述,同时以小概率融入图像原生文本元数据,增强模型的世界知识学习;针对图生图任务,按概率采样目标图像描述或配对差异描述,分别适配参考引导生成、多任务图像编辑两类场景。
- 阶段产出 :Z-Image-Omni-Base通用基座模型,同时具备任意分辨率文生图能力、基础图生图/编辑能力,是后续生成、编辑两条分支的共同起点。
【两条并行的下游分支训练管线】
从Omni-Base出发,Z-Image拆分出文生图主力模型管线 与图像编辑模型管线,分别针对生成、编辑两大核心场景做专项优化,最终产出系列落地模型。
分支一:文生图主力模型训练管线(产出Z-Image、Z-Image-Turbo)
该分支分为有监督微调、少步蒸馏、RLHF人类偏好对齐三个连续阶段,从通用基座逐步优化为极速、高质量的商用级生成模型。
阶段1:PE感知的有监督微调(Supervised Fine-tuning, SFT)
- 核心目标:将预训练阶段宽分布、高方差的生成能力,收敛到高质量、高保真、强指令遵循的子分布上,同时让模型与提示增强器(PE)深度协同,产出基础版Z-Image。
- 核心技术设计:
- 高质量对齐的分布收窄:从预训练的带噪监督,切换为严格筛选的高质量图像+超精细落地描述,强制模型丢弃低质量生成模式,严格对齐文本描述,从"最大化多样性"切换到"最大化生成质量";
- 带标签重采样的概念平衡:基于世界知识拓扑图做动态重采样,对长尾稀有概念提升采样权重、对高频概念降权,避免分布收窄过程中的灾难性遗忘,保证模型收敛的同时保留语义多样性;
- 模型融合的鲁棒性增强:微调多个偏向不同能力的SFT变体(强指令遵循、强美学渲染),在参数空间做线性插值融合,平滑损失面、中和单一模型的偏差,提升不同场景下的生成稳定性;
- PE感知联合优化:用带思维链的提示增强器(PE)优化后的描述做微调,让扩散主干与PE无缝协同,无需额外大语言模型训练,即可弥补6B参数量在世界知识、复杂推理上的局限。
阶段2:少步蒸馏(Few-step Distillation)
- 核心目标:将基础版Z-Image需要约100次函数评估(NFE)的生成过程,压缩到仅8次NFE,实现极速推理,同时不损失生成质量。
- 核心技术创新:
- 解耦DMD(Decoupled DMD):拆解传统分布匹配蒸馏的两大核心机制------CFG增强(CA,蒸馏核心驱动力)与分布匹配(DM,训练稳定正则项),为二者设计解耦的重加噪调度,完美解决传统DMD的高频细节丢失、色彩偏移问题,保证蒸馏后模型的细节保留与色彩保真;
- DMDR(分布匹配蒸馏+强化学习):将强化学习融入蒸馏过程,用DM项作为固有正则项,RL负责对齐人类审美偏好,既解锁了模型的偏好对齐能力,又有效防止了RL的"奖励黑客"问题,实现速度、质量、审美三者的平衡。
- 阶段效果:蒸馏后的模型仅需8次NFE,即可生成与100步教师模型无差异、甚至观感更优的图像,在H800显卡上实现亚秒级推理,同时完美适配16G显存的消费级硬件。
阶段3:基于人类反馈的强化学习(RLHF)
- 核心目标:进一步对齐人类细粒度审美偏好、提升指令遵循度、消除生成伪影,产出最终版Z-Image-Turbo。
- 两阶段渐进式训练:
- 前置准备:多维度奖励模型:从指令遵循能力、AI生成内容检测、美学质量三大维度构建奖励模型;其中指令遵循维度会将提示词拆解为核心主体、属性要求、动作交互、空间构图、风格渲染五个层级,通过人工标注计算元素满足率,作为核心奖励分数;
- 阶段1:基于DPO的离线对齐:聚焦文字渲染、物体计数等客观可验证维度,用VLM自动生成大规模偏好配对,经人工校验后,通过课程学习策略训练DPO,从低复杂度提示词逐步进阶到高难度场景,快速让模型对齐客观生成标准;
- 阶段2:基于GRPO的在线优化:用奖励模型的多维度分数构建综合优势函数,做在线强化学习,同时优化写实生成、美学质量、细粒度指令遵循,减少生成伪影,实现多个竞争质量维度的最优平衡。
分支二:图像编辑模型训练管线(产出Z-Image-Edit)
该分支充分复用Omni预训练的多任务能力,分为编辑任务持续预训练、编辑任务有监督微调两个阶段,无需从零训练编辑模型,高效实现高精度指令跟随编辑能力。
阶段1:面向编辑任务的持续预训练
- 核心目标:让通用基座快速适配编辑任务,学习基于自然语言指令的图像修改能力,同时保留原生的图像生成质量。
- 训练设置与核心设计:
- 训练数据:采用混合编辑数据、图形化组合配对数据、视频帧自然配对数据、可控渲染文本编辑数据,同时混入4:1比例的文生图SFT数据,避免编辑训练导致的生成质量下降;
- 训练流程:先在512×512分辨率下用全量编辑数据训练数千步,让模型快速适配编辑任务;再提升到1024×1024分辨率训练,保证高分辨率编辑的生成质量;
- 指令生成:通过Z-Captioner的三步思维链(源/目标图详细描述→差异分析→编辑指令合成),为编辑配对生成精准的自然语言指令,保证指令与图像修改的强对齐。
阶段2:面向编辑任务的有监督微调
- 核心目标:进一步提升模型的编辑指令遵循度、编辑精度,优化真实用户场景的编辑效果,产出最终版Z-Image-Edit。
- 训练细节:人工构建任务均衡的高质量编辑数据子集,重点优化局部修改、背景替换、文字编辑、主体一致性保留、风格转换等高频用户场景;同时大幅降低合成文本编辑数据的采样权重,重点用真实场景编辑数据训练,让模型深度适配真实用户的使用需求。
未完待续,Rocky会持续更新补充!!!欢迎大家多多点赞!!!
5. 深入浅出完整讲解GLM-Image核心基础知识
GLM-Image是一个混合架构的AIGC图像生成大模型,采用了自回归(AR) 主干+ 扩散(Diffusion)解码器的解耦式混合架构设计 ,能够生成高保真、细节丰富的图像,在通用图像生成质量上能够媲美AIGC业界主流的基于Latent Diffusion架构的AIGC图像生成大模型同时在文字精准渲染、知识密集型专业图像生成 两大核心场景实现了显著的性能突破,尤其擅长处理需要强语义理解、复杂信息精准还原的生成任务,在画面高保真还原、细粒度纹理细节刻画上具备极强的表现力。除核心的文生图能力外,GLM-Image还原生支持丰富的各类图生图任务,包括图像编辑、风格迁移、身份保持生成及多主体一致性生成等。其中核心架构包含了:
- 自回归生成器(AR Generator):90亿(9B)参数的语言模型,基于GLM-4-9B初始化,核心负责语义对齐与全局结构生成。
- 扩散解码器(Diffusion Decoder):70亿(7B)参数的DiT架构,用于潜在空间图像解码,核心负责高清细节还原与画质增强。
- VQ-VAE编码器:用于将图像特征离散化为token。
- 视觉编码器(Vision Encoder): 用于编码输入图像。
- Glyph编码器:基于T5的文本渲染模块,提升图像中文字的准确性。
值得关注的是,GLM-Image自回归主干的全流程训练,均基于昇腾Atlas 800T A2算力设备与昇思MindSpore AI框架完成;官方基于Mindspeed-LLM框架自研了面向视觉自回归生成任务的预训练与微调全链路方案,完成了从数据预处理、模型训练到推理部署的全流程国产化适配。
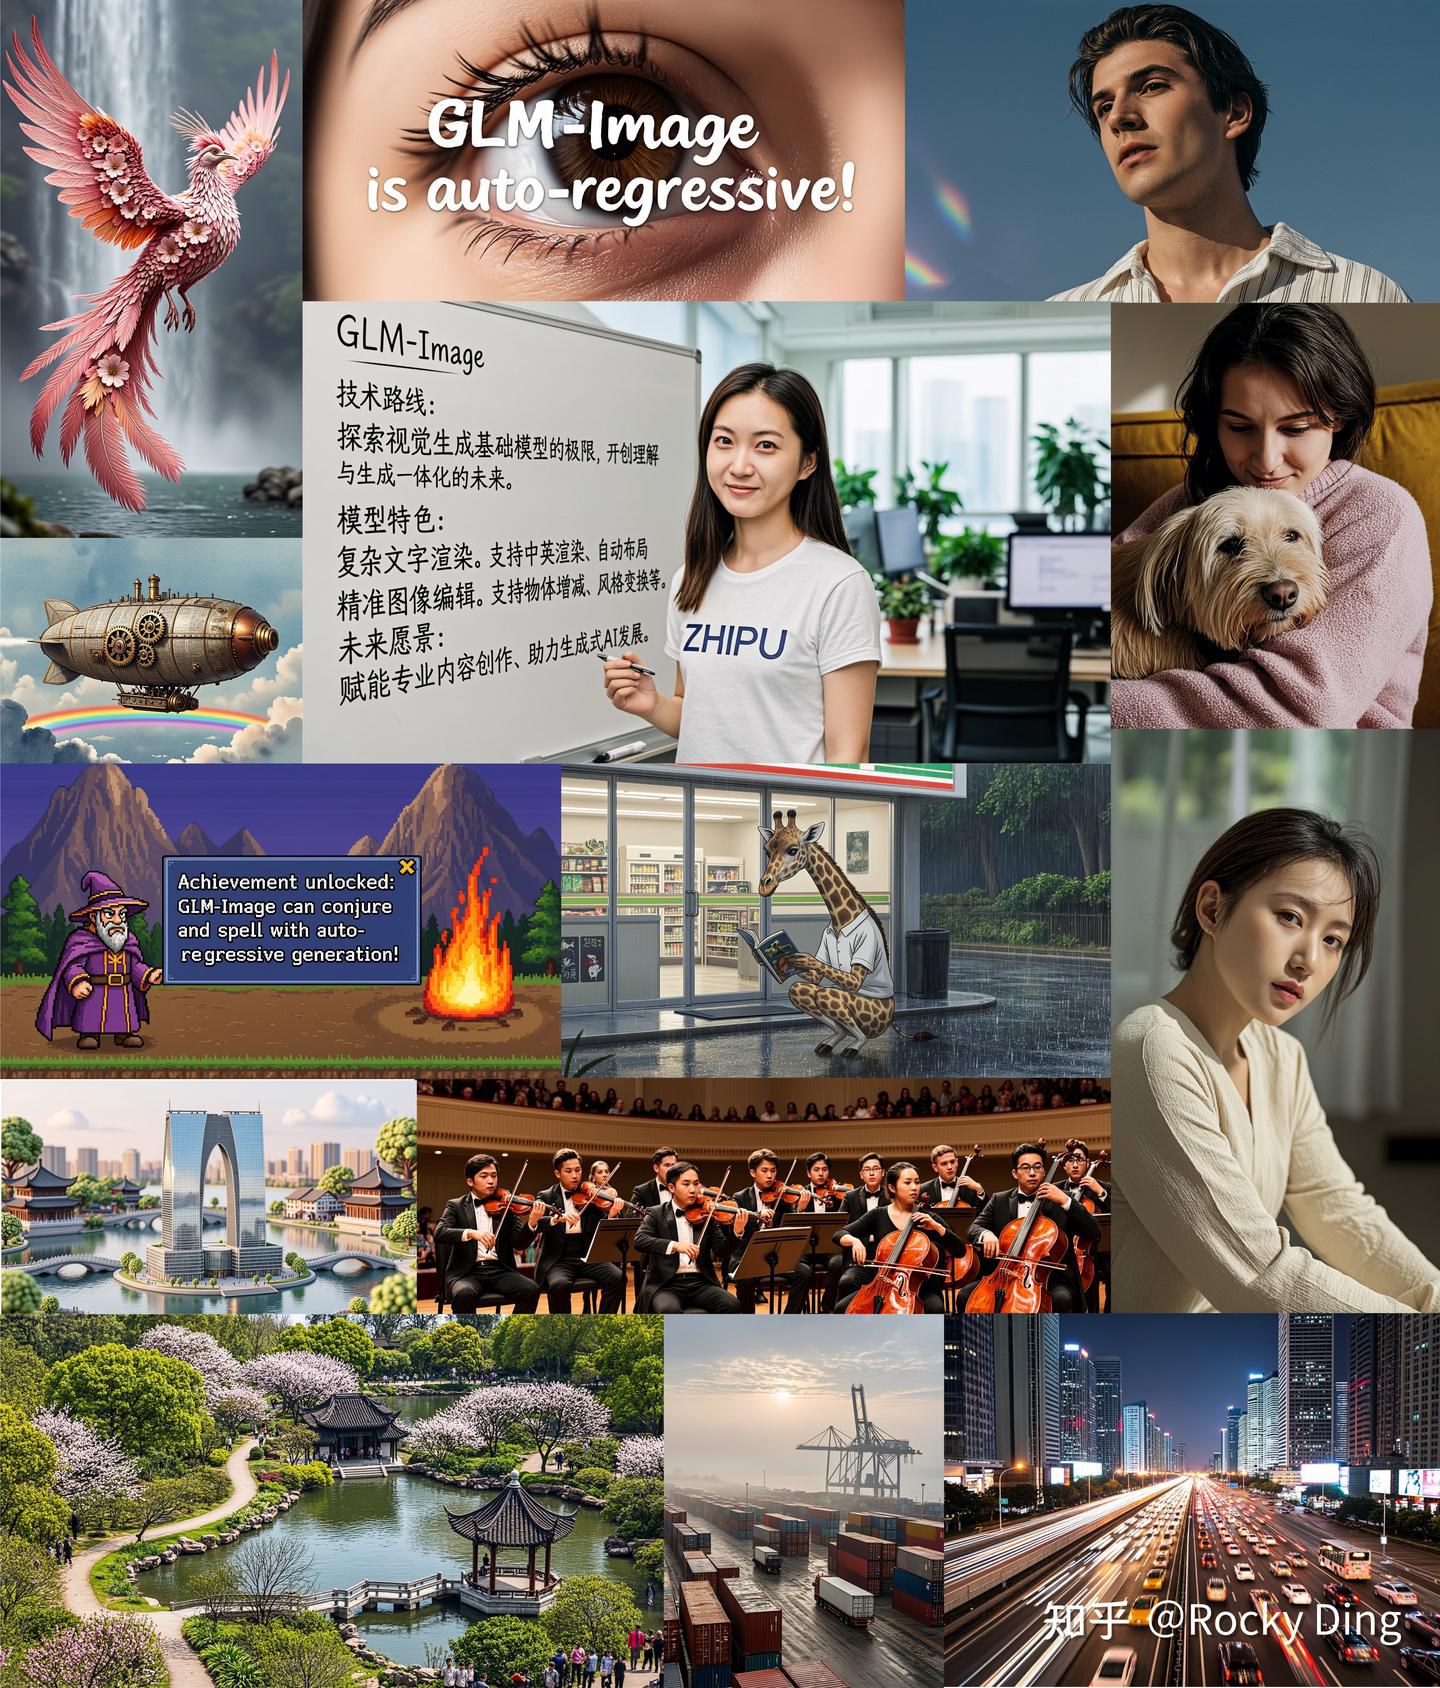
2025年AIGC行业内涌现的多款高性能闭源AIGC图像生成大模型,普遍在知识密集场景生成、画面细节质感上表现突出,而这些模型的技术底层,均展现出了自回归建模的技术特性------依托大语言模型的原生能力,实现了极强的语义理解与指令遵循能力。
基于这一行业观察,GLM-Image在架构设计之初,就将**「复杂语义信息精准理解」与「高质量画面细节生成」**作为两个解耦的核心优化目标,通过自回归生成器输出保证语义精准对齐的低频全局信息(画面布局、主体结构、核心语义),再通过扩散解码器完成高频细节的还原与画质增强,最终输出高质量生成图像。这种解耦式混合架构,不仅在通用文生图任务中实现了稳定优异的表现,更在需要强专业知识、复杂语义理解的创作场景中展现出领先优势,推动图像生成技术进入「审美质感与信息精度双向兼顾」的全新阶段。
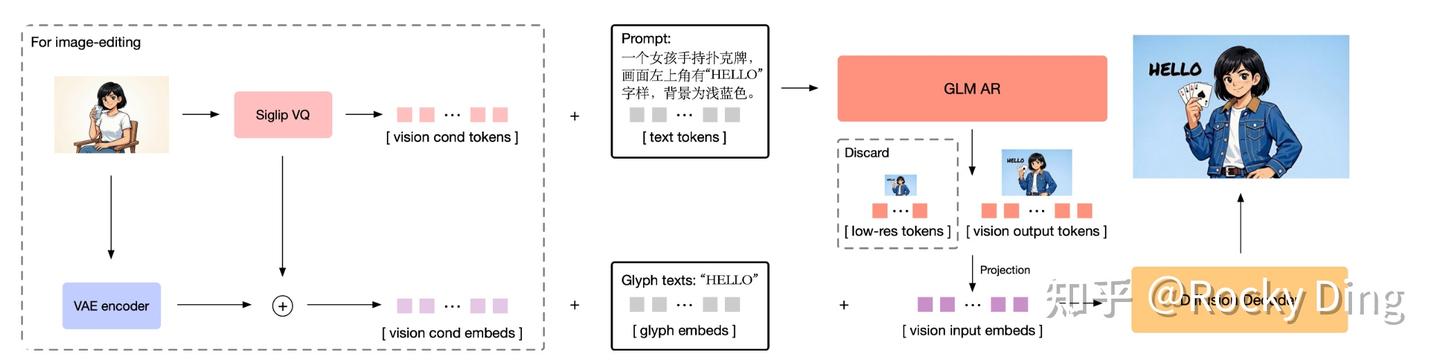
在AR+Diffusion混合架构的AIGC图像生成大模型中,整个训练和推理流程是什么样的呢?
GLM-Image采用解耦式两阶段训练策略,先完成自回归主干的训练,再单独训练扩散解码器,避免两个模块的优化目标相互干扰,保证训练稳定性与最终效果。
阶段一:GLM AR自回归主干训练
- 训练前置:模型初始化与结构适配
- 权重初始化:以GLM-4-9B-0414预训练大语言模型为基础,完整复用其Transformer主干结构与预训练权重,最大化保留模型原生的文本语义理解与长序列建模能力;
- 结构专项改造:冻结文本词嵌入层,避免预训练语义表征在微调中被破坏;新增视觉词嵌入层,完成视觉token到模型隐空间的投影映射;将原生的文本LM Head替换为视觉专用LM Head,适配视觉token的预测目标;同时将位置编码方案替换为MRoPE多模态旋转位置编码,解决文本-视觉交错序列的位置建模难题。
- 训练数据预处理与多模态条件构建
针对文生图、图生图双任务,分别构建全场景训练样本,对应架构图的不同输入分支:
- 文生图任务样本:核心输入为「文本token序列 + 目标图像对应的视觉token序列」,针对包含文字内容的样本,额外加入字形文本的glyph embeds作为辅助条件;
- 图生图/图像编辑任务样本:输入为「参考图像编码的视觉条件token/embeds + 编辑指令文本token + 目标编辑图像对应的视觉token序列」,对应架构图左侧的图像编辑分支;
- 统一图像token化:所有训练样本的目标图像,均通过XOmni的semantic-VQ tokenizer完成16×压缩比的patch切分与离散编码,得到对应分辨率的视觉token序列(256px对应256token、512px对应1024token、1024px对应4096token)。
- 分阶段多分辨率递进式训练
我们将自回归主干的训练拆分为三个递进阶段,逐步提升模型的生成能力与分辨率适配性,完美契合"先全局后细节"的视觉生成规律:
- 第一阶段:256px基础分辨率训练 该阶段输入为256px图像对应的256个视觉token,采用栅格扫描顺序(从左到右、从上到下逐行)进行自回归生成训练,核心优化目标是让模型完成从文本生成到视觉生成的能力迁移,学习基础的图文语义映射、画面全局布局与主体结构建模。
- 第二阶段:512px中高分辨率训练 该阶段引入渐进式生成策略,解决高分辨率下栅格扫描带来的生成可控性下降问题:训练时,模型先学习生成目标图像降采样后对应的256个低分辨率全局token(画面草稿),再基于该全局token生成512px对应的1024个高分辨率细节token;同时,我们针对性提升了低分辨率全局token的损失权重,强制模型优先学习全局布局与语义对齐,避免高分辨率下"细节优先、结构失控"的问题。
- 第三阶段:512px~1024px混合分辨率训练 该阶段采用动态分辨率的训练样本,token序列长度覆盖1024~4096,让模型适配不同长宽比、不同分辨率的生成需求,大幅提升泛化能力;同时延续渐进式生成策略与权重优化方案,保证超高分辨率下的生成可控性与语义对齐能力。
- 训练优化目标
自回归训练的核心优化目标为下一个token的预测交叉熵损失,针对拼接后的多模态序列,仅对目标图像对应的视觉token部分计算损失,所有条件token(文本、视觉条件、glyph嵌入)不参与损失计算;同时通过权重调整,强化低分辨率全局token的损失贡献,保证模型优先学习核心语义与全局布局。
阶段二:扩散解码器训练
在自回归主干训练收敛后,我们单独对扩散解码器进行专项训练,完成从离散视觉token到高清图像的还原能力优化:
- 训练数据构建:将训练样本的目标图像通过tokenizer编码得到视觉token,再经过投影模块得到视觉输入嵌入,作为扩散解码器的输入条件;原始高清目标图像作为扩散模型的优化目标。
- 训练核心逻辑:采用CogView4的单流DiT结构,以自回归模块输出的视觉嵌入为条件,进行扩散去噪训练,核心优化目标是还原图像的高频细节、纹理质感与高清画质;将自回归模块输出的16×压缩的隐空间特征,通过32×上采样放大,最终还原为1024px~2048px的超高清图像。
结合架构图示例,我们分别对文生图 、图生图/图像编辑两大核心场景的全链路推理流程进行拆解:
场景一:文生图(text-to-image)推理全流程
以示例中的提示词"一个女孩手持扑克牌,画面左上角有"HELLO"字样,背景为浅蓝色。"为例,完整推理步骤如下:
- 多模态条件输入编码
- 步骤1:提示词文本编码:将用户输入的中文提示词,送入GLM-4的文本分词器与词嵌入层,转换为固定维度的文本token序列,作为生成的核心语义条件;
- 步骤2:字形文本专项编码:提取提示词中需要渲染的文字内容"HELLO",送入字形编码模块,生成对应的glyph embeds,保障文字渲染的精准度;
- 步骤3:条件序列拼接:将文本token序列与glyph embeds进行拼接,构建完整的条件输入序列,送入GLM AR自回归主干。
- GLM AR自回归视觉token生成
- 步骤1:全局草稿生成:模型基于输入的条件序列,先自回归生成256个与目标图像等长宽比的低分辨率全局token,完成画面的整体布局、主体结构、核心元素位置的规划,确定女孩、扑克牌、HELLO文字、浅蓝色背景的整体位置与结构;
- 步骤2:高分辨率细节生成:基于生成的低分辨率全局token,模型继续自回归生成目标分辨率对应的高分辨率视觉输出token,比如生成1024px图像对应的4096个细节token,完成画面细节的填充;
- 步骤3:有效token筛选:丢弃低分辨率的冗余token,仅保留最终的高分辨率视觉输出token,送入后续投影模块。
- 特征投影与扩散解码器高清还原
- 步骤1:特征投影:将自回归输出的视觉token,通过投影模块转换为适配扩散解码器输入格式的视觉输入嵌入,完成两个模块的特征衔接;
- 步骤2:扩散去噪生成:将视觉输入嵌入送入7B参数量的扩散解码器,通过单流DiT结构的迭代去噪,完成高频细节、纹理质感的还原,同时通过32×的上采样放大,最终输出2048px的超高清生成图像。
场景二:图生图/图像编辑推理全流程
以示例中的参考图像(白衣女孩坐在椅子上喝水)为基础,结合编辑提示词进行图像改造为例,完整推理步骤如下:
- 参考图像双路径编码
- 步骤1:语义条件编码:将输入的参考图像送入Siglip VQ模块,编码得到离散的视觉条件token,提取参考图像的主体语义、身份特征、整体结构,作为编辑任务的核心参考;
- 步骤2:精细特征编码:同时将参考图像送入VAE encoder模块,编码得到图像的底层隐空间特征,与Siglip VQ的输出特征进行融合,得到视觉条件嵌入,为编辑任务提供精细的画面特征参考,保证编辑后的身份一致性。
- 编辑条件编码与序列拼接 对用户输入的编辑提示词进行文本编码,得到文本token序列;对需要渲染的文字内容进行字形编码,得到glyph embeds;最终将「视觉条件token + 编辑文本token + glyph embeds」进行拼接,构建完整的多模态条件序列,送入GLM AR自回归主干。
- 自回归编辑生成与高清还原 后续流程与文生图完全一致:模型先基于编辑条件生成全局布局token,再生成编辑后的目标图像对应的视觉输出token,经过投影模块送入扩散解码器,最终输出编辑后的高清图像,实现参考图像的内容编辑、风格迁移、主体改造等操作。
5.1 GLM-Image自回归生成(AR Generator)模块
GLM-Image的自回归生成主干网络,以GLM-4-9B-0414预训练LLM大语言模型为权重初始化基底,在此基础上构建了文生图(text-to-image)与图生图(image-to-image)双任务的联合训练范式。
选用GLM-4-9B-0414作为基座,核心是复用其在万亿级语料上习得的超强文本语义理解与长序列建模能力,从根源上保障图文生成任务的提示词对齐能力;而文生图+图生图双任务联合训练,可让模型同时具备零样本条件生成、参考图引导的编辑/重绘能力,大幅拓展了模型的场景适配边界,避免单任务训练带来的能力泛化不足问题。
视觉token化是离散自回归图像生成的核心基础------自回归模型的原生能力是处理离散序列数据,必须将连续的图像信号转换为离散的token序列,才能完成端到端的生成建模。在过往的视觉自回归生成相关研究中,主流的视觉token构建方案可分为三大类,三类方案在信息完整性与语义相关性上呈现出截然不同的特性:
- 基于离散化重构训练得到的视觉编码(代表方案为VQVAE6):这类方案以图像像素级重构为优化目标,编码得到的token保留了最完整的图像像素信息,但token与高层语义的关联度较弱;
- 基于离散化语义训练得到的视觉编码(代表方案为semantic-VQ7):这类方案以高层语义对齐为核心优化目标,编码得到的token具备极强的语义相关性,同时保留了可还原完整图像的基础信息,是信息完整性与语义相关性的平衡方案;
- 从一维特征向量中提取的统计语义特征(代表方案为DALLE28):这类方案的token与文本语义的关联度最高,但丢失了大量的图像细节信息,与单张图像的一一对应性较差。
从信息完备度来看,三类方案依次递减;而从与文本语义的匹配度、高层语义表征能力来看,三类方案则依次递增。对于视觉自回归生成模型而言,token之间的语义相关性,是决定模型训练收敛速度、最终生成质量与语义对齐能力的核心因素------这一点在隐空间扩散模型的迭代中也得到了验证,比如VAVAE5、SSVAE9等方案,均通过提升VAE隐空间特征的patch间语义相关性,实现了生成效果的显著提升。
针对自回归生成任务,在相近的码本(codebook)规模下,VQVAE编码的token与semantic-VQ编码的token,在训练过程中的损失量级存在显著差距(前者约为7,后者仅约为3),这一数据直接证明:语义导向的semantic-VQ token,在视觉自回归生成任务中具备天然的收敛优势,能让模型更快、更稳定地学习到语义与视觉特征的映射关系。而第三类一维语义特征,由于信息完备度不足,无法支撑端到端的完整图像生成,仅能用于主体一致性保持等特定辅助任务(如FLUX.1 Redux10),无法作为核心token方案。
基于上述全面的对比分析与实验验证,GLM-Image最终选定semantic-VQ作为核心视觉token化方案,具体落地采用了XOmni开源的tokenizer实现。该方案能在token建模过程中实现更优的语义相关性,为后续自回归模块的语义对齐能力打下基础;同时,我们基于该tokenizer输出的视觉token,构建了配套的扩散解码器,最终完成从离散token到高清生成图像的端到端还原。
在模型训练全流程中,官方对基座模型的文本词嵌入(text word embedding)层执行权重冻结操作,完整保留其预训练阶段习得的文本语义表征能力,其余网络层权重均开放参与梯度更新与微调;同时为适配视觉生成任务,新增专属的视觉词嵌入层(vision word embedding),完成离散视觉token到模型隐空间特征的投影映射。除此之外,官方还将基座原生的语言模型输出头(LM head)整体替换为视觉专用输出头(vision LM head),实现模型输出空间从文本token分布到视觉token分布的全适配,匹配生成式视觉任务的优化目标。
- 冻结文本词嵌入层的核心逻辑:预训练文本嵌入层已经完成了海量自然语言的语义映射,具备极强的跨领域语义编码能力,冻结操作可避免微调过程中语义表征被破坏,从根源上保证图文对齐的稳定性,防止出现提示词语义漂移问题;
- 新增视觉词嵌入层的必要性:文本token与视觉token的语义空间、数据分布存在本质差异,原生文本嵌入层无法完成视觉token的有效编码,新增专属嵌入层可实现视觉特征的精准映射,打通文本-视觉的模态壁垒;
- 替换LM Head的核心原因:原生LM Head的优化目标是预测下一个文本token的概率分布,而视觉生成任务需要预测离散视觉token的概率分布,二者输出维度、目标空间完全不同,替换输出头是模型适配视觉生成任务的核心改造。
针对文生图、图生图两类任务中,文本序列与视觉序列交错拼接带来的异构长序列位置编码难题,官方采用MRoPE(Multimodal Rotary Position Embedding,多模态旋转位置编码)作为模型的核心位置编码方案,有效解决了异构token序列的位置信息建模问题,保障文本与视觉token在序列中的相对位置关系被模型精准捕捉。
原生大语言模型的RoPE位置编码仅针对纯文本同构序列设计,而图文生成任务中,存在"文本前缀+视觉序列""文本前缀+参考图视觉序列+目标图视觉序列"等多种交错拼接格式,普通位置编码无法有效建模跨模态的相对位置关系,易导致注意力机制混乱。MRoPE针对多模态场景做了专项优化,可同时兼容文本、视觉两种不同模态的Tokens,精准建模长序列中任意Tokens的相对位置,保证自回归生成过程中注意力机制的有效性。
为了兼顾模型的生成质量、训练稳定性与高分辨率适配能力,官方采用了分阶段多分辨率的训练策略,将训练流程拆解为三个递进式阶段:**256px基础分辨率训练阶段、512px中高分辨率训练阶段,以及覆盖512px1024px区间的混合分辨率(mixed-resolution)训练阶段**。视觉token化环节,官方采用了XOmni开源的图像tokenizer,以16×的空间压缩比完成图像的patch切分(patchify)与离散编码操作;基于该压缩比,三个训练阶段中单条样本对应的视觉Token序列长度分别为256、1024,以及10244096的动态长度区间。同时,官方将后续diffusion解码器的最终上采样放大倍率设置为32倍,基于该倍率,GLM-Image模型最终可生成1024px至2048px的超高清图像。
- 分阶段训练的核心逻辑:直接训练超高分辨率图像会带来token序列长度爆炸、训练显存占用过高、模型难以学习全局布局等问题,从低到高的递进式训练,可让模型先学习基础的语义布局、物体结构与主体关系,再逐步学习细节纹理与高清画质,完全符合视觉生成任务"先全局后细节"的学习规律,大幅提升训练稳定性;
- token数量的计算逻辑:16×压缩比的tokenizer,会将H×W分辨率的图像,切分为(H/16)×(W/16)个patch,每个patch编码为1个独立视觉token。例如256px×256px的图像,切分后为16×16=256个patch,对应256个token;1024px×1024px的图像则对应64×64=4096个token,与文中序列长度完全匹配;
- 32倍放大倍率的设计价值:自回归模型生成的是离散视觉token,对应低分辨率的隐空间特征,需要通过diffusion解码器完成上采样还原为高清图像。32倍的放大倍率,可让模型用较短的token序列生成超高分辨率图像,在平衡计算量与训练成本的同时,实现超高清图像的端到端生成。
在256-token的基础分辨率训练阶段,官方采用常规的栅格扫描顺序(raster scan order)完成视觉token的自回归生成,即按照从左到右、从上到下的逐行顺序依次预测每个token。但在后续更高分辨率的训练阶段中,官方发现沿用该生成策略会出现模型生成可控性显著下降的问题,具体表现为画面主体布局错乱、语义与提示词偏离、细节生成失控等现象。
针对这一痛点,官方引入了渐进式生成策略(progressive generation strategy)对生成流程进行优化:在高分辨率视觉token序列生成之前,模型会先自回归生成约256个与目标图像等宽高比的前置视觉token,这部分token对应目标图像经过降采样处理后再通过tokenizer编码得到的低分辨率全局表征,承担着画面整体布局、主体结构与核心语义的建模作用。考虑到这部分前置token直接决定了最终生成图像的整体构图与语义一致性,但由于其序列长度短、单token损失占比低,在训练过程中容易被模型忽略,因此官方在后续的训练环节中,针对性地提升了该部分前置token的损失权重,强化模型对全局布局与核心语义的学习,最终实现了整体生成质量与生成可控性的双重提升。
- 高分辨率下栅格扫描的缺陷:高分辨率场景下,视觉token长度会呈平方级增长,直接逐行逐列的自回归生成,模型很难在生成早期把控全局布局,易出现"局部细节优先、全局结构失控"的问题,就像画画不打草稿直接细化,最终导致画面主体错位、构图崩坏;
- 渐进式生成的核心原理:本质是模拟人类绘画的"先打草稿、后细化细节"的逻辑,先生成低分辨率的全局token,把画面的整体构图、主体位置、核心语义先固定下来,再基于这个全局"草稿"生成高分辨率的细节token,从根源上避免高分辨率生成的布局失控问题;
- 权重优化的底层逻辑:自回归生成的总损失是序列中所有token损失的均值/求和,高分辨率场景下,细节token的数量是前置全局token的4~16倍,模型会自然倾向于拟合占比更高的细节token损失,而忽略决定画面成败的全局token。提升前置token的损失权重,就是强制模型优先学习全局布局与语义对齐,在保证"画得对"的基础上,再优化"画得好",实现生成质量与可控性的同步提升。
5.2 GLM-Iamge扩散解码器(Diffusion Decoder)模块
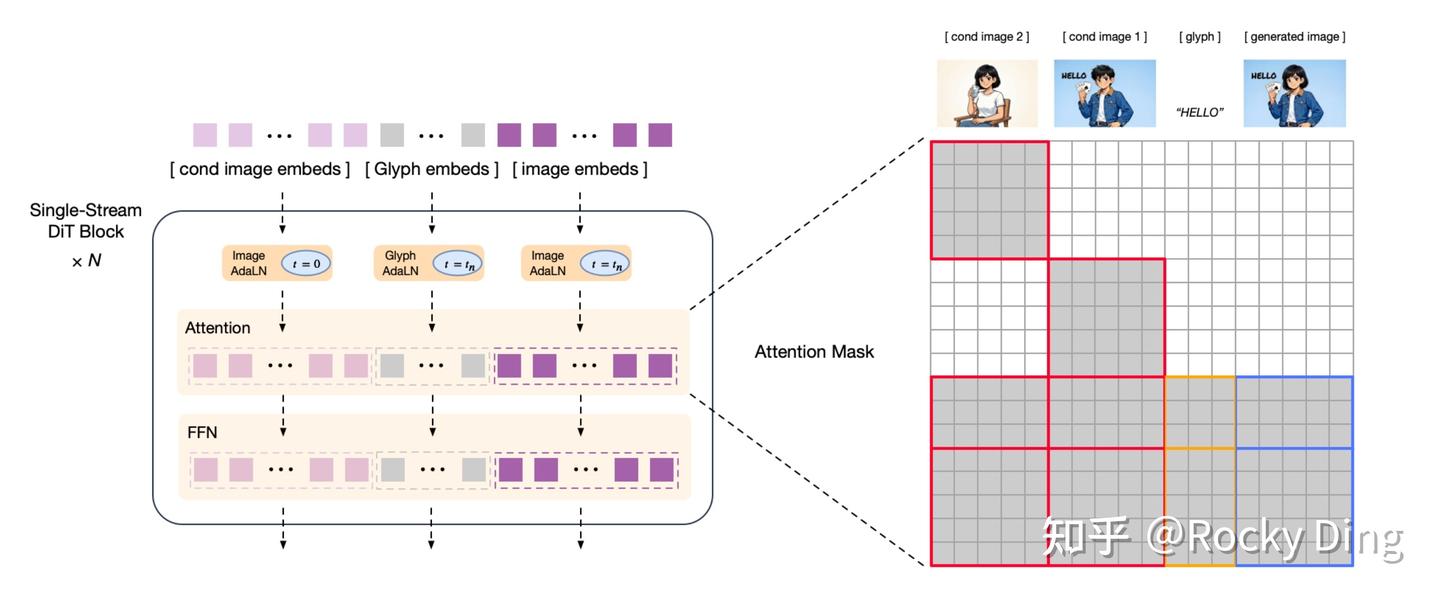
GLM-Image 的 Diffusion Decoder 采用 Single-Stream DiT(Diffusion Transformer) 架构,使用 Flow Matching 作为扩散调度策略。
在前面的自回归模块中,我们得到了Semantic-VQ Tokens,携带丰富的语义信息,同时保留了相对低频的图像布局信息,但是存在高频图像细节损失,因此需要具备生成能力的Diffusion Decoder来恢复细节。
从GLM-Image乃至AR + Diffusion的架构上来说,Diffusion Decoder具备一定的图像生成能力,能够重构目标图像和合成并恢复这些缺失的精细细节方面。这让Rocky想起了"遥远的SDXL",可以说,SDXL的Refiner模块的思想跨越周期迁移到了这里。
扩散解码器接受三种类型的输入条件:
- Conditional Image Embeds(条件图像嵌入):参考图像的 semantic-VQ tokens 和 VAE 隐变量。Semantic-VQ tokens 先经过投影层,再与 VAE 隐变量在通道维度拼接,这种模式能够保持序列长度不变,几乎不增加计算开销。Conditional Image Embeds携带丰富的语义信息和低频布局信息,但缺少高频细节。
- Glyph Embeds(字形嵌入):通过轻量级 Glyph-byT5 模型进行提取,与视觉信息在序列维度拼接,对已渲染的文本区域进行字符级编码,从而增强渲染复杂文本(尤其是中文字符)的能力。
- Image Embeds(图像嵌入):待生成图像的 VAE 隐变量(加噪后),作为扩散过程中的主要生成目标。
Single-Stream DiT Block中每个 DiT Block 包含以下组件:
- AddLN(Adaptive Layer Normalization)层:Image AddLN处理条件图像和生成图像,Glyph AddLN处理字形信息,从而分别对不同类型的嵌入进行自适应归一化。
- Attention 层:使用 块因果注意力(Block Causal Attention) 机制,从 Attention Mask 可以看到红色区域表示 条件图像内部可以互相注意(全注意力);橙色区域表示 字形信息与条件图像的交互;蓝色区域表示 生成图像与条件图像的交互;灰色区域表示生成图像内部的注意力。
- FFN(Feed-Forward Network)层表示标准的前馈神经网络,用于进一步处理和变换特征。
相比于 Qwen-Image-Edit 等模型采用的全注意力机制,GLM-Image 采用块因果注意力具有以下优势:
- 计算效率高:通过 KV Cache 技术显著降低推理开销
- 显存占用少:参考图像 token 的计算成本大幅降低
- 细节保持好:仍能保持竞争力的细节一致性
在经过多层 DiT Block 处理后,生成去噪后的 VAE 隐变量,最终通过 VAE 解码器还原为高分辨率图像。
由于 semantic-VQ tokens 已提供足够语义信息,因此Diffusion Decoder模块无需文本编码器,去除了 prompt 输入,降低显存和计算成本。同时支持双重条件输入(图像编辑任务),在图像编辑任务中,往往需要保留参考图像中的高频细节以确保编辑前后的一致性。单纯依靠 semantic-VQ tokens 所提供的语义信息,无法充分完成这种细节保持的要求。因此GLM-Image 的 DIffusion Decoder 同时使用Semantic-VQ tokens提供语义布局,VAE 隐变量保留高频细节,确保编辑前后的一致性。
GLM-Image的Diffusion Decoder完整工作流程如下所示:
python
输入阶段:
自回归模型 → semantic-VQ tokens → 投影层 → 与VAE隐变量拼接
文本区域 → Glyph-byT5 → 字形嵌入
噪声 + VAE隐变量 → 待去噪图像

处理阶段:
三种嵌入 → Single-Stream DiT Blocks (N层) → 块因果注意力 + FFN

输出阶段:
去噪后的VAE隐变量 → VAE解码器 → 最终图像
5.3 GLM-Image的Auto-Regressive + Diffusion架构的后训练策略
在模型后训练阶段,GLM-Image采用解耦的强化学习方案,对自回归模块与扩散解码器实施独立优化,进而同步提升模型的语义匹配精度与视觉细节呈现效果。该强化学习流程依托GRPO算法搭建,为两个模块分别配置了定制化反馈信号。针对扩散解码器,GLM-Image引入flow-GRPO算法------这是标准LLM GRPO的改进变体,专门为扩散模型的强化学习训练场景设计,能够精准适配其训练需求。
自回归模块聚焦低频奖励信号,核心目标是引导语义一致性与美学呈现效果,进而强化模型对指令的遵循度及艺术创作能力。在奖励信号的设计上,该模块整合了多维度奖励来源:通过HPSv3模型完成美学量化评分,借助OCR技术提升文字渲染的精准度,利用VLM模型对生成内容的整体语义合规性进行评估。与之对应,扩散解码器模块以高频奖励信号为核心,着力优化细节呈现的保真度与文字渲染的精准度。其通过LPIPS指标提升感知纹理与细节的相似度表现,结合OCR信号进一步强化文字生成的准确性,同时引入专用手部评分模型,优化生成手部的结构合理性,解决手部生成的结构偏差问题。
5.4 GRPO算法原理及在AIGC图像生成领域的应用
GRPO(Group Relative Policy Optimization,组相对策略优化 )是由DeepSeek团队提出的一种不包含价值网络的轻量化强化学习(RL)算法 ,作为PPO(近端策略优化)的核心变体,其摒弃了传统RL的价值网络设计,通过组采样 和相对奖励归一化 实现高效的优势估计,大幅降低计算/内存开销(仅为PPO的约50%),同时保持训练稳定性。该算法最初为大语言模型推理优化设计,后因高效性、高稳定性的特点,被广泛适配于AIGC图像生成领域,成为扩散模型、自回归Transformer、自回归Transformer + 扩散模型等主流AIGC图像生成大模型架构的核心优化算法。
GRPO的核心创新是用"组内相对奖励估计"替代"价值网络的绝对价值估计" ,同时保留PPO的CLIP机制和KL散度约束来保证策略网络更新的平稳性,整体遵循"策略网络建模→组采样生成→相对奖励计算→优势估计→策略更新"的逻辑链,不包含价值网络的设计使其无需额外训练价值网络,从根本上简化了训练流程、降低了计算成本。
【1.1 核心思想】
- 将待优化的AIGC图像生成大模型视为策略网络(Actor),输入为任务观测(比如文生图的纯文本Prompts,图生图的文本Prompts + 参考图),输出为动作序列(如图像的Token序列、采样步骤参数);
- 对同一观测,生成一组(G个)多样化的动作样本(图像),形成样本组,通过奖励模型为每个样本打分;
- 对组内奖励进行归一化处理 ,得到每个样本的相对优势值(无需价值网络参与),优势值的正负表示该样本相对组内平均水平的优劣;
- 结合PPO的CLIP机制和KL散度约束,以相对优势值为优化目标,更新策略网络参数,让模型向组内更优的生成策略靠拢。
GRPO的数学建模围绕策略网络定义 、组采样与奖励计算 、相对优势估计 、目标函数与策略更新 四大核心模块展开,所有公式均基于离散动作空间(适配图像生成的Token序列),也可迁移至连续动作空间(如扩散模型的采样参数)。
【模块1:策略网络定义】
在AIGC图像生成领域中,图像生成大模型(扩散/自回归/自回归+扩散等)被直接建模为策略网络 ,记为 π θ ( a ∣ c ) \pi_\theta(a|c) πθ(a∣c),其中:
- θ \theta θ:为策略网络的可学习参数。
- 输入 c c c:任务观测,文生图场景下为文本Prompts,图生图场景下为Prompts + 参考图像特征。
- 输出 a a a:动作序列 ,即生成的图像对应的离散Tokens序列(如图像patch token),记为 a = a 1 , a 2 , . . . , a T a=a_1,a_2,...,a_T a=a1,a2,...,aT, T T T为Token序列长度。
策略网络的输出为动作序列的联合概率 ,遵循自回归生成的马尔可夫性(第 t t t步的动作仅依赖于观测 c c c和前 t − 1 t-1 t−1步的动作): π θ ( a ∣ c ) = ∏ t = 1 T π θ ( a t ∣ c , a < t ) \pi_\theta(a|c) = \prod_{t=1}^T \pi_\theta(a_t|c, a_{<t}) πθ(a∣c)=∏t=1Tπθ(at∣c,a<t)
其中 a < t = a 1 , a 2 , . . . , a t − 1 a_{<t}=a_1,a_2,...,a_{t-1} a<t=a1,a2,...,at−1为前 t − 1 t-1 t−1步的动作Token子序列; a t a_t at 表示第 t t t 步生成的token; π θ ( a t ∣ c , a < t ) \pi_\theta(a_t|c, a_{<t}) πθ(at∣c,a<t)为第 t t t步生成token a t a_t at的条件概率。
【模块2:组采样与奖励计算】
GRPO的核心突破在于无需价值网络的优势估计 ,通过组内相对比较来替代绝对价值判断,其中核心步骤是组采样,目的是为同一任务观测生成多样化样本,通过组内相对比较消除绝对奖励的噪声,提升优势估计的稳健性。
- 组采样 :对同一观测 c c c,利用当前策略网络 π θ o l d \pi_{\theta_{old}} πθold生成 G G G个独立的动作样本(即 G G G张不同的生成图像),记为样本组 O = { o 1 , o 2 , . . . , o G } \mathcal{O}=\{o_1,o_2,...,o_G\} O={o1,o2,...,oG},其中每个样本 o i = ( a i , R i ) o_i=(a_i, R_i) oi=(ai,Ri), a i a_i ai为第 i i i个样本的动作Token序列, R i R_i Ri为其对应的奖励值;
{ a 1 , a 2 , . . . , a G } ∼ Independent Sampling ( π θ o l d ( ⋅ ∣ c ) ) \{a_1,a_2,...,a_G\} \sim \text{Independent Sampling}(\pi_{\theta_{old}}(\cdot|c)) {a1,a2,...,aG}∼Independent Sampling(πθold(⋅∣c))组大小 G G G为超参数,AIGC图像生成中通常取 4 ≤ G ≤ 64 4 \leq G \leq 64 4≤G≤64(目前主流设置为 G = 16 G=16 G=16), G G G过小会导致相对优势估计噪声大, G G G过大会增加计算开销。 - 奖励计算 :通过奖励模型 为每个样本 a i a_i ai计算标量奖励 R i R_i Ri,奖励模型是预训练的打分模型(如AIGC图像生成领域中的PickScore、HPSv3等审美评分模型以及BLIP-2等语义对齐模型),奖励值的高低代表生成图像的优劣(如语义对齐度、美学质量、真实性) 。 对于多维度奖励需求(如同时优化语义对齐和美学质量),需先对各维度奖励做归一化再加权融合,避免单一维度主导优化:
R i = ∑ k = 1 K w k ⋅ R i k − μ k σ k R_i = \sum_{k=1}^K w_k \cdot \frac{R_i^k - \mu_k}{\sigma_k} Ri=∑k=1Kwk⋅σkRik−μk
其中 R i k R_i^k Rik为第 i i i个样本在第 k k k维的奖励值; μ k / σ k \mu_k/\sigma_k μk/σk为第 k k k维奖励在训练集上的均值/标准差; w k w_k wk为第 k k k维奖励的权重( ∑ k = 1 K w k = 1 \sum_{k=1}^K w_k=1 ∑k=1Kwk=1),由AIGC任务需求决定(如语义密集型任务提升 w 语义 w_{语义} w语义)。
【模块3:相对优势估计】
GRPO摒弃了传统RL的价值网络 V ϕ ( c ) V_\phi(c) Vϕ(c)和优势函数 A t = R t − V ϕ ( c ) A_t = R_t - V_\phi(c) At=Rt−Vϕ(c) ,通过组内奖励的归一化 直接计算相对优势值 ,这是GRPO与PPO、DPO的核心区别。 对样本组 O \mathcal{O} O的奖励集 { R 1 , R 2 , . . . , R G } \{R_1,R_2,...,R_G\} {R1,R2,...,RG},先计算组内均值 μ R = 1 G ∑ i = 1 G R i \mu_R = \frac{1}{G}\sum_{i=1}^G R_i μR=G1∑i=1GRi和组内标准差 σ R = 1 G ∑ i = 1 G ( R i − μ R ) 2 \sigma_R = \sqrt{\frac{1}{G}\sum_{i=1}^G (R_i - \mu_R)^2} σR=G1∑i=1G(Ri−μR)2 ,则第 i i i个样本的全局相对优势值为:
A ^ i = R i − μ R σ R \hat{A}_i = \frac{R_i - \mu_R}{\sigma_R} A^i=σRRi−μR
若需对每个Token步 进行精细化优化(如自回归图像生成的长序列Tokens),将全局优势值均匀分配至每个动作步,得到第 i i i个样本第 t t t步的步长级相对优势值:
A ^ i , t = A ^ i T \hat{A}_{i,t} = \frac{\hat{A}_i}{T} A^i,t=TA^i
相对优势值的物理意义: A ^ i , t > 0 \hat{A}{i,t}>0 A^i,t>0表示该Token步的生成策略优于组内平均水平, A ^ i , t < 0 \hat{A}{i,t}<0 A^i,t<0表示劣于组内平均水平,策略模型的优化目标是让正优势值的Token步概率提升,负优势值的Token步概率降低。
【模块4:目标函数与策略更新】
GRPO的目标函数基于PPO的CLIP机制 设计,同时加入KL散度约束 ,防止策略网络更新幅度过大导致的"策略漂移"(生成质量骤降、多样性丢失),最终目标是最大化带约束的相对优势期望。
- 定义策略网络比例因子 :第 i i i个样本第 t t t步的新策略网络与旧策略网络的概率比值,反映策略网络更新的幅度:
r i , t ( θ ) = π θ ( a i , t ∣ c , a i , < t ) π θ o l d ( a i , t ∣ c , a i , < t ) r_{i,t}(\theta) = \frac{\pi_\theta(a_{i,t}|c, a_{i,<t})}{\pi_{\theta_{old}}(a_{i,t}|c, a_{i,<t})} ri,t(θ)=πθold(ai,t∣c,ai,<t)πθ(ai,t∣c,ai,<t)
其中 π θ \pi_\theta πθ为更新后的新策略, π θ o l d \pi_{\theta_{old}} πθold为更新前的旧策略。 - GRPO核心目标函数 :对所有样本、所有Token步的优势加权和取期望,加入CLIP机制限制 r i , t ( θ ) r_{i,t}(\theta) ri,t(θ)的范围,同时加入KL散度惩罚项约束新策略网络与参考策略网络的偏离程度:
J_{\\text{GRPO}}(\\theta) = \\mathbb{E}*{\\pi* {\\theta_{old}}} \\left\[ \\frac{1}{G} \\sum_{i=1}\^G \\frac{1}{T} \\sum_{t=1}\^T \\min\\left( r_{i,t}(\\theta) \\cdot \\hat{A}*{i,t}, \\text{clip}(r* {i,t}(\\theta), 1-\\epsilon, 1+\\epsilon) \\cdot \\hat{A}*{i,t} \\right) - \\beta \\cdot \\text{DKL}(\\pi* \\theta \|\| \\pi_{\\text{ref}}) \\right\] \\
其中关键超参数与符号含义:
- clip ( x , l , u ) \text{clip}(x, l, u) clip(x,l,u):PPO的裁剪函数,若 x < l x<l x<l取 l l l,若 x > u x>u x>u取 u u u,否则取 x x x, ϵ \epsilon ϵ为裁剪系数(AIGC图像生成领域中通常取 ϵ = 0.2 \epsilon=0.2 ϵ=0.2),作用是限制策略更新幅度,防止过度优化;
- π ref \pi_{\text{ref}} πref:参考策略网络 ,通常为初始预训练的AIGC图像生成大模型(或旧策略网络 π θ o l d \pi_{\theta_{old}} πθold),作用是保持AIGC图像生成大模型的基础能力;
- DKL ( π θ ∣ ∣ π ref ) \text{DKL}(\pi_\theta || \pi_{\text{ref}}) DKL(πθ∣∣πref):新策略网络与参考策略网络的KL散度,衡量两个策略网络的分布差异;
- β \beta β:KL散度的惩罚系数(AIGC图像生成领域中通常取 0.01 ≤ β ≤ 0.1 0.01 \leq \beta \leq 0.1 0.01≤β≤0.1), β \beta β过小会导致策略漂移, β \beta β过大会限制模型探索,难以提升性能。
策略更新 :通过梯度上升 最大化目标函数 J GRPO ( θ ) J_{\text{GRPO}}(\theta) JGRPO(θ),更新策略网络的参数 θ \theta θ:
θ ← θ + α ⋅ ∇ θ J GRPO ( θ ) \theta \leftarrow \theta + \alpha \cdot \nabla_\theta J_{\text{GRPO}}(\theta) θ←θ+α⋅∇θJGRPO(θ)
其中 α \alpha α为学习率,AIGC图像生成中通常采用余弦退火策略衰减学习率,避免训练后期震荡。
这里可能会有读者有疑问,为什么要通过梯度上升来最大化目标函数呢?不应该是最小化吗?Don't worry,Rocky接下来将为大家娓娓道来。
在GRPO(以及绝大多数策略梯度类强化学习算法 )中,采用梯度上升 最大化目标函数,是由强化学习的核心目标 、GRPO目标函数的数学定义 以及策略优化的物理意义 共同决定的。强化学习的本质是「最大化收益」,而非「最小化误差」。
强化学习(RL)与监督学习(SL)的优化目标完全相反,这是梯度上升的根本原因:
- 监督学习:最小化「损失函数」→ 梯度下降
监督学习的目标是缩小模型输出与真实标签的误差 ,因此定义损失函数(Loss Function,如交叉熵、MSE等)衡量误差大小,优化目标是:
min θ L ( θ ) = E ( x , y ) ∼ D Loss ( f θ ( x ) , y ) \min_\theta \mathcal{L}(\theta) = \mathbb{E}_{(x,y)\sim D} \\text{Loss}(f_\\theta(x), y) θminL(θ)=E(x,y)∼DLoss(fθ(x),y)
误差越小,模型性能越好,因此用梯度下降更新参数,沿损失函数梯度的反方向走,让损失持续减小:
θ ← θ − α ⋅ ∇ θ L ( θ ) \theta \leftarrow \theta - \alpha \cdot \nabla_\theta \mathcal{L}(\theta) θ←θ−α⋅∇θL(θ)
- 强化学习:最大化「奖励/优势期望」→ 梯度上升
强化学习的核心目标是让策略网络做出「收益更高」的决策 ,收益由奖励(Reward)或 优势(Advantage)衡量,因此定义目标函数(Objective Function,也叫「策略目标」)衡量收益大小,优化目标是:
max θ J ( θ ) = E π θ Reward/Advantage \max_\theta J(\theta) = \mathbb{E}{\pi\theta} \\text{Reward/Advantage} θmaxJ(θ)=EπθReward/Advantage
收益越高,模型性能越好(生成图像质量越高、语义越对齐),因此必须用梯度上升 更新参数,沿目标函数梯度的正方向走,让目标函数持续增大:
θ ← θ + α ⋅ ∇ θ J ( θ ) \theta \leftarrow \theta + \alpha \cdot \nabla_\theta J(\theta) θ←θ+α⋅∇θJ(θ)
一句话总结:监督学习是「减误差」,用梯度下降;强化学习是「加收益」,用梯度上升。GRPO作为策略梯度类RL算法,天然遵循这一核心逻辑。
回顾GRPO的核心目标函数(Markdown公式):
J GRPO ( θ ) = E π θ o l d 1 G ∑ i = 1 G 1 T ∑ t = 1 T min ( r i , t ( θ ) ⋅ A \^ i , t , clip ( r i , t ( θ ) , 1 − ϵ , 1 + ϵ ) ⋅ A \^ i , t ) − β ⋅ DKL ( π θ ∣ ∣ π ref ) J_{\text{GRPO}}(\theta) = \mathbb{E}{\pi{\theta_{old}}} \left \\frac{1}{G} \\sum_{i=1}\^G \\frac{1}{T} \\sum_{t=1}\^T \\min\\left( r_{i,t}(\\theta) \\cdot \\hat{A}_{i,t}, \\text{clip}(r_{i,t}(\\theta), 1-\\epsilon, 1+\\epsilon) \\cdot \\hat{A}_{i,t} \\right) - \\beta \\cdot \\text{DKL}(\\pi_\\theta \|\| \\pi_{\\text{ref}}) \\right JGRPO(θ)=EπθoldG1i=1∑GT1t=1∑Tmin(ri,t(θ)⋅A\^i,t,clip(ri,t(θ),1−ϵ,1+ϵ)⋅A\^i,t)−β⋅DKL(πθ∣∣πref)
这个函数的每一项都指向「最大化」,我们拆解分析:
- 核心项:相对优势加权的策略更新
目标函数的核心是:
min ( r i , t ( θ ) ⋅ A ^ i , t , clip ( r i , t ( θ ) , 1 − ϵ , 1 + ϵ ) ⋅ A ^ i , t ) \min\left( r_{i,t}(\theta) \cdot \hat{A}{i,t}, \text{clip}(r{i,t}(\theta), 1-\epsilon, 1+\epsilon) \cdot \hat{A}_{i,t} \right) min(ri,t(θ)⋅A^i,t,clip(ri,t(θ),1−ϵ,1+ϵ)⋅A^i,t)
其中:
- r i , t ( θ ) = π θ ( a i , t ∣ c , a i , < t ) π θ o l d ( a i , t ∣ c , a i , < t ) r_{i,t}(\theta) = \frac{\pi_\theta(a_{i,t}|c,a_{i,<t})}{\pi_{\theta_{old}}(a_{i,t}|c,a_{i,<t})} ri,t(θ)=πθold(ai,t∣c,ai,<t)πθ(ai,t∣c,ai,<t):新策略对旧策略的概率提升比例;
- A ^ i , t \hat{A}{i,t} A^i,t:相对优势值 ( A ^ i , t > 0 \hat{A}{i,t}>0 A^i,t>0 表示该token步的生成动作「优于组内平均」, A ^ i , t < 0 \hat{A}_{i,t}<0 A^i,t<0 表示「劣于组内平均」)。
梯度上升的物理意义:
- 当 A ^ i , t > 0 \hat{A}{i,t} > 0 A^i,t>0(优质动作):最大化该项 → 让 r i , t ( θ ) r{i,t}(\theta) ri,t(θ) 增大 → 新策略对优质动作的概率提升,模型更倾向于生成组内更优的图像token/采样参数;
- 当 A ^ i , t < 0 \hat{A}{i,t} < 0 A^i,t<0(劣质动作):最大化该项 → 让 r i , t ( θ ) r{i,t}(\theta) ri,t(θ) 减小 → 新策略对劣质动作的概率降低,模型减少生成组内较差的图像token/采样参数。
这正是GRPO的核心优化逻辑:通过梯度上升,让策略向「高优势动作」靠拢,远离「低优势动作」,最终生成质量更高的图像。
- 约束项:KL散度惩罚(保证稳定)
目标函数中的 − β ⋅ DKL ( π θ ∣ ∣ π ref ) - \beta \cdot \text{DKL}(\pi_\theta || \pi_{\text{ref}}) −β⋅DKL(πθ∣∣πref) 是KL散度惩罚项,作用是限制新策略与参考策略(预训练模型)的偏离程度,防止策略漂移(生成质量骤降、多样性丢失)。
梯度上升对约束项的作用:
最大化 J GRPO ( θ ) J_{\text{GRPO}}(\theta) JGRPO(θ) 等价于最小化KL散度(因为前面有负号),即:
max θ . . . − β ⋅ DKL ( . . . ) ⟺ min θ DKL ( . . . ) \max_\theta \left ... - \\beta \\cdot \\text{DKL}(...) \\right \iff \min_\theta \text{DKL}(...) θmax...−β⋅DKL(...)⟺θminDKL(...)
这保证了模型在「提升收益」的同时,不会偏离预训练模型的基础生成能力,实现「质量提升+稳定性」的平衡。
- 整体期望:最大化「平均相对收益」
J GRPO ( θ ) J_{\text{GRPO}}(\theta) JGRPO(θ) 是样本组、token步的期望平均 ,最大化该期望,就是让模型在所有Prompt、所有生成步骤、所有样本组上,都能获得更高的平均相对优势,最终实现泛化性更强、质量更稳定的图像生成。
AIGC图像生成领域常用的RL优化算法为PPO和DPO,GRPO作为二者的融合与轻量化改进,在优势估计、计算开销、适配性上有显著优势,核心差异如下表所示:
| 算法 | 优势估计方式 | 是否需要价值网络 | 计算开销(相对PPO) | 训练稳定性 | 图像生成适配性 | 核心特点 |
|---|---|---|---|---|---|---|
| GRPO | 组内相对奖励归一化 | ❌ 无需 | 50% | 高 | 极佳(大规模模型) | 高效、稳定、泛化性好 |
| PPO | 价值网络+优势函数 | ✅ 需要 | 100%(基准) | 中 | 好 | 经典通用,但计算成本高 |
| DPO | 偏好配对的直接优化 | ❌ 无需 | 70% | 高 | 好(小样本) | 小样本高效,但泛化性略逊 |
总的来说,GRPO的无价值网络+组相对奖励设计,使其在**AIGC图像生成大模型(比如SD、FLUX、Z-Image、GLM-Image等)**的优化中表现最优,既保留了PPO的稳定性,又拥有DPO的高效性,同时解决了DPO小样本下泛化性不足的问题。
GRPO本身是通用的RL算法,需针对AIGC图像生成的主流架构(扩散模型、自回归Transformer、自回归 + 扩散模型等)做轻量适配,核心适配逻辑是将不同生成架构统一建模为"策略网络",将生成过程转化为"观测→动作→奖励"的RL范式。
接下来,Rocky先讲通用适配逻辑,再讲AIGC图像生成场景下的标准化训练流程。
【2.1 核心适配逻辑】
AIGC图像生成的主流架构分为离散token生成 (自回归Transformer)和连续采样生成 (扩散模型),GRPO对两类架构的适配仅需调整动作空间定义,其余模块(组采样、相对奖励、策略更新)完全复用,适配性极强,具体如下:
| 生成架构 | 策略网络 | 动作空间a | 观测c | 奖励模型选型 |
|---|---|---|---|---|
| 自回归Transformer | 图像Transformer | 图像patch离散token序列 | 文本Prompt | PickScore(审美)+BLIP-2(语义) |
| 扩散模型 | 扩散U-Net | 扩散步骤的连续采样参数(如噪声水平、引导尺度) | 文本Prompt+扩散步t | HPSv3(审美)+DINO(视觉特征) |
核心适配点 :扩散模型为连续动作空间 ,需将GRPO的离散策略比例因子 r i , t ( θ ) r_{i,t}(\theta) ri,t(θ)替换为连续概率密度比,同时将clip机制应用于连续动作的更新幅度,其余数学公式不变。
【2.2 GRPO在AIGC图像生成达模型中的标准化训练流程】
以扩散模型(FLUX系列)文生图 为典型场景,讲解GRPO的端到端训练流程,该流程可直接复用至其他图像生成任务,仅需调整奖励模型和超参数,流程共6步,形成生成-评估-更新的闭环迭代:
步骤1:训练前准备
- 基础模型:预训练完成的SD系列、FLUX系列、自回归Transformer等AIGC图像生成大模型(作为初始策略网络 π θ i n i t \pi_{\theta_{init}} πθinit);
- 奖励模型:融合HPSv3(美学评分)、BLIP-2(文本-图像语义对齐)、DINO(视觉特征真实性)的多维度奖励模型,预训练完成并固定参数;
- 数据集:大规模文生图Prompt数据集(如LAION-5B、MS-COCO);
- 超参数:组大小 G = 16 G=16 G=16,裁剪系数 ϵ = 0.2 \epsilon=0.2 ϵ=0.2,KL惩罚系数 β = 0.05 \beta=0.05 β=0.05,学习率 α = 1 e − 6 \alpha=1e-6 α=1e−6,迭代轮数 E = 100 E=100 E=100,每轮batch size=64。
步骤2:组采样生成图像
对每个Prompt c c c,利用当前旧策略 π θ o l d \pi_{\theta_{old}} πθold(初始的AIGC图像生成大模型),生成 G = 16 G=16 G=16张多样化的图像样本,形成样本组 O = { o 1 , o 2 , . . . , o 16 } \mathcal{O}=\{o_1,o_2,...,o_{16}\} O={o1,o2,...,o16},生成时采用随机噪声初始化保证样本多样性,避免组内样本同质化。
步骤3:多维度奖励计算与权重融合
- 对组内每张图像,分别用HPSv3、BLIP-2、DINO计算美学奖励 R 1 R^1 R1、语义奖励 R 2 R^2 R2、真实奖励 R 3 R^3 R3;
- 对各维度奖励做Z-Score归一化 ,按权重 w 1 = 0.5 w_1=0.5 w1=0.5(美学)、 w 2 = 0.3 w_2=0.3 w2=0.3(语义)、 w 3 = 0.2 w_3=0.2 w3=0.2(真实)融合,得到每张图像的最终奖励 R i R_i Ri。
步骤4:相对优势估计
计算样本组的奖励均值 μ R \mu_R μR和标准差 σ R \sigma_R σR,按公式计算每张图像的全局相对优势值 A ^ i \hat{A}i A^i,并将其分配至AIGC图像生成大模型的每个采样步 t t t(一般来说是20-50步之间),得到步长级相对优势值 A ^ i , t \hat{A}{i,t} A^i,t。
步骤5:策略网络更新
- 计算AIGC图像生成大模型每个采样步的连续策略比例因子 r i , t ( θ ) r_{i,t}(\theta) ri,t(θ)(概率密度比);
- 代入GRPO核心目标函数 J GRPO ( θ ) J_{\text{GRPO}}(\theta) JGRPO(θ),计算梯度 ∇ θ J GRPO ( θ ) \nabla_\theta J_{\text{GRPO}}(\theta) ∇θJGRPO(θ);
- 用AdamW优化器做梯度上升 ,更新AIGC图像生成达模型的参数 θ \theta θ,得到新策略网络 π θ \pi_\theta πθ;
- 若新策略网络与参考策略网络的KL散度过大(如 DKL > 0.1 \text{DKL}>0.1 DKL>0.1),降低学习率并重新更新,防止策略漂移。
步骤6:迭代优化
将新策略网络 π θ \pi_\theta πθ作为下一轮的旧策略网络 π θ o l d \pi_{\theta_{old}} πθold,并重复迭代步骤2-5,直至训练收敛(比如奖励值的组内均值不再提升、生成图像的人类评价达标)。
训练收敛标志 :连续10轮迭代中,样本组的奖励均值 μ R \mu_R μR提升幅度小于0.01,且生成图像的语义对齐率(BLIP-2打分)≥95%、美学评分(HPSv3)≥8.0(满分10)。
三、GRPO在AIGC图像生成领域的典型应用场景
GRPO因高效性、高稳定性、强适配性 的特点,已成为AIGC图像生成领域的主流RL优化算法,广泛应用于文生图模型优化、图像生成加速、跨模态生成、个性化内容创作 等核心场景。GRPO能成为AIGC图像生成领域的主流RL优化算法,核心源于其适配图像生成任务的四大特性,也是其相比PPO、DPO的核心竞争力:
- 计算效率极高:无价值网络设计,内存占用减少50%,训练速度提升70%以上,适配大规模图像生成模型(如千亿参数的GLM-Image);
- 训练稳定性强:组相对奖励归一化消除了绝对奖励的噪声,结合clip机制和KL约束,训练过程无震荡,无需复杂的超参数调优;
- 适配性极强:统一建模离散/连续动作空间,可直接复用至扩散、自回归、VAE+GAN等所有主流图像生成架构,无需大幅修改;
- 泛化性好 :组采样的多样化样本让模型学习相对更优的通用策略,而非针对单一奖励函数的过拟合,域外泛化能力(如未见过的Prompt)远超DPO。
GRPO作为无价值网络的轻量化RL算法 ,其核心创新的组相对奖励归一化设计,完美契合AIGC图像生成的任务特点------既解决了传统PPO计算成本高的问题,又克服了DPO泛化性不足的缺陷,成为连接强化学习与AIGC图像生成的核心桥梁。
6. 深入浅出完整讲解Qwen-Image系列核心基础知识
前面我们已经讨论了 GLM-Image 如何结合自回归生成与扩散解码。接下来,Qwen-Image 系列给我们提供了另一条值得系统学习的路线:把多模态理解、连续图像生成、文字渲染和可控编辑连接起来,让模型逐步承接完整的视觉创作任务。
假设我们要制作一张咖啡新品海报:主标题必须准确写出"秋日限定",价格必须是"19.9元",杯子必须来自参考图,背景要换成木质桌面,第二轮还要只改价格而保留杯身图案。这个任务会同时考验语义理解、字符准确性、空间布局、身份保持和局部编辑。模型即使能生成漂亮的咖啡照片,也未必能够交付这张海报。
**Rocky认为,Qwen-Image 系列的学习价值,在于它把"读懂要求---画出细节---保留约束---继续修改"这条链条逐步落到了模型架构、训练数据和推理机制上。**我们沿着这条主线,从初代的基础组件讲到后续版本的分层、统一生成编辑与条件缓存。
6.1 Qwen-Image系列模型初识
Qwen-Image系列制剂已经发布多个版本:
| 模型或分支 | 核心定位 | 理解时最重要的边界 |
|---|---|---|
| Qwen-Image,2025年8月 | 初代文生图基础模型,突出中英文复杂文字渲染 | 20B 指 MMDiT 生成主干,另有 Qwen2.5-VL 与 VAE |
| Qwen-Image-Edit | 在初代基础上强化指令编辑 | 发布的生成与编辑权重、pipeline 需要区分 |
| Qwen-Image-Edit-2509 / 2511 | 多图编辑、主体保持与编辑一致性的迭代 | 2509 推荐1---3张输入图;2511 是版本标识,官方发布在2025年12月,不能直接按编号推断发布日期 |
| Qwen-Image-2512 | 生成分支的写实、纹理和文字排版改进 | 生成分支升级不能自动等同于编辑分支升级 |
| Qwen-Image-Layered | 将一张图分解成可独立操作的多个 RGBA 图层 | 多图层分解与输出一张透明背景图是两种任务 |
| Qwen-Image-2.0 | 统一生成和编辑,强化复杂图文、长指令及原生2K | 用对应技术报告理解架构,不能沿用初代所有配置 |
| Qwen-Image-VAE-2.0 / 2.0-RL | 分别深入研究视觉压缩与生成后的偏好优化 | 是组件或训练方案的技术报告,不是可任意互换的完整生成模型名称 |
| Qwen-Image-2.1 | 开放权重的统一生成编辑模型,支持原生 RGBA、混合粒度注意力与前缀缓存 | 7B 是视觉生成组件;许可证为 Qwen Research License |
| Qwen-Image-3.0 | 发布材料强调长规格、复杂版面、小字及知识图解 | 产品展示不等于完整架构披露,也不据版本号推断与2.1的权重继承关系 |
6.2 Qwen-Image的整体架构
初代 Qwen-Image 可以拆成三个互相配合的核心组件:
- **Qwen2.5-VL-7B:条件编码器。**把提示词,以及编辑任务中的图像,编码成能够表达对象、属性、文字内容和修改意图的特征。
- **VAE:图像编码器与解码器。**把高分辨率像素压缩成连续 latent;生成完成后,再把 latent 还原为像素。
- **20B MMDiT:生成主干。**在条件特征的引导下,反复更新目标图像 latent,逐步从噪声得到符合要求的结果。
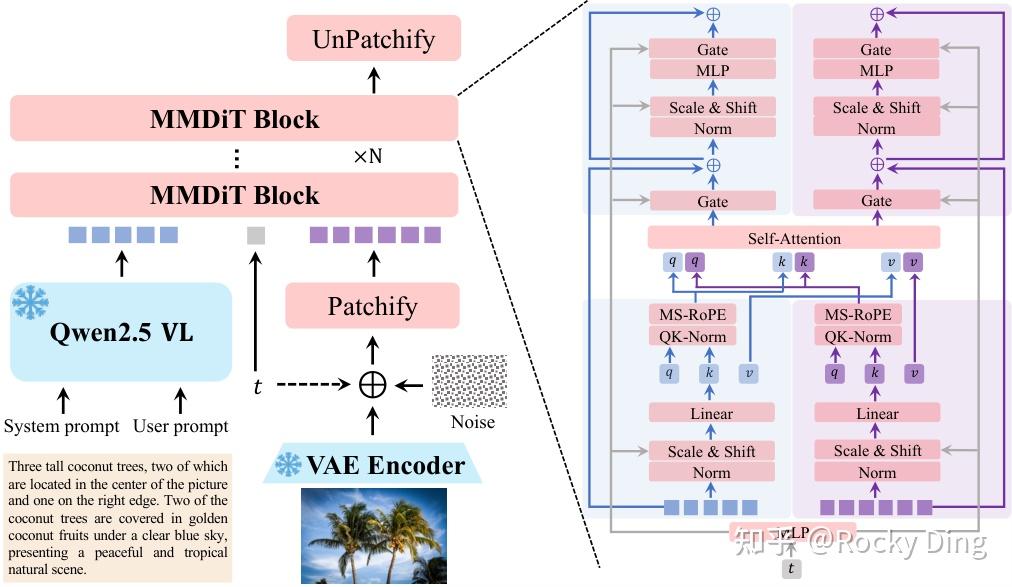
上图是初代Qwen-Image的训练架构,左侧 VAE 将训练目标图编码后加噪,纯文生图推理时直接初始化目标噪声,不需要用户先提供一张目标图,右侧展开双流 MMDiT block。
如果把这套系统类比成一个设计团队,Qwen2.5-VL 负责理解需求,VAE 决定画布的内部表达方式,MMDiT 负责逐步完成画面。这只是职责类比,三个组件在实际计算中通过张量和注意力连接。
**条件编码器会处理语言,并不意味着整张图片是逐字、自回归"说出来"的。**初代 Qwen-Image 的目标图像在连续 latent 空间中通过 Flow Matching 生成;Qwen2.5-VL 在这里主要提供末层隐藏状态,作为生成条件。它的存在不能直接推出模型会在每次出图前生成一段可见思维链。
初代配置包括60个 MMDiT block、24个注意力头、每头128维,主干注意力宽度为3072。文本特征输入维度为3584,先投影到主干使用的特征空间。文本与图像原始维度不同,只要经过相应投影,就能够进入联合注意力。
6.3 Qwen-Image的条件编码器
为什么初代选择 Qwen2.5-VL,而不简单使用一个只处理文本的编码器?论文给出了三个相关理由:语言与视觉表征已有对齐基础,语言建模能力较强,并且可以接收图像输入,从而扩展到编辑等任务。
以"左侧一个蓝色杯子,右侧一个红色杯子,红杯上写着'热可可'"为例,条件编码需要保留三类信息:两个杯子的数量和位置,颜色与杯子的绑定,以及需要逐字画出的字符串。只留下"杯子、蓝色、红色、饮品"这些笼统语义,无法充分约束正确结果。
初代使用区分任务的 system prompt:文生图强调对象颜色、数量、文字、形状及空间关系;编辑则额外强调输入图像的关键特征,以及应该如何根据指令改变它。随后提取 Qwen2.5-VL 语言主干末层的隐藏状态作为条件表示。模板的作用是组织特征提取任务;它不等于已执行一次独立的提示词重写。
这一区别在后续版本更重要:2.0另行引入 Prompt Enhancer,2.1也提供独立的生成与编辑提示词增强模型。隐藏状态编码与先生成一段增强后的提示词,是两个可以组合、但不能混为一谈的环节。
用更强的条件编码器,还要付出推理和显存成本。冻结参数只表示训练时不更新这些参数;服务时仍需要加载或调用编码器、计算条件。讨论"20B模型"或者"7B模型"的部署成本时,必须说明是否包含编码器和 VAE。
6.4 Qwen-Image的VAE
生成模型在像素空间直接处理一张1024×1024图像的代价很高,因此通常先把图像压缩到更小的 latent 网格。初代采用基于 Wan2.1-VAE 的视觉表示,空间下采样8倍,latent 通道数为16,即常见的 f8c16。
忽略批次与时间维度,图像的编码与解码可以写成:
z = E ( x ) , x ^ = D ( z ) , z ∈ R ( H / f ) × ( W / f ) × C . z=E(x),\qquad \hat{x}=D(z),\qquad z\in\mathbb{R}^{(H/f)\times(W/f)\times C}. z=E(x),x^=D(z),z∈R(H/f)×(W/f)×C.
这里,E 和 D 分别是 VAE 编码器、解码器,f 是空间下采样倍率,C 是 latent 通道数。VAE latent 是连续表示,不能把"图像 tokenizer"这个称呼自动理解成离散码本。
对普通照片而言,压缩后丢失一小段草地纹理,可能不影响观看;但对中文海报而言,丢失一个短横,就可能把一个字变成另一个字。因此,**小字渲染同时受到条件理解、latent 表达和像素解码三处约束。**即使生成主干已经给出较好的 latent,解码器仍可能把笔画还原坏。
初代方案采用共享编码器、面向图像与视频的专用解码器设计,并在图像侧冻结编码器,用文档、PPT、海报及合成段落微调图像解码器。训练重点是重建损失和感知损失的平衡。这里的共享视觉表示为后续视频扩展提供基础,不代表下载初代图像权重就获得了完整的视频生成能力。
**2.0把问题推进到高压缩、高分辨率。**其 VAE 使用16倍空间下采样和64个 latent 通道,即 f16c64;通过残差式捷径、更多通道与语义对齐,在重建质量和 latent 的可生成性之间寻找平衡。7,§3.1 VAE-2.0 专门报告进一步讨论了全局跳连、非对称编码解码结构,以及评估文档重建的 OmniDoc-TokenBench。8
为什么通道增加后,模型未必更难部署?先看 latent 元素总量:
H W 8 2 × 16 = H W 16 2 × 64 = H W 4 . \frac{HW}{8^2}\times16=\frac{HW}{16^2}\times64=\frac{HW}{4}. 82HW×16=162HW×64=4HW.
这说明 f8c16 与 f16c64 的 latent 元素数量相同,但空间位置和每个位置的通道容量分配不同。空间网格更小,不代表信息量凭空减少四倍;信息被重新组织到了通道维。
再向前看一步,还要计算 patchify 后真正送入 DiT 的 token 数。若 latent patch 边长为 p:
N i m a g e = H f p ⋅ W f p . N_{\mathrm{image}}=\frac{H}{fp}\cdot\frac{W}{fp}. Nimage=fpH⋅fpW.
对1024×1024图像,初代 f=8、p=2,得到4096个图像 token;2.1的公开配置 f=16、p=1,同样得到4096个 token。两者每个输入 token 都可对应64个 latent 标量:初代是2×2×16,2.1是1×1×64。
这个例子直接说明:不能仅凭"VAE从8倍改成16倍压缩",就断言2.1相对初代的注意力成本下降16倍。端到端效率还受层数、宽度、文本长度、参考图数量、缓存方式和内核实现影响。
最后,VAE 还有一个常被忽略的目标:latent 不仅要能重建,还要容易被扩散或流模型学习。一个保存了很多细节、却非常难预测的 latent 分布,可能让后续生成主干付出更大训练代价。这正是语义对齐与 diffusability(可扩散建模性)值得单独研究的原因。
6.5 Qwen-Image的MM-DiT与MSRoPE
初代采用 双流 MMDiT。文本条件和图像 latent 各自有投影、调制等参数路径,再在联合注意力中交换信息。双流可以理解为"保留模态各自的处理方式,同时允许跨模态信息交互"。
联合注意力可用下面这个概念表达式理解:
Q = Q t e x t ; Q i m a g e , K = K t e x t ; K i m a g e , V = V t e x t ; V i m a g e , Q=Q_{\\mathrm{text}};Q_{\\mathrm{image}},\quad K=K_{\\mathrm{text}};K_{\\mathrm{image}},\quad V=V_{\\mathrm{text}};V_{\\mathrm{image}}, Q=Qtext;Qimage,K=Ktext;Kimage,V=Vtext;Vimage,
Attention ( Q , K , V ) = softmax ( Q K ⊤ d + M ) V . \operatorname{Attention}(Q,K,V)=\operatorname{softmax}\left(\frac{QK^\top}{\sqrt{d}}+M\right)V. Attention(Q,K,V)=softmax(d QK⊤+M)V.
分号表示沿序列维拼接,M 表示相应注意力掩码。上式只用于解释信息交互;具体实现还包含 QK normalization、位置编码、时间步调制和残差连接。文本 token 提供"要生成什么",图像 token 在交互中更新空间内容。
但文本是一维序列,图像是二维网格,二者的位置关系怎么表示?Qwen-Image 使用 Multimodal Scalable RoPE,简称 MSRoPE。
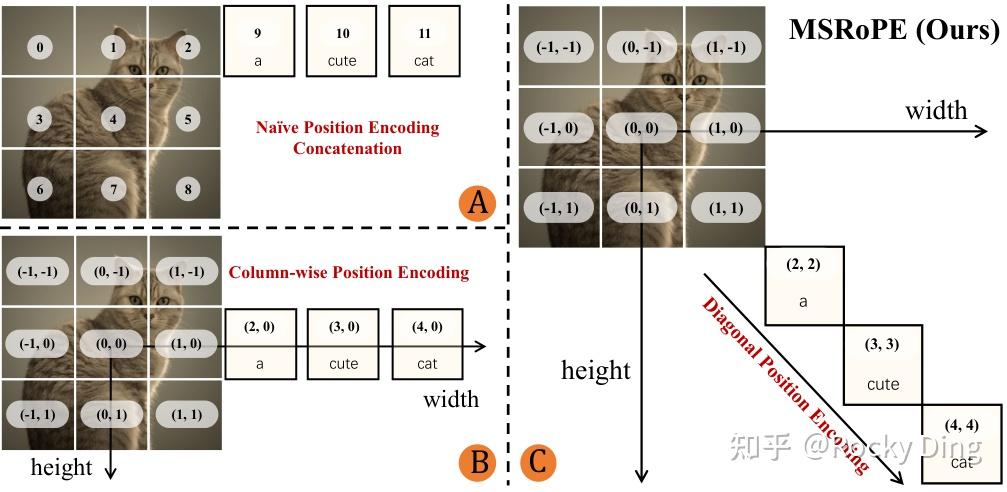
如上图所示,图像网格围绕中心组织,文本位置沿概念上的对角线安排。这里的坐标属于注意力位置编码,并不要求文字真的画在画布对角线上。
直观地看,把所有图像位置展平、再把文本接在末尾,会弱化二维结构;把文本硬塞到图像某一行,又会让这行图像 token 与文本 token 的位置模式过于相似。MSRoPE 对图像使用中心化的二维坐标,让文本在两个空间轴上使用相同的位置编号,形成"沿对角线延伸"的表示。
这样既保留图像的二维位置组织,也使文本侧的位置关系保持一维顺序的性质。编辑任务再增加 frame 维度,用来区分参考图与目标图。这里的 frame 首先承担图像身份标识,不应自动解释成视频的真实时间。
**MSRoPE改善的是模型表达位置关系的方式。**它不能单独保证"左红右蓝"永远正确,也不能替代空间关系数据、文本绑定训练和实际评测。读者应把架构设计理解为能力形成的条件之一,而非对最终行为的硬约束。
6.6 Qwen-Image为什么擅长写字:从字符、场景到复杂版面的数据构建
中文文字生成的困难是多层叠加的:字符数量多,长尾字频率低,字形局部差别小;文字还会出现在弯曲、倾斜、有遮挡和反光的物体上。最终输出既要字对,也要字处在合理位置、符合材质与透视。
初代把数据分为自然图像、人物、设计和合成等大类;标注要求描述对象属性、空间关系,并逐字记录图片中的可见文字。如果图上写着"秋日限定",caption只写"杯子上有一个标题",模型就失去了文字内容与像素字形之间最关键的监督信号。
为覆盖现实数据里的长尾文字和版面,论文设计了三类合成方法:
| 合成层次 | 构造方式 | 主要学习目标 |
|---|---|---|
| Pure Rendering | 在干净背景上排版段落,检查字体与字符能否完整渲染 | 字符、笔画、行距与基本排版 |
| Compositional Rendering | 把文字放入纸张、招牌等载体,再与场景融合 | 文字与材质、透视和环境的关系 |
| Complex Rendering | 程序化替换PPT、界面等结构化模板中的内容 | 多区域文字、层级布局与复杂指令对应 |
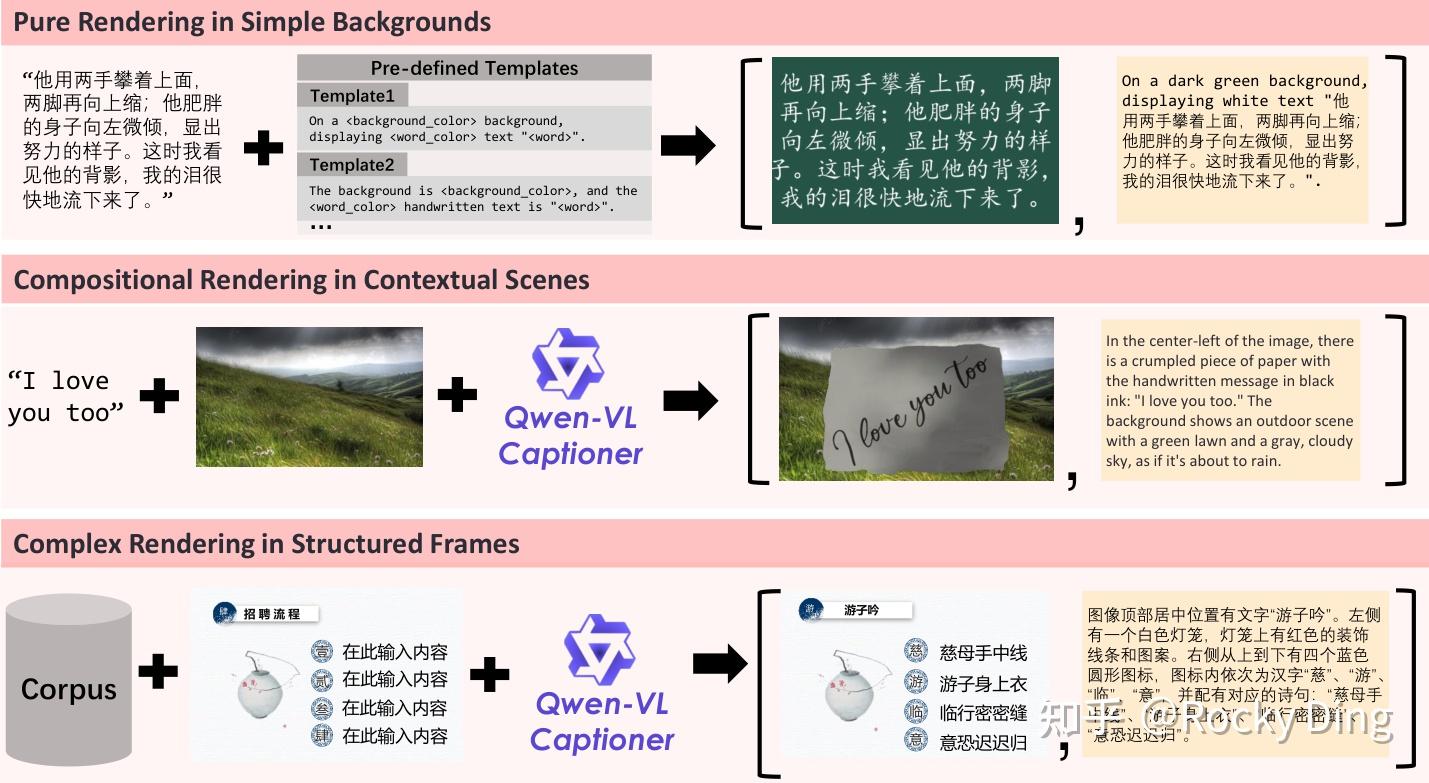
如图所示,合成数据从字形训练逐步扩展到真实场景和复杂模板。三种方式互补,不能仅靠白底文字覆盖全部商业设计任务。
这背后的核心逻辑是:**先确保"字形见过且标注正确",再让文字进入场景,最后让多个文字区域形成有层次的版面。**同时需要过滤破损图像、重复样本、异常内容、严重错配及质量问题,避免模型学习错误对应关系。
到了2.0,caption进一步区分普通描述、文字密集描述、知识描述与结构化描述。7,§2 例如一张流程图,仅用"有五个方框和几条箭头"很难监督拓扑关系;明确记录节点、属性和连线,才能更充分地表达"谁指向谁"。
数据闭环也要按失败原因分工:长尾知识或场景不足,需要补数据和继续预训练;模型已有能力但偏好不对,需要对齐;用户输入太粗略、缺少布局规格,则可以用提示词增强。把所有失败都归结成"prompt不够好",会遮蔽模型真实的能力边界。
**文字渲染强不等于知识事实正确。**一个模型可以把错误的药品剂量、天气数值或数学结论排得很漂亮。字形准确、语义正确、来源可靠,应当作为三个独立检查项。
6.8 深入浅出完整讲解Qwen-Image-Edit:语义与外观为何要双路输入
图像编辑天然包含两个目标:执行修改要求,保留不该改变的内容。我们让蓝杯变成红杯,既希望颜色变化成功,也希望杯身文字、形状、图案和桌面不要一起漂移。
初代编辑设计同时输入两类图像条件:
- Qwen2.5-VL 路径:参考图与编辑指令一起进入多模态编码器,提供理解场景和修改意图所需的语义条件。
- VAE 路径:参考图编码成 latent,与带噪目标 latent 沿序列维组合,提供更直接的外观与结构信息。
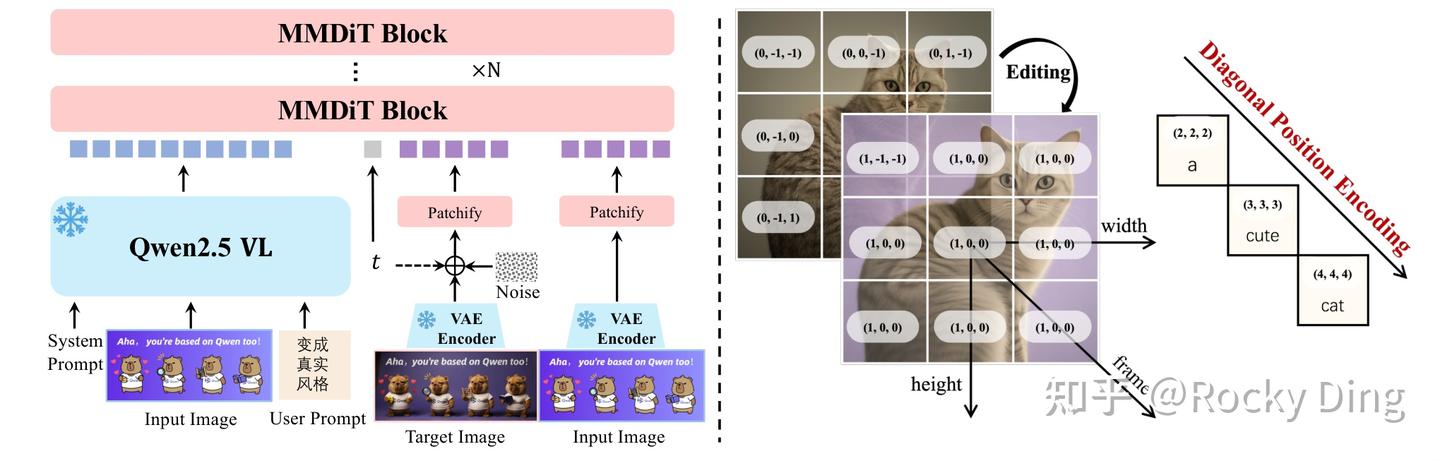
如图所示,左侧是编辑训练输入:干净参考图作为条件,目标图编码后加噪;右侧展示 frame 维度如何区分不同图像。训练时出现的目标图,在推理时并不可得。
直观地说,一条路径帮助模型理解"改什么",另一条路径帮助它记住"原来长什么样"。这是对作用的概括,不是绝对分工:语义路径同样包含视觉信息,VAE latent 也并非完全没有语义。
双路条件提高保持能力,却没有把未修改区域硬性锁死。因为整个目标画面仍可能由生成过程重新解码,所以背景、细小纹理、脸部等区域仍可能改变。对要求像素完全不动的任务,蒙版外回贴、图层合成和局部处理等工程方法仍有明确价值。
Edit-2509继续训练多图输入,支持人物+商品、人物+场景等组合,官方说明以1---3张图表现更佳;同时强化人物、商品及文字编辑一致性,并展示深度、边缘、关键点等结构条件。4 这里要区分"接受类似 ControlNet 使用的控制图"与"内部一定挂了一个独立 ControlNet 网络":接口能力本身不足以证明后者。
Edit-2511进一步强调减轻图像漂移、人物一致性及几何相关能力。这些更新值得关注,但"增强一致性"应通过连续编辑来验证:第1轮换衣服、第2轮改背景、第3轮加标题后,脸是否仍然相同,商标是否仍可读,累计偏移是否可接受。
6.9 深入浅出完整讲解Qwen-Image-Layered:让一张图成为可编辑资产
普通编辑每次都可能重新生成整张图。Layered选择改变输出表示:把输入 RGB 图像分解成多个具有颜色和透明度的 RGBA 图层,让用户能够单独移动、缩放、替换某一层。
这里的 A 是 alpha 通道,表示不透明度。若按从后到前的顺序叠加图层,使用非预乘颜色表示,在本节的合成约定下可以写成:
C i = α i R G B i + ( 1 − α i ) C i − 1 . C_i=\alpha_i\,RGB_i+(1-\alpha_i)C_{i-1}. Ci=αiRGBi+(1−αi)Ci−1.
Cᵢ是叠加第i层之后的合成结果,RGBᵢ是该层的颜色,αᵢ取值在0到1之间。这解释了为什么一层不仅需要"哪些像素属于对象"的掩码,还要有颜色和软边缘;对半透明物体、头发、阴影尤其如此。
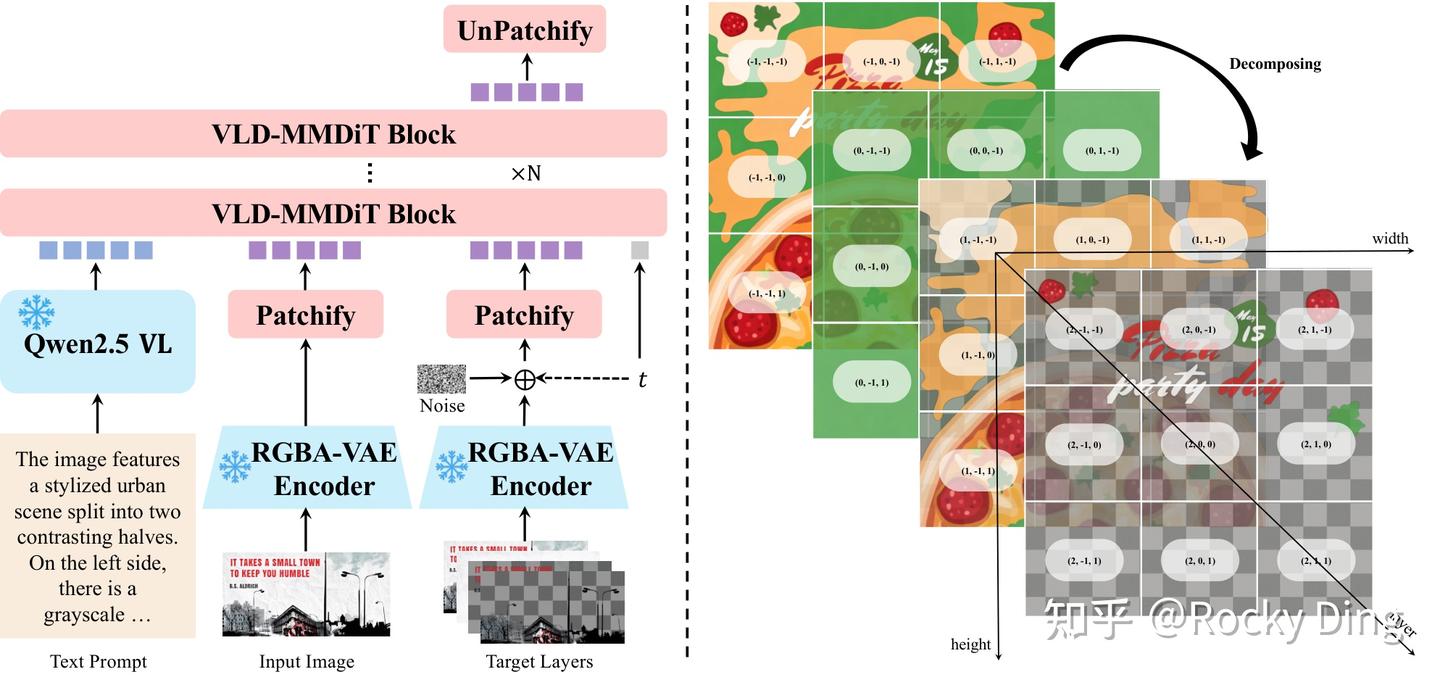
RGBA-VAE 处理透明图层,VLD-MMDiT 建模多图层,Layer3D RoPE 为不同图层增加身份维度。上图中的训练目标为多个图层 latent。
Layered的三个关键设计分别解决三类问题:
- RGBA-VAE统一编码输入图和输出透明层,减轻输入与输出表示的分布差异。RGB图可补上全不透明的alpha通道进入同一表示体系。
- VLD-MMDiT对参考图与多个目标层进行联合建模,处理层内内容以及层间关系,并支持可变层数。
- Layer3D RoPE在空间坐标之外加入图层维,避免同一空间位置的不同层被混淆。
训练则从文本到RGB/RGBA,推进到文本到多层,最后扩展到输入图到多层。这个过程让原有生成能力逐步适应透明度、层间关系与分解任务,而非一次性要求模型同时学会所有新能力。
它也超出了简单分割。把前景杯子移开后,后面的桌面需要合理补全;只裁出输入中看得见的像素,不足以得到可自由摆放的独立图层。另一方面,遮挡区域的补全存在多解,分解结果也不等于恢复作者最初使用的PSD文件,文字层仍可能只是栅格图层,而非可编辑字体对象。
**原生 RGBA、自动分层和原生矢量文档是三个不同层次的能力。**2.1输出一张透明背景素材,不能直接等同于Layered输出多层;生成一张像PPT的图片,也不能直接等同于交付具有文本框、图表与对象关系的PPTX文件。
Rocky认为,Layered的重要性在于把部分修改从"再生成一遍"转变成"操作已分离的对象"。当修改能够由确定性的移动、缩放和合成完成,未涉及的图层就更容易保持稳定。
6.10 Qwen-Image的训练与后训练
从基础模型到可用产品,通常需要多个训练阶段各自解决不同问题。初代报告介绍了 Flow Matching 预训练、高质量微调,以及 DPO、GRPO 等偏好优化方法。2.0和2.0-RL在统一生成编辑、复合奖励及能力合并方面给出了更完整的设计。
**第一步:预训练建立覆盖面。**模型需要见到足够多的对象、文字、布局、风格和图文关系,学会基本的条件生成分布。初代还将数据过滤、条件编码与主干训练拆成 Producer---Consumer 流程,让生成主干训练尽量少等待前处理。
**第二步:继续预训练与高质量微调强化细节。**2.0报告的预训练采用256/512分辨率及9:1的T2I/TI2I混合比例;继续预训练扩展到512/1024/2048,并调整为7:3;SFT进一步强化高质量与审美。7,Table 2 这些比例描述的是特定版本的训练配置,不是所有图像模型都应照抄的最优比例。
这套课程式安排具有直观意义:先在较低成本下学会大量基础概念,再逐渐提高分辨率和编辑任务比例。直接从最高分辨率开始训练,会让模型在尚未学会结构时就消耗大量算力处理细节。
**第三步:偏好优化让"可能正确"更接近"用户想要"。**DPO利用偏好样本对,使模型相对于参考模型更倾向于高质量结果。用于扩散/流模型时,需要处理生成轨迹或预测误差与偏好目标之间的关系,不能把语言模型的离散token损失原样移植。
GRPO在相同提示词下采样一组结果,比较组内奖励,得到相对优势。其直观形式为:
A i = R i − mean ( R 1 , ... , R G ) std ( R 1 , ... , R G ) + ε . A_i=\frac{R_i-\operatorname{mean}(R_1,\ldots,R_G)}{\operatorname{std}(R_1,\ldots,R_G)+\varepsilon}. Ai=std(R1,...,RG)+εRi−mean(R1,...,RG).
其中Rᵢ是第i张图的奖励,G是同组样本数,ε用于数值稳定。这个式子只是优势归一化;完整训练还包括策略比率、裁剪、正则化以及可计算的采样过程。对于确定性的ODE采样,要定义用于策略优化的概率过程,初代报告沿 Flow-GRPO 引入随机的SDE轨迹,不能把最终图片的一个评分直接当作完整策略梯度。
2.0-RL进一步把奖励按任务拆开:生成侧关注对齐、审美和人像质量,编辑侧关注修改要求和身份保持,并研究CFG策略、提示词筛选和分类别奖励权重。9 单一"好看分"很容易鼓励模型追求漂亮的重绘,却忽略用户要求保留的身份和细节。
**第四步:用OPD合并专长,用DMD减少采样成本。**这两者都叫蒸馏,但目标不同。
| 方法 | 本章对应的版本证据 | 主要解决的问题 |
|---|---|---|
| OPD,On-Policy Distillation | 2.0-RL报告§4.3 | 学生沿自己的采样轨迹,匹配相应任务教师的速度预测,把生成与编辑教师的专长合到统一模型中 |
| DMD,Distribution Matching Distillation | 2.0报告§4.3 | 训练少步学生,让其输出分布接近教师,降低生成需要的函数求值次数 |
2.0-RL的设计中,生成与编辑教师分别经过针对性优化;学生在自己的轨迹上接受与当前任务匹配的教师监督,还可以吸收教师的CFG效果。这样做的动机是缓解不同任务奖励混合优化的冲突。它并不自动意味着学生就是4步模型。
2.0的DMD实验展示了4次函数求值(4 NFE)学生与40步教师的定性对比。**少步能力依赖蒸馏后的模型及其采样配置。**把普通模型的推理步数从40改成4,不能据此声称得到了论文中的蒸馏模型;NFE降低的倍数,也不是包含编码、解码和数据传输后的总延迟提升倍数。
6.11 深入浅出完整讲解Qwen-Image-2.0:统一任务如何落实到架构
2.0把重点进一步放到长指令、复杂版面、多语言、高分辨率及生成编辑统一。这里的"统一"有实际含义:在同一生成框架中训练和处理T2I、单图编辑与多图参考任务,让模型学习不同条件组合下的视觉生成。
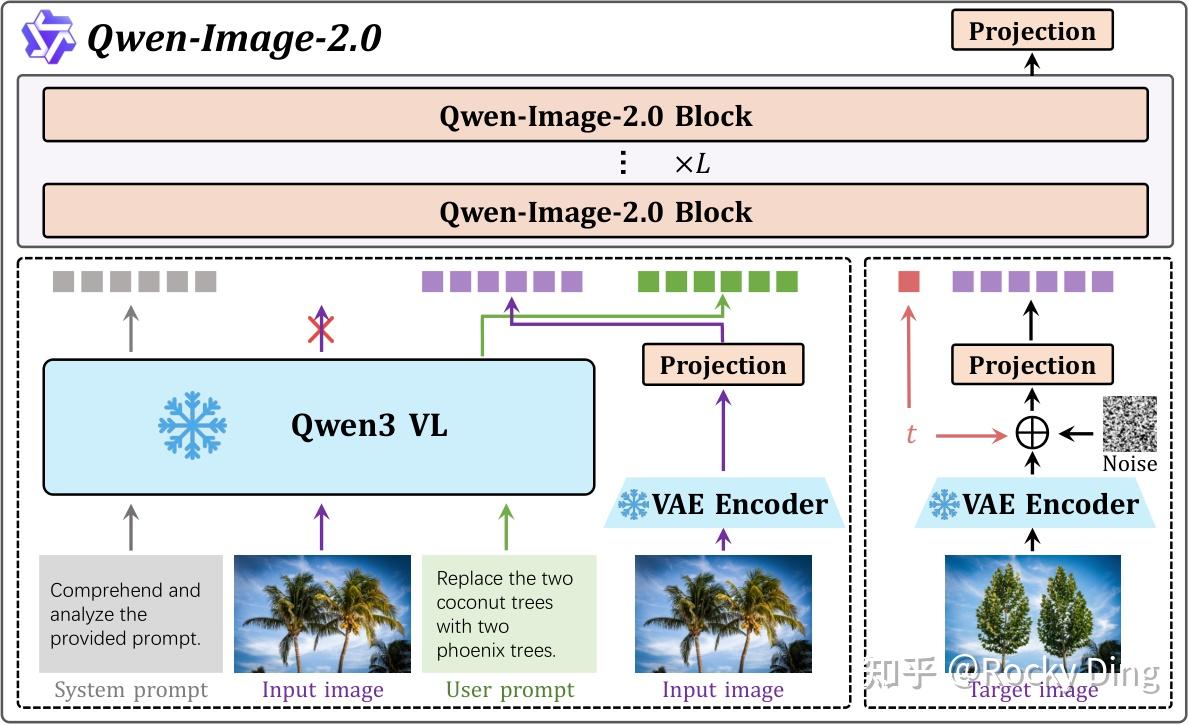
编码器换成Qwen3-VL,但其输出并非全部不加区分地送给生成主干。报告明确描述:从视觉与文本输入获得表征后,使用VAE latent替换视觉表征位置,保留相应文本表征,形成进入生成模块的多模态序列。文本表示可在前面的多模态编码过程中吸收图像上下文。
这种组织同时照顾两件事:让文本与视觉输入在条件理解阶段发生交互,又给生成主干提供适合保留细节的VAE表示。它与初代编辑的"双路引入参考图"有相通的动机,但不能把初代结构图直接重命名为2.0。
生成主干继续采用MMDiT类别的设计和MSRoPE,并调整归一化、时间调制及MLP:QK使用RMSNorm,调制去掉偏置项,MLP采用SwiGLU。这些细节的意义在于稳定联合训练中的激活与优化;"用了某种激活函数"本身不足以解释整个模型的能力提升。
另一项值得理解的组件是 Prompt Enhancer(PE)。用户说"做一张新品海报",PE可以扩写成主体、背景、构图、字体层级、光线及内容约束更完整的规格。2.0通过把细粒度描述退化为口语化提示,再学习恢复细节来构建提示词增强数据。
但PE也可能加错内容。对指定文案、价格、数量、商标和禁止修改区域,增强器应保留硬约束;评测时要分别记录用户原始提示词与实际执行提示词。如果A模型用了强重写器、B模型直接吃原始输入,结果比较的是不同系统配置,不能把所有差异归给生成主干。
2.0报告中的1K token输入和原生2K,应分别理解为条件长度能力与输出分辨率能力。前者不等于画面中能逐字无误地写满1000个token,后者也不等于可以无限放大画布并保持同等稳定性。
6.12 深入浅出完整讲解Qwen-Image-2.1:单流、混合粒度注意力与前缀缓存
2.1官方仓库把关键结构写得比较明确:视觉生成部分约7B、32层单流DiT,Qwen3-VL 8B编码器,64通道、16倍空间压缩的RGBA VAE,采用Flow Matching与Euler调度。
**单流不代表输入只剩一种模态。**文本、条件图像与目标图像仍有各自的来源和位置标识,只是在共享的Transformer序列中处理。是否共享参数,与是否接收多模态输入,是两个不同问题。
它的混合粒度注意力可以概括成:文本按token保持因果顺序;每张图像作为一个块,图像内部token允许双向交互;排在后面的目标图像可以读取前面的条件。官方实现的允许关系包含"键位置不晚于查询位置,或者属于同一图像块"。
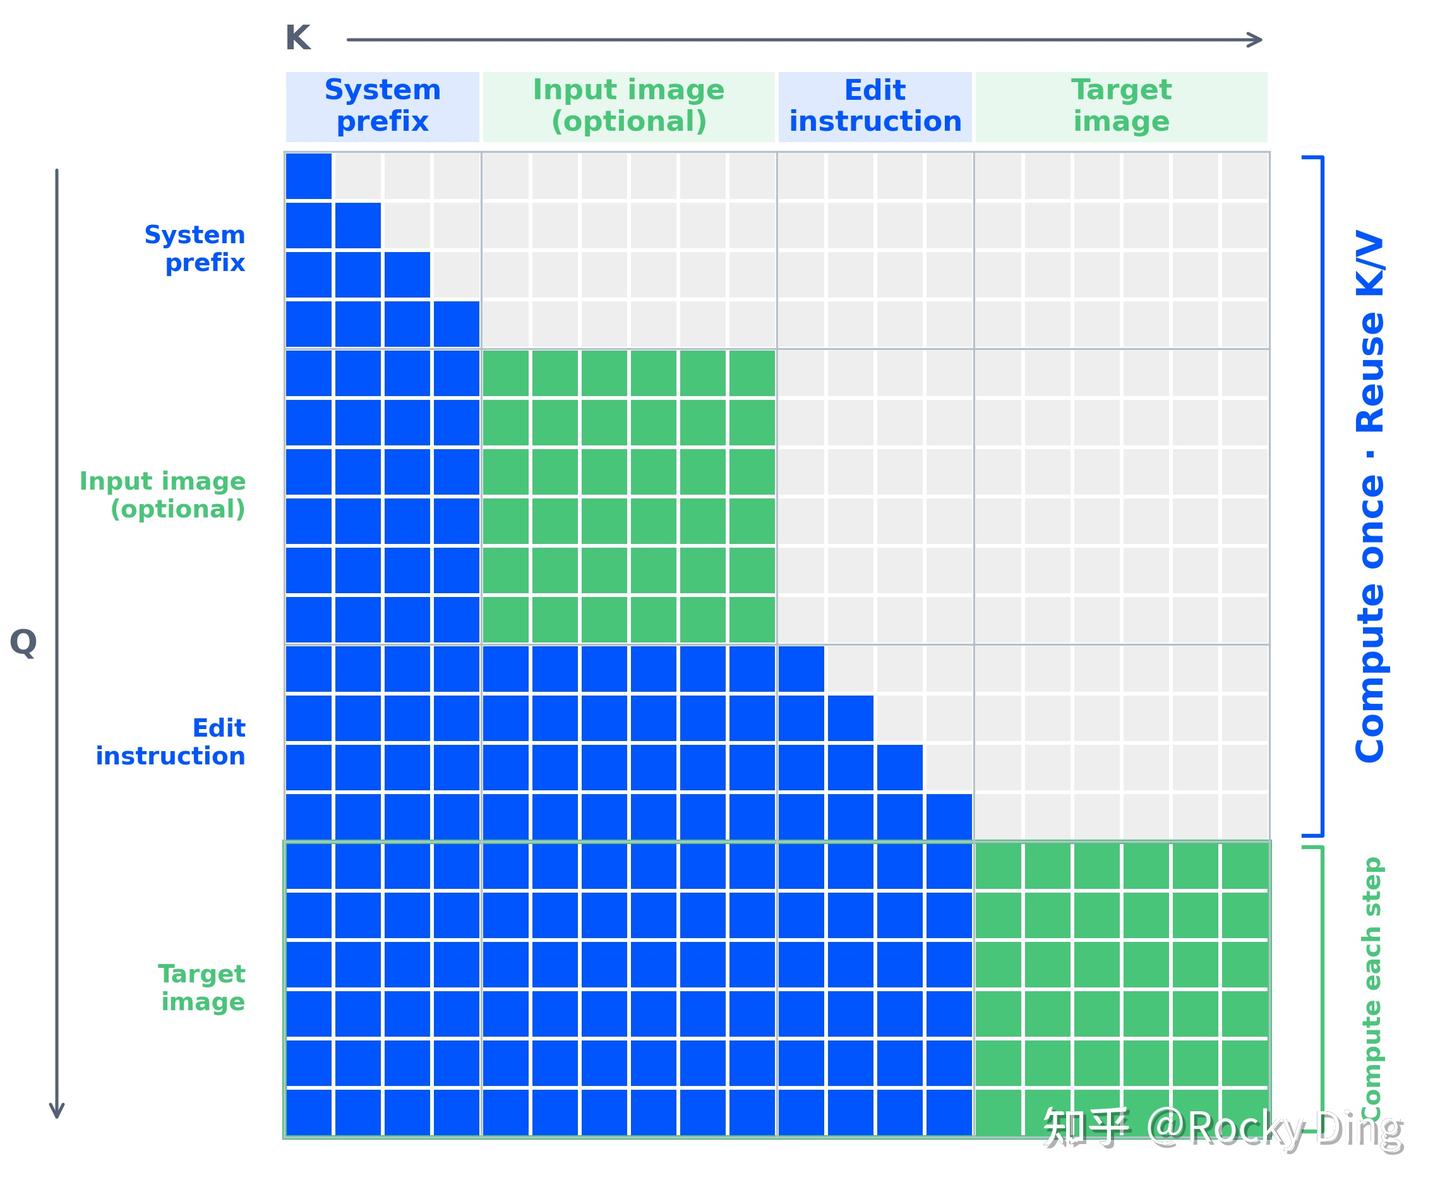
上图横轴为K,纵轴为Q;前缀不能读取后面的目标图像,而目标图像能读取前缀及自身图像块。读取方向是理解跨步复用的关键。
为什么这有助于推理?在一轮编辑的几十个去噪步中,输入商品图、人物图和文字要求都没有变化。如果每一步都重新计算它们的深层注意力特征,就会重复支付相同条件的计算成本。
但"输入没变"还不足以证明深层K/V可以复用。普通联合注意力中,条件token可能读取正在变化的目标token;时间步调制也可能让同一个条件在不同步产生不同状态。因此,2.1的缓存成立依赖两个关键条件:
- **注意力方向隔离。**前缀不读取后面的目标图像,目标噪声的变化不会反向影响前缀状态。
- 固定条件时间调制。
causal_condition=True时,文本与条件图像使用固定t=0调制,不随目标去噪时间变化。
在条件、顺序、尺寸、位置编码及模型状态相同的前提下,每层前缀K/V可以在第一次计算后缓存。后续步骤只重新计算目标图像部分,并让它读取缓存的条件K/V。这比"相邻步骤特征变化不大,所以近似复用"的缓存方式更有明确的结构依据。
**有因果注意力,也不代表目标图像在逐像素自回归生成。**2.1的目标图像块内部仍进行双向交互,整体latent按多个流匹配步骤更新。因果约束主要组织前缀与图像块之间的信息流。
缓存还存在边界:修改提示词、参考图、图像顺序、分辨率或相关位置编码,可能需要重新计算;前缀缓存本身也占内存,参考图越多,不能只看节省了多少计算而忽略显存。服务框架的具体多图上限还要单独确认,官方模型说明支持最多10张参考图,不代表所有框架版本都支持同样数量。
2.1还提供原生透明图像生成。RGBA中的透明通道属于输出资产的一部分,可以用于商品素材、贴纸和设计元素;这比"生成一张画有棋盘格背景的RGB图"多了真正可合成的alpha信息。验收时要检查文件模式、alpha通道与边缘,而不能只凭肉眼看到类似透明底的效果。
6.13 Qwen-Image-3.0的复杂版面创作能力
已有的2026年7月官方发布材料将3.0的重点放在长规格与复杂版面:最大4.5K token输入、小字、多个语言的文字渲染,以及图文混排、界面嵌套、知识信息图等场景。12 本节只解释这些展示对应的任务难点,不推断其未公开的参数量、DiT层数、训练规模与内部推理过程。
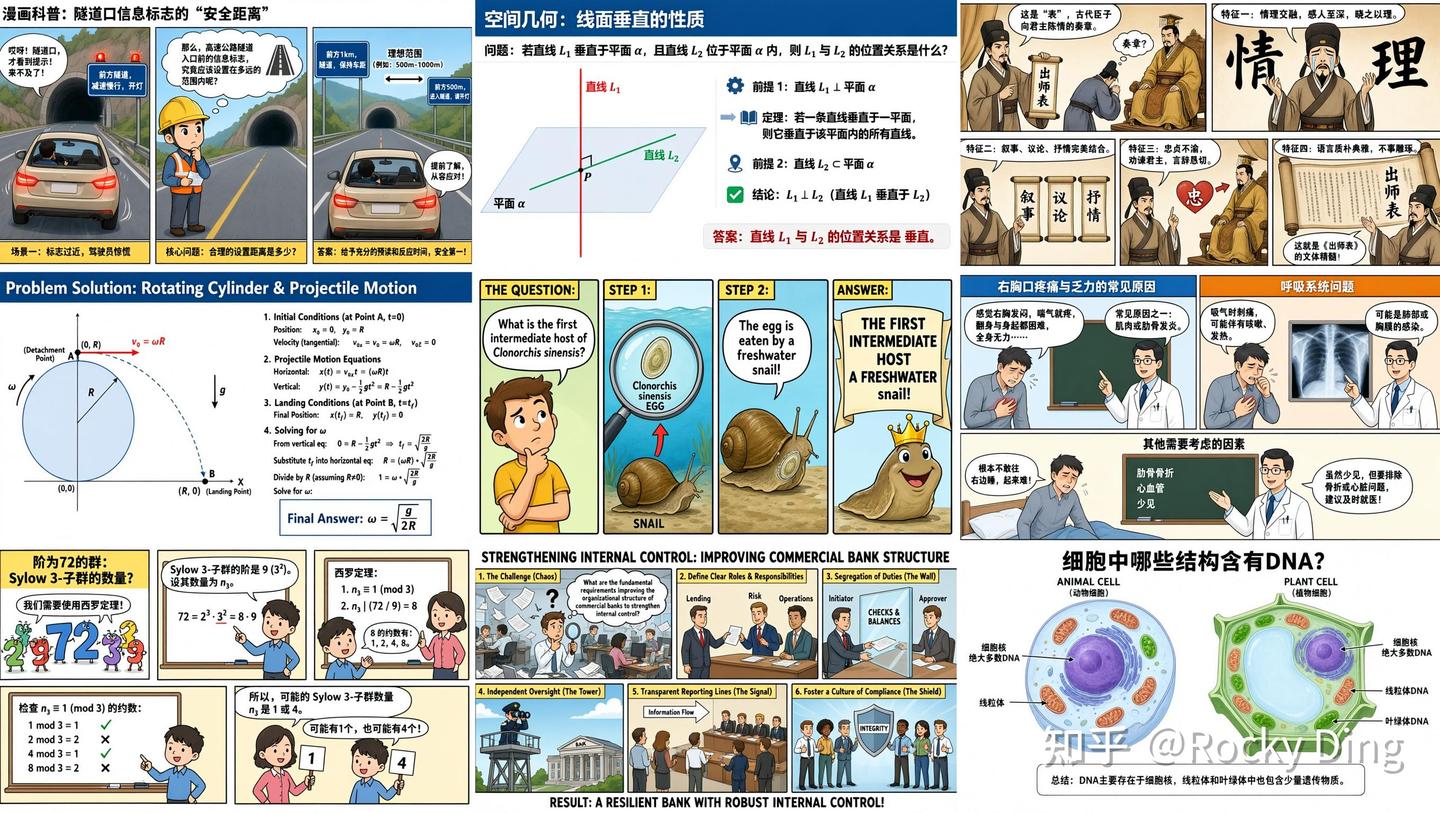
一张九宫格知识图需要同时满足多个约束:九个主题不能遗漏,说明文字要绑定到相应主题,区域之间要保持分隔,同时还要有统一的阅读层级。把一张聊天界面嵌入编辑器,再把海报嵌入聊天记录,则进一步考验对象属于哪一层界面的语义作用域。
**长输入提高的是表达复杂要求的空间,完整执行这些要求仍需逐项验证。**4.5K token的输入上限不能直接替换成相同数量的正确可见文字;小字能看清,也不能证明其中的公式、医学结论或标尺正确。
官方材料提到的"10px小字"尤其需要原始分辨率、裁剪比例、显示缩放和统计协议,才能形成可比较指标。一个精选样例能够展示上限,却不能告诉我们100张图里有多少张能稳定通过验收。
同理,产品能联网制作天气图,并不证明生成主干自身具有实时知识。检索、提示词增强、图像生成与工具执行可能组成完整产品链路,需要分别验证。对算法工程师而言,最有价值的问题是:哪些能力来自模型权重,哪些来自外部知识与工作流,哪些仍需要确定性校验。
6.14 Qwen-Image的推理部署与效果评估:从"出图"走向"交付"
部署前先固定四样东西:**准确的模型ID、对应pipeline、权重与依赖版本、实际许可证。**生成、编辑、Layered与2.1不能随意混用加载方式;LoRA也必须匹配基座结构和训练版本。
以显存为例,20B主干仅以BF16保存权重,就约需40GB的十进制字节容量;7B主干约14GB。这只是权重估算,不包含编码器、VAE、激活、注意力工作区、缓存及框架开销,也不是最低可运行显存的实测结果。CPU卸载、量化和多卡能够改变单卡驻留需求,却会引入传输、兼容性或速度上的权衡。
性能优化需要对准成本来源:
| 手段 | 主要减少什么 | 必须一起检查什么 |
|---|---|---|
| 量化 | 权重或部分计算的数值精度成本 | 小字、肤色、细节与编辑保持是否退化 |
| CPU卸载 | GPU上的常驻权重 | 主机内存、传输开销与首张延迟 |
| VAE分块解码 | 大图解码峰值显存 | 拼接缝、重叠区与颜色一致性 |
| 适配的少步蒸馏 | 生成主干函数求值次数 | 是否使用匹配的蒸馏权重、调度和指导参数 |
| 2.1前缀KV缓存 | 重复条件计算 | 缓存有效性、参考图长度与额外显存 |
| 高效注意力与并行 | 注意力内存访问或多设备分摊 | 设备支持、通信开销、数值与输出一致性 |
图像分辨率翻倍时,二维空间token数通常增加约四倍;在相同结构、常规全注意力假设下,注意力成对交互规模可增加约十六倍。但真实速度还受高效内核、线性层、缓存和硬件瓶颈影响,不能用这一个理论因子代替端到端测量。
评测也应围绕交付任务分解,而非只用一张榜单判断所有能力:
| 能力维度 | 推荐检查方式 | 典型失败 |
|---|---|---|
| 内容与关系 | 对象计数、属性绑定、空间关系;参考GenEval、DPG等协议 | 左右颠倒、对象遗漏、颜色串绑 |
| 文字与版面 | OCR字符错误率、完整字符串匹配、阅读顺序、局部人工复核 | 漏字、重复字、价格小数点错误、文字串区 |
| 编辑执行 | 修改目标是否实现,未修改区域是否保持 | 杯子变红了,但商标与脸也改变 |
| 多轮一致性 | 固定编辑链,逐轮记录身份、结构与文字漂移 | 单轮好看,多轮累计失真 |
| 图层与透明度 | alpha边缘、层间顺序、合成重建、移动后遮挡补全 | 白边、漏抠、层间内容重复 |
| 运行效率 | 同硬件下报告P50/P95延迟、吞吐、峰值显存、重试次数 | 只报DiT计时,忽略编码、解码和失败重试 |
字符错误率可表示为:
C E R = S + D + I N , \mathrm{CER}=\frac{S+D+I}{N}, CER=NS+D+I,
其中S、D、I分别为替换、删除和插入的字符数,N为目标文本字符数。OCR本身也会误识别,因此重要文案仍应人工复核;对于图像中的公式,还要检查结构和数学语义,而不能只看OCR相似度。
一个可执行的最小验收方案是:固定50条任务,覆盖10条纯文本海报、10条空间关系、10条单图编辑、10条多图身份保持和10条连续编辑;每条使用4个预先规定的随机种子,记录全部200个结果。这里是本章建议的测试设计,未宣称已经运行。测评时同时保留原始提示词、PE后的执行提示词、分辨率、步数、CFG、模型版本与失败样本,避免只挑最佳结果。
**每张合格图的成本,比每次出图的成本更贴近实际业务。**一张快图如果需要反复重试、修字和返工,交付成本未必低。可以把单次生成成本、合格率、人工修订时间与审核成本放到同一张表中比较。
许可证也会影响选择。初代与本章核对的Edit、Layered权重使用Apache-2.0;2.1使用Qwen Research License,其条款规定非商业用途,商业使用需另行取得相应授权。10 权重可下载与可直接用于商业服务应分别确认,不能继承旧版本许可证作判断。
7. 从0到1搭建使用FLUX.2、Seedream(即梦)、Z-Image、Qwen-Image、GLM_image进行AI图像创作(全网最详细讲解)
前面的章节详细讲解了各个主流AIGC图像创作大模型的核心基础知识,本章开始Rocky将带着大家从0到1使用这些模型进行AI图像创作。
**Rocky认为,AI图像创作的入门门槛已经从"会不会调用一个模型"变成"能不能把模型、运行框架、资产管理和验收标准接成闭环工作流"。**本章我们以Diffusers和ComfyUI这两个主流AIGC创作框架为例,进行深入浅出讲解。
7.1 从0到1搭建使用FLUX.2进行AI图像创作
在 Diffusers 中,FLUX.2 的核心入口是 Flux2Pipeline。它的推理链可以拆成四步:
- 文本进入 Mistral 3 文本编码器,得到条件表示。
- 参考图(如果有)经过图像预处理后,与文本条件一起送进 FLUX.2 transformer。
Flux2Scheduler按 flow-matching 的时间轨迹执行去噪;guidance_scale控制条件强度。- FLUX.2 专用 autoencoder 将 latent 解码为最终图像。
如果显卡只有 24---32GB,优先采用官方 Diffusers 文档里的 4-bit transformer 方案;如果使用 4-bit 文本编码器,则应配合 enable_model_cpu_offload(),不要把文本编码器和 32B transformer 同时强行塞入显存。下面的代码是官方 4-bit、本地文本编码器路径的最小版本:
python
# flux2_dev_diffusers_t2i.py
from pathlib import Path
import torch
from diffusers import Flux2Pipeline, AutoModel
from transformers import Mistral3ForConditionalGeneration

repo_id = "diffusers/FLUX.2-dev-bnb-4bit"
device = "cuda:0"
dtype = torch.bfloat16

# 文本编码器和 DiT 先放 CPU,由 Accelerate 在推理时调度
text_encoder = Mistral3ForConditionalGeneration.from_pretrained(
    repo_id,
    subfolder="text_encoder",
    torch_dtype=dtype,
    device_map="cpu",
)
transformer = AutoModel.from_pretrained(
    repo_id,
    subfolder="transformer",
    torch_dtype=dtype,
    device_map="cpu",
)
pipe = Flux2Pipeline.from_pretrained(
    repo_id,
    text_encoder=text_encoder,
    transformer=transformer,
    torch_dtype=dtype,
)
pipe.enable_model_cpu_offload()

generator = torch.Generator(device=device).manual_seed(42)
image = pipe(
    prompt=(
        "A realistic product photograph of a matte white ceramic teapot on a warm wooden table, "
        "soft morning light, natural material texture, centered composition."
    ),
    num_inference_steps=50,
    guidance_scale=4,
    generator=generator,
).images[0]

Path("outputs").mkdir(exist_ok=True)
image.save("outputs/flux2_dev_t2i_seed42.png")
多参考编辑的输入是一个图像列表。参考图的顺序要与提示词中的角色绑定保持一致:
python
# flux2_dev_diffusers_edit.py
from pathlib import Path
import torch
from diffusers import Flux2Pipeline
from diffusers.utils import load_image

pipe = Flux2Pipeline.from_pretrained(
    "black-forest-labs/FLUX.2-dev",
    torch_dtype=torch.bfloat16,
)
pipe.enable_model_cpu_offload()

refs = [
    load_image("inputs/person.png"),
    load_image("inputs/product.png"),
    load_image("inputs/scene.png"),
]
image = pipe(
    prompt=(
        "Use the first image for the person's identity, the second image for the product, "
        "and the third image for the environment. Place the person holding the product in the scene. "
        "Preserve the person's facial identity and the product logo geometry."
    ),
    image=refs,
    num_inference_steps=28,
    guidance_scale=4,
    generator=torch.Generator("cuda").manual_seed(42),
).images[0]

Path("outputs").mkdir(exist_ok=True)
image.save("outputs/flux2_dev_multi_ref.png")
这里的 image=refs 是 FLUX.2 的多参考条件,不是把多张图片拼成一张长图。多参考数量、显存和分辨率会共同决定序列长度;如果出现身份串位,先减少参考图并固定顺序,再考虑增加步数。
ComfyUI 官方工作流模板提供了 Text to Image (Flux.2 Dev) 和 Image Edit (Flux.2 Dev)。导入工作流后,外层看起来像一个子图;展开后可以看到实际链路:
yaml
UNETLoader(flux2_dev_fp8mixed.safetensors)
        │
CLIPLoader(mistral_3_small_flux2_bf16.safetensors,type=flux2)
        │
CLIPTextEncode ── FluxGuidance ── BasicGuider
        │                              │
EmptyFlux2LatentImage ─ Flux2Scheduler ─ SamplerCustomAdvanced
        │                              │
      VAEDecode(full_encoder_small_decoder.safetensors)
        │
     SaveImage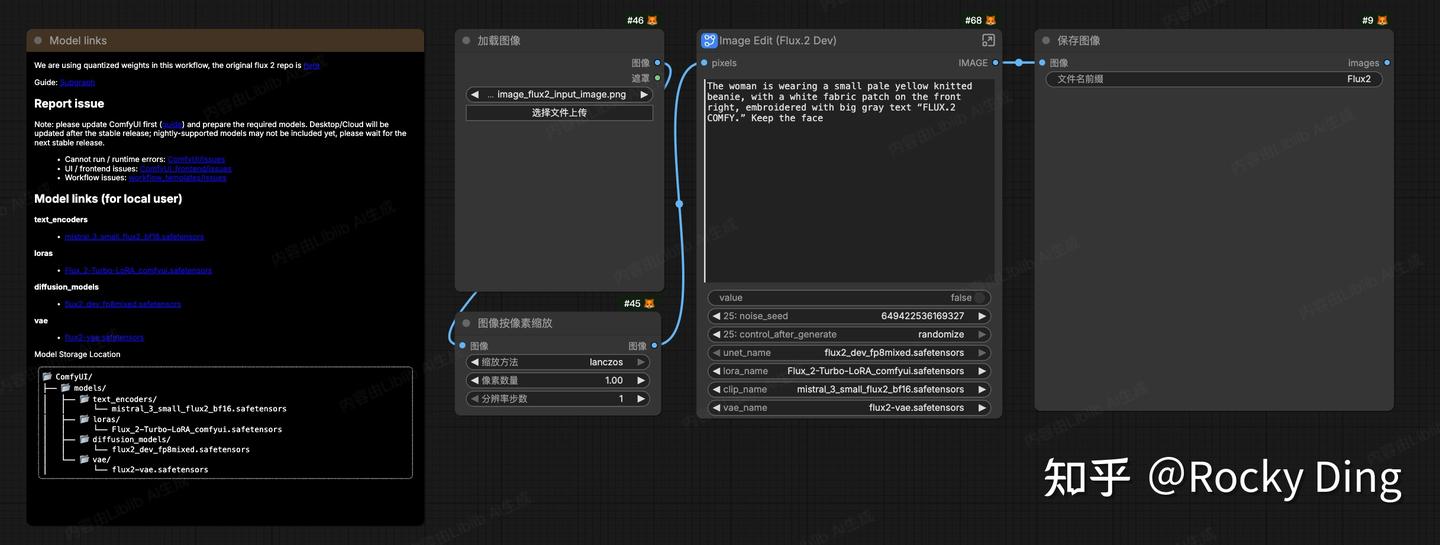
FLUX.2的ComfyUI工作流
7.2 从0到1搭建使用Z-Image进行AI图像创作
Z-Image 家族的共同基础是 6B 参数单流 DiT,Turbo 是蒸馏后的快速路径。Turbo 的 guidance_scale=0 不是"忘记写参数",而是官方 Distilled 采样约束;基础 Z-Image 则可以使用负向提示词和 CFG。二者的参数不能互抄。
官方 Diffusers 入口是 ZImagePipeline。Turbo 的最小推理脚本如下:
python
# z_image_turbo_diffusers.py
from pathlib import Path
import torch
from diffusers import ZImagePipeline

pipe = ZImagePipeline.from_pretrained(
    "Tongyi-MAI/Z-Image-Turbo",
    torch_dtype=torch.bfloat16,
    low_cpu_mem_usage=False,
)
pipe.to("cuda")

# 显存不足时改用 pipe.enable_model_cpu_offload()
# 支持时可以尝试 pipe.transformer.set_attention_backend("flash")

generator = torch.Generator("cuda").manual_seed(42)
image = pipe(
    prompt=(
        "A realistic night photograph of a young woman in red Hanfu, intricate embroidery, "
        "a softly lit pagoda in the distance, natural skin texture, cinematic composition."
    ),
    height=1024,
    width=1024,
    num_inference_steps=9,
    guidance_scale=0.0,
    generator=generator,
).images[0]

Path("outputs").mkdir(exist_ok=True)
image.save("outputs/z_image_turbo_seed42.png")
基础 Z-Image 的推理参数应单独记录:
python
# z_image_base_diffusers.py
import torch
from diffusers import ZImagePipeline

pipe = ZImagePipeline.from_pretrained(
    "Tongyi-MAI/Z-Image",
    torch_dtype=torch.bfloat16,
    low_cpu_mem_usage=False,
).to("cuda")

image = pipe(
    prompt="A clean editorial photograph of a ceramic teapot on a wooden table, soft daylight.",
    negative_prompt="blurry, distorted geometry, extra objects, unreadable text",
    height=1280,
    width=720,
    cfg_normalization=False,
    num_inference_steps=50,
    guidance_scale=4.0,
    generator=torch.Generator("cuda").manual_seed(42),
).images[0]
image.save("outputs/z_image_base_seed42.png")
官方仓库提示 Z-Image 支持 512 到 2048 的总像素范围和任意宽高比,但实际显存仍由面积、文本长度和 dtype 决定。基础模型的 negative prompt、CFG normalization 和 guidance 需要作为一组变量记录;只保存一张结果无法复盘"结构变好"是来自提示词还是来自 CFG。
ComfyUI 官方工作流提供 text_to_image_z_image_base.json 和 text_to_image_z_image_turbo.json。
text
ComfyUI/models/
├── vae/
│   └── ae.safetensors
├── text_encoders/
│   └── qwen_3_4b.safetensors
└── diffusion_models/
    └── z_image_bf16.safetensors
7.3 从0到1搭建使用GLM-Image进行AI图像创作
Diffusers官方仓库给出的入口是 GlmImagePipeline,并且要求从 Transformers 和 Diffusers 的最新源码安装:
bash
python -m pip install -U "torch>=2.4" accelerate pillow safetensors
python -m pip install git+https://github.com/huggingface/transformers.git
python -m pip install git+https://github.com/huggingface/diffusers.git
最小文生图脚本如下:
python
# glm_image_diffusers_t2i.py
from pathlib import Path
import torch
from diffusers.pipelines.glm_image import GlmImagePipeline

pipe = GlmImagePipeline.from_pretrained(
    "zai-org/GLM-Image",
    torch_dtype=torch.bfloat16,
    device_map="cuda",
)

prompt = (
    'A clean food magazine infographic. The title must read "Raspberry Mousse Cake Recipe Guide". '
    'Show a raspberry mousse cake on the right, ingredients on the lower left, and four numbered steps. '
    'Use a bright paper background, clear hierarchy, and accurately rendered text.'
)
image = pipe(
    prompt=prompt,
    height=32 * 32,
    width=36 * 32,
    num_inference_steps=50,
    guidance_scale=1.5,
    generator=torch.Generator(device="cuda").manual_seed(42),
).images[0]

Path("outputs").mkdir(exist_ok=True)
image.save("outputs/glm_image_t2i_seed42.png")
guidance_scale=1.5 和 50 步是官方示例的起点,不是所有任务的固定最优值。GLM-Image 的 AR 部分默认 do_sample=True、temperature 0.9、top-p 0.75;如果同一个 seed 仍出现文字差异,需要把 Transformers、Diffusers、GPU 和 sampling 参数一起锁定。
Diffusers 图像编辑:image 参数是列表,尺寸仍必须显式传入。
python
# glm_image_diffusers_i2i.py
from pathlib import Path
import torch
from PIL import Image
from diffusers.pipelines.glm_image import GlmImagePipeline

pipe = GlmImagePipeline.from_pretrained(
    "zai-org/GLM-Image",
    torch_dtype=torch.bfloat16,
    device_map="cuda",
)

source = Image.open("inputs/forest.png").convert("RGB")
image = pipe(
    prompt="Replace the snow forest background with an underground station and preserve the subject identity.",
    image=[source],
    height=33 * 32,
    width=32 * 32,
    num_inference_steps=50,
    guidance_scale=1.5,
    generator=torch.Generator(device="cuda").manual_seed(42),
).images[0]

Path("outputs").mkdir(exist_ok=True)
image.save("outputs/glm_image_i2i_seed42.png")
多图编辑可以把 [source] 扩展为 [source, reference],但图像顺序需要在 prompt 中明确。GLM-Image 的参考图并不是传统 strength 形式的 img2img;不要把 Stable Diffusion 的 strength 参数机械加入这个 pipeline。
7.4 从0到1搭建使用Qwen-Image进行AI图像创作
Qwen-Image-2.1 的视觉生成部分约 7B 参数,使用 32 层单流 DiT;Qwen3-VL 8B 负责文本和视觉条件,VAE 为 64 通道、16 倍空间压缩,并原生支持 RGBA、2K 和最多 10 张参考图。这里的"约 7B"只描述视觉生成部分,不能理解为整套推理系统只需要 7B 显存。
官方 Diffusers 和 ComfyUI 是 Day-0 支持,且二者分别使用不同的权重组织方式:Diffusers 使用 Hugging Face 原始 pipeline;ComfyUI 使用 Comfy-Org 转换后的 diffusion model、text encoder 和 VAE 文件。两者不能把对方的文件随意改名后混用。
python
# qwen_image21_diffusers_t2i.py
from pathlib import Path
import torch
from diffusers import QwenImage21Pipeline

pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1",
    torch_dtype=torch.bfloat16,
)
pipe.enable_model_cpu_offload()

image = pipe(
    prompt="A clean product photograph of a matte white ceramic teapot on a warm wooden table, soft morning light.",
    width=1024,
    height=1024,
    num_inference_steps=40,
    generator=torch.Generator("cuda").manual_seed(42),
    use_kv_cache=True,
).images[0]

Path("outputs").mkdir(exist_ok=True)
image.save("outputs/qwen_image21_t2i_seed42.png")
Qwen-Image-2.1 的 true_cfg_scale 默认是 1.0,官方路径通常不依赖负向提示词;如果打开 true CFG,就必须同时传入 negative_prompt,并把这次运行视为新的实验。use_kv_cache=True 复用固定文本和参考图条件的前缀 K/V,不是任意 pipeline 都可以打开的通用开关;参考图、prompt、顺序或相关位置编码改变后,应重新建立缓存。
Diffusers 编辑:单图、多图与 RGBA。
python
# qwen_image21_diffusers_edit.py
from pathlib import Path
import torch
from PIL import Image
from diffusers import QwenImage21Pipeline

pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1",
    torch_dtype=torch.bfloat16,
).to("cuda")

refs = [
    Image.open("inputs/person.png").convert("RGB"),
    Image.open("inputs/product.png").convert("RGB"),
]
image = pipe(
    prompt=(
        "Use <image1> as the person identity and <image2> as the product. "
        "Place the person holding the product in a quiet cafe. Preserve the face and logo geometry."
    ),
    image=refs,
    num_inference_steps=40,
    generator=torch.Generator("cuda").manual_seed(42),
).images[0]

Path("outputs").mkdir(exist_ok=True)
image.save("outputs/qwen_image21_multi_ref.png")
透明图需要从提示词到文件格式一起验收:
python
from pathlib import Path
import torch
from PIL import Image
from diffusers import QwenImage21Pipeline

pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1", torch_dtype=torch.bfloat16
).to("cuda")
image = pipe(
    prompt=(
        "This is an RGBA image with transparency. A cute flat-design dragon sticker, "
        "clean silhouette, subtle shadow. The image has an alpha channel and a transparent background."
    ),
    num_inference_steps=40,
    generator=torch.Generator("cuda").manual_seed(42),
).images[0]

Path("outputs").mkdir(exist_ok=True)
image.save("outputs/qwen_image21_rgba.png")
with Image.open("outputs/qwen_image21_rgba.png") as check:
    assert check.format == "PNG"
    print(check.mode, check.size, check.getbands())
    if "A" in check.getbands():
        print("alpha extrema:", check.getchannel("A").getextrema())
如果图片是 RGB 或 alpha 极值始终为 255,就不能把棋盘格背景当成透明通道成功。多图接口最多 10 张是官方能力边界,不代表任意显卡、任意分辨率都能稳定承载 10 张图。
ComfyUI官方 Qwen-Image-2.1 T2I 模板的核心文件是:
text
ComfyUI/models/
├── diffusion_models/
│   └── qwen_image_2.1_int8_convrot.safetensors
├── text_encoders/
│   ├── qwen3vl_8b_int8_convrot.safetensors
│   └── qwen3.5_9b_qwen_image_2.1_pe_t2i.int8_convrot.safetensors
└── vae/
    └── qwen_image_2.1_vae_bf16.safetensors
8. AIGC图像创作领域未来的技术发展趋势
8.1 AIGC图像创作领域主流技术发展能力层级
Rocky认为,2026年是AIGC图像创作领域的"中场时刻" 。2026年之前很多非常热闹的AIGC图像生成单点技术,会因为新一代原生多模态模型、统一图像生成编辑模型、后训练体系和智能体工作流的发展而被快速淘汰。能够经受考验留下的则是继续繁荣的跨周期技术,比如扩散模型的数学&物理本质原理、Flow Matching框架、自回归视觉token、强文本编码器、参考特征控制、图像编辑、文字渲染、多轮一致性、偏好对齐和推理式视觉创作等核心技术。
Rocky认为,AIGC图像创作领域的未来趋势可以从五个能力层级理解,如下表所示:
| 能力层级 | 核心定义 | 代表能力 | 典型模型/方法 | 主要挑战 |
|---|---|---|---|---|
| L1:原子生成(Atomic Generation) | 直接从文本生成图像 | 文生图、照片基础审美/真实感 | DDPM、Stable Diffusion、DiT、DALL-E 1等 | 不可控性强,空间关系、数量、身份和布局容易错 |
| L2:额外条件生成(Conditional Generation) | 在文本之外加入各种显式条件信息 | 身份/姿态/布局/文字渲染一致性等特征控制 | Stable Diffusion/FLUX生态 + ControlNet/IP-Adapter/PULID/InstantID等控制技术 | 属性绑定、空间精度、局部控制等仍不稳定 |
| L3:上下文生成(In-Context Generation ) | 生成推理过程中原生吸收多参考图、多条件、多轮历史或多图上下文的信息 | 多图融合、多轮编辑、角色一致、风格一致、跨图叙事等 | FLUX.1 Kontext/FLUX.2、GPT-4o/GPT Image-2、Gemini/Nano Banana pro、Qwen-Image、Seedream 4.0、Z-Image等 | 需要在多轮漂移、身份保持、未编辑区域保真、长上下文一致性方向持续优化 |
| L4:智能体式生成(Agentic Generation) | 围绕创作目标自主规划步骤、选择并调用生成与编辑工具,根据工具返回结果或视觉评估反馈调整后续动作,形成多步创作闭环 | 参考检索、任务分解、模型与工具选择、多步生成编辑、视觉评估与迭代修正 | Lovart、即梦AI、JarvisArt/JarvisEvo等 | 评估反馈可靠性、工具调用正确性、多步一致性、停止条件与成本延迟 |
| L5:世界建模生成(World-Modeling Generation) | 根据已有视觉观测、历史状态及动作或控制条件,预测环境后续变化并生成相应视觉结果,追求空间、时间与交互规律的一致性 | 动作条件下的未来预测、可交互环境生成、长时序状态保持、机器人与自动驾驶视觉仿真 | Google DeepMind Genie 3、NVIDIA Cosmos 系列等 | 动作响应准确性、长期状态一致性、物理与因果忠实性、仿真到现实的差距 |
因此,未来AIGC图像创作除了"更高质量、更高审美"这些基础维度,还要从外观生成 走向智能视觉生成:模型需要理解结构、记住上下文、遵守物理规则、调用外部工具、验证自身结果,并服务于真实的AIGC图像创作领域各方向的应用场景,如下图所示。
过去的AIGC图像创作系统已经能够复用部分生成能力,但在文字渲染、身份保持、参考图控制、精细编辑、虚拟试装等复杂任务上,往往还需要额外的控制模块、专用模型和人工流程。现在前沿图像模型正在把更多生成、编辑与参考条件控制能力纳入同一基础模型,使其能够结合指令、源图和参考图完成更复杂的视觉创作。
这种趋势可以概括为生成与编辑的统一建模。它的驱动力主要来自三个方面:
- 共享视觉能力,使不同任务之间具备知识与训练信号复用的空间。文生图、图像编辑、局部重绘和参考图生成等虽然任务形式不同,但都依赖对象识别、空间关系、材质光照、语义对应和视觉细节生成等基础能力。例如,"生成一个红色杯子"和"把图中的杯子改成红色",都需要理解杯子的形状、表面材质与颜色表达;后者还需要识别修改区域,并保持其他内容不变。让这些任务共享模型底座,有机会复用共同的视觉知识,减少为每个任务分别学习相近能力的重复投入。统一训练的价值在于共享能力基础,同时学习不同任务的约束。 这种收益取决于数据质量、任务配比和训练目标,不能假定多任务训练一定优于专用模型。
- 复杂创作需要同时协调"改什么"和"保留什么",推动生成与条件理解更紧密地结合。真实编辑往往包含多个相互制约的要求。例如,"把人物的外套换成参考图中的款式,同时保持脸部身份、姿态、背景和原有光照",需要模型同时理解源图、参考图与修改指令。如果这些信息被拆分到多个独立阶段处理,而阶段之间只传递简化提示词、局部特征或中间图像,就可能丢失细节约束;连续处理还可能引入身份漂移、边界异常和非目标区域变化。统一建模提供了在同一次生成过程中联合利用这些条件、协调修改目标与保留要求的机会。 要真正实现稳定编辑,仍需要针对性的训练数据、条件表达和保真约束,单纯共用一个主干并不能保证一致性。
- 多任务数据与工程投入可以围绕同一底座积累,形成持续迭代的规模效应。如果每增加一种创作能力,都需要单独训练、部署和维护一套模型,系统的适配与评估成本就会不断增加。共享底座后,基础视觉能力的改进有机会服务于多个任务,训练数据处理、偏好对齐、推理优化和评估体系也能部分复用。例如,更好的文字理解与渲染能力,可以同时帮助海报生成、文字替换和信息图制作。对于需要覆盖多种创作任务的平台,统一底座有利于把能力建设集中到可复用的基础设施上。 不过,实际收益仍取决于模型规模、任务干扰、调用频率和部署方式;对高精度或低延迟任务,专用模型与外部工具仍然可能更合适。
因此,未来通用AIGC图像创作模型的重要发展方向,是将生成、编辑和参考控制能力更稳定地组合起来,在完成修改的同时保持身份、结构、文字、风格及未编辑区域的一致性。这会推动文生图、图生图、文字渲染、局部编辑、多图融合和多轮创作逐步共享更强的模型底座;专业任务则可以继续通过专用模块或工具补充。
8.2 AIGC图像创作大模型的主流技术范式
当前主流的AIGC图像创作大模型不再只有一种路线,而是多种技术范式并行演进,如下表所示:
| 技术范式 | 核心思想 | 表模型/系列 |
|---|---|---|
| 经典扩散去噪 | 从噪声逐步去噪,通常在像素空间或潜空间中生成图像 | DDPM、Stable Diffusion、SDXL、DiT等 |
| 多阶段/级联生成 | 先获得低分辨率或低细节结果,再逐步增强 | Imagen、DALL-E 2、GLIDE等 |
| Flow Matching / Rectified Flow生成范式 | 学习从噪声到数据的连续向量场,通过数值积分完成生成,追求更高效的生成路径 | FLUX、Stable Diffusion 3、Seedream、Qwen-Image |
| 自回归视觉生成(AR) | 将图像表示为 token 或多尺度表示,预测下一个 token 或尺度 | DALL-E 1、Parti、LlamaGen、VAR、Emu3、Janus-Pro等 |
| 掩码 token / 离散扩散 | 并行预测缺失视觉 token,并通过多轮迭代逐步修正 | MaskGIT、Muse等 |
| AR + Diffusion/离散扩散组合架构 | 为不同模态或输出采用互补建模目标,并可能共享 Transformer 表示 | GLM-Image、Transfusion、Show-o、JanusFlow等 |
| 原生多模态统一生成编辑 | 统一处理文本、图像、参考图、编辑指令、多轮上下文和目标图像 | GPT Image、Nano Banana、Seedream、Qwen-Image-Edit、Midjourney等 |
各个主流技术范式的流程图如下所示:
总的来说,Rocky认为,2022-2024年主线是扩散模型规模化和开源生态爆发;2024-2026年技术主线逐渐转向Flow Matching、DiT、自回归视觉token、AR+扩散混合架构,以及理解-生成-编辑统一的原生多模态大模型。
根据当前主流基础大模型的演进趋势,Rocky认为未来最值得关注的方向包括:
- Visual Chain-of-Thought:先思考再创作。 模型在生成最终图像前,先生成布局草图、区域计划、文字排版、推理步骤或编辑程序,用于检查复杂约束。
- 原生多模态统一模型。 文本理解、图像理解、图像生成、图像编辑、多图输入、多轮对话逐渐统一到同一模型和同一上下文中。
- AR + Diffusion/Flow混合架构。 自回归模型负责语义规划、长上下文和推理,扩散/Flow模型负责高保真视觉渲染,这是非常有跨周期价值的架构方向。
- Agentic Visual Generation。 图像生成会成为智能体动作之一,系统会检索资料、调用OCR/布局/图表/分割/修图工具、验证输出并自动重试。
- World-Modeling Generation。 图像和视频模型将不只生成漂亮画面,而要预测行动后场景如何变化,应用场景包括服务机器人、自动驾驶、游戏世界和交互式仿真等。
- 高质量数据与后训练工程。 VLM标注、合成数据、SFT、DPO、GRPO、奖励模型、偏好优化、自动质检和安全对齐等技术的组合运用,会比单纯模型参数量更决定产品表现。
- 实时化和低成本部署。 Turbo、少步采样、蒸馏、量化、缓存、端侧推理和视频级实时生成等部署加速技术会决定商业落地上限。
8.3 AIGC图像创作涵盖的典型细粒度任务介绍
AIGC图像创作涵盖了多种细粒度任务,如下表所示,主要包括以下几类:
| 任务类别 | 主要任务内容 |
|---|---|
| 内容生成与多图合成 | 文生图、图生图、参考图生成、多图融合、布局条件生成 |
| 内容与区域编辑 | 对象添加、删除、替换、局部重绘、扩图、背景替换 |
| 外观、风格与光影变换 | 颜色、材质、光照、质感、美化、风格迁移 |
| 结构、姿态与视角变换 | 姿态、动作、比例、几何结构、面部结构、视角变化 |
| 文本与视觉版式创作 | 文字生成、文字编辑、Logo替换、海报、PPT、UI、信息图和科学图解 |
| 身份与跨图一致性控制 | 人物、角色、产品、品牌身份,多轮编辑和跨图一致性 |
| 恢复增强与垂直工作流 | 超分、去噪、压缩修复、细节增强、虚拟试装、商品编辑和电商生产 |
8.4 AIGC图像创作领域的模型训练与优化趋势
随着AIGC图像大模型从单次文生图走向多条件生成、精细编辑和连续创作,训练与优化的目标也在发生变化:模型既要生成高质量图像,也要准确理解指令、利用参考信息,并在修改过程中保持不应改变的内容。
大模型规模与训练算力仍然重要,而数据质量、任务设计、后训练反馈和推理效率,是把大模型基础能力转化为稳定创作能力的重要因素。我们可以从以下五个方面理解这一趋势。
【1. 如何构造更有效的训练监督?】
训练数据的重点正在从"数量更多"转向"每个样本提供的信息更准确"。除了图像和文本,还需要根据任务补充对象、属性、空间关系、文字区域、mask、参考图和编辑结果等结构化信息。
例如,一条图像编辑样本可以由源图像 + 编辑指令 + 编辑区域 + 目标图像组成。
对"把人物外套改成黑色,但保持脸部、姿态和背景不变"这类任务,只有一条粗略的图像描述是不够的,还需要让训练数据明确哪些区域应该改变、哪些区域应该保留。
这也是 VLM 重标注的价值:它不仅生成更长的 caption,还可以补充对象关系、文字内容、布局和编辑约束。数据筛选还要考虑去重、来源与授权、审美质量、任务均衡和安全内容,避免模型反复学习错误描述或单一风格。
【2. 如何让同一个底座模型学习多种创作任务?】
文生图、图生图、局部重绘、扩图、参考图生成和多图融合,需要的输入条件不同,但可以通过混合任务训练,让模型学习如何解释不同形式的条件。
例如,可以在同一训练体系中混合以下样本:
- 只有文本条件的文生图;
- 文本加源图像的图生图;
- 文本加源图像加 mask 的局部重绘;
- 文本加参考图的风格或身份控制;
- 多张参考图融合为一张目标图。
这样做的目标是让模型复用对象理解、空间关系、材质和视觉细节等共同能力,同时学会区分"需要修改的区域"和"必须保留的区域"。
【3. 如何把人类偏好转化为可学习的信号?】
基础训练主要让模型"能够生成",后训练则进一步要求模型"更符合指令和偏好"。监督微调通常使用高质量示范样本,教模型完成具体任务;偏好优化则通过比较不同结果,调整模型对质量、指令遵循和编辑保真的倾向。
一个简单的偏好样本可以是:同一个指令生成两个结果,其中一个文字更准确、未编辑区域更稳定,就作为偏好结果。
SFT 适合学习任务格式和基本行为;DPO 类方法适合利用偏好对进行直接优化;GRPO 或其他基于奖励的训练方法,则需要可靠的奖励函数或评价器。VLM-as-a-Judge、OCR 检查、区域相似度和人工偏好都可以提供反馈,但这些评价器本身也可能产生偏差,因此不能把自动评分直接当成绝对正确答案。
【4. 如何利用失败样本持续修正模型?】
模型训练越来越重视困难样本,而不是只在平均数据上继续堆训练量。需要从评测和实际使用中发现模型经常失败的模式,再针对这些模式构造数据和训练任务。
常见的困难模式包括:
- 多个对象的数量和位置错误;
- 海报或界面中的文字拼写、排版错误;
- 多轮编辑中的身份漂移;
- 局部重绘影响了未编辑区域;
- 参考图中的材质、服装或产品特征没有被保留。
例如,如果模型在"同时生成多个指定对象"时经常漏掉对象,就可以补充数量均衡、空间关系明确的训练样本;如果模型在连续编辑中出现身份漂移,就需要增加多轮编辑链和跨图一致性样本。
这会形成一个更具体的闭环:生成结果 → 自动或人工评估 → 失败归因 → 构造针对性样本 → 再训练 → 独立评测
这里的"闭环训练"不等于模型天然具备自我博弈能力。它依赖稳定的评估器、清晰的失败分类和独立测试集,否则模型可能只是针对评价器投机优化。
【5. 如何通过更少的采样并步数进行高质量生成?】
许多高质量图像模型需要多轮迭代采样,直接部署会受到延迟、显存和成本限制。因此,推理优化的重要目标是:在尽量少损失细节和可控性的情况下减少采样和计算。
常见方法包括:
- 一致性蒸馏;
- 少步采样蒸馏;
- 量化;
- 注意力或特征缓存;
- 并行推理;
- 更轻量的服务模型。
这里需要强调,少步并不自动等于更好:采样步数下降后,文字准确性、细节、空间关系和身份一致性可能受到影响,所以必须在目标任务上重新评估。
下图生动的展示了AIGC图像模型的训练与优化的核心过程:
从整体上看,AIGC图像模型的训练与优化正在形成更紧密的协作关系:高质量数据提供有效监督,基础训练建立通用能力,后训练改善任务表现,评估反馈定位薄弱环节,蒸馏与部署优化降低使用成本。 各环节相互配合,才能让模型在复杂创作中持续保持质量、可控性与效率。
8.5 AIGC图像创作大模型的效果评估
过去的图像生成评估往往偏重"画面是否自然、清晰、美观",但当模型开始处理复杂指令、文字渲染、局部编辑、多图融合和多轮创作后,单一审美分数已经无法代表模型的实际能力。更合理的评估方式,是按照任务目标拆分质量、遵循、一致性、安全和工程效率,并结合自动指标、人工评测与线上数据进行综合判断。
| 评估维度 | 关注问题 | 典型指标/方法 |
|---|---|---|
| 感知质量与多样性 | 图像是否自然、清晰、少伪影,并保持足够的风格和内容覆盖 | 人类偏好、Aesthetic Score、FID/KID、Precision/Recall、重复率和多样性统计 |
| 指令与条件遵循 | 是否完成了文本、参考图、mask、布局等全部条件要求 | 结构化 prompt 检查、VLM 评价、人工成对比较、任务成功率 |
| 语义、属性与空间关系 | 主体、属性、数量、位置、遮挡和关系是否正确 | 对象检测、属性识别、关系检查、布局评估、VQA 或结构化解析 |
| 文本与版式 | 图中文字是否正确、可读,位置和排版是否合理 | OCR 字符准确率、编辑距离、文字框位置、排版检查和人工评测 |
| 编辑区域与主体一致性 | 目标区域是否按要求变化,未编辑区域和参考主体是否保持 | mask 区域评估、非编辑区域差异、LPIPS/DINO/CLIP 辅助指标、主体或身份相似度 |
| 多轮、跨图与物理合理性 | 连续编辑是否漂移,多张图是否保持一致;在适用场景下是否符合物理和状态变化 | 多轮编辑链、跨图一致性测试、restore-to-original、专家评测、动作条件测试 |
| 安全与工程可用性 | 是否安全、稳定、可交付,并满足速度、成本和服务要求 | 安全分类、隐私与商标检查、审核通过率、延迟、吞吐、失败率、单张可用结果成本 |
因此,Rocky认为,AIGC图像模型评估不是寻找一个能够概括所有能力的总分,而是建立与任务对应的评估矩阵。文生图重点看指令遵循、语义关系和感知质量;图像编辑重点看目标区域变化、非编辑区域保真和主体一致性;多轮创作还要检查长期漂移;进入生产环境后,则需要进一步加入安全、延迟、成本、失败率和可用结果率。模型评估的核心,是确认模型能否在目标任务上有较好的效果与稳定的性能。
9. 推荐阅读
Rocky会持续分享AIGC的干货文章、实用教程、商业应用/变现案例以及对AIGC行业的深度思考与分析 ,欢迎大家多多点赞、喜欢、收藏和转发,给Rocky的义务劳动多一些动力吧,谢谢各位!
9.1 深入浅出完整解析AI Agent(AI智能体)的核心基础知识
2025年可以说是AI Agent全面落地应用的元年,因此Rocky在持续撰写对AI Agent的全维度解析文章:
深入浅出完整解析AI Agent(AI智能体)的核心基础知识
9.2 深入浅出完整解析扩散模型DDPM、DDIM、Classifier/Classifier-Free Guidance、Rectified Flow核心基础知识
和Rocky一起学习探究扩散模型的本质原理与和核心基础知识 ,同时不断跟进扩散模型的最新发展。Rocky在本文中对扩散模型的本质做了全面系统的梳理与讲解:
深入浅出完整解析扩散模型DDPM、DDIM、Score-Based、SDE、LDM、Classifier/Classifier-Free Guidance、Rectified Flow核心基础知识
9.3 深入浅出完整解析FLUX.1 Kontext和FLUX.1 Krea核心基础知识
Rocky也对FLUX.1 Kontext和FLUX.1 Krea的核心基础知识作了全面系统的梳理与解析:
深入浅出完整解析FLUX.1 Kontext和FLUX.1 Krea核心基础知识
9.4 深入浅出完整解析DeepSeek系列核心基础知识
Rocky也对DeepSeek系列模型的核心基础知识作了全面系统的梳理与解析:
9.5 深入浅出完整解析Stable Diffusion 3(SD 3)和FLUX.1系列核心基础知识
Rocky也对Stable Diffusion 3和FLUX.1的核心基础知识作了全面系统的梳理与解析:
深入浅出完整解析Stable Diffusion 3(SD 3)和FLUX.1系列核心基础知识
9.6 深入浅出完整解析Stable Diffusion XL(SDXL)核心基础知识
Rocky也对Stable Diffusion XL的核心基础知识作了全面系统的梳理与解析:
深入浅出完整解析Stable Diffusion XL(SDXL)核心基础知识
9.7 深入浅出完整解析Stable Diffusion(SD)核心基础知识
Rocky也对Stable Diffusion 1.x-2.x系列模型的核心基础知识做了全面系统的梳理与解析:
深入浅出完整解析Stable Diffusion(SD)核心基础知识
9.8 深入浅出完整解析Stable Diffusion中U-Net的前世今生与核心知识
Rocky对Stable Diffusion中最为关键的U-Net结构进行了深入浅出的全面解析,包括其在传统深度学习中的价值和在AIGC中的价值:
深入浅出完整解析Stable Diffusion中U-Net的前世今生与核心知识
9.9 深入浅出完整解析LoRA(Low-Rank Adaptation)模型核心基础知识
对于AIGC时代中的**"ResNet"------LoRA模型**,Rocky也进行了深入浅出的全面讲解:
深入浅出完整解析LoRA(Low-Rank Adaptation)模型核心基础知识
9.10 深入浅出完整解析ControlNet核心基础知识
AI绘画作为AIGC时代的一个核心方向,开源社区已经形成以Stable Difffusion为核心,ConrtolNet和LoRA作为首要AI绘画辅助工具的变化万千的AI绘画工作流。
ControlNet正是让AI绘画社区无比繁荣的关键一环,它让AI绘画生成过程更加的可控,更有助于广泛地将AI绘画应用到各行各业中:
9.11 深入浅出完整解析Sora等AI视频大模型核心基础知识
AI绘画和AI视频是两个互相促进、相互交融的领域,2024年无疑是AI视频领域的爆发之年,Rocky也对AI视频领域核心的Sora等大模型进行了全面系统的梳理与解析:
深入浅出完整解析Sora、Wan2.1、AnimateDiff、CogVideoX等AI视频大模型核心基础知识
9.12 深入浅出完整解析AIGC时代Transformer核心基础知识
在AIGC时代中,Transformer为AI行业带来了深刻的变革。Transformer架构正在一步一步重构所有的AI技术方向,成为AI技术架构大一统与多模态整合的关键核心基座,大有一统"AI江湖"之势。Rocky也对Transformer模型进行持续的深入浅出梳理与解析:
深入浅出完整解析AIGC时代Transformer核心基础知识
9.13 深入浅出完整解析主流AI绘画框架核心基础知识
AI绘画框架正是AI绘画"工作流"的运行载体,目前主流的AI绘画框架有Stable Diffusion WebUI、ComfyUI以及Fooocus等 。在传统深度学习时代,PyTorch、TensorFlow以及Caffe是传统深度学习模型的基础运行框架,到了AIGC时代,Rocky相信Stable Diffusion WebUI就是AI绘画领域的"PyTorch"、ComfyUI就是AI绘画领域的"TensorFlow"、Fooocus就是AI绘画领域的"Caffe":
深入浅出完整解析ComfyUI、Diffusers、Stable Diffusion WebUI等主流AIGC创作框架核心基础知识
9.14 手把手教你成为AIGC算法工程师,斩获AIGC算法offer!
在AIGC时代中,如何快速转身,入局AIGC产业?如何成为AIGC算法工程师?如何在学校中系统性学习AIGC知识,斩获心仪的AIGC算法offer?
Don't worry,Rocky为大家总结整理了全面的AIGC算法工程师成长秘籍,为大家答疑解惑,希望能给大家带来帮助:
手把手教你成为AIGC/LLM/AI Agent算法/开发工程师,斩获AIGC/LLM/AI Agent算法/开发offer!
9.15 AIGC产业的深度思考与分析
2023年3月21日,微软创始人比尔·盖茨在其博客文章《The Age of AI has begun》中表示,自从1980年首次看到图形用户界面(graphical user interface)以来,以OpenAI为代表的科技公司发布的AIGC模型是他所见过的最具革命性的技术进步。
Rocky也认为,AIGC及其生态,会成为AI行业重大变革的主导力量。AIGC会带来一个全新的红利期,未来随着AIGC的全面落地和深度商用,会深刻改变我们的工作、生活、学习以及交流方式,各行各业都将被重新定义,过程会非常有趣。
那么,在此基础上,我们该如何更好的审视AIGC的未来?我们该如何更好地拥抱AIGC引领的革新?Rocky准备从技术、产品、商业模式、长期主义等维度持续分享一些个人的核心思考与观点,希望能帮助各位读者对AIGC有一个全面的了解:
深入浅出全面解析AIGC时代核心价值与发展趋势(2025年版)
9.16 算法工程师的《三年面试五年模拟》求职秘籍
为了方便大家实习、校招以及社招的面试准备,同时帮助大家提升扩展技术基本面 ,Rocky将符合大厂和AI独角兽价值的算法高频面试知识点撰写总结成**《三年面试五年模拟之独孤九剑秘籍》,并制作成 pdf版本**,大家可在公众号WeThinkIn 后台**【精华干货】菜单或者回复关键词"三年面试五年模拟"**进行取用:
【三年面试五年模拟】AIGC时代的算法工程师的求职面试秘籍(持续更新中)
9.17 深入浅出完整解析AIGC时代中GAN系列模型的前世今生与核心知识
GAN网络作为传统深度学习时代的最热门生成式Al模型,在AIGC时代继续繁荣,作为Stable Diffusion系列模型的"得力助手",广泛活跃于Al绘画的产品与工作流中:
深入浅出完整解析AIGC时代中GAN(Generative Adversarial Network)系列模型核心基础知识