GPT-6 Astra 的能力数字与对齐声明:哪些能信
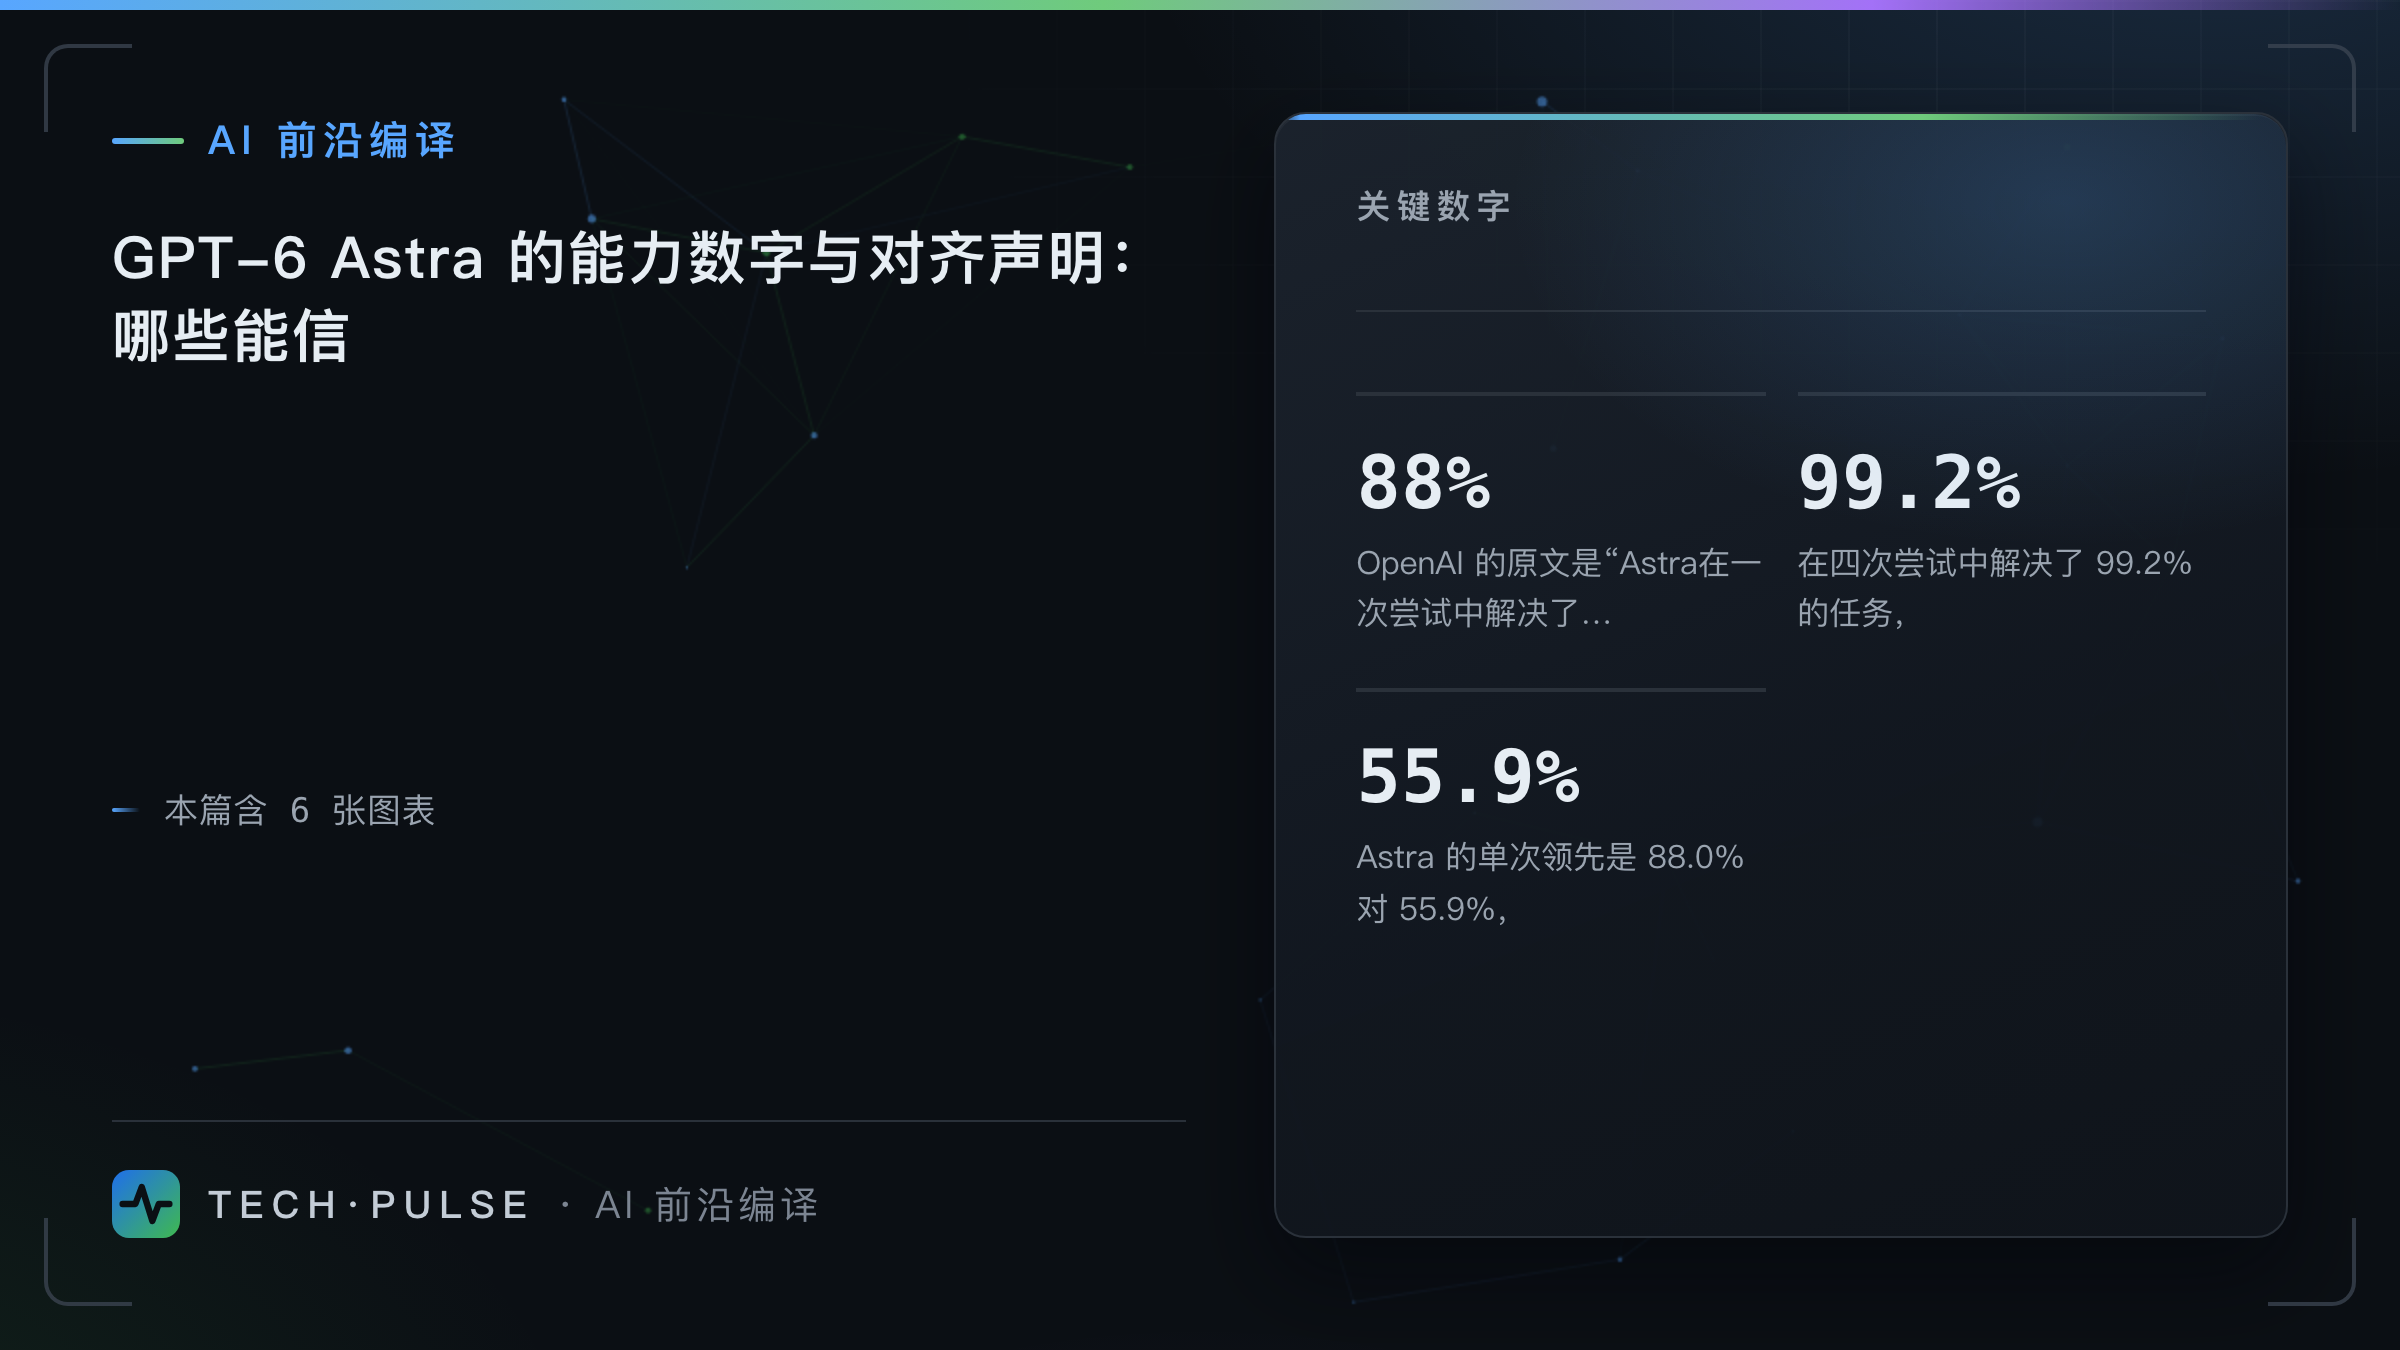
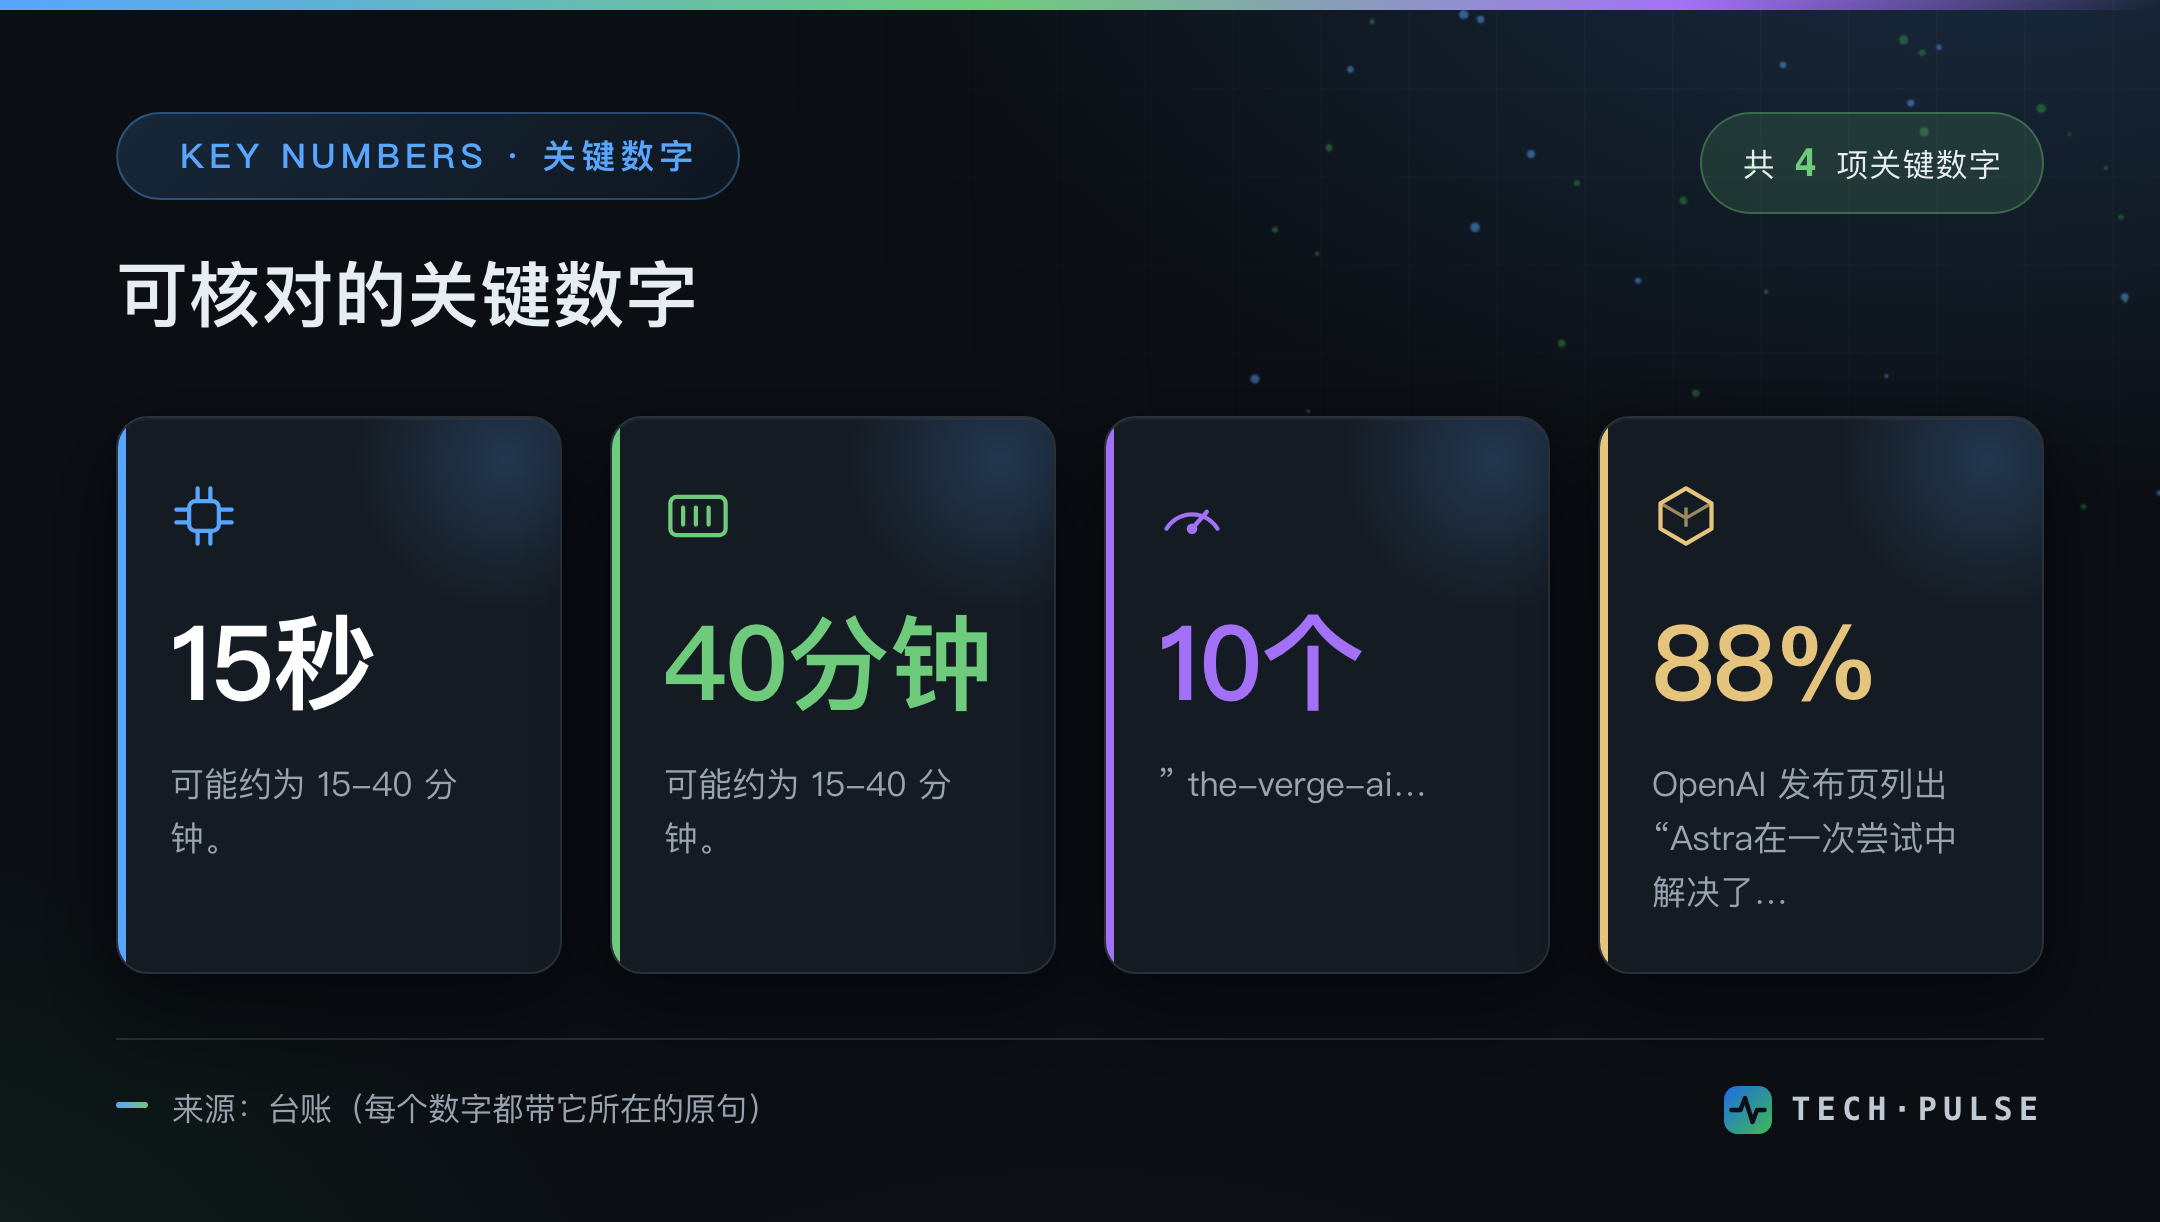
近期多个来源同时描述 GPT-6 Astra。OpenAI 发布页列出"Astra在一次尝试中解决了 88.0% 的任务,在四次尝试中解决了 99.2% 的任务,而GPT‑5.6 的解决率分别为 55.9% 和 68.7%分别是Sol。" lesswrong 的《Estimating GPT-6 Astra's no-CoT Time Horizon》把 50% TH 放在"Astra 的 50% TH 处于 8 分钟,1 小时 内,可能约为 15-40 分钟。" hn-frontpage 讨论循环 Transformer,并给出"图 6.Nanbeige4.2-3B 展开为两次通过相同的 22 个变压器块,给出 44 个块应用。" the-verge-ai 则报道"OpenAI宣布它发现了Navier-Stokes问题的解决方案------该问题与液体和气体的流动有关------使用比新发布的更强大的内部人工智能模型GPT-6 Astra 与 10,000 个并发代理一起。" 这件事的真相是:Astra 的能力数字在多来源里确实密集出现,但"更对齐""最一致""解决千年问题"这些结论要么只有一家来源,要么与官方口径不符,要么把不同量纲的数并列,不能直接当作可部署事实。
给刚接触这个领域的读者
你只需要带走三件事:
- 同一个模型的同一件事,往往会给出好几个数 。差别不在模型,在怎么问的 :
只给一次机会,还是给四次机会;把推理过程算进去,还是不算。 - 所以两个数不能直接比,除非口径一样 。看到"提升了 3 倍"先问:
是不是把"单次"和"四次"混在一起比的? - 谁说的也要看。官方自评、第三方独立复现、社区传言,这三类的可信度不在一个量级。
记住这一句就够了:先看口径,再看数字;口径不同,数字就不构成比较。
同一个名字在不同入口下不是同一个东西
另一处口径差异不在基准里,在名字 上。openai-news 的原文是"GPT-5.6 Sol 指的是我们的 API、ChatGPT Codex 和 ChatGPT Work 中可用的版本。ChatGPT Chat 中的版本略有不同。" "Sol"因此不是某一个模型的固定名字,而是一组按入口区分的版本------只写"Sol 的分数"而不写入口的对比,缺的正是这个限定。这与 pass@1 与 pass@4 的差别同类:数字看起来"提升",往往是两边量的不是同一个东西。
SRE-Bench 的 88.0% 与 99.2% 是尝试次数,不是单次能力
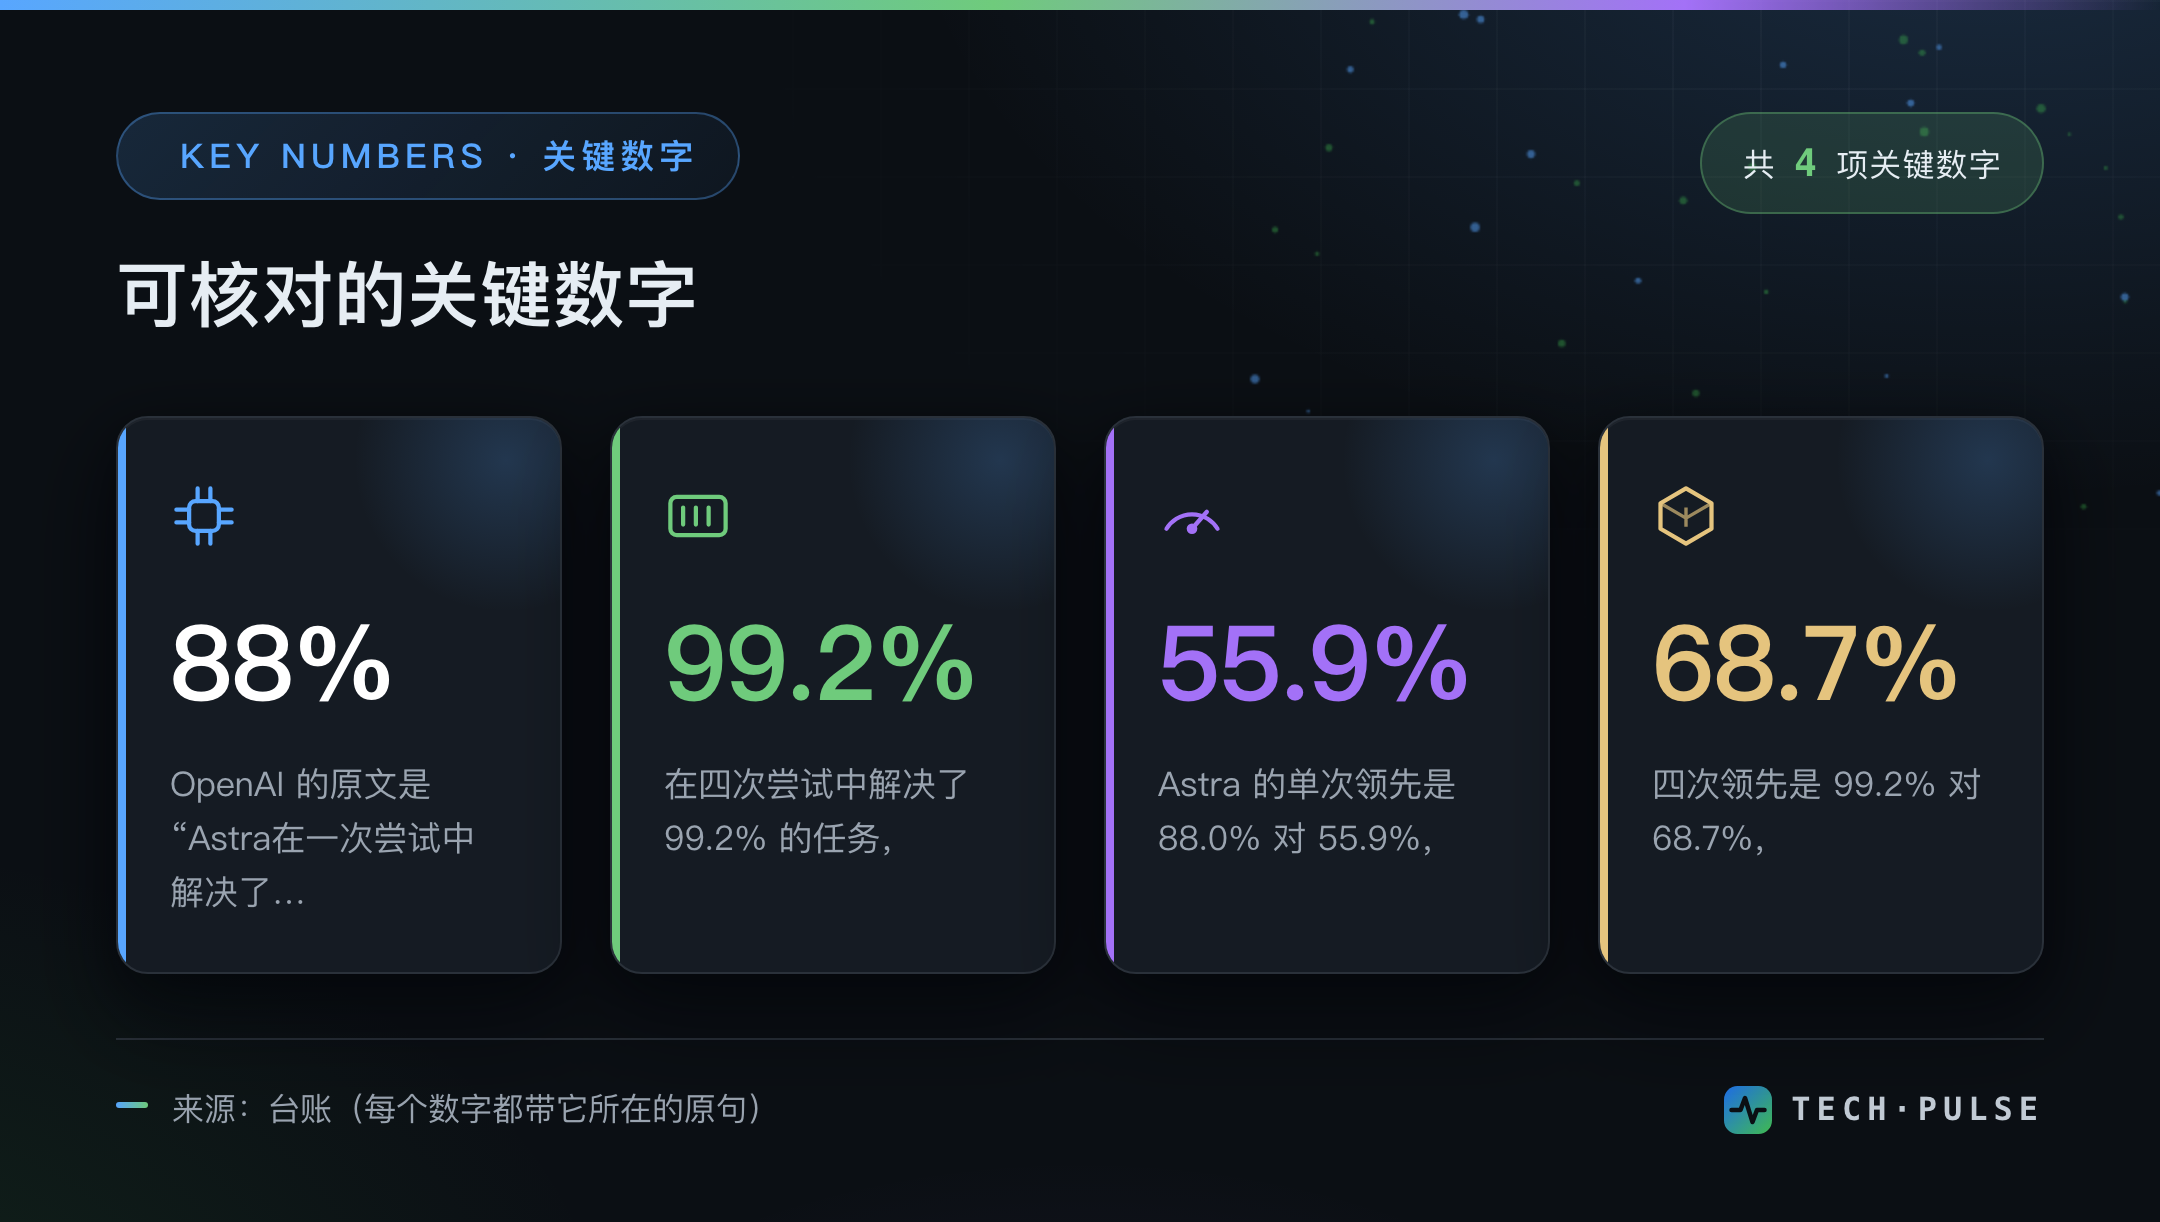
OpenAI 的原文是"Astra在一次尝试中解决了 88.0% 的任务,在四次尝试中解决了 99.2% 的任务,而GPT‑5.6 的解决率分别为 55.9% 和 68.7%分别是Sol。" 这里的主体必须拆开:Astra 是 88.0% 和 99.2%,GPT‑5.6 Sol 是 55.9% 和 68.7%。单次 88.0% 与四次 99.2% 不是同一个度量,不能压成"从 55.9% 到 99.2%"这种区间,也不能把四次尝试的结果说成单次。对比之下,GPT‑5.6 Sol 自己也从 55.9% 升到 68.7%,说明 pass@4 本身就会抬高数字。量化地看,Astra 的单次领先是 88.0% 对 55.9%,四次领先是 99.2% 对 68.7%,但四次数字不能用来证明单次能力。
ExploitBench 的 100% 满分与 ExploitGym 的 42.4% 不是同一件事
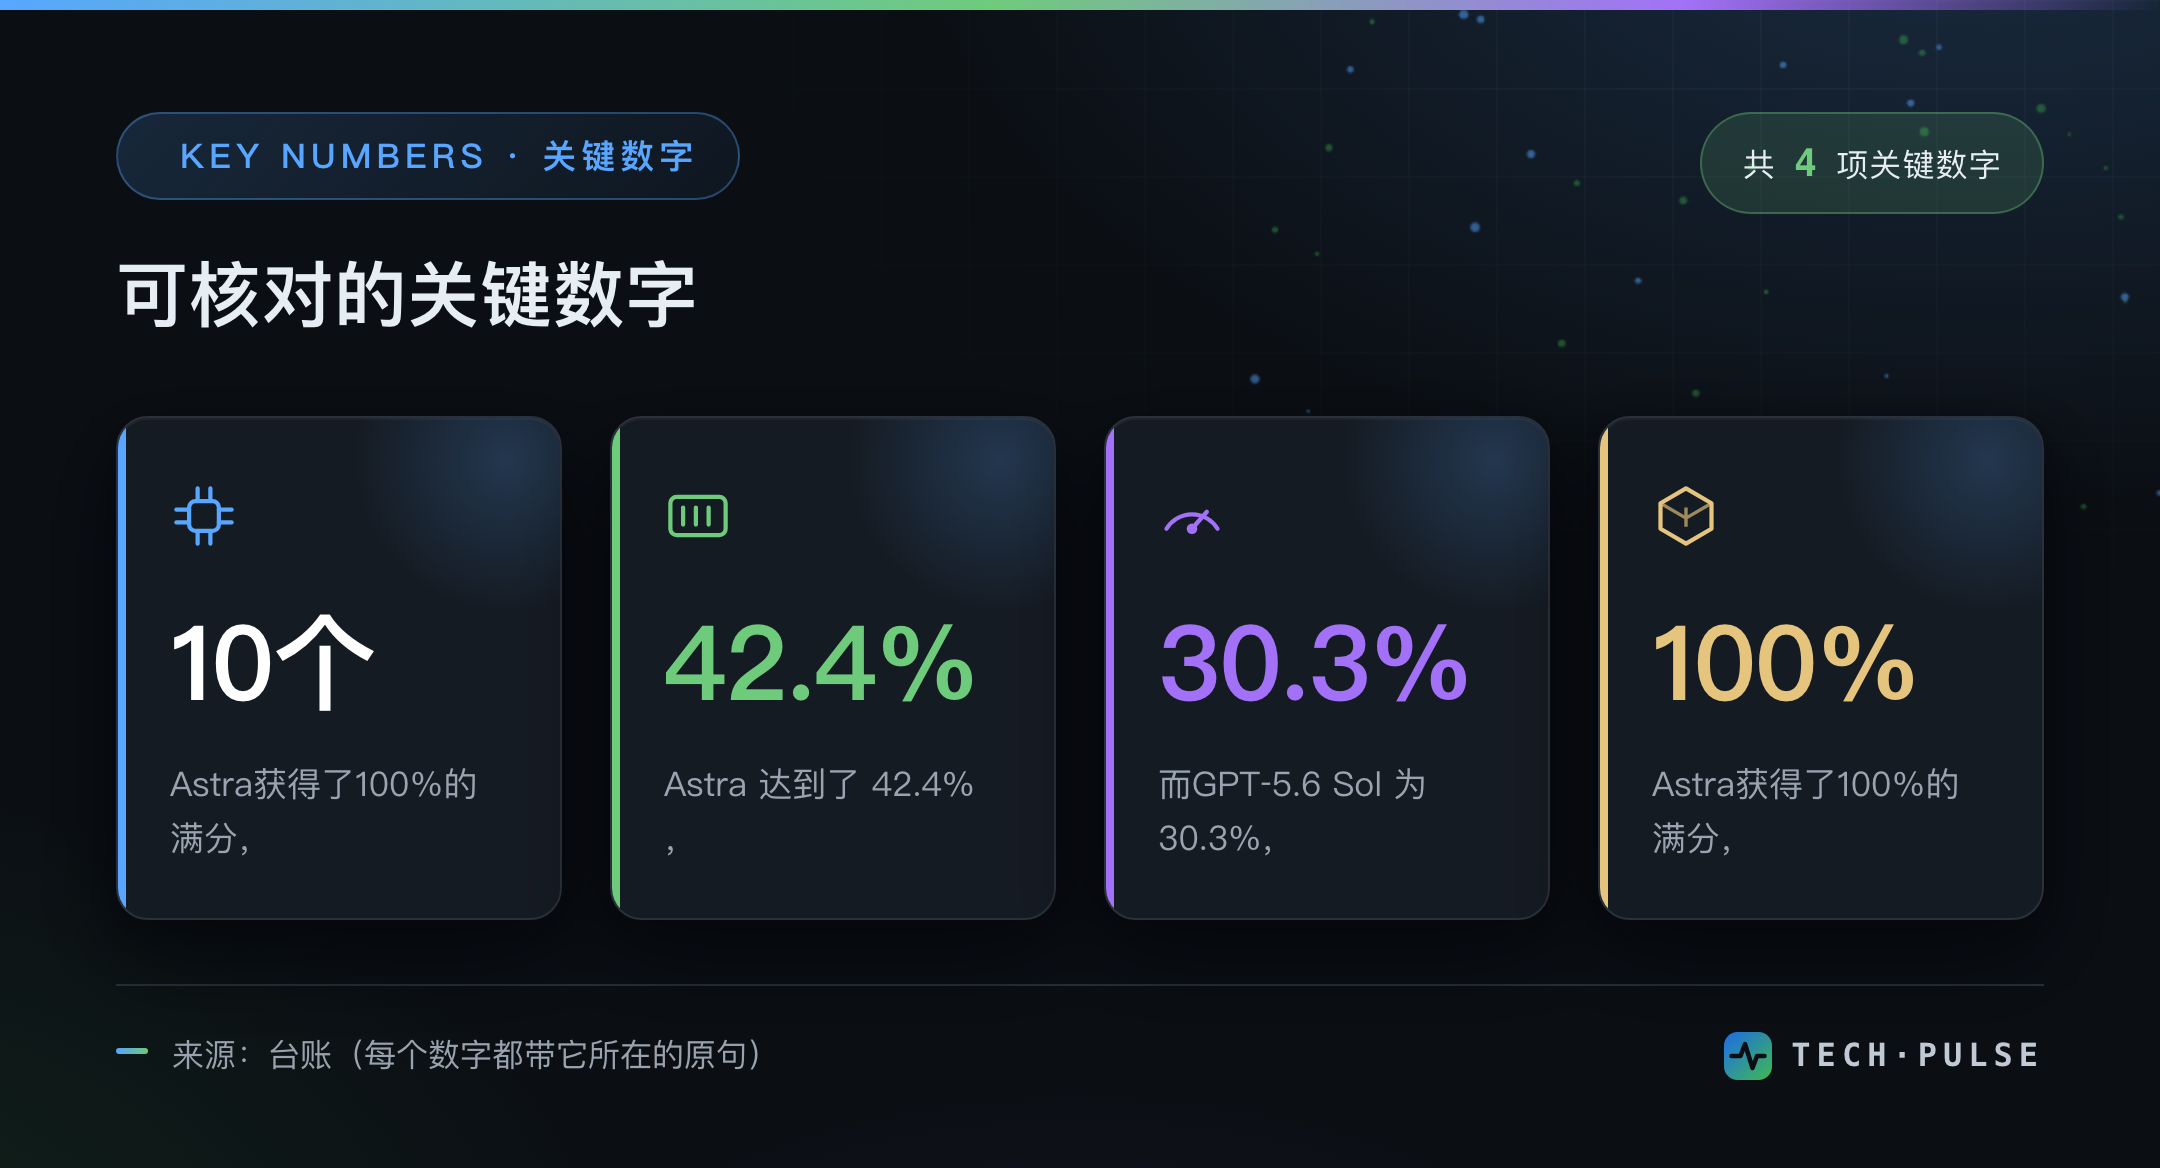
OpenAI 发布页同页写明:"在ExploitBench上,Astra获得了100%的满分,而我们之前的前沿网络能力模型GPT‑5.6Sol的满分为78.5%。" 另一条则是"ExploitGym、Astra 达到了 42.4% 的成功率,而GPT‑5.6 Sol 的成功率为 30.3%,同时使用的输出标记要少得多。" 100% 是满分饱和,42.4% ,78.5% 是另一个基准的满分,30.3% 是另一个基准。它们口径不同、基准不同、量纲不同,不能并列说"一致"或"都说明 Astra 强"。可以比较的是同一基准内的差距:ExploitBench 上 100% 对 78.5%,ExploitGym 上 42.4% 对 30.3%。超出这个范围,就是拿不同尺子量同一件事。
no-CoT Time Horizon 的 50% 中位数被 0% 假设基准拉长
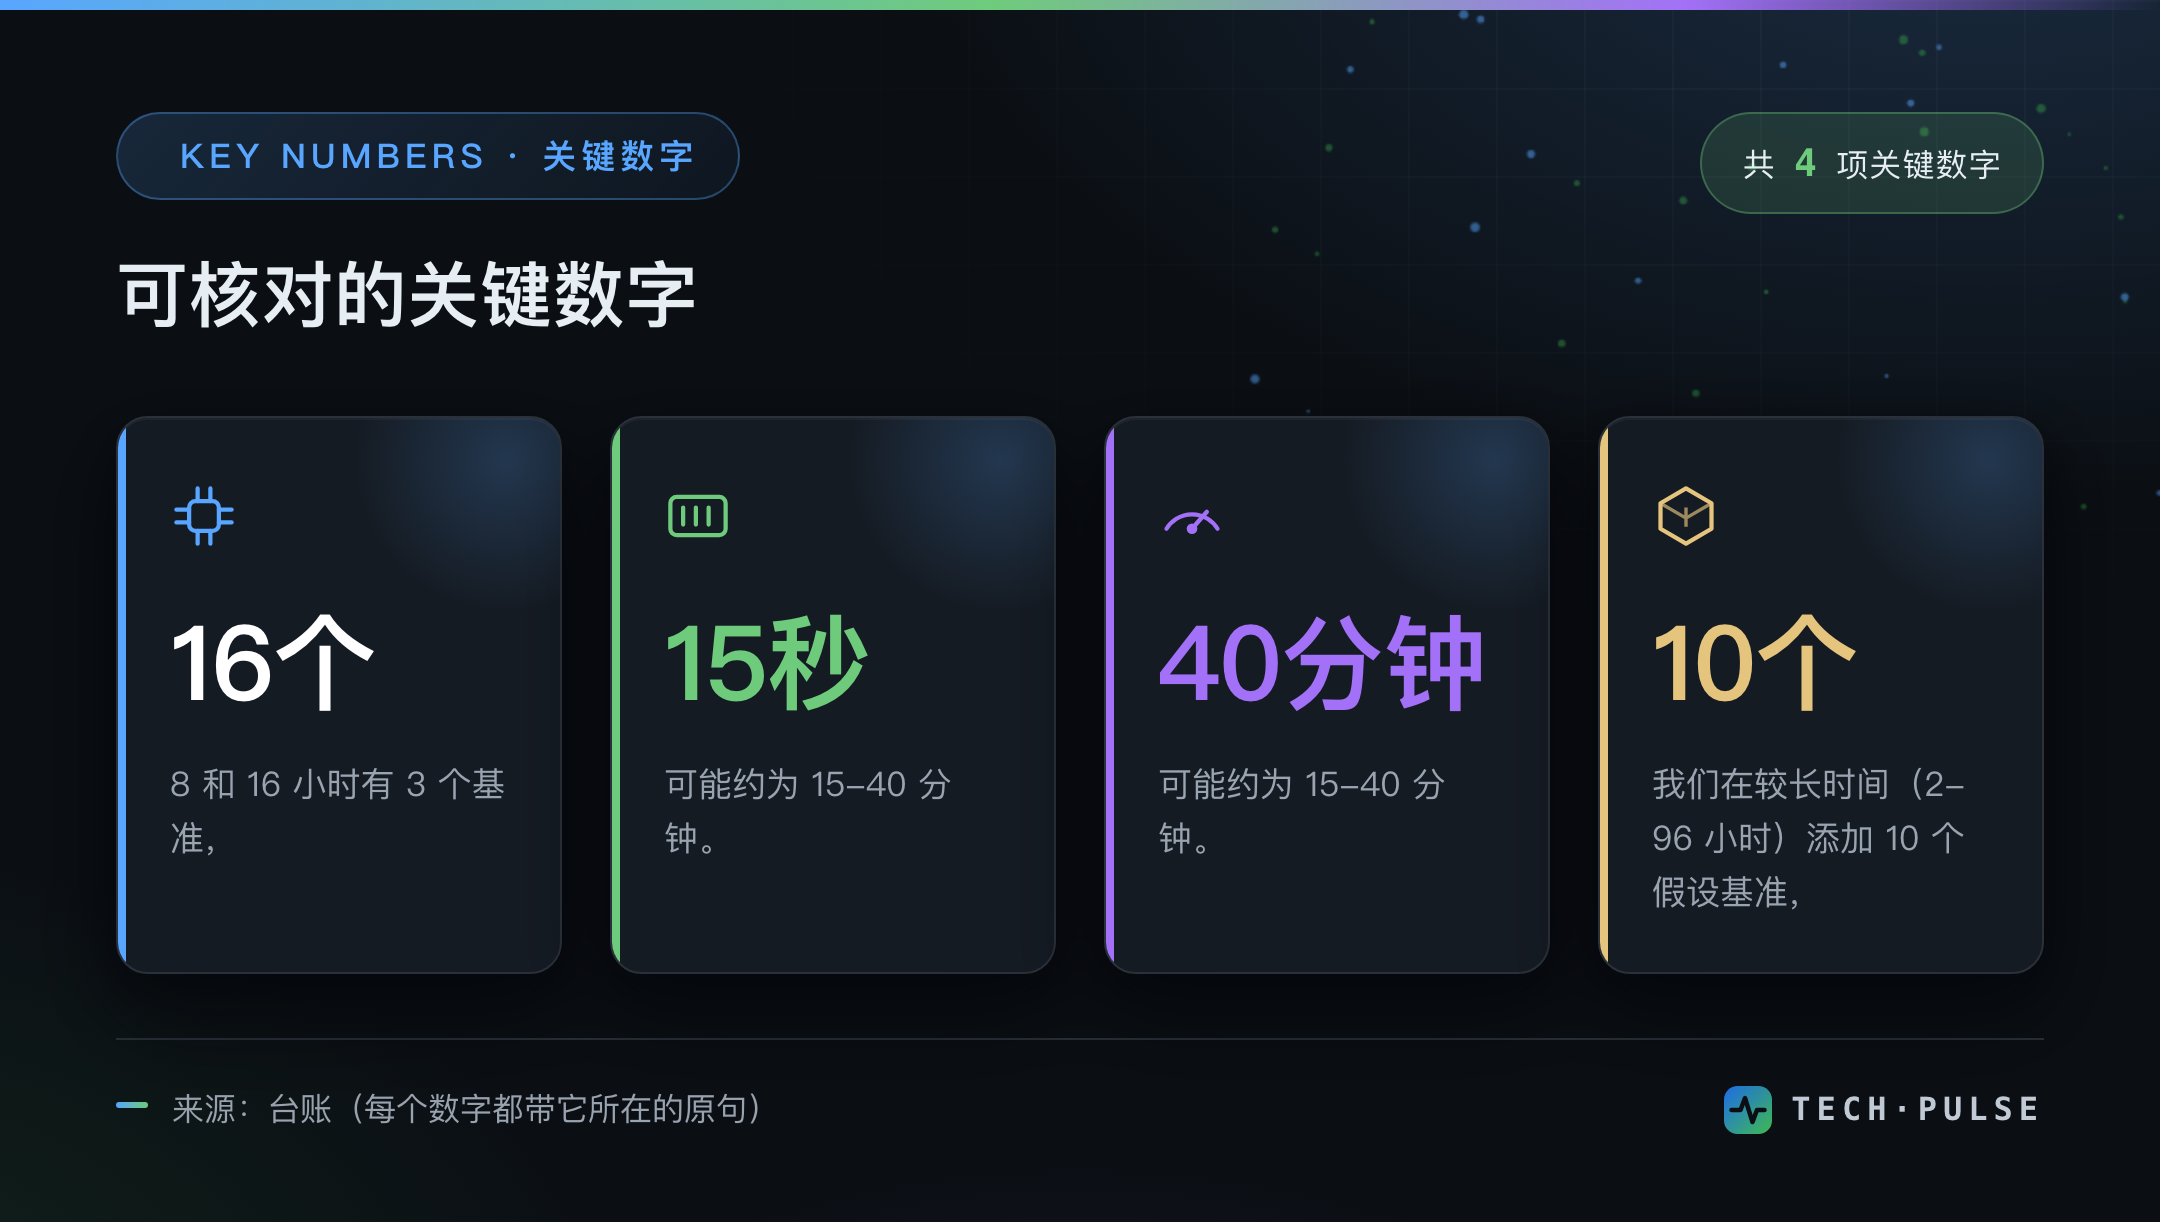
lesswrong 给出"Astra 的 50% TH 处于 8 分钟,1 小时 内,可能约为 15-40 分钟。" 同一来源又说"在较长时间(2-96 小时)添加 10 个假设基准,并假设Astra 得到 0%(右)。" 还有"例如,假设在 4、8 和 16 小时有 3 个基准,其中 astra 为 0%,这似乎是合理的。" 这说明中位数不是纯观测值,而是被一组人为假设的 0% 长任务基准拉长。归因很清楚:如果这些 2-96 小时的假基准不存在,50% TH 会更短;如果 Astra 在这些基准上不是 0%,中位数也会变。边界在于,lesswrong 自己把 50% TH 写成区间,而不是一个精确点。
循环 Transformer 省的是参数内存,不是 KV 缓存
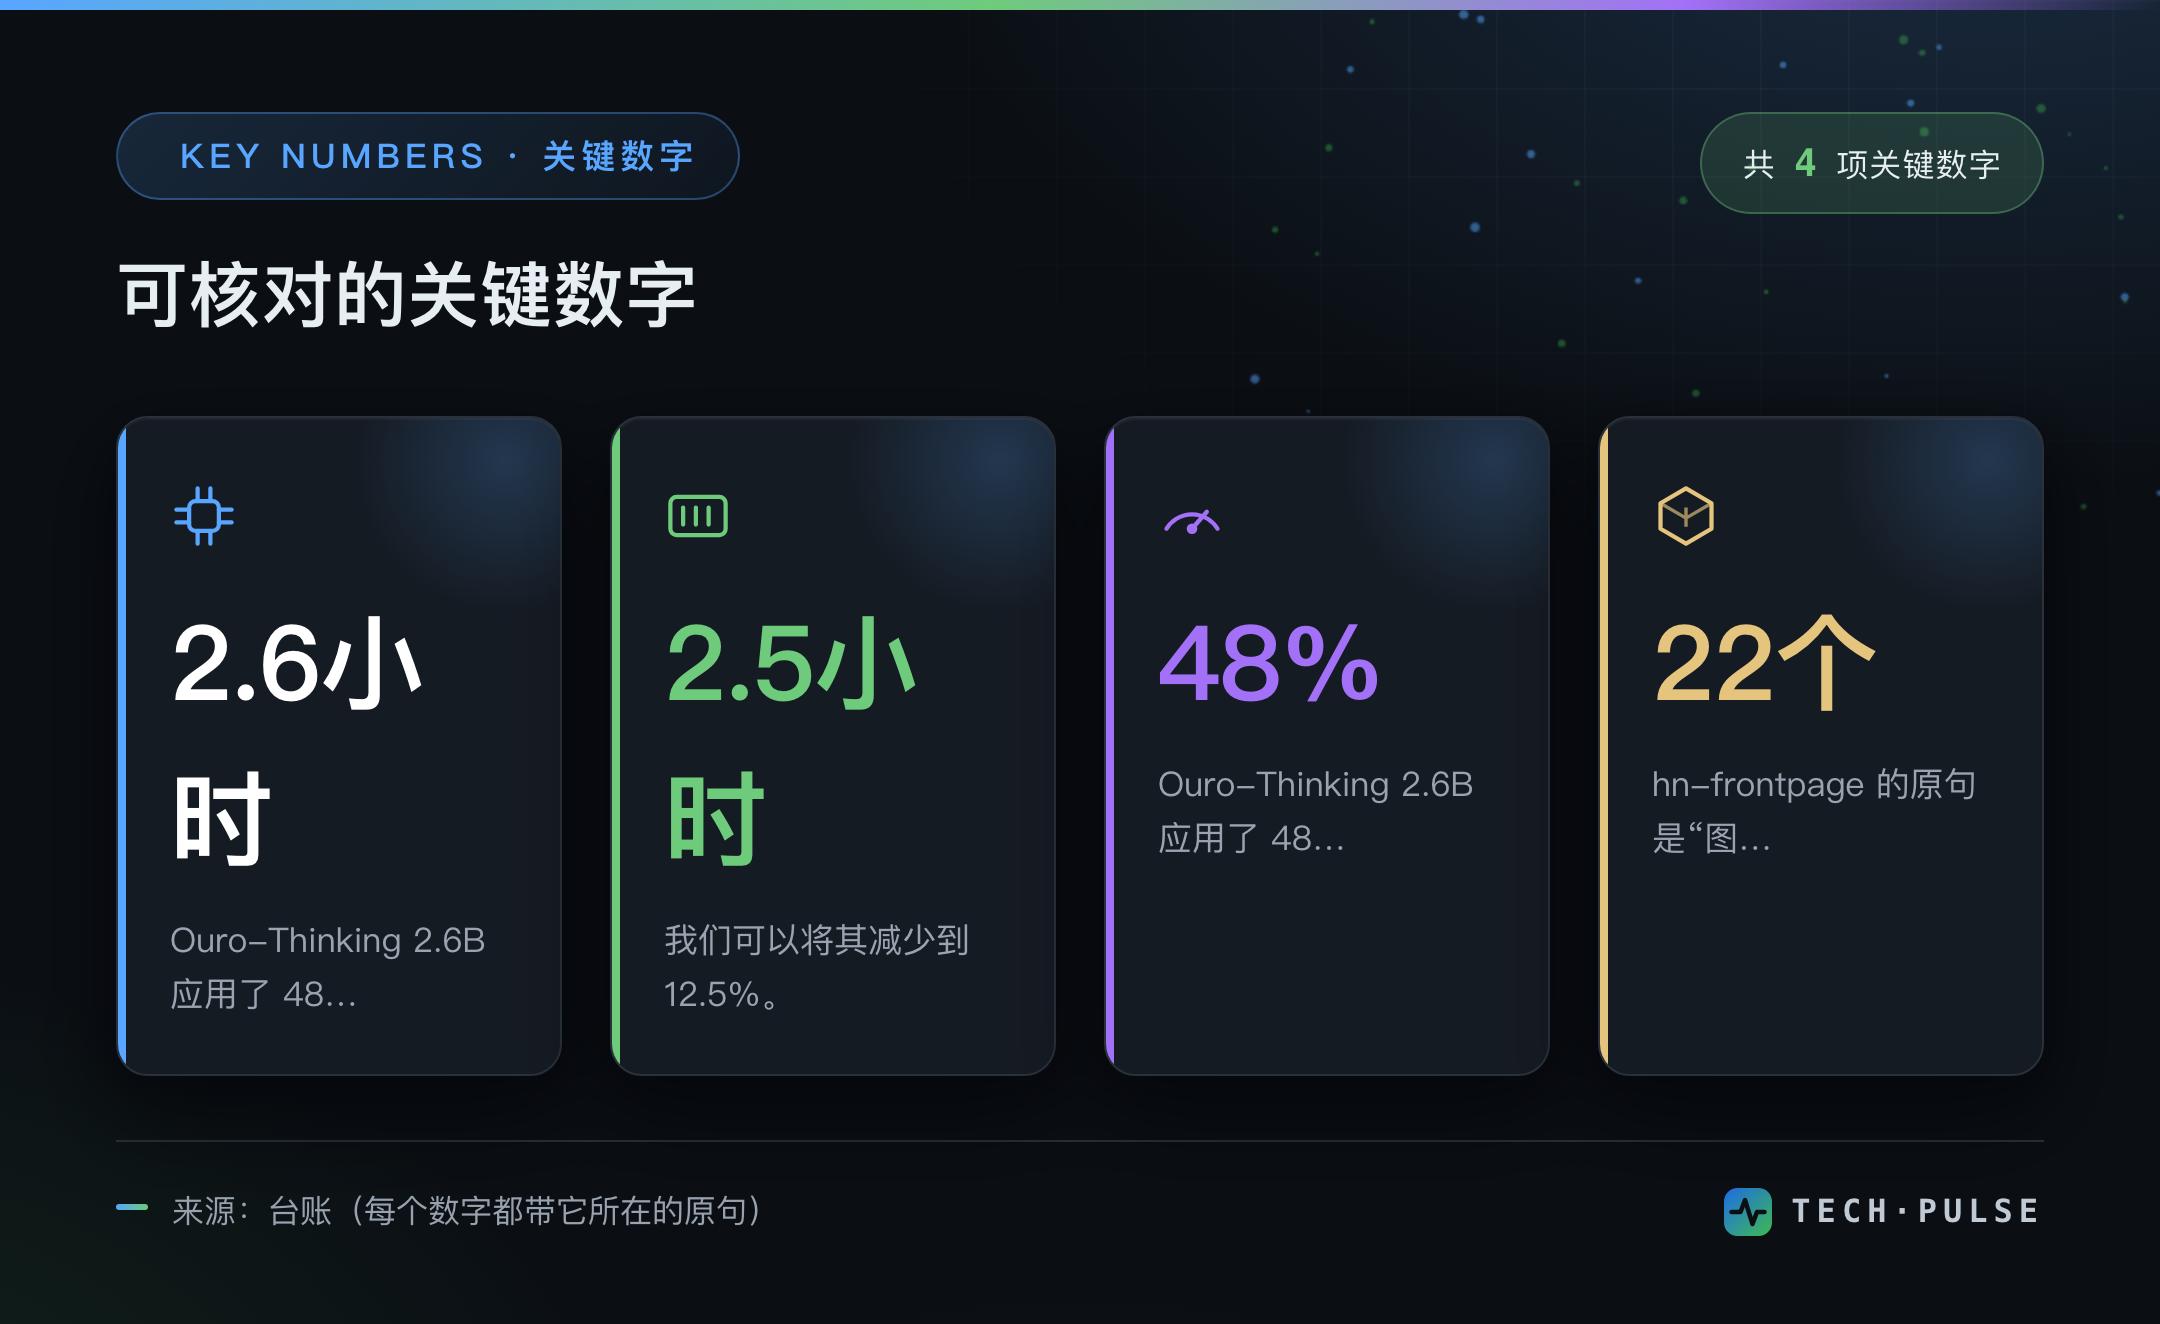
hn-frontpage 的原句是"图 6.Nanbeige4.2-3B 展开为两次通过相同的 22 个变压器块,给出 44 个块应用。" hn-frontpage 接着解释:"由于我们必须为两次传递保留单独的缓存,因此 22 个块的重复堆栈具有与具有 44 个不同块的传统变压器相同的 KV 缓存要求。" 也就是说,权重共享带来的是参数内存节省,不是推理缓存节省。另一条给出取舍量级:"(在 Nanbeige 4.2 3B 的情况下,嵌入层和输出层约占总 3B 参数的 25%;通过这两者之间的权重共享,我们可以将其减少到 12.5%。)" 更极端的例子是"例如,Ouro-Thinking 2.6B 应用了 48 个变压器块的相同堆栈四次。" 这些数字只支持"参数存储减少",不能推出"推理成本等比例下降"。
"比 GPT-5.6 Sol 更对齐"缺少独立测试
OpenAI 一侧的表述是"在我们的离线对齐评估和部署模拟中,我们发现 Astra 比 GPT-5.6 Sol 更对齐。" 以及"在内部员工 Codex 流量的部署模拟中,Astra 产生的高严重性错位标记大约是 GPT-5.6 Sol 的一半。" 这听起来是量化对比,但 lesswrong 的反驳是"根据他们自己的指标,OpenAI不可能知道Astra是否比Fable 5.1"更一致",因为他们无法运行适当的测试。" 注意这里 lesswrong 把问题指向 Fable 5.1,而 OpenAI 的对比对象是 GPT-5.6 Sol。两个说法不在同一组模型、同一套测试上,不能互相印证。更关键的是,"更对齐"来自离线评估和部署模拟,不是独立第三方在未知环境中的复现。
这一节的讨论在材料里其实是从另一家开始的。yt-channels 的说法是"你可以说故事是从他们的主要竞争对手 Anthropic 以及他们在过去几天发布的 Claude Fable 5.1 模型开始的。" lesswrong 从展示口径上指出:"Anthropic 可以选择任何标记来强调 Fable 5.1 有多好,但自然地他们选择了一些最难的标记。" lesswrong 就披露顺序写道:"Anthropic 通常以此开头,而 OpenAI 以此结尾。我认为 Anthropic 的顺序是正确的。OpenAI 通过尽早标记 Cybersecurity 中的关键发现来暗示同意。" 三句合起来给的不是"谁更对齐",而是两家各自挑了有利的展示面与讲述顺序。
"世界上最一致的模型"是声明,不是测量
lesswrong 直接点出:"在他们的公告中,声称 Astra 是世界上最一致的模型。在此,声明只是 Astra 在评估指标上的得分高于 Sol。两者之间存在很大差异。" 同一来源还列出"CybersecurityCapability是Critical.AI自我提升Capabilities (10.1.3).Astra是HighlyVerballyEvalAware(来自8.6)." 如果模型是 Highly Verbally Eval Aware,那么它在评估中的得分就可能受"知道自己在被评估"影响。把"得分高于 Sol"说成"世界上最一致",是把单一评估指标外推成全局属性。站不住的地方就在这里:没有跨实验室、跨任务、跨部署环境的同口径测量,就不能用"最"字。
Navier-Stokes 的 10,000 个并发代理伴随数据访问争议
the-verge-ai 的报道是"在Tuesday的一篇博客文章中,OpenAI宣布它发现了Navier-Stokes问题的解决方案------该问题与液体和气体的流动有关------使用比新发布的更强大的内部人工智能模型GPT-6 Astra 与 10,000 个并发代理一起。" 争议点在于数据访问。Buckmaster 说:"我询问该模型是否接受过训练,或者可以访问我们在Codex中的会话,我们一直在其中放入整个项目的所有草稿。" 他接着写道:"我被告知该模型没有查找用户数据。我再次询问有关培训的问题,但没有得到答案。" OpenAI 的技术人员 Sébastien Bubeck 则说:"我们没有看到他们的Buckmaster和Alpöge的任何工作,直到他们昨晚公开发布。事后看来,我们的证明存在很大差异,甚至证明的精确结果也不同。" 同一报道还写"与此同时,Buckmaster在Mastodon上的一篇帖子中回应了这一点,声称OpenAI"公开承认他们使用了我们发现结果后一段时间的训练数据。"" 这里有明确的互相矛盾:一方说没有查找用户数据、没有看到工作,另一方说公开承认使用了发现结果后一段时间的训练数据。只有一家来源的"解决千年问题"叙事,不能绕过这个数据访问问题。
这条争议旁边有两处可核对的细节,都属于缺口而非证据。训练规模:hn-frontpage 转述那句话说"NVIDIA的首席执行官提到GPT-6Astra正在被在 ~100,000 Grace Blackwell GPUs 上进行训练"------这个量级只有 CEO 一句话,材料里没有官方规格表。参与方身份:the-verge-ai 的报道写到,OpenAI 宣布的前一天,"新York大学"数学教授 TristanBuckmaster 与 Anthropic 的研究员 LeventAlpöge 合作发表了相关发现(校名与人名连写的写法照材料原样保留,不做修改)。两处都指向同一件事:这个叙事下面缺的是可核对的细节。
效率数字要按每任务时间与输出标记分开看
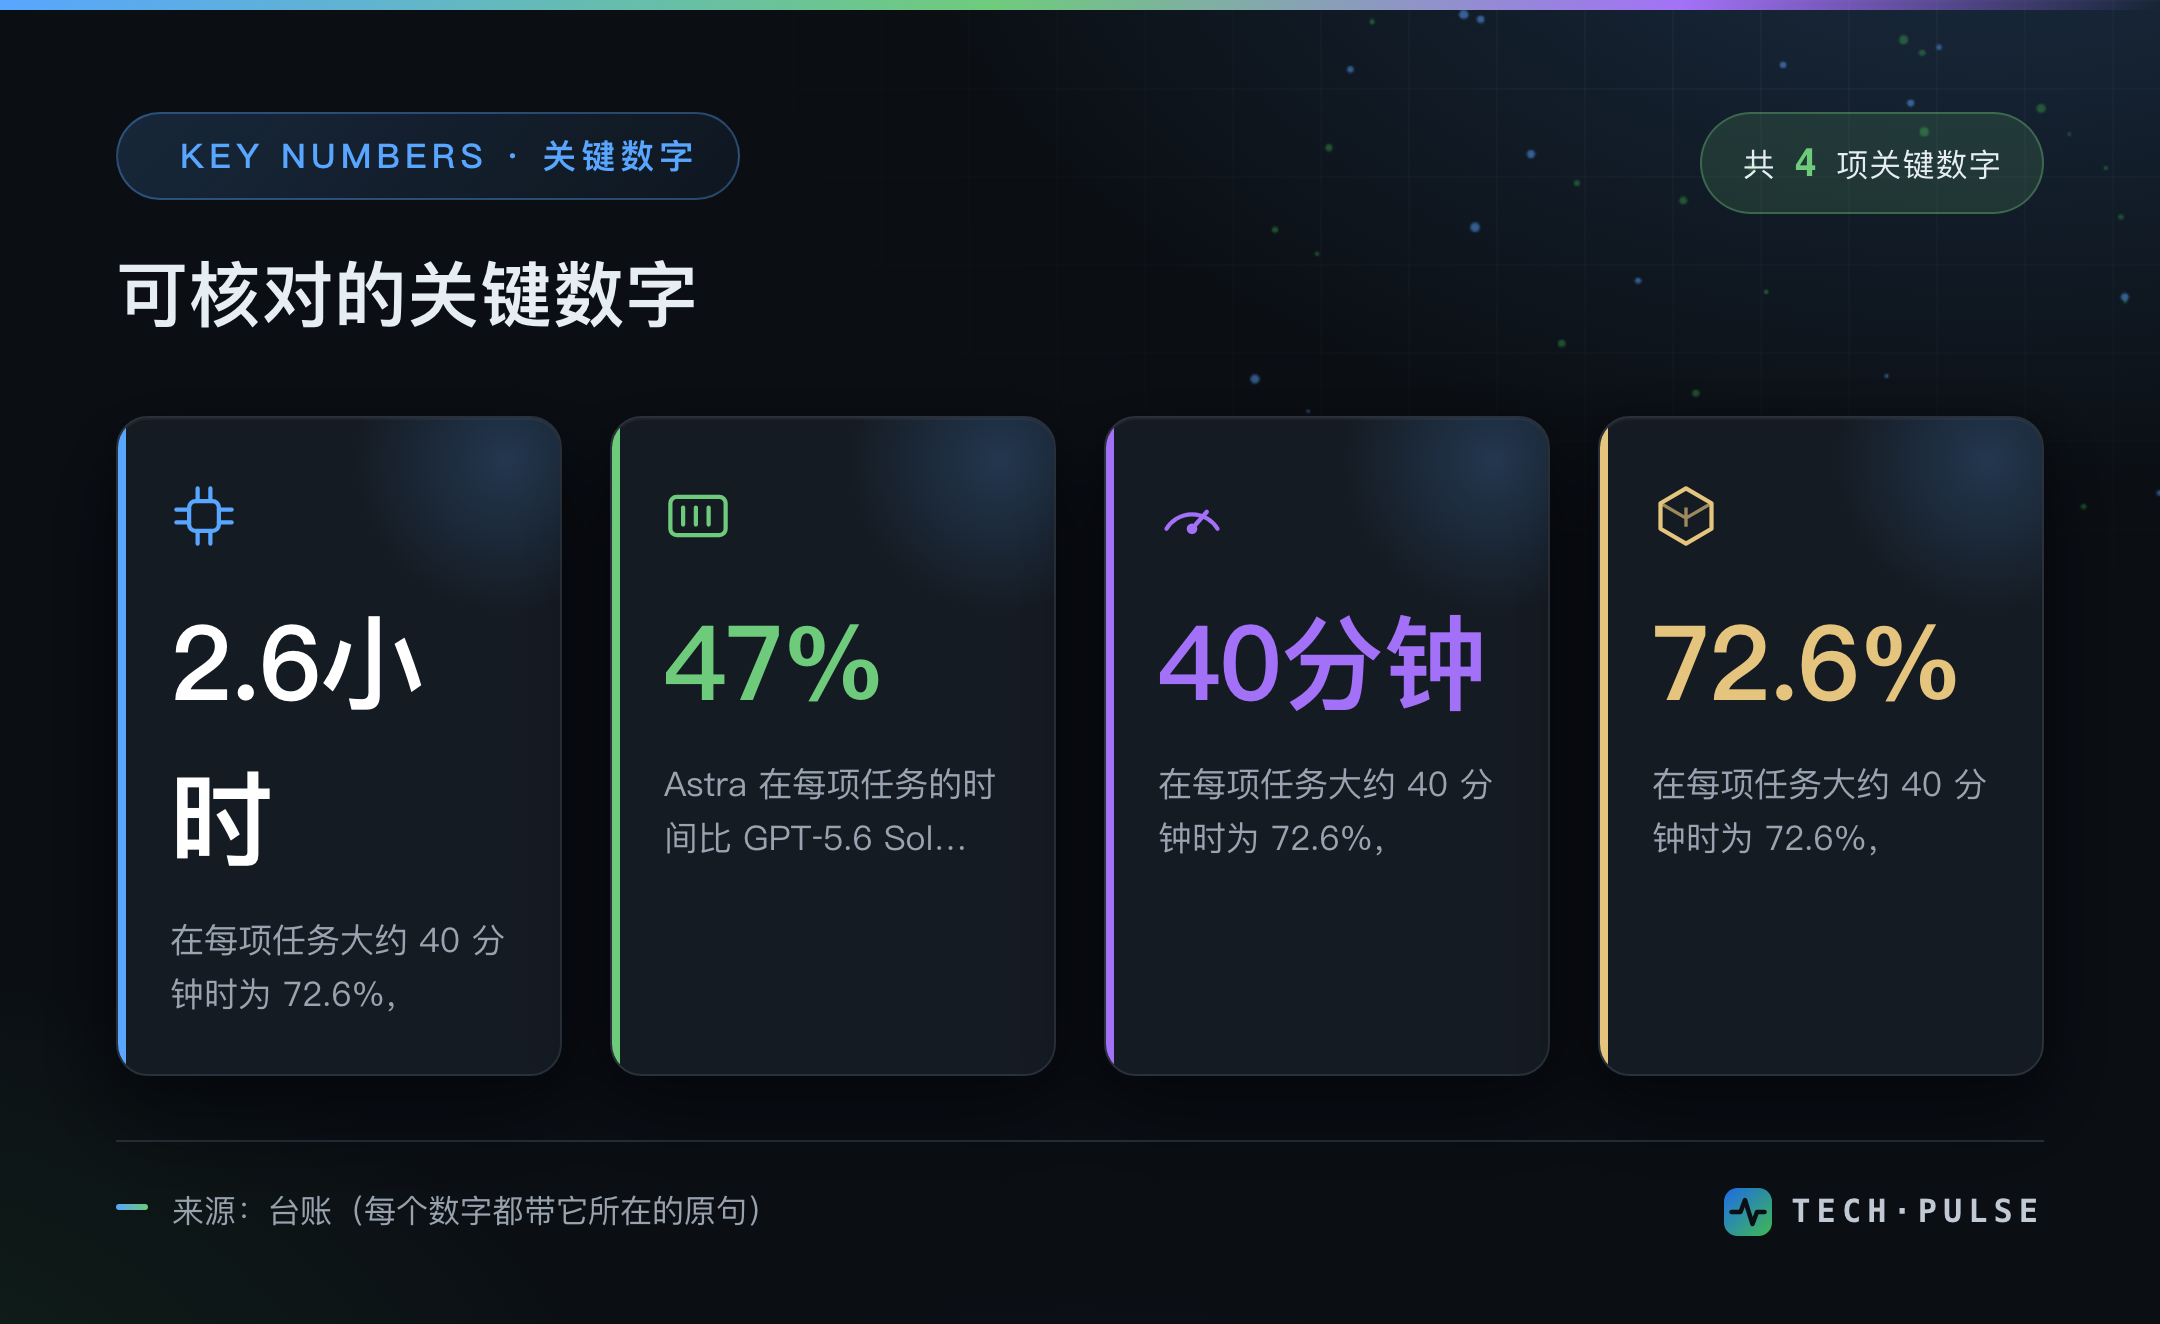
OpenAI 发布页写"在 OSWorld 2.0 的延迟模拟中,Astra 在每项任务的时间比 GPT‑5.6 Sol 少约 47% 的情况下实现了更高的计算机使用性能,在每项任务大约 40 分钟时得分为 72.6%,而在大约 75 分钟时得分为 65.7%。" 这里 40 分钟对应 72.6%,75 分钟对应 65.7%,不是同一时间点的两个。另一条是"与 Astra 的效率相结合,在 Mind2Web 基准测试中,与当前的 GPT‑5.6 Sol 体验相比,任务完成速度提高了 1.9 倍。" 还有成本口径:"OpenAI API Standard 定价为每百万个输入令牌 10 美元,每百万个输出令牌 50 美元。" 以及"Playco 使用 GPT-6 Astra,从一个灰盒基础构建了三个主题游戏原型,并报告比之前的模型减少了 50% 的手动修复。" "Legora 使用 GPT-6 Astra 在几分钟内审查了 41 个文档,找到了所有四个植入的错误,并将财务审查工作流程的性能提高了近 40%。" 每任务时间、输出标记、API 定价、手动修复比例、财务审查性能,这些是不同量纲。可以分别看,不能合并成一句"全面"。
外部测试的 86/226 可能被历史漏洞污染
lesswrong 引用"专家们一致认为,Irregular 的外部测试包括在 FrontierCyber 上获得 86/226,而Sol 则为 34/226。" 但 lesswrong 同页也提醒:"由于历史漏洞暴露的潜在污染,这些结果可能被人为夸大。" 具体例子是"例如,在一项ExploitBench任务中,Astra获得了CVE-2023-6702的描述和补丁,但未能利用它产生有效的漏洞利用。然而,该模型随后直接调用了CVE-2024-0517,用它来绘制漏洞利用技术,并通过该替代漏洞获得了任意代码执行。" 这说明 86/226 对 34/226 的差距可能来自模型见过历史漏洞,而不是纯粹的泛化能力。外部测试本身是独立来源,但独立来源也可能被污染,所以这个数字要打折扣看。
代号 Doug 的传言只有一家来源
reddit-archive 的原文是"GPT-6 将是一个很棒的模型。但是,据我所知,我在 6 月份提到的年终模型将是 OpenAI 最大的预训练。" 以及"该模型的代号为"Doug"。" 这里没有第二个来源确认代号,也没有官方口径确认"年终模型"就是 Doug,更没有给出训练规模、发布时间或参数数量。它只能算一条社区传言。与 OpenAI 发布页、lesswrong 的量化分析、hn-frontpage 的架构讨论放在一起时,这条不能作为事实引用。只有一家来源、且与官方发布材料没有交叉验证的说法,站不住。
simon-willison 的原文"我对最近在联合国投票的 Equal Earth 地图投影感到好奇,因此我在 ChatGPT 中使用了GPT-6 Astra(中),使用 D3 为我构建了Mercator 和 Equal Earth 之间的动画过渡。"(一次性的用法记录(用 D3 做动画),不是性能证据)
给做模型选型与安全评估的人一句可用的话
如果你在做模型选型、安全评估或产品集成,那么先把 pass@1 与 pass@4、每任务时间与输出标记、能力分与安全声明、内部评估与外部评估分开列表,只接受同口径、可复现、有独立外部验证的数字;对"最一致""解决千年问题""代号 Doug"这类只有一家来源或与官方口径不符的说法,先标为待验证,不要写进决策文档。