小智服务端怎样组织 ASR、LLM、TTS?先追本次连接实际使用的对象
TL;DR
- 场景:改了模型配置,设备能连、识别有文本,但回答不像预期模型,或者文字已出而扬声器未起。
- 结论 :"ASR→LLM→TTS" 只说明大方向。本连接实际拿到的对象要追到本次连接的配置来源(本地合并或 API + 设备私有覆盖)、别名 →
type→ 工厂 → 实例、连接构造是否真的重建组件,以及识别/合成/发送的具体交接点。配置有manager-api.url时改本地模型段不会影响该连接;ASR 在公共实例为InterfaceType.LOCAL时复用,否则按本连接配置新建;TTS 按本连接创建,且 ASR/VAD 是否替换还要走配置比较函数。识别有len(pcm_bytes) > 1920 * 15 = 28800的字节门槛 +InterfaceType.STREAM/ 手动模式分支;TTS 还有首段/后续段不同标点集合与sentence_id过期过滤。 - 产出:配置加载路径与别名/type 双段选择图 + 连接配置副本与对象引用图 + ASR 非流式触发连续源码 + LabLLM 3 步教学方案(复制/切换/核对)+ 4 步观察诊断表(无文本/未进 chat/报错/未合成)+ 3 步别名对照记录模板(记录 A / 记录 B / 复核)。
你给小智服务端改了模型配置,设备仍能连接,日志也有识别文本,但回答不像预期模型,或者文字已经出来,扬声器还没开始说话。此时"ASR→LLM→TTS"只能说明大方向:它没有告诉你,这个设备到底拿到了哪份配置、哪个实例,又在哪个交接点等待。
本文沿 xinnan-tech/xiaozhi-esp32-server 的一条普通语音对话路径查这些问题。它是为小智设备提供后端能力的第三方开源项目,不是虾哥官方托管服务的源码披露。核验版本固定为 6afc54a17def47578a4b3efc4680873689d3168b,核验日期 2026-09-12。下文的配置案例与排查动作均为源码推演,没有启动服务、调用模型或录音实测;仓库自己的部署警告也不能被"能运行"替代。
要建立的判断很具体:先确定本次连接的配置和 provider 对象,再沿音频、识别文本、回复片段、合成音频追交接。只有找到最后一个完成的交接点,换模型或调参数才有明确对象。
配置名称不是执行类,配置文件也不一定是最终来源
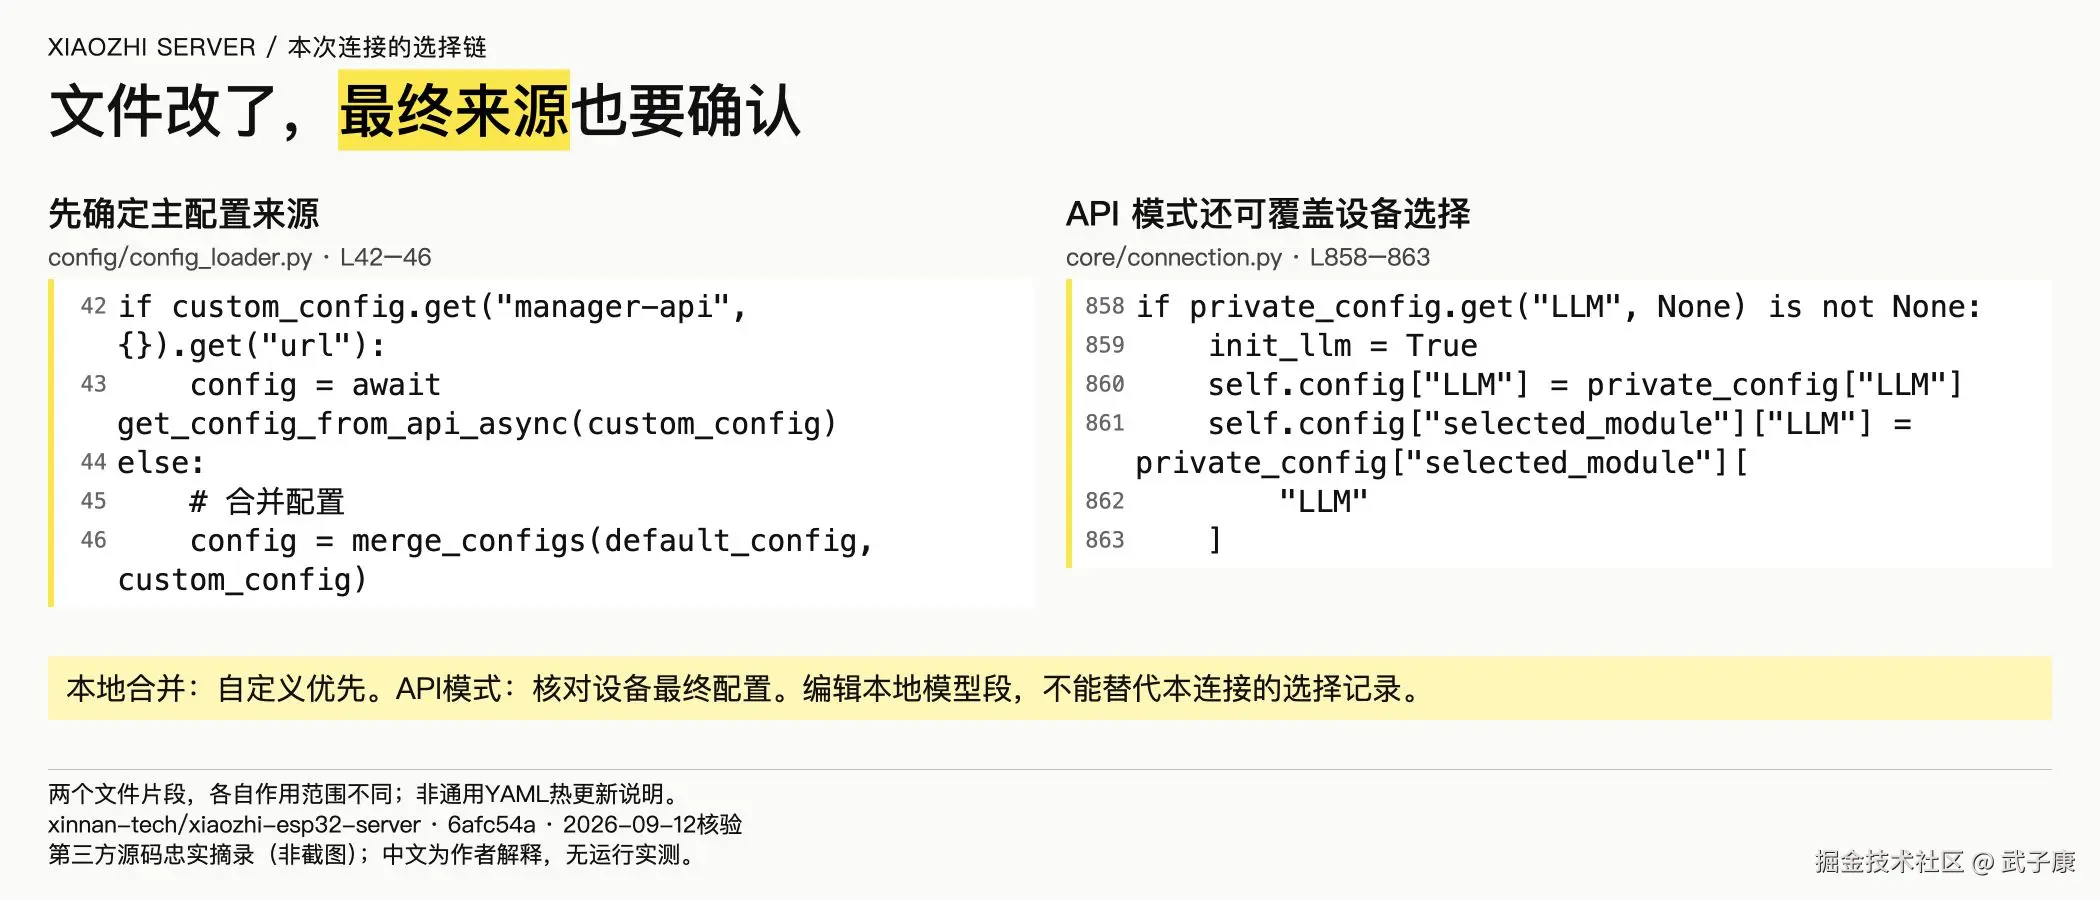
load_config() 首先查 main_config 缓存,命中就返回。没有命中时,才读取默认 config.yaml 与 data/.config.yaml。如果自定义配置含有效的 manager-api.url,代码转向管理接口获取服务端配置;否则递归合并两份本地配置,自定义值优先。同一个 YAML 键,必须先问它属于哪条加载路径。1
这意味着两个常见动作不等价。修改本地默认文件,不等于覆盖了用户配置;修改本地模型段,也不等于改变了管理接口下发的设备模型。API 路径还会在连接阶段请求设备私有配置。排查时应该记录"本地合并"或"管理接口+设备差异",而不是只附一张编辑器截图。
第二个容易误认的名字是 provider 别名。当前默认配置包含下面的关系,摘录省略了其他模块和凭据字段:
yaml
selected_module:
  LLM: ChatGLMLLM
LLM:
  ChatGLMLLM:
    type: openai
    model_name: glm-4-flash
initialize_modules() 先读取 selected_module.LLM,用它找到 LLM 下的具体配置;如果该配置有 type,再用 type 选择实现。这里的 ChatGLMLLM 是配置项名称,实际适配器类型是 openai。后者的工厂加载 core.providers.llm.openai.openai,实例再读取 model_name、base_url 或 url 等连接参数。2
所以,配置别名、适配器类型、模型名称、请求地址是四个不同观察值。接入兼容接口时,别名可以自定义,type 仍可沿用已有适配器;把别名误填成不存在的实现类型,工厂会走"不支持的LLM类型"异常。反过来,日志出现 openai 也不能单凭这个词判定实际调用了哪家模型服务。
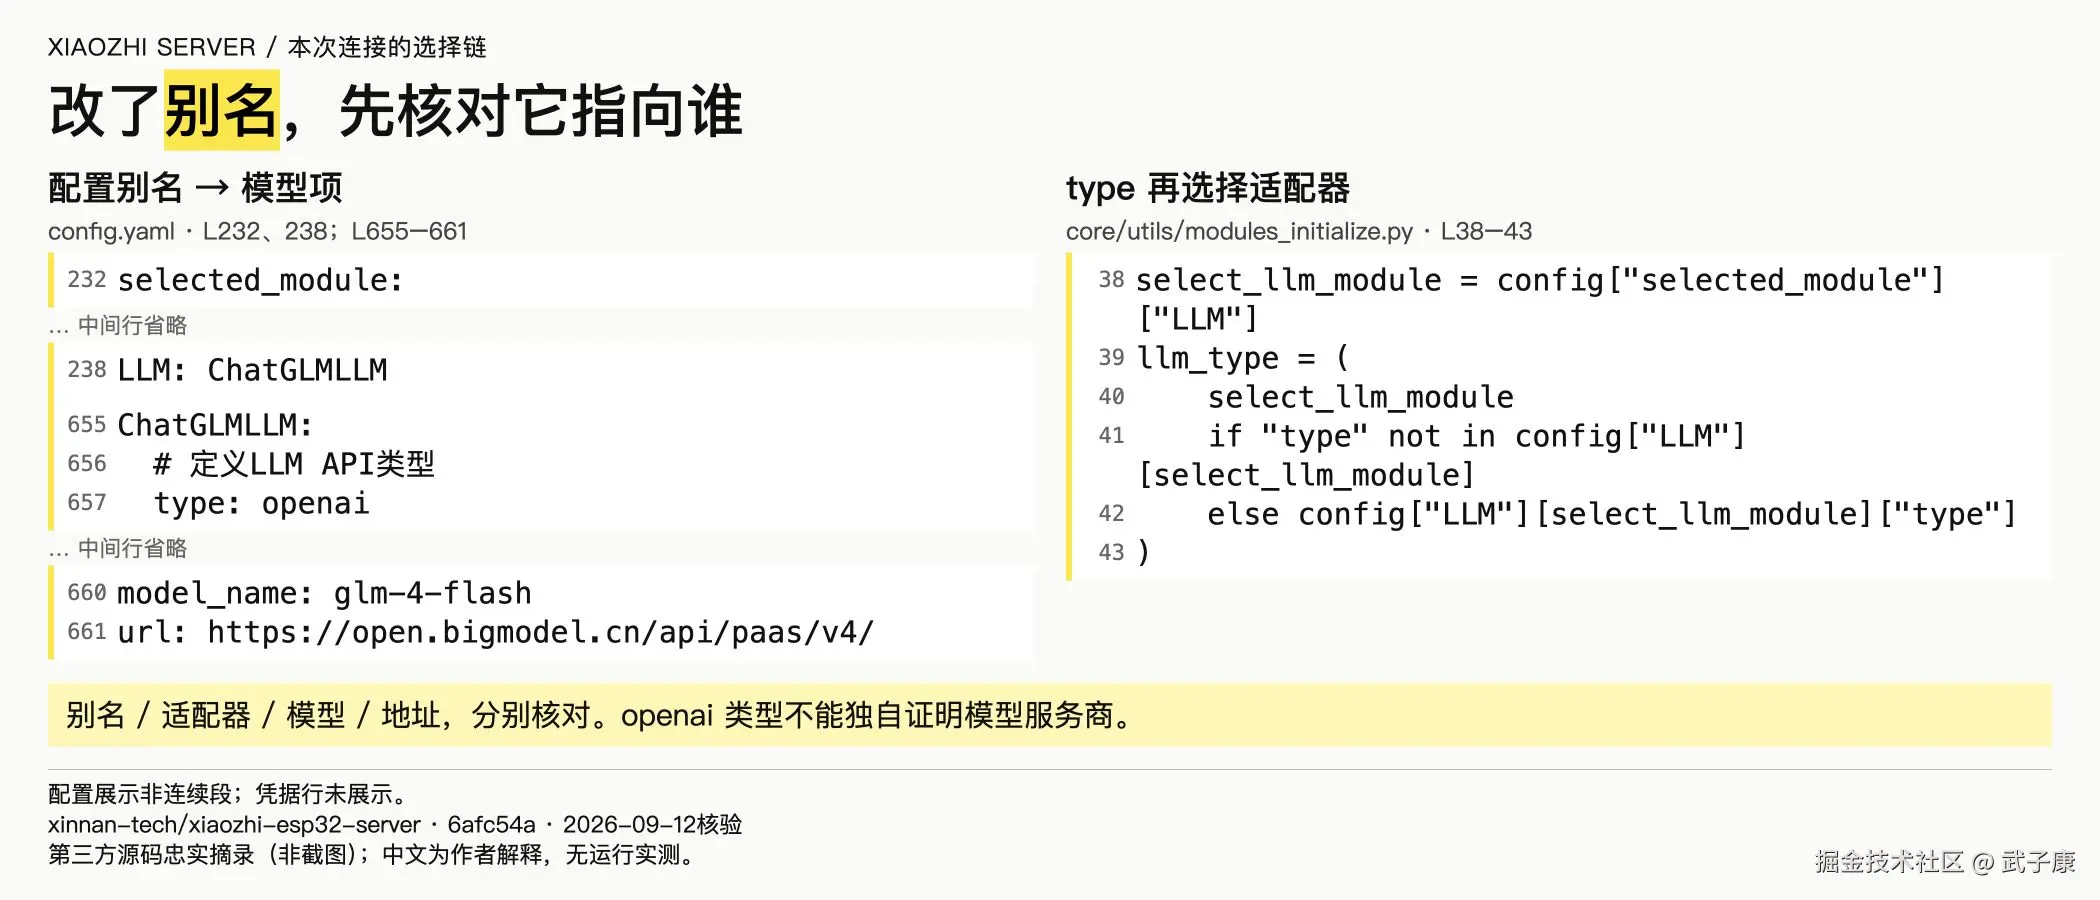
配置刷新同样需要读实际入口。WebSocketServer.update_config() 会从管理接口重新获取配置,并重建相应服务端组件;它不是一个监视 YAML 文件变化的通用 watcher。已有连接又有自己的配置副本和对象引用,因此"服务器刷新成功"与"这条正在说话的连接已切换所有模型"不是同一条事实。本文不据此断言项目完全不能热更新,也不把断开重连解释为能自动绕过主配置缓存。3
一个连接拥有独立状态,却未必独占所有模型实例
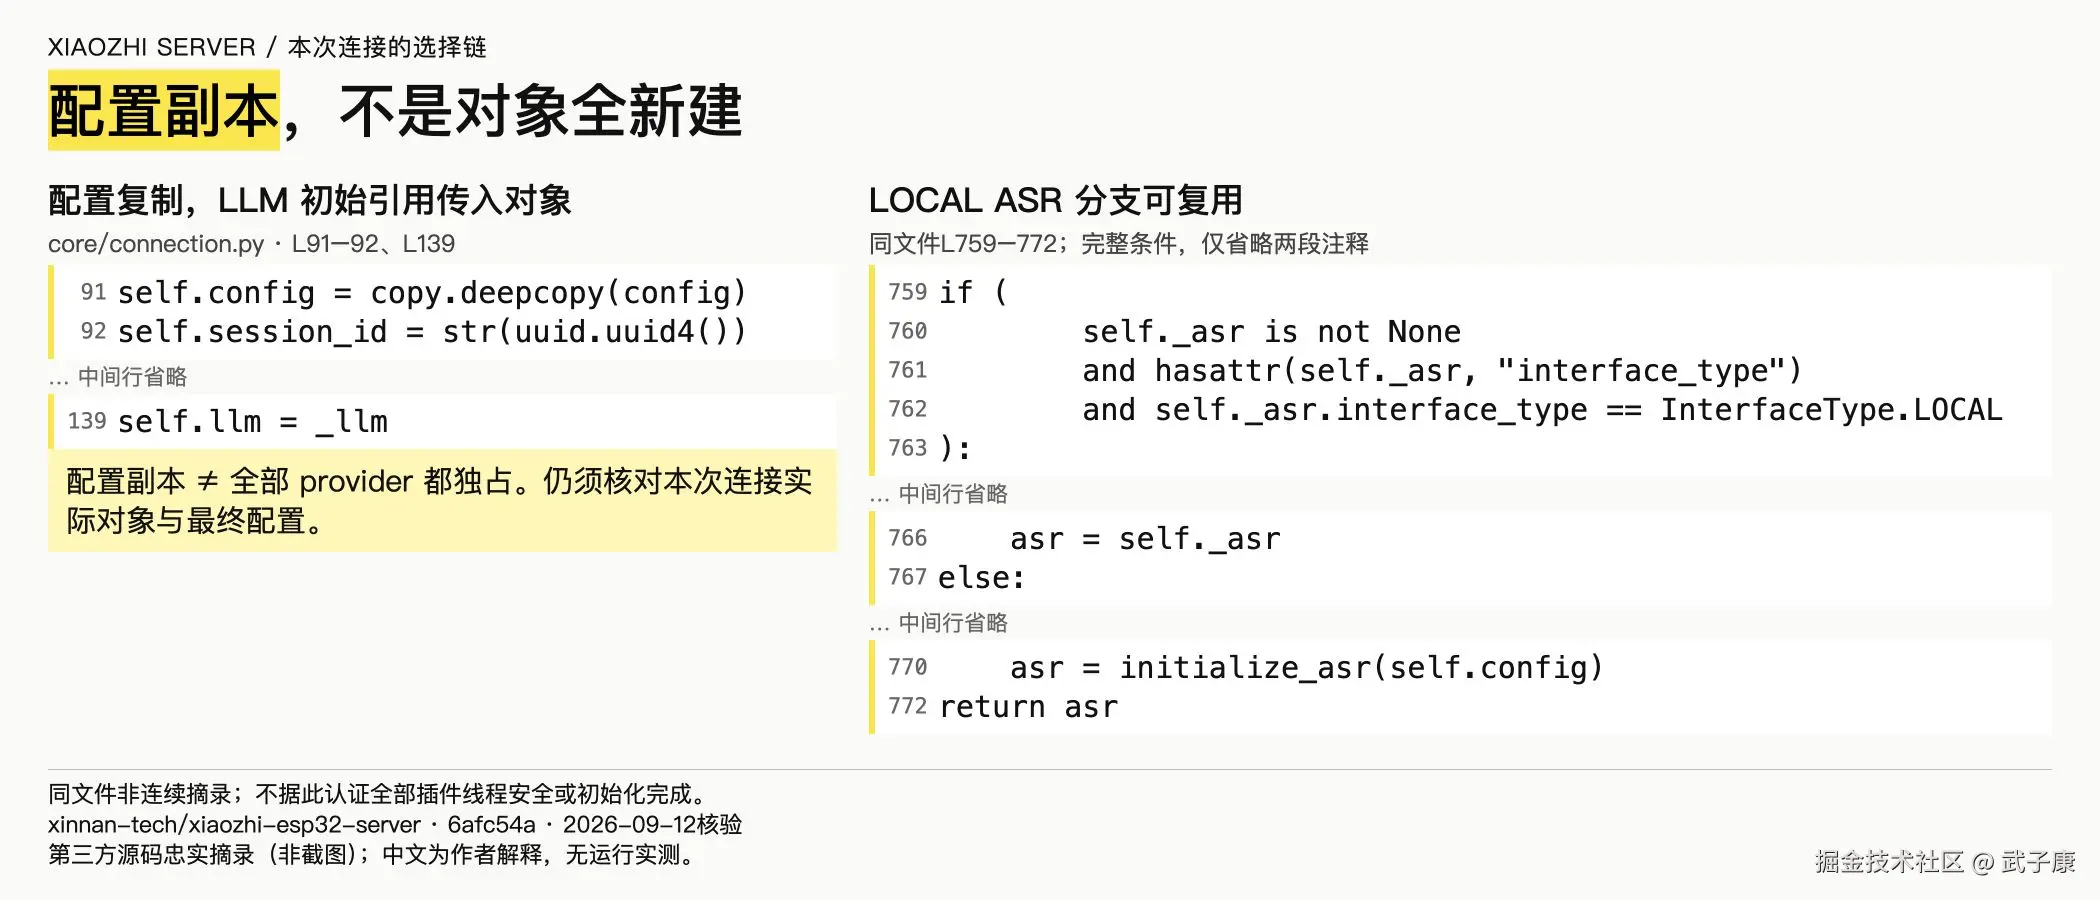
服务端启动时先初始化一部分公共模块,传给 ConnectionHandler。连接构造函数对配置做 copy.deepcopy,生成自己的 session_id,建立对话历史、音频缓存与队列;与此同时,self.llm = _llm 等赋值保留了传入对象的引用。配置副本与模型对象共享可以同时存在。3
ASR 的分支更能说明为什么不能画"每个设备创建三个模型"的图。_initialize_asr() 遇到带 InterfaceType.LOCAL 的公共 ASR 实例时直接复用;其他情况下按本连接配置新建 ASR。代码注释明确把远程连接、接收线程的隔离作为理由。音频列表和 ASR 队列放在 ConnectionHandler 上,也是为了避免把不同连接的中间状态塞进公共识别对象。4
这只是该实现的对象组织,不是对所有插件线程安全性的认证。分析某个新增 provider 时,仍要检查它是否把会话状态错误地存进共享实例。TTS 则在本连接的组件初始化中创建;API 模式下,设备私有配置若提供 TTS 或 LLM 段,会更新本连接对应配置并触发实例初始化。ASR、VAD 是否替换还经过配置比较函数,不能把"接口返回了一个配置字典"直接解释为"全部组件无条件重建"。4
初始化还有时间上的先后。后台任务先获取设备差异配置,再把组件初始化提交到线程池。组件初始化先创建 TTS 并安排打开通道;如果需要绑定设备,就提前返回,后面的 ASR、记忆、意图等正常对话组件不会按同一路径继续。安排协程执行也不等于协程已经完成。
因此,WebSocket 连上只说明连接层走到了一步。_route_message() 还会等待绑定状态,超时或需要绑定时丢弃消息并走提示路径;二进制音频到达时,如果 vad 或 asr 尚为 None,函数直接返回。这里有明确的初始化门槛,不能看到设备已连接就把无识别结果全部归给麦克风或模型供应商。4
音频进入连接队列之后,还要满足一次识别的触发条件
普通二进制消息经过解码,得到 PCM 才进入本连接的 asr_audio_queue。ASR 工作线程从队列取数据,把 handleAudioMessage() 调度回连接事件循环并等待完成;后者调用 VAD,再把音频和语音判断交给 conn.asr.receive_audio()。这不是三个远端接口依次被一个同步函数调用,而是线程、事件循环和连接状态共同组织的流程。45
以 ASR 基类的非流式自动模式为例,音频先进入 conn.asr_audio。此前没有语音、当前也没有语音时,只保留尾部一部分片段。触发识别还要检查"非 STREAM""已经检测到语音停止",以及 PCM 长度。下面是该分支的连续源码摘录:
python
if conn.asr.interface_type != InterfaceType.STREAM and conn.client_voice_stop:
    # 直接使用asr_audio中的PCM数据
    pcm_bytes = b"".join(conn.asr_audio)
    # 检查是否有足够的音频数据(每帧1920字节,15帧约28800字节)
    if len(pcm_bytes) > 1920 * 15:
        await self.handle_voice_stop(conn, [pcm_bytes])
    conn.reset_audio_states()
这里是严格大于 28800 字节,不是"大于十五个任意网络包"。把它换算成时长,需要同时知道进入此处的采样率、声道数和样本宽度;不能把注释里的帧假设推广成所有 provider 通用的固定时长门槛。手动模式在这个函数中只缓存音频,STREAM 实现也可能覆盖接收路径,不能用这一段解释全部识别器。5
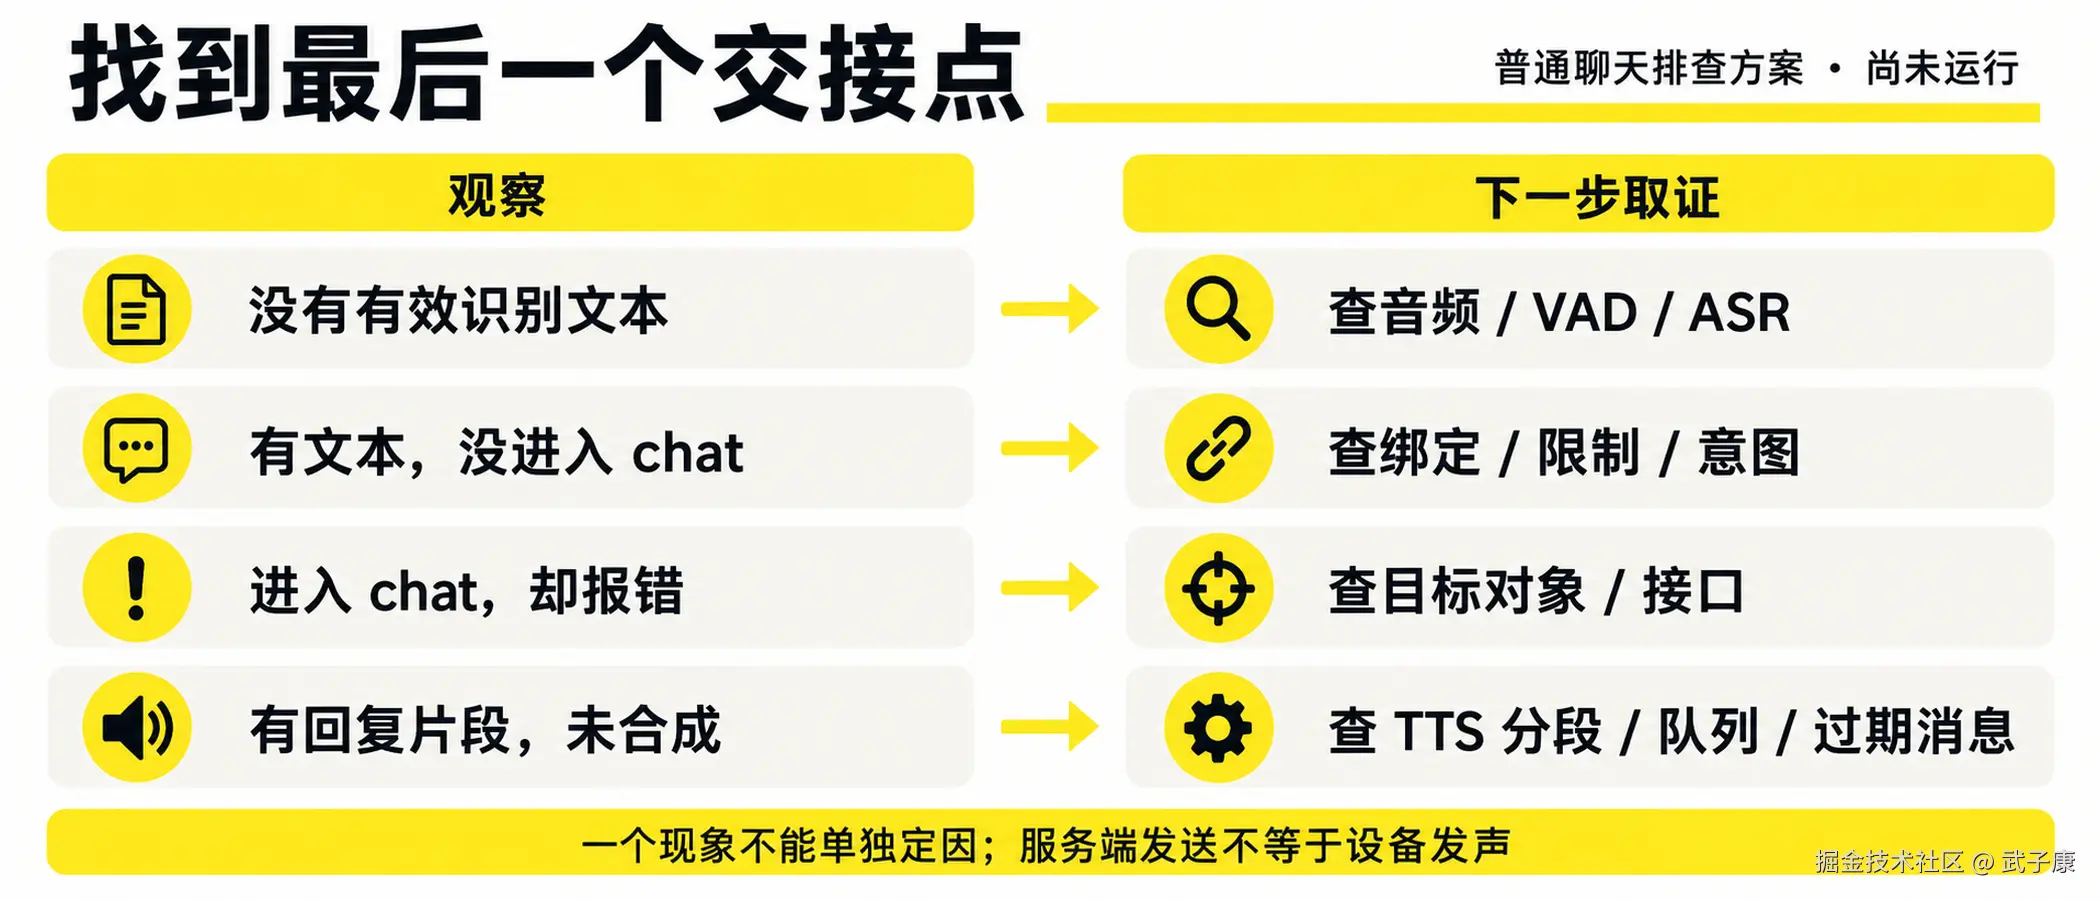
进入 handle_voice_stop() 后才调用识别包装;配置了声纹服务时,还可能与声纹识别并发等待。得到结果后会清理文本用于长度检查,只有有效文本长度大于零才进入 startToChat()。因此"收到了音频""触发了识别""得到了有效文本"应当是三个分别能核对的节点。只看到音频字节计数增长,就换 LLM 的超时参数,处理不到当前断点。
有效识别文本也不是必然进入普通聊天。startToChat() 会检查设备绑定和输出限制,再做意图处理;意图已经处理了请求时直接返回。只有继续常规聊天,才发送 STT 消息、清除本次中断状态并向连接线程池提交 conn.chat。例如工具或退出路径已经接管请求时,没有普通 LLM 回复并不自动意味着模型丢包。6
LLM 输出片段之后,TTS 仍可能在等可合成的文字
普通 chat() 顶层调用生成新的 sentence_id,把用户消息写入对话历史,并向 TTS 文本队列发送 FIRST 动作。之后可能查询记忆,再调用模型的普通流式接口或带函数的接口。工具调用还会带来另外的分支,本文的具体案例选择无意图处理的普通回答,避免把工具等待混进语音合成耗时。7
在普通文本流里,非空内容会以 MIDDLE 消息进入 TTS 文本队列。顶层结束时发送 LAST。session_id 表示连接会话,sentence_id 则用于这一轮回复的关联和过期判断;虽然名字叫 sentence,这里不能简单理解为每个中文句号都产生一个新 ID。
TTS 基类的文本工作线程收到 FIRST 后重置缓冲和首句状态;收到 TEXT 就追加缓冲,调用 _get_segment_text(),只有取到了片段才交给 to_tts_stream()。LAST 到达时,再处理剩余文字,并把结束标记放入音频队列。这就解释了一个很实际的现象:LLM 已输出字符,尚不能推出 TTS 已开始合成。8
分段规则也不是统一"等完整回答"。该基类对第一段和后续段使用不同标点集合:首段集合包含逗号,后续集合不含逗号;都包含句号等标点。一次 token 到达时没有满足分段条件,可以继续等待;到 LAST 还会处理残留。实际选用了覆盖该逻辑的流式 TTS 时,应继续读具体实现,不能把基类策略推广到全部服务商。8
用一个明确的教学输入看这个交接:如果普通 LLM 流依次给出"我来""说明,""请看配置。",第一次追加后可能还没有可合成片段;逗号到达后,基类首段规则允许取出前段;后续再按后段标点处理。这个片段序列是解释分支的假设输入,不是模型实测输出。读者应观察实际片段和分段结果,而不是据此承诺首音频时间。
还有一处必须跟进到适配器内部。OpenAI 兼容实现的 response() 请求设置 stream: True,遍历响应块时只把有效 content 向上 yield;它还有思考标签处理,最终在清理段关闭响应流。供应商发回了网络数据,并不意味着这里已经向 chat() 交出了可朗读文字。要区分"请求建立""收到块""提取到正文",不能把它们都记作首 token,也不能声称这段简单标签逻辑适配所有供应商的输出格式。
异常落在哪个位置也会改变排查证据。chat() 创建模型响应的代码段有错误捕获,后面的流遍历又有单独捕获;在遍历中出错,会向 TTS 文本队列放入系统错误回复,并为顶层追加结束动作。因此,设备说出一段通用错误提示,不证明目标模型成功生成了这段话。反过来,不能因为没有看到最外层初始化异常,就认定流式请求已经正常读完。阅读 generator 实现时,实际请求还可能在迭代才执行,日志定位要对照抛错所在阶段。7
to_tts_stream() 这个函数名也不能直接等同于供应商双向流式接口。基类在删除临时音频文件的分支中,调用 text_to_speak() 等待返回音频字节,再把字节转换为数据流交给音频回调;空结果或异常会消耗重试次数,最多尝试五次。具体provider可以覆盖实现,本文只据此说明基类的文本分段、供应商合成和音频分包是不同步骤,不能拿函数名证明供应商已经边收文字边回声音。
于是,"已经有首段文字,却过了一会儿才有音频"至少要拆成两个可观察区间:等到可合成片段之前,以及进入合成调用之后之后。前者可能与分段规则有关,后者还应核对请求耗时、空返回、失败重试和音频转换。基类打印了语音生成成功,也只证明对应代码路径取得了结果,并不证明接收设备已经播放;重试更不能被描述成稳定吞吐或服务可用性保障。8
合成产生的音频又经过 tts_audio_queue 和音频发送逻辑。sendAudioMessage() 可以先发 sentence_start,再发送音频;LAST 在对应条件`下触发 stop。发送侧还有节奏控制与等待逻辑。它们是服务端交付过程的证据,不是设备扬声器实际开始、结束发声的测量。9
中断会横穿这些阶段。处理函数设置 client_abort、清队列并发送 stop;文本消费者过滤与当前 sentence_id 不一致的消息,发送端也会检查带 ID 的残留音频。这些检查解释了为什么模型已经生成的内容仍可能被丢弃。它们不证明第三方模型请求已被取消、不会计费,或所有没有 ID 的路径都享有同样保护;连接断开时的资源释放也要另查具体 provider。89
把"改了模型却没听到预期回答"落实为一条排查记录
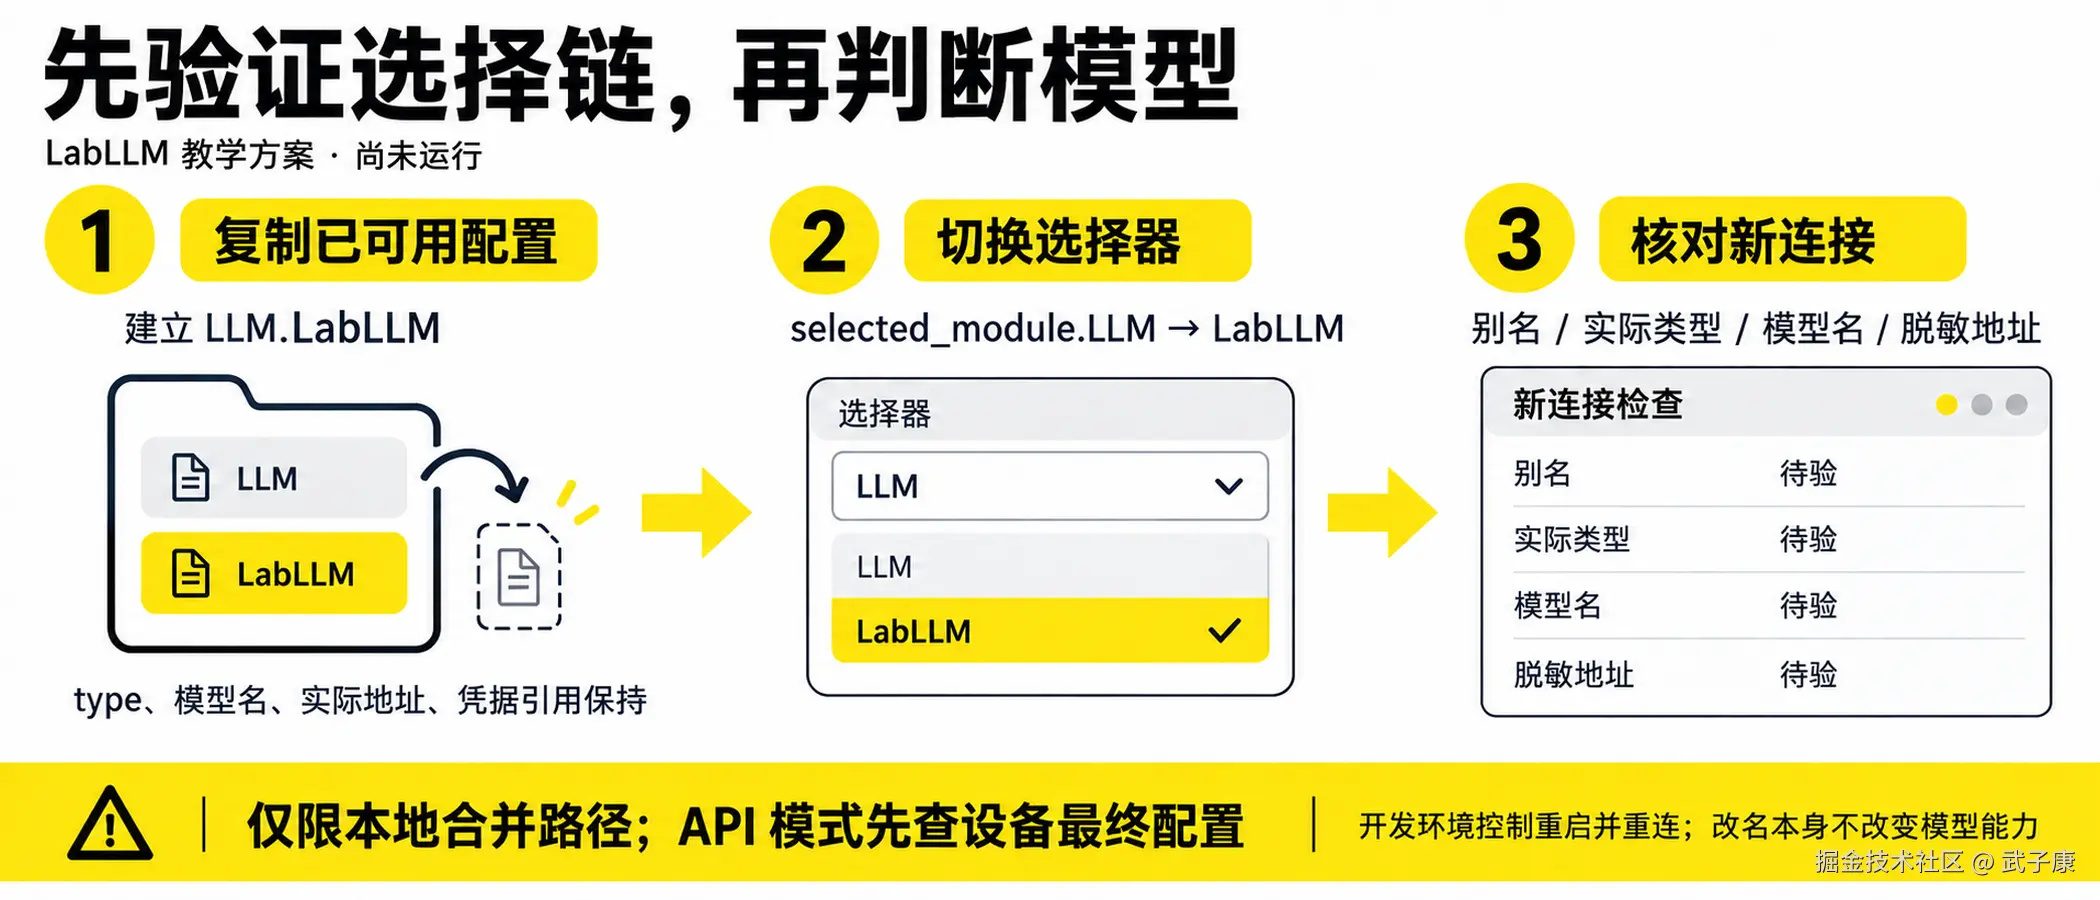
现在把前面的证据用在一个完整案例里。假设已有一套能运行的本地合并配置,使用现有 ASR、TTS,只准备把普通聊天的 LLM 配置项改名为 LabLLM,并指向自己已经有权限使用的 OpenAI 兼容服务。目的不是测试哪家模型更快,而是确认本次新连接选择了目标对象,并找出回答停在哪个交接点。
为了只改变一个因素,在 data/.config.yaml 中复制原来已可用的 LLM 配置段为 LLM.LabLLM,保留正确的 type: openai、地址、模型名和凭据引用方式,然后把把 selected_module.LLM 改为 LabLLM。其余 ASR、TTS、音频格式和网络条件保持。这里不提供虚构可用的 API 地址或密钥,也不承诺该服务与适配器所有参数兼容。
第一项记录应写成"本地合并路径;LLM 选择 LabLLM;适配器 openai;模型名与地址以本地脱敏值核对",而不是"已改 config.yaml"。若部署实际带 manager-api.url,这个案例的前提不成立,应转去核对管理接口及该设备的私有配置,不继续用编辑本地模型段碰运气。
为避免把旧进程缓存和旧连接混入这次验证,可在自己的开发环境控制重启服务并重新建立连接,再核对本连接的选择记录和实际实例类型。重启是本案例为了获得清楚起点的操作选择,不是对生产环境的通用要求。不要只检查服务器启动时的公共模块日志:API 模式下,设备私有覆盖发生得更晚。必要时添加临时诊断,记录连接 ID、选中别名、类型和脱敏地址;不要打印完整配置或密钥。
随后对设备说一句固定问题,例如"请用一句话说明今天要检查什么",记录识别结果。假如没有有效文本,排查就留在音频解码、ASR 队列、VAD 停止条件和识别异常;没有必要分析 LabLLM 的回答风格。假如已有有效文本但没有普通 chat 入口,则检查绑定、输出限制和意图是否提前处理。为了测试普通聊天,应选择不会触发已有工具、退出等意图的句子,必要时在开发配置中隔离这些分支并记录该变化。
如果 chat 已进入,再核对实际调用对象与最早非空回复片段。对象不是 LabLLM 对应实例,回到配置来源和初始化链;对象正确但模型调用报错,查地址、模型名、凭据有效性和适配器异常,而不是继续改 ASR。若已有回复片段但没有合成请求,就看 TTS 文本队列是否收到同一个 sentence_id、片段是否满足分段条件、是否已中断或过期。合成已产音频但没发出,继续查音频队列与发送分支;服务端已发出而设备无声,才把调查转向传输和客户端播放证据。
为了让这次修改有反证,还应保存一次对照:恢复旧的 selected_module.LLM,在相同开发环境重建连接,复核选择记录是否随之改变。如果两次实际实例、模型名和脱敏地址都一样,先检查是否只改了未被选中的段、是否被API配置覆盖,或者两份别名本来就指向同一模型;不要从两次答案措辞相似就判定没有切换。这里的对照目标是配置生效,不涉及模型能力优劣,更不能以一句回答当作模型身份指纹。
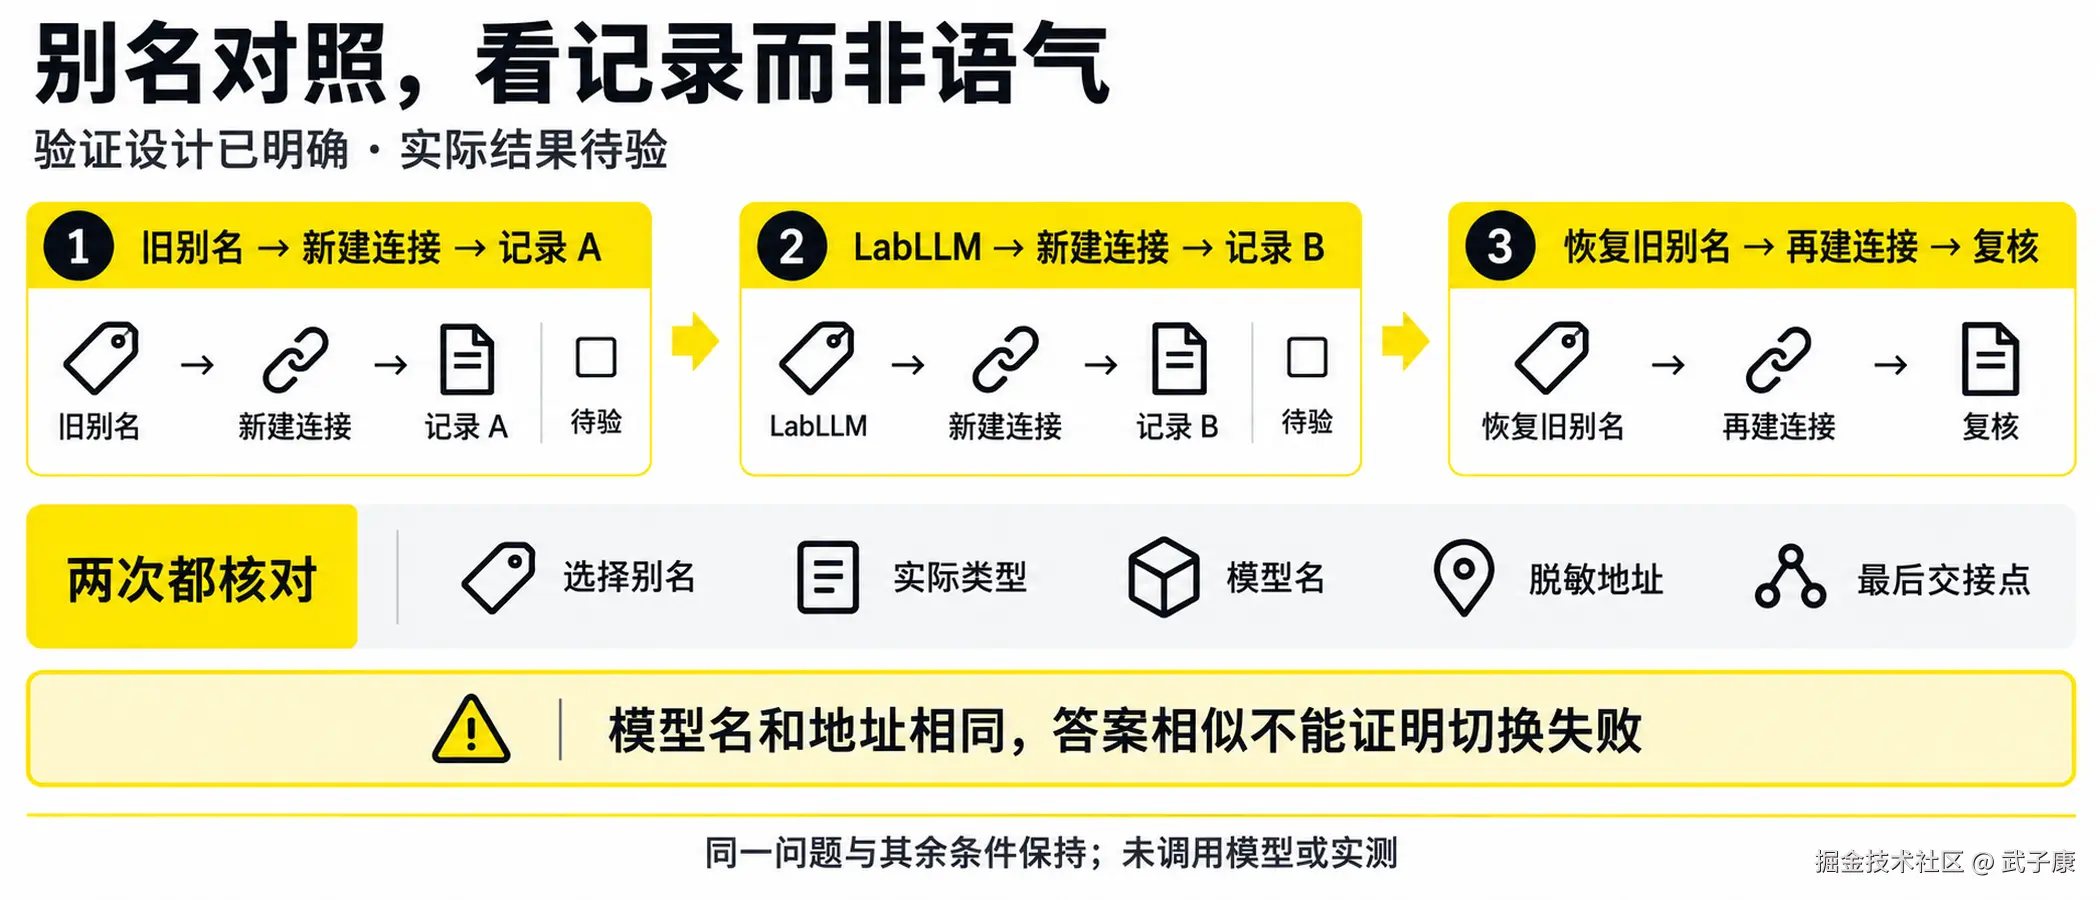
这条记录已经填好了配置键、条件、预期观察和失败后的下一步,但"实际结果"仍必须由真实运行补上。若要比较延迟,可在同一次连接和同一轮回复下分别记下:语音结束判定、有效识别文本、LLM 首个非空片段、首个合成片段、首个音频发送的时间。设备实际首声需要设备侧或录音证据;跨机器时间戳还要考虑时钟关联。不能把源码里几个阶段名相减,就写成端到端性能数据。
沿这条路径得到的最终产物,应当是一个能复核的结论,例如"本轮确实选到目标 LLM;识别文本已进入 chat;回复文字停在首段分割之前"。这是待运行验证后才能填写的结论示例。它的价值在于把下一次修改约束到证据指向的阶段,而不是每次无声都同时更换 ASR、模型和音色,最终无法知道是哪项改变起作用。
参考资料
以下链接均指向同一固定提交;源码提供实现依据,案例和排查方法为作者推演,没有运行性能结论。
- 配置加载与来源
- 选择器、type与工厂
- 服务端刷新与公共对象
- 连接状态与私有配置
- 非流式识别触发与有效文本
- 识别文本到普通聊天的分支
- 普通回复流与TTS消息
- TTS分段与过期过滤
- 音频交付与旧句子过滤
补充:项目归属与部署边界、当前默认配置、LLM工厂、OpenAI兼容适配器、中断入口。
资料复核于 2026-09-12。官方链接支撑配置加载与合并、别名/type 双段选择、连接副本与对象引用、ASR 触发与有效文本、LLM 流与 TTS 消息、TTS 分段与过期、音频交付与句子过滤的方向;LabLLM 3 步方案、4 步诊断表、3 步对照模板均为作者教学设计,未启动服务、未调用模型、未录音实测。
配图保持方法示意与第三方源码摘录的区别;图上"2026-09-12 核验"标签保留。配置案例与排查方法仅供设计参考,仍需在目标部署环境与实际请求下验证。
作者 :武子康的个人博客 发布日期:2026-09-14(资料复核 2026-09-12)