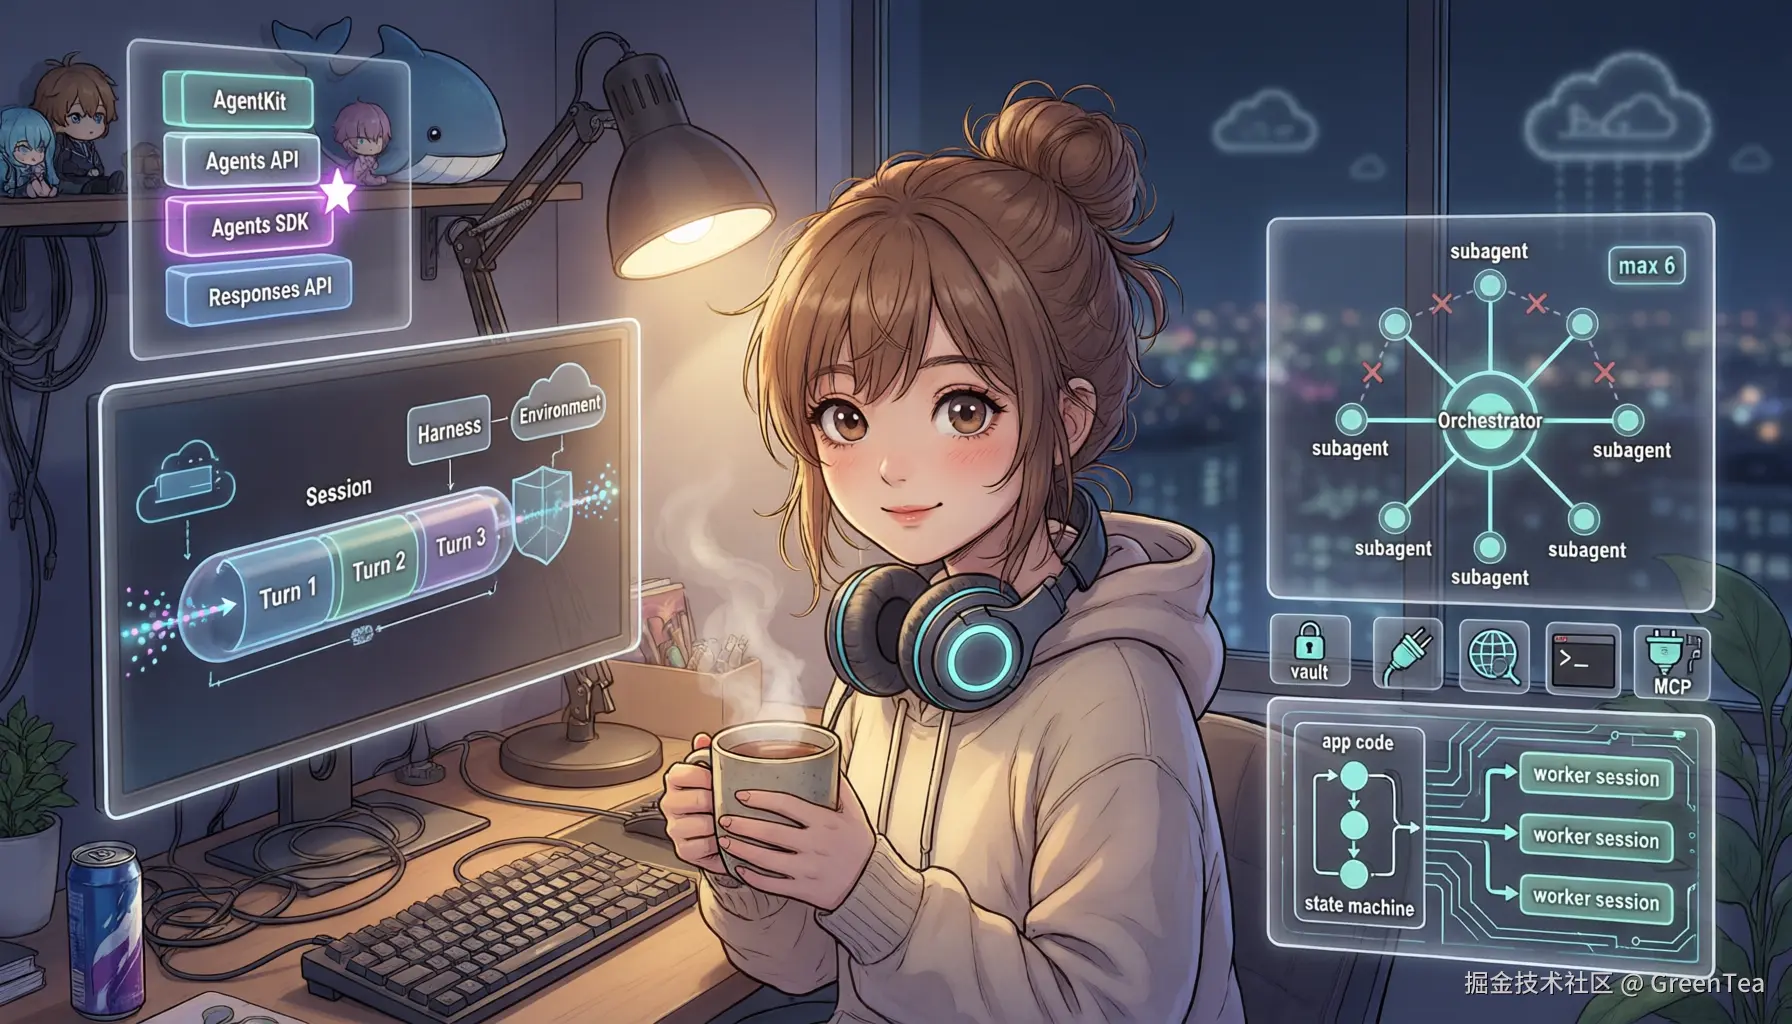
上周(9 月 10 日)OpenAI 悄悄把一个新产品推到了 public beta:Agents API。和去年 AgentKit 发布时铺天盖地的宣传不同,这次官宣相当低调,但对我这种被 agent 框架的工程细节折磨过的人来说,它的思路其实激进得多------你不再自己跑 agent loop,OpenAI 把它家的 Codex harness(就是跑 Codex CLI 的那套模型+工具循环+沙箱基础设施)直接变成一个云服务。
发一个请求,OpenAI 在云端起一个 agent,写代码、跑命令、调工具、存进度,全程托管。你只负责提交任务、消费事件流、处理需要你接手的工具调用。
这篇文章把我这几天翻文档、跑示例的结论整理一下:它是什么、有哪些能力、怎么用、以及目前有哪些明确的坑。因为还是 beta(SDK 里直接挂在 client.beta.agents 命名空间下),部分细节后续大概率会变,我会尽量把"文档明确的"和"我推测的"分开说。
一、先分清楚四个容易混淆的东西
OpenAI 的 agent 产品线现在有四个名字,很容易搞混,先对齐一下:
- Responses API:底层模型 API,带 web search、file search、code interpreter 这些内置工具。agent loop 得自己写。
- Agents SDK:2025 年 3 月发的代码框架(Python/TS/Go 等),handoffs、guardrails、tracing 都有,loop 在你的进程里跑。
- Agents API:本文主角。托管服务,loop 在 OpenAI 云端跑,集成成本最低。
- AgentKit:去年 DevDay 发的产品套件(Agent Builder 可视化画布 + ChatKit 前端 + Connector Registry),偏低代码/产品化路线。
简单说,四者是同一个能力光谱上的不同位置:Responses API 给你最大控制权但要自己写循环,Agents API 把循环整个托管走,中间是 Agents SDK,另一头是拖拽式的 Agent Builder。
二、核心模型:session、turn、harness、environment
Agents API 的抽象不复杂,四个词就讲完了。
Harness 是 OpenAI 托管的那个 Codex 实例,负责跑模型和工具循环,一个 harness 持有一个会话。Session 是持久化的会话,agent 配置、对话历史、执行产物都存在服务端,跨请求存活。Turn 是会话里的一轮工作------给空闲会话发消息就开启新 turn,给正在工作的会话发消息则是"转向"(steer)当前 turn,这个语义后面会提到,是个容易踩的坑。Environment 是 agent 干活的地方,分三档:
openai_hosted:OpenAI 管理的沙箱,可以配置预装包、初始文件、网络开关;self_hosted:你自己的机器、Docker 或者 Cloudflare Containers(官方教程已经出了),你连一个 executor 进去执行 harness 下发的命令;none:不挂任何计算环境,harness 直接调远程 MCP 工具,function tool 调用路由回你的应用代码。
创建会话就是一个 POST:
bash
curl --no-buffer --fail-with-body https://api.openai.com/v1/agents/sessions \
  -H "OpenAI-Beta: agents=v1" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "agent": {
      "model": "gpt-6-astra",
      "instructions": "写干净可跑的代码,执行它,报告真实输出。"
    },
    "environment": { "type": "openai_hosted" },
    "input": "写一个 tree.py,打印当前目录的可读文件树,然后运行它。",
    "stream": true
  }'
Python SDK 里对应 client.beta.agents.sessions.create(...),返回一个事件流。事件是分类型的,终态有 agent.session.turn.completed / turn.failed / turn.cancelled 三种,中间过程会有各种 item 级事件。文档反复强调一件事:turn 完成不等于所有工具调用都成功了 ,拿到 completed 之后还是要检查 agent 的实际产出;另外 agent.session.idle 单独出现不代表成功。
三、功能特性盘点
Agent 配置与复用
agent 配置(model、instructions、tools、reasoning)既可以内联在 session 创建请求里,也可以先用 client.beta.agents.create 存成可复用的 agent,之后传 agent_id 引用。凭据单独放在 vault 里,不混在 agent 配置中------这个设计对多 agent 场景挺关键。
还支持按 session 覆盖:同时传 agent_id 和 agent 对象,没覆盖的字段继承保存配置。但注意文档明说了 tools 这类数组字段是整体替换,不是合并------你想在保存配置基础上加一个工具,必须把旧的全带上。
内置工具
工具语义和 Responses API 一脉相承,目前可用的有:
- web search / file search:联网搜索和向量库检索;
- code interpreter / hosted shell:沙箱里跑 Python 和 shell;
- computer use:模型控制浏览器和桌面界面(客户端要有执行 harness);
- 远程 MCP:API 直接作为 MCP client 连公网上的 MCP server,这个省了大量胶水代码;
- tool search:工具定义延迟加载,模型需要时再拉取(gpt-5.4 之后的模型才支持),工具多的时候救上下文;
- Skills:版本化的技能包,上传后在托管 shell 环境里复用;
- Programmatic Tool Calling(PTC) :让模型生成一段 JavaScript 来编排工具调用,比逐个 function call 省很多轮往返,在 Agents API 里默认开启。
自己的函数用 function tool 暴露,调用请求会出现在事件流和 required_actions 里,等你的代码执行完把结果交回去,任务才能继续。
会话生命周期与交付
结果交付两条路:流式事件 和 webhooks。不想挂着长连接就用 webhook 收会话状态变化,收到再回来看结果、处理工具调用、管理环境。
几个实用的控制面接口:
python
# 续跑/转向:POST /v1/agents/sessions/{session_id}/events
client.beta.agents.sessions.events.create(session_id, {
    "events": [{
        "type": "agent.session.input.message",
        "input": [{"role": "user",
                   "content": [{"type": "input_text", "text": "加上 max-depth 参数"}]}]
    }]
})


# 取消当前 turn(会话和已有产物保留)
client.beta.agents.sessions.events.create(session_id, {
    "events": [{"type": "agent.session.input.cancel"}]
})


# 取历史产物
client.beta.agents.sessions.items.list(session_id, order="asc", limit=100)


# 删会话
client.beta.agents.sessions.delete(session_id)断连后的行为要留意:事件流不回放。断了之后不能指望重新订阅补齐漏掉的事件,正确姿势是拉取 session 和已保存的 items 来恢复现场,再决定重试还是继续。
权限与运维
API key 需要三个 scope:api.agents.read、api.agents.write(会话操作)、api.responses.write(模型推理)。官方特别提醒 key 别放进 agent 的沙箱------想想也是,agent 能跑任意代码,key 进去就等于送出去。
定价方面,beta 期间官方说法是没有额外服务费,照常按模型用量和会话/沙箱资源计费。具体数字建议以官方 pricing 页为准,我不转述没核实的数字。
四、多 Agent 编排:设计得很聪明,但不是你以为的那种
这是我最关心的部分,也是这个 API 最容易被误解的部分。
开启方式简单到离谱,加一个配置就行:
python
with client.beta.agents.sessions.create(
    agent={
        "model": "gpt-6-astra",
        "instructions": "把 Release A 和 Release B 分别委托给独立的 subagent 审查,汇总各自结论。",
        "multi_agent": {
            "enabled": True,
            "max_concurrent_subagents": 2,
        },
    },
    environment={"type": "openai_hosted"},
    input="...",
    stream=True,
) as events:
    for event in events:
        print(event.model_dump_json())
开启后 harness 会自动给协调者 agent 注入一组协调工具:创建 subagent、发消息、等待、中断。注意你不用也不能声明这些工具 ,subagent 也不是请求里预先定义的,而是协调者 LLM 在运行时动态决定创建的。事件流里能看到 agent.session.subagent.created,每个 turn 上有 subagent_id 字段可以归因到具体 agent。
这套机制的能力边界,翻完文档后我总结为六条硬事实:
- 拓扑是中心化的星型。一个协调者 + N 个 subagent(默认上限 6),subagent 之间没有点对点通信通道,所有消息都过协调者。文档也没有确认 subagent 能否再派生 subagent,从措辞看倾向于不能。
- subagent 不支持 function tools。它继承会话级的 MCP 工具、凭据和 web search 配置,你的应用函数只有协调者层能挂。想给不同 subagent 配不同工具,目前做不到,角色差异化只能靠 instructions。
- 共享单环境。创建 subagent 不会开新沙箱,所有人共用一个文件系统。这既是特性(间接协作通道)也是坑------文档原话是"改同一批文件的 agent 必须自行协调变更",也就是文件冲突自己负责。
- 编排决策全在模型脑子里 。没有任何声明式的 agent 图字段,委托顺序、并行策略全靠 instructions 里的自然语言描述,你唯一能拧的旋钮是
max_concurrent_subagents。 - 协调动作的完成不等于任务完成 。
create_subagent调用返回了,不代表那个 subagent 干完了活,要看后续 wait 的事件。 - 配置在 session 创建时冻结,运行中改不了 multi_agent 设置。
所以,回到一个我一开始就想问的问题:能不能用它做精细的确定性编排? 会话内做不到。委托是模型"决定"的,不是你"编排"的。想给"先 A 后 B、A 失败走 C"这种流程上保险,得换思路------把编排挪到会话外面。
我的做法是:每个角色开独立的 Agents API session,自己的应用代码做状态机:
python
# 外层确定性驱动(伪代码)
for step in my_dag.topo_order():
    workers = [create_session(agent_id=step.role, input=step.input)
               for _ in range(step.parallelism)]
    await wait_terminal(workers)          # 等 completed/failed/cancelled
    outputs = [fetch_items(s) for s in workers]
    if any_failed(workers):
        retry_or_fallback(step)          # 重试策略是你写的,可测试
    step.next_input = merge(outputs)     # 合流规则也是你写的,100% 确定
这样编排逻辑(拓扑、重试、超时、分支)全在自己代码里,可测试可版本化;Agents API 则只负责 worker 侧最重的运维------沙箱、持久化、断连恢复、webhooks。注意跨 session 的环境是隔离的(一个 session 一个沙箱),数据传递要么走 items 文本、要么把工件下载后重新上传,或者评估用 self-hosted 环境共享给多个 session------多 session 能否挂同一个 executor,文档没写,我还在实测。
顺带一提,如果你要的是真正的去中心化 swarm(agent 间对等通信、自由路由),这个 API 给不了------星型拓扑焊死了。那类需求目前还是 Agents SDK 的 handoff 网更合适(说起来,OpenAI 2024 年开源的 Swarm 实验库,就是今天 Agents SDK handoffs 的前身)。另外官方在公告里确认 Codex harness 本身是开源的,理论上可以自己改编排层,但那就是另一个工程量级的故事了。
五、已知的限制和坑(截至本文写作时)
最后集中列一下我确认过的坑,接入前建议过一遍:
- beta 状态 。SDK 挂在
client.beta.agents,协议头是agents=v1,接口随时可能变。生产接入建议先拿非关键业务验证。 - 数据保留。官方明确:即使用 self-hosted 沙箱,这个 API 也不满足 ZDR(零数据保留)资格。数据敏感的场景先过合规。
- 事件流不回放 。断连后漏掉的事件补不回来,只能拉 items 恢复现场。事件订阅要赶在发消息之前建好,不然早期事件就丢了。
- 空闲 ≠ 成功,completed ≠ 全部成功。判断任务结果必须看终态事件 + 检查 agent 实际产出,两层都要做。
- steering 语义。给工作中会话发消息是"转向"而不是排队。想逐个任务串行驱动,必须等终态事件再发下一条,API 没有内建消息队列。
- 协调事件可能缺内容 。
agent_messageitem 只在有内容时才带 agent 间文本,流里拿不到完整对话记录,细节要事后翻 items。 tools整体替换。session 覆盖 agent_id 配置时,数组字段不合并。漏带旧工具列表会静默丢失。- subagent 的能力天花板。不支持 function tools、不能差异化配置工具集、文档未确认可嵌套派生。
六、我的使用建议
一句话版本:如果你想要"发任务就不管"的云端 agent、并且任务能自然拆成并行的独立子任务,Agents API 现在就能用,成本比自建低一个量级;如果你的编排逻辑有确定性要求(流程、重试、合规),把它当托管 worker 用,编排层自己写;如果需要 agent 间自由路由的 swarm,或者子 agent 要挂自定义函数,现阶段用 Agents SDK。
它没有取代 Agents SDK 的意图,两者是互补关系:SDK 给你精细的控制,Agents API 给你省掉运维。真正让我觉得有价值的是它把"跑 agent"这件事的固定成本------沙箱管理、断连恢复、状态持久化、事件推送------变成了 API 的一部分。这些活不性感,但每个自建 agent 系统的团队都花过冤枉钱在这上面。
beta 才刚开始,我预计 multi_agent 部分后续会有明显迭代(比如 subagent 的 function tool 支持和声明式编排字段)。如果你也在评估,建议先把 quickstart 跑一遍,重点测断连恢复和事件流稳定性,这两个是文档承诺最少、工程上最容易出事的地方。
参考文档:
- Agents API 官方公告:openai.com/index/intro...
- Quickstart:developers.openai.com/api/docs/gu...
- 架构说明:developers.openai.com/api/docs/gu...
- 多 Agent 指南:developers.openai.com/api/docs/gu...
- 会话生命周期:developers.openai.com/api/docs/gu...
- Agents SDK 多 Agent 编排(对比参考):openai.github.io/openai-agen...