多智能体系统为什么能work?行业里流传着三条解释: 上下文更小、关注点分离更干净、可以并行。
2026 年 9 月 15 日挂在 arXiv 上的一篇论文问了一个没人问过的问题: 这些理由都在说"拆分让每个 agent 更好过",但拆完之后,叶子节点发现的东西, 有多少真的回到了根节点?
答案是
C^k · N^{1-δ}。而其中最难受的一个推论是: 如果r(b) = 1/b,那么无论你把任务拆成什么形状、拆多少层, 最终都恰好只能拿回 1 个发现。 作者在 20,000 棵随机不规则树上验证了这一点, 误差 2.4×10⁻¹⁵。这不是"多智能体不好"的论文。这是一篇"你以为你在买并行,其实你在买另外两样东西"的论文。
一、三条 folklore,和一个没人问的问题
任何一份多智能体架构的设计文档里,都能找到这三条理由:
| folklore | 说法 | 它回答的问题 |
|---|---|---|
| 上下文更小 | 每个子 agent 只看自己那一块,不会被全局信息淹没 | agent 会不会被撑爆 |
| 关注点分离 | 每个子 agent 职责单一,干扰少 | agent 会不会跑偏 |
| 可以并行 | 多个子 agent 同时跑,墙钟时间更短 | 任务要跑多久 |
这三条都对,而且都有生产数据支持。Anthropic 公开过自己的多智能体研究系统:Opus 做 lead、Sonnet 做 worker,在广度优先的研究类 query 上比单 agent Opus 胜出 90.2% ,并行化让复杂任务的研究时间最多缩短 90% ,而 token 用量为单一聊天交互的约 15 倍 。同一份材料里还有一句被引用得最多的话:token 用量本身解释了 80% 的性能方差。
但注意这三条回答的是什么问题------它们全都在说"拆分对 agent 好"。
没有一条回答:拆分对"找到的东西"好不好。
一个 deep research agent 分出 8 个子 agent 去查资料,每个子 agent 读 50 个来源,各自写一份摘要回来。8 份摘要在根节点合并成最终报告。那么问题来了:8×50 = 400 个来源里蕴含的信息,最后有多少出现在报告里?
直觉是"取决于摘要写得好不好"。论文的答案是:取决于一个指数,而那个指数是 agent 的属性,不是你架构的属性。
二、模型:把分解看成一棵树,然后数"漏掉了什么"
2.1 唯一的假设
设一个 agent 被交给 b 个条目(items),它把其中任意一个 保留下来(写进自己的输出、转发给上层)的概率是 r(b)。
这是全文唯一的建模假设。b 是你喂给它的东西,r(b) 是它往上传的东西。中间的差就是这一次转手漏掉的。
论文考虑两种 r(b) 的形式:
形式一:r(b) = 1/b
一个 agent 拿到 b 个条目,每个条目有 1/b 的概率被保留。那么它期望保留 b · (1/b) = 1 个。
这个假设下有一个漂亮到有点吓人的结果:
css
                    r(b) = 1/b

   ┌─────────────── 根 agent ───────────────┐
   │                                        │
   ┌────┴────┐         ┌────┴────┐          │
 子A       子B        子C       子D    ← 无论多少个子节点
 (b=4)    (b=4)      (b=2)    (b=2)    ← 无论每个拿几个
   │        │          │        │
  ┌┴┐      ┌┴┐        ┌┴┐      ┌┴┐
 叶叶     叶叶       叶叶     叶叶    ← 无论多深

   ⇒ 最终交付给根的"发现"数量 = 1,恒定
不管你怎么拆、拆几层、每个节点分几个,最后都恰好拿到 1 个发现。
作者在 20,000 棵随机生成的不规则树 上验证,与理论值的偏差是 2.4×10⁻¹⁵------这是浮点精度量级,等于数值上精确成立。
这个结果值得停一下。它说的不是"拆得越多损失越大",而是**"拆得越多损失越大"和"拆得越多覆盖越广"这两件事,在这个参数下恰好完全抵消**。你改变了树的形状,只是改变了"信息从哪条路径漏掉",没有改变漏掉的总量。
这是一条守恒律。
形式二:r(b) = C · b^(-δ)
把 1/b 一般化。δ 是衰减指数,C 是 b=1 时的常数因子(因为 r(1) = C · 1^(-δ) = C)。
设深度为 k 的树、总共覆盖 N 个发现(均分支 b,则 b^k = N)。每一层:父节点从 b 个子节点各收到内容,保留概率 r(b),期望保留 b · C·b^(-δ) = C·b^(1-δ) 个。走 k 层:
scss
yield = (C · b^(1-δ))^k
      = C^k · b^(k(1-δ))
      = C^k · N^(1-δ)
2.2 这个公式最狠的地方:两个因子分家了
scss
        yield  =  C^k   ×   N^(1-δ)
                  ────       ───────
                  架构项        任务项
                  (你可控)      (你几乎不可控)
任务规模 N 和架构 k 完全分离。 这意味着:
-
架构这一侧,你最多只能乘上
C^k,而C ≤ 1。 所以单看"产出量"这个指标,flat(不分层)永远是最优的 。每加一层,你就确定性地损失掉至少1-C的产出。没有一种 agent 排布能改变这一点。 -
δ是 agent 的属性,不是架构的属性。 它描述的是"一个 agent 面对b个条目时会漏掉多少"。你换架构、加层、改拓扑,都逃不掉N^(1-δ)这个指数。想改变δ,你得换 agent,不是换架构图。
一句话点破:多智能体分解并不能提高产出上限,它只是把"产出"这个指标,换成了另外两样东西。 那两样东西是什么,第四节讲。
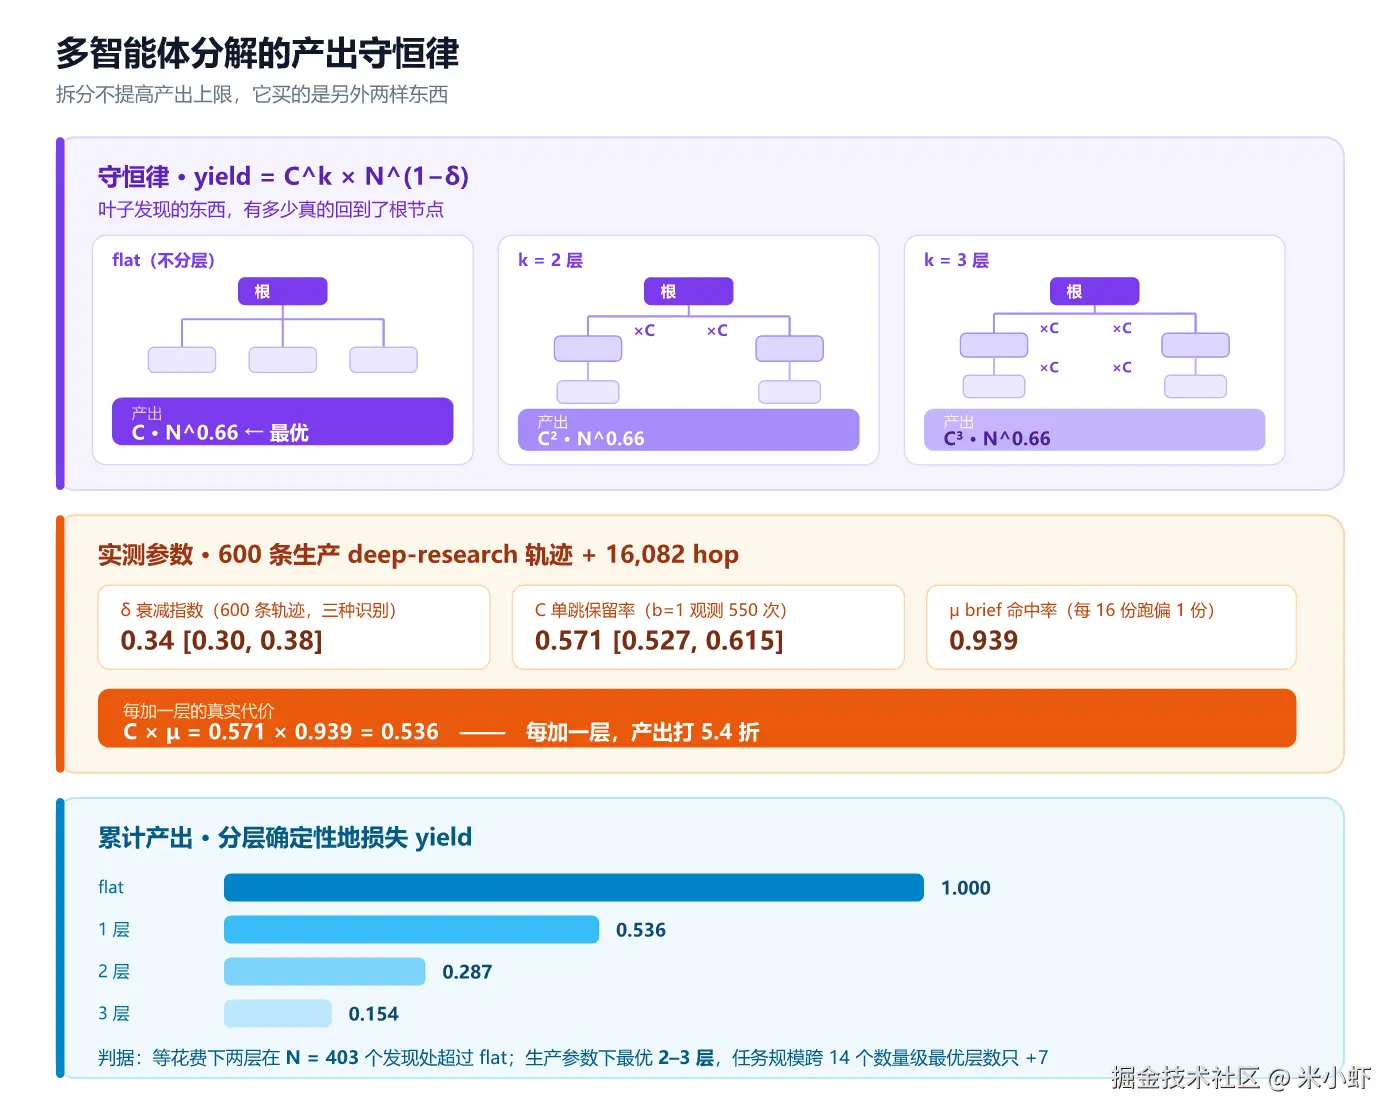
三、测出来的数:δ = 0.34,C = 0.571,μ = 0.939
公式好看不好看不重要,重要的是参数是多少。论文用生产数据测了三个数。
3.1 δ = 0.34:你的 agent 每多查 4 倍来源,只多带回 2.3 倍
语料是 600 条生产环境 deep-research 轨迹 。作者用三种互不共享失效模式的识别方法 交叉估计 δ,结果一致:
δ = 0.34,95% CI 0.30, 0.38
代入公式,N^(1-δ) = N^0.66。这意味着:
| 场景 | 计算 | 结果 |
|---|---|---|
| 来源数 ×4(N → 4N) | 4^0.66,取 δ 上界 0.38 → 4^0.62 |
只多带回 2.3 倍 |
| 同样 ×4,取 δ 点估计 0.34 | 4^0.66 |
2.5 倍 |
| 同样 ×4,取 δ 下界 0.30 | 4^0.70 |
2.6 倍 |
一个研究 agent 让子 agent 多查 4 倍的来源,最终报告里只多出约 2.3 倍的内容。 剩下那部分在层层汇总里漏掉了。
注意这个数字对工程决策的含义:如果你想让最终报告的信息量翻倍,你需要让叶子节点的工作量增加到 2^(1/0.66) = 2^1.515 ≈ 2.86 倍,接近 3 倍。而你多付的钱是 3 倍,不是 2 倍。
3.2 C = 0.571:每加一层,产出打对折多一点
C 是 r(1)------agent 拿到 1 个条目时保留它的概率。难点在于:怎么定义"条目",以及怎么知道 agent "保留"了它。
作者挑了一个非常聪明的 hop 来测:搜索工具返回 b 个编号结果,agent 写一轮输出。 这里"条目边界"由工具(而不是文本启发式)给定,是客观可数的。
- 语料规模:16,082 个 hop
- 关键:
b = 1的情况出现了 550 次 ,所以C = ρ(1)是直接观测值,不是从幂律外推出来的
C = 0.571,95% CI 0.527, 0.615
每加一层,产出乘以 0.571。也就是每层损失约 43%。
两层:0.571² = 0.326------只剩三成。三层:0.571³ = 0.186------不到两成。
3.3 μ = 0.939:还有一层"跑偏"的税
上面只算了"漏掉"。还有一类损失:子 agent 理解错了 brief,去找了别的东西。
在 1,012 条标注过的多智能体轨迹上:
每 16 份 brief 就有 1 份偏离目标 ,给出 μ = 0.939
于是每加一层的真实代价是 C · μ:
ini
每层的实际产出系数 = C · μ = 0.571 × 0.939 = 0.536每加一层,产出打 5.4 折。 两层就是 0.536² = 0.287,三层 0.154。
这个数字应该写进每一份多智能体架构设计文档的封面上。
四、那为什么还要分层:你在买另外两样东西
如果分层确定性地损失产出,为什么 Anthropic 的系统能胜出 90.2%?因为 yield 不是唯一的目标函数。论文指出分层的两个正当理由,都在 yield 之外。
4.1 root context 是唯一无法廉价遗忘的状态
子 agent 的上下文用完就扔了。但根节点的上下文贯穿整个任务,而且它没法"忘掉"------它没有上层可以压缩它,它就是终点。
深度为 k 时,根节点直接面对的条目数从 N 降到 N^(1/k):
ini
                    根节点直接面对的条目数

  flat (k=1)   ████████████████████████████████  N = 1000
  k=2          ██████                            N^0.5 ≈ 32
  k=3          ██                                N^0.33 ≈ 10
这就是"上下文更小"这条 folklore 的真正价值------它保护的是根节点,不是子节点。子节点上下文小不小无所谓,它们用完就销毁了。真正会被撑爆、而且撑爆了没救的,是那个活到最后的上下文。
这与业内已有的观察一致:上下文一旦进入衰减区,模型对中间内容的利用能力会显著下降,而根节点的上下文是唯一一个"从第一分钟积累到最后一分钟"的。
4.2 分层其实更便宜
append-only 的上下文会让人以为成本是 O(N²)。但论文测了生产数据:
生产环境的 flat agent,账单按
N^1.39增长,不是N²
(说明真实系统已经有前缀缓存、压缩等手段,不是朴素追加。)
而分层在成本上也有收益。把两个轴(yield 损失 vs 成本节省 + 根节点保护)平衡起来,论文给出了闭式解的最优层数:
| 条件 | 最优层数 |
|---|---|
| 论文实测的生产参数 | 2--3 层 |
| 任务规模跨 14 个数量级 | 最优层数只增加 7 层 |
最后这个数字很关键:任务规模涨 14 个数量级,最优层数只涨 7 层。 架构选择在极大范围内是钝感的------你不需要为"任务变大了"这件事重新设计拓扑。
另一个具体判据:在等花费的条件下,两层结构在 N = 403 个发现处超过 flat。 少于 403 个发现的任务,flat 更划算。
五、生产系统在做什么:7.8% 在做,模型说值 0.7%--11.3%
理论有了,作者最后拿真实系统检验:现实中的 multi-agent 系统,委托行为符合这个模型吗?
5.1 委托的"应然"与"实然"
把实测参数代回模型,算出"值得委托"的 session 比例,再和实际发生的比例对比:
erlang
   模型说"值得委托"的比例区间:  0.7%  ████████████░░░░░░░░░░░░░░░░  11.3%
                                              ▲
实际发生委托的比例: 7.8%注意这个区间的宽度------0.7% 到 11.3%,差了 16 倍 。这不是模型的精度问题,这说明结论对参数极度敏感 。你不能把论文的数字直接抄到自己的系统上,你必须测自己的 δ 和 C(第七节给方法)。
实际值 7.8% 落在区间内,说明模型没有偏离现实,但也谈不上"精准预测"。
5.2 最反直觉的一条:委托不是对"上下文快满了"的响应
这一条我认为是全篇最有工程价值的发现。
直觉告诉我们:agent 是因为上下文快装不下了,才想到"要不派个子 agent 出去"。这符合"上下文压力驱动委托"的心智模型。
作者用 743,819 次生产工具调用 跑了离散时间 hazard model,只使用决策前的信息(避免把决策后的状态泄漏进回归):
上下文每翻一倍,委托发生的 odds ratio = 0.969 ,95% CI 0.954, 0.985
置信区间完全在 1 以下。 也就是说,上下文变大不但没有推高委托概率,反而略微降低了它。
结论:委托是一个开局动作(opening move),不是应急反应。 Agent 在任务一开始就决定了要不要分派,而不是等到上下文撑不住了才分派。
这个结论对架构设计的直接含义:如果你在系统里实现了"上下文占用超过阈值就自动派生子 agent"这类逻辑,那么你实现的这个机制,在真实系统里并不是主要的分派驱动力。它可能有用,但它建模的不是实际发生的那个过程。
5.3 一个方法论上的警告
作者还补了一句很实在的话:同一个回归的两个朴素版本 ,给出的结果是 +0.65 和 −0.37。
符号都能翻转。
这就是为什么要"只使用决策前信息"------一旦回归里混进了决策后才观测到的变量,你得到的系数可以是正的也可以是负的,取决于你怎么设定。任何"我们分析了生产日志,发现 X 导致 Y"的结论,都应该先问一句:X 是在 Y 之前观测到的,还是之后?
六、五个工程死结(这一节比结论更重要)
6.1 δ = 0.34 是 deep-research 轨迹上的数字,不是普适常数
600 条生产轨迹,全部来自 deep research 类任务。你的工作负载如果是代码修改、数据清洗、客服工单,δ 完全可能是另一个数。
δ 描述的是"一个 agent 面对 b 个条目时的保留率",它天然是任务相关的。 你不能拿 0.34 去做预算。
6.2 幂律假设隐含了"条目之间无协同"
r(b) = C·b^(-δ) 假设保留概率只依赖于数量 b,不依赖于条目之间的内容关系。但现实中存在两种相反的情况:
- 正协同:三个来源互相印证,agent 反而更容易全记住(保留率高于幂律预测)
- 负协同:十个来源高度重复,agent 会去重,实际保留的信息远低于"10 个发现"
deep research 属于后者居多,这也是 δ 为正的原因之一。如果你的任务里条目相互独立,幂律可能低估了你。
6.3 "发现"的计数口径决定 δ
论文用了三种识别方法来规避单一口径的偏差,这一点做得很扎实。但三种方法仍然跑在同一批语料上,共享语料层面的偏差。
比如:如果这批轨迹本身就来自某个特定的 deep research 产品,它的汇总策略(固定要写 5 条要点?)会同时影响三种识别。
6.4 C 是在"条目边界由工具给定"的 hop 上测的
作者自己强调了这一点:选的 hop 是"搜索工具返回 b 个编号结果"。这里的 b 是客观的。
但很多 agent 的 hop 不是这样的------条目边界来自文本启发式(比如"把上一段按句号切开")。这类 hop 上的 C 未必是 0.571。作者的诚实在于明确说明了这一点,但你不能假装它不存在。
6.5 单作者、单语料、未公开系统身份
这篇论文是单作者(Rong He),语料来源是一个未具名的生产系统。这不代表结论不成立------恰恰相反,能拿到 74 万次工具调用的生产日志是很难得的。但这意味着:
- 没有其他团队在别的系统上复现过
δ = 0.34 - 语料的选择标准、时间窗口、任务分布均未公开
- 结论应当被当作一个有价值的第一数据点,而不是定论
七、那我该怎么决定:先测自己的 δ 和 C
7.1 一个下午就能跑完的测量
测 C(最简单) :找你系统里"工具返回编号列表 → agent 写一轮输出"的 hop。统计 b=1 的那些(或者直接从回归里读截距),看 agent 保留率是多少。这就是你的 C。
测 δ(稍麻烦) :固定架构,让 N 变化(比如让研究范围 ×2、×4、×8),量最终产出。对 log(yield) 对 log(N) 做回归,斜率就是 1-δ。
scss
log(yield) = k·log(C) + (1-δ)·log(N)
                          └──── 斜率,直接读出来
测 μ(最容易漏):抽样标注子 agent 的 brief 与它实际做的事,看偏离率。1/16 是论文的值,你的可能更好或更差。
7.2 决策树
arduino
                 你的任务,叶子节点总共会产生多少个"发现" N ?
                                    │
              ┌─────────────────────┼─────────────────────┐
              │                     │                     │
           N < ~50              N ≈ 50--400            N > ~400
              │                     │                     │
              ▼                     ▼                     ▼
        不要分层。              看根节点上下文:        分层,2--3 层。
        flat 单 agent。          ┌────┴────┐          再多不加分,
        每加一层打 5.4 折,      │         │          每层再打 5.4 折。
        你没那么多产出可折。   撑得住    撑不住
                                │         │
                                ▼         ▼
                             flat     2 层
                          (省下 C·μ)
7.3 三条可以直接执行的规则
-
把"子 agent 产出的发现,有多少出现在最终输出里"做成一个监控指标。 大多数团队监控的是"子 agent 完成了几个任务",从来不监控"它发现的东西有没有活到最后"。而后者才是系统真正的产出。
-
给跨层传递定一个 schema,就像给 API 定 schema 一样。 一个做了 10,000 token 内部工作、只返回 500 token 结构化摘要的子 agent,才是真正在省上下文;一个返回 8,000 token 报告的子 agent,等于没拆。压缩发生在"返回什么",不在"派了几个 agent"。
-
不要用"上下文占用率超过 X% 就派生子 agent"作为唯一的分派策略。 74 万次工具调用的证据说,真实的分派是开局决策。你的自动分派逻辑应该参与"任务一开始的分类",而不是"中途的应急"。
八、我的判断
第一,这篇论文终结的不是多智能体,是"拆得越细越好"这个默认动作。
C^k · N^(1-δ) 里最值得注意的是那次分家:N^(1-δ) 你几乎动不了,C^k 你只能往小了动。 所以"为了产出而分层"在数学上就是错的------分层买的从来不是产出。
第二,分层真正买的是"根节点的存活"。
根节点上下文是唯一贯穿全程、且无法廉价遗忘的状态。N → N^(1/k) 这个下降才是分层的价值所在。这也解释了为什么多智能体在广度优先的研究任务 上大获全胜(90.2%),却在紧耦合的编码任务上表现平平------编码任务的每一步都依赖上一步,你没法切,切了就要在跨层传递时把依赖关系一起传过去,而那部分传不动。
第三,δ 应该成为一个和"准确率"并列的模型/agent 评估指标。
我们现在评估 agent,评估的是"它能不能做对"。但在一个会层层汇总的系统里,"它能把多少东西带回来"是另一个独立的维度。δ = 0.34 意味着:你换一个 δ = 0.2 的 agent,比多派 4 倍的子 agent 更划算 (N^0.8 vs N^0.66,在 N=1000 时是 251 vs 102,差 2.5 倍)。
第四,最容易被误用的是那个 7.8%。
模型说 0.7%--11.3% 值得委托,实际 7.8% 在做。看到这个数字,最容易得出的结论是"所以我们委托得差不多了"。但区间宽度 16 倍本身就说明:在你测出自己的 δ 和 C 之前,这个数字对你没有任何指导意义。 论文的价值不在于给你一个数字,在于给了你一个可以自己填数字的空表格。
下一个值得看的信号 :有没有第二个团队在另一个生产系统上复现 δ。如果 δ 在不同系统、不同任务上稳定落在 0.3 附近,那它就是 agent 的一个类普适常数,值得写进教科书;如果它随任务类型大幅漂移,那它就是一个需要每个系统各自标定的工程量------而这两种情况对架构决策的含义完全不同。
参考
- 主论文 :Rong He, Decomposition Buys Integrity, Not Yield , arXiv:2609.17464,2026-09-15 提交(分类 cs.MA / cs.AI / cs.DC)。本文所有公式、参数与实验数字均来自该论文摘要及正文 HTML 版本。arxiv.org/abs/2609.17...
- 生产多智能体系统的公开对照数据:Anthropic 多智能体研究系统(Opus lead + Sonnet workers):广度优先研究类 query 上相对单 agent Opus 胜率 90.2%;并行化最多缩短 90% 研究时间;token 用量约 15 倍于单聊天交互;token 用量解释 80% 性能方差;建议并发子 agent 数 3--5。该数据为 Anthropic 公开工程博客口径,本文按"厂商自报"处理。
- 上下文衰减背景:长上下文有效利用率随长度下降的现象已有多项独立研究(本文未逐一引用,仅作为"根节点上下文为何需要保护"的定性背景)。
数据来源与免责说明
δ = 0.34 [0.30, 0.38]、C = 0.571 [0.527, 0.615]、μ = 0.939、N^1.39、"403 findings"、"0.7%--11.3% vs 7.8%"、"OR 0.969 0.954, 0.985"、"74 万次工具调用"均来自 arXiv:2609.17464。- "4 倍来源只多带回 2.3 倍"取自论文摘要原文;按
δ点估计 0.34 计算应为 2.5 倍,2.3 倍对应 CI 上界δ=0.38。本文同时列出区间(2.3--2.6 倍)。 - 文中"每层损失约 43%""打 5.4 折"由
C与C·μ直接计算得出,非论文原文表述。 - 该论文为单作者 作品,生产语料来自未具名系统,尚未见独立复现。所有参数应当作"第一数据点"而非普适常数。
- Anthropic 多智能体数据为厂商工程博客自报口径,非同行评审结果。
- 本文未对论文方法做独立验证,所有结论的适用性以读者在自己系统上的实测为准。