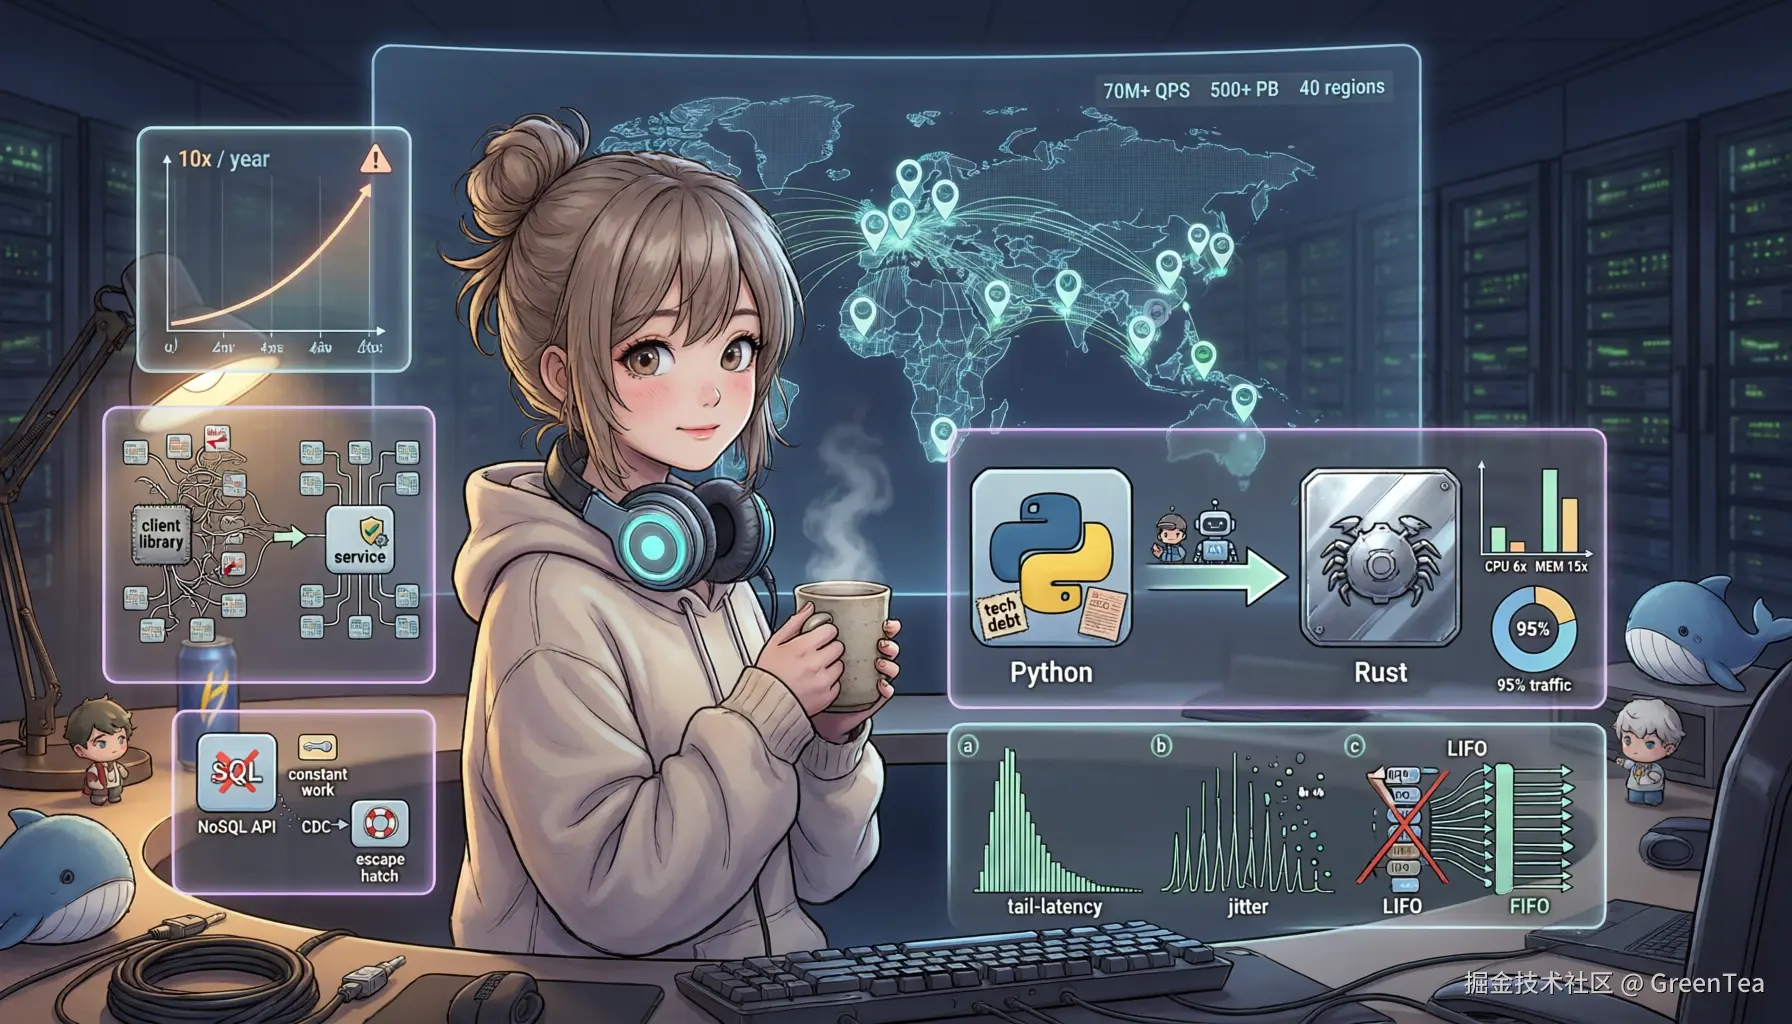
原文:Rapidly scaling online storage to serve over 1 billion ChatGPT users(OpenAI 官方工程博客,系列上篇,2026-09) 作者:Jon Lee、Chaomin Yu、Ben Ries(OpenAI Members of Technical Staff) 本文是深度解读 + 洞察提炼,架构图自绘,关键数据均来自原文。
TL;DR
OpenAI 自研的在线存储平台 Habitat 当前承载 70M+ QPS、500+ PB 数据、约 40 个地理区域 ,支撑每周 10 亿+ 活跃用户的产品流量。这篇文章值得看的不是"又一个亿级架构",而是三个反直觉的选择:
- 明知 Python 撑不住 100x 规模,仍然先用 Python 写了服务------把技术债当成战略工具,押注自家 AI 编码模型未来能替他们完成重写;
- 踩中了 aiohttp 连接池 LIFO 复用导致的主稳态失败(metastable failure) ------慢节点"最后归还连接、最先被复用",流量自我强化地拥向最慢的进程;
- API 刻意做得"弱" ------只提供受限 NoSQL 接口,拒绝任意 SQL,让"昂贵查询"在物理上变得难以书写。
以及一个足够劲爆的结论:2026 年 Q2,2 名工程师 + Codex + GPT-5.5 把整个 Python 服务重写成了 Rust,CPU 效率提升 6 倍、内存效率提升 15 倍,现已承载 95% 生产流量。
一、Habitat 是什么
OpenAI 的每个产品动作------登录、查 Codex 设置、开一个新 ChatGPT 会话------背后都是多次独立的数据查询。查询慢,产品就慢;查询挂,产品直接不可用。
Habitat 就是 OpenAI 为这些在线数据访问自建的存储平台。它的发展脉络:
text
yaml
DevDay 2023        诞生:一个 Python 客户端库 + 单个 Cosmos DB 数据库
                   (为 GPTs 发布而生)
     ↓
2023 ~ 2025        产品工程师自发采用,逐步加上缓存/压缩/加密
     ↓
2025 年中          客户端库形态到极限 → 拆成独立服务(仍是 Python)
     ↓
峰值时期           Python 服务扛住 20M+ QPS
     ↓
2026 Q2            2 人 + Codex + GPT-5.5 重写为 Rust,已承接 95% 流量
     ↓
现在 70M+ QPS / 500+ PB / ~40 regions,Python 即将全部下线作者对"难"的定位很微妙:这个规模本身"不算特别难",难的是增长速率 。业界常规做法是按 10x 设计,指望撑几年再迎下一个 10x;而 OpenAI 连续三年每年增长 10x 以上,等于没有"从容重建"的窗口。所以 Habitat 的演进史本质上是一系列战术决策的排序(sequencing) :榨干现有组件的每一分性能,顶住存储和算力的容量危机,为基础性投资(比如 Rust 重写)争取时间。
二、为什么从"客户端库"变成"独立服务"
这是全文最有共鸣的部分。库形态的致命问题不是功能,而是变更的扇出成本。
原文给了一个非常典型的案例:为了缩小单区域故障的爆炸半径,想把最关键的数据集迁移到一组按地域分布的 Azure Cosmos DB 账号上。这需要给客户端加路由逻辑:
text
加路由逻辑(挂在 feature flag 后面)
  → 协调几十个服务逐个发版上线           ------ 好几天
  → 上线前先做流量影子(shadowing)验证分片正确性 ------ 又几天
  → 发现分片逻辑有 bug,修一个再走一遍流程        ------ 又几天
  → 终于可以开 flag 了
  → 某团队因无关原因回滚服务,回滚到了带 bug 的旧客户端版本
  → 触发了他们拼命想避免的那场故障
库的变更 = 几十个团队的发版协调,脆弱、低效、随时被"人的行为"击穿(回滚是运维中最常见、最不可控的动作)。于是他们把 Habitat 抽成独立服务,换来两样东西:
- 变更的单一控制点:部署、可观测性、平台增强全部中心化,一次改进所有产品即时受益;
- 安全的单一咽喉点(chokepoint) :集中执行访问控制策略、审计日志,收敛对底层 Cosmos DB 的直接访问。原文特别提到,这里是防止外部、内部以及 agent 行为者未授权访问用户数据的关键层------把"agent 当作一类新的威胁主体"写进基础设施设计,这个视角值得注意。
三、战略性技术债:明知不行,先用 Python
抽服务时他们完全清楚 Python 作为高吞吐服务的代价:更高的网络延迟、更多的 CPU/内存成本,而且判断出"Python 的低效在 100x 规模下必然不可接受,重写几乎注定会发生"。
但他们还是先用 Python 写了服务,理由是排定优先级:
当时的首要目标不是成本或资源优化,而是解除产品开发人员的阻塞、建立核心 API、构建稳固的基础设施。
更有意思的是他们下的赌注:押注自家编码模型的进步速度会快于自身扩容的压力------等真需要迁移时,Codex 和 GPT 会让迁移变得可行。原文直言 "That bet eventually proved correct"。
这个决策链可以提炼成一个可复用的判断框架:
| 决策要素 | Habitat 的答案 |
|---|---|
| 这笔技术债挡不挡当下的路? | 不挡(先解阻塞) |
| 债的"利息"(性能/成本)能否承受? | 短期可以,靠架构手段压长尾 |
| 未来偿还本金的能力有确定性来源吗? | 有------自家编码模型 |
| 债限制了什么"不可逆"的选项吗? | 没有,API 形态先冻结好 |
技术债不可怕,没有偿还路径的技术债才可怕。
四、Python 服务的长尾延迟治理(全文最干货)
作者有一句非常精辟的话:
当平均一个用户请求要产生数百次数据库调用时,用户感受到的是最慢的那一次调用。
Python asyncio 解决了 I/O 并发,但受 GIL 限制无法提供 CPU 并行。而 Habitat 有一堆 CPU 密集任务:路由、压缩、加密、校验和、下游健康检查、请求影子、请求对冲。asyncio 的事件循环调度延迟(scheduling delay)很容易反过来主导 p99 长尾------下游存储明明响应很快,请求却卡在"协程等不到 CPU 去解析响应"。
4.1 先把"事件循环有多忙"变成一个指标
OpenAI 对 Python 服务的监控方法论:除了内存/CPU/网络/磁盘的标准 USE 指标,必须监控 asyncio 事件循环本身的延迟。做法:周期性调度一个后台任务,记录"期望执行时间"与"实际执行时间"的差值,实时得到事件循环调度延迟。
实测结果:高负载下,即使每进程并发请求不多,调度抖动也能达到数百毫秒,极端情况数秒。
应对方式非常朴素:每个进程只服务少量并发请求,靠海量水平扩展 worker 进程来补吞吐。用"更多更小的进程"换取调度延迟的可控。
4.2 特性开关配置引发的周期性长尾
上线初期用 CPU profiling 定位到第一个根因:Statsig 特性开关配置的周期性 JSON 解析。
三个因素叠加成事故配方:
- Statsig 默认每分钟拉一次全量配置(所有服务的所有规则);
- 拉取没有 jitter;
- 每个 pod 部署多达 8 个 Python 进程。
结果:每分钟都会有一个时刻,整个 pod 的所有 worker 同时停下手头的请求,集体去解析一份巨型 JSON。用户视角就是周期性的长尾尖刺。
修复也很简单:下发更小的定向配置 + 拉长刷新间隔 + 给后台任务加 jitter。
这条对任何语言的服务都适用:所有周期性后台任务都应该有随机相位,否则就是全集群同步抖动的定时炸弹。
4.3 连接池 LIFO 复用:一次教科书级 metastable failure
这是我认为全文最有传播价值的案例。背景:为了压低事件循环延迟,客户端进程很多,而客户端侧连接池导致一个客户端进程只与少数几个服务端进程建立连接 ,负载分布极不均匀------尾部进程的并发量达到平均值的 5~10 倍。
他们在一次"偶然事件"中发现了要害:停掉造成过载的客户端后,部分服务端进程仍然持续降级,请求越收越多,直到重启才恢复。典型的失控正反馈。
根因:Python aiohttp 的 TCPConnector 默认用 LIFO 复用连接------最近归还的连接最先被复用。这个默认值平时是合理的(突发流量创建的多余连接可以尽快空闲超时回收),但在过载场景下形成了正反馈闭环:
text
css
突发流量打向 A/B/C(C 是慢节点)
  → 发往 C 的请求返回最慢,其连接"最后"归还池
  → LIFO 优先复用最近归还的连接 → 新请求更容易走 C
  → C 越来越慢、越来越堵
  → C 的连接归还得越来越晚,被复用得越来越多
  → 流量自我强化地拥向最慢的进程(metastable failure)
修复:把连接池改成 FIFO 复用,直接打断这个反馈回路------代价是突发后保持更多活跃连接,但换来各节点负载公平,连稳态请求方差都一起降了。
本质:LIFO 把"队列"退化成了"堆",而负载均衡需要的是公平队列的语义。任何"最近者先出"的策略在过载场景下都会放大马太效应。 后来他们干脆把这个问题的控制权整体上交------现在主要靠 Istio/Envoy 做连接池与 server-load-aware 负载均衡。
4.4 进程太多本身就是新的故障源(thundering herd)
低延迟策略的副作用:进程数量多了一个数量级,下游连接数瞬间成了稀缺资源:
- 一次日常发版(如果不做成慢速发布)→ 连接风暴 → 下游 CPU churn;
- 一次连接泄漏 → 打满 NAT 网关,网络瘫痪;
- 阈值被"进程多一个数量级"显著拉低------纯吞吐都撑得住,连接数先撑不住。
对策同样收敛到 Envoy:
- 把 Python 的 HTTP/1 出站连接升级为 HTTP/2 多路复用,池化连接、延长连接寿命,把连接扇出压缩一个数量级;
- 在 Envoy 这个中心点统一实现限流与熔断------这些策略分散在每个 Python 进程里效果会差很多。
一个清晰的分层哲学浮出水面:Python 进程层管并发模型,Envoy/Istio 网格层管连接与过载保护,各司其职。
五、API 设计哲学:刻意做"弱"的接口
Habitat 的 API 是全文最值得后端同学咀嚼的设计决策:
不允许客户端构造任意 SQL(那意味着大扫描、多表 join),只暴露一个简单的 NoSQL API。没有"强大的 API"是显式的设计权衡。
背后的推演链条:
- 成本不对称:写一条昂贵 SQL 很便宜很容易,跑起来却昂贵且难救。Postgres 时代,OpenAI 依靠人肉 review 所有查询和 schema 变更来兜底------团队小的时候可行,团队一大就管不住,"热路径上一条新的昂贵查询打挂数据库"成了常见事故源;
- 不可预测的扇出(unpredictable fanout)是运维毒药:它破坏隔离性、搅乱负载均衡、制造难以扩容的延迟悬崖;
- 所以 Habitat 优化目标是:简单、可预测、恒定工作量(constant-work)的请求。昂贵查询在客户端一侧就变得极其显眼,复杂 join 和图遍历的活儿甩回给业务团队自己做------用设计引导更高效的方案。
具体建模借鉴了 Facebook 的 TAO 论文 (object/edge 模型):客户端预定义对象和边的类型及其关系,但不定义类型的内容。形似图,但只支持查询某个对象的直接边,不支持任意图遍历。分区策略:每个对象与其边同置(colocate)在一个存储分区,但刻意不去做跨对象的同置------于是天然容易水平扩展,代价是图遍历低效(一次 hop 可能要跨两个不同 region 的 Cosmos DB 账号)。
复杂查询怎么办?逃生舱而非主路径 :通过 CDC 把在线存储的变更近实时同步到各团队独占的 Rockset 实例,复杂查询/分析/搜索全部打到离线侧,与在线存储物理隔离。每个团队为自己的 Rockset 扩容负责------多一层接入摩擦,换来在线链路的绝对安全。
这一节可以总结成一句 slogan: "简单查询是默认,复杂查询是特权,且特权自费。"
六、Rust 重写:一次"提前埋好"的胜利
前置条件成熟时的地位:Habitat 是 OpenAI 按 core 数计第二大服务 (Envoy 足迹第四),Python 峰值扛过 20M+ QPS。
然后是本文最戏剧性的段落:
2026 年 Q2,2 名工程师 + Codex + GPT-5.5 重写了整个服务。新 Rust 服务现已承接 95% 生产流量,Python 将在未来几周内全部退役。Rust 版本 CPU 效率 6 倍、内存效率 15 倍,平均和长尾延迟显著降低。
注意这个重写不是"推倒重来",而是在一次成功迁移(库 → 服务)之后、API 与基础设施全部稳固的前提下进行的。第一段押注的"技术债偿还路径",在三年后精确兑现。这也是 Part I 标题里 "stretching a service written in an uncommon serving stack language" 的完整闭环。
七、核心洞察提炼(可以直接抄走的 takeaways)
- 规模问题 ≈ 时间问题。OpenAI 面对的不是"设计一个巨大系统",而是"在 10x/年的增速下,把战术动作排成正确的序列"------榨现成组件、防容量危机、给基础投资买时间。
- 客户端库的变更扇出是规模杀手。当你的库被几十个服务依赖,任何需要全量协调的变更都会退化成数天级的人肉编排,而且会被"某团队回滚"这类随机事件击穿。早抽服务,早建单一控制点。
- 技术债可以战略性地欠:前提是(a)它当下买到了更重要的东西,(b)利息可承受,(c)有确定的偿还能力来源。OpenAI 的偿还路径是自家 AI 编码模型------这本身就是一次对自家产品力的架构级押注。
- 监控 asyncio/事件循环延迟应成为所有 Python/JS 服务的第一性指标;测量手段(周期任务、期望/实际差值)廉价且通用。
- 所有周期性后台任务必须加 jitter(Statsig 配置拉取案例),否则全集群同步抖动。
- 连接池复用策略 = 负载均衡策略。aiohttp 默认 LIFO 在过载下制造正反馈的 metastable failure;FIFO 打破回路。任何"慢节点最后归还资源、反而最容易被复用"的机制都在积累下一次雪崩。
- 进程数量本身就是故障域:进程多一个数量级,连接数/NAT/慢启动发版都会先于吞吐成为瓶颈。用 HTTP/2 多路复用 + 网格层(Istio/Envoy)集中收口连接与熔断限流。
- API 的"弱"是可靠性之强:constant-work 请求、禁止任意查询、把复杂度赶到离线(Rockset + CDC 逃生舱)。可预测性 > 表达力。
- 用"卡在等协程被调度"而不是"下游慢"来理解长尾:容量不足时,瓶颈常常不在下游响应时间,而在客户端运行时调度。
八、待续(Part II 预告)
下篇将覆盖存储层本身:多租户大规模可靠性、读性能的分层优化策略、与 Azure Cosmos DB 合作如何支撑 500PB / 70M QPS。从选题看,下篇的重头戏是数据库层,本篇则是"服务层"------建议掘金读者两篇连读,正好构成 OLTP 平台演进的一堂完整公开课。
参考资料
- 原文:Rapidly scaling online storage to serve over 1 billion ChatGPT users --- OpenAI Blog
- TAO 论文(Habitat object/edge 模型灵感来源):TAO: Facebook's Distributed Data Store for the Social Graph, USENIX ATC 2013
- 关联阅读:aiohttp
TCPConnector文档(force_close/ 连接复用语义);Envoy HTTP/2 upstream 连接池文档