✨作者主页 :IT研究室✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、微信小程序、Golang、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
文章目录
一、前言
系统介绍
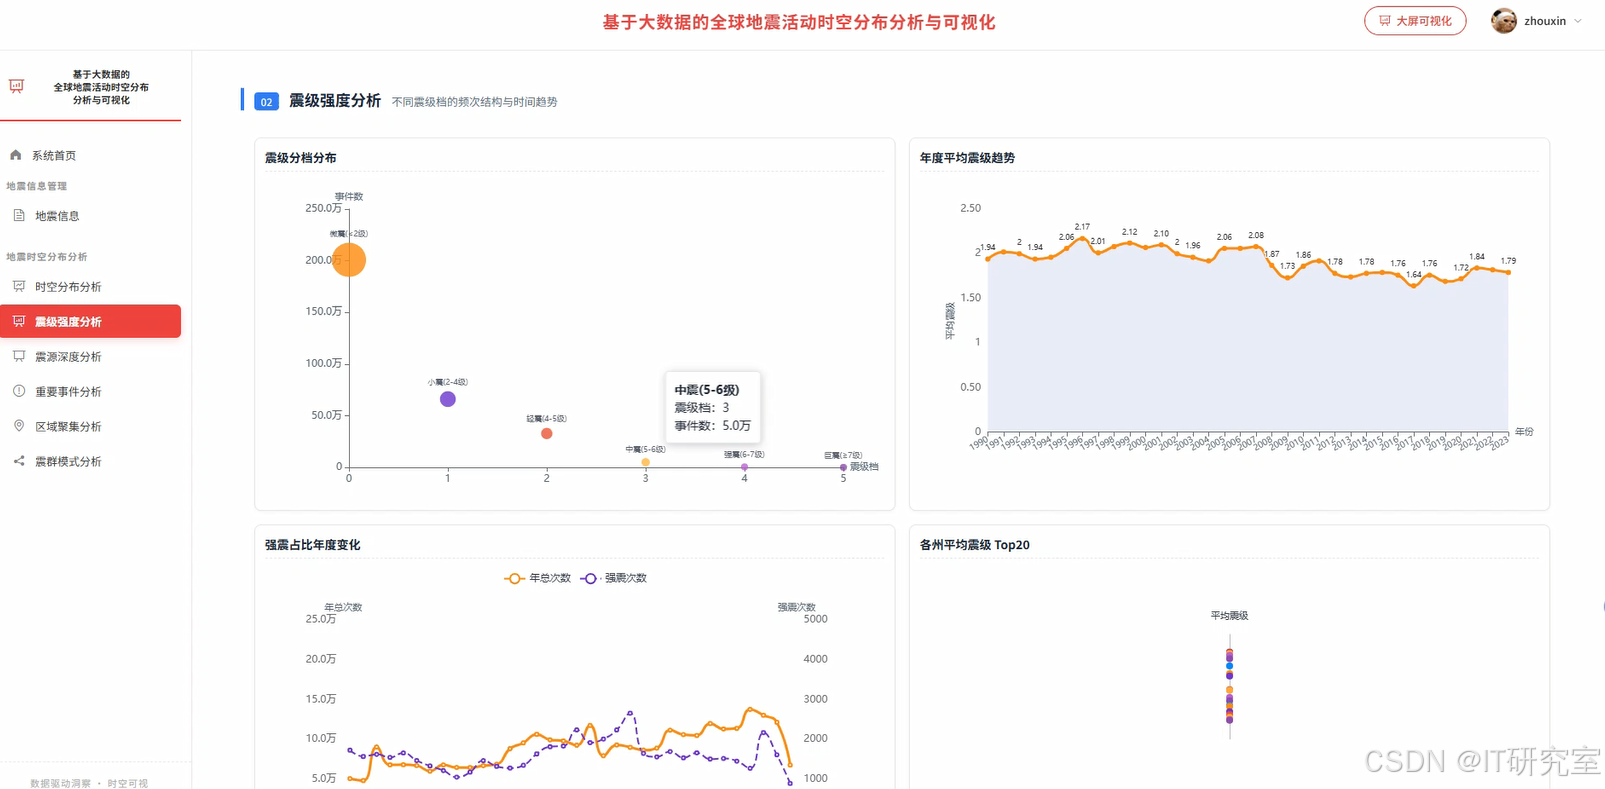
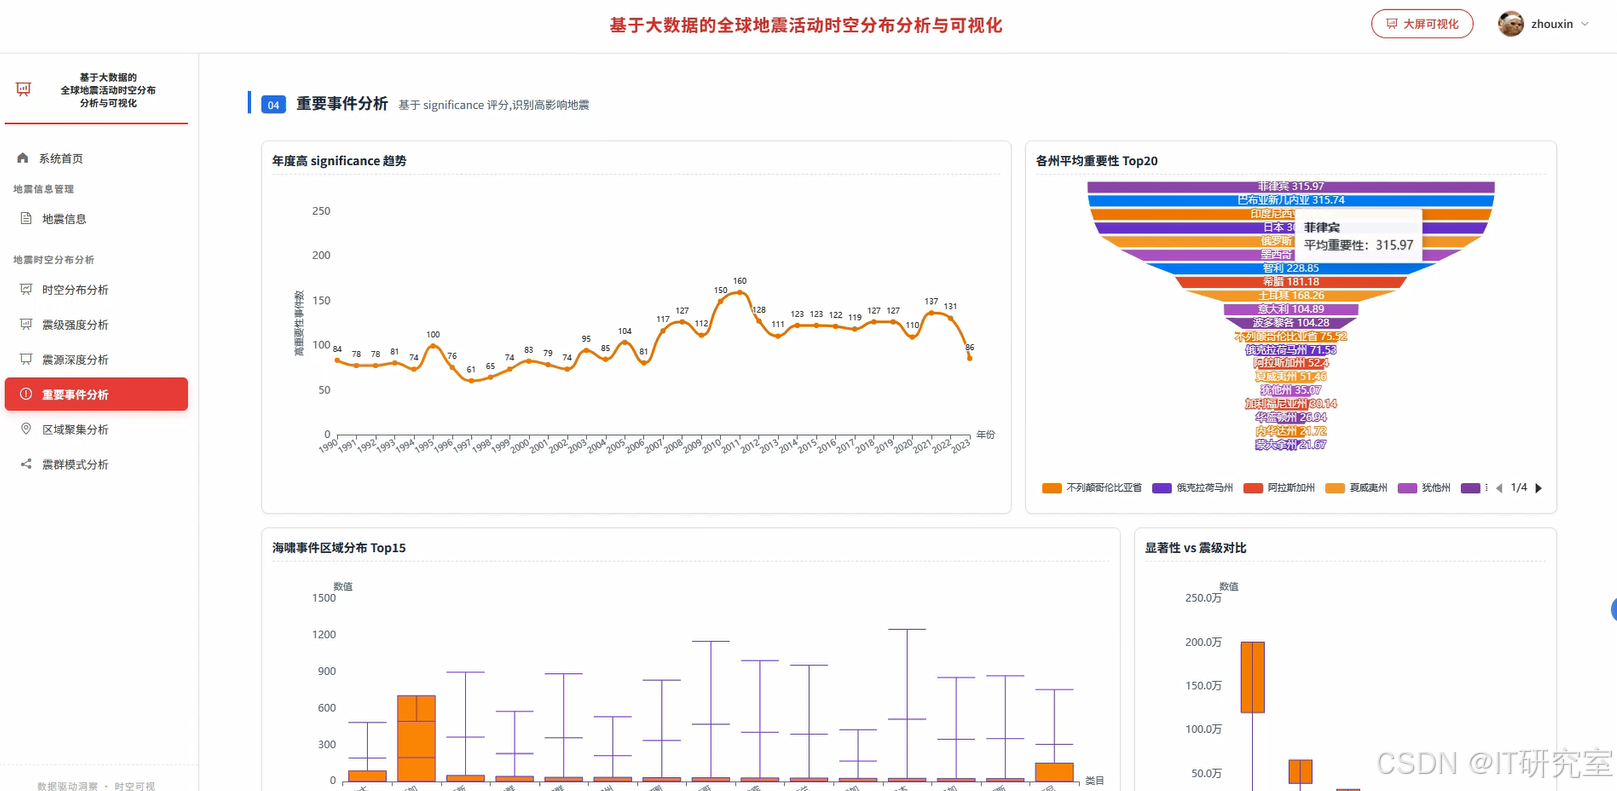
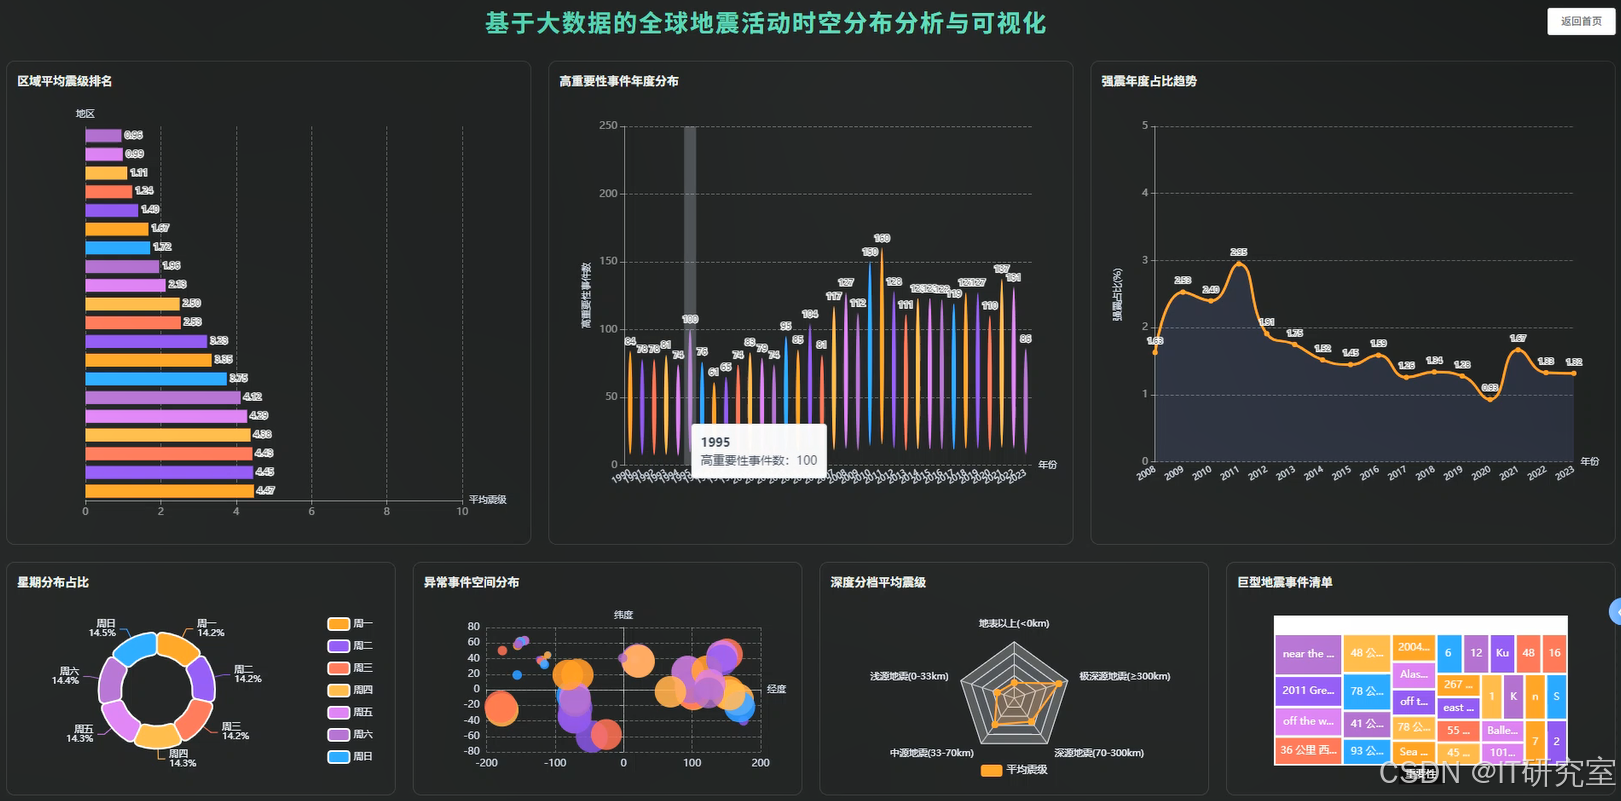
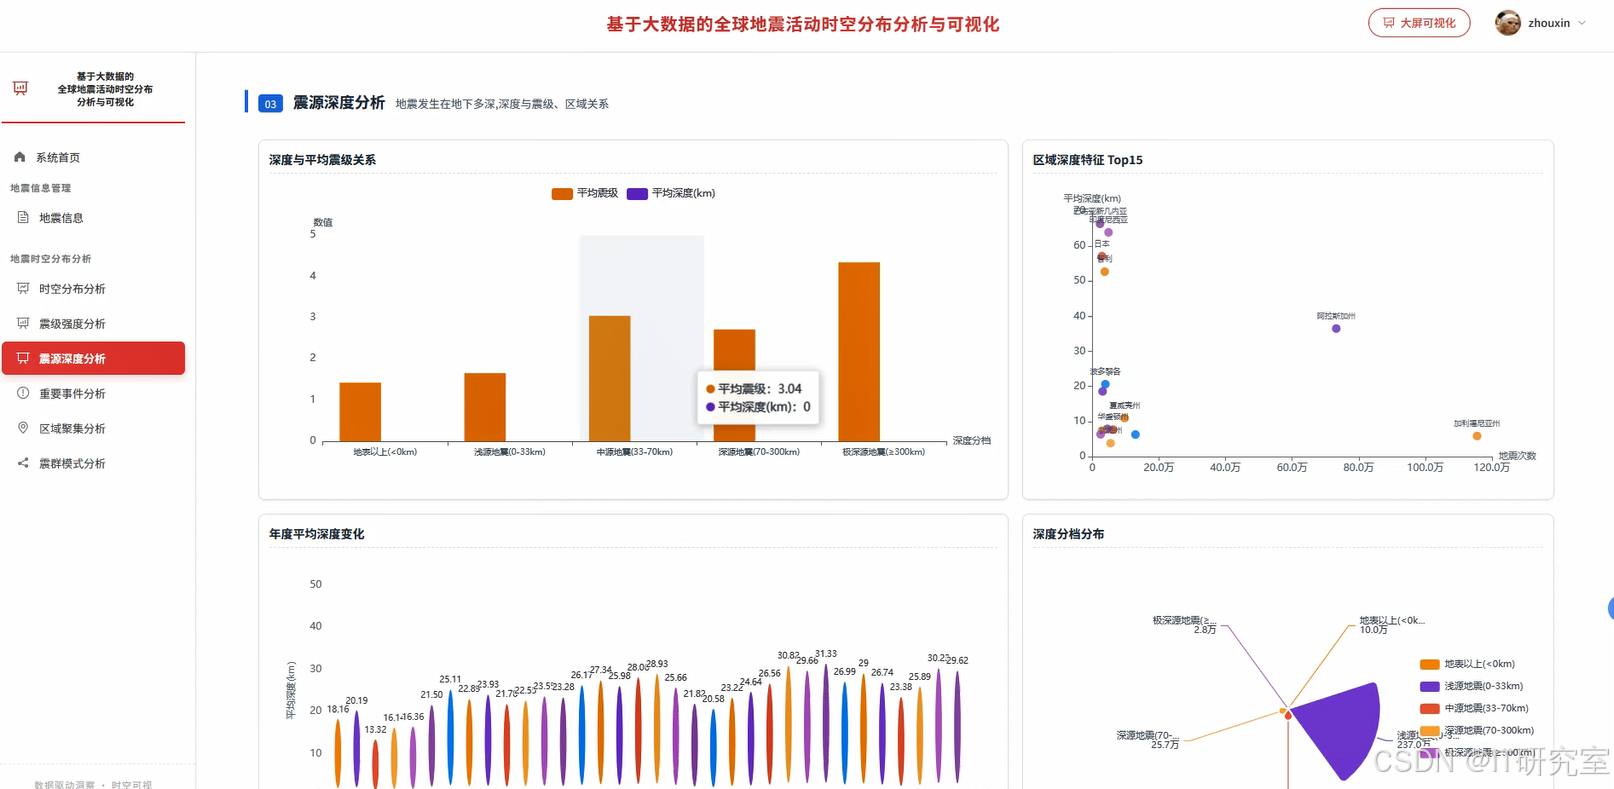
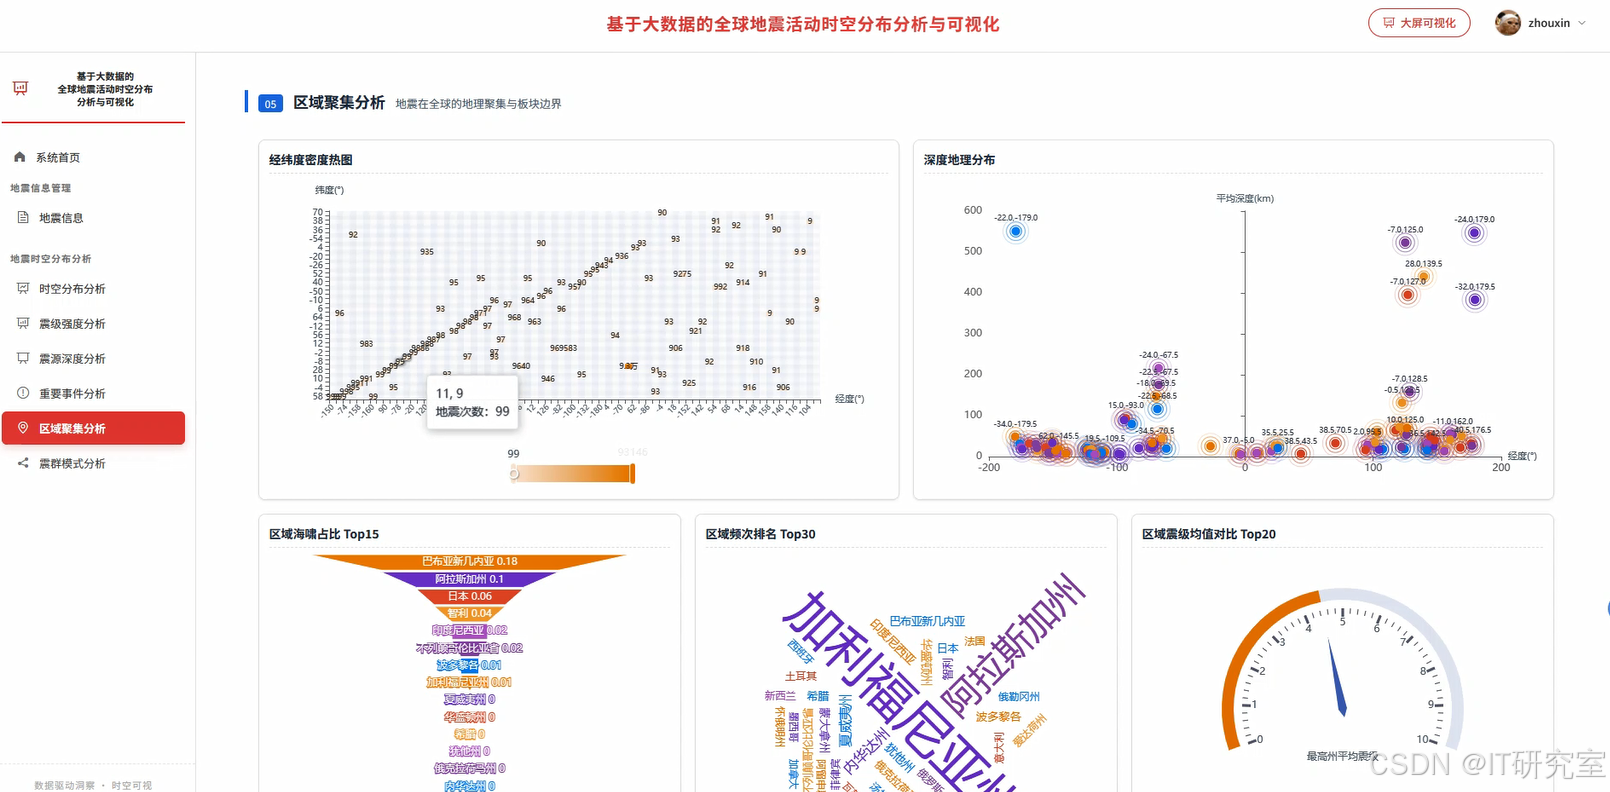
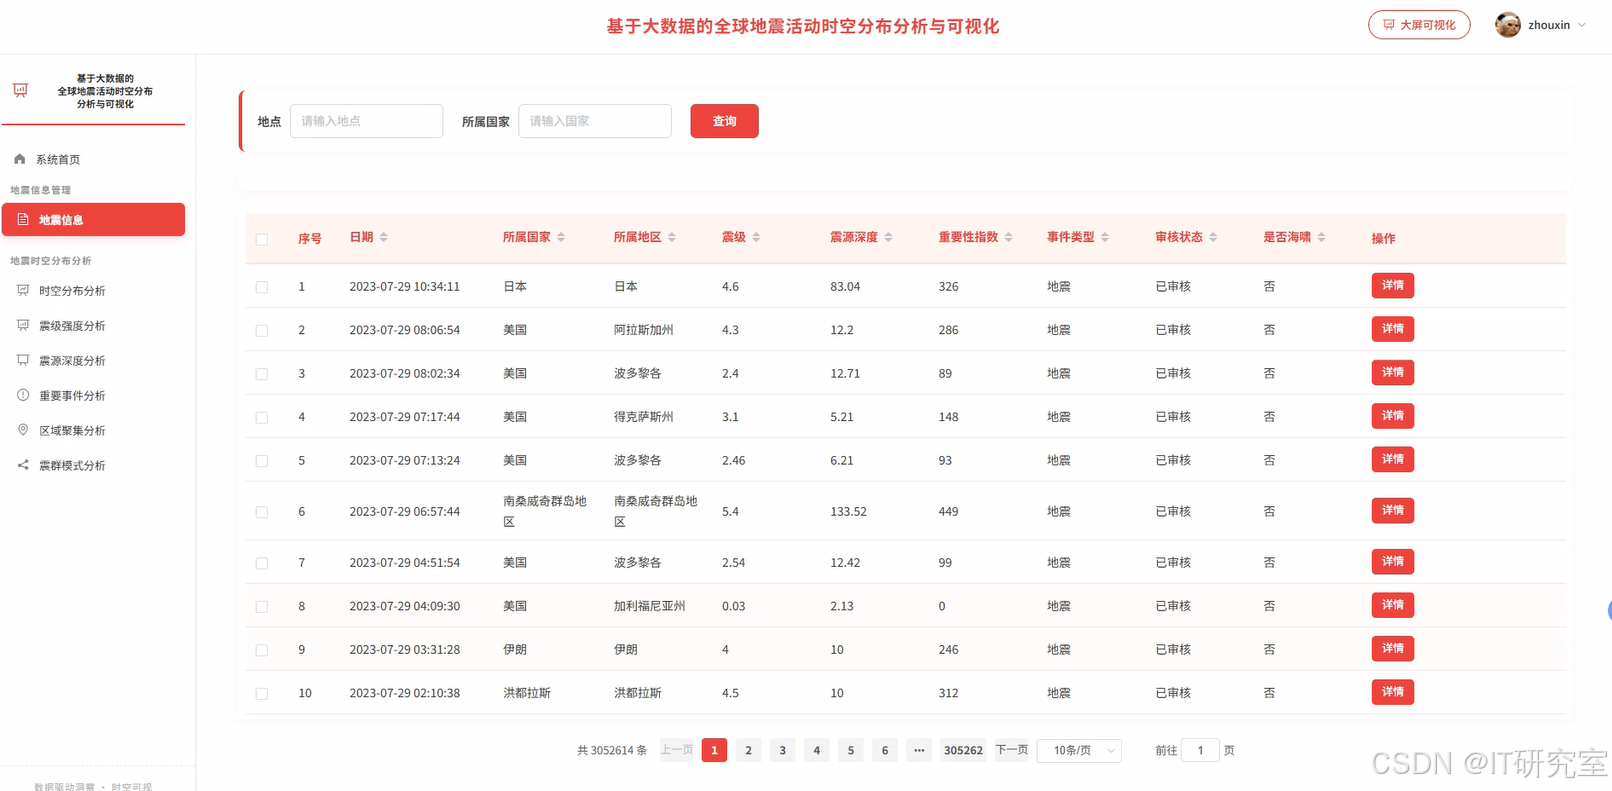
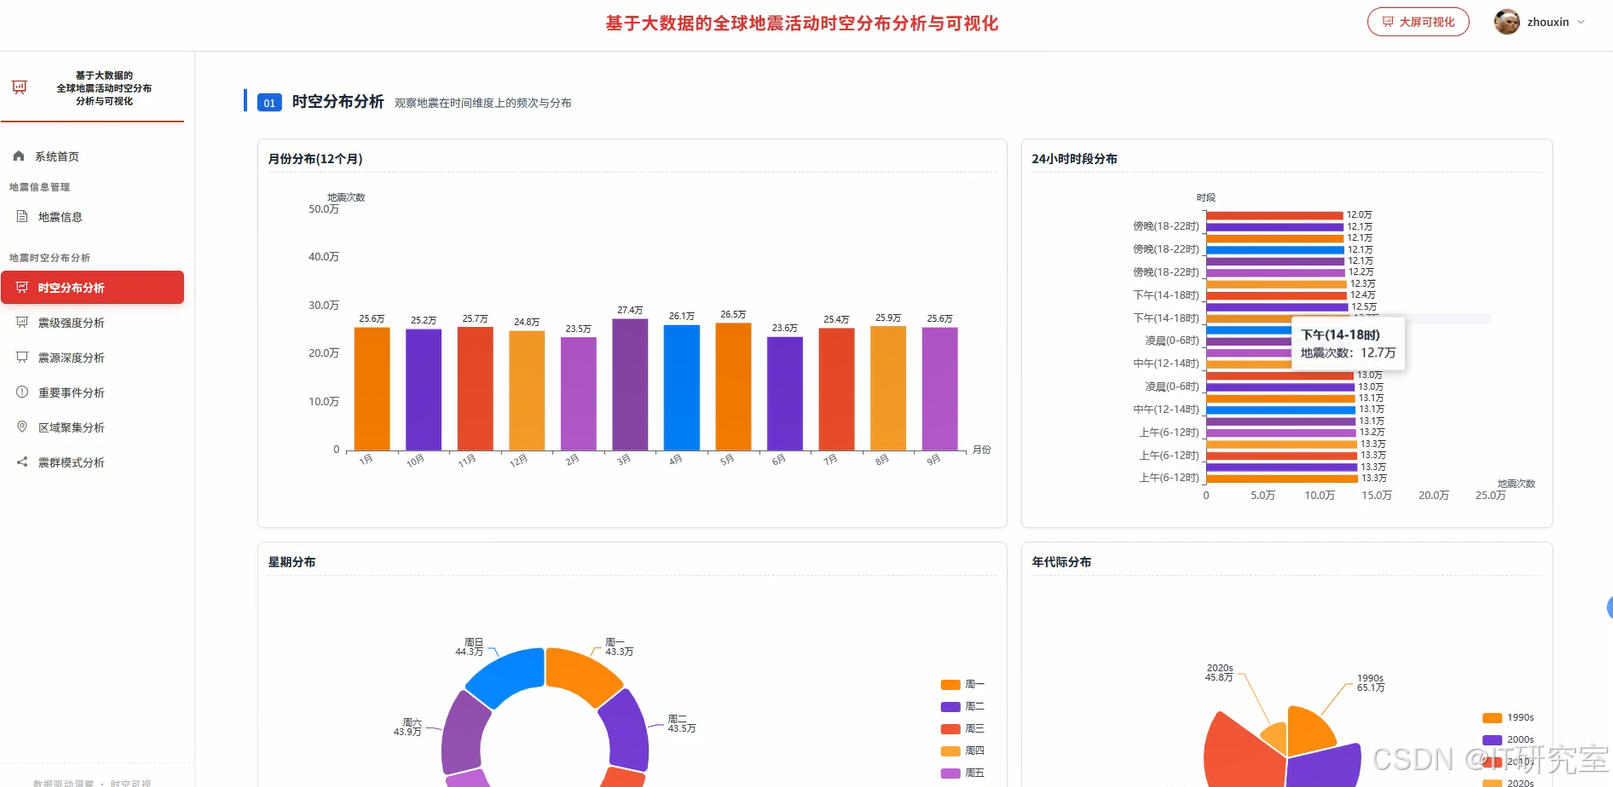
本系统名为《基于大数据的全球地震活动时空分布分析与可视化》,围绕全球地震数据展开存储、清洗、统计分析与可视化展示。系统后端采用Python+Django或Java+Spring Boot两种版本实现,大数据处理部分依托Hadoop与Spark体系,使用HDFS完成地震数据的存储,借助Spark与Spark SQL完成数据读取、筛选、聚合与统计分析,并结合Pandas、NumPy进行必要的数据整理与数值计算,数据库采用MySQL保存业务数据与分析结果,前端使用Vue、ElementUI、Echarts、HTML、CSS、JavaScript、jQuery完成页面交互与图表展示。系统功能包括地震信息、时空分布分析、震级强度分析、震源深度分析、重要事件分析、区域聚集分析、震群模式分析,其中时空分布分析从时间与空间两个角度观察地震活动变化,震级强度分析用于统计不同震级区间的地震数量与分布情况,震源深度分析用于研究地震深度层次特征,重要事件分析用于筛选影响较大的地震记录,区域聚集分析用于观察地震在特定区域内的集中程度,震群模式分析用于发现短时间内连续发生的地震序列,整体形成一个从数据存储、大数据处理到可视化呈现的完整毕业设计系统。
选题背景
全球地震活动一直是人们比较关注的自然现象,地震发生的时间、地点、震级和震源深度等信息,往往能反映出不同区域的地质活动特征。随着地震监测手段不断增多,相关数据量也在持续增长,单靠传统表格和简单统计方式,已经不太容易把全球范围内的地震活动规律看清楚。对于计算机专业毕业设计来说,如何借助大数据技术处理这些数据,并把时间、空间、震级、深度等维度联系起来分析,是一个比较实际的方向。Hadoop与Spark能够为大规模地震数据提供存储和计算支持,Spark SQL可以完成分组统计和条件筛选,Pandas、NumPy也能在数据处理过程中发挥作用。基于这些技术,本课题尝试构建一个面向全球地震活动的时空分布分析与可视化系统,把分散的地震记录整理成可以观察和分析的结果,为后续展示提供数据基础。
选题意义
本课题的意义更多体现在学习和实践层面。通过完成这个系统,可以把Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy这些大数据相关技术真正用到具体问题中,而不是只停留在概念理解上。系统把地震信息、时空分布分析、震级强度分析、震源深度分析、重要事件分析、区域聚集分析、震群模式分析等功能组合起来,能够帮助使用者从不同角度查看全球地震活动情况,也能让数据展示比单纯表格更直观一些。对于计算机专业学生来说,这类题目涉及数据存储、数据处理、后端接口、前端可视化和数据库操作,能够把大学期间学到的多个知识点串起来。虽然它只是一个毕业设计,分析深度和实际业务能力都有限,但可以作为大数据入门实践的一个小案例,也为以后继续学习数据分析和可视化打下一点基础。
二、开发环境
- 大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
- 开发语言:Python+Java(两个版本都支持)
- 后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
- 前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
- 详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
- 数据库:MySQL
三、系统界面展示
- 基于大数据的全球地震活动时空分布分析与可视化界面展示:
四、代码参考
- 项目实战代码参考:
java(贴上部分代码)
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, count, avg, max, min, window, desc
import pandas as pd
import numpy as np

spark = SparkSession.builder.appName("GlobalEarthquakeAnalysis").master("local[*]").config("spark.sql.shuffle.partitions", "4").getOrCreate()

def analyze_time_space_distribution():
    earthquake_df = spark.read.format("csv").option("header", "true").option("inferSchema", "true").load("hdfs://localhost:9000/earthquake/earthquake_data.csv")
    clean_df = earthquake_df.filter(col("magnitude").isNotNull() & col("latitude").isNotNull() & col("longitude").isNotNull() & col("time").isNotNull())
    time_df = clean_df.withColumn("year", col("time").substr(1, 4)).withColumn("month", col("time").substr(6, 2))
    year_count = time_df.groupBy("year").agg(count("*").alias("earthquake_count")).orderBy("year")
    month_count = time_df.groupBy("month").agg(count("*").alias("earthquake_count")).orderBy("month")
    space_df = clean_df.withColumn("lat_range", (col("latitude") / 10).cast("int") * 10).withColumn("lon_range", (col("longitude") / 10).cast("int") * 10)
    space_count = space_df.groupBy("lat_range", "lon_range").agg(count("*").alias("earthquake_count")).orderBy(desc("earthquake_count"))
    year_pd = year_count.toPandas()
    month_pd = month_count.toPandas()
    space_pd = space_count.toPandas()
    year_pd["earthquake_count"] = pd.to_numeric(year_pd["earthquake_count"])
    month_pd["earthquake_count"] = pd.to_numeric(month_pd["earthquake_count"])
    space_pd["earthquake_count"] = pd.to_numeric(space_pd["earthquake_count"])
    year_result = year_pd.to_dict(orient="records")
    month_result = month_pd.to_dict(orient="records")
    space_result = space_pd.head(100).to_dict(orient="records")
    return {"year_distribution": year_result, "month_distribution": month_result, "space_distribution": space_result}

def analyze_magnitude_intensity():
    earthquake_df = spark.read.format("csv").option("header", "true").option("inferSchema", "true").load("hdfs://localhost:9000/earthquake/earthquake_data.csv")
    magnitude_df = earthquake_df.filter(col("magnitude").isNotNull())
    magnitude_df = magnitude_df.withColumn("magnitude_level", when(col("magnitude") < 3, "微震").when((col("magnitude") >= 3) & (col("magnitude") < 5), "小震").when((col("magnitude") >= 5) & (col("magnitude") < 7), "中强震").otherwise("强震"))
    level_count = magnitude_df.groupBy("magnitude_level").agg(count("*").alias("earthquake_count"), avg("magnitude").alias("avg_magnitude"), max("magnitude").alias("max_magnitude"), min("magnitude").alias("min_magnitude")).orderBy(desc("earthquake_count"))
    level_pd = level_count.toPandas()
    level_pd["earthquake_count"] = pd.to_numeric(level_pd["earthquake_count"])
    level_pd["avg_magnitude"] = pd.to_numeric(level_pd["avg_magnitude"])
    level_pd["max_magnitude"] = pd.to_numeric(level_pd["max_magnitude"])
    level_pd["min_magnitude"] = pd.to_numeric(level_pd["min_magnitude"])
    magnitude_array = np.array(level_pd["earthquake_count"].tolist())
    magnitude_mean = float(np.mean(magnitude_array)) if len(magnitude_array) > 0 else 0.0
    magnitude_std = float(np.std(magnitude_array)) if len(magnitude_array) > 0 else 0.0
    level_result = level_pd.to_dict(orient="records")
    return {"magnitude_level_distribution": level_result, "magnitude_mean": magnitude_mean, "magnitude_std": magnitude_std}

def analyze_depth_and_region_cluster():
    earthquake_df = spark.read.format("csv").option("header", "true").option("inferSchema", "true").load("hdfs://localhost:9000/earthquake/earthquake_data.csv")
    depth_df = earthquake_df.filter(col("depth").isNotNull() & col("latitude").isNotNull() & col("longitude").isNotNull())
    depth_df = depth_df.withColumn("depth_level", when(col("depth") < 70, "浅源地震").when((col("depth") >= 70) & (col("depth") < 300), "中源地震").otherwise("深源地震"))
    depth_count = depth_df.groupBy("depth_level").agg(count("*").alias("earthquake_count"), avg("depth").alias("avg_depth"), max("depth").alias("max_depth"), min("depth").alias("min_depth")).orderBy(desc("earthquake_count"))
    region_df = depth_df.withColumn("region_lat", (col("latitude") / 5).cast("int") * 5).withColumn("region_lon", (col("longitude") / 5).cast("int") * 5)
    region_count = region_df.groupBy("region_lat", "region_lon").agg(count("*").alias("earthquake_count"), avg("magnitude").alias("avg_magnitude"), avg("depth").alias("avg_depth")).filter(col("earthquake_count") >= 5).orderBy(desc("earthquake_count"))
    depth_pd = depth_count.toPandas()
    region_pd = region_count.toPandas()
    depth_pd["earthquake_count"] = pd.to_numeric(depth_pd["earthquake_count"])
    depth_pd["avg_depth"] = pd.to_numeric(depth_pd["avg_depth"])
    region_pd["earthquake_count"] = pd.to_numeric(region_pd["earthquake_count"])
    region_pd["avg_magnitude"] = pd.to_numeric(region_pd["avg_magnitude"])
    region_pd["avg_depth"] = pd.to_numeric(region_pd["avg_depth"])
    depth_array = np.array(depth_pd["earthquake_count"].tolist())
    region_array = np.array(region_pd["earthquake_count"].tolist())
    depth_mean = float(np.mean(depth_array)) if len(depth_array) > 0 else 0.0
    region_mean = float(np.mean(region_array)) if len(region_array) > 0 else 0.0
    depth_result = depth_pd.to_dict(orient="records")
    region_result = region_pd.head(100).to_dict(orient="records")
    return {"depth_level_distribution": depth_result, "region_cluster_distribution": region_result, "depth_mean": depth_mean, "region_mean": region_mean}
五、系统视频
基于大数据的全球地震活动时空分布分析与可视化项目视频:
结语
最新大数据毕业设计选题推荐-基于大数据的全球地震活动时空分布分析与可视化-大数据-Spark-Hadoop-Bigdata
想看其他类型的计算机毕业设计作品也可以和我说都有 谢谢大家!
有技术这一块问题大家可以评论区交流或者私我~
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇