1、登录阿里云平台
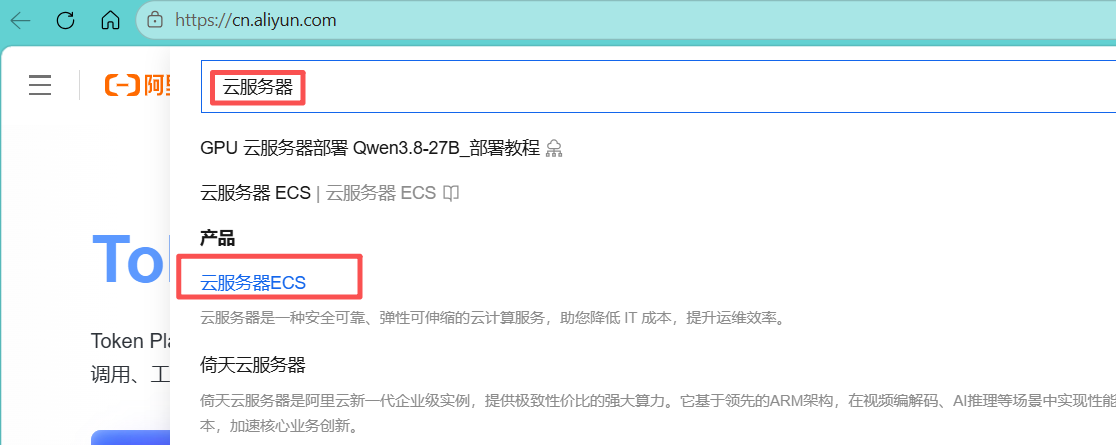
搜索 云服务器 ECS,
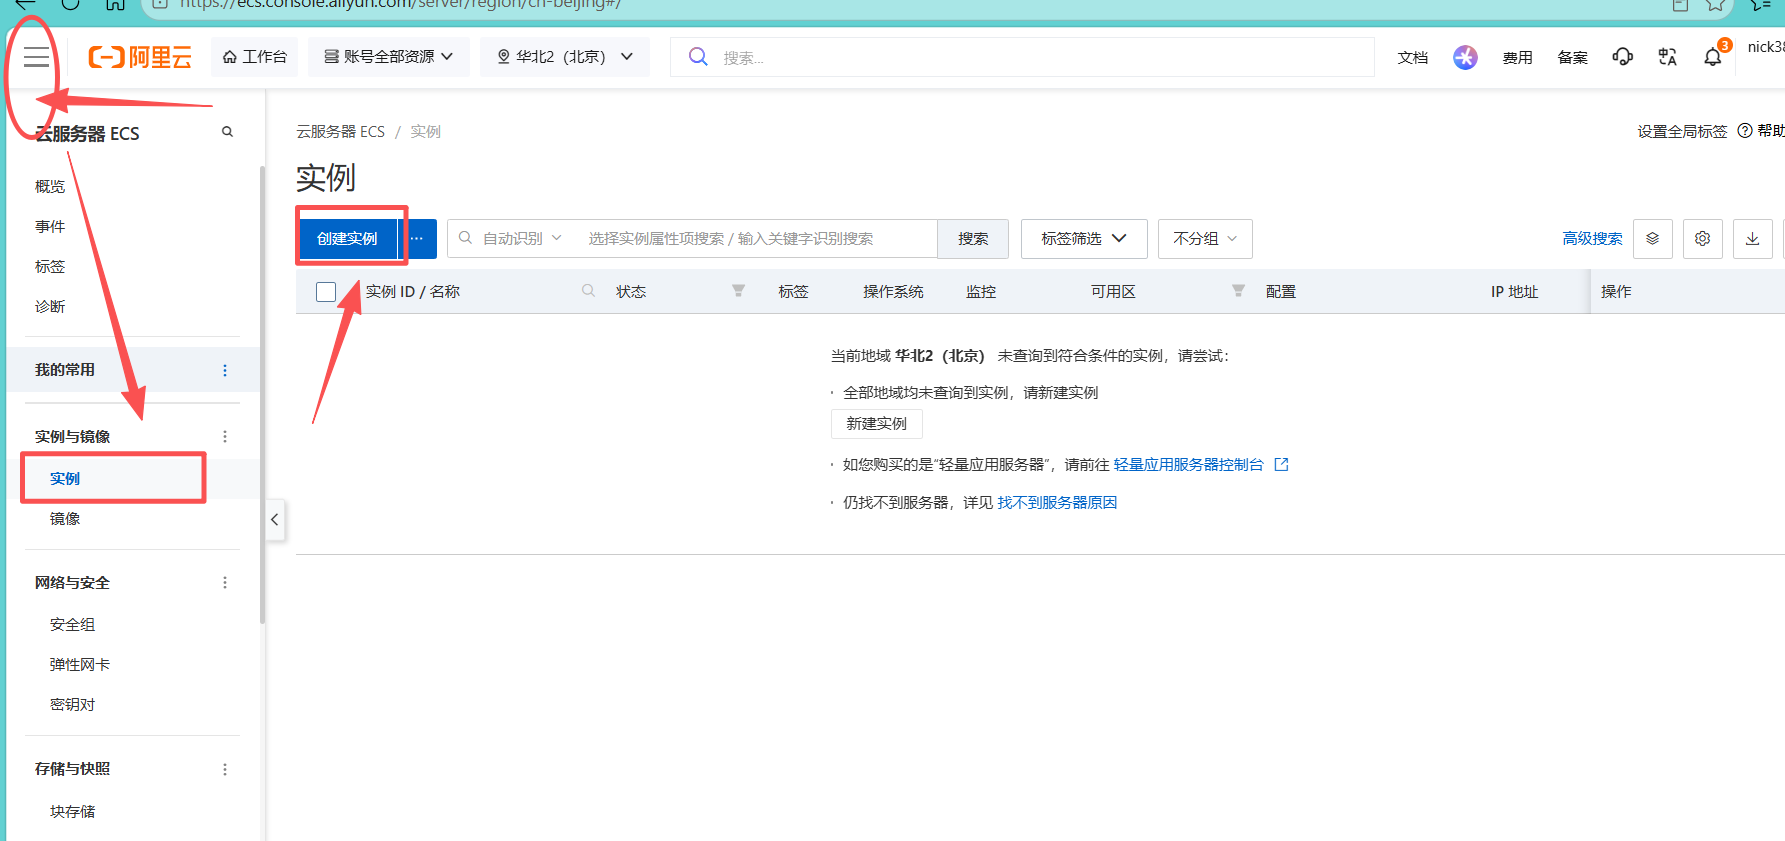
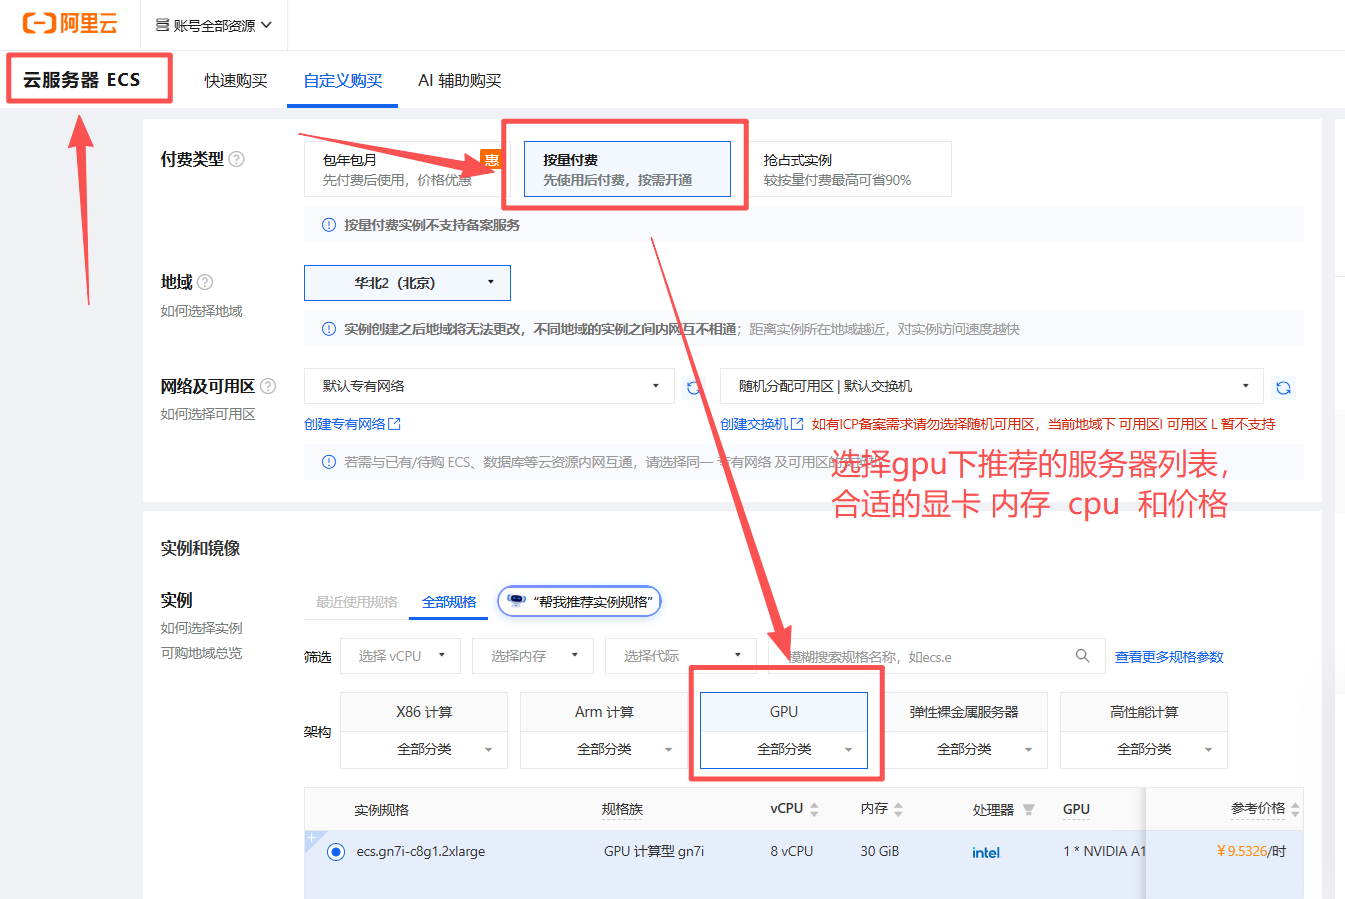
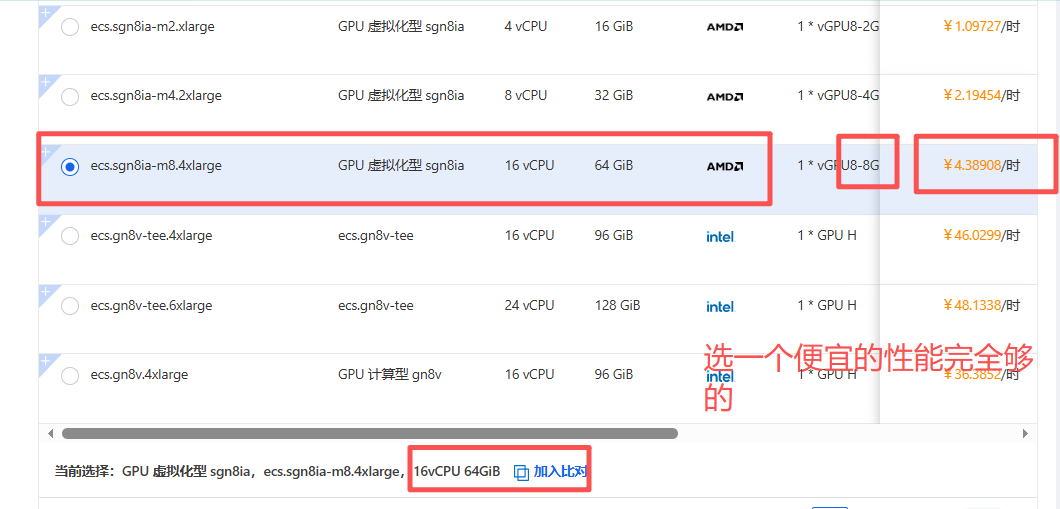
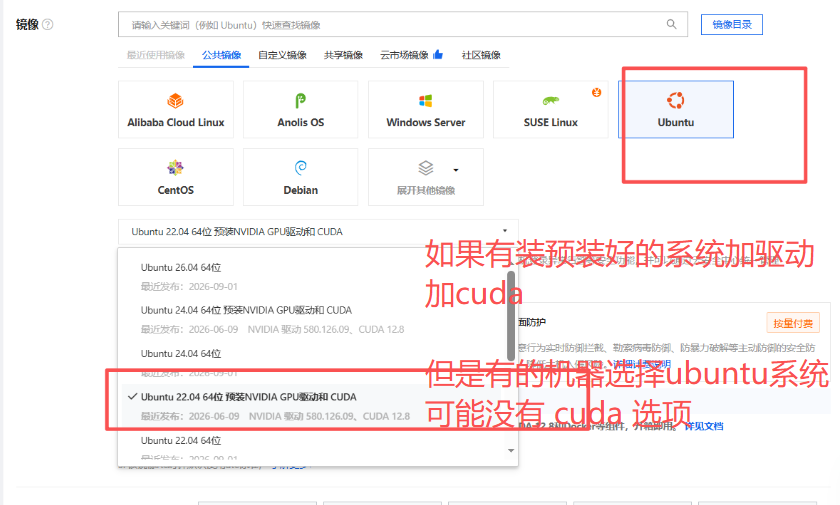
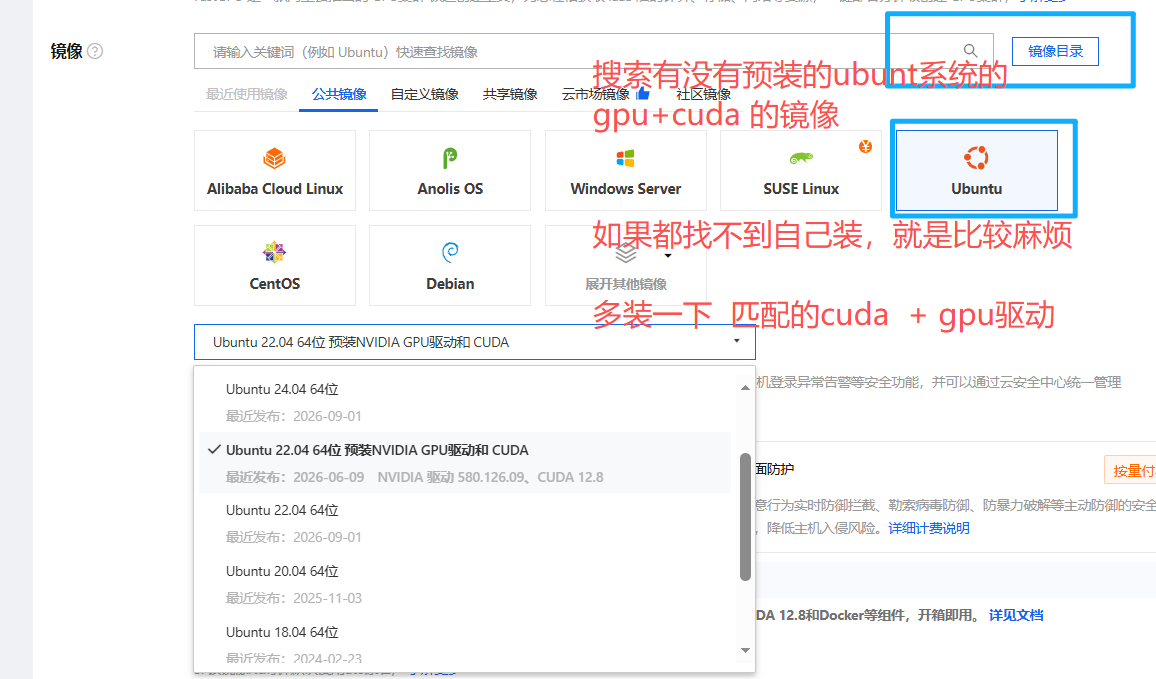
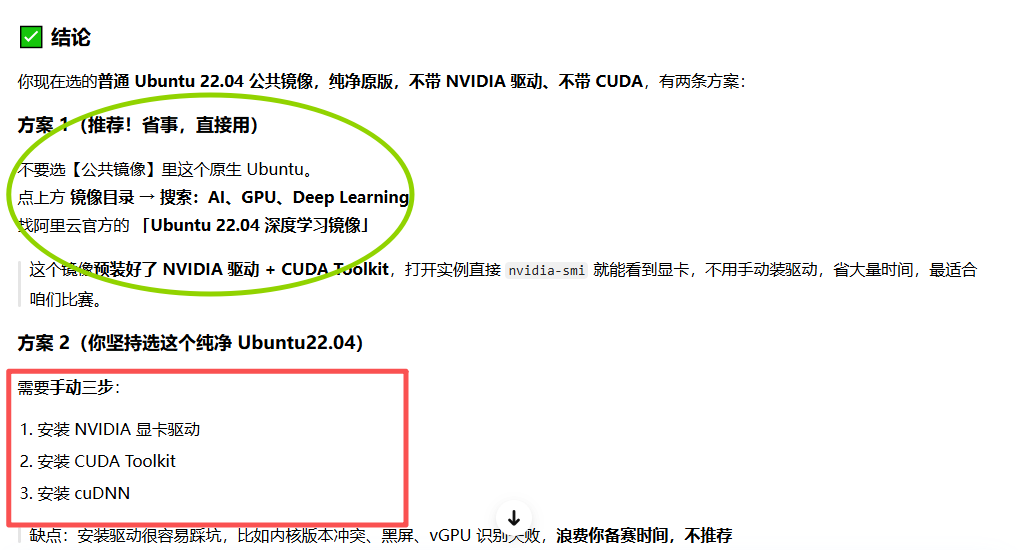
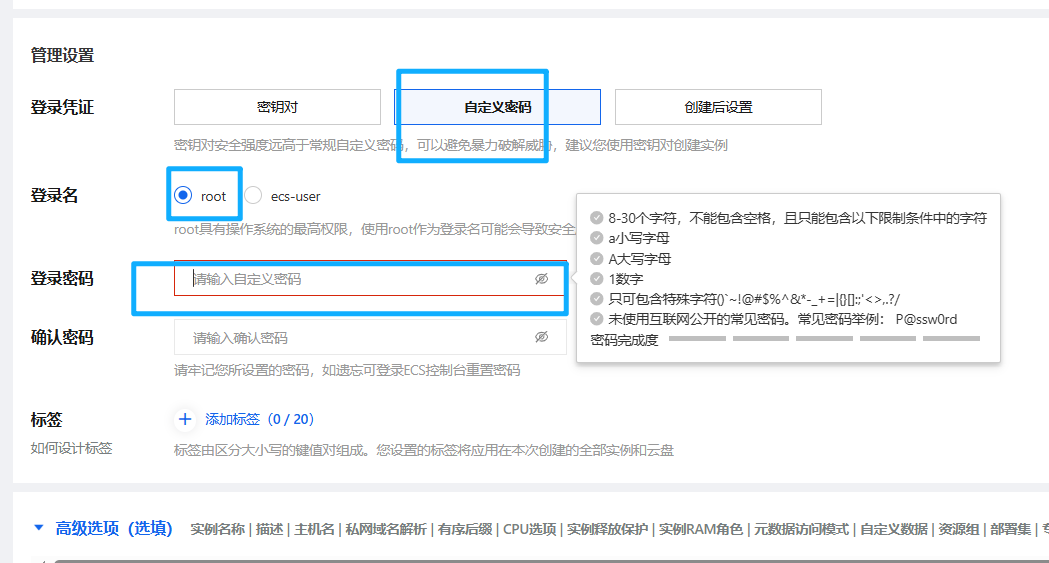
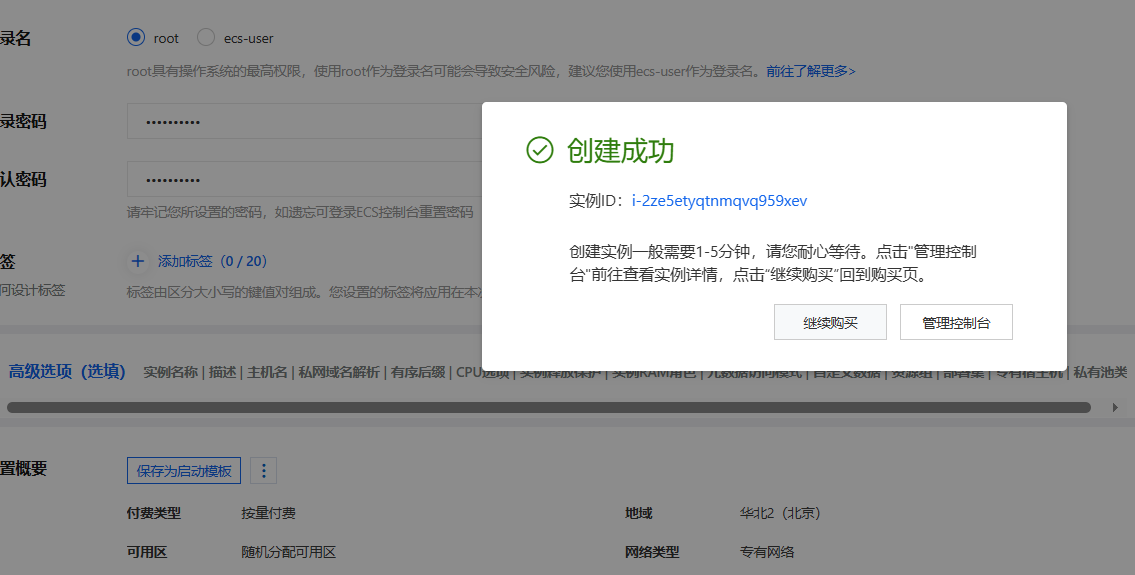
注意创建的实例要扣钱的,完全不用注销

1、ecs 是什么
ECS = Elastic Compute Service,阿里云弹性云服务器 通俗讲:就是阿里云给你开一台虚拟机电脑,你远程登录上去用。
- ecs.gn7i-c8g1.2xlarge 是这台虚拟机的规格名字
- 它里面虚拟出来:8 核 CPU、30G 内存、绑定 1 块 A10 显卡
- 本质:在阿里云物理服务器上虚拟化出来的机器,你拿到的是独立系统,可以装 python、cuda、跑模型。
2、BF16 是什么(重点,和你跑模型显存强相关)
BF16 = Brain Float 16,16 位脑浮点数 ,是一种数字存储格式,用来存大模型权重。
大模型里面所有参数,本质就是一大堆小数;不同格式,占用存储空间不一样,精度略有差别。
三种最常用格式对比
- FP32(32 位单精度) 1 个参数占 4 字节。1B 参数≈4GB 显存。
- 精度最高,显存消耗巨大,推理基本不用。
- FP16(半精度) 1 个参数占 2 字节。1B 参数≈2GB 显存。 老显卡(T4)支持。
- BF16(Brain Float16) 1 个参数也是占 2 字节,1B 参数≈2GB 显存 ✅ A10 显卡原生完美支持 BF16!
- 和 FP16 占用显存一样大;但数值范围更大,跑大模型不容易溢出、报错。
- 现在 Qwen、DeepSeek 这类新模型,推荐优先用 BF16 推理。
一句话区分: BF16 / FP16 都是 16bit,显存占用一样;BF16 更适合 LLM 大模型,A10 显卡跑模型优先开 BF16。
INT8、INT4:是整数量化,占用显存更少(1B 参数对应 1GB / 0.5GB),会轻微损失模型回答精度。
1.5B 是什么
B = Billion,十亿 1.5B = 1.5 Billion = 15 亿参数 Qwen2.5-1.5B-Instruct,意思就是:这个大模型一共有 15 亿个参数。
Qwen2.5-1.5B,BF16 加载: 1.5B × 2 字节 = 约 3GB 显存。 对比 FP32 需要 6GB(每个参数占用4个字节),直接省一半显存。
0.6B:6 亿参数(你的 Embedding 向量模型,很小)
- Qwen3.5-0_8B(主问答大模型,0.8B = 8 亿参数)
- BF16 半精度:8 亿 ×2 字节 ≈ 1.6GB 显存
- INT4 量化:仅约 0.4GB 显存 👉 比咱们之前看的 1.5B 更小!A10 的 24G 显存轻轻松松,加载飞快,推理速度更快,非常适合比赛。
- Qwen3-Embedding-0_6B(向量嵌入模型,0.6B=6 亿参数)
- BF16:约 1.2GB 显存
- INT4:0.3GB 显存
模型需要的内存 cpu 和 gpu 大小推荐
Qwen3.5-0_8B(主问答大模型,0.8B = 8 亿参数)
- BF16 半精度:8 亿 ×2 字节 ≈ 1.6GB 显存
- INT4 量化:仅约 0.4GB 显存
✅ 两个模型一起加载(BF16),总共也就2.8GB 显存
FAISS 向量检索(你比赛指定
faiss-cpu,检索全部在 CPU 内存跑,不吃显存,吃内存 + CPU)**推荐:**8 vCPU + 30G 内存,8g 显存,