大语言模型的知识来源于训练数据,存在固有的时效性限制和领域知识盲区。RAG (Retrieval-Augmented Generation, 检索增强生成) 在生成前检索外部知识,将事实信息注入模型上下文,是解决 LLM 知识边界问题的主流方案。本章覆盖 RAG 的核心原理、完整流程、关键优化策略以及在 Agent 系统中的角色。
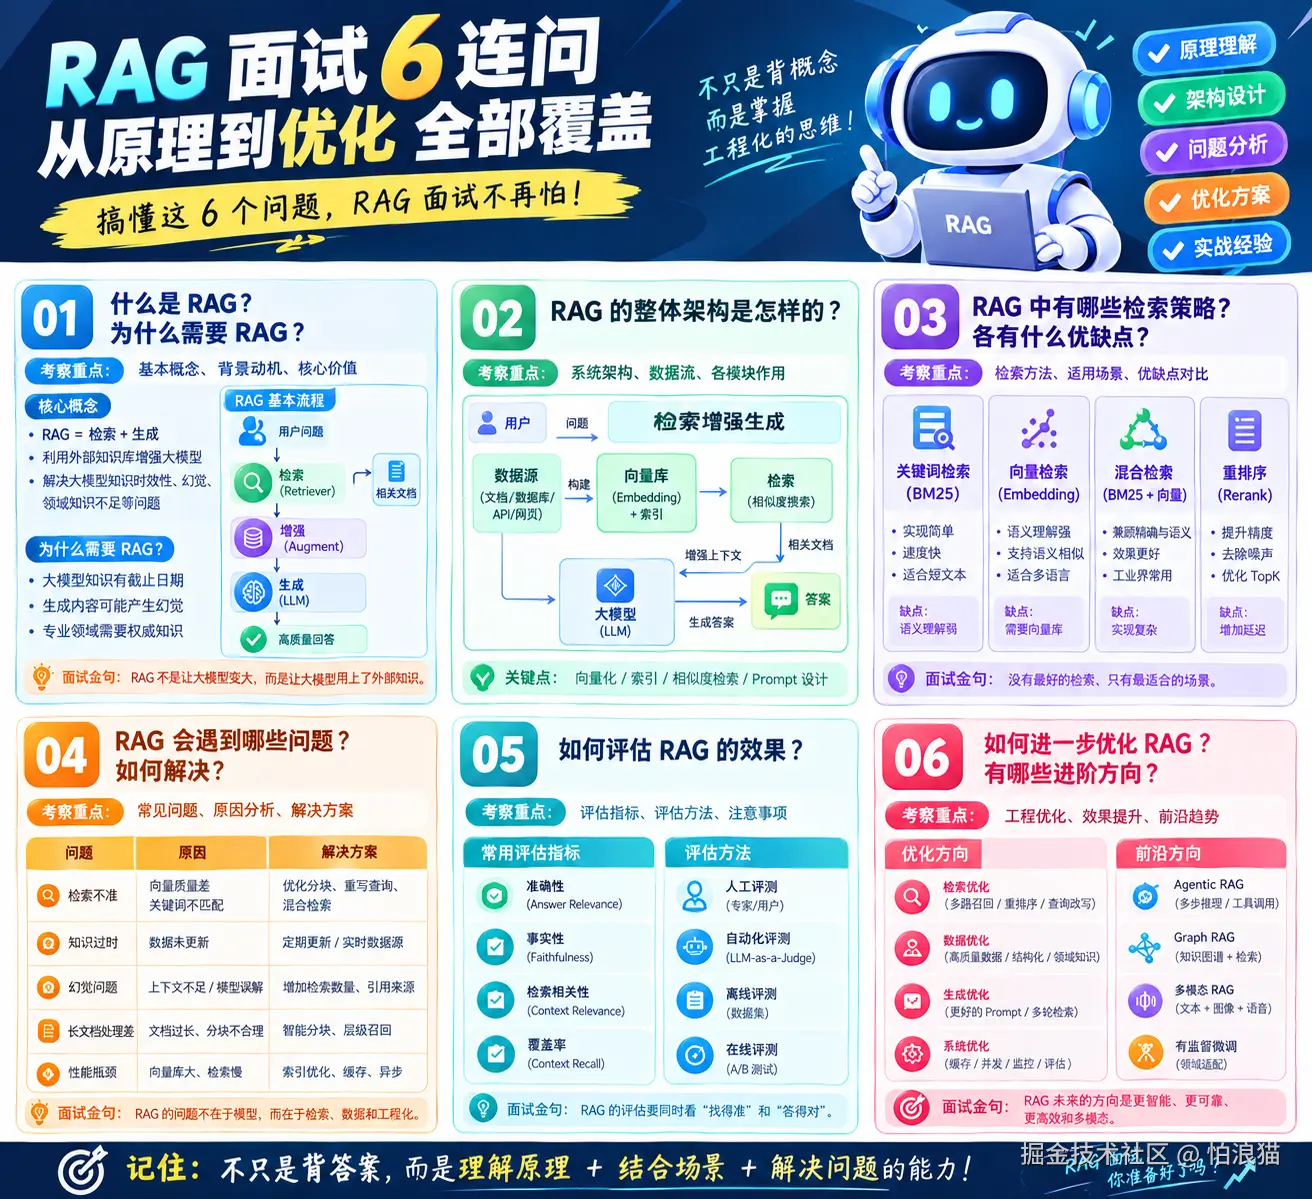
5.1 RAG 核心原理:解决 LLM 的知识边界问题
LLM 训练完成后参数固定,无法主动获取新知识。「参数化知识」有四个核心缺陷:知识时效性差(训练数据有截止日期);领域知识不足(企业私有知识、专业文献覆盖有限);事实幻觉(不确定时生成看似合理但错误的内容);缺乏可追溯性(无法说明回答的知识来源)。
RAG 的做法直截了当:生成回答前,先从外部知识库检索相关文档片段,注入 Prompt,由 LLM 基于检索结果生成回答。知识存储从模型参数转移到外部数据库,实现了动态更新和精确引用。
从信息论角度看,RAG 是一种「非参数化知识注入」机制:模型参数存储通用的语言理解和推理能力,事实知识存储在外部检索系统中。两者解耦带来明显的工程优势------知识更新只需更新数据库,多个模型可以共享同一知识库,知识来源可以审计和追溯。
与另外两种知识增强方式相比,各有取舍。Fine-tuning 将领域知识编码到模型参数中,适合学习领域风格和任务模式,但不适合频繁更新的知识。Context Stuffing 直接将所有相关知识放入 Prompt,简单但受限于上下文窗口大小。RAG 在两者之间取得平衡,既能接入大规模知识库,又保持知识的动态更新能力。
| 知识增强方式 | 知识规模 | 更新成本 | 时效性 | 可追溯性 | 适用场景 |
|---|---|---|---|---|---|
| Fine-tuning | 中等 | 高(需重训) | 差 | 无 | 领域风格适配、任务模式学习 |
| Context Stuffing | 小 | 低 | 好 | 有 | 小规模知识、快速原型 |
| RAG | 大 | 低 | 好 | 有 | 企业知识库、大规模文档问答 |
RAG 并非万能方案。任务需要深度推理而非事实检索时(如数学证明、代码生成),RAG 帮助有限。知识需要被「理解」而非「查找」时(如学习新编程语言语法),Fine-tuning 可能更有效。工程实践中,RAG 常与 Fine-tuning 结合:Fine-tuning 让模型学会如何使用检索到的知识,RAG 提供具体的知识内容。
把握一个关键区分:RAG 解决的是「模型不知道」的问题,而非「模型不会推理」的问题。前者靠检索外部知识弥补,后者需要改进推理能力。在 Agent 系统中,RAG 更像是给 Agent 配了一本随时可查的「参考手册」,而不是提升它的「思考能力」。
5.2 完整 RAG 流程:离线索引与在线查询
RAG 系统的完整生命周期分为两个阶段:离线索引构建可检索的知识库,在线查询处理用户请求并生成回答。两个阶段的设计质量共同决定 RAG 系统的整体效果。
离线索引是 RAG 的基础建设。首先是文档加载,需要处理 PDF、Word、HTML、Markdown 等多种格式。不同格式需要不同的解析器------PDF 要处理版面布局和表格结构,HTML 要去除导航栏和广告等噪声。
接下来是文档分块,将长文档切分为语义完整的片段。分块策略直接影响检索精度:块太大包含过多无关信息,稀释语义信号;块太小丢失上下文,检索到的片段无法独立理解。分块后,每个块通过 Embedding 模型编码为高维向量,连同原始文本存入向量数据库。
在线查询是 RAG 的服务路径。用户问题先经过查询理解和改写,然后通过向量检索和关键词检索的混合方式召回候选文档,再经重排序模型精排,最终将 Top-K 结果组装为上下文,交由 LLM 生成回答。
bash
离线索引阶段                          在线查询阶段
┌─────────────┐                    ┌─────────────┐
│  原始文档库  │                    │  用户查询    │
└──────┬──────┘                    └──────┬──────┘
       │                                  │
       v                                  v
┌─────────────┐                    ┌─────────────┐
│  文档解析    │                    │  查询改写    │
└──────┬──────┘                    └──────┬──────┘
       │                                  │
       v                                  v
┌─────────────┐                    ┌─────────────┐
│  文档分块    │                    │  混合检索    │
└──────┬──────┘                    │ (向量+关键词) │
       │                           └──────┬──────┘
       v                                  │
┌─────────────┐                           v
│  向量化编码  │                    ┌─────────────┐
└──────┬──────┘                    │  重排序      │
       │                           └──────┬──────┘
       v                                  │
┌─────────────┐                           v
│  向量数据库  │ <───── 向量检索 ──────┌─────────────┐
│ + 元数据存储 │                       │  上下文组装  │
└─────────────┘                       └──────┬──────┘
                                            │
                                            v
                                      ┌─────────────┐
                                      │  LLM 生成    │
                                      └──────┬──────┘
                                            │
                                            v
                                      ┌─────────────┐
                                      │  回答+来源   │
                                      └─────────────┘
以下是一个使用 LangChain 构建离线索引的代码示例:
python
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain.embeddings import OpenAIEmbeddings
from langchain.vectorstores import Chroma

# 文档加载与分块
text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=512,
    chunk_overlap=50,
    separators=["\n\n", "\n", "。", "!", "?", ",", " ", ""]
)
chunks = text_splitter.split_documents(documents)

# 向量化与存储
embeddings = OpenAIEmbeddings(model="text-embedding-3-small")
vectorstore = Chroma.from_documents(
    documents=chunks,
    embedding=embeddings,
    collection_metadata={"hnsw:space": "cosine"}
)
在线查询阶段的代码示例:
python
from langchain.retrievers import ContextualCompressionRetriever
from langchain.retrievers.document_compressors import CrossEncoderReranker
from langchain_community.cross_encoders import HuggingFaceCrossEncoder

# 混合检索:向量 + 关键词
vector_retriever = vectorstore.as_retriever(search_kwargs={"k": 50})
keyword_retriever = BM25Retriever.from_documents(chunks)
keyword_retriever.k = 50

# 重排序
reranker_model = HuggingFaceCrossEncoder(model_name="BAAI/bge-reranker-v2-m3")
compressor = CrossEncoderReranker(
    model=reranker_model,
    top_n=5
)
hybrid_retriever = EnsembleRetriever(
    retrievers=[vector_retriever, keyword_retriever],
    weights=[0.6, 0.4]
)
final_retriever = ContextualCompressionRetriever(
    base_compressor=compressor,
    base_retriever=hybrid_retriever
)

# 生成回答
docs = final_retriever.get_relevant_documents(query)
context = "\n\n".join([doc.page_content for doc in docs])
answer = llm.invoke(f"基于以下资料回答问题:\n{context}\n\n问题:{query}")
整个流程中一个容易被忽视的环节:元数据管理。每个文档块都应记录来源信息(文件名、页码、章节标题等),在后续的来源标注、权限过滤和检索优化中至关重要。企业场景中,不同部门的知识库可能需要权限隔离,通过元数据过滤可以在检索阶段实现访问控制。
另一个关键设计决策是 Embedding 模型选择。不同模型在语言支持、向量维度、检索精度上差异显著。中文场景推荐支持中英双语的模型,如 BGE (BAAI General Embedding)、M3E 或 OpenAI 的 text-embedding-3-small。模型确定后不宜频繁更换------更换 Embedding 意味着重建整个向量索引。
5.3 文档分块策略:从固定长度到语义分块
文档分块是 RAG 中最具工程挑战的环节之一,直接决定检索的召回率和精确率,进而影响生成质量。理想的分块应满足三个条件:语义完整(每个块可独立理解)、边界合理(不割裂紧密相关的信息)、大小适中(不太大稀释检索信号,不太小丢失上下文)。
最基础的策略是固定长度分块:按固定 Token 数量切分文本,实现简单,但可能在句子中间切断,破坏语义完整性,也无法适应文档结构变化。工程中通常配合滑动窗口,设置重叠区域缓解边界问题。
python
# 固定长度分块(带重叠)
from langchain.text_splitter import CharacterTextSplitter

splitter = CharacterTextSplitter(
    separator="\n\n",
    chunk_size=300,
    chunk_overlap=50,
    length_function=len
)
chunks = splitter.split_text(long_text)
按句子和段落分块是固定长度的改进版:以自然语言边界(句号、换行)作为切分点,保证语义完整。段落超过预设大小时再按句子细分。适合结构良好的文章类文档,对无结构文本效果有限。
递归字符分块(Recursive Character Text Splitter)是 LangChain 的默认策略,按分隔符优先级递归切分:先尝试最高优先级分隔符(如双换行),块仍然太大再用次优先级(如单换行、句号),直到满足大小要求。
python
# 递归字符分块
from langchain.text_splitter import RecursiveCharacterTextSplitter

splitter = RecursiveCharacterTextSplitter(
    chunk_size=512,
    chunk_overlap=50,
    separators=[
        "\n#{1,6} ",   # Markdown 标题
        "\n\n",         # 段落
        "\n",           # 行
        "。", "!", "?",  # 中文句子结束
        ".", "!", "?",   # 英文句子结束
        ",", ",", " ", ""  # 最后回退到字符
    ]
)
语义分块(Semantic Chunking)更进一层:计算相邻句子的 Embedding 相似度,相似度低于阈值时认为话题切换,在此处切分。语义连贯性更好,但需要对每个句子向量化,计算成本更高。
python
# 语义分块示例
from langchain_experimental.text_splitter import SemanticChunker
from langchain.embeddings import OpenAIEmbeddings

embeddings = OpenAIEmbeddings()
splitter = SemanticChunker(
    embeddings,
    breakpoint_threshold_type="percentile",  # 用百分位数确定阈值
    breakpoint_threshold=95,                  # 相似度差异超过95百分位时切分
)
chunks = splitter.split_text(long_text)
不同文档类型应选不同分块策略。Markdown 利用标题层级作为边界;代码以函数和类为单位;PDF 需要单独处理表格和图片------表格转结构化文本,图片描述信息(OCR 或视觉模型提取)作为独立块。
| 文档类型 | 推荐分块策略 | 推荐块大小 | 注意事项 |
|---|---|---|---|
| 文章/报告 | 递归字符分块 | 400-600 Token | 保持段落完整性 |
| Markdown | 按标题层级分块 | 300-500 Token | 保留标题路径作为元数据 |
| 代码文件 | 按函数/类分块 | 函数级别 | 保留导入语句上下文 |
| 版面感知分块 | 400-600 Token | 单独处理表格和图片 | |
| 对话记录 | 按对话轮次分块 | 单轮或多轮 | 保留时间戳和参与者信息 |
| 技术文档 | 按章节分块 | 500-800 Token | 保留章节编号和标题 |
分块大小需要平衡检索精度和上下文完整性。较小的块(128-256 Token)语义信号集中,检索精度高,但可能缺少上下文。较大的块(512-1024 Token)上下文完整,但检索信号被稀释。先在测试集上评估不同块大小,选最适合数据集的配置。
进阶技巧是「父子分块」:检索时用较小的子块保证精度,生成时将子块所属的父块(更大的上下文)注入 Prompt,兼顾检索精确性和上下文完整性。LangChain 中通过 ParentDocumentRetriever 实现。
5.4 Hybrid Search 与 Reranking:检索质量的双重保障
检索是 RAG 的核心环节,检索质量直接决定生成质量的上限。单一检索方式各有局限:纯向量检索擅长语义匹配但可能遗漏精确匹配的关键词;纯关键词检索(BM25, Best Matching 25)擅长精确匹配但无法理解语义。Hybrid Search (混合检索) 将两者结合,是工业级 RAG 的标准配置。
向量检索将查询和文档都编码为高维向量,计算相似度(通常用余弦相似度或内积)。它使用双塔模型(Bi-Encoder),查询和文档独立编码,因此可以离线预计算文档向量,在线检索时只需计算查询向量与预存向量的相似度,速度快。
向量检索的优势在于语义理解:查询「如何提高系统性能」可以检索到「优化程序运行效率」的文档,即使没有共同关键词。弱点是对精确匹配不敏感------查特定产品编号、人名、代码片段时,向量检索可能无法精确命中。
关键词检索(BM25)基于词频统计:一个词在文档中出现越多、在整个语料库中出现越少,该文档与该词的相关性越高。BM25 对精确匹配非常敏感,适合检索特定 ID、专有名词、技术术语。
Hybrid Search 的实现是并行执行两种检索,然后通过融合算法合并结果。最常用的是 RRF (Reciprocal Rank Fusion, 倒数排名融合):对每个文档,计算它在各检索结果列表中排名的倒数之和,按融合分数排序。公式简单但有效。
python
# Hybrid Search 实现
from langchain.retrievers import EnsembleRetriever, BM25Retriever

# 向量检索
vector_retriever = vectorstore.as_retriever(
    search_type="similarity",
    search_kwargs={"k": 50}
)

# 关键词检索
bm25_retriever = BM25Retriever.from_documents(chunks)
bm25_retriever.k = 50

# 混合检索(加权融合)
hybrid_retriever = EnsembleRetriever(
    retrievers=[vector_retriever, bm25_retriever],
    weights=[0.6, 0.4]  # 向量检索权重更高
)
Hybrid Search 之后通常接 Reranking (重排序) 模块。必要性在于:向量检索的双塔模型为了效率牺牲了精度------查询和文档独立编码,无法捕获深层交互特征。重排序使用 Cross-Encoder,将查询和文档拼接输入模型,更精确地评估相关性。
Cross-Encoder 的计算成本远高于 Bi-Encoder。Bi-Encoder 只需计算一次查询向量,然后与所有文档向量做点积;Cross-Encoder 需要对每个 (query, document) 对单独前向传播。因此工程中采用两阶段架构:先用 Bi-Encoder 召回 Top-50 到 Top-100 候选,再用 Cross-Encoder 精排取 Top-5 到 Top-10。
bash
检索两阶段架构:

用户查询
    │
    v
┌──────────────────┐
│ 第一阶段:召回     │
│ Hybrid Search    │──→ 50-100 候选文档
│ (Bi-Encoder+BM25)│
└──────────────────┘
    │
    v
┌──────────────────┐
│ 第二阶段:精排     │
│ Cross-Encoder    │──→ 5-10 最终文档
│ Reranker         │
└──────────────────┘
    │
    v
┌──────────────────┐
│ 上下文组装 + 生成  │
└──────────────────┘
python
# 使用 BGE Reranker 进行重排序
from langchain.retrievers.document_compressors import CrossEncoderReranker
from langchain_community.cross_encoders import HuggingFaceCrossEncoder

# 加载 Cross-Encoder 模型
reranker = HuggingFaceCrossEncoder(
    model_name="BAAI/bge-reranker-v2-m3"
)

# 构建重排序压缩器
compressor = CrossEncoderReranker(
    model=reranker,
    top_n=5  # 保留 Top-5
)

# 将重排序器与检索器组合
from langchain.retrievers import ContextualCompressionRetriever
final_retriever = ContextualCompressionRetriever(
    base_compressor=compressor,
    base_retriever=hybrid_retriever
)
常用 Reranker 模型:Cohere Rerank(商业 API,效果好但付费)、BGE-Reranker 系列(开源,支持中英文,推荐 bge-reranker-v2-m3)、cross-encoder/ms-marco-MiniLM(开源,英文为主,模型小速度快)。选择时平衡精度、延迟和成本。
一个容易被忽视的优化点是查询向量的编码方式。使用相同 Embedding 模型编码查询和文档是基本要求,进一步可以为查询添加指令前缀。例如 E5 模型中,查询编码为 "query: 如何部署应用",文档编码为 "passage: 部署文档内容...",让模型更好区分查询和文档的编码方式,提升检索精度。
另一个进阶技巧是动态调整 Hybrid Search 权重。包含特定 ID 或专有名词的查询,提高关键词检索权重;开放式语义查询,提高向量检索权重。可以通过规则判断查询类型,或用 LLM 分类后动态调整。
5.5 GraphRAG:知识图谱增强的检索范式
传统 RAG 基于文本块的向量检索,处理需要跨文档推理的问题时表现不佳。例如「公司A的CEO和公司B的CEO是否毕业于同一所大学」,传统 RAG 需要检索两个公司的CEO信息,再分别检索两人的教育背景,最后由 LLM 串联推理。任何一环检索失败都会导致答案错误。
GraphRAG (Knowledge Graph-enhanced RAG, 知识图谱增强的检索增强生成) 通过构建结构化的实体-关系图谱解决多跳推理问题。离线索引阶段,GraphRAG 不仅分块和向量化文档,还使用 LLM 或专用 NLP 模型抽取实体和关系,构建知识图谱。
知识图谱中节点代表实体(人、组织、地点等),边代表实体间的关系,每个节点和边可关联原始文本片段作为证据。检索时,GraphRAG 不仅做向量检索找相关文本块,还在图谱上做图遍历,沿实体间的关系边找到多跳关联信息。
GraphRAG 的索引构建比传统 RAG 复杂得多。实体抽取识别命名实体,关系抽取判断实体对之间的关系类型,实体消歧将指代同一实体的不同表述合并,最后用图算法(如 Leiden 算法)将紧密关联的实体聚类为社区并生成摘要。
bash
GraphRAG 索引构建流程:

文档块 ──→ 实体抽取 ──→ 关系抽取
                              │
                              v
                         实体消歧/合并
                              │
                              v
                    ┌──── 知识图谱 ────┐
                    │                  │
                    v                  v
              社区检测            向量索引(节点+边)
                    │
                    v
              社区摘要生成
在线查询阶段,GraphRAG 支持两种检索模式。局部检索:从查询中提取实体,在图谱中找到对应节点,遍历相邻节点和边获取相关子图信息,适合具体实体查询如「张三在哪个公司工作」。
全局检索:利用社区摘要回答全局性问题。将所有社区摘要汇总,让 LLM 基于摘要生成回答,适合总结性问题如「这个领域的主要技术趋势是什么」。
python
# GraphRAG 概念示例(基于 Microsoft GraphRAG 思路)
from graphrag import GraphRAG

# 索引构建
graphrag = GraphRAG(
    llm=llm,
    embedding_model=embeddings,
    entity_extraction_prompt=ENTITY_EXTRACTION_TEMPLATE,
    community_detection_algorithm="leiden"
)

# 从文档构建知识图谱
graphrag.index(documents)

# 查询:支持局部检索和全局检索
local_result = graphrag.query(
    "张三和李四的关系是什么",
    mode="local"   # 局部图遍历
)
global_result = graphrag.query(
    "这个文档集的主要主题有哪些",
    mode="global"  # 全局社区摘要
)| 维度 | 传统 RAG | GraphRAG |
|---|---|---|
| 知识结构 | 扁平的文本块向量 | 结构化的实体-关系图 |
| 检索方式 | 语义相似度匹配 | 图遍历 + 语义检索 |
| 多跳推理 | 弱(依赖 LLM 串联) | 强(沿图谱边遍历) |
| 全局视角 | 缺失 | 支持(社区摘要) |
| 构建成本 | 低 | 高(需实体抽取和关系建模) |
| 查询延迟 | 低 | 中等 |
| 适用场景 | 事实查询、段落检索 | 关系推理、全局总结 |
GraphRAG 的主要瓶颈在构建成本。实体抽取和关系建模需要大量 LLM 推理,大规模文档库的索引成本可能比传统 RAG 高一个数量级。因此 GraphRAG 通常用于对推理深度要求较高的场景,而非所有 RAG 应用的默认选择。
工程中更务实的是混合架构:对核心知识构建知识图谱用于深度推理,对全量文档保持传统向量索引用于广度检索。查询时根据问题类型选路径------实体关系类走图谱检索,事实查询类走向量检索,在成本和效果之间取得平衡。
另一个值得关注的方向是 LightRAG,它简化了 GraphRAG 的索引流程,通过轻量级实体抽取和双层检索(实体级和文档级)降低构建成本,同时保留图结构的推理优势。资源有限的团队值得评估。
5.6 查询改写与多轮对话 RAG
用户提问时往往不会给出一个完美的检索查询。问题可能包含指代词(「他的公司」)、过于简短(「价格呢」)、包含多个子问题、或使用与文档库不一致的术语。查询改写 (Query Rewriting) 的目标是将原始问题转化为更适合检索的查询,提升召回率和精确率。
查询改写有多种策略,针对不同的问题类型。
指代消解是最基础的策略,用于多轮对话。用户说「他的公司在哪里」时,「他」指代前文提到的人物,通过 LLM 将指代词替换为具体实体,生成独立查询:「张三的公司在哪里」。
查询扩展将一个问题拆分为多个子问题分别检索。例如「比较 React 和 Vue 的性能」拆分为「React 的性能特点」和「Vue 的性能特点」,分别检索后合并结果,适合对比类和综合类问题。
HyDE (Hypothetical Document Embeddings, 假设文档嵌入) 是一种巧妙的改写策略。核心洞察:与查询语义相似的文档,和与查询假设答案语义相似的文档,往往不是同一批文档。HyDE 先让 LLM 生成假设性回答,再用假设回答(而非原始查询)做向量检索。假设回答在文本风格和内容上更接近目标文档,检索效果往往更好。
python
# HyDE 实现
from langchain.retrievers import HypotheticalDocumentEmbedder

hyde_retriever = HypotheticalDocumentEmbedder.from_llm(
    llm=llm,
    base_embeddings=embeddings,
    prompt_template="请回答以下问题:\n{question}\n\n回答:"
)

# HyDE 内部流程:
# 1. LLM 生成假设回答
# 2. 对假设回答做向量化
# 3. 用假设回答的向量检索文档
docs = hyde_retriever.get_relevant_documents("什么是 RAG?")
多查询生成 (Multi-Query Generation) 让 LLM 从不同角度生成多个查询,分别检索后合并去重,通过增加查询多样性提升召回率,适合模糊查询或宽泛主题的检索。
python
# 多查询生成
from langchain.retrievers import MultiQueryRetriever

multi_query_retriever = MultiQueryRetriever.from_llm(
    retriever=vectorstore.as_retriever(),
    llm=llm,
    include_original=True  # 包含原始查询
)
# LLM 会生成如:
# 原始查询:"RAG 评估方法"
# 改写1:"RAG 系统的评估指标有哪些"
# 改写2:"如何衡量 RAG 的检索质量"
# 改写3:"RAG 生成质量的评估框架"
多轮对话 RAG 的核心挑战是上下文依赖。用户在后续问题中经常省略前文信息或使用指代词,直接用原始问题做检索效果很差。标准做法是「对话压缩与查询改写」:将对话历史和当前问题输入 LLM,生成包含完整上下文的独立查询。
python
# 多轮对话查询改写
from langchain.chains import create_history_aware_retriever
from langchain_core.prompts import ChatPromptTemplate

condense_prompt = ChatPromptTemplate.from_messages([
    ("system", "基于对话历史,将用户最后的问题改写为独立的检索查询。"
               "不要回答问题,只改写。"),
    ("human", "对话历史:{chat_history}\n\n当前问题:{input}")
])

history_aware_retriever = create_history_aware_retriever(
    llm=llm,
    retriever=final_retriever,
    prompt=condense_prompt
)
除了查询改写,多轮对话 RAG 还需要考虑对话级的状态管理。进阶方案是维护「对话知识状态」:每轮对话后提取已建立的事实和待确认的信息,作为后续检索的补充上下文,类似于人类在多轮讨论中逐步积累共识。
工程经验:查询改写的质量取决于 LLM 能力和改写 Prompt 设计。改写 Prompt 应明确指示 LLM 不要尝试回答问题,只专注生成好的检索查询。同时保留原始查询作为兜底------改写查询的检索结果不理想时,回退到原始查询。
5.7 RAG 系统评估:从检索质量到生成质量
RAG 评估是一个多维度的工程问题。与纯生成模型不同,RAG 的输出质量同时取决于检索质量和生成质量,需要分别评估和联合评估。业界较成熟的评估框架有 RAGAS (RAG Assessment, RAG 评估框架) 和 TruLens。
RAG 评估分为三个维度:检索质量、生成质量和端到端效果。
检索质量评估关注系统能否找到正确的文档。核心指标包括 Recall@K(Top-K 结果中包含相关文档的比例)、Precision@K(Top-K 中相关文档的占比)、MRR (Mean Reciprocal Rank, 平均倒数排名)。Recall@K 是最关键的指标------检索阶段就遗漏了正确文档,生成阶段无法弥补。
生成质量评估关注 LLM 是否正确使用了检索到的信息。核心指标:Faithfulness (忠实度,回答中的陈述是否都能从检索上下文找到支持,用于检测幻觉)、Answer Relevance (回答相关性,回答是否真正回应了用户问题)、Context Relevance (上下文相关性,检索到的上下文是否与问题相关)。
端到端评估关注最终用户体验。核心指标:Answer Correctness (回答正确性,回答是否事实正确)、Citation Accuracy (引用准确性,标注的来源是否正确指向支持文档)。通常需要人工标注的 ground truth 作为参照。
| 评估维度 | 指标 | 含义 | 评估方法 |
|---|---|---|---|
| 检索质量 | Recall@K | Top-K 中相关文档的召回率 | 人工标注相关文档 |
| 检索质量 | Precision@K | Top-K 中相关文档的精确率 | 人工标注相关文档 |
| 检索质量 | MRR | 相关文档的排名倒数均值 | 人工标注相关文档 |
| 生成质量 | Faithfulness | 回答是否忠实于检索内容 | LLM 辅助评估 |
| 生成质量 | Answer Relevance | 回答与问题的相关性 | LLM 辅助评估 |
| 生成质量 | Context Relevance | 上下文与问题的相关性 | LLM 辅助评估 |
| 端到端 | Answer Correctness | 回答是否正确 | 人工评估或 LLM 辅助 |
| 端到端 | Citation Accuracy | 引用来源是否准确 | 人工评估 |
python
# 使用 RAGAS 评估 RAG 系统
from ragas import evaluate
from ragas.metrics import (
    faithfulness,
    answer_relevancy,
    context_precision,
    context_recall,
)
from datasets import Dataset

# 准备评估数据
eval_data = {
    "question": ["什么是RAG?", "GraphRAG有什么优势?"],
    "answer": ["RAG是检索增强生成技术...", "GraphRAG支持多跳推理..."],
    "contexts": [["RAG通过检索外部知识..."], ["GraphRAG构建知识图谱..."]],
    "ground_truth": ["RAG结合检索和生成...", "GraphRAG通过图遍历支持多跳推理..."]
}
dataset = Dataset.from_dict(eval_data)

# 执行评估
results = evaluate(
    dataset,
    metrics=[
        context_precision,    # 上下文精确率
        context_recall,       # 上下文召回率
        faithfulness,         # 忠实度
        answer_relevancy,     # 回答相关性
    ]
)
print(results)
# 输出示例:
# {'context_precision': 0.85, 'context_recall': 0.92,
#  'faithfulness': 0.88, 'answer_relevancy': 0.91}
Faithfulness 指标的评估方法值得深入理解。它将回答拆分为一系列原子陈述(atomic statements),逐一检查每个陈述是否能在检索上下文中找到支持。例如「RAG 由 Facebook 在 2020 年提出」会被拆分为「RAG 是一种技术」「RAG 由 Facebook 提出」「RAG 在 2020 年提出」三个陈述,分别验证。能有效检测部分幻觉------回答中大部分正确但混入少量编造信息的情况。
构建高质量评估数据集是 RAG 评估的关键挑战。人工标注成本高,难以大规模进行。实用方案是「LLM 生成 + 人工审核」:用 LLM 从文档中生成问答对,人工审核质量后作为评估数据。可以快速生成大量样本,但 LLM 生成的问答对可能偏向简单问题,覆盖面有限。
分层评估是定位问题的最佳实践:先评估检索质量,确保检索阶段没问题;再评估生成质量,验证 LLM 正确使用了检索结果;最后做端到端评估。检索质量好但端到端效果差,说明问题出在生成阶段------可能是 Prompt 设计不当或 LLM 能力不足。
持续监控也是生产级 RAG 系统的必要环节。记录每个查询的检索结果、生成回答和用户反馈(如点赞/点踩),持续追踪系统性能,发现退化趋势。LangSmith、Phoenix 等工具提供 RAG 可观测性方案,支持查询级别的 trace 分析和聚合指标监控。
5.8 RAG 在 Agent 中的角色:知识工具与记忆增强
在 Agent 系统中,RAG 的角色从「独立的问答系统」转变为「Agent 可调用的知识工具」。Agent 在规划阶段主动决定何时检索知识、检索什么内容、如何使用检索结果。RAG 成为 Agent 感知世界的重要通道之一。
Agent 调用 RAG 的典型场景:回答事实性问题前检索相关知识确保准确性;执行复杂任务时检索操作手册或 API 文档;需要引用权威来源时检索知识库获取支撑材料;遇到领域特定问题时检索企业内部知识库。
将 RAG 作为 Agent 工具实现,需要定义清晰的工具接口。工具接收查询字符串,返回检索到的文档片段,Agent 通过 function calling 机制决定何时调用。
python
# 将 RAG 定义为 Agent 工具
from langchain.tools import Tool

def knowledge_search(query: str) -> str:
    """检索企业知识库,返回相关知识片段。

    Args:
        query: 检索查询,应该是一个清晰的问题或关键词。

    Returns:
        检索到的知识片段,包含来源信息。
    """
    docs = final_retriever.get_relevant_documents(query)
    results = []
    for i, doc in enumerate(docs, 1):
        source = doc.metadata.get("source", "未知来源")
        results.append(f"[{i}] 来源: {source}\n{doc.page_content}")
    return "\n\n".join(results)

knowledge_tool = Tool(
    name="knowledge_search",
    description="当需要查找企业内部知识、产品文档、技术规范时使用此工具。",
    func=knowledge_search
)

# 将工具注册到 Agent
agent = create_react_agent(
    llm=llm,
    tools=[knowledge_tool, search_tool, calculator_tool],
    prompt=agent_prompt
)
RAG 与 Agent 记忆系统的关系是一个重要的设计话题。Agent 的记忆系统通常分为短期记忆(当前对话上下文窗口)和长期记忆(跨会话的持久化存储)。RAG 在其中扮演「外部知识」角色------提供客观事实和领域知识,而非 Agent 的个人经历。
更高级的设计是将 Agent 的记忆本身也用 RAG 方式存储和检索。交互历史(对话记录、执行的操作、用户反馈)被分块、向量化存入向量数据库,需要时通过检索调用。Agent 可以回忆起数天甚至数周前的交互细节,突破上下文窗口限制。
python
# Agent 记忆的 RAG 化存储
class AgentMemoryStore:
    def __init__(self, vectorstore, llm):
        self.vectorstore = vectorstore
        self.llm = llm

    def store_interaction(self, user_input, agent_response, context):
        """存储一次交互到记忆库"""
        memory_text = (
            f"用户: {user_input}\n"
            f"Agent: {agent_response}\n"
            f"时间: {context.get('timestamp', '')}\n"
            f"会话: {context.get('session_id', '')}"
        )
        self.vectorstore.add_texts(
            texts=[memory_text],
            metadatas=[context]
        )

    def recall(self, query, k=5):
        """从记忆库中检索相关历史交互"""
        docs = self.vectorstore.similarity_search(query, k=k)
        return [doc.page_content for doc in docs]
在这种设计中,Agent 拥有两种检索通道:知识检索(RAG 工具,检索外部知识库)和记忆检索(检索自身交互历史)。两者协同工作------知识检索提供事实信息,记忆检索提供上下文和偏好。例如用户说「像上次那样帮我生成报告」时,Agent 先检索记忆找到「上次」的交互记录,再检索知识库获取报告模板和规范。
Agent 场景下的 RAG 还有一个特殊需求:主动检索。传统 RAG 是被动触发的------用户提问后检索。Agent 可以在任务执行过程中主动判断是否需要检索,例如编写代码时遇到不熟悉的 API,主动暂停当前任务,调用知识检索查找 API 文档,然后继续编码。
实现主动检索的关键是让 Agent 具备「知识边界感知」能力------知道自己不知道什么。可以通过系统 Prompt 设置规则:遇到不确定的事实性问题先检索再回答;操作特定领域工具时先查阅文档;用户引用了之前的交互时先检索记忆。更高级的方案是让 Agent 自我评估对某个问题的确信度,低于阈值时触发检索。
一个值得关注的架构模式是「RAG-as-Tool」与「Always-RAG」的结合。核心领域知识设置为「Always-RAG」------每次回答自动检索,不需要 Agent 决定。辅助性知识设置为「RAG-as-Tool」------Agent 根据需要决定是否检索。分层设计在保证核心知识准确性的同时,减少不必要的检索开销。
本章知识点总结
| 知识点 | 核心内容 | 关键细节 |
|---|---|---|
| RAG 核心原理 | 检索外部知识注入 Prompt 后生成 | 解决知识时效性、幻觉、领域不足、不可追溯问题 |
| 离线索引 | 文档加载-解析-分块-向量化-存储 | 元数据管理不可忽视,Embedding 模型不宜频繁更换 |
| 在线查询 | 查询改写-混合检索-重排序-生成 | 两阶段架构:先召回再精排 |
| 固定长度分块 | 按 Token 数切分,配合滑动窗口 | 简单但可能切断语义,需重叠区域缓解 |
| 递归字符分块 | 按分隔符优先级递归切分 | 适合结构化文档,LangChain 默认策略 |
| 语义分块 | 按语义相似度切分 | 计算成本高但语义保持好 |
| 父子分块 | 小块检索,大块生成 | 兼顾检索精度和上下文完整性 |
| Hybrid Search | 向量检索 + 关键词检索融合 | RRF 融合算法,权重可动态调整 |
| Reranking | Cross-Encoder 精排 | Bi-Encoder 召回后精排,两阶段架构 |
| GraphRAG | 知识图谱增强的检索 | 支持多跳推理和全局视角,构建成本高 |
| 查询改写 | 指代消解、查询扩展、HyDE、多查询 | 多轮对话必须做查询改写 |
| HyDE | 生成假设文档做检索 | 假设答案比原始查询更接近目标文档 |
| 多轮对话 RAG | 对话压缩为独立查询后检索 | 维护对话级知识状态可进一步提升效果 |
| 检索质量评估 | Recall@K, Precision@K, MRR | Recall@K 是最关键指标 |
| 生成质量评估 | Faithfulness, Answer Relevance | Faithfulness 通过原子陈述逐条验证 |
| RAGAS 评估框架 | 自动化 RAG 评估工具 | 支持 LLM 辅助评估,需评估数据集 |
| RAG as Agent Tool | RAG 作为 Agent 可调用工具 | Agent 主动决定何时检索 |
| 记忆 RAG 化 | Agent 交互历史向量化存储 | 突破上下文窗口限制,支持跨会话记忆 |
| 主动检索 | Agent 自主判断是否需要检索 | 需要知识边界感知能力 |
| 分层 RAG 架构 | Always-RAG + RAG-as-Tool | 核心知识自动检索,辅助知识按需检索 |