一、从一次事故说起
图形验证码故障复盘时,我反复提到一句话:"Tomcat 的 200 个工作线程被占满了"。可能有同学会有疑问:这 200 是哪来的?是所有服务器共享的吗?我们这套系统到底能扛多少并发、多少 QPS?
本文把这条线一次讲透:先弄懂 Tomcat 线程池是什么,再算出我们 6 服务 × 4 实例的系统的理论并发和 QPS 上限,最后看 Redis 缓存能把天花板抬高多少。
二、Tomcat 线程默认多大
Spring Boot 内置的 Tomcat 有一套默认配置,四个数字要分清:
| 配置项 | 默认值 | 干什么的 |
|---|---|---|
server.tomcat.threads.max |
200 | 工作线程上限,决定"同时处理中"的请求数 |
server.tomcat.threads.min-spare |
10 | 启动时预创建的空闲线程,忙起来再逐步加到 200 |
server.tomcat.max-connections |
8192 | 最多能同时保持的 TCP 连接数(挂着的连接,不是处理的请求) |
server.tomcat.accept-count |
100 | 线程用光后,请求排队的长度上限 |
类比成饭店前台就很好记:min-spare=10 是开张时先站 10 个接待员;max=200 是店里最多养 200 个接待员;8192 是门口最多能站 8192 个客人;100 是店内最多允许 100 个人排号等着。修改方式是在 application.yml 里配 server.tomcat.threads.max: 500。
(1)那server.tomcat.threads.max 工作线程有上限吗?
先说结论:代码层没有硬编码上限,但现实世界有一串天花板------真正限制你的是内存和操作系统,不是 Tomcat 配置本身。
(2)配置层的"上限"
server.tomcat.threads.max 在 Spring Boot 里绑定到 int 类型,对应 Tomcat 的 maxThreads。Tomcat 源码里默认值 200、最小值 1,往上没有硬校验------理论上你可以配到 2147483647,Spring Boot 也会接受。
但这个数字没有任何意义,因为在配到几万之前,现实已经把你拦住了。
(3)现实层的四个天花板
| 天花板 | 具体限制 | 数量级 |
|---|---|---|
| 线程栈内存 | 每个 Java 线程默认占 1MB 栈内存(-Xss 可调),是堆之外的 native 内存 |
默认堆 4G 的机器,线程到几千个就可能 OOM |
| 操作系统线程数限制 | Linux 的 ulimit -u(max user processes),常见默认 1024~4096 |
一个 JVM 的线程数超不过这个 |
| maxConnections 关联 | NIO 模式下连接上限是 max-connections(默认 8192),线程再多也服务不了更多连接 |
8192 是连接数天花板 |
| 性能拐点 | 线程数超过 CPU 核数几倍后,吞吐不升反降(上下文切换、GC 压力) | 几十核的机器,几千线程就是拐点 |
最典型的翻车方式是 OutOfMemoryError: unable to create native thread------不是堆满了,是线程栈把 native 内存吃光了,堆监控完全看不出来。
(4)更重要的一个认知:调大 ≠ 变强
Tomcat 默认 200 线程,对绝大多数 REST 场景是够的,甚至偏多。原因:
-
NIO 模式下,真正决定连接能力的是 maxConnections(8192),线程只是"处理连接上活跃请求"的工人。你把线程调到 5000,但 maxConnections 还是 8192,多出来的线程闲着,还白白吃内存、增加切换开销。
-
线程数的意义是"并行等 I/O" 。如果请求大多在等数据库、等 Redis(I/O 密集型),加线程能提升一点并发;如果请求是纯计算(CPU 密集型),加线程纯属负优化。业界经验公式:
线程数 ≈ CPU 核数 × (1 + 等待时间/计算时间),按这个算,很多服务 50~100 线程就够。
(5)什么时候才需要调大
就两种情况,且都要先排除别的因素:
-
慢客户端/长轮询/流式响应:一个连接长时间占着线程,200 不够用;
-
大量阻塞式调用 (同步等第三方、等锁):线程在干等,需要更多线程来摊。但这其实是"代码该改异步"的信号------治本,而不是靠调大
maxThreads兜底。
对应我们之前聊的验证码事故:那次的教训反过来也成立------200 线程被阻塞式 tryAcquire 占满是"代码问题放大线程问题",解法是改非阻塞,而不是把线程调到 500。调大线程只是延迟爆雷,阻塞没消除,500 个线程一样会被占满。
三、是一台服务器默认的线程吗
不是。200 是一个 JVM 进程的线程,不是物理服务器的。
TypeScript
┌───────────────────────────────────────────────┐
│                物理服务器(一台机器)             │
│                                               │
│  ┌──────────────┐   ┌──────────────┐          │
│  │   实例 A     │   │   实例 B     │    ...    │
│  │  (JVM 进程)  │   │  (JVM 进程)  │           │
│  │              │   │              │           │
│  │ Tomcat 200   │   │ Tomcat 200   │           │
│  │ HikariCP 50  │   │ HikariCP 50  │           │
│  └──────────────┘   └──────────────┘          │
└───────────────────────────────────────────────┘
一栋楼(物理服务器)里有 N 家公司(实例),各公司有自己独立的前台团队(Tomcat 线程池),互不共享。实例 A 忙到 200 个线程全占满,实例 B 线程全闲着,也帮不了 A------除非负载均衡把请求匀过去。
部署 3 个实例就有 3 个 200,总共最多 600。这个"200"是进程维度的,和操作系统线程、和物理机核数都没有直接关系。
四、Tomcat 线程和"线程池"是什么关系
Tomcat 本身就是个线程池 ,内部叫 StandardThreadExecutor,管理的就是那 200 个线程。所以"Tomcat 线程"不是和"线程池"并列的两个东西,而是"一个池子里的工人"。
真正容易混淆的是另一个池子:业务线程池 ,代码里自己 new 的 ThreadPoolExecutor,比如 Executors.newFixedThreadPool(10)。两个池子分工不同:
TypeScript
请求进来 → Tomcat 线程池(前台接待员)
                │
                │  处理到慢环节(发短信、调三方接口、算报表)
                │  把任务丢给后厨
                ▼
业务线程池(后厨厨师,如 10 个线程)关键坑在丢出去的姿势:只有"丢进去不等结果"(异步,不调 future.get())Tomcat 接待员才真正抽身去接下一个请求;如果是同步等后厨做完再走,接待员照样被占着。
验证码事故就是这个坑的教科书案例:tryAcquire(3, TimeUnit.SECONDS) 让 200 个接待员原地干等 3 秒,前台人手占满,整个饭店(同进程所有接口)都转不动。
五、谁是并发上限
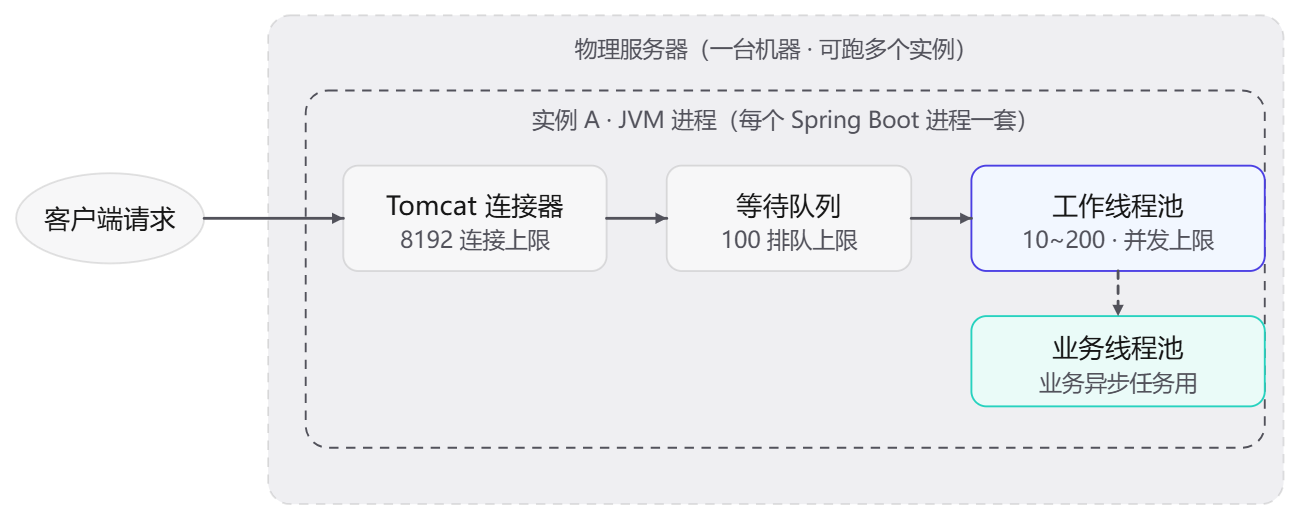
把请求从进来到处理完画成一条链路:
TypeScript
    客户端请求
        │
        ▼
  ┌──────────────────┐
  │ Tomcat 连接器      │  最多挂 8192 个连接
  └──────────────────┘
        │
        ▼
  ┌──────────────────┐
  │   等待队列         │  最多排 100 个
  └──────────────────┘
        │
        ▼
  ┌──────────────────┐
  │   工作线程池       │  默认最多 200 个同时处理  ← 并发上限在这
  └──────────────────┘
        │  处理中调用
        ▼
  ┌──────────────────┐
  │   业务线程池       │  请求内部的异步任务(如 10 个线程)
  └──────────────────┘
8192 个连接可以挂着,但只有 200 个能同时"真正处理";多出来的最多 100 个排队;再多的直接拒绝或超时。
结论一句话:请求级并发上限 = Tomcat 工作线程数(默认 200) 。业务线程池是嵌套在请求内部的第二层并发,它决定"单个请求里异步任务能并行跑多少",不决定系统能同时接多少请求。
六、系统级,假如:6 服务 × 4 实例的各层并发上限
实例总数 = 6 × 4 = 24 个,各层上限一起算:
| 层 | 计算 | 并发上限 |
|---|---|---|
| Tomcat 请求线程 | 24 × 200 | 4800 |
| 数据库操作并发 | 24 × 50(HikariCP 单实例池) | 1200 |
| MySQL 连接 | 配置上限 | 4190 |
注意:MySQL 的 4190 > 1200,数据库端不是瓶颈,这个配置是合理的。真正的瓶颈是 HikariCP 总和 1200------它决定了"同一时刻最多只有 1200 个请求在真正执行 SQL"。
七、并发和 QPS 的换算(Little's Law)
并发是"同时处理中的请求数",QPS 是"每秒完成的请求数",两者靠响应时间换算:
TypeScript
QPS = 并发数 ÷ 平均响应时间直观例子:1 个线程处理 1 个请求要 100ms,那它每秒最多完成 10 个,就是 10 QPS。200 个线程、每个请求 100ms,单实例就是 2000 QPS。
反过来看这张表,体会"响应时间决定天花板":
| 单请求平均耗时 | 单实例 200 线程的理论 QPS |
|---|---|
| 10ms | 20000 |
| 100ms | 2000 |
| 500ms | 400 |
所以并发上限 200 不等于 QPS 上限 200。响应越快,同样线程数能完成的 QPS 越高 ------这也是为什么优化慢 SQL、加缓存的收益是乘法级的。
八、场景 A:全走 MySQL(不缓存)
每个请求都要拿一个 HikariCP 连接,所以并发上限被卡死在 1200:
| 平均响应时间 | 理论 QPS |
|---|---|
| 300ms(慢 SQL、大查询) | 1200 ÷ 0.3 ≈ 4000 |
| 100ms(常见 OLTP) | 1200 ÷ 0.1 ≈ 12000 |
| 50ms(轻查询) | 1200 ÷ 0.05 ≈ 24000 |
全走 DB 时,理论天花板大约每秒 1 万左右(按 100ms 基准)。Tomcat 的 4800 在这里用不满------1200 先到顶。
九、场景 B:走 Redis 缓存
走缓存时请求不再占用 DB 连接,瓶颈从"1200 个 DB 连接"抬回到"4800 个 Tomcat 线程",响应时间也从 100ms 级降到 1~5ms 级。两个因素同时变好,QPS 是乘法级提升:
| 场景 | 并发上限 | 单请求耗时 | 理论 QPS |
|---|---|---|---|
| 全走 MySQL | 1200(HikariCP) | 100ms | ≈ 1 万 |
| 走 Redis 缓存 | 4800(Tomcat) | 5ms | 数万 ~ 十万级 |
但这里要泼三盆冷水,新瓶颈会转移:
-
Redis 单点是新的咽喉。24 个实例全打同一个 Redis,单实例 Redis 的实用上限大约 5~10 万次操作/秒,会先于 Tomcat 到顶。要再上就得 Redis 集群分片。
-
理论值只是天花板。真实压测到几万 QPS 时,先撞上的往往是 GC 停顿、日志磁盘 IO、网络带宽、锁竞争这些"看不见的墙"。典型现象:理论算出来 5 万,压测到 8000 就被 GC 卡住。
-
缓存命中率决定一切 。上面的数字默认"全命中"。一旦穿透(缓存雪崩、热点 key 失效),请求打回 MySQL,上限立刻跌回场景 A 的 1200 并发。所以高并发系统真正要盯的是命中率和穿透防护(空值缓存、布隆过滤器),而不是纯算 QPS。
注意,使用redis性能优化时避坑 :接口性能优化:Redis 缓存序列化踩坑记录:@Cacheable 撞上 Stream.toList()
十、结论
| 场景 | 瓶颈 | 理论 QPS(100ms 基准) |
|---|---|---|
| 全走 MySQL | HikariCP 1200 连接 | ≈ 1 万 |
| 走 Redis 缓存 | Redis 单点 5~10 万次/s | 数万级,实际靠压测 |
三个要点:
-
请求并发上限看 Tomcat 的 200(单实例),QPS = 并发 ÷ 响应时间,响应时间才是真正的杠杆;
-
全走 DB 时系统卡在 HikariCP 的 1200,理论约 1 万 QPS,MySQL 4190 不是瓶颈不用动;
-
走缓存能上一个大台阶,但新瓶颈在 Redis 单点和应用自身资源,最终数字别信理论,上线前用 JMeter 或 hey 压一轮,把"平均响应时间"换成压测实测值再定容量。
最后提醒一个配置陷阱:HikariCP 单实例 50、24 实例共 1200,离 mysql最大连接数4190 很远没问题;但如果哪个服务单独调大到 200,服务实例增加,全系统总和会逼近甚至超过 4190,MySQL 开始报 Too many connections。4190 是全系统共享的预算,不是每个服务独立的额度。