YOLO26最新创新改进系列:融合 E3AD 认知注意力 Neck:具身认知增强的 FPN/PAN 特征选择机制,高效创新!
截止目前,YOLO26最新创新改进系列已更新100+种,排列组合后可达到上万种创新模型!极大节省科研时间!!! 仍在持续更新中...
畅享持续更新且可大幅度提升文章档次的纯干货工具!
前言:为什么这类改进值得写进论文
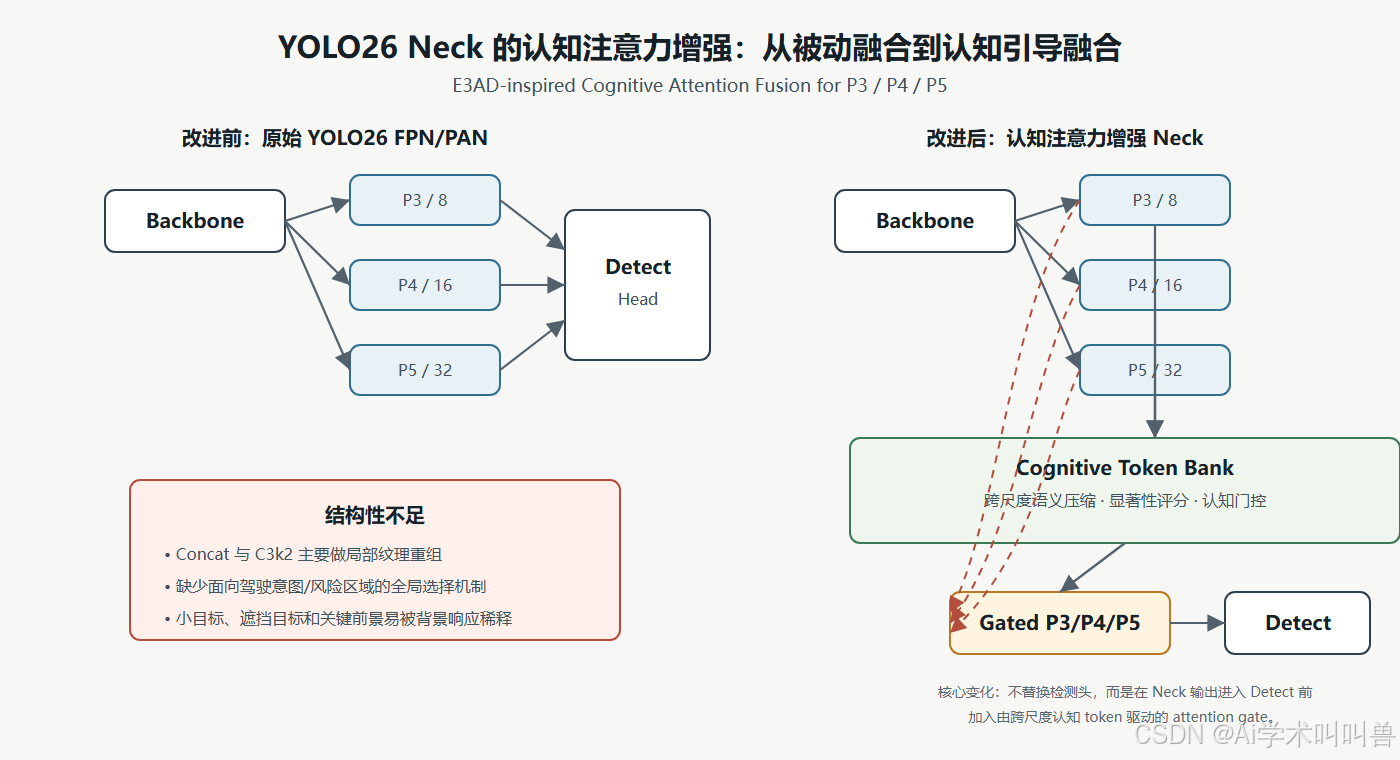
原始 YOLO26 的 FPN/PAN Neck 依靠上采样、下采样、Concat 与 C3k2 完成多尺度融合。这种结构高效、稳定,但它的融合本质仍然是"局部卷积驱动的特征重组":P3、P4、P5 被拼接后统一卷积,模型并不知道哪些区域更符合任务意图,哪些纹理只是背景扰动。对于小目标、遮挡目标、密集场景和视觉干扰较强的图像,关键前景响应容易被背景纹理稀释。
本次改进的核心不是简单堆叠注意力模块,而是借鉴 NeurIPS 2025 工作 Embodied Cognition Augmented End2End Autonomous Driving 的思想,将"具身认知"转化为 YOLO Neck 中的跨尺度认知门控。改进后的模块从 P3/P4/P5 中提取全局认知 token,再生成通道门控和空间门控,对 Detect 前的三尺度特征进行选择性增强。
这类写法适合论文方法部分的原因在于:它不是泛泛地说"加入注意力",而是给出了清晰的创新动机、结构位置、信息流和计算公式,能够围绕"原 YOLO 多尺度融合缺乏任务认知选择机制"这一痛点展开。
1. 原文摘要翻译与介绍提炼
原文链接:
摘要翻译
论文指出,端到端自动驾驶模型已经能够从传感器输入直接学习驾驶决策,但现有方法大多依赖视觉特征到轨迹规划的映射,缺少对人类驾驶者认知过程的显式建模。人类驾驶并不是被动识别图像,而是在感知环境、理解风险、预测交互和形成驾驶意图之间动态切换。为此,E3AD 引入驾驶过程中的脑电信号,将其视为一种具身认知监督,通过视频与 EEG 的对比学习构建 Driving-Thinking Model。该模型学习视觉场景与驾驶者认知状态之间的对应关系,并在下游端到端自动驾驶框架中作为认知增强分支使用。论文进一步将该认知表征接入时空特征、ego query 或 planning features,以提升规划过程对复杂交通场景的理解能力。
Introduction 提炼
原文介绍部分可以概括为三个层次:
第一,现有端到端自动驾驶模型虽然在感知、预测、规划联合学习上取得进展,但它们多数只从外部视觉输入中学习关联,缺少"为什么当前区域重要"的认知解释。
第二,人类驾驶行为具有典型的具身认知属性:驾驶者会把视觉刺激、身体状态、注意力分配和风险判断综合起来,并据此形成动作倾向。EEG 信号虽然不是检测模型推理时必须输入的模态,但可以在训练或表征学习阶段提供一种认知先验。
第三,E3AD 的关键价值在于把脑电-视觉对齐得到的认知表征注入自动驾驶模型,使模型不再只做纯视觉编码,而是在时空特征、查询特征或规划特征中引入更接近人类驾驶注意机制的选择偏置。
2. 为什么要融合:创新切入点
YOLO 的 Neck 主要解决"不同尺度特征如何融合"的问题,但原始 FPN/PAN 默认每一层特征都通过固定结构向下游传递。这带来三个方法痛点。
第一,融合是结构驱动的,不是任务认知驱动的。Concat 只负责拼接,C3k2 负责卷积重组,但没有显式建模"当前场景中哪些区域更值得被检测头关注"。
第二,多尺度信息缺少统一认知中心。P3 关注细节,P4 兼顾语义与位置,P5 具有强语义但空间分辨率低。原始 Neck 让它们在局部路径中交互,却缺少一个跨尺度 token 对全局显著性进行归纳。
第三,检测任务中的难例往往不是单纯的低层纹理问题,而是选择问题:遮挡行人、远处小目标、背景相似目标、密集区域目标,都需要模型在空间和通道两个维度上重新分配注意力。
因此,本次融合的创新切入点是:
将 E3AD 的"认知增强时空特征"迁移为 YOLO26 Neck 的"认知增强多尺度检测特征",通过跨尺度 token 生成 attention gate,让模型在 Detect 前完成一次面向目标重要性的特征重标定。
3. 改进模块核心结构与原理
3.1 原始 YOLO26 Neck 结构
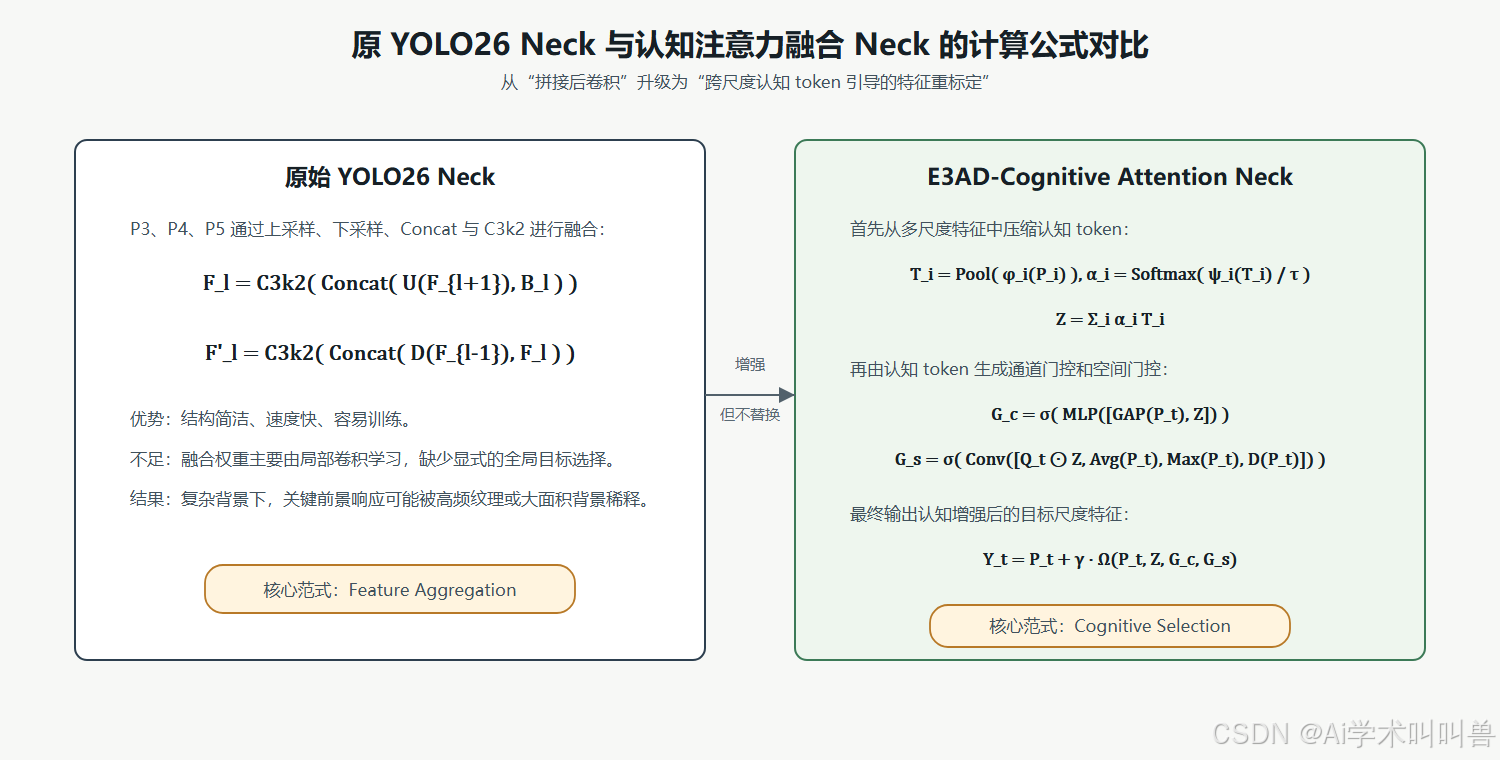
原始 YOLO26 的 Neck 可以抽象为:
text
P5 -> Upsample -> Concat(P4) -> C3k2
P4 -> Upsample -> Concat(P3) -> C3k2
P3 -> Downsample -> Concat(P4) -> C3k2
P4 -> Downsample -> Concat(P5) -> C3k2
Detect(P3, P4, P5)
其基本计算形式为:
text
F_l = C3k2(Concat(U(F_{l+1}), B_l))
F'_l = C3k2(Concat(D(F_{l-1}), F_l))其中,U 表示上采样,D 表示下采样,B_l 表示 Backbone 对应尺度输出。该路径高效,但对特征重要性的判断完全交给局部卷积隐式学习。
3.2 融合后的 E3AD-Cognitive Attention Fusion
改进模块输入为 Neck 输出的三尺度特征:
text
P3, P4, P5模块首先对三尺度特征进行通道对齐,并提取认知 token:
text
T_i = Pool(phi_i(P_i))
alpha_i = Softmax(psi_i(T_i) / tau)
Z = sum(alpha_i * T_i)其中,T_i 是第 i 个尺度的 token,alpha_i 是跨尺度显著性权重,Z 是融合后的 cognitive thought token。
随后,模块针对目标尺度 P_t 生成通道门控与空间门控:
text
G_c = Sigmoid(MLP([GAP(P_t), Z]))
G_s = Sigmoid(Conv([Q_t * Z, Avg(P_t), Max(P_t), D(P_t)]))其中,G_c 强调"哪些通道更重要",G_s 强调"哪些空间位置更重要",D(P_t) 表示局部细节能量。
最终输出为:
text
Y_t = P_t + gamma * Omega(P_t, Z, G_c, G_s)这里的 gamma 是可学习残差强度,保证模块不是粗暴替换原特征,而是在原 YOLO26 Neck 输出的基础上进行认知校正。
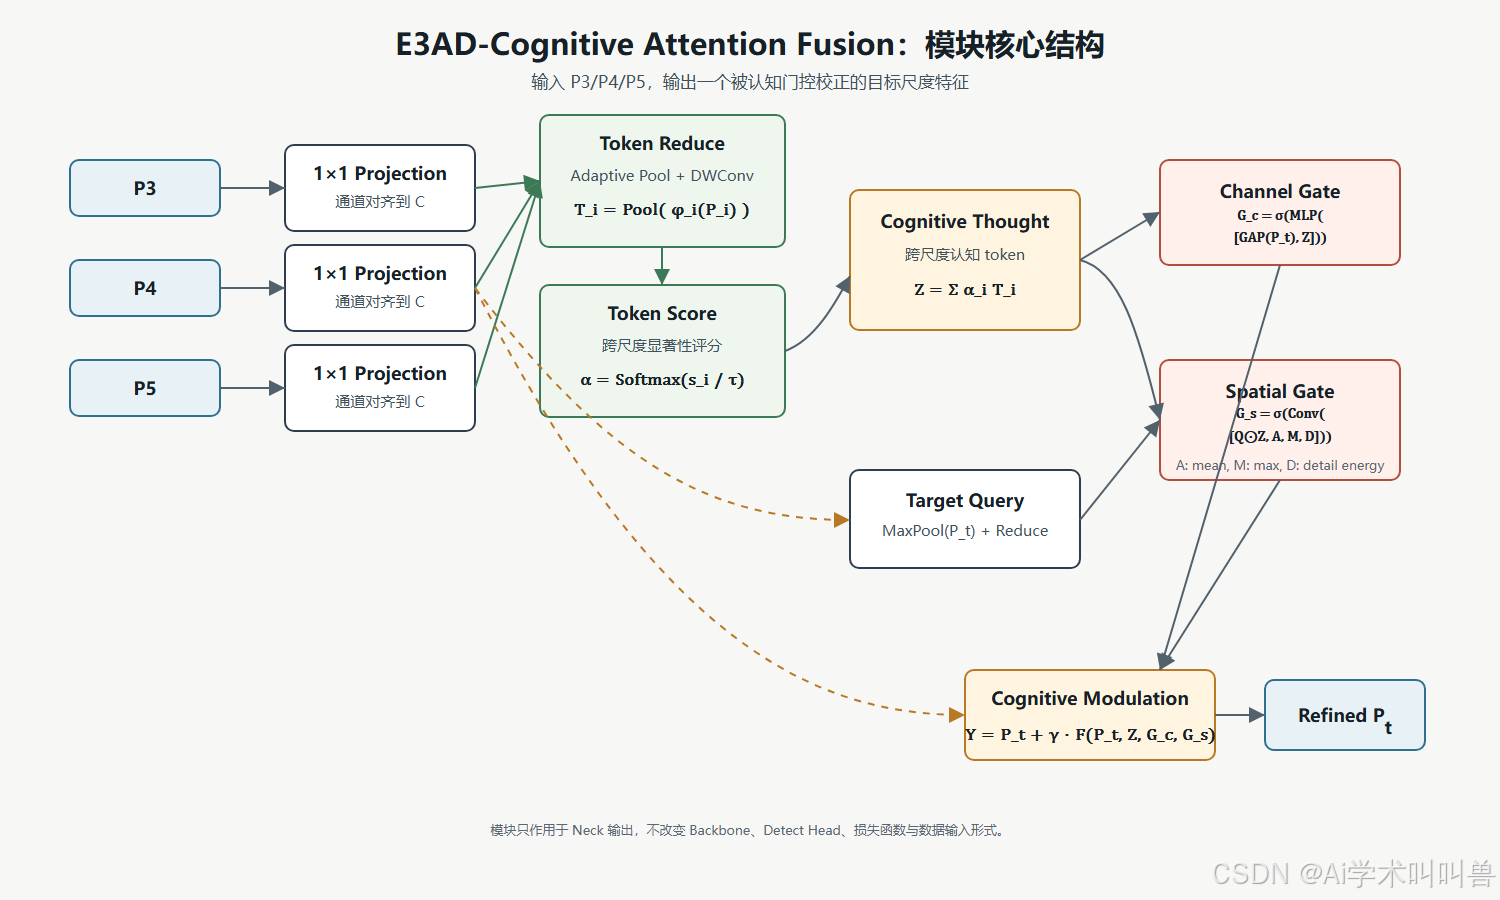
3.3 模块各部分作用
| 结构 | 作用 | 对原 YOLO 的补充 |
|---|---|---|
| Multi-scale Projection | 对齐 P3/P4/P5 通道 | 解决不同尺度语义维度不一致 |
| Token Reduce | 压缩每个尺度的全局信息 | 从局部卷积扩展到全局上下文 |
| Token Score | 学习跨尺度显著性权重 | 判断当前目标更依赖细节还是语义 |
| Cognitive Thought | 形成统一认知 token | 作为多尺度融合的全局选择中心 |
| Channel Gate | 选择重要语义通道 | 抑制无关背景通道响应 |
| Spatial Gate | 选择重要空间区域 | 强化目标区域、边缘区域和显著区域 |
| Residual Injection | 稳定增强 Detect 前特征 | 避免破坏原 YOLO26 的检测路径 |
4. 整合融合方法总览
完整网络仍保持 YOLO26 的 Backbone、FPN/PAN 主路径和 Detect Head 不变,只在 Detect 前加入三个并行的认知注意力融合模块:
text
P3, P4, P5 -> E3AD-Cog Gate(P3) -> Refined P3
P3, P4, P5 -> E3AD-Cog Gate(P4) -> Refined P4
P3, P4, P5 -> E3AD-Cog Gate(P5) -> Refined P5
Refined P3, Refined P4, Refined P5 -> Detect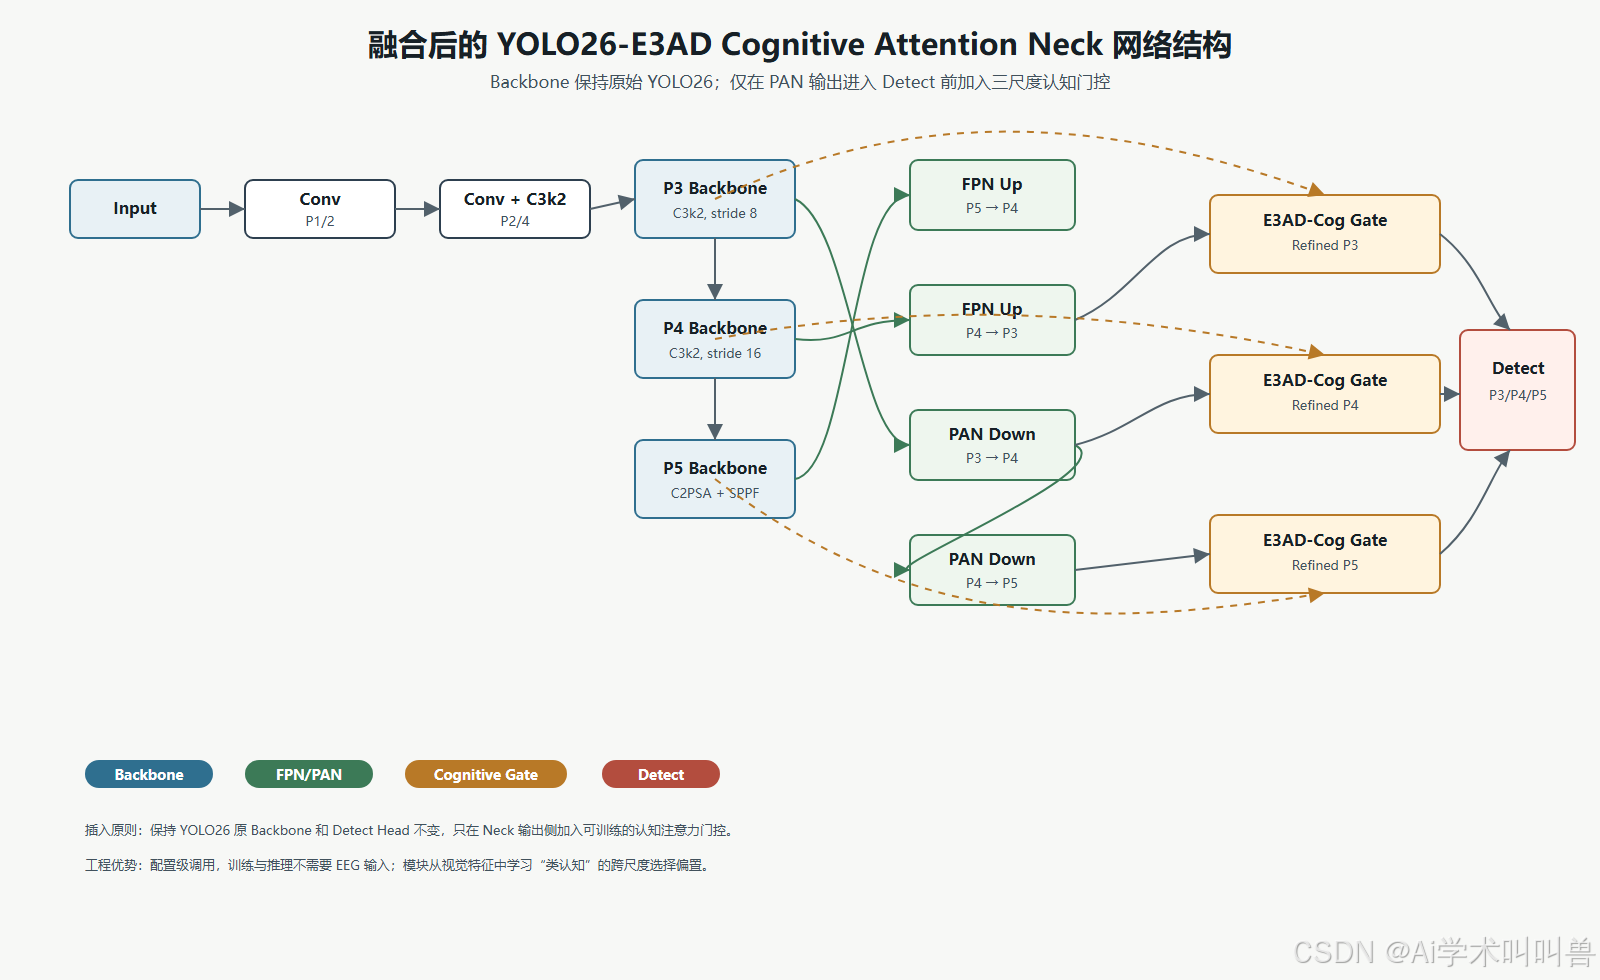
方法优势
第一,改进位置清晰。模块插入 Detect 前,不改变 Backbone 与检测头,便于做消融实验,也便于在论文中和原 YOLO26 直接对比。
第二,认知信息来自视觉特征内部。与 E3AD 原论文不同,这里的 YOLO26 推理阶段不需要 EEG 输入;模块将"具身认知增强"的思想转化为视觉特征中的跨尺度选择机制。
第三,同时覆盖通道与空间两个维度。通道门控决定语义维度的重要性,空间门控决定候选区域的重要性,两者共同缓解原始 Neck 被动拼接的问题。
第四,对 P3/P4/P5 分别增强。小目标更依赖 P3,中等目标更依赖 P4,大目标或强语义目标更依赖 P5;三尺度分别门控能够保留 YOLO 多尺度检测的基本优势。
第五,残差式设计更适合从零训练。输出保留原特征主干,再通过可学习残差注入认知增强项,使训练初期不会因为强注意力而破坏检测头输入分布。
5. 适合写进论文的创新点表述
可以在论文中这样表述本方法:
-
提出一种 E3AD-inspired Cognitive Attention Neck,将具身认知增强思想从端到端自动驾驶规划迁移到 YOLO26 多尺度目标检测中,实现了从"被动特征拼接"到"认知引导特征选择"的结构升级。
-
构建跨尺度 cognitive token bank,对 P3、P4、P5 特征进行统一压缩、评分和加权聚合,使 Neck 在进入检测头之前获得全局尺度感知能力。
-
设计通道-空间双重认知门控,通过
G_c与G_s同时建模语义通道重要性和空间区域显著性,从而增强目标区域响应并抑制背景干扰。 -
采用残差式认知注入机制,在保持 YOLO26 原始 Backbone、FPN/PAN 主路径和 Detect Head 不变的前提下,实现低侵入式结构增强,便于消融实验和工程部署。
-
该模块不依赖额外模态输入,在训练和推理阶段均可直接基于 RGB 图像特征运行,为将认知启发式建模引入通用目标检测框架提供了一种轻量可复用范式。
6. 原网络与融合后特点对比
| 对比维度 | 原始 YOLO26 | 融合 E3AD-Cognitive Attention 后 |
|---|---|---|
| Neck 融合方式 | 上下采样 + Concat + C3k2 | 跨尺度 token + 通道门控 + 空间门控 |
| 特征选择机制 | 隐式卷积学习 | 显式认知 attention gate |
| 全局上下文 | 主要依赖深层语义间接传递 | 由 P3/P4/P5 共同形成 cognitive token |
| 小目标区域 | 易受背景纹理影响 | P3 经过认知门控后强化细节显著区 |
| 中大目标区域 | 依赖 PAN 路径逐层传递 | P4/P5 可直接接收跨尺度认知反馈 |
| 改动范围 | 原始结构 | 仅 Detect 前 Neck 输出侧增强 |
| 推理输入 | RGB 图像 | RGB 图像,不额外引入 EEG |
| 论文叙事 | 常规多尺度融合 | 具身认知启发的目标检测特征选择 |
7. 写作痛点与本文方法的价值
很多 YOLO 改进文章的问题在于:只说"加入注意力模块",却没有解释为什么这个注意力适合当前结构,也没有说明它解决了原模型的哪个结构缺陷。这样的写法很难支撑高质量论文的方法创新。
本方法的写作逻辑更完整:
首先指出原 YOLO26 Neck 的痛点是"多尺度融合缺乏认知选择机制";然后引入 E3AD 的具身认知思想作为理论来源;接着把 EEG-视觉认知对齐的思想转化为 YOLO 内部的视觉认知 token;最后用通道门控、空间门控和残差注入完成结构实现。
因此,它不是孤立模块堆叠,而是一条从论文思想、结构缺陷、模块设计到公式表达都闭环的改进路线。
8. 总结
E3AD 给自动驾驶带来的启发是:视觉模型不应只被动编码画面,还应学习"什么更重要"。将这一思想迁移到 YOLO26 后,可以把 Neck 从传统的多尺度特征聚合器升级为具有认知选择能力的特征调制器。
写在最后
学术因方向、个人实验和写作能力以及具体创新内容的不同而无法做到一通百通,关注UP:Ai学术叫叫兽
在所有资料中留下联系方式以便在科研之余为家人们答疑解惑,本up主获得过国奖,发表多篇SCI,擅长目标检测领域,拥有多项竞赛经历,拥有软件著作权,核心期刊等经历。
因为经历过所以更懂小白的痛苦!
因为经历过所以更具有指向性的指导!
祝所有科研工作者都能够在自己的领域上更上一层楼!